

검색 증강 생성
검색 증강 생성
RAG를 사용해 대규모 지식 베이스로 에이전트를 강화하세요.
개요
검색 증강 생성(RAG) 을 사용하면 에이전트가 대화 중에 대규모 지식 베이스에 액세스하고 활용할 수 있습니다. 전체 문서를 컨텍스트 윈도우에 로드하는 대신, RAG는 각 사용자 쿼리에 가장 관련성 높은 정보만 검색하므로 에이전트는 다음과 같은 작업을 수행할 수 있습니다.
- 프롬프트에 담을 수 있는 것보다 훨씬 큰 지식 베이스에 액세스
- 지식에 기반한 더 정확한 응답 제공
- 소스 자료를 참조하여 환각 감소
- 여러 전문 에이전트를 만들지 않고 지식 확장
RAG는 기존 프롬프팅의 컨텍스트 윈도우 한도를 초과할 수 있는 대용량 문서, 기술 매뉴얼 또는 방대한 지식 베이스를 참조해야 하는 에이전트에 적합합니다. RAG는 에이전트 응답 시간에 약 250ms의 약간의 지연 시간을 추가합니다.
이 동영상은 이전 버전의 대시보드에서 녹화되었습니다. RAG 구성 단계는 변경되지 않았지만 일부 인터페이스 요소는 다르게 보일 수 있습니다.
RAG 작동 방식
RAG가 활성화되면 에이전트는 다음 단계를 통해 사용자 쿼리를 처리합니다.
- 쿼리 처리: 사용자의 질문을 분석하고 최적의 검색을 위해 재구성합니다.
- 임베딩 생성: 처리된 쿼리를 사용자의 질문을 나타내는 벡터 임베딩으로 변환합니다.
- 검색: 시스템이 지식 베이스에서 의미상 가장 유사한 콘텐츠를 찾습니다.
- 응답 생성: 에이전트가 대화 컨텍스트와 검색된 정보를 모두 사용해 응답을 생성합니다.
이 프로세스는 사용자의 쿼리와 관련된 정보가 사실에 근거한 답변을 생성할 수 있도록 LLM에 전달되게 합니다.
가이드
사전 요구 사항
- ElevenLabs 계정
- 구성된 ElevenLabs 대화형 에이전트
- 에이전트의 지식 베이스에 추가된 문서 최소 1개
에이전트에 RAG 활성화
대시보드에서 업데이트
CLI에서 업데이트
API에서 업데이트
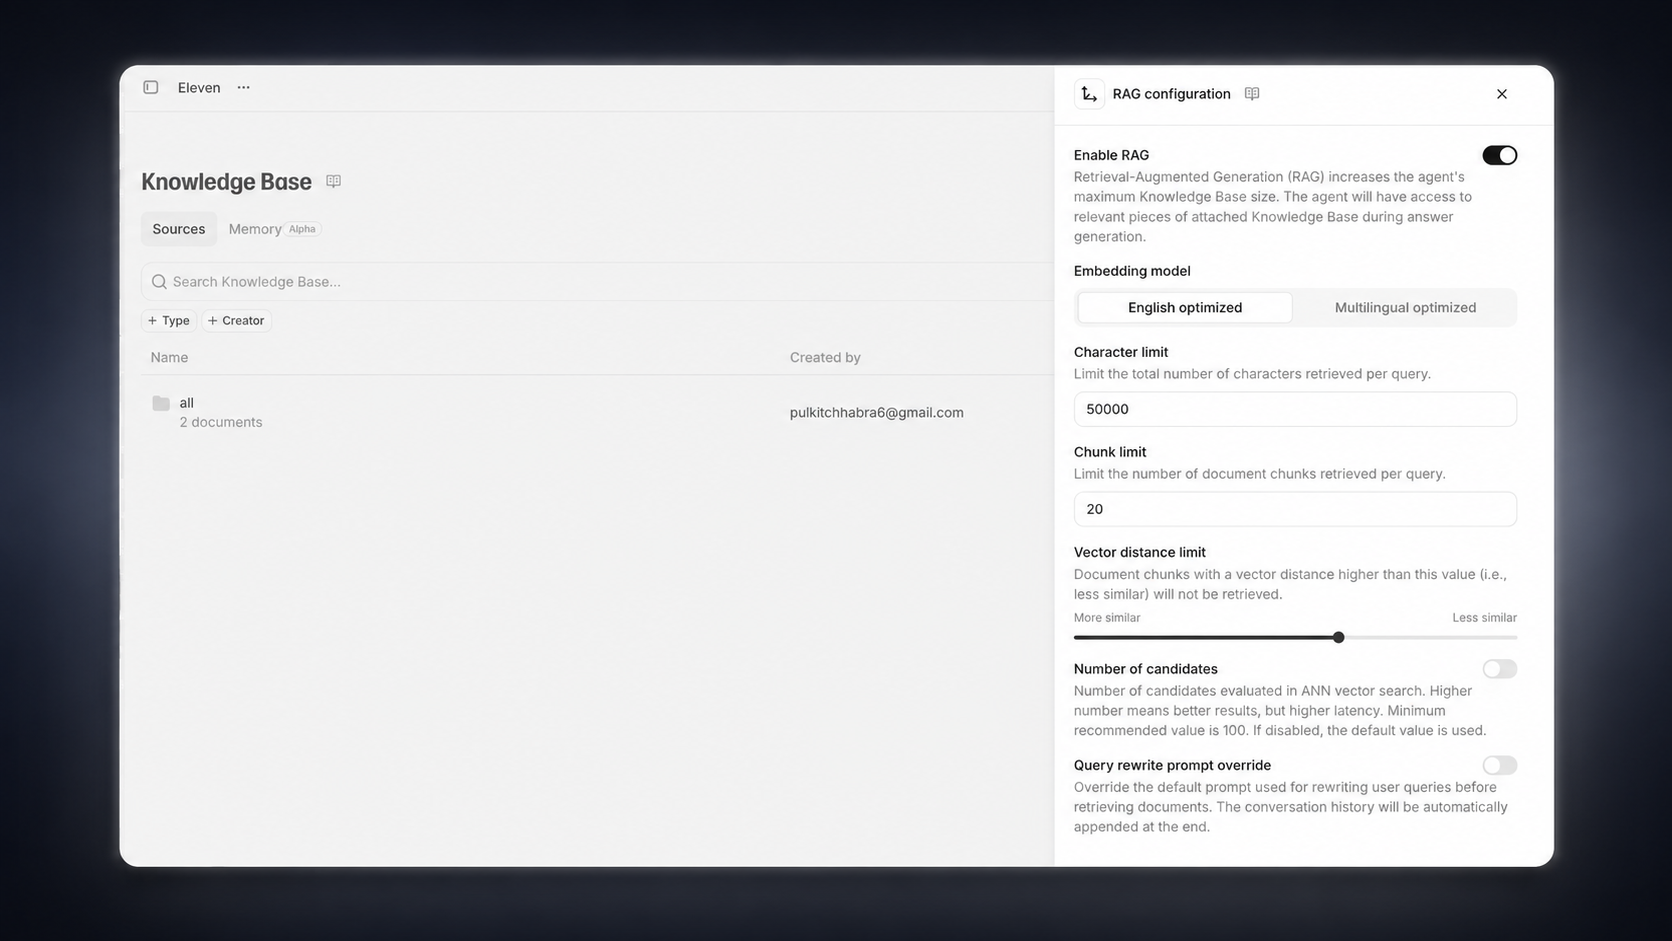
에이전트 설정에서 Knowledge Base 섹션으로 이동한 후 Use RAG 옵션을 켜세요. 필요에 따라 Advanced 탭에서 임베딩 모델, 최대 문서 청크 수, 최대 벡터 거리를 구성하세요.
지식 베이스 인덱싱
지식 베이스의 각 문서는 RAG와 함께 사용하려면 먼저 인덱싱해야 합니다. 이 프로세스는 RAG가 활성화된 에이전트에 문서를 추가하면 자동으로 수행됩니다.
대용량 문서는 인덱싱에 몇 분이 걸릴 수 있습니다. 지식 베이스 목록에서 인덱싱 상태를 확인할 수 있습니다.
문서 사용 모드 구성(선택 사항)
지식 베이스의 각 문서에 대해 사용 방식을 선택할 수 있습니다.
- 자동(기본값): 쿼리와 관련이 있을 때만 문서를 검색합니다.
- 프롬프트: 관련성과 관계없이 문서가 항상 시스템 프롬프트에 포함됩니다.
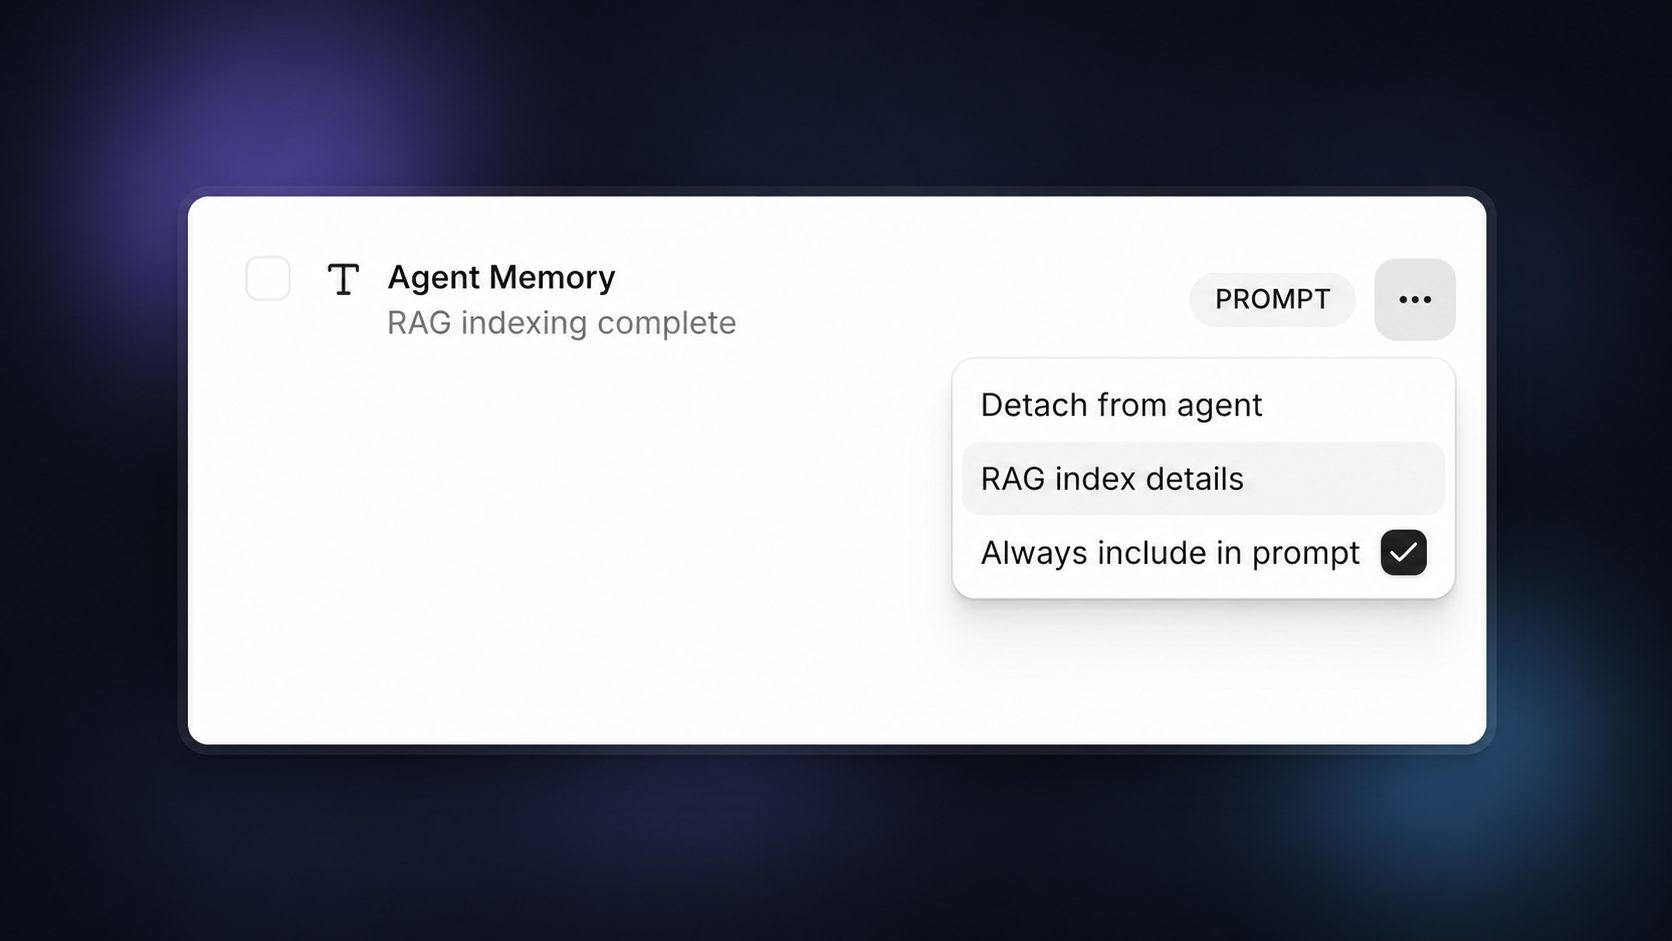
너무 많은 문서를 “프롬프트” 모드로 설정하면 컨텍스트 제한을 초과할 수 있습니다. 중요한 정보에만 이 옵션을 제한적으로 사용하세요.
RAG가 활성화된 에이전트 테스트
구성을 저장한 후 지식 베이스와 관련된 질문을 하여 에이전트를 테스트하세요. 이제 에이전트가 문서에서 특정 정보를 검색하고 참조할 수 있습니다.
사용 제한
공정한 리소스 할당을 위해 ElevenLabs는 구독 등급에 따라 워크스페이스별로 RAG에 인덱싱할 수 있는 문서의 총 크기에 제한을 적용합니다.
제한은 다음과 같습니다.
참고:
- 이 제한은 RAG 인덱스 자체의 내부 저장 크기(훨씬 더 클 수 있음)가 아니라 RAG에 인덱싱되는 문서의 총 원본 파일 크기에 적용됩니다.
- 500바이트 미만의 문서는 RAG에 인덱싱할 수 없으며 대신 자동으로 프롬프트에 사용됩니다.
API 구현
API를 통해서도 RAG를 구현할 수 있습니다.