跳到导航

检索增强生成

使用 RAG 和大型知识库增强智能体能力。

概览

检索增强生成(RAG) 让智能体能在对话中访问和使用大型知识库。RAG 无需将完整文档加载到上下文窗口,而是仅检索与每个用户查询最相关的信息,让智能体能够:

  • 访问远超提示词容量的知识库
  • 提供更准确、有知识依据的回复
  • 通过引用源材料减少幻觉
  • 无需创建多个专业智能体即可扩展知识

RAG 非常适合需要引用大型文档、技术手册或大量知识库的智能体,这些内容会超出传统提示词的上下文窗口限制。 RAG 会为智能体响应时间增加约 250ms 的少量延迟。

此视频使用旧版控制台录制。RAG 配置步骤未变,但部分界面元素可能有所不同。

RAG 的工作原理

启用 RAG 后,智能体会通过以下步骤处理用户查询:

  1. 查询处理:分析并重构用户问题,以实现最佳检索效果。
  2. 嵌入生成:将处理后的查询转换为代表用户问题的向量嵌入。
  3. 检索:系统从知识库中查找语义最相似的内容。
  4. 回复生成:智能体结合对话上下文和检索到的信息生成回复。

这一流程可确保与用户查询相关的信息传递给 LLM,从而生成事实正确的答案。

指南

前提条件

为智能体启用 RAG

在智能体设置中,打开 知识库 并选择 检索 标签。在 检索模式 下,选择 每轮 可在每轮对话中搜索知识库;选择 按需 则仅在智能体判断需要时搜索。仅提示词 会关闭检索。

在 语义搜索 下配置嵌入模型、向量距离限制和候选数量,并在 检索限制 下配置字符和分块限制。

知识库索引

知识库中的每份文档都需要先建立索引,才能与 RAG 配合使用。 向启用 RAG 的智能体添加文档时,会自动完成此过程。

大型文档的索引可能需要几分钟。你可以在知识库列表中查看索引状态。

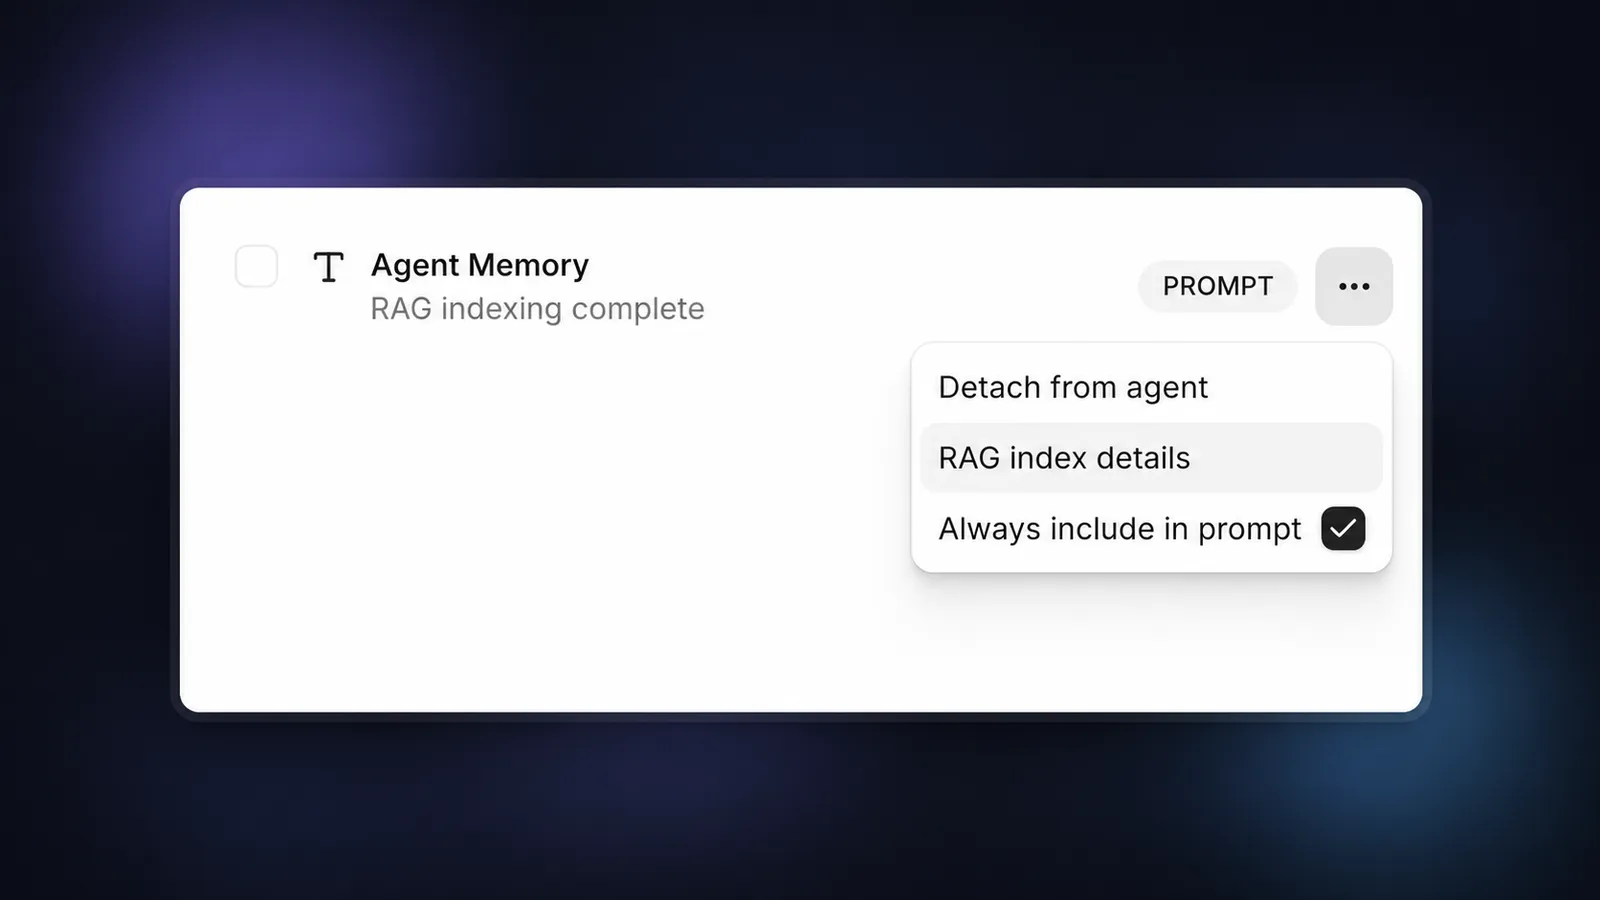
配置文档使用模式(可选)

可以为知识库中的每份文档选择使用方式:

  • 自动(默认):仅在与查询相关时检索文档
  • 提示词:无论是否相关,始终将文档加入系统提示词
知识库中的文档使用模式选项

将过多文档设为“提示词”模式可能超出上下文限制。仅对关键信息谨慎使用此选项。

测试启用 RAG 的智能体

保存配置后,围绕知识库内容向智能体提问进行测试。现在,智能体应能从文档中检索并引用具体信息。

使用限制

为确保资源公平分配,ElevenLabs 会根据订阅套餐,对每个工作区可为 RAG 建立索引的文档总大小设置限制。

限制如下:

订阅套餐文档总大小限制说明
免费版1MB长时间未使用后,索引可能会被删除。
Starter2MB
Creator20MB
Pro100MB
Scale500MB
商业版1GB
企业版1GB可根据套餐和协议提供更高限制。

注意:

  • 这些限制适用于为 RAG 建立索引的文档 原始文件大小 总和,而非 RAG 索引本身的内部存储大小(后者可能大得多)。
  • 小于 500 字节的文档无法建立 RAG 索引,系统会自动改为在提示词中使用。

API 实现

也可以通过 API 实现 RAG:

from elevenlabs import ElevenLabs
import time
# Initialize the ElevenLabs client
elevenlabs = ElevenLabs(api_key="your-api-key")
# First, index a document for RAG
document_id = "your-document-id"
embedding_model = "e5_mistral_7b_instruct"
# Trigger RAG indexing
response = elevenlabs.conversational_ai.knowledge_base.document.compute_rag_index(
documentation_id=document_id,
model=embedding_model
)
# Check indexing status
while response.status not in ["SUCCEEDED", "FAILED"]:
time.sleep(5) # Wait 5 seconds before checking status again
response = elevenlabs.conversational_ai.knowledge_base.document.compute_rag_index(
documentation_id=document_id,
model=embedding_model
)
# Then update agent configuration to use RAG
agent_id = "agent_7101k5zvyjhmfg983brhmhkd98n6"
# Get the current agent configuration
agent_config = elevenlabs.conversational_ai.agents.get(agent_id=agent_id)
# Enable RAG in the agent configuration
agent_config.agent.prompt.rag = {
"enabled": True,
"embedding_model": "e5_mistral_7b_instruct",
"max_documents_length": 10000
}
# Update document usage mode if needed
for i, doc in enumerate(agent_config.agent.prompt.knowledge_base):
if doc.id == document_id:
agent_config.agent.prompt.knowledge_base[i].usage_mode = "auto"
# Update the agent configuration
elevenlabs.conversational_ai.agents.update(
agent_id=agent_id,
conversation_config=agent_config.agent
)