

Uitspraakwoordenboeken
Leer hoe je bepaalt hoe je AI-agent specifieke woorden en zinnen uitspreekt.
Overzicht
Met uitspraakwoordenboeken kun je aanpassen hoe je AI-agent specifieke woorden of zinnen uitspreekt. Dit is vooral handig voor:
- Het corrigeren van de uitspraak van namen, plaatsen of technische termen
- Het zorgen voor een consistente uitspraak in gesprekken
- Het aanpassen van regionale uitspraakvariaties
Configuratie
Foneemtags in uitspraakwoordenboeken werken alleen met de modellen eleven_v4, eleven_flash_v2 en eleven_v3.
Andere modellen slaan foneemtags in woordenboeken over en gebruiken de standaarduitspraak. Gebruik voor andere modellen in plaats daarvan aliastags om spellingen of zinnen te vervangen die de gewenste uitspraak opleveren.
Als je IPA- en CMU-uitspraken wilt gebruiken in andere talen dan Engels, moet je overschakelen naar de modellen eleven_v3 of eleven_v4.
Een woordenboek aan je agent koppelen
Bijwerken via het dashboard
Bijwerken via de CLI
Bijwerken via de API
Open je agent in het dashboard, ga naar Steminstellingen en voeg een uitspraakwoordenboek toe. Sla je wijzigingen op.
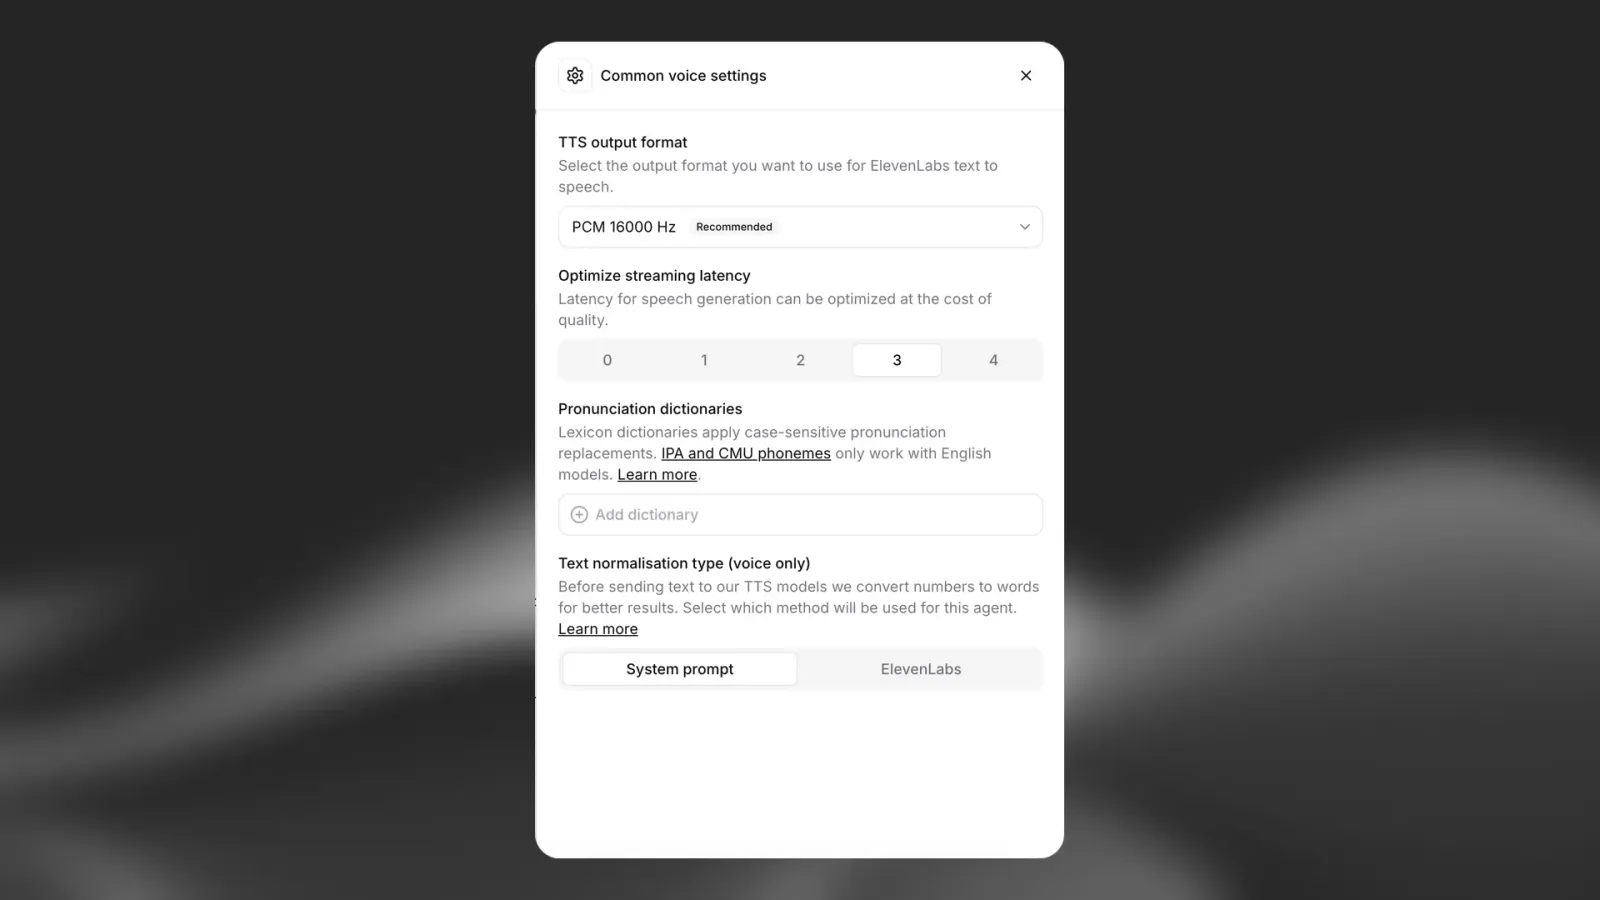
Bestandsindeling van woordenboeken
Uitspraakwoordenboeken gebruiken XML-gebaseerde .pls-bestanden. Dit is een voorbeeldstructuur:
Ondersteunde indelingen
Uitspraakwoordenboeken ondersteunen twee typen uitspraaknotatie:
-
IPA (International Phonetic Alphabet)
- Nauwkeurigere controle over de uitspraak
- Vereist kennis van IPA-symbolen
- Voorbeeld: “nginx” als
/ˈɛndʒɪnˈɛks/
-
CMU-indeling (Carnegie Mellon University)-woordenboekindeling
- Eenvoudigere ASCII-gebaseerde indeling
- Toegankelijker voor Engelse uitspraken
- Voorbeeld: “tomato” als “T AH M EY T OW”
Je kunt AI-tools zoals Claude of ChatGPT gebruiken om IPA- of CMU-notaties voor specifieke woorden te genereren.
Best practices
- Hoofdlettergevoeligheid: Maak indien nodig afzonderlijke vermeldingen voor versies van woorden met hoofdletters en kleine letters
- Testen: Test uitspraken altijd met de door jou gekozen stem en het gekozen model
- Onderhoud: Houd je woordenboek overzichtelijk en gedocumenteerd
- Bereik: Richt je op woorden die vaak verkeerd worden uitgesproken of cruciaal zijn voor je use case
Veelgestelde vragen
Welke modellen ondersteunen op fonemen gebaseerde uitspraak?
Foneemtags in uitspraakwoordenboeken werken alleen met de modellen eleven_v4, eleven_flash_v2 en eleven_v3.
Andere modellen slaan foneemtags in woordenboeken over en gebruiken de standaarduitspraak. Gebruik voor andere modellen in plaats daarvan aliastags om spellingen of zinnen te vervangen die de gewenste uitspraak opleveren.
Als je IPA- en CMU-uitspraken wilt gebruiken in andere talen dan Engels, moet je overschakelen naar het model eleven_v4 of eleven_v3.
Kan ik meerdere woordenboeken gebruiken?
Ja, je kunt meerdere woordenboekbestanden uploaden voor verschillende sets uitspraken.
Wat gebeurt er als een woord niet in het woordenboek staat?
Het model gebruikt de standaardregels voor uitspraak voor woorden die niet in het woordenboek staan.