

Voice Design
Overzicht
Voice Design helpt creators wanneer de exacte stem die ze zoeken niet beschikbaar is in de Voice Library. Kun je geen geschikte stem vinden voor je project, dan kun je er zelf een maken. Voice Design is het meest geschikt voor snelle verkenning en iteratie, en de kwaliteit van de output kan variëren afhankelijk van je prompt en use case. Als je de meest consistente, productierijpe kwaliteit nodig hebt, zijn Professional Voice Clones (PVC) momenteel de stemmen van de hoogste kwaliteit op ons platform. Als er dus een PVC beschikbaar is in onze bibliotheek die aan je behoeften voldoet, raden we aan die te gebruiken.
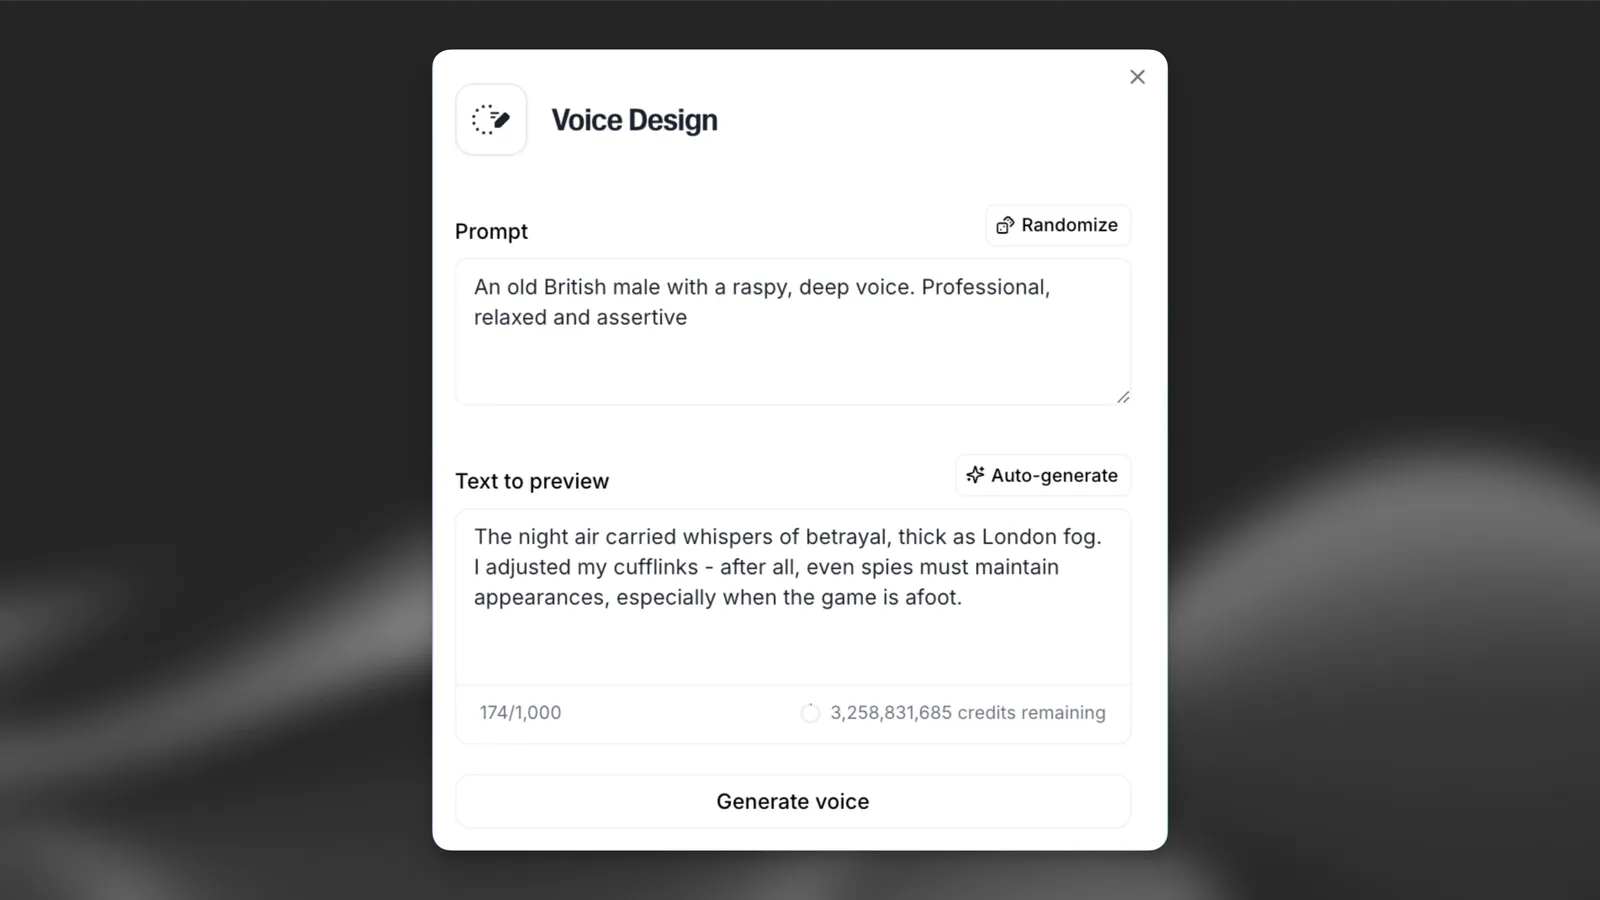
Je vindt Voice Design door in de ElevenLabs-app naar Voices -> My Voices -> Add a new voice -> Voice Design te gaan, of via de API.
Wanneer je op genereren klikt, genereren we drie stemopties voor je. De enige kosten voor het gebruik van Voice Design zijn het aantal credits voor het genereren van je previewtekst. Die worden maar één keer in rekening gebracht, ook al genereren we drie samples voor je. In het tekstvak “Text to preview” zie je hoeveel tekens worden afgetrokken.
Na het genereren kun je een van de gegenereerde stemmen selecteren en opslaan. Dit neemt een van je stemslots in.
Handleiding voor prompts
De prompt vormt de basis van je stem. Deze vertelt het model wat voor soort stem je probeert te maken — van het accent en het karaktertype tot het geslacht en de uitstraling van de stem. Een goed geformuleerde prompt kan het verschil maken tussen een algemene stem en een stem die echt bij je visie past. Over het algemeen leveren meer beschrijvende en gedetailleerde prompts nauwkeurigere en genuanceerdere resultaten op. Hoe meer details je geeft — waaronder leeftijd, geslacht, toon, accent, tempo, emotie, stijl en meer — hoe beter het model een stem kan interpreteren en produceren die doelgericht en afgestemd voelt.
Soms werken korte en eenvoudige prompts echter ook, vooral wanneer je een neutralere of breed inzetbare stem zoekt. Bijvoorbeeld: “Een rustige mannelijke verteller” kan je precies geven wat je nodig hebt zonder in detail te treden — met name als je geen heel specifiek karakter of specifieke stijl wilt creëren. Het juiste detailniveau hangt af van je use case. Bouw je een fantasiepersonage? Een virtuele assistent? Een vermoeide New Yorker van in de 60 met een droge humor? Hoe duidelijker je dit in je prompt definieert, hoe dichter de output komt bij wat je voor ogen hebt.
Aanbevolen promptindeling
Gebruik voor consistente resultaten deze structuur voor je prompt:
Voorbeeld:
Moedertaal Spaans, español europeo (sin rasgos de español latinoamericano). Vrouw, 35–40. Redelijke kwaliteit. Persona: betrouwbare supportmedewerker. Emotie: geruststellend, aandachtig, zelfverzekerd. Zacht, natuurlijk timbre met milde intonatie, directe nabijheid en een ruisvrij signaal. Brengt updates in een ontspannen tempo met duidelijke nadruk op nuttige informatie, en straalt empathie en professionaliteit uit.
Veelvoorkomende valkuilen om te vermijden
- Gebruik “accent” niet als je intonatie bedoelt — dit kan ongewenste verschuivingen in dialect veroorzaken. Beschrijf in plaats daarvan intonatie, nadruk of patronen in de voordracht.
- Vermijd FX-woorden — termen als “reverb”, “echo”, “phone” of “tape” kunnen de kwaliteit van de output negatief beïnvloeden.
- Wees expliciet over taal en dialect — vermeld altijd de taal en regionale variant in de eerste zin om afwijkingen te voorkomen.
Audiokwaliteit
Audiokwaliteit verwijst naar de helderheid, zuiverheid en algehele natuurgetrouwheid van de gegenereerde stem. Standaard streeft ElevenLabs ernaar schone en natuurlijk klinkende audio te produceren, maar als je project een specifiek kwaliteitsniveau vereist, kun je dit het beste expliciet in je prompt opnemen.
Voor resultaten van hoge kwaliteit kun je het model helpen door een zin als “perfecte audiokwaliteit” of “opname in studiokwaliteit” aan je stembeschrijving toe te voegen. Dit helpt ervoor te zorgen dat de stem wordt gegenereerd met maximale helderheid, minimale vervorming en een gepolijste afwerking.
Je kunt ook specifieke kwaliteitsbeschrijvingen gebruiken die consistente resultaten opleveren:
- Redelijke kwaliteit
- Goede kwaliteit
- Zeer goede kwaliteit
- Uitstekende kwaliteit
- Studiokwaliteit
- Uitzendkwaliteit
Deze beschrijvingen helpen de hoogste audiokwaliteit te bereiken wanneer je ze in je prompt opneemt.
Het opnemen van dit soort zinnen kan de nauwkeurigheid van de prompt in het algemeen soms verminderen als de stem heel specifiek of niche is.
Er kunnen ook creatieve situaties zijn waarin een lagere audiokwaliteit bewust gewenst is, zoals bij het nabootsen van een telefoongesprek, een oude radio-uitzending of gevonden beeldmateriaal. Laat kwaliteitsbeschrijvingen in die situaties weg of neem expliciet zinnen op zoals:
- “Audio met lage natuurgetrouwheid”
- “Slechte audiokwaliteit”
- “Klinkt als een voicemail”
- “Gedempt en ver weg, zoals op een oude cassetterecorder”
De plaats van deze zin in je prompt is flexibel — deze kan aan het begin of einde staan, al hebben we gemerkt dat beide goed werken.
Leeftijd, toon/klankkleur en gender
Deze drie kenmerken vormen de basis van stemontwerp en bepalen de algehele identiteit en emotionele impact van de stem. Hoe meer details je geeft, hoe makkelijker het voor de AI is om een stem te produceren die bij je creatieve visie past — of je nu een geloofwaardig personage ontwikkelt, een boeiende verteller creëert of een virtuele assistent ontwerpt.
Leeftijd
Het beschrijven van de waargenomen leeftijd van de stem helpt om de rijpheid, vocale textuur en energie ervan te bepalen. Gebruik specifieke termen om de AI naar de juiste stemkwaliteit te sturen.
Handige omschrijvingen:
- “Adolescente man” / “adolescente vrouw”
- “Jonge volwassene” / “tussen de 20 en 30 jaar” / “begin 30”
- “Man van middelbare leeftijd” / “vrouw van in de 40”
- “Oudere man” / “oudere vrouw” / “man van in de 80”
Toon/klankkleur
Verwijst naar de fysieke kwaliteit van de stem, die wordt bepaald door toonhoogte, resonantie en vocale textuur. Dit staat los van emotionele voordracht of houding.
Veelvoorkomende omschrijvingen voor toon/klankkleur:
- “Diep” / “laag”
- “Glad” / “vol”
- “Hees” / “schor”
- “Nasaal” / “schel”
- “Luchtig” / “ademend”
- “Krachtig” / “resonerend”
- “Licht” / “dun”
- “Warm” / “zacht”
- “Blikkerig” / “metaalachtig”
Gender
Gender heeft vaak invloed op toonhoogte, vocaal gewicht en de aanwezigheid van de toon — maar je kunt verder gaan dan eenvoudige categorieën door het geluid te beschrijven in plaats van de identiteit.
Voorbeelden:
- “Een laag klinkende, hese vrouwenstem”
- “Een mannelijke mannenstem, diep en resonerend”
- “Een genderneutrale stem — zacht en met een gemiddelde toonhoogte”
Accent
Accent speelt een cruciale rol bij het bepalen van de regionale, culturele en emotionele identiteit van een stem. Als je project afhankelijk is van een authentiek geluid — of het nu realistisch moet zijn of gestileerd voor een personage — is het essentieel om duidelijk en bewust te zijn over het gewenste accent.
De woordkeuze is belangrijk: bepaalde termen leveren doorgaans consistentere resultaten op. Zo geeft “dik” vaak betere resultaten dan “sterk” wanneer je beschrijft hoe opvallend een accent moet zijn. Er komt veel uitproberen bij kijken, dus we raden je aan te experimenteren met de formulering en zo creatief en beschrijvend mogelijk te zijn.
Wees voorzichtig met het woord “accent” — als je intonatie- of klemtoonpatronen bedoelt in plaats van een regionaal dialect, gebruik dan die termen. Als je “accent” gebruikt terwijl je intonatie bedoelt, kan dat ongewenste verschuivingen in dialect veroorzaken.
- Voorbeelden van duidelijke accentprompts:
- “Een man van middelbare leeftijd met een dik Frans accent”
- “Een jonge vrouw met een licht Zuidelijk accent”
- “Een oude man met een zwaar Oost-Europees accent”
- “Een vrolijke vrouw die spreekt met een helder Brits accent”
- “Een jongere man met een zachte Ierse tongval”
- “Een gezaghebbende stem met een neutraal Amerikaans accent”
- “Een man met een regionaal Australisch accent, ontspannen en nasaal”
Vermijd al te vage omschrijvingen zoals “buitenlands” of “exotisch” — die zijn onnauwkeurig en kunnen inconsistente resultaten opleveren.
Combineer het accent met andere eigenschappen, zoals toon, leeftijd of tempo, voor meer controle. Bijvoorbeeld: “Een sarcastische oude vrouw met een dik New Yorks accent, die langzaam spreekt.”
Voor fantasy- of fictieve stemmen kun je echte accenten als inspiratie gebruiken:
- “Een elf met een echt dik Brits accent. Hij is vorstelijk en lyrisch.”
- “Een goblin met een schor Oost-Europees accent.”
Tempo
Tempo verwijst naar de snelheid en het ritme waarmee een stem spreekt. Het is een belangrijk onderdeel bij het vormgeven van de persoonlijkheid, emotionele toon en helderheid van de stem. Duidelijk zijn over het tempo is essentieel, vooral wanneer je stemmen ontwerpt voor specifieke toepassingen zoals verhalen vertellen, reclame, personagedialogen of instructieve content.
Gebruik duidelijke taal om te beschrijven hoe snel of langzaam de stem moet spreken. Je kunt ook beschrijven hoe het tempo aanvoelt — of het gelijkmatig, grillig, weloverwogen of vlot is. Als het tempo verandert, geef dan aan waar en waarom.
Voorbeelden van omschrijvingen voor tempo:
- “Spreekt snel” / “in een hoog tempo”
- “In een normaal tempo” / “spreekt normaal”
- “Spreekt langzaam” / “met een langzaam ritme”
- “Weloverwogen en afgemeten tempo”
- “Gerekt, alsof elk woord wordt geproefd”
- “Met een gehaast ritme, alsof diegene haast heeft”
- “Ontspannen en conversationeel tempo”
- “Ritmisch en muzikaal tempo”
- “Grillig tempo, met abrupte pauzes en uitbarstingen”
- “Gelijkmatig tempo, met consistente timing tussen woorden”
- “Staccato voordracht”
Tekst voor preview
Zodra je een goede stemprompt hebt geschreven, speelt de tekst die je gebruikt om die stem te previewen een cruciale rol in hoe deze daadwerkelijk klinkt. De previewtekst werkt als een uitvoeringsscript — deze bepaalt de toon, het tempo en de emotionele voordracht die de stem probeert te evenaren.
Voor de beste resultaten moet je previewtekst de stembeschrijving aanvullen, niet tegenspreken. Als je prompt bijvoorbeeld een “kalme en reflectieve jongere vrouwenstem met een licht Japans accent” beschrijft, botst een zin als “Hé! Ik kan niet uitstaan wat je met die verdomde plek hebt gedaan!!!” met die bedoeling. Het model zal die tegenstrijdigheid proberen te verzoenen, wat vaak leidt tot onnatuurlijke of inconsistente resultaten.
Gebruik in plaats daarvan voorbeeldtekst die de beoogde persoonlijkheid en emotionele toon van de stem weerspiegelt. Voor het bovenstaande voorbeeld ondersteunt iets als “De laatste tijd is het stil geweest… Ik heb tijd gehad om na te denken, en misschien had ik dat wel het hardst nodig.” de prompt en helpt het een natuurlijkere, samenhangende stem te genereren.
Daarnaast hebben we gemerkt dat langere previewteksten doorgaans stabielere en expressievere resultaten opleveren. Korte zinnen kunnen soms abrupt of inconsistent klinken, vooral bij het testen van subtiele eigenschappen zoals toon of tempo. Door het model meer context te geven — een volledige zin of zelfs een korte alinea — kan het een vloeiendere en nauwkeurigere weergave van de stem leveren.
Parameters
Volume
Bepaalt het volume van de Text to Preview-generatie en uiteindelijk van de stem nadat deze is opgeslagen.
Guidance Scale
Bepaalt hoe nauw de Prompt wordt gevolgd. Hogere waarden houden zich strikter aan de prompt, maar kunnen leiden tot een lagere audiokwaliteit als de prompt erg niche is. Lagere waarden geven het model meer ruimte om creatief te zijn, ten koste van de nauwkeurigheid van de prompt. Gebruik een lagere waarde als de uitvoering en audiokwaliteit over het algemeen belangrijker zijn dan de prompt perfect volgen. Hoge waarden worden aanbevolen wanneer de nauwkeurigheid van het accent of de toon van het grootste belang is.
Eigenschappen en voorbeelden
Experimenteer met de manier waarop je deze omschrijvingen formuleert. Bijvoorbeeld: “Perfecte audiokwaliteit” kan ook worden geschreven als “de audiokwaliteit is perfect”. Deze kunnen soms verschillende resultaten opleveren!