

Voice Design
Przewodnik po tworzeniu głosów na podstawie polecenia tekstowego.
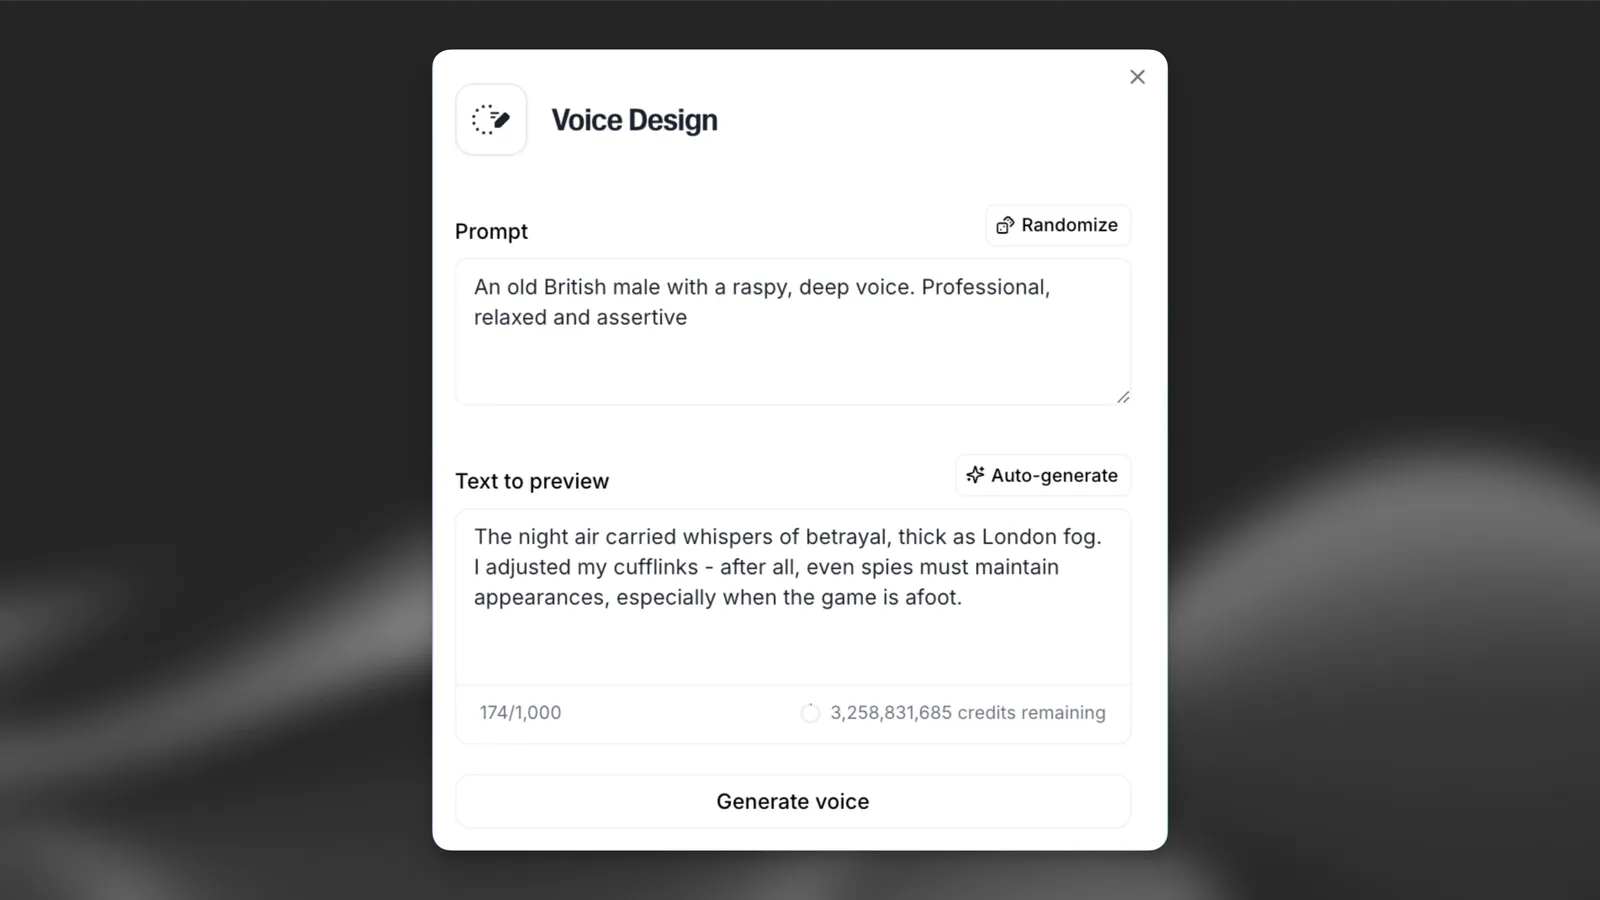
Przegląd
Voice Design pomaga twórcom uzupełnić braki, gdy dokładnego głosu, którego szukają, nie ma w Voice Library. Jeśli nie możesz znaleźć odpowiedniego głosu do projektu, możesz go stworzyć. Voice Design najlepiej sprawdza się do szybkiego testowania i iteracji, a jakość wyników może się różnić zależnie od polecenia i zastosowania. Jeśli potrzebujesz najwyższej, gotowej do produkcji jakości, Professional Voice Clones (PVC) to obecnie głosy najwyższej jakości na naszej platformie. Jeśli w naszej bibliotece jest PVC, które spełnia twoje potrzeby, zalecamy użycie go.
Voice Design znajdziesz w aplikacji ElevenLabs: Voices -> My Voices -> Add a new voice -> Voice Design, albo przez API.
Po kliknięciu Generate utworzymy dla ciebie trzy opcje głosu. Za użycie Voice Design płacisz tylko za liczbę kredytów potrzebnych do wygenerowania tekstu podglądu. Opłata jest pobierana tylko raz, mimo że generujemy trzy próbki. Liczbę znaków, które zostaną odjęte, zobaczysz w polu tekstowym „Text to preview”.
Po wygenerowaniu możesz wybrać i zapisać jedną z wersji, która zajmie jeden z twoich slotów głosowych.
Przewodnik po tworzeniu poleceń
Polecenie to podstawa twojego głosu. Mówi modelowi, jaki głos chcesz stworzyć — od akcentu i typu postaci po płeć i charakter głosu. Dobrze napisane polecenie może zadecydować o różnicy między ogólnym głosem a takim, który naprawdę pasuje do twojej wizji. Zwykle bardziej opisowe i szczegółowe polecenia dają dokładniejsze i bardziej zniuansowane wyniki. Im więcej podasz szczegółów — wieku, płci, tonu, akcentu, tempa, emocji, stylu i innych — tym lepiej model zinterpretuje i stworzy głos, który brzmi celowo i jest dopasowany do twoich potrzeb.
Czasem jednak działają też krótkie, proste polecenia, zwłaszcza gdy zależy ci na bardziej neutralnym lub uniwersalnym głosie. Na przykład „Spokojny męski narrator” może dać dokładnie to, czego potrzebujesz, bez wchodzenia w szczegóły — szczególnie jeśli nie tworzysz bardzo konkretnej postaci lub stylu. Właściwy poziom szczegółowości zależy od zastosowania. Tworzysz postać fantasy? Wirtualnego asystenta? Zmęczoną nowojorczankę po sześćdziesiątce z suchym poczuciem humoru? Im wyraźniej opiszesz to w poleceniu, tym bliższy twojej wizji będzie wynik.
Zalecany format polecenia
Aby uzyskać spójne wyniki, ułóż polecenie w tym formacie:
Przykład:
Rodzimy hiszpański, hiszpański europejski (bez cech hiszpańskiego latynoamerykańskiego). Kobieta, 35–40 lat. Dostateczna jakość. Persona: rzetelna operatorka wsparcia. Emocje: uspokajająca, uważna, pewna siebie. Gładka, naturalna barwa z łagodną intonacją, bliska i wyraźna, bez szumów. Przekazuje aktualizacje w spokojnym tempie, wyraźnie podkreślając pomocne informacje oraz emanując empatią i profesjonalizmem.
Częste błędy, których warto unikać
- Nie używaj słowa „akcent”, gdy masz na myśli intonację — może to wywołać niechciane zmiany dialektu. Zamiast tego opisz intonację, akcentowanie lub sposób mówienia.
- Unikaj słów opisujących efekty — określenia takie jak „pogłos”, „echo”, „telefon” czy „taśma” mogą obniżyć jakość wyniku.
- Jasno określ język i dialekt — zawsze podaj język i wariant regionalny w pierwszym zdaniu, aby zapobiec odchyleniom.
Jakość audio
Jakość audio oznacza klarowność, czystość i ogólną wierność generowanego głosu. Domyślnie ElevenLabs stara się tworzyć czyste, naturalnie brzmiące audio — ale jeśli projekt wymaga określonej jakości, najlepiej wyraźnie uwzględnić to w poleceniu.
Aby uzyskać wysoką jakość, dodaj do opisu głosu frazę taką jak „idealna jakość audio” lub „nagranie jakości studyjnej”. Pomaga to zadbać o maksymalną klarowność, minimalne zniekształcenia i dopracowane brzmienie.
Możesz też użyć konkretnych określeń jakości, które dają spójne wyniki:
- Dostateczna jakość
- Dobra jakość
- Bardzo dobra jakość
- Doskonała jakość
- Jakość studyjna
- Jakość nadawcza
Te określenia pomagają uzyskać najwyższą jakość audio, gdy dodasz je do polecenia.
Dodanie takich fraz może czasem ogólnie zmniejszyć dokładność polecenia, jeśli głos jest bardzo konkretny lub niszowy.
Są też kreatywne sytuacje, w których niższa jakość audio jest zamierzona, na przykład przy symulacji rozmowy telefonicznej, starej audycji radiowej lub znalezionego nagrania. W takich przypadkach całkiem pomiń określenia jakości albo wyraźnie dodaj frazy takie jak:
- „Audio niskiej jakości”
- „Słaba jakość audio”
- „Brzmi jak poczta głosowa”
- „Stłumione i odległe, jak na starym magnetofonie”
Miejsce tej frazy w poleceniu jest dowolne — może być na początku lub na końcu, a z naszych obserwacji wynika, że dobrze działa w obu miejscach.
Wiek, ton/barwa i płeć
Te trzy cechy to podstawa projektowania głosu. Kształtują jego ogólną tożsamość i wydźwięk emocjonalny. Im więcej podasz szczegółów, tym łatwiej AI stworzy głos pasujący do twojej wizji — niezależnie od tego, czy tworzysz wiarygodną postać, angażującego narratora czy wirtualnego asystenta.
Wiek
Opis postrzeganego wieku głosu pomaga określić jego dojrzałość, fakturę i energię. Używaj konkretnych określeń, aby naprowadzić AI na odpowiednią jakość głosu.
Przydatne określenia:
- „Stary mężczyzna” / „starsza kobieta”
- „Młody dorosły” / „po dwudziestce” / „tuż po trzydziestce”
- „Mężczyzna w średnim wieku” / „kobieta po czterdziestce”
- „Starszy mężczyzna” / „starsza kobieta” / „mężczyzna po osiemdziesiątce”
Ton/barwa
Odnosi się do fizycznej jakości głosu, na którą wpływają wysokość, rezonans i faktura wokalu. Różni się od emocjonalnego sposobu mówienia czy nastawienia.
Popularne określenia tonu/barwy:
- „Głęboki” / „niski”
- „Gładki” / „bogaty”
- „Chropowaty” / „ochrypły”
- „Nosowy” / „piskliwy”
- „Lekki” / „oddechowy”
- „Donośny” / „rezonujący”
- „Lekki” / „cienki”
- „Ciepły” / „łagodny”
- „Metaliczny” / „blaszany”
Płeć
Płeć często wpływa na wysokość, ciężar i wyrazistość głosu — ale możesz wyjść poza proste kategorie, opisując brzmienie zamiast tożsamości.
Przykłady:
- „Niski, zachrypnięty kobiecy głos”
- „Męski głos, głęboki i rezonujący”
- „Neutralna płeć — miękki głos o średniej wysokości”
Akcent
Akcent odgrywa kluczową rolę w określaniu regionalnej, kulturowej i emocjonalnej tożsamości głosu. Jeśli twój projekt wymaga autentycznego brzmienia — realistycznego lub stylizowanego pod postać — jasne i świadome określenie pożądanego akcentu jest niezbędne.
Dobór słów ma znaczenie — niektóre określenia zwykle dają bardziej spójne wyniki. Na przykład „wyraźny” często działa lepiej niż „silny”, gdy opisujesz stopień zauważalności akcentu. Warto testować metodą prób i błędów, więc eksperymentuj z frazami i bądź jak najbardziej kreatywny oraz opisowy.
Zachowaj ostrożność przy słowie „akcent” — jeśli masz na myśli intonację lub wzorce akcentowania, a nie regionalny dialekt, użyj tych określeń. Użycie słowa „akcent”, gdy chodzi o intonację, może wywołać niechciane zmiany dialektu.
- Przykłady jasnych poleceń dotyczących akcentu:
- „Mężczyzna w średnim wieku z wyraźnym francuskim akcentem”
- „Młoda kobieta z lekkim południowym zaśpiewem”
- „Stary mężczyzna z silnym wschodnioeuropejskim akcentem”
- „Wesoła kobieta mówiąca z wyraźnym brytyjskim akcentem”
- „Młodszy mężczyzna z lekkim irlandzkim zaśpiewem”
- „Autorytatywny głos z neutralnym amerykańskim akcentem”
- „Mężczyzna z regionalnym australijskim akcentem, wyluzowany i nosowy”
Unikaj zbyt ogólnych określeń, takich jak „zagraniczny” czy „egzotyczny” — są nieprecyzyjne i mogą dawać niespójne wyniki.
Połącz akcent z innymi cechami, takimi jak ton, wiek czy tempo, aby mieć większą kontrolę. Np. „Sarkastyczna starsza kobieta z wyraźnym nowojorskim akcentem, mówiąca powoli”.
W przypadku głosów fantasy lub fikcyjnych możesz wskazać akcenty ze świata rzeczywistego jako inspirację:
- „Elf z poprawnym, wyraźnym brytyjskim akcentem. Jest królewski i liryczny.”
- „Goblin z chropowatym wschodnioeuropejskim akcentem.”
Tempo
Tempo to szybkość i rytm, z jakimi mówi głos. To kluczowy element kształtujący osobowość, ton emocjonalny i zrozumiałość głosu. Jasne określenie tempa jest szczególnie ważne przy projektowaniu głosów do konkretnych zastosowań, takich jak storytelling, reklamy, dialogi postaci czy materiały instruktażowe.
Używaj jasnego języka, aby opisać, jak szybko lub wolno powinien mówić głos. Możesz też opisać wrażenie, jakie daje tempo — czy jest równe, nieregularne, rozważne czy lekkie. Jeśli tempo się zmienia, koniecznie wskaż gdzie i dlaczego.
Przykłady określeń tempa:
- „Mówi szybko” / „w szybkim tempie”
- „W normalnym tempie” / „mówi normalnie”
- „Mówi powoli” / „w wolnym rytmie”
- „Rozważne i miarowe tempo”
- „Przeciągane, jakby delektował się każdym słowem”
- „W pośpiesznym rytmie, jakby się spieszył”
- „Spokojne, konwersacyjne tempo”
- „Rytmiczne i muzyczne tempo”
- „Nieregularne tempo, z nagłymi przerwami i zrywami”
- „Równe tempo, ze stałymi odstępami między słowami”
- „Sposób mówienia staccato”
Tekst podglądu
Gdy napiszesz dobre polecenie dla głosu, tekst użyty do jego podglądu odgrywa kluczową rolę w tym, jak głos faktycznie zabrzmi. Tekst podglądu działa jak scenariusz wykonania — określa ton, tempo i emocjonalny sposób mówienia, do których głos będzie próbował się dopasować.
Aby uzyskać najlepsze wyniki, tekst podglądu powinien uzupełniać opis głosu, a nie mu przeczyć. Na przykład jeśli polecenie opisuje „spokojny i refleksyjny młodszy kobiecy głos z lekkim japońskim akcentem”, użycie zdania „Hej! Nie zniosę tego, co zrobiłeś z tym cholernym miejscem!!!” będzie sprzeczne z tym zamiarem. Model spróbuje pogodzić tę niezgodność, co często prowadzi do nienaturalnych lub niespójnych wyników.
Zamiast tego użyj przykładowego tekstu, który odzwierciedla zamierzoną osobowość i ton emocjonalny głosu. W powyższym przykładzie zdanie takie jak „Ostatnio jest cicho… Miałam czas pomyśleć i może właśnie tego najbardziej potrzebowałam.” wspiera polecenie i pomaga wygenerować bardziej naturalny, spójny głos.
Zauważyliśmy też, że dłuższe teksty podglądu zwykle dają stabilniejsze i bardziej wyraziste wyniki. Krótkie frazy mogą czasem brzmieć urywanie lub niespójnie, zwłaszcza podczas testowania subtelnych cech, takich jak ton czy tempo. Większy kontekst dla modelu — pełne zdanie, a nawet krótki akapit — pozwala uzyskać płynniejszą i dokładniejszą reprezentację głosu.
Parametry
Głośność
Steruje głośnością generowania Text to Preview, a docelowo także głosu po zapisaniu.
Skala wskazówek
Określa, jak ściśle model trzyma się polecenia. Wyższe wartości oznaczają większą zgodność z poleceniem, ale mogą obniżyć jakość audio, jeśli polecenie jest bardzo niszowe. Niższe wartości pozwalają modelowi na większą kreatywność kosztem dokładności polecenia. Użyj niższej wartości, jeśli ogólnie ważniejsze są wykonanie i jakość audio niż idealne odwzorowanie polecenia. Wysokie wartości są zalecane, gdy kluczowa jest dokładność akcentu lub tonu.
Atrybuty i przykłady
Eksperymentuj ze sposobem zapisu tych określeń. Na przykład „Idealna jakość audio” można też zapisać jako „jakość audio jest idealna”. Czasem daje to różne wyniki!