

Diseño de Voz
Guía para crear voces a partir de un prompt de texto.
Descripción general
Diseño de Voz ayuda a creadores a cubrir las carencias cuando la voz exacta que buscan no está disponible en la Biblioteca de Voces. Si no encuentras una voz adecuada para tu proyecto, puedes crear una. Diseño de Voz es ideal para explorar e iterar rápidamente, y la calidad del resultado puede variar según el prompt y el caso de uso. Si necesitas una calidad más uniforme y lista para producción, los Clones de Voz Profesionales (PVC) son actualmente las voces de mayor calidad de nuestra plataforma; por tanto, si hay un PVC disponible en nuestra biblioteca que se adapta a tus necesidades, te recomendamos usarlo.
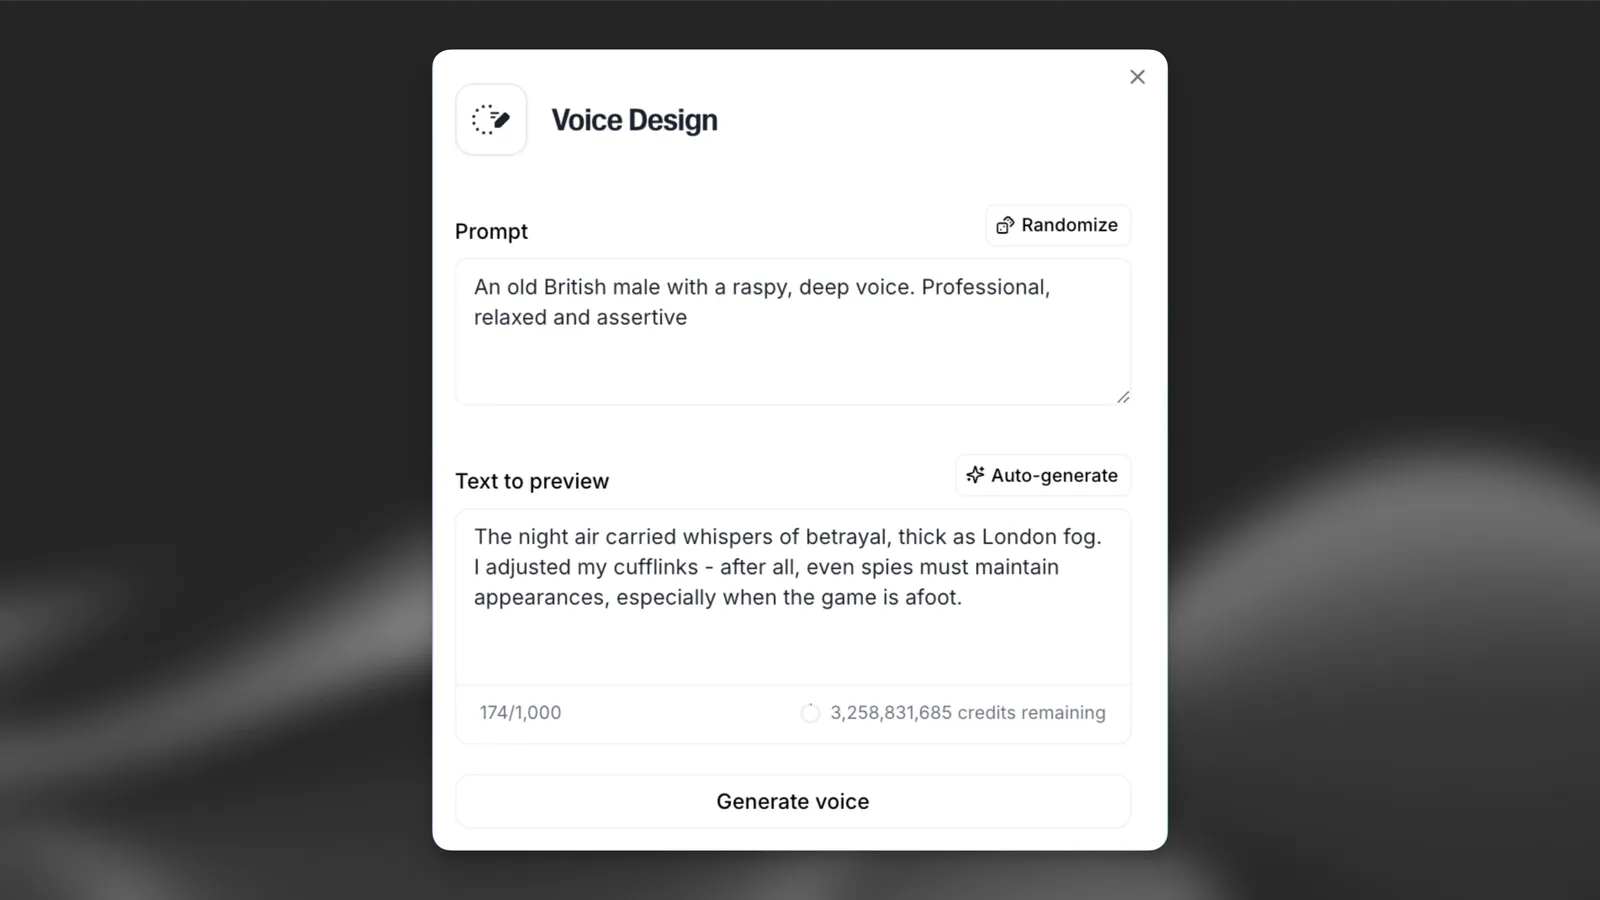
Puedes encontrar Diseño de Voz en Voces -> Mis voces -> Crear una voz -> Diseño de Voz, en la app de ElevenLabs o a través de la API.
Al pulsar generar, crearemos tres opciones de voz para ti. El único coste de usar Diseño de Voz es el número de créditos necesarios para generar el texto de vista previa, que solo se cobra una vez aunque generemos tres muestras. Puedes ver el número de caracteres que se descontarán en el cuadro de texto «Texto de vista previa».
Tras generar las voces, podrás seleccionar y guardar una de ellas, que ocupará una de tus plazas de voz.
Guía de prompting
El prompt es la base de tu voz. Le indica al modelo qué tipo de voz intentas crear, desde el acento y el tipo de personaje hasta el género y el estilo de la voz. Un prompt bien elaborado puede marcar la diferencia entre una voz genérica y una que realmente se ajusta a tu visión. En general, los prompts más descriptivos y detallados suelen dar resultados más precisos y matizados. Cuantos más detalles proporciones —como edad, género, tono, acento, ritmo, emoción o estilo—, mejor podrá el modelo interpretar y crear una voz intencionada y personalizada.
Sin embargo, los prompts cortos y sencillos también pueden funcionar, especialmente si buscas una voz más neutra o de uso general. Por ejemplo, «Un narrador tranquilo» podría darte exactamente lo que necesitas sin entrar en detalles, sobre todo si no intentas crear un personaje o estilo muy concreto. El nivel de detalle adecuado depende de tu caso de uso. ¿Estás creando un personaje de fantasía? ¿Un asistente virtual? ¿Una neoyorquina cansada de unos 60 años con un humor seco? Cuanto más claramente lo definas en el prompt, más se acercará el resultado a lo que imaginas.
Formato de prompt recomendado
Para obtener resultados uniformes, estructura el prompt con este formato:
Ejemplo:
Español nativo, español europeo (sin rasgos de español latinoamericano). Mujer, 35–40 años. Calidad aceptable. Personalidad: operadora de soporte fiable. Emoción: tranquilizadora, atenta, segura. Timbre suave y natural, con entonación delicada, proximidad directa y señal sin ruido. Ofrece actualizaciones a un ritmo relajado y enfatiza con claridad la información útil, transmitiendo empatía y profesionalidad.
Errores habituales que debes evitar
- No uses «acento» cuando te refieras a la entonación: puede provocar cambios de dialecto no deseados. Describe en su lugar los patrones de entonación, énfasis o interpretación.
- Evita palabras de efectos: términos como «reverberación», «eco», «teléfono» o «cinta» pueden afectar negativamente a la calidad del resultado.
- Sé explícito con el idioma y el dialecto: especifica siempre el idioma y la variante regional en la primera frase para evitar desviaciones.
Calidad de audio
La calidad de audio se refiere a la claridad, limpieza y fidelidad general de la voz generada. De forma predeterminada, ElevenLabs busca producir audio limpio y natural, pero si tu proyecto requiere un nivel de calidad concreto, es mejor incluirlo explícitamente en el prompt.
Para lograr resultados de alta calidad, puedes ayudar al modelo añadiendo a la descripción de voz una frase como «calidad de audio perfecta» o «grabación con calidad de estudio». Esto ayuda a garantizar que la voz se genere con la máxima claridad, una distorsión mínima y un acabado pulido.
También puedes usar descriptores de calidad específicos que ofrecen resultados uniformes:
- Calidad aceptable
- Buena calidad
- Muy buena calidad
- Calidad excelente
- Calidad de estudio
- Calidad de emisión
Estos descriptores ayudan a lograr la máxima calidad de audio cuando se incluyen en el prompt.
Incluir este tipo de frases a veces puede reducir la precisión general del prompt si la voz es muy específica o de nicho.
También puede haber casos creativos en los que se busque intencionadamente una menor calidad de audio, como al simular una llamada telefónica, una emisión de radio antigua o metraje encontrado. En esas situaciones, omite por completo los descriptores de calidad o incluye explícitamente frases como:
- «Audio de baja fidelidad»
- «Mala calidad de audio»
- «Suena como un mensaje de voz»
- «Apagado y distante, como en una grabadora de cinta antigua»
La posición de esta frase en el prompt es flexible: puede aparecer al principio o al final, y hemos comprobado que funciona bien en ambos casos.
Edad, tono/timbre y género
Estas tres características son la base del diseño de voz y definen la identidad general y la resonancia emocional de la voz. Cuanto más detalle proporciones, más fácil será para la IA producir una voz que se ajuste a tu visión creativa, ya sea para crear un personaje creíble, elaborar un narrador atractivo o diseñar un asistente virtual.
Edad
Describir la edad percibida de la voz ayuda a definir su madurez, textura vocal y energía. Usa términos específicos para guiar a la IA hacia la cualidad vocal adecuada.
Descriptores útiles:
- «Hombre mayor» / «mujer mayor»
- «Adulto joven» / «veintitantos años» / «principios de los 30»
- «Hombre de mediana edad» / «mujer de unos 40 años»
- «Hombre anciano» / «mujer de edad avanzada» / «hombre de unos 80 años»
Tono/timbre
Se refiere a la cualidad física de la voz, determinada por el tono, la resonancia y la textura vocal. Es distinto de la interpretación emocional o la actitud.
Descriptores habituales de tono/timbre:
- «Grave» / «de tono bajo»
- «Suave» / «rica»
- «Áspera» / «ronca»
- «Nasal» / «chillona»
- «Aérea» / «entrecortada»
- «Potente» / «resonante»
- «Ligera» / «fina»
- «Cálida» / «melosa»
- «Metálica» / «metalizada»
Género
El género suele influir en el tono, el peso vocal y la presencia tonal, pero puedes ir más allá de las categorías simples describiendo el sonido en lugar de la identidad.
Ejemplos:
- «Una voz femenina ronca y de tono bajo»
- «Una voz masculina, grave y resonante»
- «Un género neutro: suave y de tono medio»
Acento
El acento desempeña un papel fundamental a la hora de definir la identidad regional, cultural y emocional de una voz. Si tu proyecto depende de un sonido auténtico, ya sea realista o estilizado para un personaje, es esencial tener claro el acento deseado e indicarlo de forma deliberada.
La elección de palabras importa: ciertos términos suelen producir resultados más uniformes. Por ejemplo, «marcado» suele ofrecer mejores resultados que «fuerte» al describir lo notable que debe ser un acento. Hay mucho margen para prueba y error, y te animamos a experimentar con la redacción y a ser lo más creativo y descriptivo posible.
Ten cuidado al usar la palabra «acento»: si te refieres a patrones de entonación o énfasis en lugar de a un dialecto regional, usa esos términos. Usar «acento» cuando te refieres a la entonación puede provocar cambios de dialecto no deseados.
- Ejemplos de prompts de acento claros:
- «Un hombre de mediana edad con un marcado acento francés»
- «Una mujer joven con un ligero acento sureño estadounidense»
- «Un hombre mayor con un fuerte acento de Europa del Este»
- «Una mujer alegre que habla con un nítido acento británico»
- «Un hombre joven con una suave cadencia irlandesa»
- «Una voz autoritaria con acento estadounidense neutro»
- «Un hombre con un acento regional australiano, relajado y nasal»
Evita descriptores demasiado vagos como «extranjero» o «exótico»: son imprecisos y pueden producir resultados poco uniformes.
Combina el acento con otros rasgos, como el tono, la edad o el ritmo, para tener un mayor control. Por ejemplo: «Una mujer mayor sarcástica con un marcado acento neoyorquino que habla despacio».
Para voces de fantasía o ficción, puedes usar acentos reales como inspiración:
- «Un elfo con un marcado y correcto acento británico. Es regio y lírico.»
- «Un duende con un acento áspero de Europa del Este.»
Ritmo
El ritmo se refiere a la velocidad y la cadencia con la que habla una voz. Es un componente clave para definir la personalidad, el tono emocional y la claridad de la voz. Ser explícito sobre el ritmo es esencial, especialmente al diseñar voces para casos de uso concretos como narración, publicidad, diálogos de personajes o contenido instructivo.
Usa un lenguaje claro para describir lo rápido o despacio que debe hablar la voz. También puedes describir cómo se percibe el ritmo: si es constante, irregular, deliberado o ágil. Si el ritmo cambia, asegúrate de indicar dónde y por qué.
Ejemplos de descriptores de ritmo:
- «Habla rápido» / «a un ritmo rápido»
- «A un ritmo normal» / «habla con normalidad»
- «Habla despacio» / «con un ritmo lento»
- «Ritmo deliberado y medido»
- «Alargado, como si saboreara cada palabra»
- «Con una cadencia apresurada, como si tuviera prisa»
- «Ritmo relajado y conversacional»
- «Rítmico y musical»
- «Ritmo irregular, con pausas y aceleraciones repentinas»
- «Ritmo uniforme, con una cadencia constante entre palabras»
- «Interpretación entrecortada»
Texto de vista previa
Una vez que hayas escrito un buen prompt de voz, el texto que uses para previsualizar esa voz desempeña un papel crucial en cómo sonará realmente. El texto de vista previa actúa como un guion de interpretación: establece el tono, el ritmo y la expresión emocional que la voz intentará reproducir.
Para obtener los mejores resultados, el texto de vista previa debe complementar la descripción de voz, no contradecirla. Por ejemplo, si el prompt describe «una voz femenina joven, tranquila y reflexiva con un ligero acento japonés», usar una frase como «¡Eh! ¡¡¡No soporto lo que has hecho con el maldito sitio!!!» chocará con esa intención. El modelo intentará resolver esa incoherencia, lo que suele dar lugar a resultados poco naturales o inconsistentes.
En su lugar, usa texto de muestra que refleje la personalidad y el tono emocional previstos para la voz. Para el ejemplo anterior, algo como «Últimamente todo ha estado en calma… He tenido tiempo para pensar, y quizá era lo que más necesitaba» respalda el prompt y ayuda a generar una voz más natural y coherente.
Además, hemos comprobado que los textos de vista previa más largos suelen producir resultados más estables y expresivos. Las frases cortas a veces pueden sonar bruscas o inconsistentes, especialmente al probar cualidades sutiles como el tono o el ritmo. Dar más contexto al modelo —una frase completa o incluso un párrafo corto— le permite ofrecer una representación más fluida y precisa de la voz.
Parámetros
Volumen
Controla el volumen de la generación de Texto de vista previa y, en última instancia, de la voz una vez guardada.
Escala de guía
Determina hasta qué punto se sigue el prompt. Los valores más altos se ajustarán más estrictamente al prompt, pero podrían generar una peor calidad de audio si el prompt es muy específico, mientras que los valores más bajos permitirán que el modelo sea más creativo a costa de la precisión del prompt. Usa un valor más bajo si la interpretación y la calidad de audio son, en general, más importantes que ajustarse perfectamente al prompt. Se recomiendan valores altos cuando la precisión del acento o el tono es de máxima importancia.
Atributos y ejemplos
Experimenta con la forma de redactar estos descriptores. Por ejemplo, «Calidad de audio perfecta» también puede escribirse como «la calidad de audio es perfecta». ¡A veces pueden producir resultados diferentes!