

Stimmgestaltung
Ein Leitfaden zum Erstellen von Stimmen aus einem Text-Prompt.
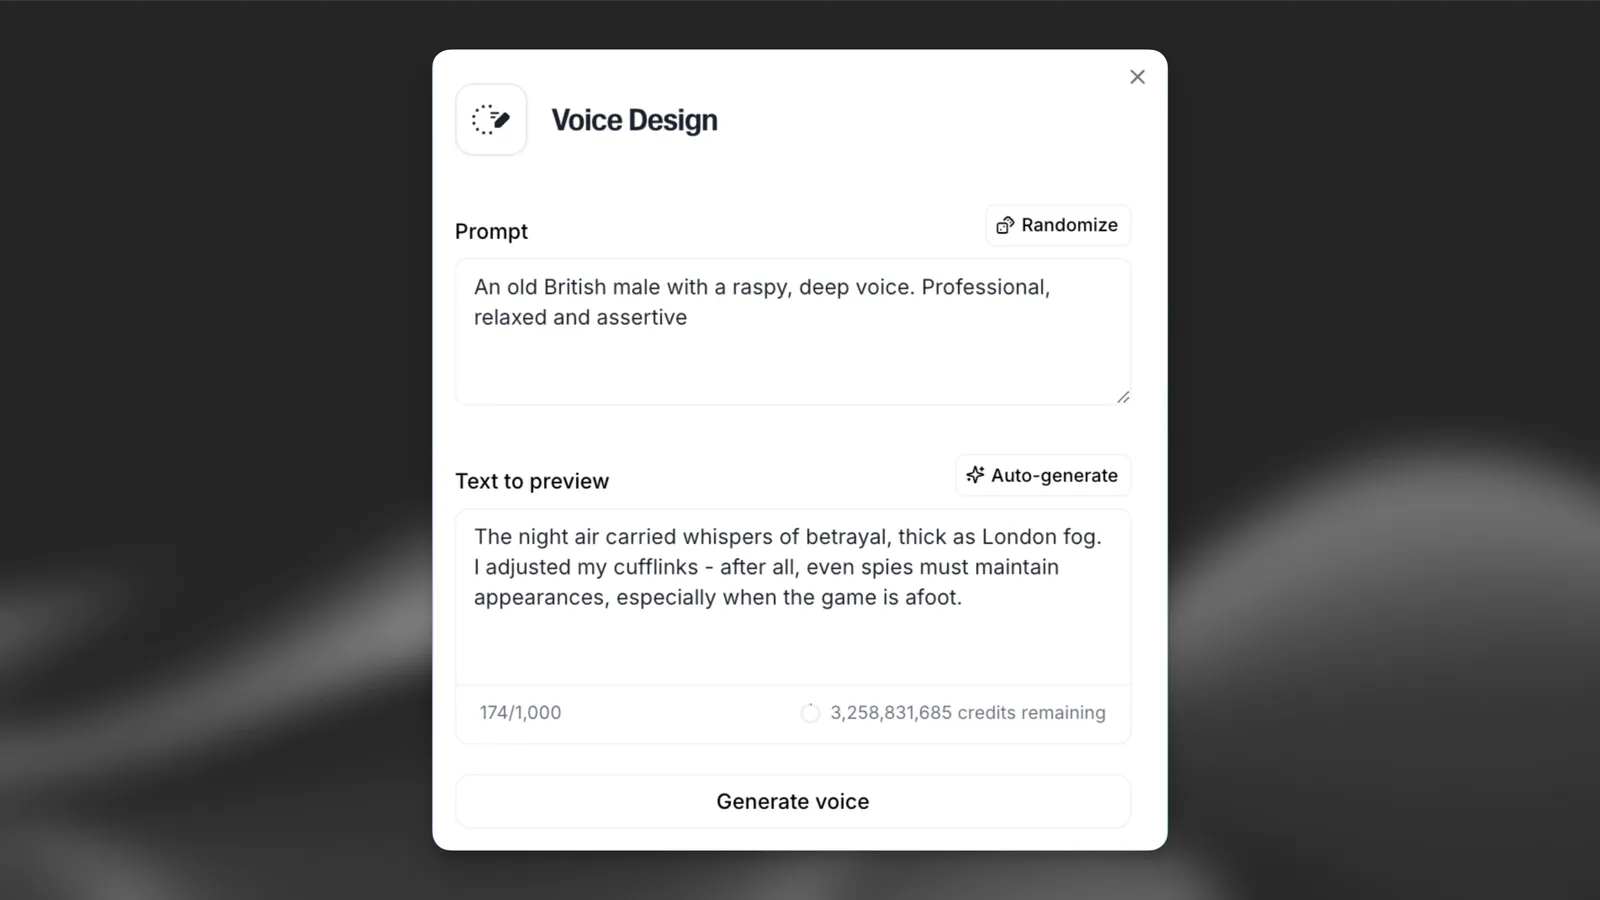
Überblick
Voice Design hilft Kreativen, Lücken zu schließen, wenn die gesuchte Stimme nicht in der Voice Library verfügbar ist. Wenn Sie keine passende Stimme für Ihr Projekt finden, können Sie eine erstellen. Voice Design eignet sich besonders für schnelle Erkundung und Iteration. Die Ausgabequalität kann je nach Prompt und Anwendungsfall variieren. Wenn Sie die konsistenteste, produktionsreife Qualität benötigen, bieten Professional Voice Clones (PVC) derzeit die hochwertigsten Stimmen auf unserer Plattform. Wenn in unserer Bibliothek ein PVC verfügbar ist, das Ihren Anforderungen entspricht, empfehlen wir daher, diesen zu verwenden.
Sie finden Voice Design in der ElevenLabs-App unter Stimmen -> Meine Stimmen -> Neue Stimme hinzufügen -> Voice Design oder über die API.
Wenn Sie auf „Generieren“ klicken, erstellen wir drei Stimmoptionen für Sie. Bei Voice Design werden Ihnen nur die Credits für die Generierung Ihres Vorschautexts berechnet – und das nur einmal, obwohl wir drei Beispiele erstellen. Die Anzahl der abgezogenen Zeichen sehen Sie im Textfeld „Text zur Vorschau“.
Nach der Generierung können Sie eine der Stimmen auswählen und speichern. Sie belegt einen Ihrer Stimm-Slots.
Leitfaden für Prompts
Der Prompt ist die Grundlage Ihrer Stimme. Er teilt dem Modell mit, welche Art von Stimme Sie erstellen möchten – vom Akzent und Charaktertyp bis zu Geschlecht und Stimmung der Stimme. Ein gut formulierter Prompt kann den Unterschied zwischen einer allgemeinen Stimme und einer Stimme ausmachen, die wirklich zu Ihrer Vision passt. Im Allgemeinen liefern detailliertere und präzisere Prompts genauere und nuanciertere Ergebnisse. Je mehr Details Sie angeben – darunter Alter, Geschlecht, Tonfall, Akzent, Sprechtempo, Emotion, Stil und mehr –, desto besser kann das Modell eine gezielte, maßgeschneiderte Stimme interpretieren und liefern.
Manchmal funktionieren jedoch auch kurze, einfache Prompts, insbesondere wenn Sie eine neutralere oder vielseitig einsetzbare Stimme anstreben. „Ein ruhiger männlicher Sprecher“ kann Ihnen beispielsweise genau das liefern, was Sie brauchen, ohne ins Detail zu gehen – besonders, wenn Sie keinen sehr spezifischen Charakter oder Stil erstellen möchten. Der richtige Detailgrad hängt von Ihrem Anwendungsfall ab. Erstellen Sie einen Fantasy-Charakter? Einen virtuellen Assistenten? Eine erschöpfte New Yorkerin in ihren 60ern mit trockenem Humor? Je klarer Sie dies in Ihrem Prompt definieren, desto näher kommt die Ausgabe Ihrer Vorstellung.
Empfohlenes Prompt-Format
Für konsistente Ergebnisse strukturieren Sie Ihren Prompt nach diesem Format:
Beispiel:
Muttersprachliches Spanisch, europäisches Spanisch (ohne Merkmale lateinamerikanischen Spanischs). Weiblich, 35–40. Akzeptable Qualität. Persona: zuverlässige Supportmitarbeiterin. Emotion: beruhigend, aufmerksam, selbstsicher. Sanfter, natürlicher Klang mit leichter Intonation, direkter Nähe und rauschfreiem Signal. Übermittelt Updates in entspanntem Tempo mit klarer Betonung hilfreicher Informationen und vermittelt Empathie und Professionalität.
Häufige Fehler vermeiden
- Verwenden Sie nicht „Akzent“, wenn Sie Intonation meinen – dies kann unerwünschte Dialektwechsel auslösen. Beschreiben Sie stattdessen Intonation, Betonung oder Sprechmuster.
- Vermeiden Sie FX-Begriffe – Begriffe wie „Hall“, „Echo“, „Telefon“ oder „Band“ können die Ausgabequalität beeinträchtigen.
- Geben Sie Sprache und Dialekt eindeutig an – nennen Sie immer im ersten Satz die Sprache und regionale Variante, um Abweichungen zu verhindern.
Audioqualität
Audioqualität bezeichnet Klarheit, Reinheit und die allgemeine Wiedergabetreue der generierten Stimme. Standardmäßig erzeugt ElevenLabs sauberes und natürlich klingendes Audio. Wenn Ihr Projekt jedoch ein bestimmtes Qualitätsniveau erfordert, sollten Sie dies ausdrücklich in Ihren Prompt aufnehmen.
Für hochwertige Ergebnisse können Sie dem Modell helfen, indem Sie Ihrer Stimmbeschreibung eine Formulierung wie „perfekte Audioqualität“ oder „Aufnahme in Studioqualität“ hinzufügen. Dies trägt dazu bei, dass die Stimme mit maximaler Klarheit, minimalen Verzerrungen und einem professionellen Finish gerendert wird.
Sie können auch konkrete Qualitätsbeschreibungen verwenden, die konsistente Ergebnisse liefern:
- Akzeptable Qualität
- Gute Qualität
- Sehr gute Qualität
- Ausgezeichnete Qualität
- Studioqualität
- Sendequalität
Diese Beschreibungen helfen, die höchste Audioqualität zu erzielen, wenn Sie sie in Ihren Prompt aufnehmen.
Solche Formulierungen können die Genauigkeit des Prompts manchmal allgemein verringern, wenn die Stimme sehr spezifisch oder nischig ist.
Es kann auch kreative Fälle geben, in denen eine geringere Audioqualität beabsichtigt ist, etwa bei der Simulation eines Telefonats, einer alten Radiosendung oder Found Footage. Lassen Sie in solchen Situationen Qualitätsbeschreibungen entweder ganz weg oder fügen Sie ausdrücklich Formulierungen hinzu wie:
- „Audio mit geringer Wiedergabetreue“
- „Schlechte Audioqualität“
- „Klingt wie eine Sprachnachricht“
- „Gedämpft und entfernt, wie auf einem alten Tonbandgerät“
Die Platzierung dieser Formulierung in Ihrem Prompt ist flexibel – sie kann am Anfang oder Ende stehen. Wir haben festgestellt, dass beides gut funktioniert.
Alter, Tonfall/Klangfarbe und Geschlecht
Diese drei Eigenschaften bilden die Grundlage der Stimmgestaltung und prägen die Gesamtidentität und emotionale Wirkung der Stimme. Je mehr Details Sie angeben, desto leichter kann die KI eine Stimme erzeugen, die Ihrer kreativen Vision entspricht – unabhängig davon, ob Sie einen glaubwürdigen Charakter entwickeln, einen überzeugenden Sprecher gestalten oder einen virtuellen Assistenten entwerfen.
Alter
Die Beschreibung des wahrgenommenen Alters einer Stimme hilft, ihre Reife, Stimmtextur und Energie zu definieren. Verwenden Sie konkrete Begriffe, um die KI zur richtigen Stimmqualität zu führen.
Nützliche Beschreibungen:
- „Alter Mann“ / „alte Frau“
- „Junger Erwachsener“ / „in den 20ern“ / „Anfang 30“
- „Mann mittleren Alters“ / „Frau in ihren 40ern“
- „Älterer Mann“ / „ältere Frau“ / „Mann in seinen 80ern“
Tonfall/Klangfarbe
Bezeichnet die physische Qualität der Stimme, die durch Tonhöhe, Resonanz und Stimmtextur geprägt wird. Sie unterscheidet sich von emotionaler Darbietung oder Haltung.
Häufige Beschreibungen für Tonfall/Klangfarbe:
- „Tief“ / „tiefe Tonlage“
- „Sanft“ / „voll“
- „Kiesig“ / „rau“
- „Näselnd“ / „schrill“
- „Luftig“ / „gehaucht“
- „Klangvoll“ / „resonant“
- „Hell“ / „dünn“
- „Warm“ / „weich“
- „Blechernd“ / „metallisch“
Geschlecht
Das Geschlecht beeinflusst häufig Tonhöhe, Stimmgewicht und klangliche Präsenz. Sie können jedoch über einfache Kategorien hinausgehen, indem Sie den Klang statt die Identität beschreiben.
Beispiele:
- „Eine tiefe, raue weibliche Stimme“
- „Eine männliche Stimme, tief und resonant“
- „Ein neutrales Geschlecht – weich und mittlere Tonlage“
Akzent
Der Akzent spielt eine entscheidende Rolle bei der Definition der regionalen, kulturellen und emotionalen Identität einer Stimme. Wenn Ihr Projekt von einem authentischen Klang abhängt – ob realistisch oder für einen Charakter stilisiert –, ist es essenziell, den gewünschten Akzent klar und gezielt zu beschreiben.
Die Wortwahl ist wichtig – bestimmte Begriffe liefern tendenziell konsistentere Ergebnisse. Beispielsweise führt „ausgeprägt“ oft zu besseren Ergebnissen als „stark“, wenn Sie beschreiben, wie deutlich ein Akzent sein soll. Hier ist viel Ausprobieren gefragt. Experimentieren Sie mit der Formulierung und seien Sie so kreativ und beschreibend wie möglich.
Seien Sie vorsichtig mit dem Wort „Akzent“ – wenn Sie Intonations- oder Betonungsmuster statt eines regionalen Dialekts meinen, verwenden Sie stattdessen diese Begriffe. Die Verwendung von „Akzent“, wenn Sie Intonation meinen, kann unerwünschte Dialektwechsel auslösen.
- Beispiele für klare Akzent-Prompts:
- „Ein Mann mittleren Alters mit ausgeprägtem französischem Akzent“
- „Eine junge Frau mit leichtem Südstaaten-Twang“
- „Ein alter Mann mit starkem osteuropäischem Akzent“
- „Eine fröhliche Frau mit klarem britischem Akzent“
- „Ein jüngerer Mann mit sanftem irischem Tonfall“
- „Eine autoritäre Stimme mit neutralem amerikanischem Akzent“
- „Ein Mann mit regionalem australischem Akzent, entspannt und näselnd“
Vermeiden Sie zu vage Beschreibungen wie „fremd“ oder „exotisch“ – sie sind ungenau und können inkonsistente Ergebnisse erzeugen.
Kombinieren Sie den Akzent mit anderen Merkmalen wie Tonfall, Alter oder Sprechtempo, um mehr Kontrolle zu erhalten. Zum Beispiel: „Eine sarkastische alte Frau mit ausgeprägtem New-York-Akzent, die langsam spricht.“
Für Fantasy- oder fiktive Stimmen können Sie Akzente aus der realen Welt als Inspiration vorschlagen:
- „Ein Elf mit einem gepflegten, ausgeprägten britischen Akzent. Er ist königlich und lyrisch.“
- „Ein Goblin mit rauem osteuropäischem Akzent.“
Sprechtempo
Das Sprechtempo bezeichnet die Geschwindigkeit und den Rhythmus, mit dem eine Stimme spricht. Es ist ein wichtiger Bestandteil bei der Gestaltung von Persönlichkeit, emotionalem Ton und Klarheit einer Stimme. Eine eindeutige Angabe des Sprechtempos ist besonders wichtig, wenn Sie Stimmen für spezifische Anwendungsfälle wie Storytelling, Werbung, Charakterdialoge oder Lerninhalte erstellen.
Verwenden Sie klare Sprache, um zu beschreiben, wie schnell oder langsam die Stimme sprechen soll. Sie können auch beschreiben, wie sich das Tempo anfühlt – ob gleichmäßig, unregelmäßig, bewusst oder locker. Wenn sich das Tempo verändert, geben Sie an, wo und warum.
Beispiele für Beschreibungen des Sprechtempos:
- „Spricht schnell“ / „in schnellem Tempo“
- „In normalem Tempo“ / „spricht normal“
- „Spricht langsam“ / „mit langsamem Rhythmus“
- „Bedachtes und gemessenes Tempo“
- „Gedehnt, als würde jedes Wort ausgekostet“
- „Mit hastigem Rhythmus, als hätte die Person es eilig“
- „Entspanntes, gesprächiges Tempo“
- „Rhythmisches und musikalisches Tempo“
- „Unregelmäßiges Tempo mit abrupten Pausen und Ausbrüchen“
- „Gleichmäßiges Tempo mit konsistentem Abstand zwischen den Wörtern“
- „Stakkatoartige Darbietung“
Text zur Vorschau
Sobald Sie einen aussagekräftigen Stimm-Prompt geschrieben haben, spielt der Text, den Sie zur Vorschau dieser Stimme verwenden, eine entscheidende Rolle für ihren tatsächlichen Klang. Der Vorschautext funktioniert wie ein Darbietungsskript – er bestimmt Ton, Tempo und emotionale Darbietung, an denen sich die Stimme orientieren soll.
Für die besten Ergebnisse sollte Ihr Vorschautext die Stimmbeschreibung ergänzen, nicht ihr widersprechen. Wenn Ihr Prompt beispielsweise eine „ruhige und nachdenkliche jüngere weibliche Stimme mit leichtem japanischen Akzent“ beschreibt, steht ein Satz wie „Hey! Ich kann nicht ausstehen, was du mit diesem verdammten Ort gemacht hast!!!“ im Widerspruch zu dieser Absicht. Das Modell wird versuchen, diesen Widerspruch aufzulösen, was oft zu unnatürlichen oder inkonsistenten Ergebnissen führt.
Verwenden Sie stattdessen Beispieltext, der die beabsichtigte Persönlichkeit und den emotionalen Ton der Stimme widerspiegelt. Für das obige Beispiel unterstützt etwas wie „In letzter Zeit war es ruhig … Ich hatte Zeit nachzudenken, und vielleicht war das genau das, was ich am meisten brauchte.“ den Prompt und hilft, eine natürlichere, stimmigere Stimme zu generieren.
Außerdem haben wir festgestellt, dass längere Vorschautexte tendenziell stabilere und ausdrucksstärkere Ergebnisse liefern. Kurze Phrasen können manchmal abrupt oder inkonsistent klingen, besonders wenn Sie subtile Eigenschaften wie Tonfall oder Tempo testen. Mehr Kontext – ein vollständiger Satz oder sogar ein kurzer Absatz – ermöglicht dem Modell eine flüssigere und genauere Darstellung der Stimme.
Parameter
Lautstärke
Steuert die Lautstärke der Text-to-Preview-Generierung und letztlich der gespeicherten Stimme.
Guidance Scale
Bestimmt, wie genau der Prompt befolgt wird. Höhere Werte halten sich strenger an den Prompt, können jedoch zu schlechterer Audioqualität führen, wenn der Prompt sehr nischig ist. Niedrigere Werte erlauben dem Modell mehr Kreativität, gehen aber zulasten der Prompt-Genauigkeit. Verwenden Sie einen niedrigeren Wert, wenn Darbietung und Audioqualität generell wichtiger sind als die perfekte Umsetzung des Prompts. Hohe Werte werden empfohlen, wenn die Genauigkeit von Akzent oder Tonfall besonders wichtig ist.
Attribute und Beispiele
Experimentieren Sie mit der Formulierung dieser Beschreibungen. „Perfekte Audioqualität“ kann beispielsweise auch als „Die Audioqualität ist perfekt“ formuliert werden. Das kann manchmal unterschiedliche Ergebnisse liefern.