Speech to Text

Anleitung zum Transkribieren von Audio mit ElevenLabs
Speech-to-Text-Produktfunktion

Überblick

Mit Speech to Text können Sie gesprochene Audiodateien mit modernster Genauigkeit in Text transkribieren. Dank automatischer Spracherkennung können Sie Audio in zahlreichen Sprachen transkribieren.

Transkript erstellen

1

Audio hochladen

Navigieren Sie im ElevenLabs-Dashboard zur Seite Speech to Text und klicken Sie auf „Dateien transkribieren“. Im Dialog können Sie eine Audio- oder Videodatei zur Transkription hochladen.
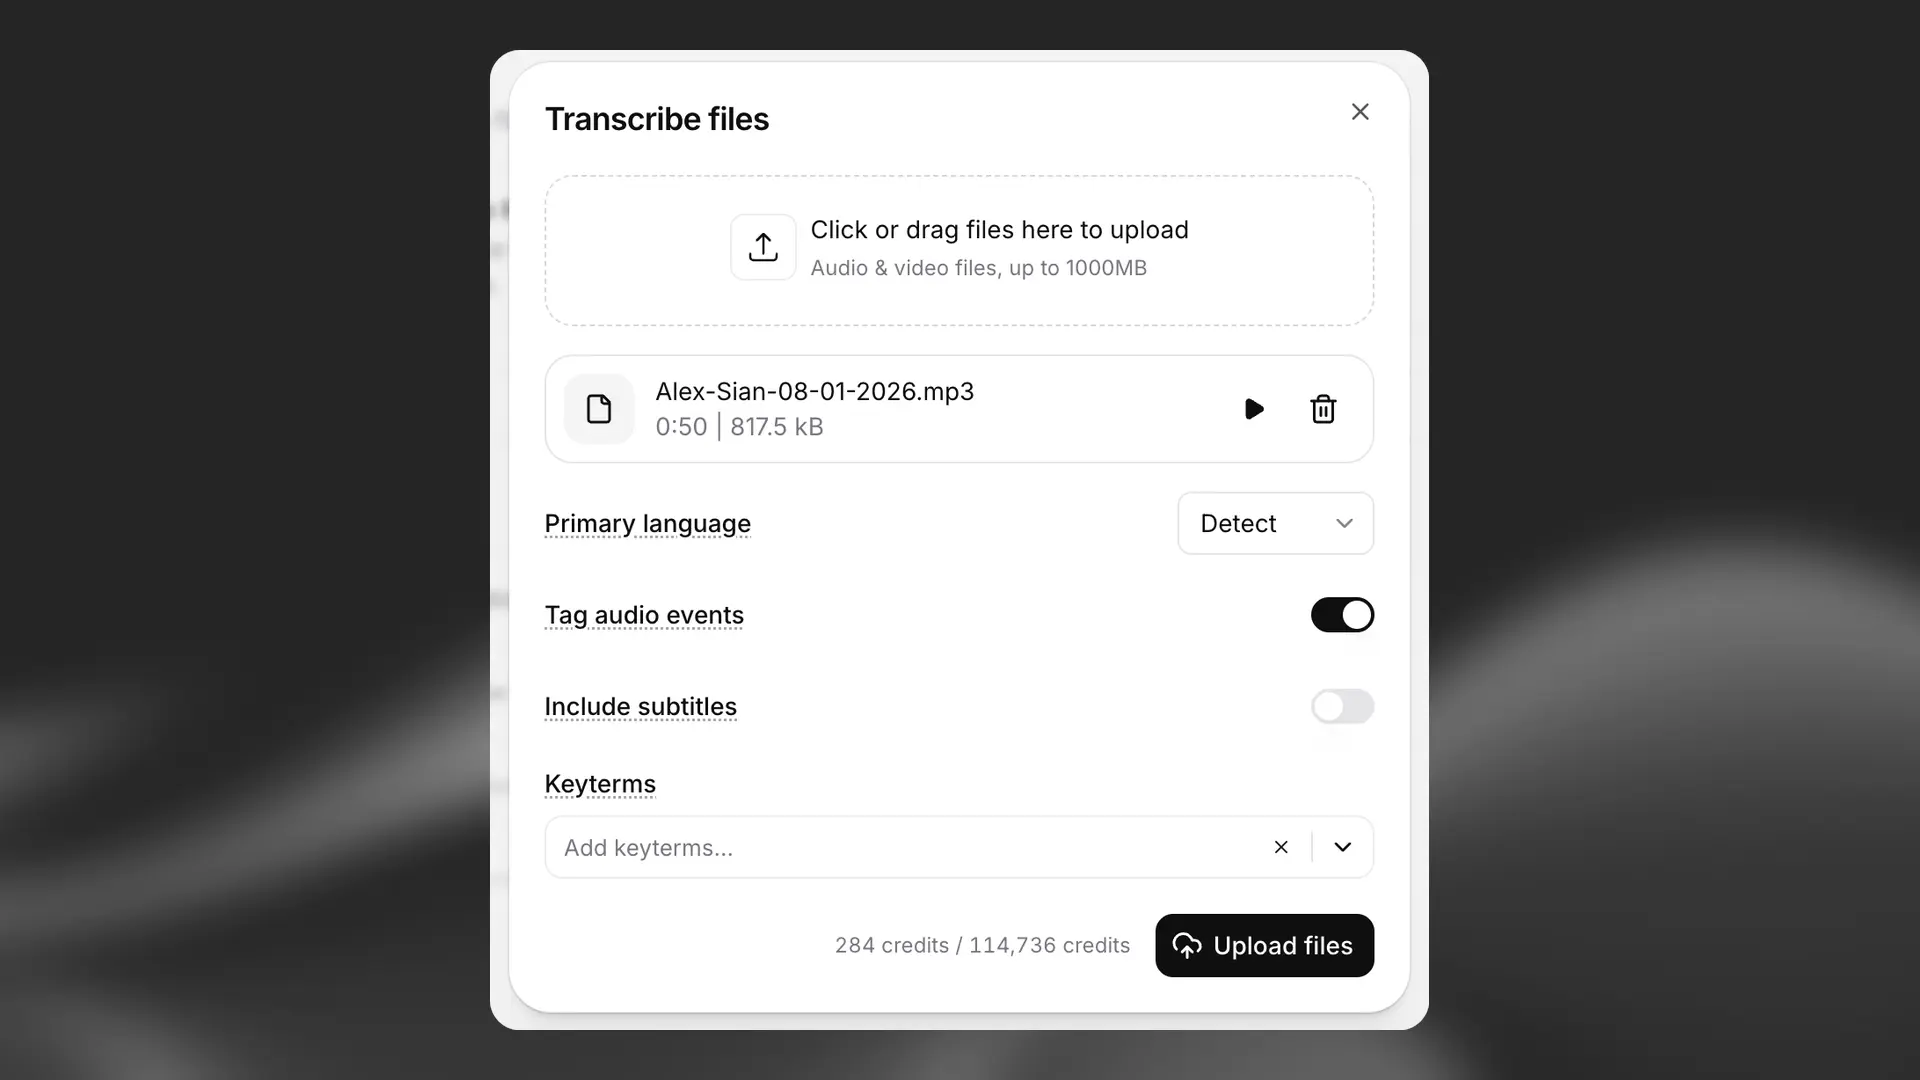
Speech-to-Text-Upload

2

Optionen auswählen

  • Wählen Sie die primäre Sprache des Audios aus, wenn Sie sie kennen. Sie können die Einstellung auf „Erkennen“ lassen; alle Sprachen im Audio werden dann automatisch erkannt.

  • Wählen Sie mit dem Umschalter „Audioereignisse taggen“, ob Audioereignisse wie Lachen oder Applaus markiert werden sollen.

  • Mit Keyterm-Prompting können Sie bis zu 1.000 Wörter oder Ausdrücke hinzufügen, damit das Modell diese bevorzugt transkribiert. Das ist hilfreich für bestimmte Wörter oder Sätze, die im Audio nicht häufig vorkommen, etwa Produktnamen, Namen oder andere spezifische Begriffe.

Wenn Sie bereit sind, klicken Sie zum Senden auf „Dateien hochladen“.

3

Ergebnisse anzeigen

Klicken Sie im mittleren Bereich auf den Namen der hochgeladenen Audiodatei, um die Ergebnisse anzuzeigen. Sie können auf ein Wort klicken, um die Audiowiedergabe an dieser Stelle zu starten.

Klicken Sie oben rechts auf „Exportieren“, um die Ergebnisse in verschiedenen Formaten herunterzuladen.

Transkript-Editor

Nachdem Sie ein Transkript erstellt haben, können Sie es in unserem Transkript-Editor bearbeiten. Erfahren Sie in dieser Anleitung mehr darüber.

FAQ

Ja, das Tool unterstützt das Hochladen von Audio- und Videodateien. Die maximale Dateigröße beträgt für beide 3 GB.

Sprecher umbenennen

Ja, Sie können Sprecher umbenennen, indem Sie neben der Bezeichnung „Sprecher“ auf „Bearbeiten“ klicken.

Speech to Text wandelt gesprochene Audios in geschriebenen Text um. Bei ElevenLabs heißt unser Speech-to-Text-Modell Scribe. Damit können Sie Sprache in über 90 Sprachen präzise transkribieren und Audio einfach in lesbaren, durchsuchbaren Text umwandeln.

Hauptfunktionen von Scribe

  • Branchenführende Genauigkeit mit 98 % Genauigkeit in wichtigen Sprachen wie Englisch, Französisch, Italienisch, Portugiesisch, Spanisch und Deutsch.
  • Präzise Zeitstempel auf Wortebene, damit Sie genau sehen, wann jedes Wort gesprochen wird.
  • Intelligente Sprecherdiarisierung, die verschiedene Sprecher automatisch erkennt und voneinander trennt.
  • Dynamische Audio-Tagging zur Erkennung nichtsprachlicher Geräusche.
  • Unterstützung für bis zu 32 Sprecher bei hoher Genauigkeit.

Neu in Scribe v2

Scribe v2 erweitert das Kernmodell um zusätzliche Funktionen für anspruchsvollere Anwendungsfälle.

  • Keyterm-Prompting. Sie können bis zu 100 Wörter oder Ausdrücke angeben, um das Modell bei der korrekten Transkription wichtiger Begriffe zu unterstützen. Die Verwendung von Keyterm-Prompting erhöht die Kosten um 20 %.
  • Entitätserkennung. Sie können bestimmte Informationskategorien für die Erkennung im Transkript auswählen, etwa Kreditkartennummern, Namen oder medizinische Erkrankungen. Die Entitätserkennung ist nur über die API verfügbar und erhöht die Kosten um 30 %.
  • Intelligente Unterstützung mehrerer Sprachen. Sie können Audio mit mehreren Sprachen übermitteln, und Scribe v2 erkennt und transkribiert jede Sprache automatisch korrekt.
  • Verbesserte Stabilität. Scribe v2 verarbeitet Pausen, Tonwechsel und lange Stille ohne Unterbrechungen oder Genauigkeitsverlust.

Welche Version sollten Sie verwenden?

Wir empfehlen Scribe v2, wenn Transkriptionen mit hoher Genauigkeit erforderlich sind. Es ist über unsere Website und API verfügbar. Bei der Nutzung von Speech to Text über unsere Website ist Scribe v2 das Standardmodell.

Für medizinische und klinische Audios verwenden Sie Scribe v2 Medical (scribe_v2_medical) über dieselbe API. Die Abrechnung erfolgt zum selben Tarif wie für Scribe v2.

Für Echtzeit-Anwendungsfälle empfehlen wir Scribe v2 Realtime, verfügbar über ElevenAgents und per API.

Weitere Details finden Sie in unserer Speech-to-Text-Dokumentation.

Speech to Text unterstützt über 90 Sprachen. 

Eine vollständige Übersicht der unterstützten Sprachen finden Sie im Abschnitt Sprachunterstützung unserer Speech-to-Text-Dokumentation.

Das Parallelitätslimit (gleichzeitig parallel ausgeführte Anfragen) hängt von Ihrem Abonnement und davon ab, ob Sie Speech to Text oder Echtzeit-Spracherkennung verwenden.

Nachfolgend finden Sie die aktuellen Parallelitätslimits für Speech to Text.

TarifSpeech to Text-ParallelitätslimitEchtzeit-Spracherkennung-Parallelitätslimit
Kostenlos86
Starter129
Creator2015
Pro4030
Scale6045
Business6045
EnterpriseErhöhtErhöht

Wenn Sie eine höhere Anzahl gleichzeitiger Anfragen benötigen, kontaktieren Sie bitte direkt unsere Enterprise-Abteilung über diese Webseite. Wir besprechen gerne einen maßgeschneiderten Tarif, der Ihren spezifischen Anforderungen entspricht.

No results