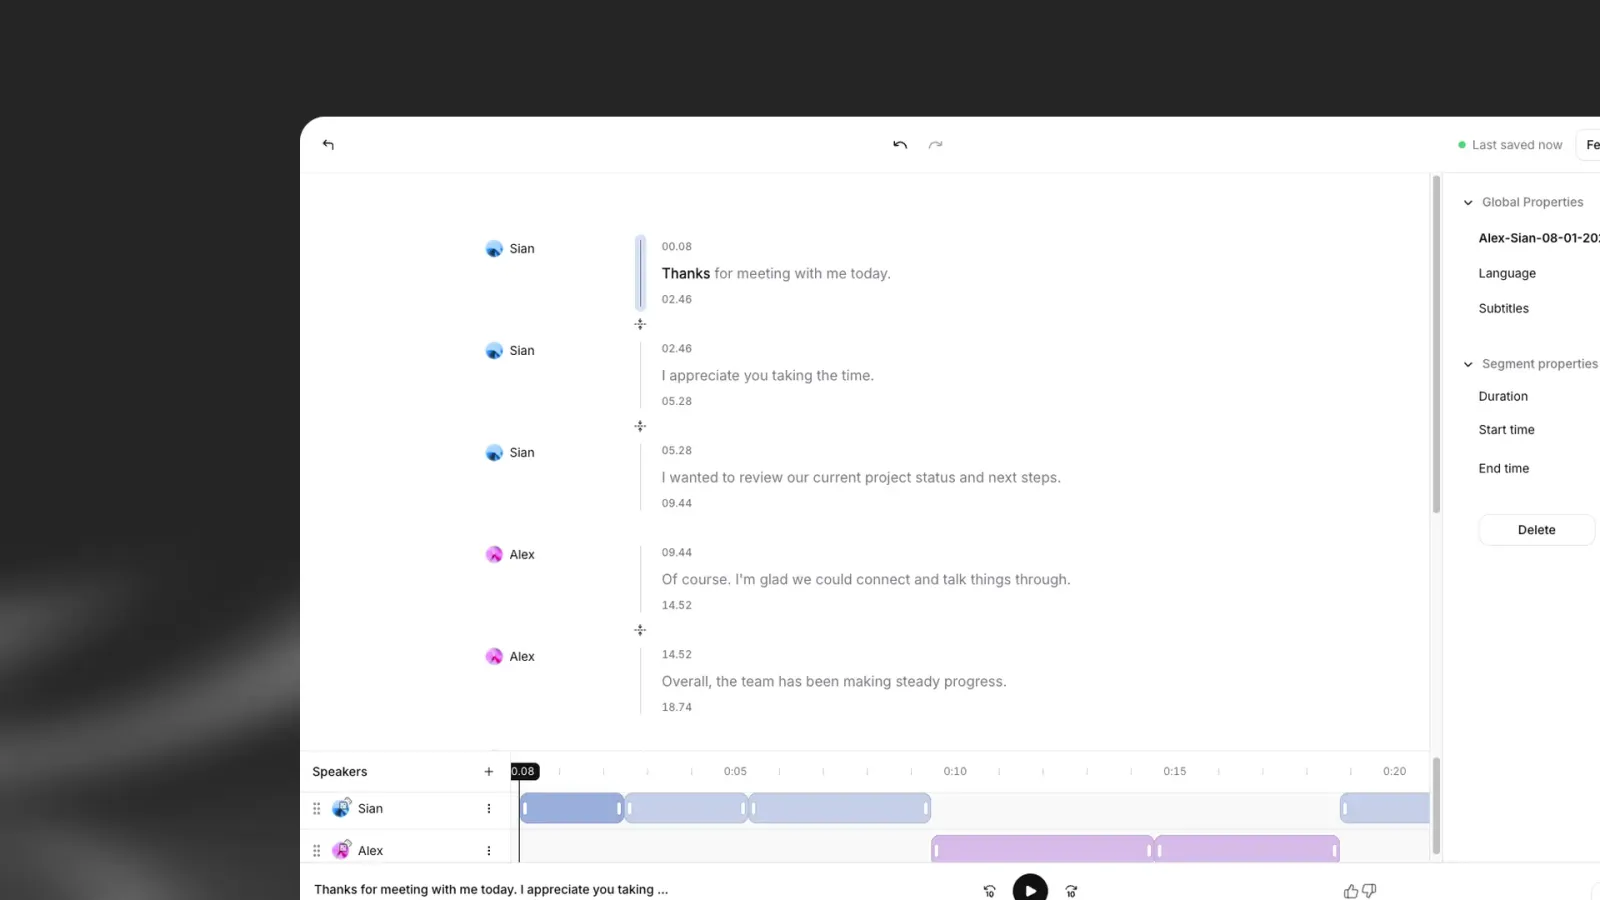
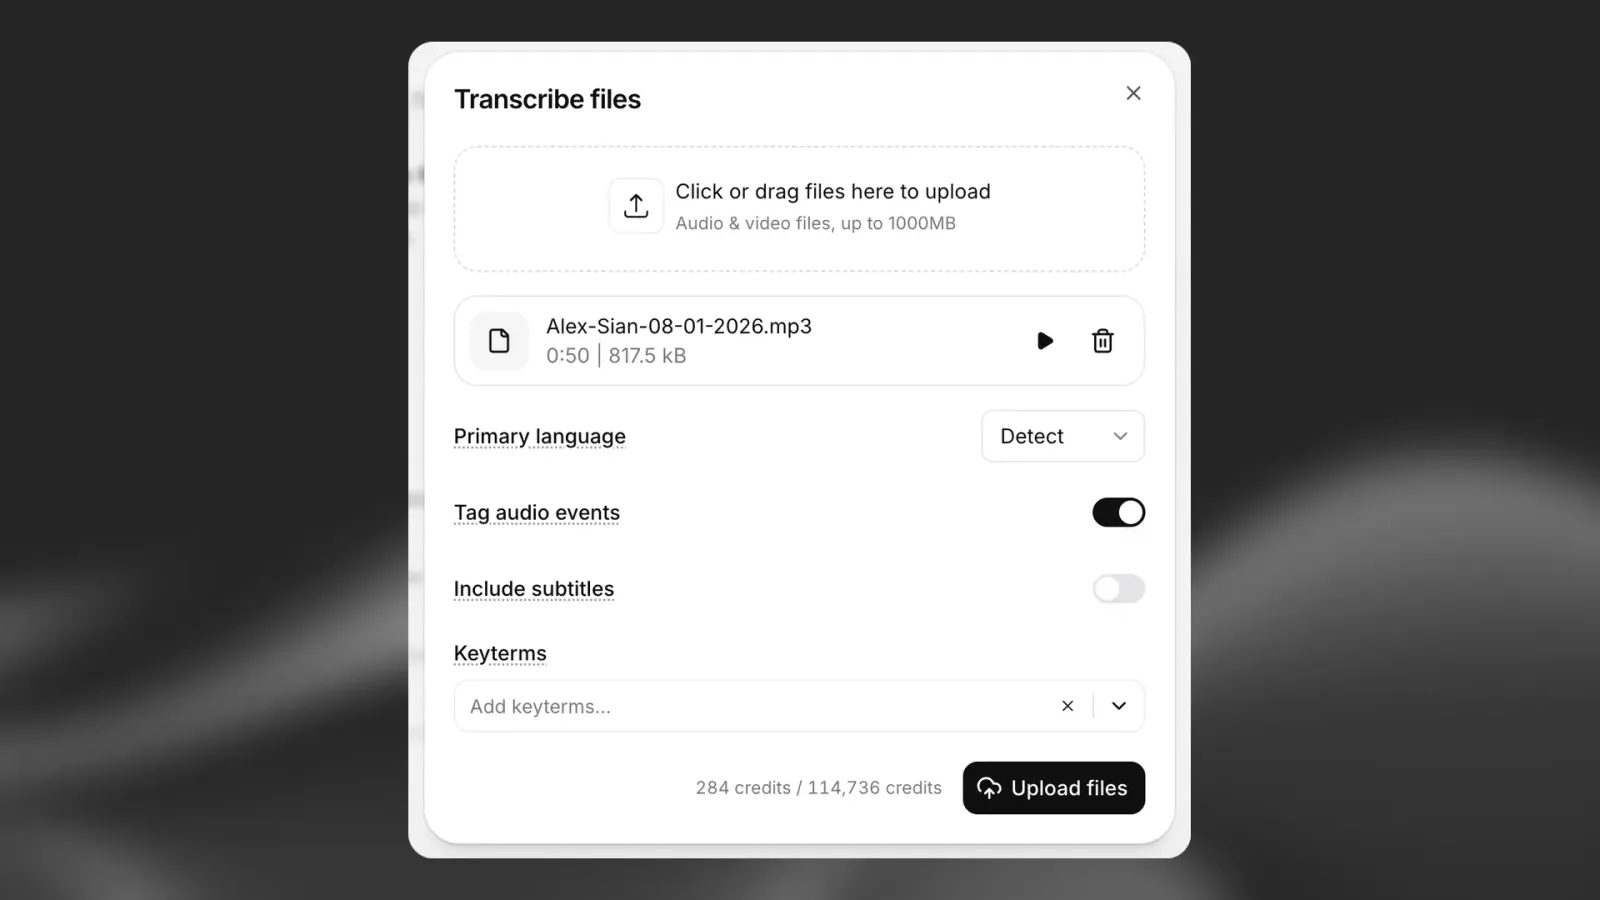
Speech to Text zamienia mówione audio na tekst. W ElevenLabs naszym modelem Speech to Text jest Scribe. Umożliwia dokładną transkrypcję mowy w ponad 90 językach, dzięki czemu łatwo zamienisz audio w czytelny tekst z możliwością wyszukiwania.
Najważniejsze funkcje Scribe
- Wiodąca w branży dokładność: 98% w głównych językach, takich jak angielski, francuski, włoski, portugalski, hiszpański i niemiecki.
- Precyzyjne znaczniki czasu na poziomie słów, dzięki którym dokładnie wiesz, kiedy padło każde słowo.
- Inteligentne rozpoznawanie mówców, które automatycznie identyfikuje i rozdziela różne osoby mówiące.
- Dynamiczne tagowanie audio do wykrywania dźwięków innych niż mowa.
- Obsługa do 32 mówców przy zachowaniu wysokiej dokładności.
Co nowego w Scribe v3
Scribe v3 to nasz najdokładniejszy model Speech to Text. W porównaniu z Scribe v2 oferuje:
- Mniej błędów transkrypcji. W teście FLEURS obejmującym 102 języki Scribe
v3 popełnia o 27% mniej błędów słów niż Scribe v2.
- Dokładniejsze etykiety mówców w audio z wieloma osobami mówiącymi.
- Formatowanie liczb. Przez API możesz wybrać, czy liczby są zapisywane
cyframi, czy słownie.
- Języki dodatkowe. Przez API możesz wskazać inne języki, których spodziewasz się
w audio, aby zwiększyć dokładność w nagraniach wielojęzycznych.
Scribe v3 zachowuje możliwości wprowadzone w Scribe v2:
- Podpowiedzi z kluczowymi terminami. Możesz podać do 100 słów lub fraz, aby pomóc modelowi
poprawnie transkrybować ważne terminy. Użycie tej funkcji zwiększa koszt o 20%.
- Wykrywanie encji. Możesz wybrać konkretne kategorie informacji do wykrywania w
transkrypcji, np. numery kart kredytowych, imiona i nazwiska lub schorzenia. Wykrywanie encji jest
dostępne tylko przez API i zwiększa koszt o 30%.
- Inteligentna obsługa wielu języków. Możesz przesłać audio zawierające wiele języków,
a Scribe automatycznie wykryje i poprawnie transkrybuje każdy z nich.
- Większa stabilność. Scribe radzi sobie z pauzami, zmianami tonu i długą ciszą
bez przerywania działania ani utraty dokładności.
Której wersji użyć?
Gdy potrzebujesz bardzo dokładnej transkrypcji, polecamy Scribe v3 (scribe_v3). Jest dostępny na naszej stronie i przez API. Przy korzystaniu ze Speech to Text na naszej stronie Scribe v3 jest domyślnym modelem. Obszary robocze w środowiskach rezydencji danych używają Scribe v2.
Do nagrań medycznych i klinicznych użyj Scribe v2 Medical (scribe_v2_medical) przez to samo API. Jest rozliczany według tej samej stawki co Scribe v2.
Do zastosowań w czasie rzeczywistym polecamy Scribe v3 Live (scribe_v3_live), dostępny przez realtime API. ElevenAgents domyślnie używa Scribe v2 Realtime.
Więcej informacji znajdziesz w naszej dokumentacji Speech to Text.