Vai alla navigazione

Speech to Text

Una guida per trascrivere l'audio con ElevenLabs
Funzionalità del prodotto Text to Speech

Panoramica

Con Speech to Text, puoi trascrivere l’audio parlato in testo con una precisione all’avanguardia. Grazie al rilevamento automatico della lingua, puoi trascrivere audio in moltissime lingue.

Creare una trascrizione

1

Carica l'audio

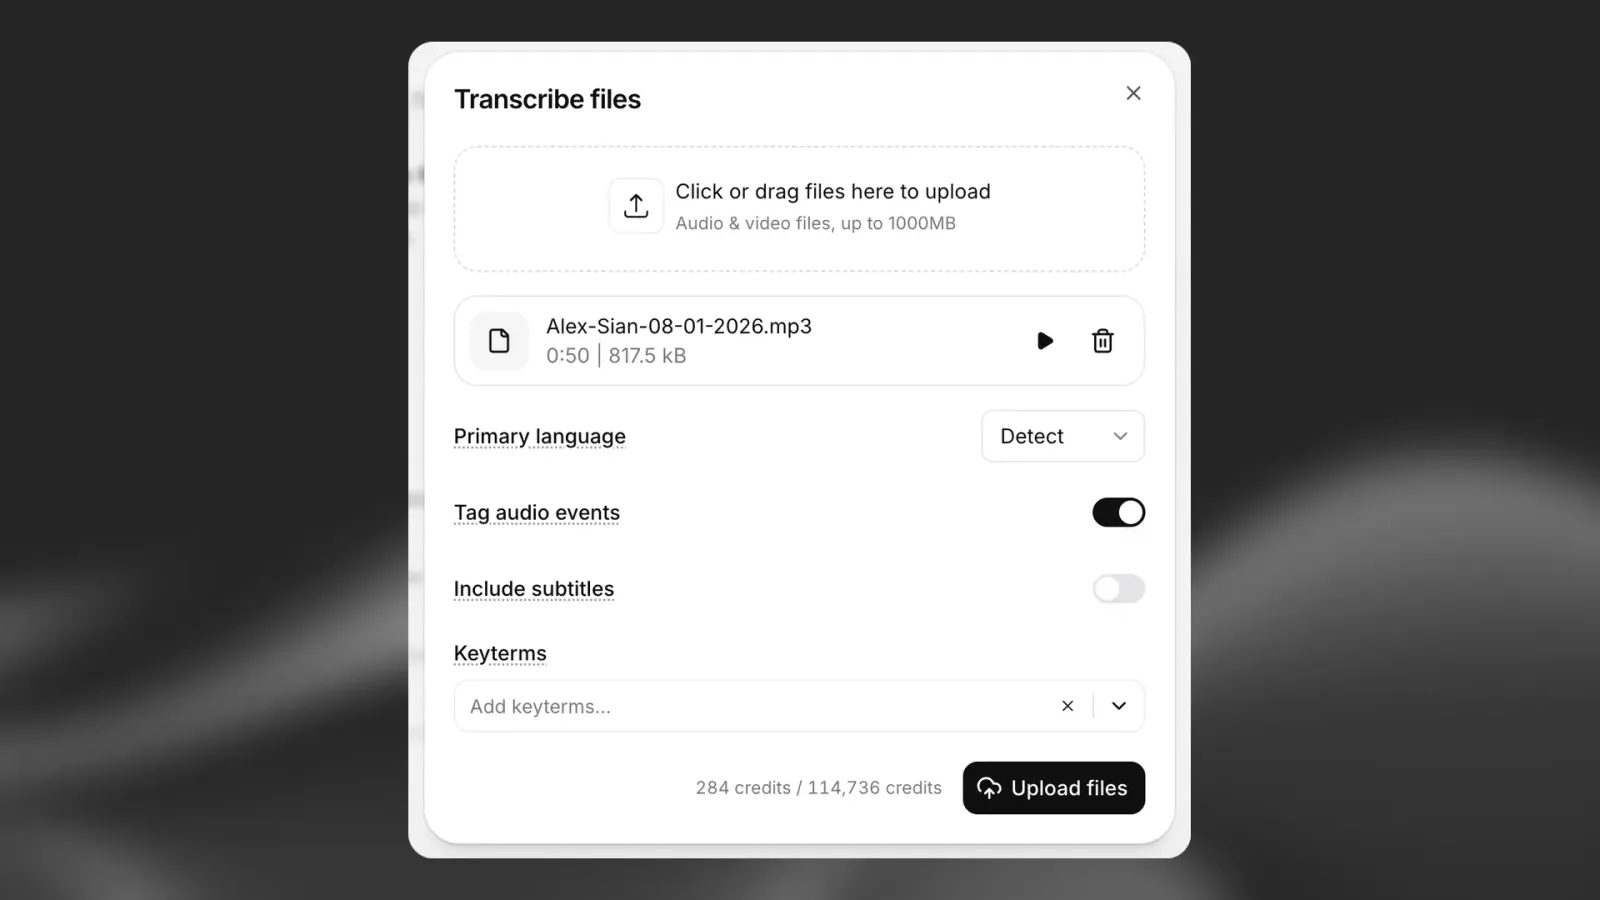
Nella dashboard di ElevenLabs, vai alla pagina Speech to Text e fai clic sul pulsante “Trascrivi file”. Dalla finestra modale puoi caricare un file audio o video da trascrivere.

Caricamento Speech to Text

2

Seleziona le opzioni

  • Se la conosci, seleziona la lingua principale dell’audio. Puoi lasciare l’impostazione su “Rileva” e le lingue presenti nell’audio verranno rilevate automaticamente.

  • Scegli se vuoi contrassegnare eventi audio come risate o applausi usando l’interruttore “Contrassegna eventi audio”.

  • I prompt per termini chiave ti consentono di aggiungere fino a 1000 parole o frasi per orientare il modello verso la loro trascrizione. È utile per trascrivere parole o frasi specifiche non comuni nell’audio, come nomi di prodotti, nomi propri o altri termini specifici.

Quando sei pronto, fai clic sul pulsante “Carica file” per inviare.

3

Visualizza i risultati

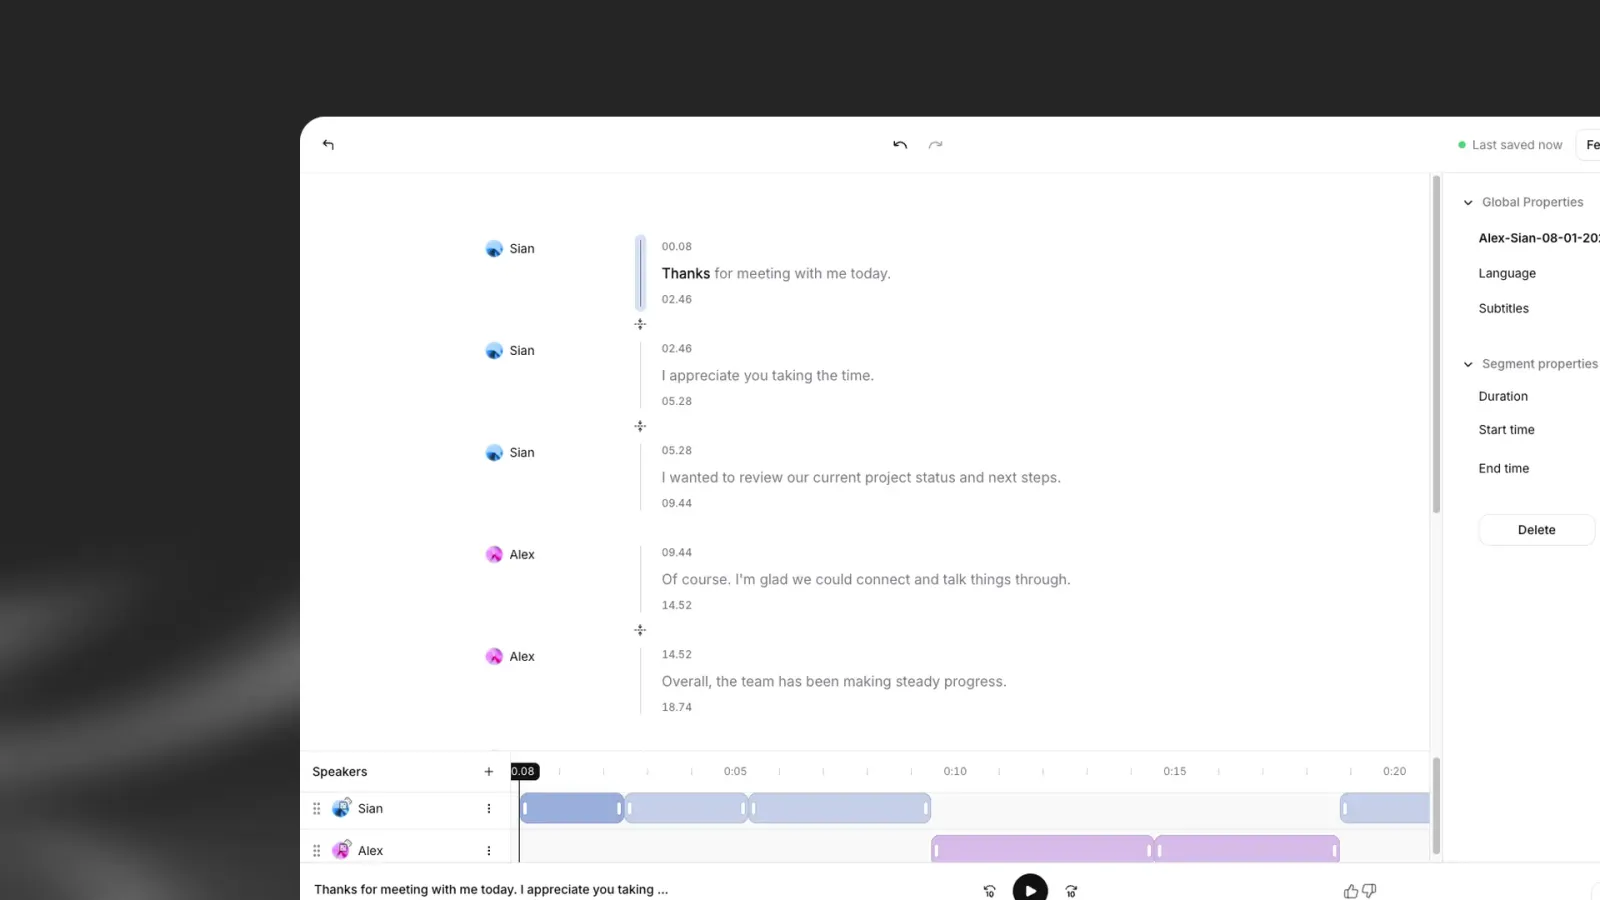
Fai clic sul nome del file audio che hai caricato nel riquadro centrale per visualizzare i risultati. Puoi fare clic su una parola per avviare la riproduzione dell’audio da quel punto.

Fai clic sul pulsante “Esporta” in alto a destra per scaricare i risultati in vari formati.

Editor della trascrizione

Dopo aver creato una trascrizione, puoi modificarla nel nostro Editor della trascrizione. Scopri di più in questa guida.

FAQ

Sì, lo strumento supporta il caricamento di file audio e video. La dimensione massima del file per entrambi è 3 GB.

Rinominare gli speaker

Sì, puoi rinominare gli speaker facendo clic sul pulsante “modifica” accanto all’etichetta “Speaker”.

Speech to Text converte l’audio parlato in testo scritto. In ElevenLabs, il nostro modello Speech to Text è Scribe. Ti consente di trascrivere accuratamente il parlato in oltre 90 lingue, trasformando facilmente l’audio in testo leggibile e ricercabile.

Funzionalità principali di Scribe

  • Precisione leader del settore, con un’accuratezza del 98% nelle principali lingue come inglese, francese, italiano, portoghese, spagnolo e tedesco.
  • Timestamp precisi a livello di parola, così puoi vedere esattamente quando viene pronunciata ogni parola.
  • Diarizzazione intelligente dei parlanti, che identifica e separa automaticamente i diversi parlanti.
  • Tag audio dinamici per rilevare suoni non vocali.
  • Supporto per fino a 32 parlanti mantenendo un’elevata precisione.

Novità di Scribe v3

Scribe v3 è il nostro modello Speech to Text più accurato. Rispetto a Scribe v2, offre:

  • Meno errori di trascrizione. Nel benchmark FLEURS su 102 lingue, Scribe v3 commette il 27% di errori di parola in meno rispetto a Scribe v2.
  • Etichette dei parlanti più accurate nell’audio con più parlanti.
  • Formattazione dei numeri. Tramite l’API, puoi scegliere se i numeri vengono scritti come cifre o in lettere.
  • Lingue secondarie. Tramite l’API, puoi elencare altre lingue previste nell’audio per migliorare la precisione negli audio multilingue.

Scribe v3 mantiene le funzionalità introdotte in Scribe v2:

  • Prompting dei termini chiave. Puoi fornire fino a 100 parole o frasi per guidare il modello nella corretta trascrizione dei termini importanti. L’uso del prompting dei termini chiave aumenta il costo del 20%.
  • Rilevamento delle entità. Puoi scegliere categorie specifiche di informazioni da rilevare nella trascrizione, come numeri di carte di credito, nomi o condizioni mediche. Il rilevamento delle entità è disponibile solo tramite API ed è incluso gratuitamente.
  • Supporto intelligente per più lingue. Puoi inviare audio che contiene più lingue, e Scribe rileverà e trascriverà automaticamente ciascuna di esse correttamente.
  • Stabilità migliorata. Scribe gestisce pause, cambiamenti di tono e lunghi silenzi senza interrompersi né perdere precisione.

Quale versione dovresti usare?

Ti consigliamo Scribe v3 (scribe_v3) quando è necessaria una trascrizione ad alta precisione. È disponibile tramite il nostro sito web e le API. Quando usi Speech to Text tramite il nostro sito web, Scribe v3 è il modello predefinito. I workspace negli ambienti di residenza dei dati utilizzano Scribe v2.

Per audio medici e clinici, usa Scribe v2 Medical (scribe_v2_medical) tramite la stessa API. Viene fatturato alla stessa tariffa di Scribe v2.

Per casi d’uso in tempo reale, ti consigliamo Scribe v3 Live (scribe_v3_live), disponibile tramite l’API in tempo reale. ElevenAgents utilizza Scribe v2 Realtime per impostazione predefinita.

Per maggiori dettagli, consulta la nostra documentazione di Speech to Text.

Speech to Text supporta oltre 90 lingue. 

Per un elenco completo delle lingue supportate, consulta la sezione sul supporto linguistico della nostra documentazione Speech to Text.

Il limite di concorrenza (richieste simultanee eseguite in parallelo) dipende dal tuo abbonamento e dal fatto che tu stia usando Speech to Text o Trascrizione vocale in tempo reale.

Di seguito sono riportati gli attuali limiti di concorrenza per Speech to Text.

PianoLimite di concorrenza Speech to TextLimite di concorrenza Trascrizione vocale in tempo reale
Free86
Starter129
Creator2015
Pro4030
Scale6045
Business6045
EnterpriseAumentatoAumentato

Se hai bisogno di un numero maggiore di richieste simultanee, contatta direttamente il nostro reparto Enterprise tramite questa pagina web. Saremo lieti di discutere un piano su misura che soddisfi le tue esigenze specifiche.

Per stimare il limite di concorrenza necessario per il tuo traffico, usa lo stimatore di concorrenza.

No results