

Progettazione della voce
Panoramica
Voice Design aiuta i creator a colmare le lacune quando la voce esatta che cercano non è disponibile nella Voice Library. Se non trovi una voce adatta al tuo progetto, puoi crearne una. Voice Design è ideale per esplorare e iterare rapidamente e la qualità dell’output può variare in base al prompt e al caso d’uso. Se ti serve una qualità più costante e pronta per la produzione, le Professional Voice Clones (PVC) sono attualmente le voci di qualità più elevata sulla nostra piattaforma. Se nella nostra libreria è disponibile una PVC adatta alle tue esigenze, ti consigliamo di usarla.
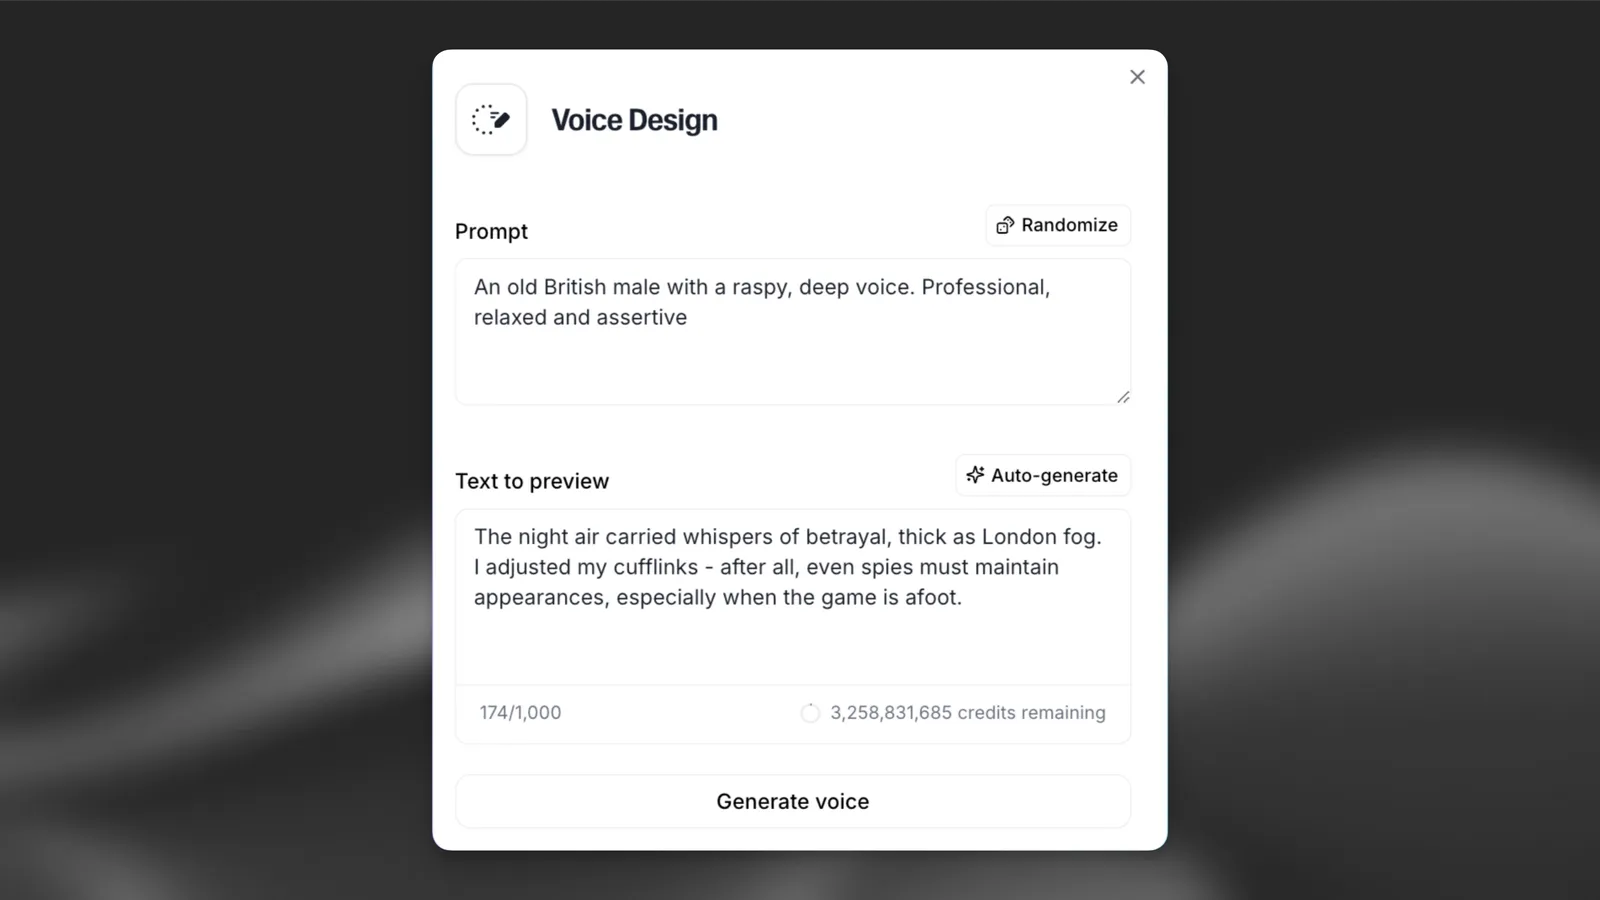
Puoi trovare Voice Design andando su Voci -> Le mie voci -> Crea una voce -> Voice Design nell’app ElevenLabs o tramite l’API.
Quando selezioni Genera, creeremo tre opzioni vocali per te. L’unico addebito per l’uso di Voice Design corrisponde al numero di crediti necessari per generare il testo di anteprima, che viene addebitato una sola volta anche se generiamo tre campioni. Puoi vedere il numero di caratteri che verranno detratti nella casella di testo “Testo da ascoltare in anteprima”.
Dopo la generazione, puoi selezionare e salvare una delle voci generate, che occuperà uno dei tuoi slot vocali.
Guida ai prompt
Il prompt è la base della tua voce. Indica al modello quale tipo di voce vuoi creare: dall’accento e dal tipo di personaggio al genere e all’atmosfera della voce. Un prompt ben formulato può fare la differenza tra una voce generica e una che rispecchia davvero la tua visione. In generale, prompt più descrittivi e dettagliati tendono a produrre risultati più accurati e sfumati. Più dettagli fornisci — inclusi età, genere, tono, accento, ritmo, emozione, stile e altro ancora — meglio il modello riesce a interpretare e generare una voce intenzionale e su misura.
Tuttavia, a volte funzionano anche prompt brevi e semplici, soprattutto se vuoi una voce più neutra o versatile. Ad esempio, “Un narratore maschile calmo” potrebbe darti esattamente ciò che ti serve senza entrare nei dettagli, in particolare se non cerchi di creare un personaggio o uno stile molto specifico. Il giusto livello di dettaglio dipende dal tuo caso d’uso. Stai creando un personaggio fantasy? Un assistente virtuale? Una newyorkese sessantenne stanca con un umorismo secco? Più lo definisci chiaramente nel prompt, più l’output si avvicinerà a ciò che immagini.
Formato di prompt consigliato
Per risultati coerenti, struttura il prompt usando questo formato:
Esempio:
Native Spanish, español europeo (sin rasgos de español latinoamericano). Female, 35–40. Ok quality. Persona: operadora de soporte confiable. Emotion: reassuring, attentive, confident. Smooth, natural timbre with gentle intonation, forward proximity, and a noise-free signal. Delivers updates at a relaxed pace with clear emphasis on helpful information, projecting empathy and professionalism.
Errori comuni da evitare
- Non usare “accento” quando intendi intonazione — può causare cambiamenti di dialetto indesiderati. Descrivi invece l’intonazione, l’enfasi o le modalità di espressione.
- Evita termini relativi agli effetti — parole come “riverbero”, “eco”, “telefono” o “nastro” possono influire negativamente sulla qualità dell’output.
- Indica esplicitamente lingua e dialetto — specifica sempre la lingua e la variante regionale nella prima frase per evitare deviazioni.
Qualità audio
La qualità audio si riferisce alla chiarezza, alla pulizia e alla fedeltà complessiva della voce generata. Per impostazione predefinita, ElevenLabs mira a produrre audio pulito e naturale, ma se il tuo progetto richiede un livello di qualità specifico, è meglio indicarlo esplicitamente nel prompt.
Per risultati di alta qualità, puoi aiutare il modello aggiungendo alla descrizione della voce una frase come “qualità audio perfetta” o “registrazione di qualità da studio”. Questo aiuta a garantire che la voce venga generata con la massima chiarezza, distorsione minima e una resa curata.
Puoi anche usare descrittori di qualità specifici che producono risultati coerenti:
- Qualità discreta
- Buona qualità
- Qualità molto buona
- Qualità eccellente
- Qualità da studio
- Qualità broadcast
Questi descrittori aiutano a ottenere la massima qualità audio quando vengono inclusi nel prompt.
Includere questo tipo di frasi può talvolta ridurre l’accuratezza generale del prompt se la voce è molto specifica o di nicchia.
In alcuni casi creativi, una qualità audio più bassa può essere intenzionale, ad esempio per simulare una telefonata, una vecchia trasmissione radiofonica o un filmato ritrovato. In queste situazioni, non includere affatto descrittori di qualità oppure aggiungi esplicitamente frasi come:
- “Audio a bassa fedeltà”
- “Qualità audio scarsa”
- “Sembra un messaggio in segreteria”
- “Ovattato e distante, come su un vecchio registratore a nastro”
La posizione di questa frase nel prompt è flessibile: può comparire all’inizio o alla fine, e abbiamo riscontrato che funziona bene in entrambi i casi.
Età, tono/timbro e genere
Queste tre caratteristiche sono alla base della progettazione della voce e ne definiscono l’identità complessiva e la risonanza emotiva. Più dettagli fornisci, più sarà facile per l’IA produrre una voce adatta alla tua visione creativa, sia che tu stia creando un personaggio credibile, un narratore coinvolgente o un assistente virtuale.
Età
Descrivere l’età percepita della voce aiuta a definirne la maturità, la texture vocale e l’energia. Usa termini specifici per guidare l’IA verso la giusta qualità vocale.
Descrittori utili:
- “Uomo anziano” / “donna anziana”
- “Giovane adulto” / “sui 20 anni” / “primi 30 anni”
- “Uomo di mezza età” / “donna sui 40 anni”
- “Uomo molto anziano” / “donna avanti con l’età” / “uomo sugli 80 anni”
Tono/timbro
Si riferisce alla qualità fisica della voce, determinata da altezza, risonanza e texture vocale. È distinto dall’espressione emotiva o dall’atteggiamento.
Descrittori comuni di tono/timbro:
- “Profondo” / “basso”
- “Morbido” / “ricco”
- “Rocoso” / “ruvido”
- “Nasale” / “stridulo”
- “Armonioso” / “soffiato”
- “Possente” / “risonante”
- “Leggero” / “sottile”
- “Caldo” / “morbido”
- “Metallico” / “metallico”
Genere
Il genere spesso influenza l’altezza, il peso vocale e la presenza timbrica, ma puoi andare oltre le semplici categorie descrivendo il suono anziché l’identità.
Esempi:
- “Una voce femminile bassa e roca”
- “Una voce maschile virile, profonda e risonante”
- “Un genere neutro, morbido e di altezza media”
Accento
L’accento svolge un ruolo fondamentale nel definire l’identità regionale, culturale ed emotiva di una voce. Se il tuo progetto dipende da un suono autentico, realistico o stilizzato per un personaggio, è essenziale indicare in modo chiaro e intenzionale l’accento desiderato.
La scelta delle parole conta: alcuni termini tendono a produrre risultati più coerenti. Ad esempio, “marcato” spesso dà risultati migliori di “forte” per descrivere quanto debba essere evidente un accento. Sono necessari molti tentativi e aggiustamenti, quindi ti invitiamo a sperimentare con la formulazione e a essere il più creativo e descrittivo possibile.
Fai attenzione quando usi la parola “accento”: se intendi modelli di intonazione o enfasi anziché un dialetto regionale, usa invece questi termini. Usare “accento” quando intendi intonazione può causare cambiamenti di dialetto indesiderati.
- Esempi di prompt chiari per l’accento:
- “Un uomo di mezza età con un marcato accento francese”
- “Una giovane donna con una lieve inflessione del Sud degli Stati Uniti”
- “Un anziano con un forte accento dell’Europa orientale”
- “Una donna allegra che parla con un nitido accento britannico”
- “Un uomo giovane con una leggera cadenza irlandese”
- “Una voce autorevole con un accento americano neutro”
- “Un uomo con un accento regionale australiano, rilassato e nasale”
Evita descrittori troppo vaghi come “straniero” o “esotico”: sono imprecisi e possono produrre risultati incoerenti.
Combina l’accento con altri tratti come tono, età o ritmo per avere un maggiore controllo. Ad esempio: “Un’anziana sarcastica con un marcato accento newyorkese, che parla lentamente.”
Per voci fantasy o di fantasia, puoi suggerire accenti del mondo reale come ispirazione:
- “Un elfo con un autentico e marcato accento britannico. È regale e lirico.”
- “Un goblin con un accento roco dell’Europa orientale.”
Ritmo
Il ritmo si riferisce alla velocità e alla cadenza con cui parla una voce. È un elemento fondamentale per definire la personalità, il tono emotivo e la chiarezza della voce. Essere espliciti sul ritmo è essenziale, soprattutto quando progetti voci per casi d’uso specifici come narrazione, pubblicità, dialoghi di personaggi o contenuti didattici.
Usa un linguaggio chiaro per descrivere quanto velocemente o lentamente deve parlare la voce. Puoi anche descrivere come appare il ritmo: costante, irregolare, deliberato o scorrevole. Se il ritmo cambia, assicurati di indicare dove e perché.
Esempi di descrittori del ritmo:
- “Parla velocemente” / “a ritmo rapido”
- “A ritmo normale” / “parla normalmente”
- “Parla lentamente” / “con un ritmo lento”
- “Ritmo deliberato e misurato”
- “Prolungato, come se assaporasse ogni parola”
- “Con una cadenza frettolosa, come se fosse di corsa”
- “Ritmo rilassato e conversazionale”
- “Ritmo cadenzato e musicale”
- “Ritmo irregolare, con pause e improvvise accelerazioni”
- “Ritmo uniforme, con una tempistica costante tra le parole”
- “Espressione staccata”
Testo da ascoltare in anteprima
Dopo aver scritto un buon prompt vocale, il testo che usi per ascoltare quella voce in anteprima svolge un ruolo cruciale nel definirne il suono effettivo. Il testo di anteprima funziona come un copione di interpretazione: stabilisce il tono, il ritmo e l’espressione emotiva che la voce cercherà di riprodurre.
Per ottenere i migliori risultati, il testo di anteprima dovrebbe completare la descrizione della voce, non contraddirla. Ad esempio, se il prompt descrive una “voce femminile giovane, calma e riflessiva con un leggero accento giapponese”, usare una frase come “Ehi! Non sopporto quello che hai fatto a questo dannato posto!!!” andrà in conflitto con questa intenzione. Il modello cercherà di conciliare questa discrepanza, ottenendo spesso risultati innaturali o incoerenti.
Usa invece un testo di esempio che rispecchi la personalità e il tono emotivo previsti per la voce. Per l’esempio precedente, una frase come “Ultimamente è stato tutto tranquillo… Ho avuto tempo per riflettere e forse era proprio ciò di cui avevo più bisogno.” supporta il prompt e aiuta a generare una voce più naturale e coerente.
Inoltre, abbiamo osservato che testi di anteprima più lunghi tendono a produrre risultati più stabili ed espressivi. Le frasi brevi possono talvolta suonare brusche o incoerenti, soprattutto quando testi qualità sottili come il tono o il ritmo. Dare al modello più contesto — una frase completa o persino un breve paragrafo — gli consente di offrire una rappresentazione della voce più fluida e accurata.
Parametri
Volume
Controlla il volume della generazione Text to Preview e, in definitiva, della voce una volta salvata.
Scala di guida
Determina quanto fedelmente viene seguito il prompt. Valori più alti aderiscono più rigorosamente al prompt, ma possono ridurre la qualità audio se il prompt è molto di nicchia, mentre valori più bassi consentono al modello di essere più creativo a discapito dell’accuratezza del prompt. Usa un valore più basso se l’interpretazione e la qualità audio sono generalmente più importanti di una perfetta aderenza al prompt. I valori alti sono consigliati quando l’accuratezza dell’accento o del tono è di primaria importanza.
Attributi ed esempi
Sperimenta con il modo in cui scrivi questi descrittori. Ad esempio, “Qualità audio perfetta” può anche essere scritto come “la qualità audio è perfetta”. A volte possono produrre risultati diversi!