Immagini e Video
Panoramica
Immagini e Video ti permette di creare contenuti visivi di alta qualità a partire da semplici descrizioni testuali o immagini di riferimento. Genera immagini statiche o video dinamici in qualsiasi stile, poi perfezionali in modo iterativo con prompt aggiuntivi, aumentane la risoluzione per un output in alta definizione e aggiungi persino il lip-sync con l’audio. Esporta le risorse finali come file autonomi o importale direttamente nei progetti di ElevenCreative Studio.
Alcuni modelli di Immagini e Video e le funzionalità di caricamento degli input sono soggetti a restrizioni negli Stati Uniti per requisiti normativi o dei provider. Consulta le descrizioni dei singoli modelli per informazioni specifiche sulla disponibilità.
Gli utenti del piano Free possono generare solo immagini e hanno un limite di tre richieste di immagini al giorno. La generazione di video richiede un piano a pagamento.
Guida
Segui questi passaggi per creare la tua prima risorsa visiva:
Seleziona la modalità
Usa l’interruttore nell’angolo in alto a destra della casella del prompt per scegliere tra la generazione di Immagini o Video.
Fornisci un prompt o un riferimento
Descrivi l’output desiderato in linguaggio naturale nella casella del prompt. Per avere più controllo, trascina immagini o video esistenti dalle schede Esplora o Cronologia negli slot di riferimento, oppure carica le tue immagini di riferimento in un’ampia gamma di formati di file, inclusi JPG, PNG, WEBP e altri.
Scegli un modello e le impostazioni
Seleziona il modello generativo ideale per il tuo obiettivo (ad esempio, Google Veo 3.1, Kling 2.5, Flux 1 Kontext Pro). Consulta la sezione Modelli per informazioni dettagliate su ciascun modello. Regola impostazioni come proporzioni, risoluzione, durata (per i video) e numero di variazioni da generare.
Genera la risorsa
Fai clic sul pulsante Genera. Le tue risorse verranno create e mostrate nella scheda Cronologia per essere esaminate.
Migliora e perfeziona
Usa gli strumenti di miglioramento per perfezionare i tuoi contenuti. Aumenta la risoluzione, applica un LipSync realistico con l’audio oppure fai clic su Ricrea per generare una nuova variazione con le stesse impostazioni.
Workflow
Il processo di creazione ti porta dall’ispirazione alla risorsa finale in quattro fasi:
Esplora
Scopri le creazioni della community per trovare ispirazione, studiare prompt efficaci o inserire riferimenti direttamente nel tuo lavoro.
Genera
Usa la casella del prompt per descrivere ciò che vuoi creare, seleziona un modello, ottimizza le impostazioni e dai vita alla tua idea.
Cronologia
Esamina le tue generazioni nella scheda Cronologia per iterare e migliorare. Ricrea variazioni, riutilizza i prompt e applica miglioramenti come l’aumento della risoluzione e il lip-sync.
Esporta
Scarica le risorse finali in vari formati oppure inviale direttamente a ElevenCreative Studio per usarle nei tuoi progetti.
Esplora
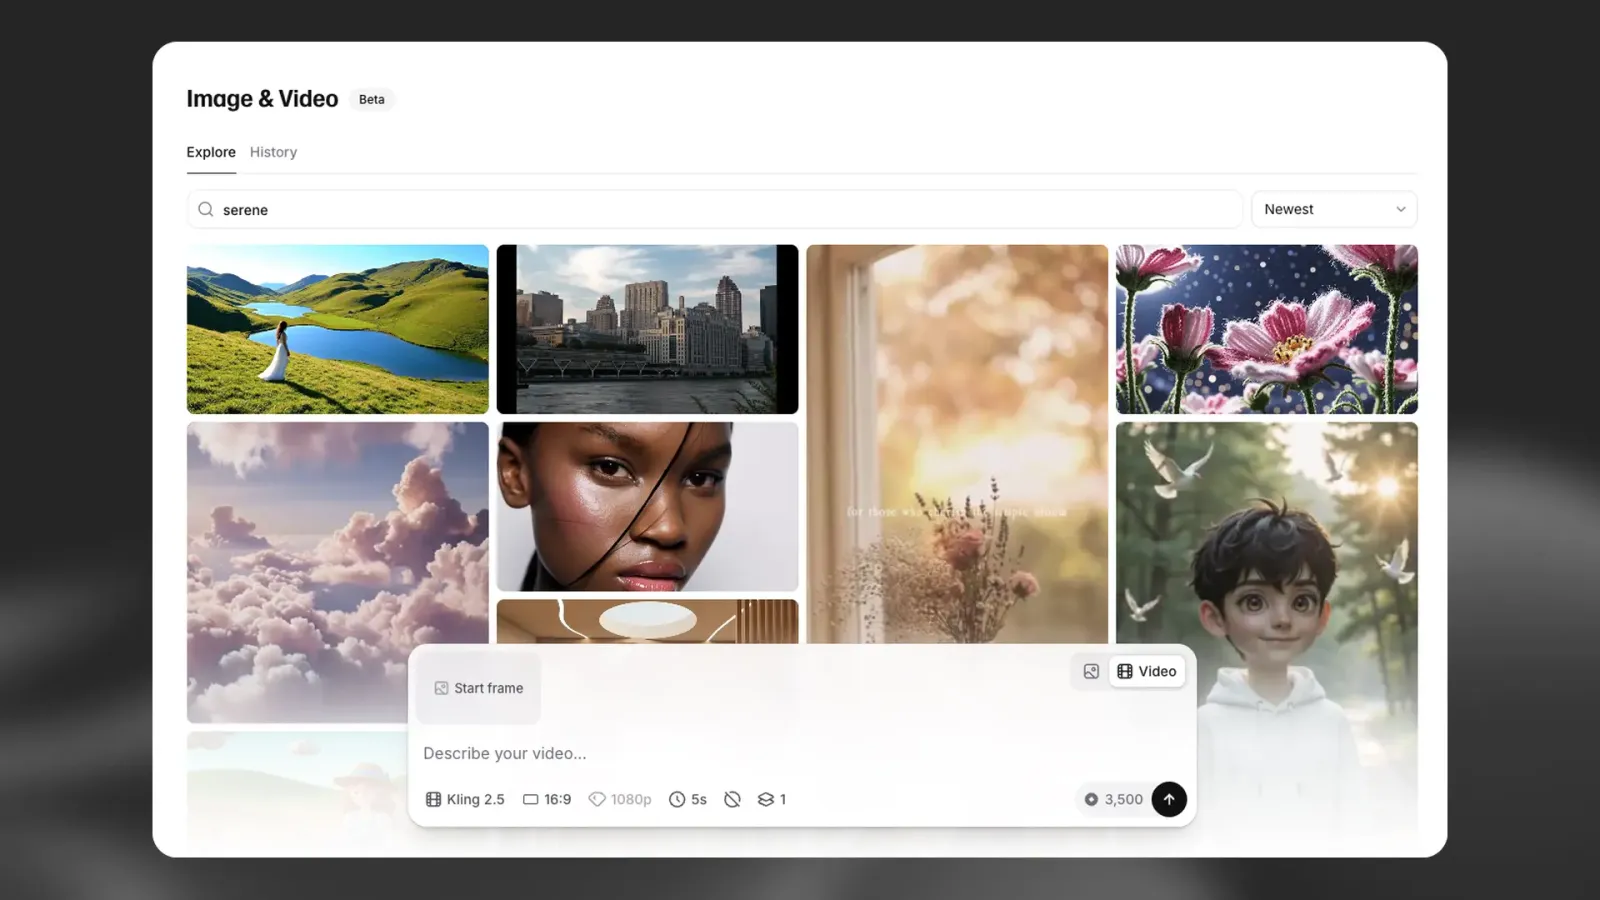
La scheda Esplora mostra una galleria di creazioni della community per trovare ispirazione e immagini da usare come riferimenti.
Cerca: usa la barra di ricerca per trovare immagini e video in base a parole chiave.
Ordina: passa da Di tendenza a Più recenti per vedere ciò che è popolare o aggiunto di recente.
Trascinamento: trascina qualsiasi risultato dalla griglia direttamente nella casella del prompt per usarlo come fotogramma iniziale, fotogramma finale o riferimento di stile.
Visualizza dettagli: fai clic su qualsiasi riquadro per vedere il prompt completo e le impostazioni usate per crearlo.
Genera
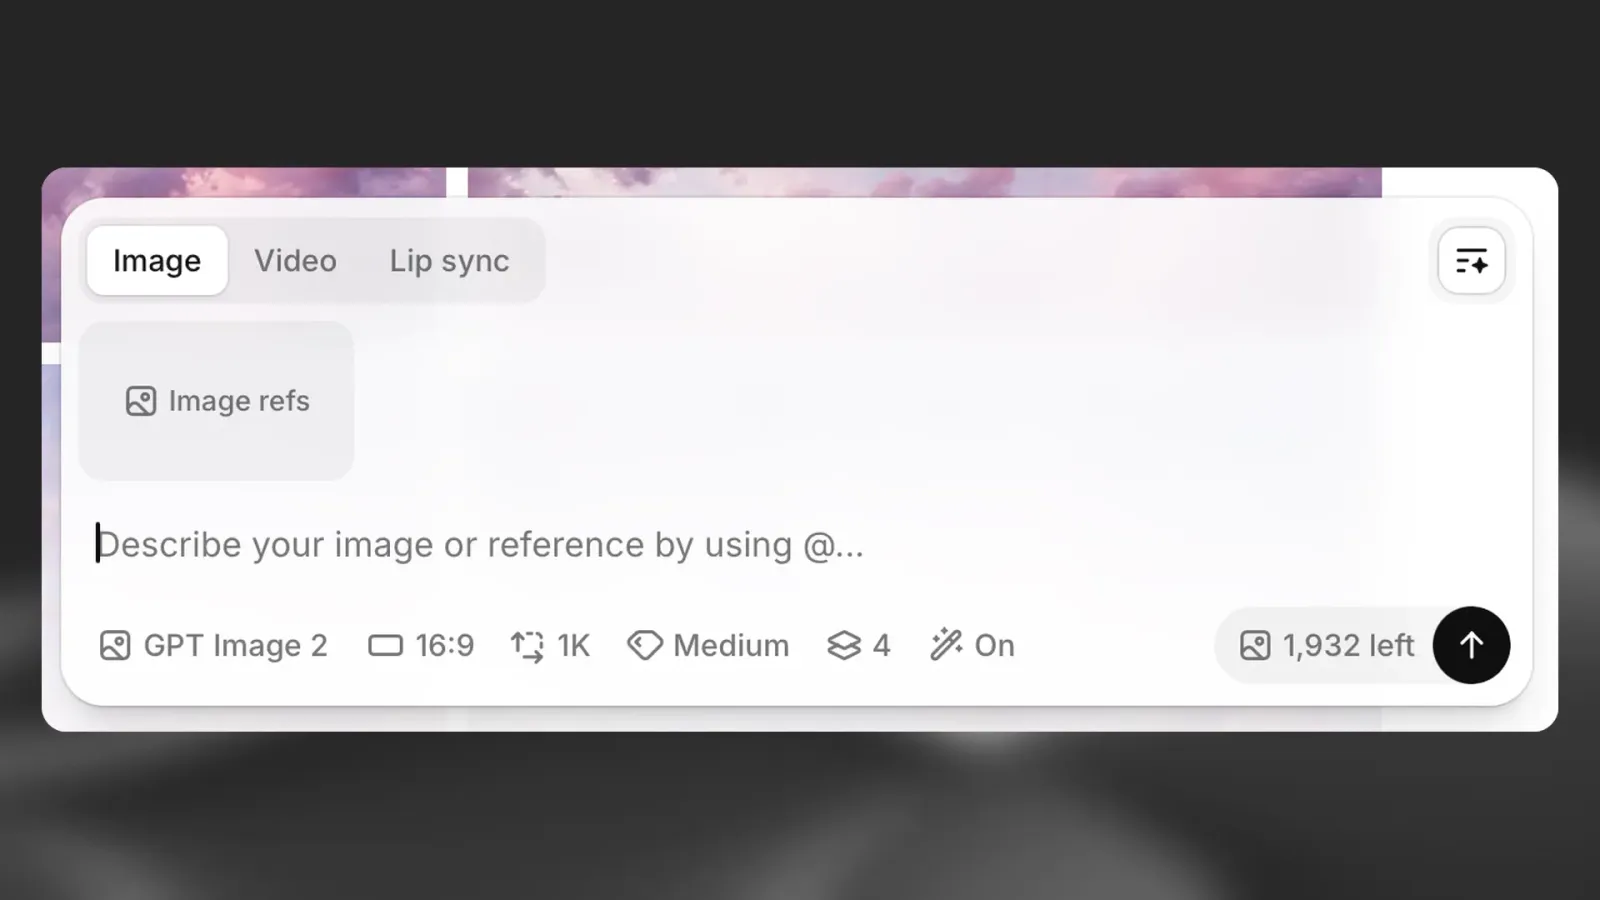
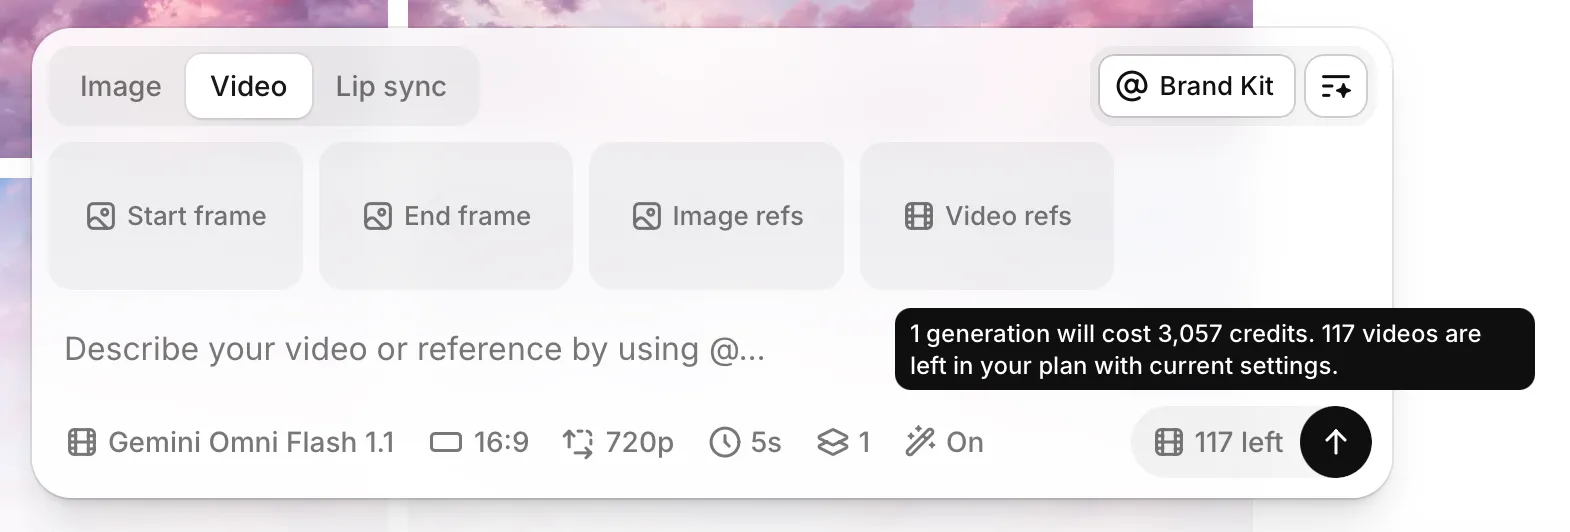
La casella del prompt è fissata nella parte inferiore della pagina e offre tutti i controlli per creare contenuti visivi.
Imposta modalità e prompt
Seleziona la modalità: usa l’interruttore nell’angolo in alto a destra per passare dalla generazione di Immagini a quella di Video.
Scrivi il prompt: nel campo principale, descrivi ciò che vuoi generare usando il linguaggio naturale. Per risultati ottimali, sii chiaro e descrittivo.
Scegli modelli e impostazioni
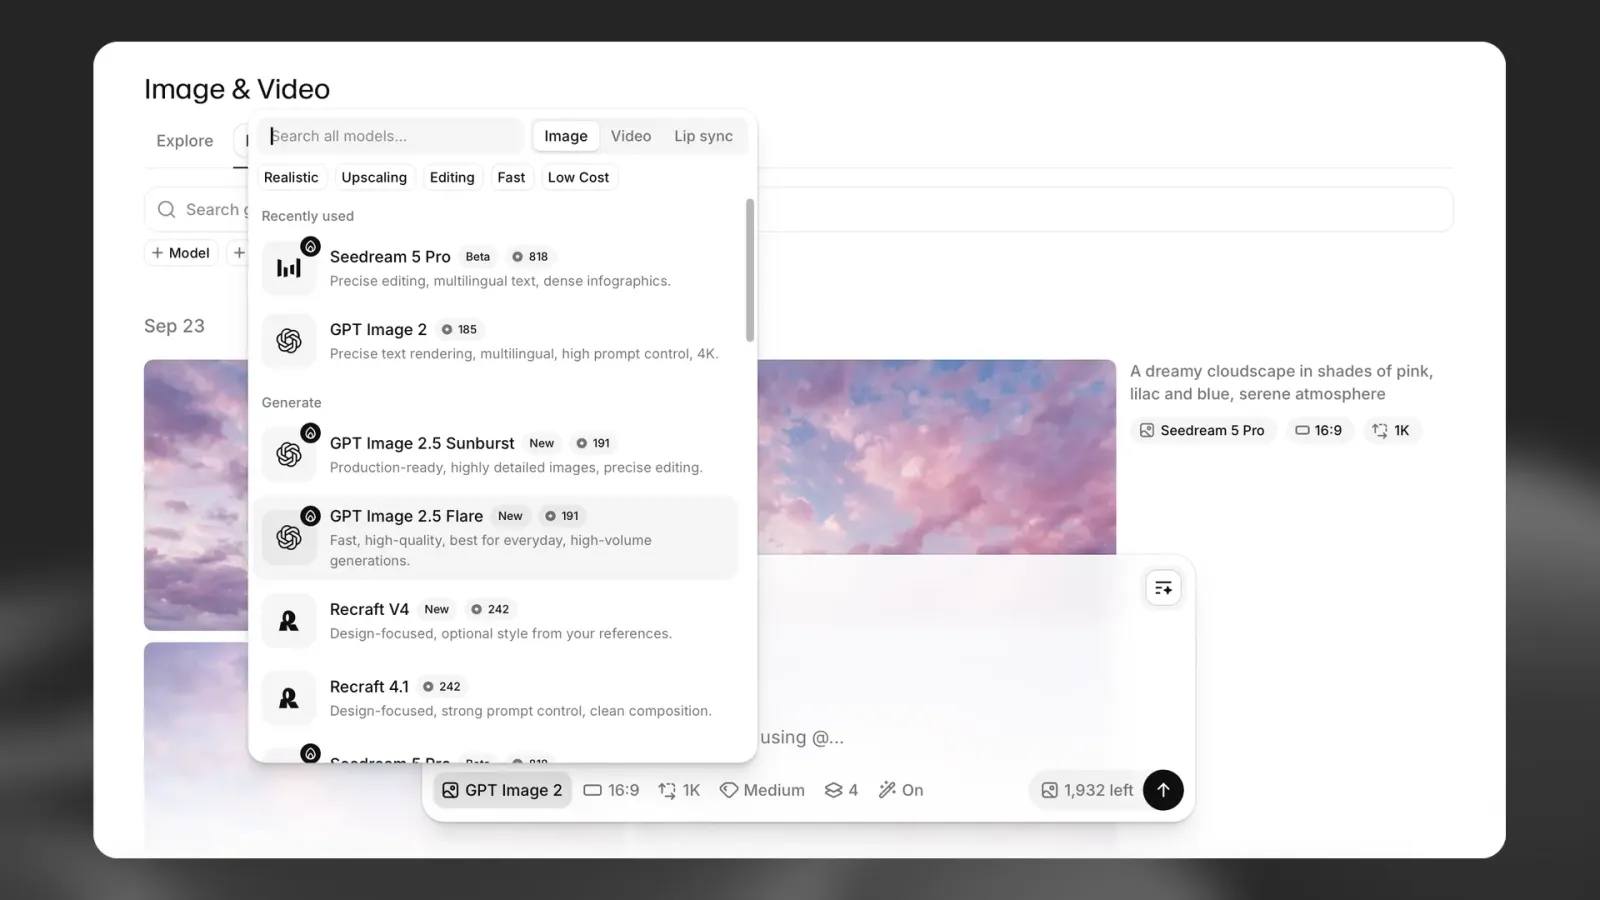
Seleziona il modello: apri il menu dei modelli per esplorare le opzioni disponibili, come Google Veo 3.1, Kling 2.5 o Flux 1 Kontext Pro. Ogni modello presenta punti di forza e funzionalità unici, elencati per un confronto semplice. Consulta la sezione Modelli per informazioni dettagliate.
Regola le impostazioni: ottimizza la generazione con le impostazioni visualizzate sotto il prompt. Variano in base al modello, ma spesso includono:
- Proporzioni: controlla le dimensioni dell’output
- Risoluzione: imposta il livello di qualità
- Durata: specifica la durata del video (in modalità video)
- Numero di generazioni: crea fino a 4 variazioni contemporaneamente
Usa i controlli: nei modelli supportati, abilita l’Audio, aggiungi un Prompt negativo per escludere elementi indesiderati o regola il Controllo audio.
Aggiungi riferimenti
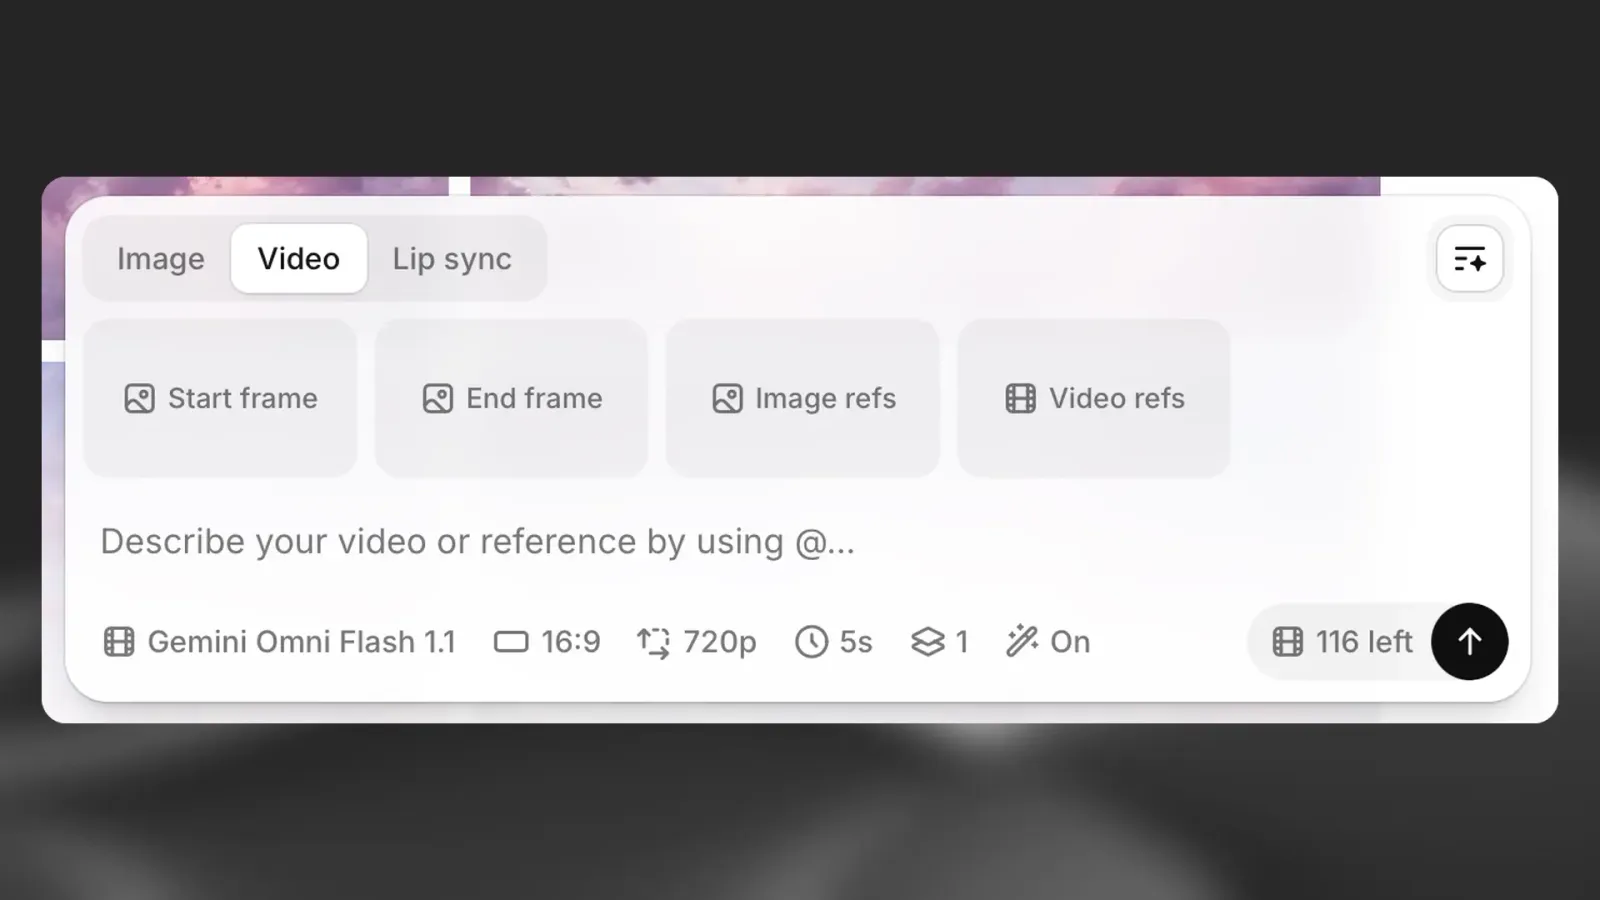
Per un maggiore controllo sull’output, aggiungi riferimenti visivi che guidino la generazione. La disponibilità dipende dal modello selezionato. Supportiamo un’ampia gamma di formati di file immagine, inclusi JPG, PNG, WEBP e altri.
Fotogramma iniziale (video): imposta l’immagine di apertura del video.
Fotogramma finale (video): imposta l’immagine finale, influenzando la transizione.
Riferimenti immagine (immagine o video): fornisci una o più immagini per guidare lo stile e l’aspetto generale.
Trascina gli elementi direttamente dalle schede Esplora o Cronologia negli slot di riferimento per un workflow più rapido.
Genera
Prima di generare, un indicatore di costo mostra il costo totale per il numero di risorse che hai scelto di creare. Quando sei pronto, fai clic su Genera. Le tue nuove creazioni appariranno nella scheda Cronologia.
Cronologia
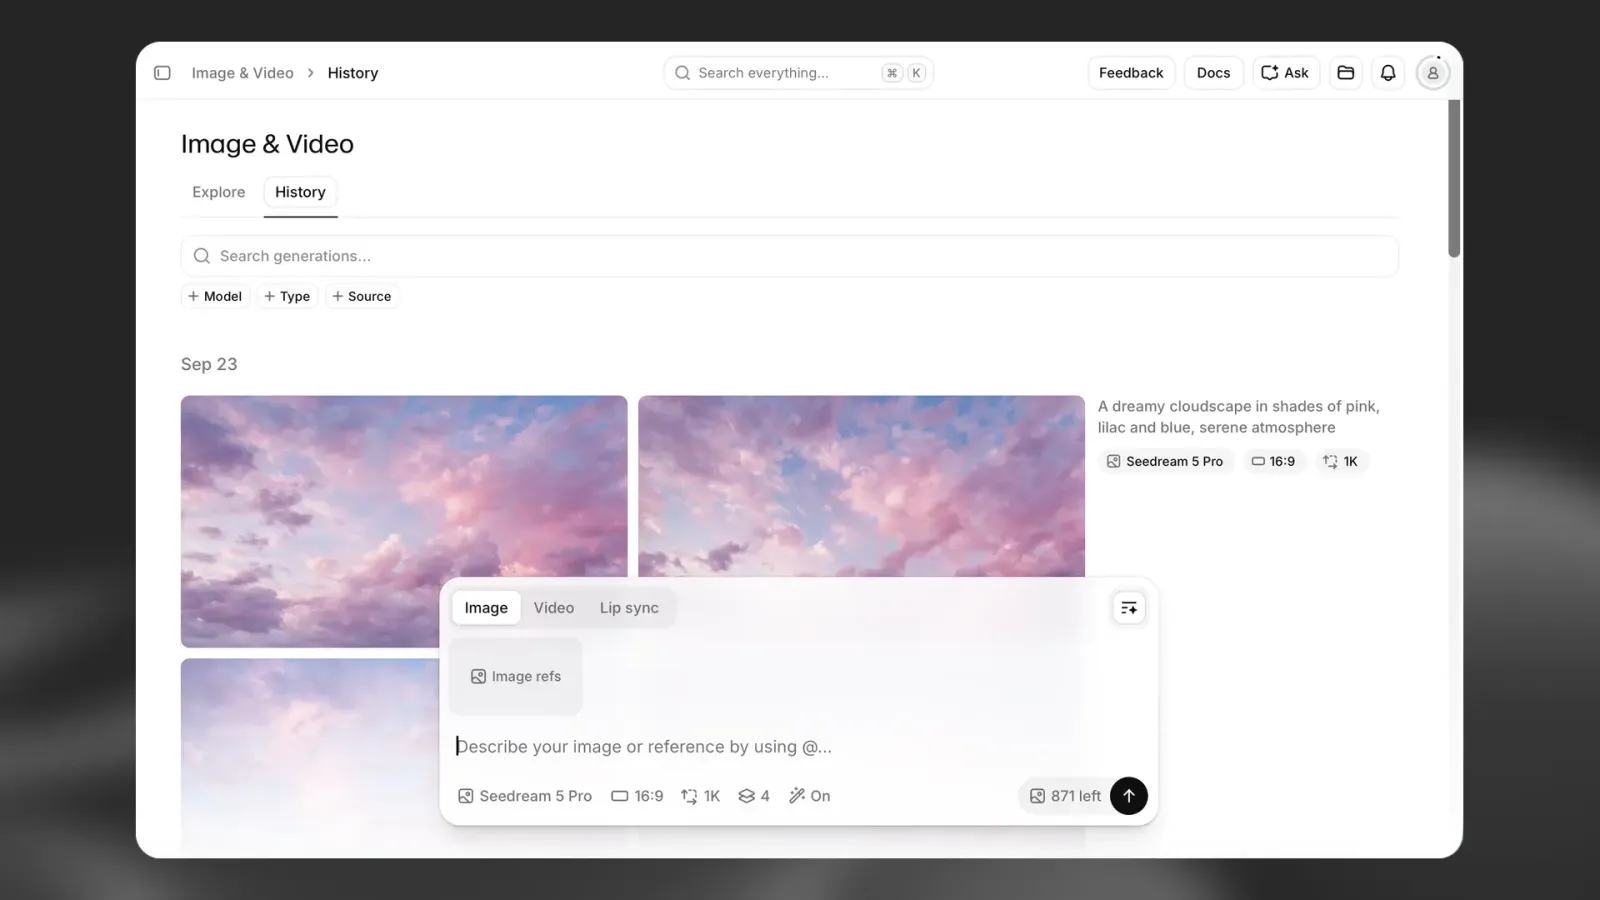
La scheda Cronologia offre un registro cronologico di tutto ciò che hai generato e funge da workspace per perfezionare il lavoro precedente.
Sfoglia: visualizza tutte le immagini e i video passati.
Esamina: fai clic su una risorsa per vedere il prompt originale, il modello e le impostazioni usate per crearla.
Riutilizza: trascina gli elementi dalla Cronologia nella casella del prompt per usarli come riferimenti per nuove generazioni.
Itera: fai clic su Ricrea per eseguire di nuovo lo stesso prompt e le stesse impostazioni per una nuova variazione, oppure regola le impostazioni per guidare la generazione in una nuova direzione.
Condividi: fai clic su Condividi per generare un link univoco per la tua risorsa. Invialo a compagni di team e collaboratori per ricevere feedback.
Esporta: scarica la risorsa come file autonomo oppure fai clic su Modifica in Studio per importarla direttamente in ElevenCreative Studio.
Esporta
Quando hai una generazione che ti soddisfa, usa gli strumenti di miglioramento integrati prima di esportarla.
Migliorare le tue creazioni
Aumenta la risoluzione: usa Topaz Upscale per aumentare la risoluzione fino a 4 volte preservando i dettagli nitidi.
LipSync: applica un lip-sync realistico ai tuoi contenuti visivi:
- Omnihuman 1.5: anima un’immagine statica con una traccia audio
- Veed LipSync: doppia un video esistente con nuovo audio
Esportare le tue risorse
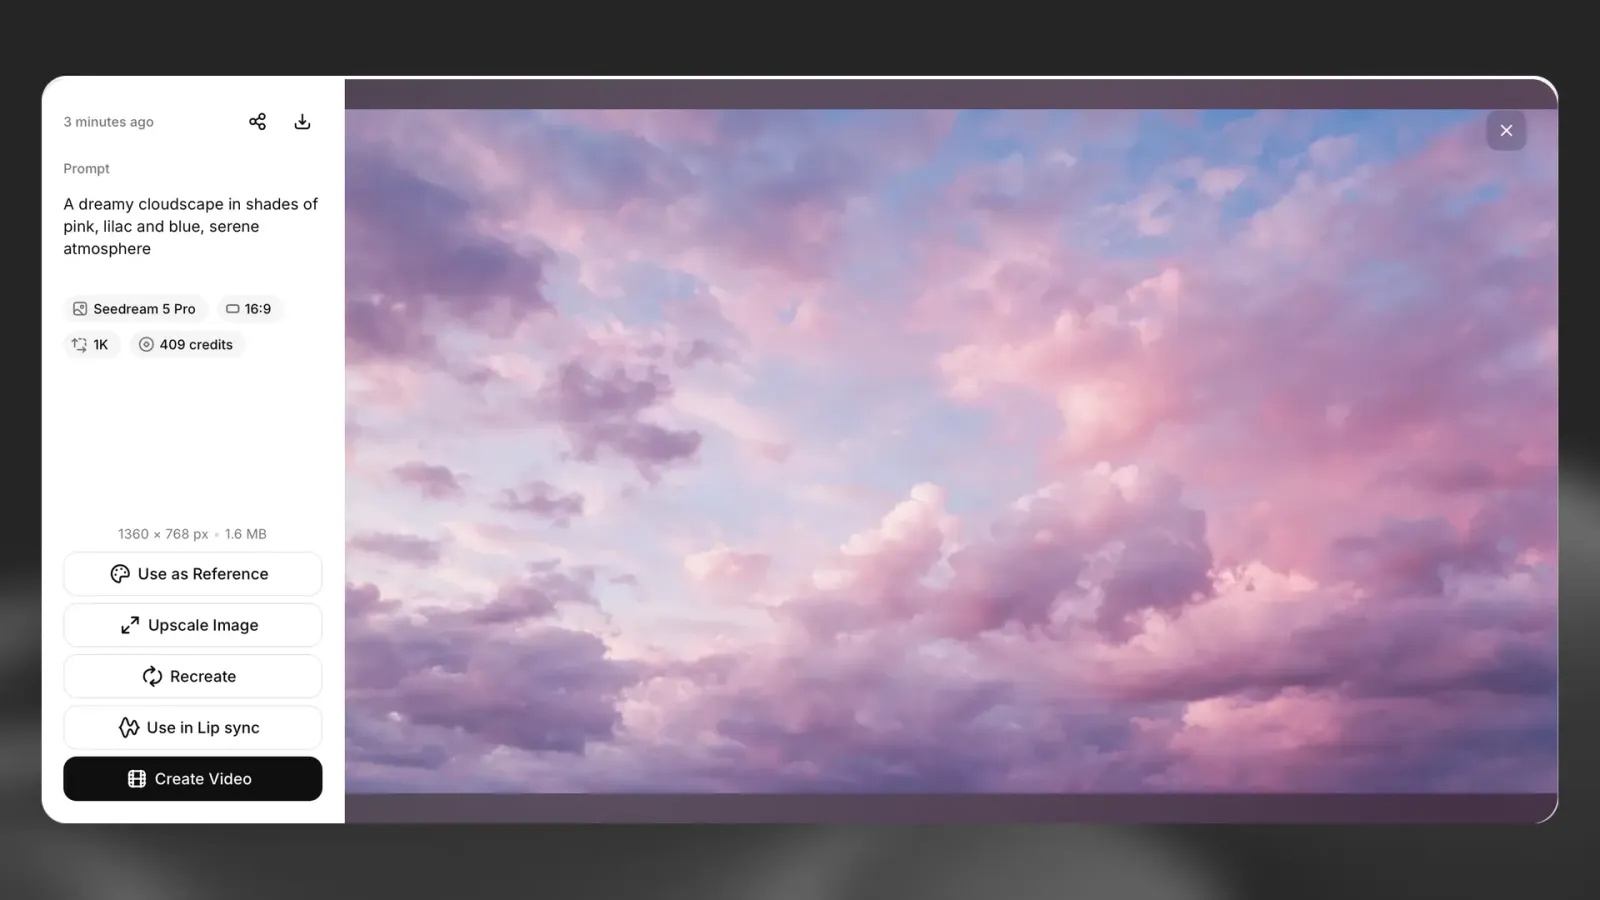
Esporta le risorse finali scaricandole in locale oppure inviandole direttamente a ElevenCreative Studio.
Modifica in Studio: importa la risorsa direttamente in un progetto di ElevenCreative Studio.
Scarica: salva la risorsa sul tuo computer.
Formati di download supportati
Video:
- MP4: codec H.264, H.265. Qualità fino a 4K (con upscaling)
Immagine:
- PNG: output ad alta risoluzione e senza perdita
Modelli
Immagini e Video offre accesso a modelli specializzati ottimizzati per diversi casi d’uso. Ogni modello offre funzionalità uniche, dall’iterazione rapida alla qualità pronta per la produzione.
I modelli di post-elaborazione richiedono un output già generato, ma puoi anche caricare un file immagine o video.
Gli amministratori del workspace Enterprise possono controllare quali modelli di generazione di immagini e video sono disponibili per i membri del workspace. Per impostazione predefinita, tutti i modelli sono disabilitati nei workspace Enterprise e devono essere abilitati esplicitamente dagli amministratori. Scopri di più sulle approvazioni dei modelli.
Per le richieste API, i modelli ByteDance sono disabilitati per impostazione predefinita e richiedono un’approvazione esplicita prima dell’uso. I clienti Enterprise possono contattare l’assistenza per richiedere l’accesso.
Modelli generativi video
Seedance 2.0
Un modello video multimodale unificato con generazione congiunta di audio e video, che offre un controllo da regista su recitazione, illuminazione, ombre e movimento della telecamera per risultati cinematografici e ultra-realistici.
Input di generazione:
- Da testo a video
- Frame iniziale
- Frame finale
- Riferimenti immagine
- Riferimenti video
- Riferimenti audio
Funzionalità:
- Architettura multimodale unificata che genera congiuntamente audio e video sincronizzati in un unico passaggio
- Funzionalità di riferimento e modifica multimodale leader del settore, con input simultanei di testo, immagini, audio e video
- Eccezionale stabilità del movimento con realismo di livello cinematografico in linea con gli standard del settore
- Controllo creativo da regista su recitazione, illuminazione, ombre e movimento della telecamera
- Durate di generazione flessibili da 4 s fino a 15 s
- Controllo nativo dell’audio, abilitabile o disabilitabile per ogni generazione
- Creazione in batch con fino a 4 generazioni alla volta
Opzioni di output:
- Risoluzioni: 480p, 720p, 1080p
- Proporzioni: 21:9, 16:9, 4:3, 1:1, 3:4, 9:16
Ideale per:
- Storytelling cinematografico che richiede audio e immagini sincronizzati
- Contenuti basati su riferimenti con rigorosa aderenza a immagini, video o audio di origine
- Produzioni professionali che richiedono un controllo dettagliato di illuminazione e riprese
Costo: varia in base alle impostazioni selezionate e alla durata
Seedance 2.0 Fast
Una variante più veloce e meno costosa di Seedance 2.0 con gli stessi input di riferimento multimodali, con output limitato a 720p.
Input di generazione:
- Da testo a video
- Frame iniziale
- Frame finale
- Riferimenti immagine (fino a 9)
- Riferimenti video (fino a 3, 15 s complessivi)
- Riferimenti audio (fino a 3, 15 s complessivi)
Funzionalità:
- Stessa gestione dei riferimenti di Seedance 2.0, con un limite complessivo di 12 riferimenti per generazione
- Frame e riferimenti si escludono a vicenda: usa un frame iniziale o finale, oppure i riferimenti, non entrambi
- Durate di generazione flessibili da 4 s fino a 15 s
- Controllo nativo dell’audio, abilitabile o disabilitabile per ogni generazione
- Creazione in batch con fino a 4 generazioni alla volta
Opzioni di output:
- Risoluzioni: 480p, 720p
- Proporzioni: 21:9, 16:9, 4:3, 1:1, 3:4, 9:16
Ideale per:
- Iterare sui prompt di Seedance 2.0 prima di un rendering a piena risoluzione
- Clip basate su riferimenti per cui l’output a 720p è sufficiente
Costo: varia in base alle impostazioni selezionate e alla durata
API: bytedance-seedance-v2-fast
Seedance 2.0 Fast non è disponibile negli Stati Uniti.
Seedance 2.0 Mini
La variante più piccola di Seedance 2.0: circa due volte più veloce di Seedance 2.0 a circa metà del costo, con gli stessi input e output a 720p.
Input di generazione:
- Da testo a video
- Frame iniziale
- Frame finale
- Riferimenti immagine (fino a 9)
- Riferimenti video (fino a 3, 15 s complessivi)
- Riferimenti audio (fino a 3, 15 s complessivi)
Funzionalità:
- Stessa gestione dei riferimenti di Seedance 2.0, con un limite complessivo di 12 riferimenti per generazione
- Frame e riferimenti si escludono a vicenda: usa un frame iniziale o finale, oppure i riferimenti, non entrambi
- Durate di generazione flessibili da 4 s fino a 15 s
- Controllo nativo dell’audio, abilitabile o disabilitabile per ogni generazione
- Creazione in batch con fino a 4 generazioni alla volta
Opzioni di output:
- Risoluzioni: 480p, 720p
- Proporzioni: 21:9, 16:9, 4:3, 1:1, 3:4, 9:16
Ideale per:
- Bozze e anteprime ad alto volume
- Workflow attenti ai costi che richiedono comunque input audio e riferimenti
Costo: varia in base alle impostazioni selezionate e alla durata
API: bytedance-seedance-v2-mini
Seedance 2.0 Mini non è disponibile negli Stati Uniti.
Seedance 2.5
Il successore di Seedance 2.0, con un realismo più nitido, fino a 50 riferimenti combinati tra immagini, video e audio, e generazioni fino a 30 secondi.
Input di generazione:
- Da testo a video
- Frame iniziale
- Frame finale
- Riferimenti immagine (fino a 30)
- Riferimenti video (fino a 10, 30 s complessivi)
- Riferimenti audio (fino a 10, 30 s complessivi)
Funzionalità:
- Nessun limite complessivo tra i tipi di riferimento; sono accettati riferimenti solo audio senza immagini o video
- Frame e riferimenti si escludono a vicenda
- Durate di generazione flessibili da 4 s fino a 30 s
- Le proporzioni vengono ricavate dal frame iniziale o dal video di riferimento, quando fornito
- Controllo nativo dell’audio, abilitabile o disabilitabile per ogni generazione
- Creazione in batch con fino a 4 generazioni alla volta
Opzioni di output:
- Risoluzioni: 480p, 720p
- Proporzioni: 21:9, 16:9, 4:3, 1:1, 3:4, 9:16
Ideale per:
- Clip di lunga durata che devono rimanere coerenti con molti riferimenti
- Scene di dialogo e recitazione guidate da audio di riferimento
Costo: varia in base alle impostazioni selezionate e alla durata
Seedance 2.5 non offre un controllo del seed.
Seedance 2.5 Video Edit
Modifica un video esistente descrivendo i cambiamenti. La durata dell’output e le proporzioni seguono il video di input.
Input di generazione:
- Video da modificare (obbligatorio, fino a 30 s)
- Prompt testuale che descrive le modifiche
- Riferimenti immagine (fino a 30)
- Riferimenti video aggiuntivi (fino a 10, 30 s complessivi)
- Riferimenti audio (fino a 10, 30 s complessivi)
Funzionalità:
- Nessun controllo della durata: l’output corrisponde alla durata del video di input
- Le proporzioni vengono ricavate dal video di input
- Controllo nativo dell’audio, abilitabile o disabilitabile per ogni generazione
- Creazione in batch con fino a 4 generazioni alla volta
Opzioni di output:
- Risoluzioni: 480p, 720p
Ideale per:
- Modificare abbigliamento, oggetti di scena, illuminazione o ambientazione in filmati esistenti
- Trasferimento di stile che preserva il movimento originale
Costo: varia in base alle impostazioni selezionate e alla durata
Seedance 2.5 Video Extend
Prosegue un video esistente dal punto in cui termina, guidato da un prompt e da riferimenti facoltativi.
Input di generazione:
- Video da estendere (obbligatorio, fino a 30 s)
- Prompt testuale che descrive il proseguimento
- Riferimenti immagine (fino a 30)
- Riferimenti video aggiuntivi (fino a 10, 30 s complessivi)
- Riferimenti audio (fino a 10, 30 s complessivi)
Funzionalità:
- Durata dell’estensione da 4 s fino a 30 s
- Le proporzioni vengono ricavate dal video di input
- Controllo nativo dell’audio, abilitabile o disabilitabile per ogni generazione
- Creazione in batch con fino a 4 generazioni alla volta
Opzioni di output:
- Risoluzioni: 480p, 720p
Ideale per:
- Allungare un’inquadratura che termina troppo presto
- Concatenare più generazioni in una sequenza più lunga
Costo: varia in base alle impostazioni selezionate e alla durata
Kling 3.0
Un modello video avanzato che funziona come un regista IA, mantenendo un’elevata coerenza di personaggi, oggetti e scene durante movimenti complessi della telecamera.
Input di generazione:
- Da testo a video
- Frame iniziale
- Frame finale
Funzionalità:
- Conservazione ad alta fedeltà di personaggi e scene tramite riferimenti di immagini o video multiangolazione
- Co-generazione audio-visiva nativa con sincronizzazione labiale multilingue e suono ambientale
- Durate di generazione flessibili da 3 s fino a 15 s
- Genera fino a 4 varianti contemporaneamente
- Gestione migliorata di testo, dinamica dei fluidi e interazioni fisiche complesse
Opzioni di output:
- Risoluzioni: solo 1080p
- Proporzioni: 16:9, 1:1, 9:16
Ideale per:
- Storytelling incentrato sui personaggi che richiede continuità visiva
- Spot e risorse con esigenze specifiche di rendering del testo
Costo: varia in base alle impostazioni selezionate e alla durata
Supporta prompt negativi per un controllo dettagliato. L’audio può essere abilitato o disabilitato per ogni generazione.
Kling 3.0 non è disponibile negli Stati Uniti.
Kling O3
Un modello video ad alta coerenza che funziona come un regista IA, preservando l’identità di personaggi, oggetti e scene durante movimenti complessi della telecamera.
Input di generazione:
- Da testo a video
- Frame iniziale
- Frame finale
- Riferimento video
- Riferimento immagine
Funzionalità:
- Mantiene una precisa identità visiva per i personaggi e gli oggetti principali tramite riferimenti multiangolazione
- Supporta durate di generazione continue da 3 s fino a 15 s
- Genera fino a 4 varianti alla volta
- Modellazione accurata delle interazioni tra elementi e coerenza del movimento
- Supporto nativo per audio abilitato o disabilitato per ogni generazione
Opzioni di output:
- Risoluzioni: solo 1080p
- Proporzioni: 16:9, 1:1, 9:16
Ideale per:
- Storytelling incentrato sui personaggi che richiede una rigorosa continuità visiva
- Risorse professionali di marketing e brand con rendering coerente degli oggetti
Costo: varia in base alle impostazioni selezionate e alla durata
Kling O3 non è disponibile negli Stati Uniti.
Kling O3 Edit
Un modello di editing video-to-video guidato dal linguaggio naturale e basato sull’architettura O3, che consente trasformazioni visive complesse, come la sostituzione di personaggi e il cambio di ambiente, senza necessità di mascheramento manuale o regolazioni frame per frame.
Input di generazione:
- Video di origine
- Riferimenti immagine (fino a 4 elementi/angolazioni distinti)
- Descrizione testuale (istruzioni in linguaggio naturale)
Funzionalità:
- Interpreta prompt conversazionali per sostituire soggetti o ambientazioni rispettando la struttura di movimento originale
- Mantiene angolazioni della telecamera, schemi di movimento e relazioni spaziali originali durante tutta la modifica
- Combina fino a 4 elementi totali, incluse immagini frontali e multiangolazione, per garantire una coerenza dei personaggi ad alta fedeltà
- Opzione per preservare l’audio originale o generare output silenzioso per ogni generazione
- Genera fino a 4 varianti modificate alla volta
Opzioni di output:
- Risoluzioni: dipendenti dal video di origine
- Proporzioni: corrispondono al video di origine
Ideale per:
- Sostituzione ad alta fedeltà di personaggi in filmati esistenti mantenendo i movimenti originali
- Trasformazioni complete dell’ambiente di una scena (ad esempio, cambiare una città di giorno in un paesaggio notturno futuristico)
- Applicare trasferimenti di stile che richiedono una rigorosa aderenza alle dinamiche della telecamera esistente
Costo: varia in base alla durata del video e alle impostazioni selezionate
Kling O3 Edit non è disponibile negli Stati Uniti.
Google Veo 3.1
Un modello di livello professionale per la generazione di video cinematografici di alta qualità.
Input di generazione:
- Da testo a video
- Frame iniziale
- Frame finale
- Riferimenti immagine
Funzionalità:
- Qualità eccellente e controllo creativo con prompt negativi
- Audio completamente integrato e sincronizzato
- Dialoghi realistici, sincronizzazione labiale ed effetti sonori
- Durate fisse: 4 s, 6 s e 8 s
- Creazione in batch con fino a 4 generazioni alla volta
- Controllo audio dedicato
Opzioni di output:
- Risoluzioni: 720p, 1080p
- Proporzioni: 16:9, 9:16
Ideale per:
- Generazione di video cinematografici di alta qualità con pieno controllo creativo
Costo: varia in base alle impostazioni selezionate e alla durata
API: veo-3.1-generate-001
Abilitare o disabilitare l’audio modifica i crediti di generazione.
Google Veo 3.1 Fast
Un modello ad alta velocità ottimizzato per anteprime e generazioni rapide, che offre immagini più nitide con minore latenza.
Input di generazione:
- Da testo a video
- Frame iniziale
- Frame finale
Funzionalità:
- Controllo creativo avanzato con prompt negativi e controllo audio dedicato
- Durate fisse: 4 s, 6 s e 8 s
- Creazione in batch con fino a 4 generazioni alla volta
- Modella accuratamente la fisica del mondo reale per movimenti e interazioni realistici
Opzioni di output:
- Risoluzioni: 720p, 1080p
- Proporzioni: 16:9, 9:16
Ideale per:
- Iterazioni rapide e immagini per test A/B
- Creazione rapida di contenuti per social media
Costo: varia in base alle impostazioni selezionate e alla durata
Google Veo 3.1 Lite
Una variante di Veo 3.1 conveniente e ad alta velocità, ottimizzata per generazioni rapide con minore potenza di calcolo.
Input di generazione:
- Da testo a video
- Frame iniziale
Funzionalità:
- Controllo creativo dettagliato con prompt negativi e controllo audio dedicato
- Durate fisse: 4 s, 6 s e 8 s
- Creazione in batch con fino a 4 generazioni alla volta
Opzioni di output:
- Risoluzioni: 720p
- Proporzioni: 16:9, 9:16
Ideale per:
- Creazione di contenuti ad alto volume, quando velocità ed efficienza dei costi sono prioritarie
- Esplorazione rapida di concetti e anteprime
Costo: varia in base alle impostazioni selezionate e alla durata
Gemini Omni Flash 1.1
Il modello video di Google che tiene conto della fisica, con audio nativo, output fino a 4K e generazione sia con interpolazione dei frame sia guidata da riferimenti.
Input di generazione:
- Da testo a video
- Frame iniziale
- Frame finale
- Riferimenti immagine (fino a 10)
- Riferimenti video (fino a 3, ciascuno fino a 10 s)
Funzionalità:
- Frame e riferimenti si escludono a vicenda: interpola tra i frame oppure guida la generazione con riferimenti
- Durate fisse da 3 s a 10 s; la durata segue il video di riferimento quando ne viene allegato uno
- Rendering efficace di brevi testi ed etichette sullo schermo
- Creazione in batch con fino a 4 generazioni alla volta
Opzioni di output:
- Risoluzioni: 360p, 720p, 1080p, 4K
- Proporzioni: 16:9, 9:16
Ideale per:
- Video esplicativi e tipografia cinetica con testo leggibile
- Movimenti fisicamente realistici con soggetti coerenti tra i riferimenti
Costo: varia in base alle impostazioni selezionate e alla durata
Gemini Omni Flash 1.1 Extend
Prosegue un video esistente dal punto in cui termina usando Gemini Omni Flash 1.1, per una durata complessiva fino a 40 secondi.
Input di generazione:
- Video da estendere (obbligatorio, fino a 30 s)
- Prompt testuale che descrive il proseguimento
Funzionalità:
- Durata dell’estensione da 3 s a 10 s
- Le proporzioni seguono il video di input
- Creazione in batch con fino a 4 generazioni alla volta
Opzioni di output:
- Risoluzioni: 360p, 720p, 1080p, 4K
Ideale per:
- Allungare le generazioni di Gemini Omni Flash senza un taglio visibile
- Creare sequenze più lunghe di quanto consenta una singola generazione
Costo: varia in base alle impostazioni selezionate e alla durata
Gemini Omni Flash
Il primo modello video Gemini Omni: movimento che tiene conto della fisica, audio nativo e il miglior rendering di testo sullo schermo tra i modelli video disponibili, a 720p.
Input di generazione:
- Da testo a video
- Riferimenti immagine (fino a 8)
- Riferimento video (1, fino a 10 s)
Funzionalità:
- Durate fisse da 3 s a 10 s; la durata segue il video di riferimento quando ne viene allegato uno
- Nessun frame iniziale o finale; usa invece i riferimenti immagine per fissare un soggetto
- Creazione in batch con fino a 4 generazioni alla volta
Opzioni di output:
- Risoluzioni: 720p
- Proporzioni: 16:9, 9:16
Ideale per:
- Didascalie brevi, titoli e video esplicativi con etichette
- Coerenza tra più immagini a 720p
Costo: varia in base alle impostazioni selezionate e alla durata
Seedance 1.5 Pro
Un modello specializzato avanzato per creare sequenze dinamiche ad alta fedeltà, con maggiore stabilità temporale e un controllo preciso delle transizioni tra keyframe.
Input di generazione:
- Text-to-Video
- Frame iniziale
- Frame finale
Funzionalità:
- Collega perfettamente i frame iniziale e finale per sequenze coerenti con più inquadrature
- Modellazione ad alta fedeltà di azioni complesse e coerenza ambientale
- Supporta durate di generazione fisse da 4 s a 12 s
- Genera fino a 4 varianti alla volta
- Supporto nativo per l’audio attivato o disattivato per ogni generazione
Opzioni di output:
- Risoluzioni: 420p, 720p
- Proporzioni: 21:9, 16:9, 4:3, 1:1, 3:4, 9:16
Ideale per:
- Storytelling e scene d’azione che richiedono una fisica stabile tra specifici riferimenti visivi
- Transizioni cinematografiche e risorse video professionali con requisiti rigorosi per inizio e fine
Costo: varia in base alle impostazioni selezionate e alla durata
Seedance 1.5 Pro è deprecato. ByteDance ritirerà il modello l’11 novembre 2026 e non è più disponibile per nuove generazioni. Usa invece un modello Seedance 2.0. Seedance 1.5 Pro non è disponibile negli Stati Uniti.
FLUX 3
Il modello video di Black Forest Labs con movimenti naturali, scene con più inquadrature, audio generato ed estensione video.
Input di generazione:
- Text-to-Video
- Frame iniziale
- Frame finale
- Video da estendere (1, fino a 15 s)
Funzionalità:
- L’estensione video è incompatibile con i frame iniziale e finale
- Durate di generazione flessibili da 5 s a 20 s
- Controllo nativo dell’audio con audio attivato o disattivato per ogni generazione
- Creazione in batch con fino a 4 generazioni alla volta
Opzioni di output:
- Risoluzioni: 720p, 1080p
- Proporzioni: 21:9, 2:1, 16:9, 4:3, 1:1, 3:4, 9:16
Ideale per:
- Scene con più inquadrature da un singolo prompt
- Estendere una clip esistente mantenendo movimenti e audio coerenti
Costo: varia in base alle impostazioni selezionate e alla durata
FLUX 3 Edit
Modifica un video esistente a partire da un prompt testuale. Durata e inquadratura dell’output seguono il video sorgente, fino a 15 s.
Input di generazione:
- Video da modificare (obbligatorio, fino a 15 s)
- Prompt testuale che descrive le modifiche
Opzioni di output:
- Risoluzione e proporzioni corrispondono al video sorgente
Ideale per:
- Modifiche di filmati esistenti basate su prompt
Costo: varia in base alle impostazioni selezionate e alla durata
MiniMax H3
Il modello video di punta di MiniMax con riferimenti multimodali, audio generato e output fino a 4K.
Input di generazione:
- Text-to-Video
- Frame iniziale
- Frame finale
- Riferimenti immagine (fino a 9)
- Riferimenti video (fino a 3, da 2 s a 15 s ciascuno, 15 s complessivi)
- Riferimenti audio (fino a 3, da 2 s a 15 s ciascuno, 15 s complessivi)
Funzionalità:
- Limite combinato di 12 riferimenti per generazione; i riferimenti audio richiedono almeno un riferimento immagine o video
- Frame e riferimenti sono incompatibili tra loro
- Durate di generazione flessibili da 5 s a 15 s
- Genera audio sincronizzato
- Creazione in batch con fino a 4 generazioni alla volta
Opzioni di output:
- Risoluzioni: 480p, 768p, 2K, 4K (2K e 4K sono ottenute tramite upscaling da 768p)
- Proporzioni: 21:9, 16:9, 4:3, 1:1, 3:4, 9:16
Ideale per:
- Scene guidate da riferimenti che richiedono output ad alta risoluzione
- Clip di dialogo guidate da audio di riferimento
Costo: varia in base alle impostazioni selezionate e alla durata
MiniMax H3 non è disponibile negli Stati Uniti.
MiniMax H3 Max
Una variante quasi istantanea di MiniMax H3 con gli stessi input e una forte resa estetica, renderizzata nativamente fino a 768p.
Input di generazione:
- Text-to-Video
- Frame iniziale
- Frame finale
- Riferimenti immagine (fino a 9)
- Riferimenti video (fino a 3, da 2 s a 15 s ciascuno, 15 s complessivi)
- Riferimenti audio (fino a 3, da 2 s a 15 s ciascuno, 15 s complessivi)
Funzionalità:
- Limite combinato di 12 riferimenti per generazione; i riferimenti audio richiedono almeno un riferimento immagine o video
- Frame e riferimenti sono incompatibili tra loro
- Durate di generazione flessibili da 5 s a 15 s
- Genera audio sincronizzato
- Creazione in batch con fino a 4 generazioni alla volta
Opzioni di output:
- Risoluzioni: 480p, 768p
- Proporzioni: 21:9, 16:9, 4:3, 1:1, 3:4, 9:16
Ideale per:
- Iterazioni rapide su prompt e riferimenti
- Anteprime prima del rendering con MiniMax H3
Costo: varia in base alle impostazioni selezionate e alla durata
MiniMax H3 Max non è disponibile negli Stati Uniti.
MiniMax H3 Max Recast
Sostituisce le persone in un video sorgente usando da 1 a 4 foto. La durata segue quella della sorgente, fino a 30 s, e l’audio originale viene mantenuto.
Input di generazione:
- Video sorgente (fino a 30 s)
- Foto delle persone da sostituire (da 1 a 4)
Funzionalità:
- La durata dell’output segue il video sorgente
- Mantiene l’audio sorgente
Opzioni di output:
- Risoluzioni: fino a 1080p
- Le proporzioni seguono il video sorgente
Ideale per:
- Sostituire le persone in filmati esistenti con soggetti tratti da foto di riferimento
Costo: varia in base alle impostazioni selezionate e alla durata
Kling O1
Un modello video di ragionamento all’avanguardia progettato per un’aderenza superiore ai prompt e simulazioni complesse del mondo fisico, che usa un’elaborazione logica avanzata per interpretare ed eseguire istruzioni articolate.
Input di generazione:
- Text-to-Video (descrizione)
- Frame iniziale e frame finale
- Riferimento video
- Riferimento immagine
Funzionalità:
- Capacità eccezionale di interpretare prompt multilivello ed eseguire azioni cronologiche complesse
- Usa immagini e video come ancore visive per mantenere un’elevata coerenza di personaggi e scene
- Modellazione superiore di interazioni fisiche, rapporti di causa-effetto e dinamica dei fluidi
- Supporta generazioni di alta qualità per clip da 5 s e 10 s
- Genera fino a 4 varianti alla volta
Opzioni di output:
- Risoluzioni: dipendono dall’input
- Proporzioni: 16:9, 1:1, 9:16
Ideale per:
- Concetti creativi molto specifici che richiedono un’aderenza precisa a descrizioni lunghe e dettagliate
- Storytelling professionale in cui il realismo fisico e la coerenza tra più riferimenti sono fondamentali
Costo: varia in base alle impostazioni selezionate e alla durata
Kling O1 non è disponibile negli Stati Uniti.
Kling O1 Edit
Un modello di editing video-to-video guidato dal linguaggio naturale che consente trasformazioni visive complesse, come la sostituzione di personaggi e il cambio di ambientazione, senza mascherature manuali né regolazioni fotogramma per fotogramma.
Input di generazione:
- Video sorgente
- Riferimenti immagine (fino a 4 elementi/angolazioni distinti)
- Descrizione testuale (istruzioni in linguaggio naturale)
Funzionalità:
- Interpreta prompt conversazionali per sostituire soggetti o ambientazioni rispettando la struttura del movimento originale
- Mantiene angolazioni della camera, schemi di movimento e relazioni spaziali originali durante la modifica
- Combina fino a 4 elementi totali, incluse immagini frontali e da più angolazioni, per garantire un’elevata coerenza dei personaggi
- Opzione per mantenere l’audio sorgente originale o generare un output senza audio per ogni generazione
- Genera fino a 4 varianti modificate alla volta
Opzioni di output:
- Risoluzioni: dipendono dal video sorgente
- Proporzioni: corrispondono al video sorgente
Ideale per:
- Sostituzione ad alta fedeltà di personaggi in filmati esistenti, mantenendo i movimenti originali
- Trasformazioni complete dell’ambiente della scena, ad esempio da una città di giorno a un paesaggio notturno futuristico
- Applicare trasferimenti di stile che richiedono una rigorosa aderenza alle dinamiche di camera esistenti
Costo: varia in base alla durata del video e alle impostazioni selezionate
Kling O1 Edit non è disponibile negli Stati Uniti.
Kling 2.6 Motion Control
Un modello specializzato per il trasferimento preciso del movimento, che ti consente di animare un’immagine di un personaggio con un video di riferimento per replicare movimenti, gesti e angolazioni della camera specifici.
Input di generazione:
- Immagine del personaggio (sorgente)
- Video del movimento (riferimento)
- Descrizione testuale (facoltativa)
Funzionalità:
- Scegli “Match Video” per una replica esatta del movimento o “Match Image” per aggiungere nuovi movimenti creativi a un personaggio
- Supporta fino a 30 s in modalità Match Video e 10 s in modalità Match Image
- Mappatura ad alta fedeltà del movimento umano da filmati di riferimento a un personaggio statico
- Supporto nativo per attivare o disattivare l’audio per ogni generazione
- Genera fino a 4 varianti alla volta
Opzioni di output:
- Risoluzioni: dipendono dalla sorgente
- Proporzioni: dipendono dalla sorgente
Ideale per:
- Replicare coreografie complesse o movimenti specifici su un personaggio personalizzato
- Animazioni di personaggi di lunga durata che richiedono un’elevata fedeltà del movimento
- Contenuti per i social media guidati dai movimenti dei video di tendenza
Costo: varia in base alle impostazioni selezionate e alla durata
Kling 2.6 Motion Control non è disponibile negli Stati Uniti.
Kling 3.0 Motion Control
Un modello specializzato per il trasferimento preciso del movimento basato sull’architettura Kling 3.0, che ti consente di animare un’immagine di un personaggio con un video di riferimento per replicare movimenti, gesti e angolazioni della camera specifici con maggiore fedeltà.
Input di generazione:
- Immagine del personaggio (sorgente)
- Video del movimento (riferimento)
- Descrizione testuale (facoltativa)
Funzionalità:
- Scegli “Match Video” per una replica esatta del movimento o “Match Image” per aggiungere nuovi movimenti creativi a un personaggio
- Supporta fino a 30 s in modalità Match Video e 10 s in modalità Match Image
- Mappatura ad alta fedeltà del movimento umano da filmati di riferimento a un personaggio statico
- Supporto nativo per attivare o disattivare l’audio per ogni generazione
- Genera fino a 4 varianti alla volta
Opzioni di output:
- Risoluzioni: dipendono dalla sorgente
- Proporzioni: dipendono dalla sorgente
Ideale per:
- Replicare coreografie complesse o movimenti specifici su un personaggio personalizzato
- Animazioni di personaggi di lunga durata che richiedono un’elevata fedeltà del movimento
- Contenuti per i social media guidati dai movimenti dei video di tendenza
Costo: varia in base alle impostazioni selezionate e alla durata
Kling 3.0 Motion Control non è disponibile negli Stati Uniti.
Kling 2.6
Un modello generativo ottimizzato progettato per una maggiore fedeltà del movimento e transizioni più fluide, che bilancia iterazioni ad alta velocità e output visivo di qualità produttiva.
Input di generazione:
- Text-to-Video
- Frame iniziale (Image-to-Video)
Funzionalità:
- Dinamica del movimento migliorata: miglioramenti significativi nella fluidità dei movimenti e nelle interazioni fisiche realistiche
- Controllo flessibile dell’audio: supporto nativo per attivare o disattivare l’audio per ogni generazione
- Creazione in batch: genera fino a 4 varianti contemporaneamente
- Perfezionamento granulare: controllo creativo avanzato grazie al supporto dei prompt negativi
- Durate fisse: supporta durate di generazione di 5 s e 10 s
Opzioni di output:
- Risoluzioni: dipendono dall’input
- Proporzioni: 16:9, 1:1, 9:16
Ideale per:
- Clip ricche d’azione che richiedono movimenti fluidi dei personaggi
- Contenuti professionali per i social media con elevata aderenza ai prompt
Costo: varia in base alle impostazioni selezionate e alla durata
Kling 2.6 non è disponibile negli Stati Uniti.
Kling 2.5
Un modello equilibrato e versatile per la generazione di video Full HD di alta qualità.
Input di generazione:
- Text-to-Video
- Frame iniziale
Funzionalità:
- Eccelle nella simulazione di movimenti complessi e fisica realistica
- Modella accuratamente la dinamica dei fluidi e le espressioni
- Durate fisse: 5 s e 10 s
- Creazione in batch con fino a 4 generazioni alla volta
Opzioni di output:
- Risoluzioni: 1080p
- Proporzioni: 16:9, 1:1, 9:16
Ideale per:
- Simulazioni fisiche realistiche e movimenti complessi
Costo: varia in base alle impostazioni selezionate e alla durata
Il frame finale non è attualmente supportato. Non puoi fornire riferimenti immagine. Il controllo dell’audio non è disponibile.
Kling 2.5 non è disponibile negli Stati Uniti.
Runway Gen-4.5
Qualità del movimento, aderenza ai prompt e fedeltà visiva all’avanguardia per video cinematografici e altamente realistici.
Input di generazione:
- Text-to-Video
- Frame iniziale (Image-to-Video)
Funzionalità:
- Qualità del movimento eccezionale, con realismo e simulazione fisica leader del settore
- Aderenza superiore ai prompt per un controllo creativo preciso delle scene complesse
- Elevata fedeltà visiva per output di qualità cinematografica
- Genera fino a 4 varianti contemporaneamente
Opzioni di output:
- Risoluzioni: 720p
- Proporzioni: 16:9, 9:16
Ideale per:
- Contenuti cinematografici che richiedono la massima qualità e realismo del movimento
- Produzioni professionali che richiedono un’aderenza precisa ai prompt
- Storytelling visivo ad alta fedeltà
Costo: varia in base alle impostazioni selezionate e alla durata
Runway Gen-4 Turbo
Un modello video avanzato progettato per iterazioni rapide e creazione conveniente, in grado di produrre video di alta qualità.
Input di generazione:
- Text-to-Video
- Frame iniziale (Image-to-Video)
Funzionalità:
- Ottimizzato per una generazione ultrarapida, con risultati fino a quattro volte più veloci rispetto alle iterazioni precedenti
- Consente di dirigere con precisione movimenti dei personaggi, angolazioni della camera e composizioni delle scene
- Eccelle nel mantenere coerenza e stabilità visiva nelle scene dinamiche
- Supporta durate di generazione da 2 s a 10 s
- Genera fino a 4 varianti contemporaneamente
Opzioni di output:
- Risoluzioni: 720p
- Proporzioni: 21:9, 16:9, 4:3, 1:1, 3:4, 9:16
Ideale per:
- Prototipazione rapida e sperimentazione creativa che richiedono feedback quasi istantanei
- Progetti professionali che richiedono tempi di consegna rapidi per risorse di marketing ad alta risoluzione
- Contenuti cinematografici con requisiti specifici di movimento della camera
Costo: varia in base alle impostazioni selezionate e alla durata
Runway Gen-4 Aleph
Un modello video in-context all’avanguardia progettato per la generazione visiva multi-attività, in grado di eseguire modifiche complesse mantenendo la struttura di base dei filmati sorgente.
Input di generazione:
- Video sorgente
- Immagine di riferimento
- Descrizione testuale
Funzionalità:
- Aggiungi, rimuovi o trasforma senza difficoltà oggetti e soggetti all’interno di una scena, con illuminazione, ombre e prospettiva naturali
- Modifica luoghi, stagioni e momenti della giornata, ad esempio trasformando filmati nuvolosi in un tramonto suggestivo, con aggiornamenti realistici della temperatura colore
- Modifica l’età e l’aspetto degli attori oppure cambia la texture di abiti e soggetti tramite semplici prompt in linguaggio naturale
- Applica a un’immagine statica il movimento e il percorso della camera specifici di un video di riferimento, per un controllo preciso dell’animazione
- Genera angolazioni della camera completamente nuove, come inquadrature inverse o dal basso, da una singola sequenza video esistente
- Include green screen preciso, con isolamento e rilevamento dei bordi, generazione dell’inquadratura successiva per continuare la storia e trasferimento di stile estetico
- Genera fino a 4 varianti contemporaneamente
Opzioni di output:
- Risoluzioni: 720p
- Proporzioni: automatiche
Ideale per:
- Attività professionali di effetti visivi come ringiovanimento digitale, nuova illuminazione e rimozione di oggetti
- Prototipazione cinematografica rapida e generazione di copertura alternativa della camera da una singola inquadratura
- Contenuti di marketing creativi che richiedono trasformazioni ambientali o stilistiche radicali
Costo: varia in base alle impostazioni selezionate e alla durata
Runway Aleph 2.0
Il modello di editing video di Runway: trasforma un video esistente verso un aspetto di destinazione preservando movimento e coerenza.
Input:
- Video sorgente (obbligatorio, da 2 s a 30 s)
- Immagine dell’aspetto di destinazione (obbligatoria)
- Prompt testuale che descrive le modifiche
Funzionalità:
- Durata e inquadratura dell’output seguono il video sorgente
- Trasferimento di stile guidato dall’immagine dell’aspetto di destinazione
- Creazione in batch con fino a 4 generazioni alla volta
Ideale per:
- Modificare illuminazione, stile o ambientazione di filmati esistenti
- Applicare l’aspetto di un’immagine di riferimento a un’intera clip
Costo: varia in base alle impostazioni selezionate e alla durata
Runway Act-Two
Un modello specializzato nel trasferimento delle performance che anima i personaggi mappando movimento, parlato ed espressioni facciali da un video guida su un’immagine o un video di riferimento del personaggio.
Input di generazione:
- Performance guida (video)
- Input del personaggio (immagine o video)
Funzionalità:
- Trasferisce espressioni facciali sfumate, lip-sync e audio sincronizzato direttamente da un attore sorgente a qualsiasi personaggio
- Aggiunge automaticamente movimenti secondari e leggere vibrazioni della camera alle immagini statiche dei personaggi per un aspetto più naturale
- Opzione precisa per attivare o disattivare i movimenti di corpo e mani quando usi un’immagine del personaggio
- Impostazioni regolabili per bilanciare performance emotive intense e coerenza visiva del personaggio
- Possibilità di modificare la voce del personaggio dopo la generazione mantenendo un allineamento perfetto con la performance guida
Opzioni di output:
- Risoluzioni: 720p
- Rapporti d’aspetto: Auto
Ideale per:
- Dare vita a ritratti statici di personaggi con movimenti e parlato umani realistici
- Animare personaggi non umani o avatar stilizzati con espressioni ad alta fedeltà
- Produrre rapidamente contenuti con volto parlante e gesti del corpo integrati
Costo: varia in base alle impostazioni selezionate e alla durata
Seedance 1 Pro
Un modello specializzato per creare sequenze dinamiche con più inquadrature, ampi movimenti e azione.
Input di generazione:
- Text-to-Video
- Frame iniziale
- Frame finale
Funzionalità:
- Fisica altamente stabile e transizioni fluide tra le inquadrature
- Durate fisse: 3s, 4s, 5s, 6s, 7s, 8s, 9s, 10s, 11s e 12s
- Creazione in batch con fino a 4 generazioni alla volta
- Massima flessibilità creativa con numerose opzioni di rapporto d’aspetto
Opzioni di output:
- Risoluzioni: 480p, 720p, 1080p
- Rapporti d’aspetto: 21:9, 16:9, 4:3, 1:1, 3:4, 9:16
Ideale per:
- Storytelling e scene d’azione che richiedono una fisica stabile
Costo: varia in base alle impostazioni selezionate e alla durata
Il rapporto d’aspetto e la risoluzione non influiscono sui crediti di generazione, mentre la durata sì.
Seedance 1 Pro non è disponibile negli Stati Uniti.
LTX Audio-to-Video
Un modello foundation basato su DiT progettato per generare video e audio sincronizzati in un unico passaggio, garantendo parlato coerente e movimento realistico.
Input di generazione:
- Text-to-Video
- Image-to-Video
- Audio-to-Video
- Depth-to-Video
Funzionalità:
- Genera simultaneamente dialoghi, movimenti labiali e audio ambientale per un allineamento perfetto senza strumenti esterni
- Scene dinamiche con movimento stabile, identità coerente e forte coerenza tra i frame
- Supporta la generazione sincronizzata ad alta fedeltà fino a 20 secondi
- Direzione creativa avanzata tramite supporto dettagliato dei prompt negativi
- Genera fino a 4 varianti alla volta
Opzioni di output:
- Risoluzioni: 720p, 1080p
- Rapporti d’aspetto: 16:9, 4:3, 1:1, 3:4, 9:16
Ideale per:
- Parlato coerente e performance espressive dei personaggi
- Contenuti narrativi che richiedono audio ambientale integrato e tempistiche coerenti
- Scene dinamiche con una logica di movimento complessa che tiene conto della camera
Costo: varia in base alle impostazioni selezionate e alla durata
LTX 2 Pro
Un modello generativo ad alta fedeltà ottimizzato per il massimo dettaglio visivo e la stabilità strutturale, capace di produrre output 4K di qualità professionale con movimenti fluidi.
Input di generazione:
- Text-to-Video
- Frame iniziale (Image-to-Video)
Funzionalità:
- Dà priorità alla qualità visiva e alla coerenza rispetto alla velocità, garantendo risultati stabili nelle sequenze estese
- Supporta 25 FPS e 50 FPS per movimenti eccezionalmente fluidi e professionali
- Generazione audiovisiva integrata con opzione per attivare o disattivare l’audio
- Progettato per gestire output nativi 1080p, 2k e 4k senza perdita di dettaglio
- Genera fino a 4 varianti alla volta
Opzioni di output:
- Risoluzioni: 1080p, 2k, 4k
- Frame rate: 25 FPS, 50 FPS
- Rapporto d’aspetto: 16:9 (predefinito)
- Durate: 6s, 8s, 10s
Ideale per:
- Produzioni cinematografiche ad alta risoluzione che richiedono nitidezza 4K
- Contenuti professionali che necessitano di movimenti fluidi a 50 FPS
- Sequenze dettagliate in cui stabilità visiva e integrità strutturale sono essenziali
Costo: varia in base alle impostazioni selezionate e alla durata
LTX 2 Retake
Uno strumento di regia IA di precisione che consente di reindirizzare selettivamente dialoghi, emozioni e azioni nelle inquadrature esistenti senza interrompere la continuità né rigenerare l’intera sequenza.
Input di generazione:
- Video sorgente
- Descrizione testuale
Funzionalità:
- Modifica segmenti specifici mantenendo un’elevata conservazione del contesto dei frame circostanti
- Riformula le battute mantenendo coerenti voce, performance e ambiente del personaggio
- Più modalità di modifica: seleziona tra “Audio & Video”, “Solo audio” o “Solo video” per isolare e rigenerare elementi specifici dell’inquadratura
- I nuovi contenuti ereditano naturalmente movimento, illuminazione e tono originali per transizioni fluide
- Sperimenta subito reazioni alternative dei personaggi, momenti emotivi o movimenti della camera all’interno di una singola inquadratura
- Genera fino a 4 varianti simultaneamente per un confronto creativo affiancato
Opzioni di output:
- Rapporti d’aspetto: solo 16:9
Ideale per:
- Adattare script e perfezionare i dialoghi senza riprese o registrazioni aggiuntive
- Correggere momenti emotivi o problemi di ritmo in post-produzione
- Testare più messaggi del brand e call-to-action in un singolo contenuto di marketing
Costo: varia in base alle impostazioni selezionate e alla durata
LTX 2 Fast
Un modello generativo ottimizzato per la velocità, progettato per cicli di feedback rapidi e creazione di contenuti ad alta velocità, con immagini ad alta risoluzione e tempi di rendering significativamente ridotti.
Input di generazione:
- Text-to-Video
- Frame iniziale (Image-to-Video)
Funzionalità:
- Progettato per velocità e iterazioni rapide, consente esperimenti visivi veloci e anteprime quasi istantanee
- Supporta output nativi 1080p, 2k e 4k con un overhead computazionale inferiore rispetto al modello Pro
- Supporta 25 FPS e 50 FPS per movimenti fluidi ad alta velocità
- Consente la generazione rapida di contenuti audiovisivi sincronizzati fino a 20 secondi
- Supporto nativo per attivare o disattivare l’audio per ogni generazione
- Genera fino a 4 varianti simultaneamente
Opzioni di output:
- Risoluzioni: 1080p, 2k, 4k
- Frame rate: 25 FPS, 50 FPS
- Rapporto d’aspetto: 16:9 (predefinito)
- Durate: 6s, 8s, 10s, 12s, 14s, 16s, 18s, 20s
Ideale per:
- Prototipazione rapida ed esplorazione creativa in cui la velocità è prioritaria rispetto al massimo dettaglio
- Contenuti social ad alto volume che richiedono tempi di consegna rapidi
- Test A/B di diversi concetti visivi e stili di movimento
Costo: varia in base alle impostazioni selezionate e alla durata
Wan 3.0
Un modello video cinematografico con riferimenti a immagini, video e audio, audio generato e generazioni fino a 30 secondi.
Input di generazione:
- Text-to-Video
- Frame iniziale
- Frame finale
- Riferimenti immagine (fino a 10)
- Riferimenti video (fino a 5, 15s complessivi)
- Riferimenti audio (fino a 5, 15s complessivi)
Funzionalità:
- Frame e riferimenti si escludono a vicenda
- Durate fisse: 5s, 10s, 15s, 20s e 30s
- Controllo audio nativo con audio attivato o disattivato per ogni generazione
- Miglioramento opzionale del prompt
- Creazione in batch con fino a 4 generazioni alla volta
Opzioni di output:
- Risoluzioni: 480p, 720p, 1080p
- Rapporti d’aspetto: Auto, 16:9, 4:3, 1:1, 3:4, 9:16
Ideale per:
- Inquadrature cinematografiche più lunghe con forte aderenza al prompt
- Scene basate su riferimenti con audio
Costo: varia in base alle impostazioni selezionate e alla durata
Wan 3.0 non è disponibile negli Stati Uniti.
Wan 3.0 Prime
Una variante più rapida di Wan 3.0 con gli stessi input e opzioni di output, adatta all’ideazione.
Input di generazione:
- Text-to-Video
- Frame iniziale
- Frame finale
- Riferimenti immagine (fino a 10)
- Riferimenti video (fino a 5, 15s complessivi)
- Riferimenti audio (fino a 5, 15s complessivi)
Funzionalità:
- Tempo di generazione pari a circa la metà di Wan 3.0
- Durate fisse: 5s, 10s, 15s, 20s e 30s
- Controllo audio nativo con audio attivato o disattivato per ogni generazione
- Creazione in batch con fino a 4 generazioni alla volta
Opzioni di output:
- Risoluzioni: 480p, 720p, 1080p
- Rapporti d’aspetto: Auto, 16:9, 4:3, 1:1, 3:4, 9:16
Ideale per:
- Esplorare idee prima di un rendering finale con Wan 3.0
- Workflow sensibili ai tempi di consegna
Costo: varia in base alle impostazioni selezionate e alla durata
Wan 3.0 Prime non è disponibile negli Stati Uniti.
Wan 2.6
Una piattaforma video cinematografica di nuova generazione che usa un’architettura multimodale unificata per offrire contenuti 1080p pronti per la produzione, con sincronizzazione audio nativa e sequenze multi-inquadratura intelligenti.
Input di generazione:
- Text-to-Video
- Frame iniziale (Image-to-Video)
- Riferimento video (Video-to-Video)
- Riferimento audio (audio di sottofondo o dialogo opzionale)
Funzionalità:
- Sistema multimodale unificato: elabora testo, immagini, video e audio tramite un unico framework integrato per una qualità di output coerente
- Sincronizzazione audio nativa: genera e allinea automaticamente dialoghi, narrazione ed effetti sonori ambientali ai movimenti sullo schermo
- Sequenze multi-inquadratura intelligenti: organizza automaticamente sequenze video collegate in archi narrativi coerenti mantenendo la coerenza dei personaggi
- Durate estese: supporta una generazione stabile e di alta qualità per durate fisse di 5s, 10s e 15s
- Controllo creativo avanzato: supporta prompt negativi per la gestione dettagliata e la creazione in batch di fino a 4 varianti
Opzioni di output:
- Risoluzioni: 720p, 1080p
- Rapporti d’aspetto: 16:9, 4:3, 1:1, 3:4, 9:16
Ideale per:
- Storytelling narrativo professionale e complesse sequenze cinematografiche multi-inquadratura
- Annunci per i social e contenuti di marketing che richiedono audio integrato ad alta fedeltà
- Contenuti incentrati sui personaggi che richiedono rigorosa coerenza visiva e di movimento tramite riferimenti video
Costo: varia in base alle impostazioni selezionate e alla durata
Wan 2.6 non è disponibile negli Stati Uniti.
Wan 2.5 Video
Un modello versatile che offre movimenti cinematografici e alta fedeltà al prompt da testo o da un’immagine iniziale.
Input di generazione:
- Text-to-Video
- Frame iniziale (Image-to-Video)
Funzionalità:
- Controllo creativo dettagliato con prompt negativi e controllo audio dedicato
- Durate fisse: 5s e 10s
- Creazione in batch con fino a 4 generazioni alla volta
Opzioni di output:
- Risoluzioni: 480p, 720p, 1080p
- Rapporti d’aspetto: 16:9, 1:1, 9:16
Ideale per:
- Contenuti cinematografici con forte aderenza al prompt
Costo: varia in base alle impostazioni selezionate e alla durata
Il costo di generazione varia in base alle impostazioni selezionate.
Wan 2.5 Video non è disponibile negli Stati Uniti.
Modelli generativi di immagini
GPT Image 2.5 Sunburst
Il modello di immagini di OpenAI pronto per la produzione, per output molto dettagliati e modifiche precise.
Input di generazione:
- Text-to-Image
- Riferimenti immagine (fino a 10)
Funzionalità:
- Cinque livelli di qualità, da Bassa a Massima
- Risoluzione personalizzata fino a 3840px per lato, con rapporti d’aspetto fino a 3:1
- Creazione in batch con fino a 4 generazioni alla volta
Opzioni di output:
- Risoluzioni: 1K, 2K, 4K o personalizzata
- Rapporti d’aspetto: 3:1, 21:9, 2:1, 16:9, 3:2, 4:3, 5:4, 1:1, 4:5, 3:4, 2:3, 9:16, 1:2, 1:3
Ideale per:
- Asset finali in cui dettaglio e fedeltà sono fondamentali
- Modifiche precise a immagini esistenti
Costo: varia in base alle impostazioni selezionate e al numero di varianti
GPT Image 2.5 Flare
Una variante rapida di GPT Image 2.5 con gli stessi controlli di Sunburst, ottimizzata per generazioni quotidiane ad alto volume.
Input di generazione:
- Text-to-Image
- Riferimenti immagine (fino a 10)
Funzionalità:
- Cinque livelli di qualità, da Bassa a Massima
- Risoluzione personalizzata fino a 3840px per lato, con rapporti d’aspetto fino a 3:1
- Creazione in batch con fino a 4 generazioni alla volta
Opzioni di output:
- Risoluzioni: 1K, 2K, 4K o personalizzata
- Rapporti d’aspetto: 3:1, 21:9, 2:1, 16:9, 3:2, 4:3, 5:4, 1:1, 4:5, 3:4, 2:3, 9:16, 1:2, 1:3
Ideale per:
- Generazione di immagini ad alto volume
- Iterazioni rapide che richiedono comunque 4K e dimensioni personalizzate
Costo: varia in base alle impostazioni selezionate e al numero di varianti
API: gpt-image-2.5-flare
GPT Image 2
Un modello IA avanzato progettato per la generazione precisa di immagini, con rendering del testo migliorato e funzionalità di output ad alta risoluzione.
Funzionalità:
- Controllo preciso del testo per creare immagini con tipografia accurata e nitida
- Output PNG ad alta risoluzione adatto all’uso professionale e commerciale
- Supporta più riferimenti immagine per guidare stile e composizione
- Genera fino a 4 immagini alla volta
Opzioni di output:
- Rapporti d’aspetto: 3:2, 1:1, 2:3
- Opzioni di qualità: bassa, media, alta
Ideale per:
- Immagini di marketing e asset di design che richiedono un posizionamento preciso del testo
- Contenuti professionali con requisiti di alta risoluzione
- Progetti creativi che richiedono un controllo accurato delle immagini basato sul testo
Costo: varia in base alle impostazioni selezionate e al numero di varianti
API: gpt-image-2
Nano Banana 2.1
Un modello di immagini con output 4K nativo e fino a 14 riferimenti immagine.
Input di generazione:
- Text-to-Image
- Riferimenti immagine (fino a 14)
Opzioni di output:
- Risoluzioni: 4K
- Rapporti d’aspetto: da 8:1 a 1:8 e auto
Ideale per:
- Immagini guidate da riferimenti che richiedono il 4K nativo
Costo: varia in base alle impostazioni selezionate e al numero di varianti
Nano Banana 2
Un modello avanzato di generazione di immagini IA che combina qualità pronta per la produzione ed elaborazione ultraveloce, con una migliore conoscenza del mondo e coerenza dei soggetti.
Funzionalità:
- Output a risoluzione 4K nativa senza upscaling, per dettagli estremamente nitidi
- Generazione di immagini ultrarapida in appena 1-2 secondi
- Maggiore aderenza al prompt grazie a ragionamento avanzato e rispetto delle istruzioni
- Rendering nitido e accurato del testo in più lingue per mockup, segnaletica e infografiche
- Stile coerente per più soggetti, che preserva l’identità di più personaggi e oggetti
- Migliore conoscenza del mondo per una generazione delle scene più accurata
- Supporta più riferimenti immagine per guidare la generazione
- Genera fino a 4 immagini alla volta
Opzioni di output:
- Rapporti d’aspetto: 21:9, 16:9, 5:4, 4:3, 3:2, 1:1, 2:3, 3:4, 4:5, 9:16
- Risoluzioni: fino a 4K
Ideale per:
- Workflow creativi rapidi che richiedono iterazioni in tempo reale
- Contenuti del brand e storytelling con identità dei personaggi coerente
- Immagini professionali con testo e tipografia accurati
Costo: varia in base alle impostazioni selezionate e al numero di varianti
Nano Banana 2 Lite
Una variante rapida ed economica di Nano Banana 2 per generazione e modifica veloci in 1K.
Input di generazione:
- Text-to-Image
- Riferimenti immagine (fino a 14)
Funzionalità:
- Output 1K fisso per velocità e costi coerenti
- Stessa capacità di 14 riferimenti immagine di Nano Banana 2
- Creazione in batch con fino a 4 generazioni alla volta
Opzioni di output:
- Risoluzioni: 1K
- Rapporti d’aspetto: 21:9, 16:9, 5:4, 4:3, 3:2, 1:1, 2:3, 3:4, 4:5, 9:16
Ideale per:
- Iterazioni rapide e bozze
- Modifiche in blocco per cui 1K è sufficiente
Costo: varia in base alle impostazioni selezionate e al numero di varianti
Krea 2 Medium
Un modello versatile di generazione di immagini pronto per la produzione di Krea AI, che bilancia qualità e velocità per un’ampia gamma di workflow creativi.
Funzionalità:
- Generazione di immagini ad alta fedeltà con forte aderenza al prompt
- Supporta più riferimenti immagine per guidare la generazione
- Genera fino a 4 immagini alla volta
Opzioni di output:
- Rapporti d’aspetto: 16:9, 4:3, 1:1, 3:4, 9:16
Ideale per:
- Creazione di contenuti professionali che richiede una qualità coerente
- Iterazioni rapide su diversi concetti creativi
Costo: varia in base alle impostazioni selezionate e al numero di varianti
Krea 2 Large
Il modello di punta di Krea AI per la generazione di immagini, offre massima fedeltà visiva e controllo creativo avanzato per workflow di produzione professionali.
Caratteristiche:
- Dettagli e realismo eccezionali per risultati di livello professionale
- Controllo avanzato dello stile con supporto per più immagini di riferimento
- Genera fino a 4 immagini alla volta
Opzioni di output:
- Proporzioni: 16:9, 4:3, 1:1, 3:4, 9:16
Ideale per:
- Produzione di immagini commerciali ed editoriali di alta gamma
- Composizioni creative complesse che richiedono la massima fedeltà
Costo: varia in base alle impostazioni selezionate e al numero di variazioni
Recraft V4.1
Un modello text-to-image incentrato sul design, con ottimo controllo dei prompt e composizioni pulite.
Input di generazione:
- Text-to-Image
Caratteristiche:
- L’output 2K usa la variante Pro del modello
- Creazione in batch con fino a 4 generazioni alla volta
Opzioni di output:
- Risoluzioni: 1K, 2K
- Proporzioni: 2:1, 16:9, 3:2, 14:10, 4:3, 5:4, 1:1, 4:5, 3:4, 10:14, 2:3, 6:10, 9:16, 1:2
Ideale per:
- Grafiche, icone e poster basati sul layout
- Composizioni pulite create solo dal testo
Costo: varia in base alle impostazioni selezionate e al numero di variazioni
Recraft V4.1 Flash
Un modello text-to-image veloce e incentrato sul design.
Input di generazione:
- Text-to-Image
Opzioni di output:
- Proporzioni: 16 rapporti
Ideale per:
- Grafiche basate sul layout create solo dal testo
Costo: varia in base alle impostazioni selezionate e al numero di variazioni
Recraft V4
Un modello di immagini incentrato sul design, in grado di riprodurre lo stile delle immagini di riferimento.
Input di generazione:
- Text-to-Image
- Riferimenti di stile (fino a 10)
Caratteristiche:
- Controllo della corrispondenza dello stile: Preciso segue fedelmente lo stile di riferimento, Flessibile riproduce l’aspetto generale
- L’output 2K usa la variante Pro del modello
- Creazione in batch con fino a 4 generazioni alla volta
Opzioni di output:
- Risoluzioni: 1K, 2K
- Proporzioni: 2:1, 16:9, 3:2, 14:10, 4:3, 5:4, 1:1, 4:5, 3:4, 10:14, 2:3, 6:10, 9:16, 1:2
Ideale per:
- Grafiche coerenti con il brand a partire da un set di riferimenti di stile
- Lavori di illustrazione e design
Costo: varia in base alle impostazioni selezionate e al numero di variazioni
Seedream 5 Lite
Un modello di immagini leggero e veloce di ByteDance che offre risultati di alta qualità con requisiti di elaborazione ridotti.
Caratteristiche:
- Generazione rapida per iterazioni creative veloci
- Supporta più immagini di riferimento per guidare la generazione
- Genera fino a 4 immagini alla volta
Opzioni di output:
- Proporzioni: 16:9, 4:3, 1:1, 3:4, 9:16
Ideale per:
- Workflow di creazione di immagini ad alto volume che richiedono velocità
- Esplorazione rapida di concetti e anteprime
Costo: varia in base alle impostazioni selezionate e al numero di variazioni
API: bytedance-seedream-5-lite
Seedream 5 Lite non è disponibile negli Stati Uniti.
Seedream 5 Pro
La variante Seedream 5 a maggiore fedeltà, per editing preciso, testo multilingue e infografiche dense.
Input di generazione:
- Text-to-Image
- Immagini di riferimento (fino a 10)
Caratteristiche:
- Rendering accurato del testo multilingue
- Gestisce layout densi come infografiche e poster
- Creazione in batch con fino a 4 generazioni alla volta
Opzioni di output:
- Risoluzioni: 1K, 2K
- Proporzioni: 16:9, 4:3, 1:1, 3:4, 9:16
Ideale per:
- Design ricchi di testo in più lingue
- Editing multi-immagine con rigorosa aderenza ai riferimenti
Costo: varia in base alle impostazioni selezionate e al numero di variazioni
Seedream 5 Pro non è disponibile negli Stati Uniti.
GPT Image 1.5
Un modello di punta ad alta velocità progettato per la generazione precisa di immagini basata sul testo e per l’editing fotografico complesso e non distruttivo, che preserva i dettagli originali.
Caratteristiche:
- Esegue in modo affidabile le modifiche richieste mantenendo l’integrità di illuminazione, composizione e aspetto dei soggetti nelle immagini sorgente
- Supporta attività di editing complesse, tra cui aggiunta, rimozione, combinazione e fusione di elementi
- Fornisce output fino a 4 volte più velocemente rispetto alle iterazioni precedenti
- Genera fino a 4 immagini alla volta
Opzioni di output:
- Proporzioni: 3:2, 1:1, 2:3
- Opzioni di qualità: bassa, media, alta
Ideale per:
- Ritocchi fotografici pratici e prove virtuali realistiche di abbigliamento o acconciature
- Trasformazioni concettuali e filtri stilistici che mantengono l’essenza dell’immagine di input
- Iterazione rapida di concetti text-to-image
Costo: varia in base alle impostazioni selezionate e al numero di variazioni
API: gpt-image-1.5
GPT Image 1
Il modello di immagini di prima generazione di OpenAI, con buona aderenza ai prompt, testo leggibile ed editing dettagliato.
Input di generazione:
- Text-to-Image
- Immagini di riferimento (fino a 5)
Caratteristiche:
- Tre livelli di qualità: Bassa, Media, Alta
- Creazione in batch con fino a 4 generazioni alla volta
Opzioni di output:
- Proporzioni: 3:2, 1:1, 2:3
Ideale per:
- Workflow già basati sull’output di GPT Image 1
- Modifiche semplici e attività testo-in-immagine a risoluzione standard
Costo: varia in base alle impostazioni selezionate e al numero di variazioni
API: gpt-image-1
Seedream 4.5
Un modello di base multimodale ad alte prestazioni che riunisce sintesi text-to-image, editing preciso delle immagini e composizione complessa multi-immagine in un unico framework efficiente.
Caratteristiche:
- Supporto nativo per la generazione rapida di immagini ad alta fedeltà fino alla risoluzione 4K
- Conservazione eccezionale dei tratti del viso, dell’illuminazione, della tonalità cromatica e dei dettagli fini durante le attività di editing basate su riferimenti
- Identifica e fonde con precisione gli elementi target tra più immagini di input, per risultati controllabili e coerenti
- Offre capacità di composizione di livello professionale, con rendering chiaro e accurato di testi piccoli per poster e immagini del brand
- Genera fino a 4 immagini alla volta
Opzioni di output:
- Proporzioni: 16:9, 4:3, 1:1, 3:4, 9:16
- Risoluzioni: 2K, 4K
Ideale per:
- Workflow di graphic design professionale che richiedono layout e tipografia precisi
- Editing fotografico complesso che richiede rigorosa aderenza all’identità e all’illuminazione di riferimento
- Compositing creativo ad alta risoluzione che usa più fonti visive
Costo: varia in base alle impostazioni selezionate e al numero di variazioni
Seedream 4.5 non è disponibile negli Stati Uniti.
Kling O1 Image
Un modello di generazione di immagini ad alta fedeltà con capacità di ragionamento avanzate, progettato per un’aderenza superiore ai prompt e una precisa coerenza visiva nelle composizioni complesse.
Caratteristiche:
- Eccezionale capacità di interpretare ed eseguire descrizioni testuali articolate e multilivello con grande precisione
- Usa immagini di riferimento per mantenere l’identità del soggetto, l’illuminazione e lo stile estetico tra le generazioni
- Ottimizzato per texture realistiche, relazioni spaziali complesse ed effetti di illuminazione di livello professionale
- Genera fino a 4 immagini alla volta
Opzioni di output:
- Proporzioni: Auto, 16:9, 9:16, 1:1, 4:3, 3:4, 3:2, 2:3, 21:9
- Risoluzioni: 1K, 2K
Ideale per:
- Risorse creative professionali che richiedono rigorosa aderenza a prompt testuali dettagliati e tecnici
- Editing di immagini ad alta coerenza e character design con riferimenti visivi
Costo: varia in base alle impostazioni selezionate e al numero di variazioni
Kling O1 Image non è disponibile negli Stati Uniti.
FLUX.2 [Pro]
Un modello di generazione ed editing delle immagini di livello produttivo, progettato per workflow professionali e caratterizzato da qualità visiva all’avanguardia, velocità, precisione e coerenza.
Caratteristiche:
- Usa più immagini di riferimento contemporaneamente per ottenere una coerenza di personaggi e identità ai vertici del settore su centinaia di risorse
- Offre un salto senza precedenti nella qualità dei dettagli, riducendo il divario con la fotografia reale, dalle texture dei tessuti agli elementi architettonici
- Fornisce rendering del testo pronto per la produzione per tipografia complessa, mockup UI e infografiche
- Supporta la specifica precisa dei colori del brand tramite codici esadecimali senza approssimazioni
- Garantisce posizionamento accurato degli oggetti, fisica realistica, illuminazione coerente e prospettiva corretta nelle scene complesse
- Ottimizzato per maggiore precisione e reattività alle istruzioni strutturate e complesse
- Genera fino a 4 immagini alla volta
Opzioni di output:
- Proporzioni: 16:9, 4:3, 1:1, 3:4, 9:16
- Risoluzioni: 720p, 1080p, 2K
Ideale per:
- Realizzare campagne con personaggi coerenti e posizionare con precisione i prodotti in qualsiasi contesto
- Creare mockup di interfacce con testo leggibile e sistemi di design visivo coerenti
- Generare fotografie di prodotto su larga scala e scatti contestuali lifestyle
Costo: varia in base alle impostazioni selezionate e al numero di variazioni
Nano Banana Pro
Un modello professionale di generazione ed editing delle immagini basato sul ragionamento, progettato per produrre risorse ad alta fedeltà, offrire controllo creativo avanzato e seguire le istruzioni con precisione.
Input:
- Immagine di riferimento
- Descrizione testuale (supporta prompt complessi e multilivello)
Caratteristiche:
- Pianifica le scene prima del rendering per offrire illuminazione fisicamente accurata, relazioni precise tra gli oggetti e aderenza superiore ai prompt
- Genera testo multilingue nitido e leggibile in vari stili di font e calligrafia per poster e mockup di prodotto d’impatto
- Mantiene alta fedeltà e somiglianza per fino a 5 persone e più oggetti in diversi output creativi
- Integra Google Search per migliorare le immagini con dati reali, conoscenze del mondo reale e informazioni in tempo reale come meteo o sport
- Regola angolazioni della fotocamera, punti focali e illuminazione della scena, ad esempio trasformando il giorno in notte, con strumenti di editing locale avanzati
- La comprensione spaziale superiore consente di generare infografiche, diagrammi tecnici e slide di presentazione accurati
- Genera fino a 4 variazioni alla volta
Opzioni di output:
- Risoluzioni: 1K, 2K, 4K
- Proporzioni: Auto, 21:9, 16:9, 5:4, 4:3, 3:2, 1:1, 2:3, 3:4, 4:5, 9:16
Ideale per:
- Pubblicità professionale, risorse del brand e fotografia di prodotto e-commerce di alta gamma
- Contenuti didattici, infografiche basate sui dati e documentazione tecnica complessa
- Prototipazione rapida di design visivi ad alta risoluzione con identità coerente di personaggi o brand
Costo: varia in base alle impostazioni selezionate e al numero di variazioni
API: gemini-3-pro-image
Nano Banana
Un modello ad alta velocità per generare e modificare rapidamente immagini di alta qualità direttamente dai prompt testuali.
Caratteristiche:
- Supporta più immagini di riferimento per guidare la generazione
- Genera fino a 4 immagini alla volta
Opzioni di output:
- Proporzioni: 21:9, 16:9, 5:4, 4:3, 3:2, 1:1, 2:3, 3:4, 4:5, 9:16
Ideale per:
- Creazione e iterazione rapide di immagini
Costo: varia in base alle impostazioni selezionate e al numero di variazioni
Runway Gen-4 Image
Un modello base avanzato progettato per la generazione di immagini ad alta fedeltà, che offre un controllo stilistico senza precedenti e memoria visiva per mantenere la coerenza tra le scene.
Caratteristiche:
- Fissa personaggi, stili o oggetti specifici usando immagini di input per mantenere una coerenza di livello professionale tra più output
- Ottimizzato per interpretare descrizioni complesse in linguaggio naturale, offrendo un controllo preciso su dettagli visivi, illuminazione ed emozioni
- In grado di generare immagini di alta qualità per casi d’uso diversi, dagli storyboard cinematografici alla fotografia professionale di prodotto
- Genera fino a 4 immagini alla volta
Opzioni di output:
- Proporzioni: 16:9, 4:3, 1:1, 3:4, 9:16
- Risoluzioni: 720p, 1080p
Ideale per:
- Garantire che i protagonisti mantengano il proprio aspetto in ambienti e condizioni di illuminazione diverse
- Produrre rapidamente risorse del brand ad alta risoluzione, prove virtuali e visualizzazioni di prodotto pronte per la scalabilità
- Esplorare diverse direzioni artistiche mantenendo l’identità visiva centrale tramite immagini di riferimento
Costo: varia in base alle impostazioni selezionate e al numero di variazioni
Runway Gen-4 Image Turbo
Un modello di generazione di immagini ottimizzato per la velocità, che fornisce risultati 2,5 volte più rapidamente rispetto a Gen-4 Image standard mantenendo la stessa qualità di output.
Caratteristiche:
- L’elaborazione ottimizzata consente un’esplorazione creativa rapida e genera immagini ad alta fedeltà in una frazione del tempo
- Carica fino a tre immagini di riferimento per guidare la comprensione del modello di personaggi, ambienti e stili artistici specifici
- Risolve il problema della deriva visiva codificando caratteristiche visive specifiche dalle immagini di riferimento per mantenere l’identità tra più generazioni
- Applica facilmente l’estetica, l’illuminazione e la texture di un’immagine di riferimento a soggetti e scene completamente nuovi
- Usa i parametri seed per esplorare sistematicamente le variazioni o ricreare output specifici con precisione
- Genera fino a 4 immagini alla volta
Opzioni di output:
- Proporzioni: 16:9, 4:3, 1:1, 3:4, 9:16
- Risoluzioni: 720p, 1080p
Ideale per:
- Produrre rapidamente su larga scala immagini ottimizzate per Instagram Stories (9:16) o post standard (1:1)
- Mantenere una rigorosa identità visiva nelle campagne usando le linee guida di stile del brand come immagini di riferimento
- Sviluppare pose e ambientazioni coerenti dei personaggi, assicurando al contempo che il protagonista resti riconoscibile
- Creare con precisione scatti lifestyle e stagionali di prodotto diversi tramite riferimenti
Costo: varia in base alle impostazioni selezionate e al numero di variazioni
Seedream 4
Un modello di immagini specializzato per generare sequenze multi-inquadratura o scene con ampi movimenti e azione.
Caratteristiche:
- Eccelle nella creazione di immagini con fisica stabile e transizioni coerenti
- Supporta più immagini di riferimento per guidare la generazione
- Genera fino a 4 immagini alla volta
Opzioni di output:
- Proporzioni: auto, 16:9, 4:3, 1:1, 3:4, 9:16
Ideale per:
- Scene d’azione e composizioni dinamiche
Costo: varia in base alle impostazioni selezionate e al numero di variazioni
Seedream 4 non è disponibile negli Stati Uniti.
Wan 2.5 Image
La variante per immagini di Wan 2.5, con alta fedeltà ai prompt e supporto per immagini di riferimento.
Input di generazione:
- Text-to-Image
- Immagini di riferimento (fino a 2)
Caratteristiche:
- Controlli per prompt negativi e seed
- Creazione in batch con fino a 4 generazioni alla volta
Opzioni di output:
- Proporzioni: 16:9, 4:3, 1:1, 3:4, 9:16
Ideale per:
- Immagini fisse che corrispondono all’aspetto delle generazioni video Wan
- Immagini concettuali fedeli ai prompt
Costo: varia in base alle impostazioni selezionate e al numero di variazioni
Wan 2.5 Image non è disponibile negli Stati Uniti.
FLUX 3 Image
Un modello di immagini con fino a 10 immagini di riferimento e output 4K.
Input di generazione:
- Text-to-Image
- Immagini di riferimento (fino a 10)
Opzioni di output:
- Risoluzioni: 4K
- Proporzioni: 16 rapporti
Ideale per:
- Immagini 4K guidate da riferimenti
Costo: varia in base alle impostazioni selezionate e al numero di variazioni
FLUX.1 Kontext [Pro]
Un modello professionale per la generazione e l’editing avanzati di immagini, con elevata coerenza delle scene e controllo dello stile.
Caratteristiche:
- Controllo dello stile basato sulle immagini, che richiede un’immagine di riferimento per guidare l’estetica visiva
- Genera fino a 4 immagini alla volta
Opzioni di output:
- Proporzioni: 21:9, 16:9, 4:3, 3:2, 1:1, 2:3, 3:4, 4:5, 9:16, 9:21
Ideale per:
- Contenuti professionali con requisiti di stile precisi
Costo: varia in base alle impostazioni selezionate e al numero di variazioni
Modelli di lip-sync
Creatify Aurora
Un modello diffusion transformer (DiT) all’avanguardia, progettato per il rendering di avatar ultra-realistici e reattivi, guidati da audio e testo.
Input di generazione:
- Avatar (immagine sorgente)
- Parlato (file audio)
- Descrizione testuale (guida)
Funzionalità:
- Va oltre il lip-sync di base includendo battito di ciglia, respirazione ed espressioni facciali naturali basati sul contesto
- Sincronizza automaticamente i movimenti delle mani e di tutto il corpo in base al tono e all’inflessione della voce, per una performance di qualità da studio
- Interpreta con precisione l’intensità e l’intonazione vocale per offrire espressioni emotive fedeli alla performance
- Mantiene un’elevata fedeltà del personaggio e coerenza comportamentale anche durante dialoghi estesi o performance musicali
- Ottimizzato per varie configurazioni, incluse presentazioni con angolazione laterale, dialoghi in stile podcast e animazioni stilizzate
- Genera fino a 4 varianti alla volta
Opzioni di output:
- Risoluzioni: 480p, 720p
Ideale per:
- Annunci video professionali basati su avatar e contenuti di marketing
- Storytelling virtuale ad alta fedeltà e performance musicali espressive
- Video educativi o formativi di lunga durata che richiedono una presenza costante del personaggio
Costo: varia in base all’input, alle impostazioni e alla durata
API: creatify-aurora
Veed Fabric
Un modello rapido e preciso di lip-sync da immagine a video che anima un’immagine statica per adattarla all’audio fornito.
Input:
- Immagine sorgente
- File audio del parlato
Funzionalità:
- Anima la bocca e le espressioni facciali nell’immagine sorgente per adattarle all’audio fornito
- Crea video “parlanti” ad alta fedeltà da immagini statiche
- Strumento specifico per il lip-sync, non un modello completo di generazione video
Ideale per:
- Creare avatar parlanti da immagini statiche
- Aggiungere dialoghi a ritratti di personaggi
- Workflow professionali per contenuti basati su avatar
Costo: varia in base all’input, alle impostazioni e alla durata
Per risultati ottimali, l’immagine dovrebbe contenere una figura rilevabile.
HeyGen Avatar 4
L’ultimo modello di avatar di HeyGen per generare video con primo piano parlante altamente realistici ed espressivi a partire da una singola immagine e un input audio.
Input:
- Immagine sorgente
- File audio del parlato
Funzionalità:
- Anima le espressioni facciali e i movimenti delle labbra per adattarli all’audio fornito con elevata fedeltà
- Produce movimenti naturali della testa e microespressioni sottili per risultati realistici
- Strumento specifico per il lip-sync, non un modello completo di generazione video
Ideale per:
- Video professionali con portavoce e presentatori
- Creare contenuti personalizzati basati su avatar su larga scala
- Video di marketing e formazione con una presenza costante del personaggio
Costo: varia in base all’input, alle impostazioni e alla durata
Per risultati ottimali, l’immagine dovrebbe contenere un volto chiaramente visibile.
Sync 3
Il modello di lip-sync video di ultima generazione di Sync, che offre una sincronizzazione di qualità da studio per un’ampia gamma di tipi di contenuto.
Input di generazione:
- Video sorgente
- Audio del parlato
Funzionalità:
- Lip-sync ad alta precisione che preserva dettagli facciali unici, denti naturali e texture della pelle
- Ottimizzato per tutti i tipi di contenuto, inclusi live action, animazione 3D e video generati dall’IA
- Strumento di lip-sync da video a video, non un generatore video completo
Ideale per:
- Doppiaggio e localizzazione professionali per film e pubblicità
- Migliorare o correggere i dialoghi in qualsiasi formato video
- Workflow di traduzione di contenuti ad alto volume
Costo: varia in base all’input, alle impostazioni e alla durata
Per risultati ottimali, il video dovrebbe contenere una figura rilevabile.
Sync Lipsync 2 Pro
Un modello di editing video all’avanguardia progettato per un lip-sync di qualità da studio che preserva dettagli facciali unici, supportando al contempo output ad alta risoluzione.
Input di generazione:
- Video sorgente
- Audio del parlato
Funzionalità:
- Integra un upscaling avanzato per supportare output 4K mantenendo texture nitide e naturali
- Protegge caratteristiche facciali uniche come denti naturali, lentiggini, trucco e peli del viso complessi senza perdita di nitidezza
- Ottimizzato per funzionare con tutti i tipi di contenuto, inclusi live action, animazione 3D e video generati dall’IA
- Offre risultati espressivi e sincronizzati immediatamente, senza richiedere addestramento specifico per il parlante o fine-tuning del modello
- Genera fino a 4 varianti contemporaneamente
Ideale per:
- Doppiaggio di livello professionale e contenuti localizzati per film e pubblicità di fascia alta
- Migliorare o correggere i dialoghi di personaggi animati in 3D e generati dall’IA
- Progetti ad alta risoluzione che richiedono coerenza facciale e dettagli perfetti a livello di pixel
Costo: varia in base all’input, alle impostazioni e alla durata
OmniHuman 1.5
Un modello di utilità dedicato per generare lip-sync eccezionalmente realistico e simile a quello umano.
Input:
- Immagine sorgente statica
- File audio del parlato
Funzionalità:
- Anima la bocca nell’immagine sorgente per adattarla all’audio fornito
- Crea video “parlanti” ad alta fedeltà da immagini statiche
- Strumento specifico per il lip-sync, non un modello completo di generazione video
Ideale per:
- Creare avatar parlanti
- Aggiungere dialoghi a immagini statiche
- Workflow professionali di doppiaggio
Costo: varia in base all’input, alle impostazioni e alla durata
Per risultati ottimali, l’immagine dovrebbe contenere una figura rilevabile.
OmniHuman 1.5 non è disponibile negli Stati Uniti.
MiniMax H3 Max Lip Sync
Anima un’immagine statica a partire da una clip vocale, con output fino a 2K.
Input:
- Immagine sorgente
- Audio del parlato (da 5 a 14,8 s)
Funzionalità:
- Strumento specifico per il lip-sync, non un modello completo di generazione video
Ideale per:
- Ritratti parlanti da un’immagine statica e una breve clip audio
Costo: varia in base all’input, alle impostazioni e alla durata
Veed Lipsync
Un modello di utilità rapido, conveniente e preciso per applicare un lip-sync realistico ai video.
Input:
- Video sorgente
- Nuovo file audio del parlato
Funzionalità:
- Rianima i movimenti della bocca nel video sorgente per adattarli al nuovo audio
- Strumento di lip-sync da video a video, non un generatore video completo
Ideale per:
- Doppiaggio ad alto volume e conveniente
- Tradurre contenuti
- Correggere l’audio nelle clip video con risultati realistici
Costo: varia in base all’input, alle impostazioni e alla durata
Per risultati ottimali, il video dovrebbe contenere una figura rilevabile.
Veed Lipsync 2.0
Il successore di Veed Lipsync di qualità superiore per applicare un lip-sync realistico ai video esistenti.
Input:
- Video sorgente
- Nuovo file audio del parlato
Funzionalità:
- Rianima i movimenti della bocca nel video sorgente per adattarli al nuovo audio
- Strumento di lip-sync da video a video, non un generatore video completo
- Creazione in batch con fino a 4 generazioni alla volta
Ideale per:
- Doppiaggio e traduzione, quando la qualità dell’output conta più del costo
- Correggere i dialoghi nelle clip finite
Costo: varia in base all’input, alle impostazioni e alla durata
Per risultati ottimali, il video dovrebbe contenere una figura rilevabile.
Modelli di utilità
Topaz Image Upscale
Aumenta la risoluzione di un’immagine preservandone i dettagli.
Input:
- Immagine sorgente
Funzionalità:
- Fattori di upscaling: 1,25x, 1,5x, 2x, 3x, 4x
Ideale per:
- Preparare immagini per display ad alta risoluzione
Costo: varia in base all’input
Topaz Video Upscale
Aumenta la risoluzione di un video preservandone i dettagli.
Input:
- Video sorgente
Funzionalità:
- Fattori di upscaling: 1,25x, 1,5x, 2x, 3x, 4x
- Modalità di elaborazione rapide e precise
- Conversione opzionale del frame rate a 24, 25, 30, 48, 50 o 60 fps
Ideale per:
- Preparare video per display ad alta risoluzione
Costo: varia in base all’input
Rimozione dello sfondo
Rimuove lo sfondo da un’immagine e la restituisce con trasparenza alfa.
Input:
- Immagine sorgente
Funzionalità:
- Non richiede prompt
- Un solo output per esecuzione
Ideale per:
- Scontorni di prodotti e compositing
- Preparare soggetti da usare come riferimenti in altre generazioni
Costo: varia in base all’input
Rimozione dello sfondo video
Rimuove lo sfondo da un video.
Input:
- Video sorgente
Funzionalità:
- Non richiede prompt
- Lo sfondo dell’output può essere trasparente, nero o verde
Ideale per:
- Ritagliare un soggetto da filmati esistenti
- Preparare video per il compositing
Costo: varia in base all’input
Runway Ruby
Converte video a gamma dinamica standard in HDR.
Input:
- Video sorgente (fino a 30 s)
Funzionalità:
- Non richiede prompt
- Un solo output per esecuzione; durata e inquadratura seguono la sorgente
Ideale per:
- Preparare filmati per display HDR
- Ricalibrare il colore dei video generati per la distribuzione
Costo: varia in base alla durata del video
Domande frequenti
|
|