Bild och video
Översikt
Med Image & Video kan du skapa visuellt innehåll av hög kvalitet från enkla textbeskrivningar eller referensbilder. Skapa statiska bilder eller dynamiska videor i valfri stil, förfina dem stegvis med fler promptar, skala upp till hög upplösning och lägg till läppsynkning med ljud. Exportera färdiga resurser som fristående filer eller importera dem direkt till projekt i ElevenCreative Studio.
Vissa modeller för Image & Video och funktioner för att ladda upp indata är begränsade i USA på grund av myndighetskrav eller krav från leverantörer. Kontrollera beskrivningen för varje modell för specifik tillgänglighet.
Användare av gratisplanen kan bara skapa bilder och är begränsade till tre bildförfrågningar per dag. För att skapa video krävs en betald plan.
Guide
Följ de här stegen för att skapa din första visuella resurs:
Välj läge
Använd reglaget i det övre högra hörnet av promptfältet för att välja mellan att skapa bilder eller videor.
Ange en prompt eller referens
Beskriv resultatet du vill ha med naturligt språk i promptfältet. För mer kontroll kan du dra befintliga bilder eller videor från flikarna Utforska eller Historik till referensfälten, eller ladda upp egna referensbilder i många olika filformat, inklusive JPG, PNG, WEBP och fler.
Välj modell och inställningar
Välj den generativa modell som passar ditt mål bäst, till exempel Google Veo 3.1, Kling 2.5 eller Flux 1 Kontext Pro. Läs mer om varje modell i avsnittet Modeller. Justera inställningar som bildförhållande, upplösning, längd (för video) och antalet variationer som ska skapas.
Skapa din resurs
Klicka på knappen Skapa. Dina resurser skapas och visas på fliken Historik där du kan granska dem.
Förbättra och förfina
Använd förbättringsverktyg för att finslipa ditt material. Skala upp upplösningen, använd realistisk LipSync med ljud eller klicka på Återskapa för att skapa en ny variation med samma inställningar.
Arbetsflöde
Skapandeprocessen tar dig från inspiration till färdig resurs i fyra steg:
Utforska
Upptäck skapelser från communityn för att hitta inspiration, studera effektiva promptar eller hämta referenser direkt till ditt eget arbete.
Skapa
Använd promptfältet för att beskriva vad du vill skapa, välj en modell, finjustera inställningarna och förverkliga din idé.
Historik
Granska dina skapelser på fliken Historik för att iterera och förbättra. Återskapa variationer, återanvänd promptar och använd förbättringar som uppskalning och läppsynkning.
Exportera
Ladda ner färdiga resurser i olika format eller skicka dem direkt till ElevenCreative Studio för användning i dina projekt.
Utforska
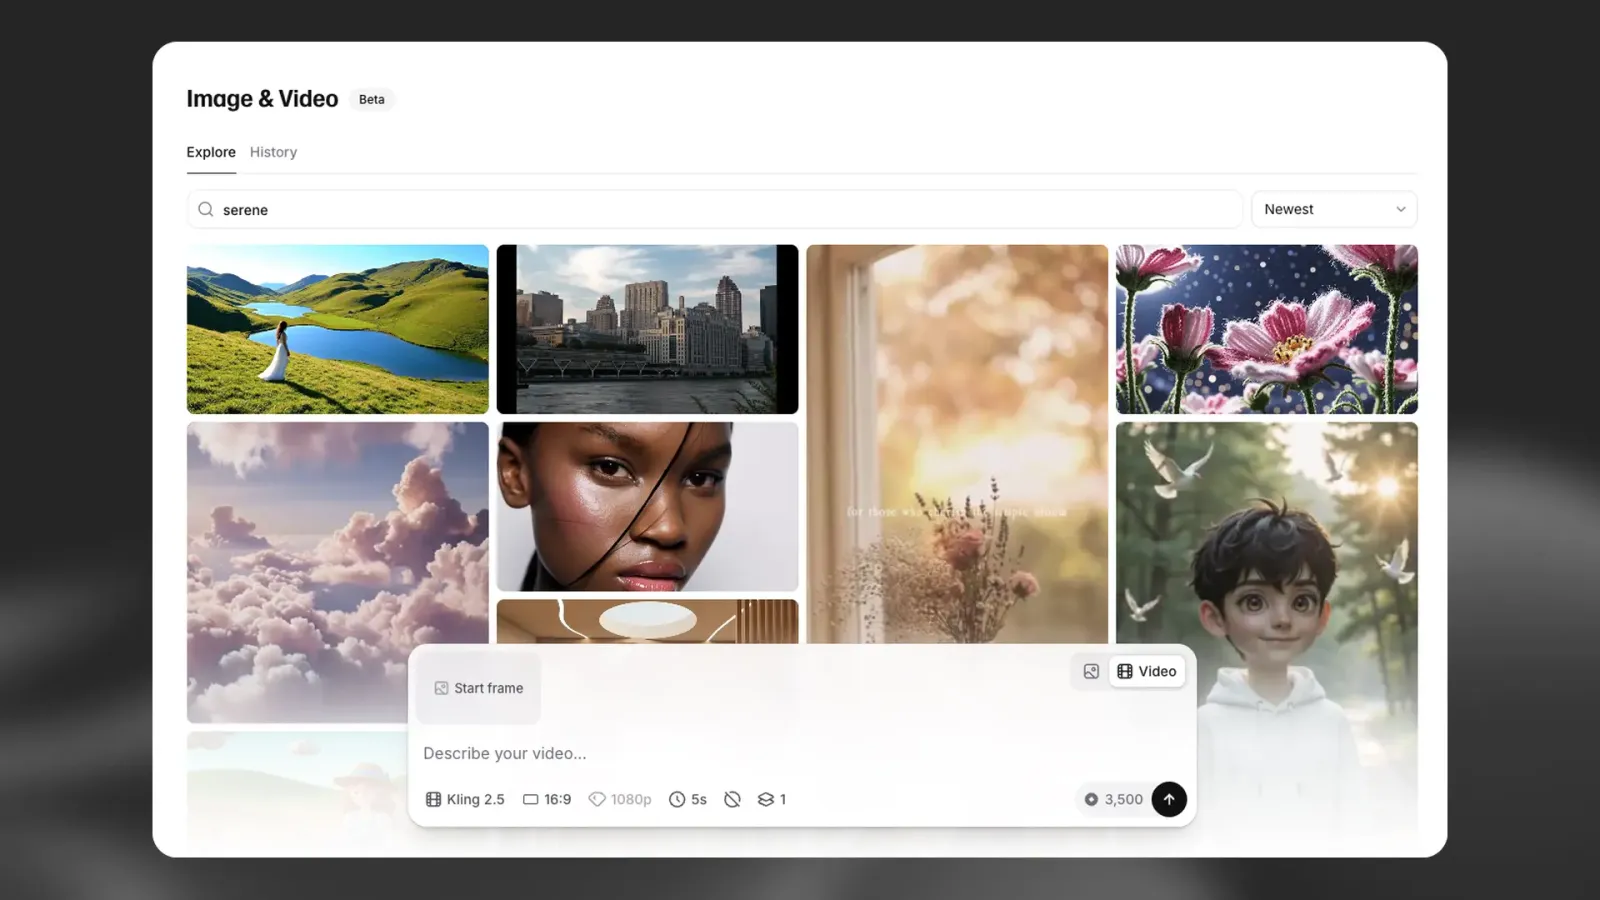
Fliken Utforska visar ett galleri med skapelser från communityn där du kan hitta inspiration och visuellt material att använda som referenser.
Sök: Använd sökfältet för att hitta bilder och videor utifrån nyckelord.
Sortera: Växla mellan Trendande och Senaste för att se vad som är populärt eller nyligen tillagt.
Dra och släpp: Dra valfritt resultat från rutnätet direkt till promptfältet för att använda det som startbild, slutbild eller stilreferens.
Förhandsgranska detaljer: Klicka på en ruta för att se hela prompten och inställningarna som användes för att skapa den.
Skapa
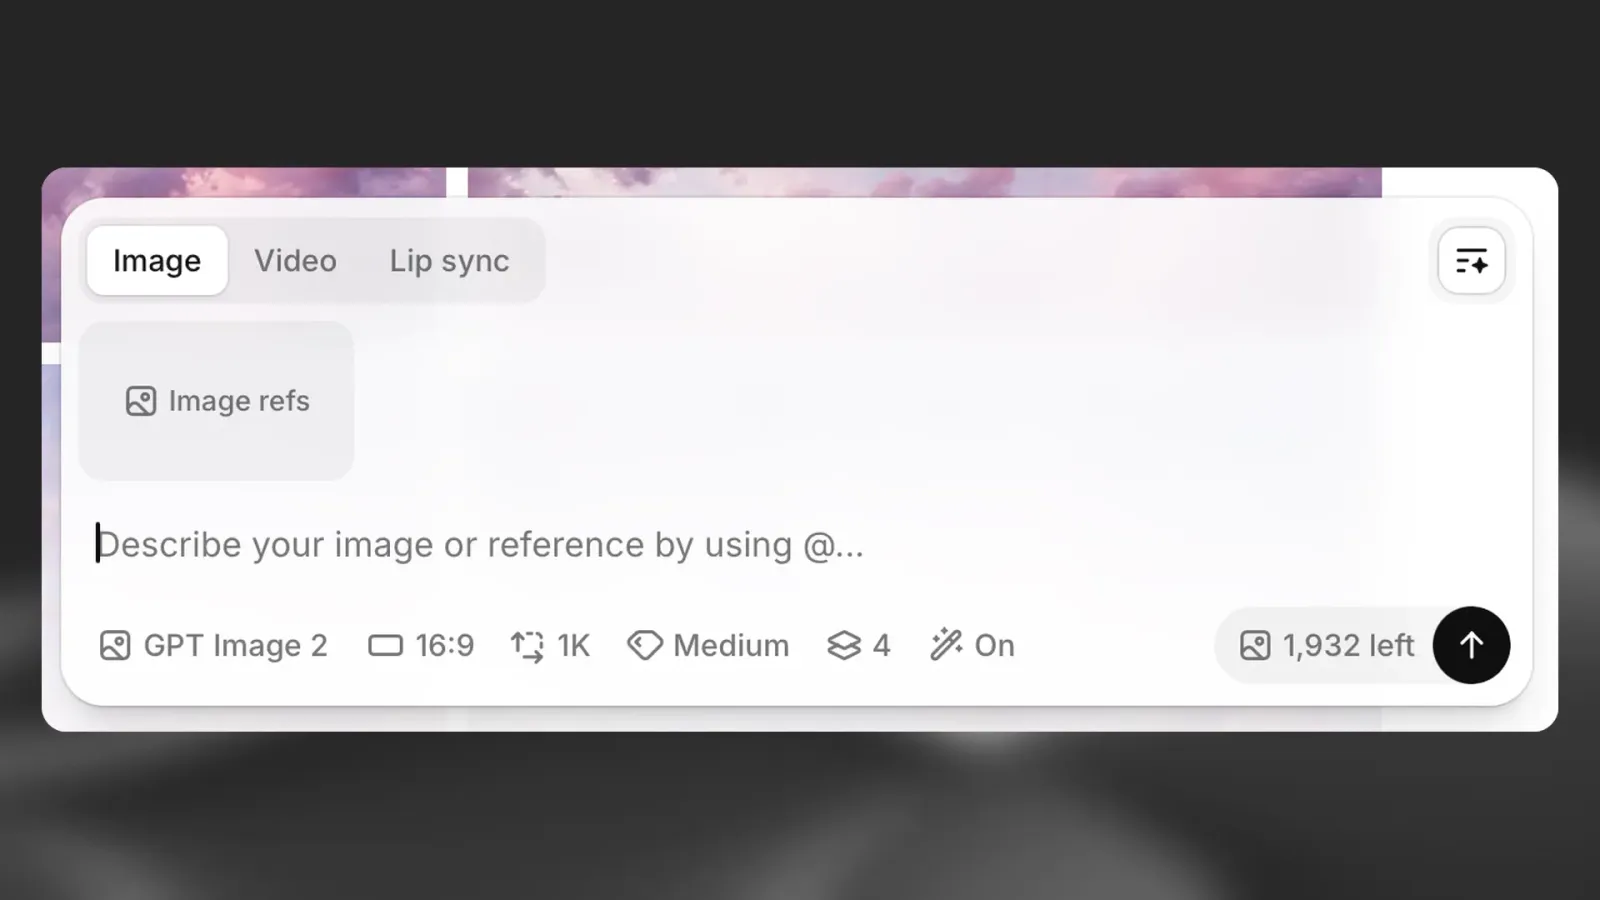
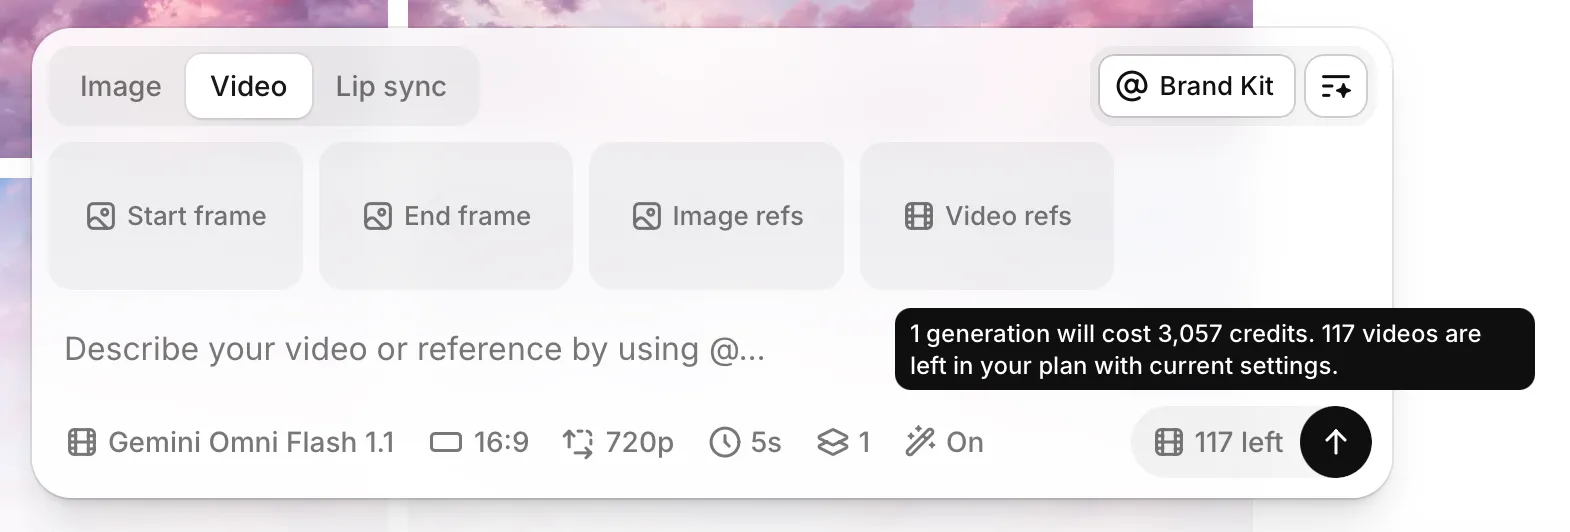
Promptfältet är fäst längst ned på sidan och innehåller alla reglage för att skapa visuellt innehåll.
Ställ in läge och prompt
Välj läge: Använd reglaget i det övre högra hörnet för att växla mellan att skapa bilder och videor.
Skriv din prompt: Beskriv vad du vill skapa med naturligt språk i huvudfältet. Var tydlig och beskrivande för bästa resultat.
Välj modeller och inställningar
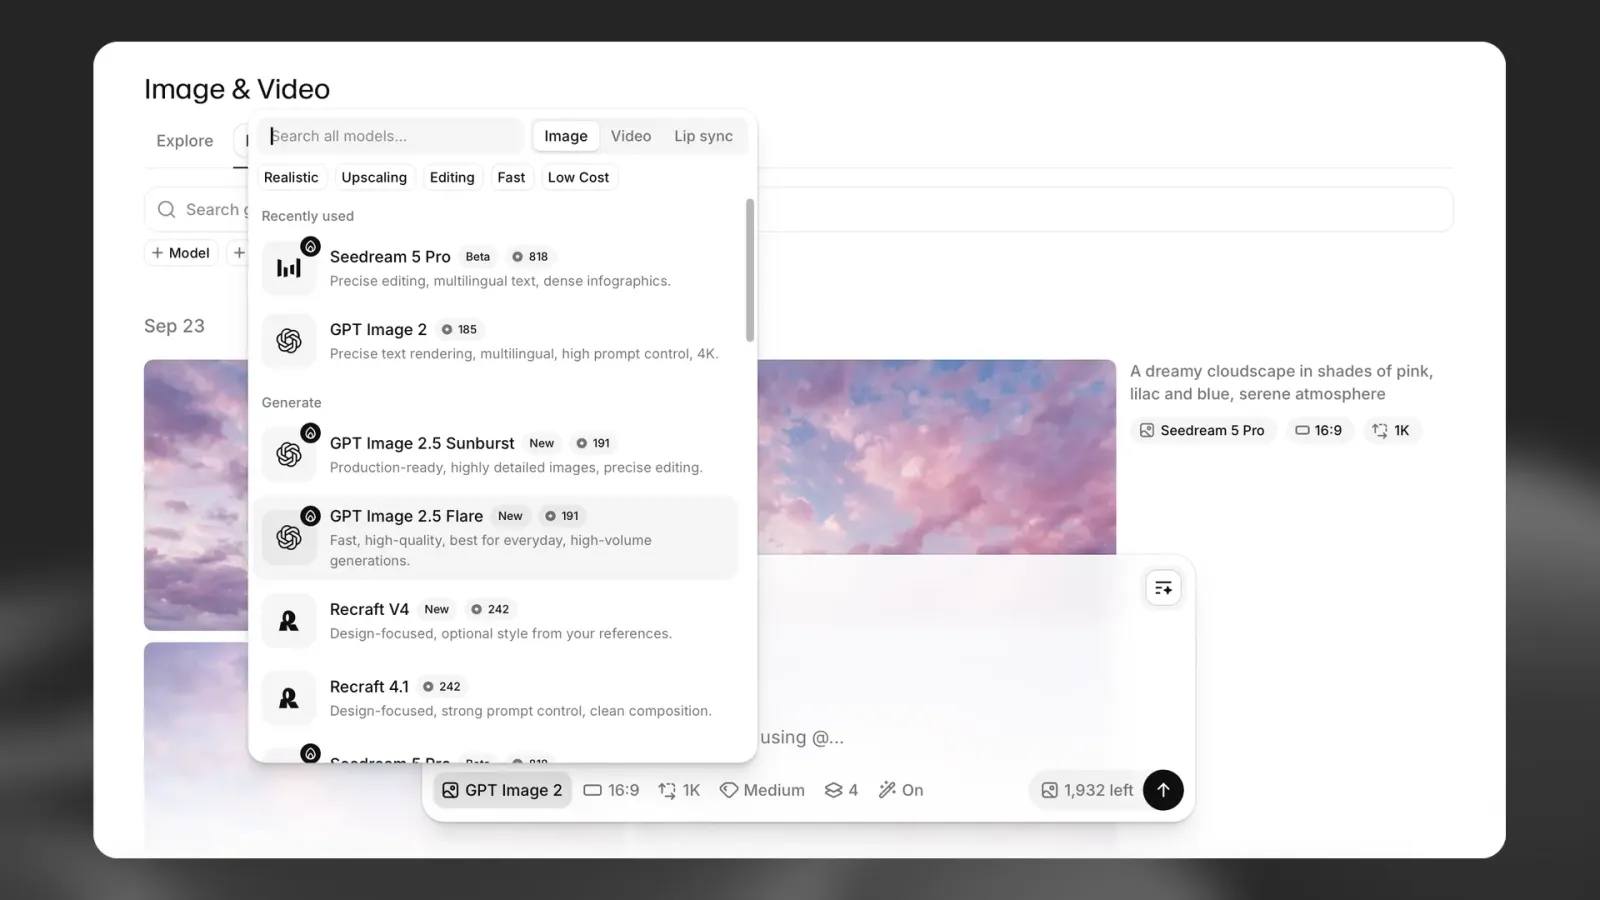
Välj modell: Öppna modellmenyn för att bläddra bland tillgängliga alternativ som Google Veo 3.1, Kling 2.5 eller Flux 1 Kontext Pro. Varje modell har unika styrkor och funktioner som listas för enkel jämförelse. Läs mer i avsnittet Modeller.
Justera inställningar: Finjustera din skapelse med inställningarna som visas under prompten. De varierar mellan modeller men omfattar ofta:
- Bildförhållande: Styr måtten på resultatet
- Upplösning: Ange kvalitetsnivån
- Längd: Ange videons längd (i videoläge)
- Antal skapelser: Skapa upp till fyra variationer samtidigt
Använd reglage: På modeller som stöds kan du aktivera Ljud, lägga till en Negativ prompt för att utesluta oönskade element eller justera Ljudkontroll.
Lägg till referenser
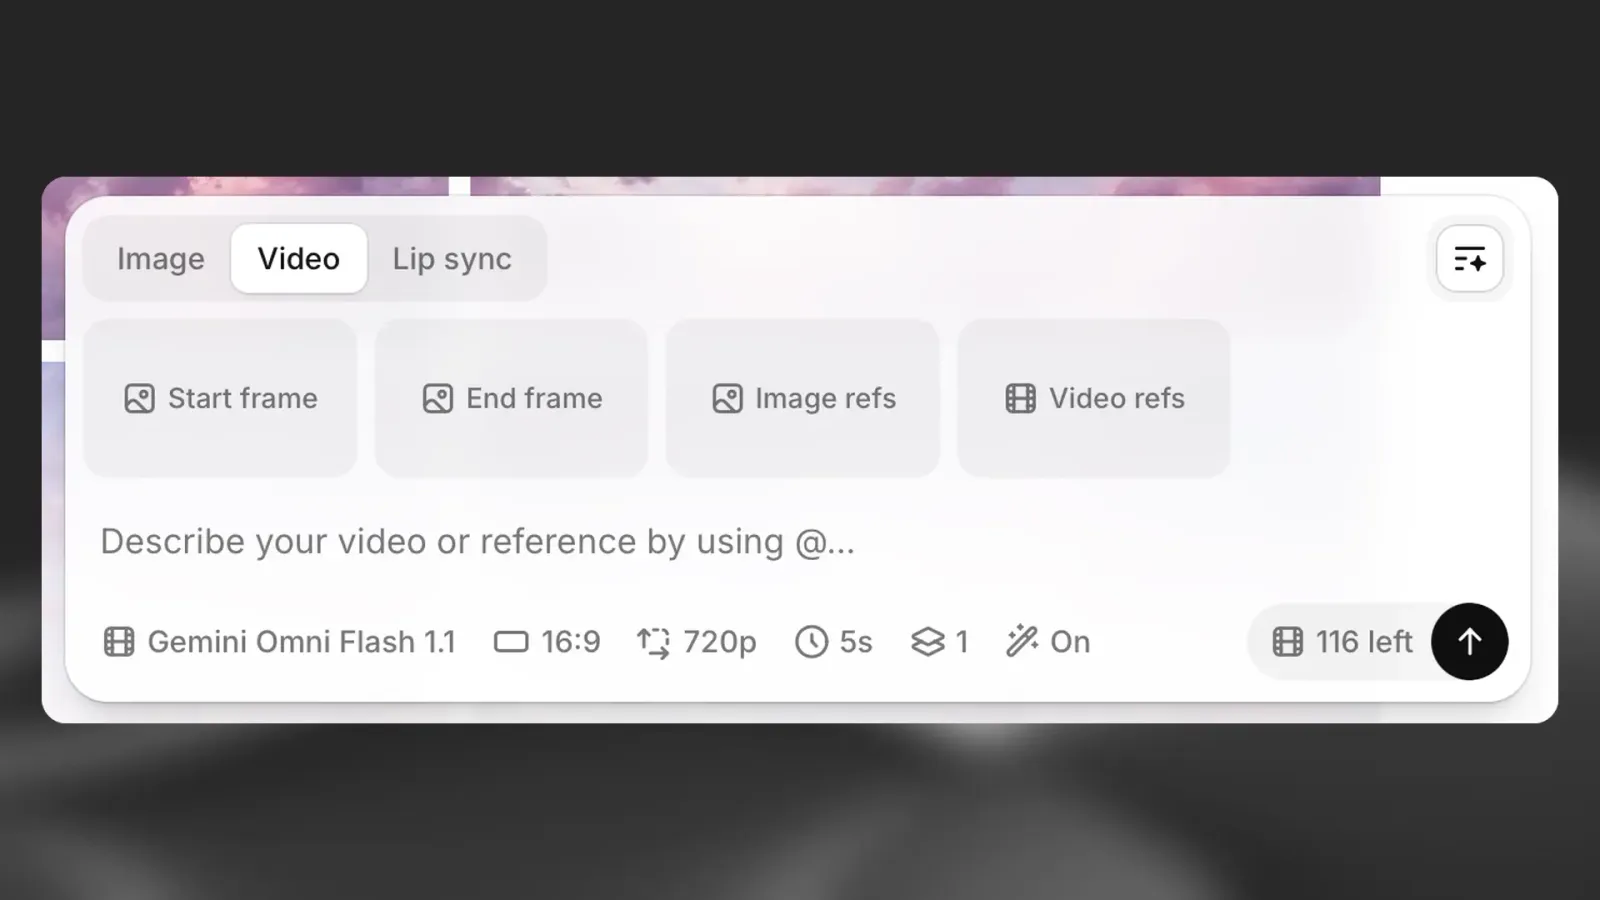
För större kontroll över resultatet kan du lägga till visuella referenser som styr skapandet. Tillgängligheten beror på den valda modellen. Vi stöder många olika bildfilformat, inklusive JPG, PNG, WEBP och fler.
Startbild (video): Anger den första bilden i videon.
Slutbild (video): Anger den sista bilden och påverkar övergången.
Bildreferenser (bild eller video): Ange en eller flera bilder som styr den övergripande stilen och utseendet.
Dra och släpp objekt direkt från flikarna Utforska eller Historik till referensfälten för ett snabbare arbetsflöde.
Skapa
Innan du skapar visar en kostnadsindikator den totala kostnaden för antalet resurser du har valt att skapa. När du är redo klickar du på Skapa. Dina nya skapelser visas på fliken Historik.
Historik
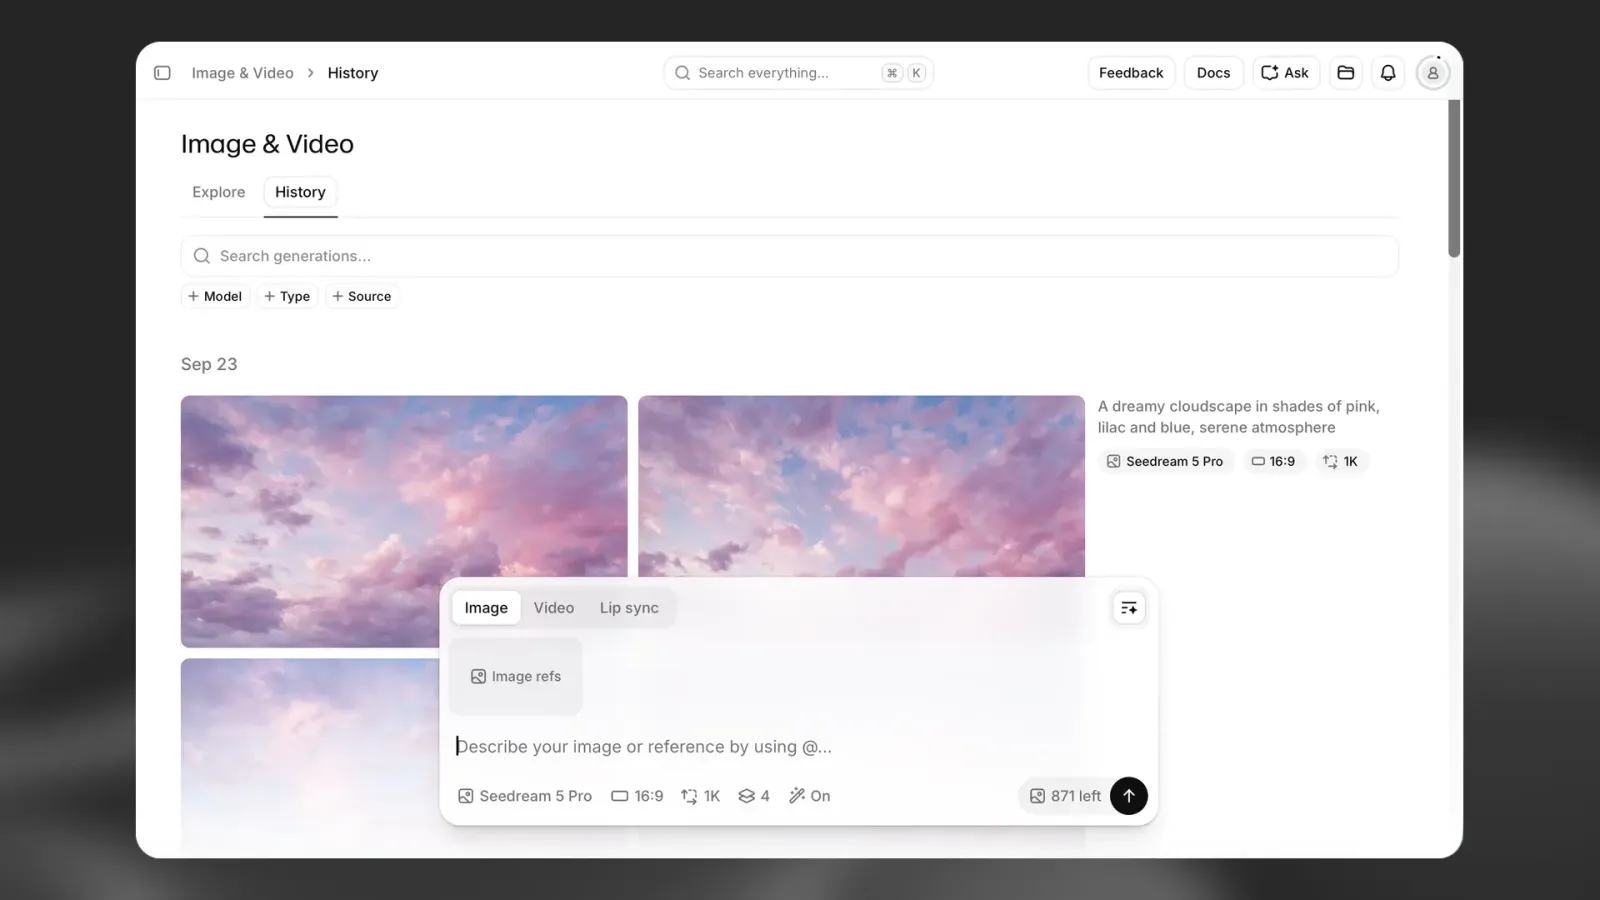
Fliken Historik innehåller en kronologisk logg över allt du har skapat och fungerar som en arbetsyta för att förfina tidigare arbete.
Bläddra: Visa alla tidigare bilder och videor.
Granska: Klicka på en resurs för att se den ursprungliga prompten, modellen och inställningarna som användes för att skapa den.
Återanvänd: Dra objekt från Historik tillbaka till promptfältet för att använda dem som referenser för nya skapelser.
Iterera: Klicka på Återskapa för att köra samma prompt och inställningar igen och skapa en ny variation, eller justera inställningarna för att styra skapandet i en ny riktning.
Dela: Klicka på Dela för att skapa en unik länk till din resurs. Skicka den till teammedlemmar och samarbetspartner för feedback.
Exportera: Ladda ner resursen som en fristående fil eller klicka på Redigera i Studio för att importera den direkt till ElevenCreative Studio.
Exportera
När du har en skapelse du är nöjd med kan du använda de inbyggda förbättringsverktygen innan du exporterar.
Förbättra dina skapelser
Skala upp: Använd Topaz Upscale för att öka upplösningen upp till 4 gånger samtidigt som skarpa detaljer bevaras.
LipSync: Använd realistisk läppsynkning på ditt visuella material:
- Omnihuman 1.5: Animera en statisk bild med ett ljudspår
- Veed LipSync: Dubba en befintlig video med nytt ljud
Exportera dina resurser
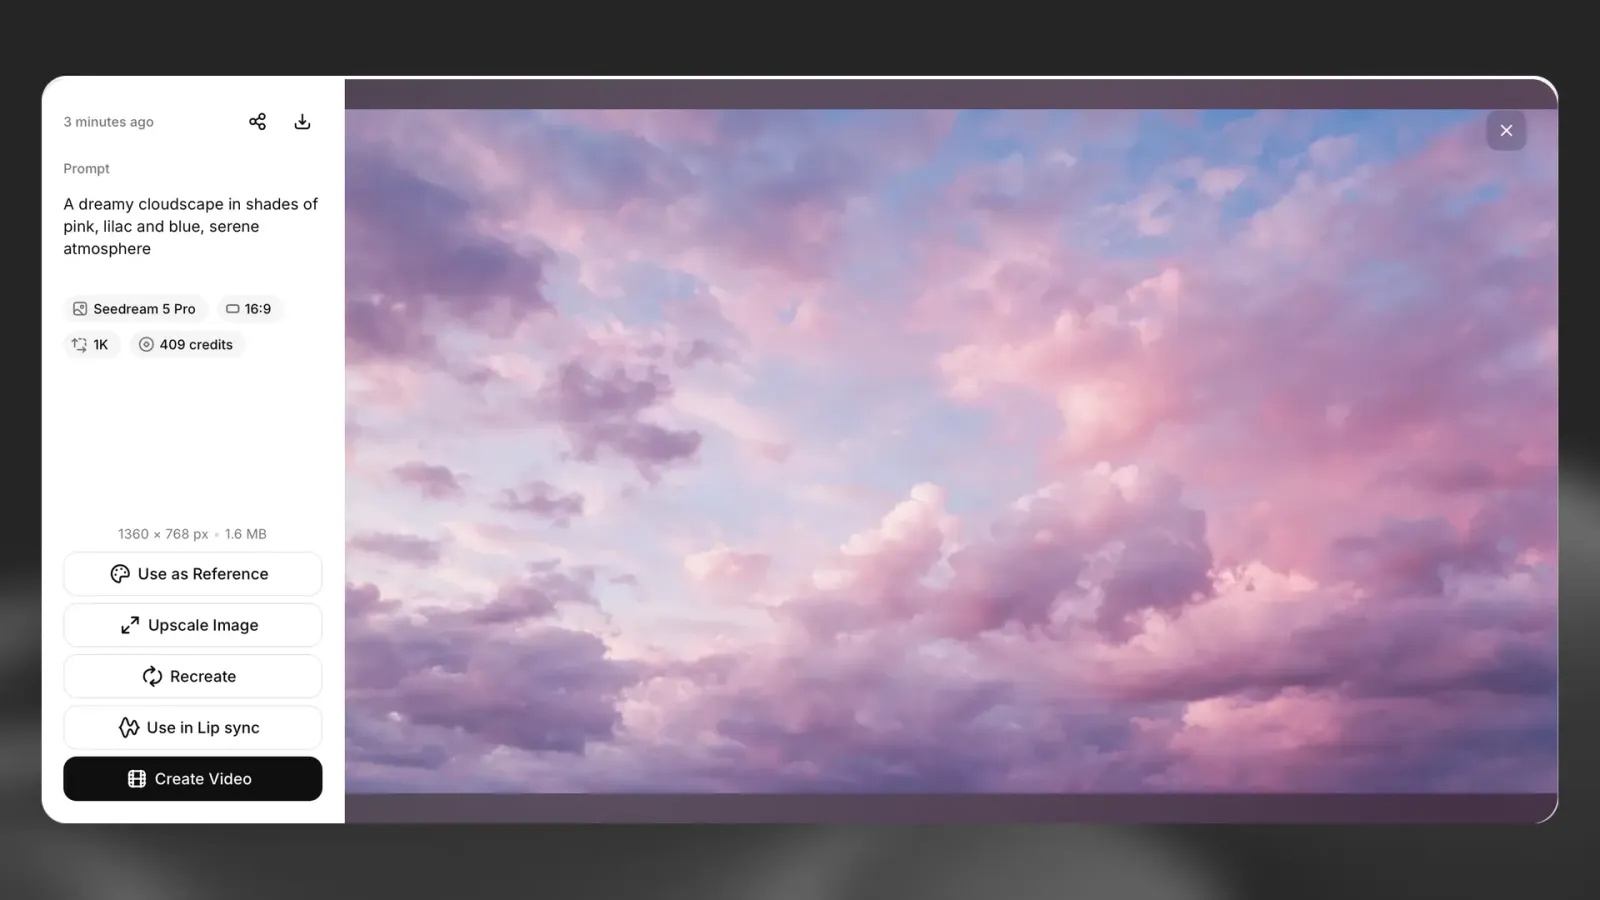
Exportera färdiga resurser genom att ladda ner dem lokalt eller skicka dem direkt till ElevenCreative Studio.
Redigera i Studio: Importera resursen direkt till ett projekt i ElevenCreative Studio.
Ladda ner: Spara resursen på din lokala dator.
Nedladdningsformat som stöds
Video:
- MP4: Codecs H.264, H.265. Kvalitet upp till 4K (med uppskalning)
Bild:
- PNG: Högupplöst, förlustfri utdata
Modeller
Image & Video ger tillgång till specialiserade modeller som är optimerade för olika användningsområden. Varje modell har unika funktioner, från snabb iteration till produktionsklar kvalitet.
Efterbehandlingsmodeller kräver ett befintligt genererat resultat, men du kan också ladda upp en egen bild- eller videofil.
Administratörer för Enterprise-arbetsytor kan styra vilka modeller för bild- och videogenerering som är tillgängliga för arbetsytans medlemmar. Som standard är alla modeller inaktiverade för Enterprise-arbetsytor och måste aktiveras uttryckligen av administratörer. Läs mer om modell- godkännanden.
För API-förfrågningar är ByteDance-modeller inaktiverade som standard och kräver uttryckligt godkännande före användning. Enterprise-kunder kan kontakta supporten för att begära åtkomst.
Generativa videomodeller
Seedance 2.0
En enhetlig multimodal videomodell med gemensam generering av ljud och video, som ger kontroll på regissörsnivå över framförande, ljussättning, skuggor och kamerarörelser för ultrarealistiska, filmiska resultat.
Indata för generering:
- Text-till-video
- Startbildruta
- Slutbildruta
- Bildreferenser
- Videoreferenser
- Ljudreferenser
Funktioner:
- Enhetlig multimodal arkitektur som genererar synkroniserat ljud och video i ett enda steg
- Branschledande multimodala referens- och redigeringsfunktioner som samtidigt tar emot text-, bild-, ljud- och videoindata
- Exceptionell rörelsestabilitet med filmisk realism enligt branschstandarder
- Kreativ kontroll på regissörsnivå över framförande, ljussättning, skuggor och kamerarörelser
- Flexibla genereringslängder från 4 s upp till 15 s
- Inbyggd ljudkontroll med ljud aktiverat eller inaktiverat per generering
- Batchskapande med upp till 4 genereringar åt gången
Utdataalternativ:
- Upplösningar: 480p, 720p, 1080p
- Bildförhållanden: 21:9, 16:9, 4:3, 1:1, 3:4, 9:16
Passar bäst för:
- Filmisk storytelling som kräver synkroniserat ljud och bild
- Referensdrivet innehåll med strikt följsamhet till källbilder, videor eller ljud
- Professionella produktioner som kräver detaljerad kontroll över ljussättning och kameraarbete
Kostnad: Varierar beroende på valda inställningar och längd
Seedance 2.0 Fast
En snabbare variant av Seedance 2.0 till lägre kostnad, med samma multimodala referensindata och utdata begränsad till 720p.
Indata för generering:
- Text-till-video
- Startbildruta
- Slutbildruta
- Bildreferenser (upp till 9)
- Videoreferenser (upp till 3, sammanlagt 15 s)
- Ljudreferenser (upp till 3, sammanlagt 15 s)
Funktioner:
- Samma referenshantering som Seedance 2.0, med en sammanlagd gräns på 12 referenser per generering
- Bildrutor och referenser utesluter varandra: använd en start- eller slutbildruta, eller referenser, inte båda
- Flexibla genereringslängder från 4 s upp till 15 s
- Inbyggd ljudkontroll med ljud aktiverat eller inaktiverat per generering
- Batchskapande med upp till 4 genereringar åt gången
Utdataalternativ:
- Upplösningar: 480p, 720p
- Bildförhållanden: 21:9, 16:9, 4:3, 1:1, 3:4, 9:16
Passar bäst för:
- Att iterera på Seedance 2.0-prompter före rendering i full upplösning
- Referensdrivna klipp där 720p-utdata räcker
Kostnad: Varierar beroende på valda inställningar och längd
API: bytedance-seedance-v2-fast
Seedance 2.0 Fast är inte tillgänglig i USA.
Seedance 2.0 Mini
Den minsta Seedance 2.0-varianten: ungefär dubbelt så snabb som Seedance 2.0 till cirka halva kostnaden, med samma indata och 720p-utdata.
Indata för generering:
- Text-till-video
- Startbildruta
- Slutbildruta
- Bildreferenser (upp till 9)
- Videoreferenser (upp till 3, sammanlagt 15 s)
- Ljudreferenser (upp till 3, sammanlagt 15 s)
Funktioner:
- Samma referenshantering som Seedance 2.0, med en sammanlagd gräns på 12 referenser per generering
- Bildrutor och referenser utesluter varandra: använd en start- eller slutbildruta, eller referenser, inte båda
- Flexibla genereringslängder från 4 s upp till 15 s
- Inbyggd ljudkontroll med ljud aktiverat eller inaktiverat per generering
- Batchskapande med upp till 4 genereringar åt gången
Utdataalternativ:
- Upplösningar: 480p, 720p
- Bildförhållanden: 21:9, 16:9, 4:3, 1:1, 3:4, 9:16
Passar bäst för:
- Utkast och förhandsvisningar i stora volymer
- Kostnadskänsliga arbetsflöden som fortfarande behöver ljud- och referensindata
Kostnad: Varierar beroende på valda inställningar och längd
API: bytedance-seedance-v2-mini
Seedance 2.0 Mini är inte tillgänglig i USA.
Seedance 2.5
Efterföljaren till Seedance 2.0 med skarpare realism, upp till 50 kombinerade bild-, video- och ljudreferenser samt genereringar på upp till 30 sekunder.
Indata för generering:
- Text-till-video
- Startbildruta
- Slutbildruta
- Bildreferenser (upp till 30)
- Videoreferenser (upp till 10, sammanlagt 30 s)
- Ljudreferenser (upp till 10, sammanlagt 30 s)
Funktioner:
- Ingen sammanlagd gräns mellan referenstyper; enbart ljudreferenser accepteras utan bild eller video
- Bildrutor och referenser utesluter varandra
- Flexibla genereringslängder från 4 s upp till 30 s
- Bildförhållandet hämtas från startbildrutan eller referensvideon när en sådan anges
- Inbyggd ljudkontroll med ljud aktiverat eller inaktiverat per generering
- Batchskapande med upp till 4 genereringar åt gången
Utdataalternativ:
- Upplösningar: 480p, 720p
- Bildförhållanden: 21:9, 16:9, 4:3, 1:1, 3:4, 9:16
Passar bäst för:
- Längre klipp som behöver vara konsekventa med många referenser
- Dialog- och prestationsscener som styrs av referensljud
Kostnad: Varierar beroende på valda inställningar och längd
Seedance 2.5 erbjuder ingen seed-kontroll.
Seedance 2.5 Video Edit
Redigerar en befintlig video genom att du beskriver ändringarna. Utdatans längd och bildförhållande följer indatavideon.
Indata för generering:
- Video att redigera (krävs, upp till 30 s)
- Textprompt som beskriver redigeringarna
- Bildreferenser (upp till 30)
- Ytterligare videoreferenser (upp till 10, sammanlagt 30 s)
- Ljudreferenser (upp till 10, sammanlagt 30 s)
Funktioner:
- Ingen längdkontroll: utdatan matchar indatavideons längd
- Bildförhållandet hämtas från indatavideon
- Inbyggd ljudkontroll med ljud aktiverat eller inaktiverat per generering
- Batchskapande med upp till 4 genereringar åt gången
Utdataalternativ:
- Upplösningar: 480p, 720p
Passar bäst för:
- Att ändra kläder, rekvisita, ljussättning eller miljö i befintligt material
- Stilöverföring som bevarar den ursprungliga rörelsen
Kostnad: Varierar beroende på valda inställningar och längd
Seedance 2.5 Video Extend
Fortsätter en befintlig video där den slutar, med vägledning från en prompt och valfria referenser.
Indata för generering:
- Video att förlänga (krävs, upp till 30 s)
- Textprompt som beskriver fortsättningen
- Bildreferenser (upp till 30)
- Ytterligare videoreferenser (upp till 10, sammanlagt 30 s)
- Ljudreferenser (upp till 10, sammanlagt 30 s)
Funktioner:
- Förlängningslängd från 4 s upp till 30 s
- Bildförhållandet hämtas från indatavideon
- Inbyggd ljudkontroll med ljud aktiverat eller inaktiverat per generering
- Batchskapande med upp till 4 genereringar åt gången
Utdataalternativ:
- Upplösningar: 480p, 720p
Passar bäst för:
- Att förlänga en tagning som slutar för tidigt
- Att kedja flera genereringar till en längre sekvens
Kostnad: Varierar beroende på valda inställningar och längd
Kling 3.0
En avancerad videomodell som fungerar som en AI-regissör och bevarar hög konsekvens för karaktärer, föremål och scener genom komplexa kamerarörelser.
Indata för generering:
- Text-till-video
- Startbildruta
- Slutbildruta
Funktioner:
- Högfidelitetsbevarande av karaktärer och scener med bild- eller videoreferenser från flera vinklar
- Inbyggd gemensam ljud- och videogenerering med flerspråkig läppsynkning och omgivningsljud
- Flexibla genereringslängder från 3 s upp till 15 s
- Generera upp till 4 variationer samtidigt
- Förbättrad hantering av text, vätskedynamik och komplexa fysiska interaktioner
Utdataalternativ:
- Upplösningar: endast 1080p
- Bildförhållanden: 16:9, 1:1, 9:16
Passar bäst för:
- Karaktärsdriven storytelling som kräver visuell kontinuitet
- Reklam och material med specifika krav på textrendering
Kostnad: Varierar beroende på valda inställningar och längd
Stöder negativa prompter för detaljerad kontroll. Ljud kan aktiveras eller inaktiveras per generering.
Kling 3.0 är inte tillgänglig i USA.
Kling O3
En videomodell med hög konsekvens som fungerar som en AI-regissör och bevarar identiteten hos karaktärer, föremål och scener genom komplexa kamerarörelser.
Indata för generering:
- Text-till-video
- Startbildruta
- Slutbildruta
- Videoreferens
- Bildreferens
Funktioner:
- Bevarar exakt visuell identitet för huvudkaraktärer och föremål med referenser från flera vinklar
- Stöder sömlösa genereringslängder från 3 s upp till 15 s
- Generera upp till 4 variationer åt gången
- Exakt modellering av elementinteraktioner och sammanhängande rörelser
- Inbyggt stöd för aktiverat eller inaktiverat ljud per generering
Utdataalternativ:
- Upplösningar: endast 1080p
- Bildförhållanden: 16:9, 1:1, 9:16
Passar bäst för:
- Karaktärsdriven storytelling som kräver strikt visuell kontinuitet
- Professionell marknadsföring och varumärkesmaterial med konsekvent rendering av föremål
Kostnad: Varierar beroende på valda inställningar och längd
Kling O3 är inte tillgänglig i USA.
Kling O3 Edit
En språkstyrd video-till-video-redigeringsmodell baserad på O3-arkitekturen, som möjliggör komplexa visuella förändringar – till exempel byte av karaktärer och miljöer – utan manuell maskning eller justeringar bildruta för bildruta.
Indata för generering:
- Källvideo
- Bildreferenser (upp till 4 distinkta element/vinklar)
- Textbeskrivning (instruktioner på naturligt språk)
Funktioner:
- Tolkar samtalsbaserade prompter för att byta ut motiv eller miljöer samtidigt som den ursprungliga rörelsestrukturen bevaras
- Bevarar ursprungliga kameravinklar, rörelsemönster och rumsliga relationer genom hela redigeringen
- Kombinerar upp till 4 element totalt (inklusive frontala bilder och bilder från flera vinklar) för konsekventa karaktärer med hög kvalitet
- Alternativ för att bevara ursprungligt källjud eller generera tyst utdata per generering
- Generera upp till 4 redigerade variationer åt gången
Utdataalternativ:
- Upplösningar: Beror på källvideon
- Bildförhållanden: Matchar källvideon
Passar bäst för:
- Högfidelitetsbyte av karaktärer i befintligt material samtidigt som ursprungliga rörelser behålls
- Fullständiga förändringar av scenmiljön (t.ex. att ändra en stad i dagsljus till ett futuristiskt nattlandskap)
- Att tillämpa stilöverföringar som kräver strikt följsamhet till befintlig kameradynamik
Kostnad: Varierar beroende på videons längd och valda inställningar
Kling O3 Edit är inte tillgänglig i USA.
Google Veo 3.1
En professionell modell för högkvalitativ, filmisk videogenerering.
Indata för generering:
- Text-till-video
- Startbildruta
- Slutbildruta
- Bildreferenser
Funktioner:
- Utmärkt kvalitet och kreativ kontroll med negativa prompter
- Helt integrerat och synkroniserat ljud
- Realistisk dialog, läppsynkning och ljudeffekter
- Fasta längder: 4 s, 6 s och 8 s
- Batchskapande med upp till 4 genereringar åt gången
- Separat ljudkontroll
Utdataalternativ:
- Upplösningar: 720p, 1080p
- Bildförhållanden: 16:9, 9:16
Passar bäst för:
- Högkvalitativ, filmisk videogenerering med full kreativ kontroll
Kostnad: Varierar beroende på valda inställningar och längd
API: veo-3.1-generate-001
Att aktivera eller inaktivera ljud ändrar genereringskrediterna.
Google Veo 3.1 Fast
En höghastighetsmodell optimerad för snabba förhandsvisningar och genereringar, med skarpare bild och lägre latens.
Indata för generering:
- Text-till-video
- Startbildruta
- Slutbildruta
Funktioner:
- Avancerad kreativ kontroll med negativa prompter och separat ljudkontroll
- Fasta längder: 4 s, 6 s och 8 s
- Batchskapande med upp till 4 genereringar åt gången
- Modellerar verklighetens fysik exakt för realistiska rörelser och interaktioner
Utdataalternativ:
- Upplösningar: 720p, 1080p
- Bildförhållanden: 16:9, 9:16
Passar bäst för:
- Snabb iteration och bilder för A/B-testning
- Snabb innehållsskapande för sociala medier
Kostnad: Varierar beroende på valda inställningar och längd
Google Veo 3.1 Lite
En kostnadseffektiv höghastighetsvariant av Veo 3.1, optimerad för snabb generering med minskad beräkningskapacitet.
Indata för generering:
- Text-till-video
- Startbildruta
Funktioner:
- Detaljerad kreativ kontroll med negativa prompter och separat ljudkontroll
- Fasta längder: 4 s, 6 s och 8 s
- Batchskapande med upp till 4 genereringar åt gången
Utdataalternativ:
- Upplösningar: 720p
- Bildförhållanden: 16:9, 9:16
Passar bäst för:
- Innehållsskapande i stora volymer där snabbhet och kostnadseffektivitet prioriteras
- Snabb utforskning av koncept och förhandsvisningar
Kostnad: Varierar beroende på valda inställningar och längd
Gemini Omni Flash 1.1
Googles fysikmedvetna videomodell med inbyggt ljud, utdata upp till 4K och både interpolering av bildrutor samt referensstyrd generering.
Indata för generering:
- Text-till-video
- Startbildruta
- Slutbildruta
- Bildreferenser (upp till 10)
- Videoreferenser (upp till 3, vardera upp till 10 s)
Funktioner:
- Bildrutor och referenser utesluter varandra: interpolera mellan bildrutor eller styr med referenser
- Fasta längder från 3 s till 10 s; längden följer referensvideon när en är bifogad
- Stark rendering av kort text och etiketter på skärmen
- Batchskapande med upp till 4 genereringar åt gången
Utdataalternativ:
- Upplösningar: 360p, 720p, 1080p, 4K
- Bildförhållanden: 16:9, 9:16
Passar bäst för:
- Förklarande videor och kinetisk typografi med läsbar text
- Fysiskt förankrade rörelser med konsekventa motiv mellan referenser
Kostnad: Varierar beroende på valda inställningar och längd
Gemini Omni Flash 1.1 Extend
Fortsätter en befintlig video där den slutar med Gemini Omni Flash 1.1, till en sammanlagd längd på upp till 40 sekunder.
Indata för generering:
- Video att förlänga (krävs, upp till 30 s)
- Textprompt som beskriver fortsättningen
Funktioner:
- Förlängningslängd från 3 s till 10 s
- Bildförhållandet följer indatavideon
- Batchskapande med upp till 4 genereringar åt gången
Utdataalternativ:
- Upplösningar: 360p, 720p, 1080p, 4K
Passar bäst för:
- Att förlänga Gemini Omni Flash-genereringar utan ett synligt klipp
- Att bygga sekvenser som är längre än en enskild generering tillåter
Kostnad: Varierar beroende på valda inställningar och längd
Gemini Omni Flash
Den första Gemini Omni-videomodellen: fysikmedvetna rörelser, inbyggt ljud och den bästa textrenderingen på skärmen bland de tillgängliga videomodellerna, i 720p.
Indata för generering:
- Text-till-video
- Bildreferenser (upp till 8)
- Videoreferens (1, upp till 10 s)
Funktioner:
- Fasta längder från 3 s till 10 s; längden följer referensvideon när en är bifogad
- Ingen start- eller slutbildruta; använd bildreferenser för att i stället förankra ett motiv
- Batchskapande med upp till 4 genereringar åt gången
Utdataalternativ:
- Upplösningar: 720p
- Bildförhållanden: 16:9, 9:16
Passar bäst för:
- Korta bildtexter, titlar och förklarande videor med etiketter
- Konsekvens mellan flera bilder i 720p
Kostnad: Varierar beroende på valda inställningar och längd
Seedance 1.5 Pro
En uppgraderad specialiserad modell för att skapa dynamiska sekvenser med hög återgivning, förbättrad tidsmässig stabilitet och exakt kontroll över övergångar mellan nyckelbilder.
Indata för generering:
- Text-till-video
- Startbild
- Slutbild
Funktioner:
- Sammanfogar start- och slutbilder sömlöst för sammanhängande sekvenser med flera tagningar
- Modellering med hög återgivning av komplexa handlingar och konsekventa miljöer
- Stöder fasta genereringslängder från 4 s upp till 12 s
- Generera upp till 4 variationer åt gången
- Inbyggt stöd för att aktivera eller inaktivera ljud för varje generering
Utdataalternativ:
- Upplösningar: 420p, 720p
- Bildformat: 21:9, 16:9, 4:3, 1:1, 3:4, 9:16
Passar bäst för:
- Berättande och actionscener som kräver stabil fysik mellan specifika visuella riktmärken
- Filmiska övergångar och professionellt videomaterial med strikta krav på start och slut
Kostnad: Varierar beroende på valda inställningar och längd
Seedance 1.5 Pro har fasats ut. ByteDance avvecklar modellen den 11 november 2026, och den erbjuds inte längre för nya genereringar. Använd en Seedance 2.0-modell i stället. Seedance 1.5 Pro är inte tillgänglig i USA.
FLUX 3
Black Forest Labs videomodell med naturliga rörelser, scener med flera tagningar, genererat ljud och videoförlängning.
Indata för generering:
- Text-till-video
- Startbild
- Slutbild
- Video att förlänga (1, upp till 15 s)
Funktioner:
- Videoförlängning kan inte användas tillsammans med start- och slutbilder
- Flexibla genereringslängder från 5 s upp till 20 s
- Inbyggd ljudkontroll med ljud aktiverat eller inaktiverat för varje generering
- Batchskapande med upp till 4 genereringar åt gången
Utdataalternativ:
- Upplösningar: 720p, 1080p
- Bildformat: 21:9, 2:1, 16:9, 4:3, 1:1, 3:4, 9:16
Passar bäst för:
- Scener med flera tagningar från en enda prompt
- Att förlänga ett befintligt klipp med matchande rörelse och ljud
Kostnad: Varierar beroende på valda inställningar och längd
FLUX 3 Edit
Redigerar en befintlig video utifrån en textprompt. Utdatalängd och bildutsnitt följer källvideon, upp till 15 s.
Indata för generering:
- Video att redigera (krävs, upp till 15 s)
- Textprompt som beskriver redigeringarna
Utdataalternativ:
- Upplösning och bildformat matchar källvideon
Passar bäst för:
- Promptbaserade ändringar av befintligt videomaterial
Kostnad: Varierar beroende på valda inställningar och längd
MiniMax H3
MiniMax flaggskeppsvideomodell med multimodala referenser, genererat ljud och utdata upp till 4K.
Indata för generering:
- Text-till-video
- Startbild
- Slutbild
- Bildreferenser (upp till 9)
- Videoreferenser (upp till 3, vardera 2 s till 15 s, totalt 15 s)
- Ljudreferenser (upp till 3, vardera 2 s till 15 s, totalt 15 s)
Funktioner:
- Sammanlagt högst 12 referenser per generering; ljudreferenser kräver minst en bild- eller videoreferens
- Bilder och referenser kan inte användas tillsammans
- Flexibla genereringslängder från 5 s upp till 15 s
- Genererar synkroniserat ljud
- Batchskapande med upp till 4 genereringar åt gången
Utdataalternativ:
- Upplösningar: 480p, 768p, 2K, 4K (2K och 4K skalas upp från 768p)
- Bildformat: 21:9, 16:9, 4:3, 1:1, 3:4, 9:16
Passar bäst för:
- Referensdrivna scener som behöver levereras i hög upplösning
- Dialogklipp som drivs av referensljud
Kostnad: Varierar beroende på valda inställningar och längd
MiniMax H3 är inte tillgänglig i USA.
MiniMax H3 Max
En nästan omedelbar variant av MiniMax H3 med samma indata och stark estetik, som renderas direkt i upp till 768p.
Indata för generering:
- Text-till-video
- Startbild
- Slutbild
- Bildreferenser (upp till 9)
- Videoreferenser (upp till 3, vardera 2 s till 15 s, totalt 15 s)
- Ljudreferenser (upp till 3, vardera 2 s till 15 s, totalt 15 s)
Funktioner:
- Sammanlagt högst 12 referenser per generering; ljudreferenser kräver minst en bild- eller videoreferens
- Bilder och referenser kan inte användas tillsammans
- Flexibla genereringslängder från 5 s upp till 15 s
- Genererar synkroniserat ljud
- Batchskapande med upp till 4 genereringar åt gången
Utdataalternativ:
- Upplösningar: 480p, 768p
- Bildformat: 21:9, 16:9, 4:3, 1:1, 3:4, 9:16
Passar bäst för:
- Snabb iteration av promptar och referenser
- Förhandsvisningar före rendering med MiniMax H3
Kostnad: Varierar beroende på valda inställningar och längd
MiniMax H3 Max är inte tillgänglig i USA.
MiniMax H3 Max Recast
Byter ut personer i en källvideo med hjälp av 1 till 4 foton. Längden följer källan, upp till 30 s, och originalljudet behålls.
Indata för generering:
- Källvideo (upp till 30 s)
- Foton på personerna som ska bytas ut (1 till 4)
Funktioner:
- Utdatalängden följer källvideon
- Behåller källjudet
Utdataalternativ:
- Upplösningar: upp till 1080p
- Bildformatet följer källvideon
Passar bäst för:
- Att ersätta personer i befintligt videomaterial med motiv från referensfoton
Kostnad: Varierar beroende på valda inställningar och längd
Kling O1
En avancerad resonemangsmodell för video, utformad för överlägsen följsamhet till promptar och komplex simulering av den fysiska världen. Den använder avancerad logisk bearbetning för att tolka och utföra detaljerade instruktioner.
Indata för generering:
- Text-till-video (beskrivning)
- Startbild och slutbild
- Videoreferens
- Bildreferens
Funktioner:
- Exceptionell förmåga att tolka promptar med flera lager och utföra komplexa kronologiska handlingar
- Använder både bilder och videor som visuella ankare för att bibehålla hög konsekvens för karaktärer och scener
- Överlägsen modellering av fysiska interaktioner, orsak och verkan samt vätskedynamik
- Stöder högkvalitativ generering för klipp på 5 s och 10 s
- Generera upp till 4 variationer åt gången
Utdataalternativ:
- Upplösningar: Beror på indata
- Bildformat: 16:9, 1:1, 9:16
Passar bäst för:
- Mycket specifika kreativa koncept som kräver exakt följsamhet till långa, detaljerade beskrivningar
- Professionellt berättande där fysisk realism och konsekvens mellan flera referenser är avgörande
Kostnad: Varierar beroende på valda inställningar och längd
Kling O1 är inte tillgänglig i USA.
Kling O1 Edit
En videoredigeringsmodell som drivs av naturligt språk och möjliggör komplexa visuella förändringar – som att byta ut karaktärer och miljöer – utan manuell maskning eller justeringar bildruta för bildruta.
Indata för generering:
- Källvideo
- Bildreferenser (upp till 4 olika element/vinklar)
- Textbeskrivning (instruktioner på naturligt språk)
Funktioner:
- Tolkar konversationsbaserade promptar för att ersätta motiv eller miljöer samtidigt som den ursprungliga rörelsestrukturen respekteras
- Bibehåller ursprungliga kameravinklar, rörelsemönster och rumsliga relationer genom hela redigeringen
- Kombinerar upp till 4 element totalt (inklusive framifrån- och flervinkelbilder) för att säkerställa konsekventa karaktärer med hög återgivning
- Alternativ för att behålla ursprungligt källjud eller generera ljudlös utdata för varje generering
- Generera upp till 4 redigerade variationer åt gången
Utdataalternativ:
- Upplösningar: Beror på källvideon
- Bildformat: Matchar källvideon
Passar bäst för:
- Att ersätta karaktärer med hög återgivning i befintligt videomaterial och samtidigt behålla ursprungliga rörelser
- Fullständiga förändringar av scenmiljöer (t.ex. att ändra en stad i dagsljus till ett futuristiskt nattlandskap)
- Att tillämpa stilöverföringar som kräver strikt följsamhet till befintlig kameradynamik
Kostnad: Varierar beroende på videons längd och valda inställningar
Kling O1 Edit är inte tillgänglig i USA.
Kling 2.6 Motion Control
En specialiserad modell för exakt rörelseöverföring som låter dig styra en karaktärsbild med en referensvideo för att återskapa specifika rörelser, gester och kameravinklar.
Indata för generering:
- Karaktärsbild (källa)
- Rörelsevideo (referens)
- Textbeskrivning (valfritt)
Funktioner:
- Välj “Match Video” för exakt rörelseåterskapning eller “Match Image” för att lägga till nya kreativa rörelser för en karaktär
- Stöder upp till 30 s i läget Match Video och 10 s i läget Match Image
- Kartläggning med hög återgivning av mänskliga rörelser från referensmaterial till en stillbild av en karaktär
- Inbyggt stöd för att aktivera eller inaktivera ljud för varje generering
- Generera upp till 4 variationer åt gången
Utdataalternativ:
- Upplösningar: Beror på källan
- Bildformat: Beror på källan
Passar bäst för:
- Att återskapa komplex koreografi eller specifika rörelser för en egen karaktär
- Längre karaktärsanimationer som kräver hög rörelseåtergivning
- Innehåll för sociala medier som drivs av populära videorörelser
Kostnad: Varierar beroende på valda inställningar och längd
Kling 2.6 Motion Control är inte tillgänglig i USA.
Kling 3.0 Motion Control
En specialiserad modell för exakt rörelseöverföring, byggd på Kling 3.0-arkitekturen. Den låter dig styra en karaktärsbild med en referensvideo för att återskapa specifika rörelser, gester och kameravinklar med förbättrad återgivning.
Indata för generering:
- Karaktärsbild (källa)
- Rörelsevideo (referens)
- Textbeskrivning (valfritt)
Funktioner:
- Välj “Match Video” för exakt rörelseåterskapning eller “Match Image” för att lägga till nya kreativa rörelser för en karaktär
- Stöder upp till 30 s i läget Match Video och 10 s i läget Match Image
- Kartläggning med hög återgivning av mänskliga rörelser från referensmaterial till en stillbild av en karaktär
- Inbyggt stöd för att aktivera eller inaktivera ljud för varje generering
- Generera upp till 4 variationer åt gången
Utdataalternativ:
- Upplösningar: Beror på källan
- Bildformat: Beror på källan
Passar bäst för:
- Att återskapa komplex koreografi eller specifika rörelser för en egen karaktär
- Längre karaktärsanimationer som kräver hög rörelseåtergivning
- Innehåll för sociala medier som drivs av populära videorörelser
Kostnad: Varierar beroende på valda inställningar och längd
Kling 3.0 Motion Control är inte tillgänglig i USA.
Kling 2.6
En optimerad generativ modell utformad för förbättrad rörelseåtergivning och mjukare övergångar, med balans mellan snabb iteration och visuella resultat av produktionskvalitet.
Indata för generering:
- Text-till-video
- Startbild (bild-till-video)
Funktioner:
- Förbättrad rörelsedynamik: Betydande förbättringar av rörelseflyt och realistiska fysikinteraktioner
- Flexibel ljudkontroll: Inbyggt stöd för att aktivera eller inaktivera ljud för varje generering
- Batchskapande: Generera upp till 4 variationer samtidigt
- Detaljerad förfining: Avancerad kreativ kontroll genom stöd för negativa promptar
- Fasta längder: Stöder genereringslängder på 5 s och 10 s
Utdataalternativ:
- Upplösningar: Beror på indata
- Bildformat: 16:9, 1:1, 9:16
Passar bäst för:
- Actionfyllda klipp som kräver smidiga karaktärsrörelser
- Professionellt innehåll för sociala medier med stark följsamhet till promptar
Kostnad: Varierar beroende på valda inställningar och längd
Kling 2.6 är inte tillgänglig i USA.
Kling 2.5
En balanserad och mångsidig modell för högkvalitativ videogenerering i full HD.
Indata för generering:
- Text-till-video
- Startbild
Funktioner:
- Utmärker sig vid simulering av komplexa rörelser och realistisk fysik
- Modellerar vätskedynamik och uttryck på ett korrekt sätt
- Fasta längder: 5 s och 10 s
- Batchskapande med upp till 4 genereringar åt gången
Utdataalternativ:
- Upplösningar: 1080p
- Bildformat: 16:9, 1:1, 9:16
Passar bäst för:
- Realistiska fysiksimuleringar och komplexa rörelser
Kostnad: Varierar beroende på valda inställningar och längd
Slutbild stöds för närvarande inte. Det går inte att ange bildreferenser. Ljudkontroll är inte tillgänglig.
Kling 2.5 är inte tillgänglig i USA.
Runway Gen-4.5
Toppmodern rörelsekvalitet, följsamhet till promptar och visuell återgivning för filmisk, mycket realistisk video.
Indata för generering:
- Text-till-video
- Startbild (bild-till-video)
Funktioner:
- Exceptionell rörelsekvalitet med branschledande realism och fysiksimulering
- Överlägsen följsamhet till promptar för exakt kreativ kontroll över komplexa scener
- Hög visuell återgivning som ger utdata i filmisk kvalitet
- Generera upp till 4 variationer samtidigt
Utdataalternativ:
- Upplösningar: 720p
- Bildformat: 16:9, 9:16
Passar bäst för:
- Filmiskt innehåll som kräver högsta rörelsekvalitet och realism
- Professionella produktioner som kräver exakt följsamhet till promptar
- Visuellt berättande med hög återgivning
Kostnad: Varierar beroende på valda inställningar och längd
Runway Gen-4 Turbo
En avancerad videomodell utformad för snabb iteration och kostnadseffektivt skapande, som kan producera videor av hög kvalitet.
Indata för generering:
- Text-till-video
- Startbild (bild-till-video)
Funktioner:
- Optimerad för ultrasnabb generering och ger resultat upp till fyra gånger snabbare än tidigare versioner
- Möjliggör exakt styrning av karaktärsrörelser, kameravinklar och scenkompositioner
- Utmärker sig vid att bibehålla visuell sammanhållning och stabilitet i dynamiska scener
- Stöder genereringslängder från 2 s upp till 10 s
- Generera upp till 4 variationer samtidigt
Utdataalternativ:
- Upplösningar: 720p
- Bildformat: 21:9, 16:9, 4:3, 1:1, 3:4, 9:16
Passar bäst för:
- Snabb prototypframtagning och kreativa experiment som kräver nästan omedelbar återkoppling
- Professionella projekt som behöver snabba leveranser av marknadsföringsmaterial i hög upplösning
- Filmiskt innehåll med specifika krav på kamerarörelser
Kostnad: Varierar beroende på valda inställningar och längd
Runway Gen-4 Aleph
En toppmodern videomodell för in-context-användning, utformad för visuell generering av flera uppgifter och kapabel att utföra komplexa redigeringar samtidigt som den underliggande strukturen i källmaterialet behålls.
Indata för generering:
- Källvideo
- Referensbild
- Textbeskrivning
Funktioner:
- Lägg sömlöst till, ta bort eller omvandla objekt och motiv i en scen med naturlig belysning, skuggor och perspektiv
- Ändra platser, årstider och tid på dagen (t.ex. genom att omvandla molnigt material till en dramatisk solnedgång) med realistiska uppdateringar av färgtemperatur
- Ändra skådespelares ålder och utseende eller ge kläder och motiv nya texturer genom enkla promptar på naturligt språk
- Tillämpa en referensvideos specifika rörelse och kamerabana på en stillbild för exakt animationskontroll
- Generera helt nya kameravinklar, som omvända bilder eller låga vinklar, från en enda befintlig videosekvens
- Innehåller exakt green screen-arbete (isolering med kantdetektering), generering av nästa bild för att fortsätta berättelsen och estetisk stilöverföring
- Generera upp till 4 variationer samtidigt
Utdataalternativ:
- Upplösningar: 720p
- Bildformat: Auto
Passar bäst för:
- Professionella visuella effektuppgifter som digital föryngring, ombelysning och borttagning av objekt
- Snabb filmisk prototypframtagning och generering av alternativa kamerabilder från en enda tagning
- Kreativt marknadsföringsinnehåll som kräver stora förändringar av miljö eller stil
Kostnad: Varierar beroende på valda inställningar och längd
Runway Aleph 2.0
Runways videoredigeringsmodell: omvandlar en befintlig video mot ett önskat utseende samtidigt som rörelse och konsekvens bevaras.
Indata:
- Källvideo (krävs, 2 s till 30 s)
- Bild med önskat utseende (krävs)
- Textprompt som beskriver redigeringarna
Funktioner:
- Utdatalängd och bildutsnitt följer källvideon
- Stilöverföring styrd av bilden med önskat utseende
- Batchskapande med upp till 4 genereringar åt gången
Passar bäst för:
- Att ändra belysning, stil eller miljö i befintligt videomaterial
- Att tillämpa en referensbilds utseende på ett helt klipp
Kostnad: Varierar beroende på valda inställningar och längd
Runway Act-Two
En specialiserad modell för rörelseöverföring som animerar karaktärer genom att överföra rörelse, tal och ansiktsuttryck från en styrande video till en bild- eller videoreferens av en karaktär.
Indata för generering:
- Styrande framträdande (video)
- Karaktärsindata (bild eller video)
Funktioner:
- Överför nyanserade ansiktsuttryck, läppsynkronisering och synkroniserat ljud direkt från en källskådespelare till valfri karaktär
- Lägger automatiskt till sekundära rörelser och subtila kameraskakningar i statiska karaktärsbilder för ett mer naturligt utseende
- Exakt reglage för att aktivera eller inaktivera kropps- och handrörelser när du använder en karaktärsbild
- Justerbara inställningar för att balansera mellan intensivt känslomässigt framförande och karaktärens visuella konsekvens
- Möjlighet att ändra karaktärens röst efter generering och samtidigt behålla perfekt synkronisering med det styrande framförandet
Utdataval:
- Upplösningar: 720p
- Bildförhållanden: Auto
Passar bäst för:
- Att väcka statiska karaktärsporträtt till liv med realistiska mänskliga rörelser och tal
- Att animera icke-mänskliga karaktärer eller stiliserade avatarer med uttryck med hög precision
- Att snabbt skapa talking-head-innehåll med integrerade kroppsgester
Kostnad: Varierar beroende på valda inställningar och längd
Seedance 1 Pro
En specialiserad modell för att skapa dynamiska sekvenser med flera tagningar, omfattande rörelser och action.
Indata för generering:
- Text-till-video
- Startbildruta
- Slutbildruta
Funktioner:
- Mycket stabil fysik och sömlösa övergångar mellan tagningar
- Fasta längder: 3 s, 4 s, 5 s, 6 s, 7 s, 8 s, 9 s, 10 s, 11 s och 12 s
- Batchskapande med upp till 4 genereringar åt gången
- Maximal kreativ flexibilitet med många alternativ för bildförhållande
Utdataval:
- Upplösningar: 480p, 720p, 1080p
- Bildförhållanden: 21:9, 16:9, 4:3, 1:1, 3:4, 9:16
Passar bäst för:
- Berättande och actionscener som kräver stabil fysik
Kostnad: Varierar beroende på valda inställningar och längd
Bildförhållande och upplösning påverkar inte genereringskrediterna, men längden gör det.
Seedance 1 Pro är inte tillgängligt i USA.
LTX Audio-to-Video
En DiT-baserad grundmodell som är utformad för att generera synkroniserad video och ljud i ett enda steg, vilket ger sammanhängande tal och realistiska rörelser.
Indata för generering:
- Text-till-video
- Bild-till-video
- Ljud-till-video
- Djup-till-video
Funktioner:
- Genererar dialog, läpprörelser och bakgrundsljud samtidigt för perfekt synkronisering utan externa verktyg
- Dynamiska scener med stabila rörelser, konsekvent identitet och stark sammanhållning mellan bildrutor
- Stöder synkroniserad generering med hög precision i upp till 20 sekunder
- Avancerad kreativ styrning genom detaljerat stöd för negativa prompter
- Generera upp till 4 variationer åt gången
Utdataval:
- Upplösningar: 720p, 1080p
- Bildförhållanden: 16:9, 4:3, 1:1, 3:4, 9:16
Passar bäst för:
- Sammanhängande tal och uttrycksfulla karaktärsframträdanden
- Berättande innehåll som kräver integrerat bakgrundsljud och konsekvent tajming
- Dynamiska scener med komplex rörelselogik som tar hänsyn till kameran
Kostnad: Varierar beroende på valda inställningar och längd
LTX 2 Pro
En generativ modell med hög precision som är optimerad för maximal visuell detaljrikedom och strukturell stabilitet och kan skapa 4K-utdata i produktionskvalitet med mjuka rörelser.
Indata för generering:
- Text-till-video
- Startbildruta (bild-till-video)
Funktioner:
- Prioriterar visuell kvalitet och konsekvens framför hastighet, vilket ger stabila resultat i längre sekvenser
- Stöder både 25 FPS och 50 FPS för exceptionellt mjuka och professionella rörelser
- Integrerad audiovisuell generering med ett reglage för att slå på eller av ljud
- Byggd för att hantera inbyggda utdata i 1080p, 2k och 4k utan detaljförlust
- Generera upp till 4 variationer åt gången
Utdataval:
- Upplösningar: 1080p, 2k, 4k
- Bildfrekvenser: 25 FPS, 50 FPS
- Bildförhållande: 16:9 (standard)
- Längder: 6 s, 8 s, 10 s
Passar bäst för:
- Filmisk produktion med hög upplösning som kräver 4K-skärpa
- Professionellt innehåll som kräver mjuka rörelser i 50 FPS
- Detaljerade sekvenser där visuell stabilitet och strukturell integritet är avgörande
Kostnad: Varierar beroende på valda inställningar och längd
LTX 2 Retake
Ett exakt AI-regiverktyg som gör det möjligt att ändra dialog, känslor och handling i befintliga tagningar utan att bryta kontinuiteten eller generera om hela sekvensen.
Indata för generering:
- Källvideo
- Textbeskrivning
Funktioner:
- Ändra specifika segment samtidigt som kontexten från omgivande bildrutor bevaras väl
- Omformulera repliker och behåll samtidigt karaktärens röst, framträdande och miljö konsekventa
- Flera redigeringslägen: Välj mellan “Audio & Video”, “Audio only” eller “Video only” för att isolera och generera om specifika delar av tagningen
- Nytt innehåll ärver naturligt originalets rörelser, ljussättning och ton för sömlösa övergångar
- Experimentera direkt med alternativa karaktärsreaktioner, känslomässiga ögonblick eller kamerarörelser i en enda tagning
- Generera upp till 4 variationer samtidigt för kreativ jämförelse sida vid sida
Utdataval:
- Bildförhållanden: endast 16:9
Passar bäst för:
- Att justera manus och finslipa dialog utan nyinspelning eller ominspelning av ljud
- Att åtgärda problem med känslomässiga ögonblick eller tempo i efterproduktionen
- Att testa flera varumärkesbudskap och uppmaningar till handling i ett och samma marknadsföringsmaterial
Kostnad: Varierar beroende på valda inställningar och längd
LTX 2 Fast
En hastighetsoptimerad generativ modell som är byggd för snabba återkopplingsloopar och snabb innehållsproduktion och levererar högupplösta bilder med betydligt kortare renderingstider.
Indata för generering:
- Text-till-video
- Startbildruta (bild-till-video)
Funktioner:
- Konstruerad för hastighet och snabba iterationer, vilket möjliggör snabb visuell experimentering och nästan omedelbara förhandsvisningar
- Stöder inbyggda utdata i 1080p, 2k och 4k med lägre beräkningskostnad än Pro-modellen
- Stöder både 25 FPS och 50 FPS för mjuka rörelser i hög hastighet
- Möjliggör snabb generering av synkroniserat audiovisuellt innehåll med längder på upp till 20 sekunder
- Inbyggt stöd för att aktivera eller inaktivera ljud för varje generering
- Generera upp till 4 variationer samtidigt
Utdataval:
- Upplösningar: 1080p, 2k, 4k
- Bildfrekvenser: 25 FPS, 50 FPS
- Bildförhållande: 16:9 (standard)
- Längder: 6 s, 8 s, 10 s, 12 s, 14 s, 16 s, 18 s, 20 s
Passar bäst för:
- Snabb prototypframtagning och kreativ utforskning där hastighet prioriteras framför maximal detaljrikedom
- Stora mängder innehåll för sociala medier som kräver snabb leverans
- A/B-testning av olika visuella koncept och rörelsestilar
Kostnad: Varierar beroende på valda inställningar och längd
Wan 3.0
En filmisk videomodell med bild-, video- och ljudreferenser, genererat ljud och genereringar på upp till 30 sekunder.
Indata för generering:
- Text-till-video
- Startbildruta
- Slutbildruta
- Bildreferenser (upp till 10)
- Videoreferenser (upp till 5, sammanlagt 15 s)
- Ljudreferenser (upp till 5, sammanlagt 15 s)
Funktioner:
- Bildrutor och referenser kan inte användas samtidigt
- Fasta längder: 5 s, 10 s, 15 s, 20 s och 30 s
- Inbyggd ljudstyrning med ljud aktiverat eller inaktiverat per generering
- Valfri promptförbättring
- Batchskapande med upp till 4 genereringar åt gången
Utdataval:
- Upplösningar: 480p, 720p, 1080p
- Bildförhållanden: Auto, 16:9, 4:3, 1:1, 3:4, 9:16
Passar bäst för:
- Längre filmiska tagningar med hög följsamhet till prompten
- Referensdrivna scener med ljud
Kostnad: Varierar beroende på valda inställningar och längd
Wan 3.0 är inte tillgängligt i USA.
Wan 3.0 Prime
En snabbare variant av Wan 3.0 med samma indata och utdataval, anpassad för idéutveckling.
Indata för generering:
- Text-till-video
- Startbildruta
- Slutbildruta
- Bildreferenser (upp till 10)
- Videoreferenser (upp till 5, sammanlagt 15 s)
- Ljudreferenser (upp till 5, sammanlagt 15 s)
Funktioner:
- Ungefär halva genereringstiden jämfört med Wan 3.0
- Fasta längder: 5 s, 10 s, 15 s, 20 s och 30 s
- Inbyggd ljudstyrning med ljud aktiverat eller inaktiverat per generering
- Batchskapande med upp till 4 genereringar åt gången
Utdataval:
- Upplösningar: 480p, 720p, 1080p
- Bildförhållanden: Auto, 16:9, 4:3, 1:1, 3:4, 9:16
Passar bäst för:
- Att utforska idéer före en slutlig rendering i Wan 3.0
- Arbetsflöden där snabb leverans är viktig
Kostnad: Varierar beroende på valda inställningar och längd
Wan 3.0 Prime är inte tillgängligt i USA.
Wan 2.6
En filmisk videoplattform av nästa generation som använder en enhetlig multimodal arkitektur för att leverera produktionsklart innehåll i 1080p med inbyggd ljudsynkronisering och intelligent sekvensering av flera tagningar.
Indata för generering:
- Text-till-video
- Startbildruta (bild-till-video)
- Videoreferens (video-till-video)
- Ljudreferens (valfritt bakgrundsljud eller dialog)
Funktioner:
- Enhetligt multimodalt system: Bearbetar text, bilder, video och ljud via ett enda integrerat ramverk för konsekvent utdatakvalitet
- Inbyggd ljudsynkronisering: Genererar och synkroniserar automatiskt dialog, berättarröst och miljöljudeffekter med rörelserna på skärmen
- Intelligent sekvensering av flera tagningar: Organiserar automatiskt sammanhängande videosekvenser till tydliga berättelsebågar och bibehåller samtidigt konsekventa karaktärer
- Förlängda längder: Stöder stabil generering med hög kvalitet i fasta längder på 5 s, 10 s och 15 s
- Avancerad kreativ styrning: Stöder negativa prompter för detaljerad hantering och batchskapande av upp till 4 variationer
Utdataval:
- Upplösningar: 720p, 1080p
- Bildförhållanden: 16:9, 4:3, 1:1, 3:4, 9:16
Passar bäst för:
- Professionellt berättande och komplexa filmiska sekvenser med flera tagningar
- Annonser i sociala medier och marknadsföringsinnehåll som kräver integrerat ljud med hög precision
- Karaktärsdrivet innehåll som kräver strikt visuell konsekvens och konsekventa rörelser via videoreferenser
Kostnad: Varierar beroende på valda inställningar och längd
Wan 2.6 är inte tillgängligt i USA.
Wan 2.5 Video
En mångsidig modell som levererar filmiska rörelser och hög följsamhet till prompten från text eller en startbild.
Indata för generering:
- Text-till-video
- Startbildruta (bild-till-video)
Funktioner:
- Detaljerad kreativ styrning med negativa prompter och särskild ljudstyrning
- Fasta längder: 5 s och 10 s
- Batchskapande med upp till 4 genereringar åt gången
Utdataval:
- Upplösningar: 480p, 720p, 1080p
- Bildförhållanden: 16:9, 1:1, 9:16
Passar bäst för:
- Filmiskt innehåll med hög följsamhet till prompten
Kostnad: Varierar beroende på valda inställningar och längd
Genereringskostnaden varierar beroende på valda inställningar.
Wan 2.5 Video är inte tillgängligt i USA.
Generativa bildmodeller
GPT Image 2.5 Sunburst
OpenAI:s bildmodell i produktionskvalitet för mycket detaljerade resultat och exakt redigering.
Indata för generering:
- Text-till-bild
- Bildreferenser (upp till 10)
Funktioner:
- Fem kvalitetsnivåer från låg till maximal
- Anpassad upplösning på upp till 3840 px per sida, med bildförhållanden på upp till 3:1
- Batchskapande med upp till 4 genereringar åt gången
Utdataval:
- Upplösningar: 1K, 2K, 4K eller anpassad
- Bildförhållanden: 3:1, 21:9, 2:1, 16:9, 3:2, 4:3, 5:4, 1:1, 4:5, 3:4, 2:3, 9:16, 1:2, 1:3
Passar bäst för:
- Slutliga material där detaljer och precision är viktigast
- Exakta redigeringar av befintliga bilder
Kostnad: Varierar beroende på valda inställningar och antal variationer
GPT Image 2.5 Flare
En snabb GPT Image 2.5-variant med samma reglage som Sunburst, anpassad för vardaglig generering i stora volymer.
Indata för generering:
- Text-till-bild
- Bildreferenser (upp till 10)
Funktioner:
- Fem kvalitetsnivåer från låg till maximal
- Anpassad upplösning på upp till 3840 px per sida, med bildförhållanden på upp till 3:1
- Batchskapande med upp till 4 genereringar åt gången
Utdataval:
- Upplösningar: 1K, 2K, 4K eller anpassad
- Bildförhållanden: 3:1, 21:9, 2:1, 16:9, 3:2, 4:3, 5:4, 1:1, 4:5, 3:4, 2:3, 9:16, 1:2, 1:3
Passar bäst för:
- Bildgenerering i stora volymer
- Snabba iterationer som ändå behöver 4K och anpassade storlekar
Kostnad: Varierar beroende på valda inställningar och antal variationer
API: gpt-image-2.5-flare
GPT Image 2
En avancerad AI-modell som är utformad för exakt bildgenerering med förbättrad textåtergivning och funktioner för högupplösta utdata.
Funktioner:
- Exakt textstyrning för att skapa bilder med korrekt typografi och tydlighet
- Högupplöst PNG-utdata som passar professionell och kommersiell användning
- Stöder flera bildreferenser för att styra stil och komposition
- Genererar upp till 4 bilder åt gången
Utdataval:
- Bildförhållanden: 3:2, 1:1, 2:3
- Kvalitetsalternativ: låg, medel, hög
Passar bäst för:
- Marknadsföringsbilder och designmaterial som kräver exakt textplacering
- Professionellt innehåll med krav på hög upplösning
- Kreativa projekt som behöver exakt textbaserad bildstyrning
Kostnad: Varierar beroende på valda inställningar och antal variationer
API: gpt-image-2
Nano Banana 2.1
En bildmodell med inbyggd 4K-utdata och upp till 14 bildreferenser.
Indata för generering:
- Text-till-bild
- Bildreferenser (upp till 14)
Utdataval:
- Upplösningar: 4K
- Bildförhållanden: 8:1 till 1:8 samt auto
Passar bäst för:
- Referensstyrda bilder som behöver inbyggd 4K
Kostnad: Varierar beroende på valda inställningar och antal variationer
Nano Banana 2
En avancerad AI-modell för bildgenerering som kombinerar produktionsklar kvalitet med ultrasnabb bearbetning, förbättrad kunskap om världen och konsekventa motiv.
Funktioner:
- Inbyggd 4K-upplösning utan uppskalning för kristallklara detaljer
- Blixtsnabb bildgenerering på så lite som 1–2 sekunder
- Överlägsen följsamhet till prompten genom avancerat resonemang och instruktionsefterlevnad
- Skarp och korrekt textåtergivning på flera språk för mockups, skyltar och infografik
- Konsekvent stil för flera motiv som bevarar identiteten för flera karaktärer och objekt
- Förbättrad kunskap om världen för mer exakt generering av scener
- Stöder flera bildreferenser för att styra genereringen
- Genererar upp till 4 bilder åt gången
Utdataval:
- Bildförhållanden: 21:9, 16:9, 5:4, 4:3, 3:2, 1:1, 2:3, 3:4, 4:5, 9:16
- Upplösningar: Upp till 4K
Passar bäst för:
- Snabba kreativa arbetsflöden som kräver iterationer i realtid
- Varumärkesinnehåll och berättande med konsekvent karaktärsidentitet
- Professionella bilder med korrekt text och typografi
Kostnad: Varierar beroende på valda inställningar och antal variationer
Nano Banana 2 Lite
En snabb och billig variant av Nano Banana 2 för snabb generering och redigering i 1K.
Indata för generering:
- Text-till-bild
- Bildreferenser (upp till 14)
Funktioner:
- Fast 1K-utdata för konsekvent hastighet och kostnad
- Samma kapacitet för 14 bildreferenser som Nano Banana 2
- Batchskapande med upp till 4 genereringar åt gången
Utdataval:
- Upplösningar: 1K
- Bildförhållanden: 21:9, 16:9, 5:4, 4:3, 3:2, 1:1, 2:3, 3:4, 4:5, 9:16
Passar bäst för:
- Snabba iterationer och utkast
- Massredigeringar där 1K räcker
Kostnad: Varierar beroende på valda inställningar och antal variationer
Krea 2 Medium
En mångsidig, produktionsklar modell för bildgenerering från Krea AI som balanserar kvalitet och hastighet för många olika kreativa arbetsflöden.
Funktioner:
- Bildgenerering med hög precision och hög följsamhet till prompten
- Stöder flera bildreferenser för att styra genereringen
- Genererar upp till 4 bilder åt gången
Utdataval:
- Bildförhållanden: 16:9, 4:3, 1:1, 3:4, 9:16
Passar bäst för:
- Professionell innehållsproduktion som kräver jämn kvalitet
- Snabba iterationer av olika kreativa koncept
Kostnad: Varierar beroende på valda inställningar och antal variationer
Krea 2 Large
Krea AI:s flaggskeppsmodell för bildgenerering, med högsta möjliga visuella exakthet och avancerad kreativ kontroll för professionella produktionsflöden.
Funktioner:
- Enastående detaljrikedom och realism för resultat i professionell kvalitet
- Avancerad stilkontroll med stöd för flera bildreferenser
- Genererar upp till 4 bilder åt gången
Utdataval:
- Bildformat: 16:9, 4:3, 1:1, 3:4, 9:16
Passar för:
- Exklusiv kommersiell och redaktionell bildproduktion
- Komplexa kreativa kompositioner som kräver maximal exakthet
Kostnad: Varierar beroende på valda inställningar och antal variationer
Recraft V4.1
En designfokuserad text-till-bild-modell med bra promptkontroll och rena kompositioner.
Indata för generering:
- Text-till-bild
Funktioner:
- 2K-utdata använder Pro-modellvarianten
- Batchskapande med upp till 4 genereringar åt gången
Utdataval:
- Upplösningar: 1K, 2K
- Bildformat: 2:1, 16:9, 3:2, 14:10, 4:3, 5:4, 1:1, 4:5, 3:4, 10:14, 2:3, 6:10, 9:16, 1:2
Passar för:
- Layoutdriven grafik, ikoner och affischer
- Rena kompositioner enbart från text
Kostnad: Varierar beroende på valda inställningar och antal variationer
Recraft V4.1 Flash
En snabb, designfokuserad text-till-bild-modell.
Indata för generering:
- Text-till-bild
Utdataval:
- Bildformat: 16 format
Passar för:
- Layoutdriven grafik enbart från text
Kostnad: Varierar beroende på valda inställningar och antal variationer
Recraft V4
En designfokuserad bildmodell som kan matcha stilen i referensbilder.
Indata för generering:
- Text-till-bild
- Stilreferenser (upp till 10)
Funktioner:
- Kontroll för stilmatchning: Precise följer referensstilen nära, Flexible matchar det övergripande utseendet
- 2K-utdata använder Pro-modellvarianten
- Batchskapande med upp till 4 genereringar åt gången
Utdataval:
- Upplösningar: 1K, 2K
- Bildformat: 2:1, 16:9, 3:2, 14:10, 4:3, 5:4, 1:1, 4:5, 3:4, 10:14, 2:3, 6:10, 9:16, 1:2
Passar för:
- Varumärkeskonsekvent grafik från en uppsättning stilreferenser
- Illustrations- och designarbete
Kostnad: Varierar beroende på valda inställningar och antal variationer
Seedream 5 Lite
En lättviktig bildmodell från ByteDance med snabb generering, som ger resultat av hög kvalitet med lägre beräkningskrav.
Funktioner:
- Snabb generering för snabb kreativ iteration
- Stöder flera bildreferenser för att vägleda genereringen
- Genererar upp till 4 bilder åt gången
Utdataval:
- Bildformat: 16:9, 4:3, 1:1, 3:4, 9:16
Passar för:
- Arbetsflöden för bildskapande i stora volymer som kräver snabbhet
- Snabb utforskning av koncept och förhandsvisningar
Kostnad: Varierar beroende på valda inställningar och antal variationer
API: bytedance-seedream-5-lite
Seedream 5 Lite är inte tillgänglig i USA.
Seedream 5 Pro
Varianten Seedream 5 med högre exakthet för precis redigering, flerspråkig text och detaljrika infografiker.
Indata för generering:
- Text-till-bild
- Bildreferenser (upp till 10)
Funktioner:
- Exakt återgivning av flerspråkig text
- Hanterar detaljrika layouter som infografiker och affischer
- Batchskapande med upp till 4 genereringar åt gången
Utdataval:
- Upplösningar: 1K, 2K
- Bildformat: 16:9, 4:3, 1:1, 3:4, 9:16
Passar för:
- Texttunga designer på flera språk
- Redigering med flera bilder och strikt följsamhet till referenser
Kostnad: Varierar beroende på valda inställningar och antal variationer
Seedream 5 Pro är inte tillgänglig i USA.
GPT Image 1.5
En snabb flaggskeppsmodell för precis textbaserad bildgenerering och komplex, icke-destruktiv fotoredigering som bevarar originaldetaljer.
Funktioner:
- Utför pålitligt begärda ändringar samtidigt som ljussättning, komposition och motivets utseende i källbilder bevaras
- Stöder komplexa redigeringsuppgifter, inklusive att lägga till, ta bort, kombinera och blanda element
- Levererar resultat upp till 4 gånger snabbare än tidigare iterationer
- Genererar upp till 4 bilder åt gången
Utdataval:
- Bildformat: 3:2, 1:1, 2:3
- Kvalitetsalternativ: låg, medel, hög
Passar för:
- Praktiska fotojusteringar och realistisk virtuell provning av kläder eller frisyrer
- Konceptuella omvandlingar och stilistiska filter som behåller kärnan i indatabilden
- Snabb iteration av text-till-bild-koncept
Kostnad: Varierar beroende på valda inställningar och antal variationer
API: gpt-image-1.5
GPT Image 1
OpenAI:s första generationens bildmodell med bra promptföljsamhet, läsbar text och detaljerad redigering.
Indata för generering:
- Text-till-bild
- Bildreferenser (upp till 5)
Funktioner:
- Tre kvalitetsnivåer: låg, medel, hög
- Batchskapande med upp till 4 genereringar åt gången
Utdataval:
- Bildformat: 3:2, 1:1, 2:3
Passar för:
- Arbetsflöden som redan bygger på utdata från GPT Image 1
- Enkla redigeringar och text-i-bild-uppgifter i standardupplösning
Kostnad: Varierar beroende på valda inställningar och antal variationer
API: gpt-image-1
Seedream 4.5
En högpresterande multimodal grundmodell som samlar text-till-bild-syntes, precis bildredigering och komplex komposition med flera bilder i ett enda effektivt ramverk.
Funktioner:
- Inbyggt stöd för snabb generering av högupplösta bilder upp till 4K
- Exceptionellt bevarande av ansiktsdrag, ljussättning, färgton och fina detaljer vid redigeringsuppgifter baserade på referensindata
- Identifierar och blandar korrekt målelement i flera indatabilder för kontrollerbara, konsekventa resultat
- Erbjuder kompositionsmöjligheter på designernivå med tydlig, exakt återgivning av liten text för affischer och varumärkesbilder
- Genererar upp till 4 bilder åt gången
Utdataval:
- Bildformat: 16:9, 4:3, 1:1, 3:4, 9:16
- Upplösningar: 2K, 4K
Passar för:
- Professionella arbetsflöden för grafisk design som kräver exakt layout och typografi
- Komplex fotoredigering som kräver strikt följsamhet till referensidentitet och ljussättning
- Kreativ komposition i hög upplösning med flera visuella källor
Kostnad: Varierar beroende på valda inställningar och antal variationer
Seedream 4.5 är inte tillgänglig i USA.
Kling O1 Image
En bildgenereringsmodell med hög exakthet och avancerad slutledningsförmåga, utformad för överlägsen promptföljsamhet och precis visuell konsekvens i komplexa kompositioner.
Funktioner:
- Enastående förmåga att tolka och utföra detaljerade textbeskrivningar med flera lager med hög precision
- Använder bildreferenser för att behålla motivets identitet, ljussättning och estetiska stil mellan genereringar
- Optimerad för realistiska texturer, komplexa rumsliga relationer och ljuseffekter i professionell kvalitet
- Genererar upp till 4 bilder åt gången
Utdataval:
- Bildformat: Auto, 16:9, 9:16, 1:1, 4:3, 3:4, 3:2, 2:3, 21:9
- Upplösningar: 1K, 2K
Passar för:
- Professionella kreativa tillgångar som kräver strikt följsamhet till detaljerade och tekniska textprompter
- Bildredigering med hög konsekvens och karaktärsdesign med visuella referenser
Kostnad: Varierar beroende på valda inställningar och antal variationer
Kling O1 Image är inte tillgänglig i USA.
FLUX.2 [Pro]
En produktionsklar modell för bildgenerering och redigering, utformad för professionella arbetsflöden och med toppmodern visuell kvalitet med fokus på snabbhet, precision och konsekvens.
Funktioner:
- Referera till flera bilder samtidigt för branschledande konsekvens för karaktärer och identitet i hundratals tillgångar
- Ger ett aldrig tidigare skådat lyft i detaljkvalitet och minskar skillnaden mot verklig fotografering, från tygtexturer till arkitektoniska element
- Levererar produktionsklar textåtergivning för komplex typografi, UI-mockups och infografiker
- Stöder exakt specifikation av varumärkesfärger via hexkoder utan approximation
- Säkerställer korrekt objektplacering, realistisk fysik, sammanhängande ljussättning och rätt perspektiv i komplexa scener
- Optimerad för bättre precision och respons på strukturerade, komplexa instruktioner
- Genererar upp till 4 bilder åt gången
Utdataval:
- Bildformat: 16:9, 4:3, 1:1, 3:4, 9:16
- Upplösningar: 720p, 1080p, 2K
Passar för:
- Kampanjer med konsekventa karaktärer och exakt placering av produkter i valfri miljö
- Att skapa gränssnittsmockups med läsbar text och konsekventa visuella designsystem
- Att generera produktfotografi i stor skala och kontextuella livsstilsbilder
Kostnad: Varierar beroende på valda inställningar och antal variationer
Nano Banana Pro
En professionell, resonemangsbaserad modell för bildgenerering och redigering, utformad för tillgångsproduktion med hög exakthet, avancerad kreativ kontroll och precis instruktionsefterlevnad.
Indata:
- Bildreferens
- Textbeskrivning (stöder komplexa prompter med flera lager)
Funktioner:
- Planerar scener före rendering för att ge fysiskt korrekt ljussättning, korrekta objektrelationer och överlägsen promptföljsamhet
- Genererar skarp, läsbar flerspråkig text i olika typsnitt och handstilar för slagkraftiga affischer och produktmockups
- Bibehåller hög exakthet och likhet för upp till 5 personer och flera objekt i olika kreativa resultat
- Integrerar Google Search för att förbättra bilder med faktiska data, verklig kunskap och realtidsinformation som väder eller sport
- Justera kameravinklar, fokuspunkter och scenljus (t.ex. från dag till natt) med avancerade lokala redigeringsverktyg
- Överlägsen rumsuppfattning möjliggör generering av exakta infografiker, tekniska diagram och presentationsbilder
- Genererar upp till 4 variationer åt gången
Utdataval:
- Upplösningar: 1K, 2K, 4K
- Bildformat: Auto, 21:9, 16:9, 5:4, 4:3, 3:2, 1:1, 2:3, 3:4, 4:5, 9:16
Passar för:
- Professionell annonsering, varumärkestillgångar och exklusiv produktfotografi för e-handel
- Pedagogiska förklaringar, datadrivna infografiker och komplex teknisk dokumentation
- Snabb prototypframtagning av högupplösta visuella designer med konsekvent karaktärs- eller varumärkesidentitet
Kostnad: Varierar beroende på valda inställningar och antal variationer
API: gemini-3-pro-image
Nano Banana
En snabb modell för snabb bildgenerering och redigering av hög kvalitet direkt från textprompter.
Funktioner:
- Stöder flera bildreferenser för att vägleda genereringen
- Genererar upp till 4 bilder åt gången
Utdataval:
- Bildformat: 21:9, 16:9, 5:4, 4:3, 3:2, 1:1, 2:3, 3:4, 4:5, 9:16
Passar för:
- Snabbt bildskapande och iteration
Kostnad: Varierar beroende på valda inställningar och antal variationer
Runway Gen-4 Image
En avancerad grundmodell för bildgenerering med hög exakthet, som erbjuder oöverträffad stilkontroll och visuellt minne för att behålla konsekvens mellan scener.
Funktioner:
- Förankra karaktärer, stilar eller specifika objekt med indatabilder för konsekvens i professionell kvalitet mellan flera resultat
- Optimerad för att tolka komplexa beskrivningar på naturligt språk för precis kontroll över visuella detaljer, ljussättning och känslor
- Kan generera visuellt material av hög kvalitet för många användningsområden, från filmiska storyboards till professionell produktfotografi
- Genererar upp till 4 bilder åt gången
Utdataval:
- Bildformat: 16:9, 4:3, 1:1, 3:4, 9:16
- Upplösningar: 720p, 1080p
Passar för:
- Att säkerställa att huvudpersoner behåller sitt utseende i olika miljöer och ljussättningar
- Snabb produktion av högupplösta varumärkestillgångar, virtuella provningar och skalbara produktvisualiseringar
- Att utforska olika konstnärliga riktningar medan den visuella kärnidentiteten låses med bildreferenser
Kostnad: Varierar beroende på valda inställningar och antal variationer
Runway Gen-4 Image Turbo
En optimerad bildgenereringsmodell utvecklad för snabbhet, som levererar resultat 2,5 gånger snabbare än standardmodellen Gen-4 Image med samma utdatakvalitet.
Funktioner:
- Optimerad bearbetning möjliggör snabb kreativ utforskning och genererar bilder med hög exakthet på en bråkdel av tiden
- Ladda upp upp till tre referensbilder för att vägleda modellens förståelse av specifika karaktärer, miljöer och konstnärliga stilar
- Löser problemet med visuell avdrift genom att koda specifika visuella egenskaper från referensbilder för att behålla identiteten mellan flera genereringar
- Tillämpa enkelt estetiken, ljussättningen och texturen från en referensbild på helt nya motiv och scener
- Använd seed-parametrar för att systematiskt utforska variationer eller återskapa specifika resultat med precision
- Genererar upp till 4 bilder åt gången
Utdataval:
- Bildformat: 16:9, 4:3, 1:1, 3:4, 9:16
- Upplösningar: 720p, 1080p
Passar för:
- Snabb produktion i stor skala av plattformsoptimerade bilder för Instagram Stories (9:16) eller vanliga inlägg (1:1)
- Att behålla strikt visuell identitet mellan kampanjer genom att använda varumärkets stilguider som referensbilder
- Att utveckla konsekventa karaktärsposer och miljöer samtidigt som huvudpersonen förblir igenkännbar
- Att skapa varierade livsstils- och säsongsbilder av produkter exakt med referensbaserad vägledning
Kostnad: Varierar beroende på valda inställningar och antal variationer
Seedream 4
En specialiserad bildmodell för att generera sekvenser med flera bilder eller scener med stora rörelser och mycket action.
Funktioner:
- Utmärker sig vid skapande av bilder med stabil fysik och sammanhängande övergångar
- Stöder flera bildreferenser för att vägleda genereringen
- Genererar upp till 4 bilder åt gången
Utdataval:
- Bildformat: auto, 16:9, 4:3, 1:1, 3:4, 9:16
Passar för:
- Actionscener och dynamiska kompositioner
Kostnad: Varierar beroende på valda inställningar och antal variationer
Seedream 4 är inte tillgänglig i USA.
Wan 2.5 Image
Bildvarianten av Wan 2.5, med hög promptföljsamhet och stöd för referensbilder.
Indata för generering:
- Text-till-bild
- Bildreferenser (upp till 2)
Funktioner:
- Kontroller för negativ prompt och seed
- Batchskapande med upp till 4 genereringar åt gången
Utdataval:
- Bildformat: 16:9, 4:3, 1:1, 3:4, 9:16
Passar för:
- Stillbilder som matchar utseendet på Wan-videogenereringar
- Konceptbilder som följer prompten
Kostnad: Varierar beroende på valda inställningar och antal variationer
Wan 2.5 Image är inte tillgänglig i USA.
FLUX 3 Image
En bildmodell med upp till 10 bildreferenser och 4K-utdata.
Indata för generering:
- Text-till-bild
- Bildreferenser (upp till 10)
Utdataval:
- Upplösningar: 4K
- Bildformat: 16 format
Passar för:
- Referensstyrda bilder i 4K
Kostnad: Varierar beroende på valda inställningar och antal variationer
FLUX.1 Kontext [Pro]
En professionell modell för avancerad bildgenerering och redigering, med stark scenkonsekvens och stilkontroll.
Funktioner:
- Bildbaserad stilkontroll som kräver en referensbild för att vägleda det visuella uttrycket
- Genererar upp till 4 bilder åt gången
Utdataval:
- Bildformat: 21:9, 16:9, 4:3, 3:2, 1:1, 2:3, 3:4, 4:5, 9:16, 9:21
Passar för:
- Professionellt innehåll med exakta stilkrav
Kostnad: Varierar beroende på valda inställningar och antal variationer
Läppsynkningsmodeller
Creatify Aurora
En avancerad diffusion transformer-modell (DiT) som är utformad för att rendera ultrarealistiska, reaktiva avatarer som styrs av ljud- och textinstruktioner.
Inmatning för generering:
- Avatar (källbild)
- Tal (ljudfil)
- Textbeskrivning (instruktion)
Funktioner:
- Går längre än grundläggande läppsynkning med kontextmedvetna blinkningar, andning och naturliga ansiktsuttryck
- Synkroniserar automatiskt hand- och helkroppsrörelser utifrån röstton och betoning för ett resultat i studiokvalitet
- Tolkar exakt röstintensitet och tonhöjd för att ge känslouttryck som stämmer med framförandet
- Bibehåller hög karaktärstrohet och konsekvent beteende även i längre dialoger eller musikframträdanden
- Optimerad för olika upplägg, bland annat presentationer från sidan, dialoger i podcaststil och stiliserade animationer
- Generera upp till 4 variationer åt gången
Utalternativ:
- Upplösningar: 480p, 720p
Passar för:
- Professionella videoannonser och marknadsföringsinnehåll med avatarer
- Virtuellt berättande med hög detaljrikedom och uttrycksfulla musikframträdanden
- Långa utbildnings- eller träningsvideor som kräver en konsekvent karaktärsnärvaro
Kostnad: Varierar beroende på inmatning, inställningar och längd
API: creatify-aurora
Veed Fabric
En snabb och exakt bild-till-video-modell för läppsynkning som animerar en stillbild för att matcha angivet ljud.
Inmatning:
- Källbild
- Talljudfil
Funktioner:
- Animerar munnen och ansiktsuttrycken i källbilden så att de matchar angivet ljud
- Skapar högkvalitativ “talande” video från stillbilder
- Ett specifikt verktyg för läppsynkning, inte en fullständig videogenereringsmodell
Passar för:
- Skapa talande avatarer från stillbilder
- Lägga till dialog i karaktärsporträtt
- Professionella arbetsflöden för avatarbaserat innehåll
Kostnad: Varierar beroende på inmatning, inställningar och längd
För bästa resultat bör bilden innehålla en identifierbar person.
HeyGen Avatar 4
HeyGens senaste avatarmodell för att skapa mycket realistiska och uttrycksfulla videor med talande personer från en enda bild och ljudinmatning.
Inmatning:
- Källbild
- Talljudfil
Funktioner:
- Animerar ansiktsuttryck och läpprörelser så att de matchar angivet ljud med hög precision
- Skapar naturliga huvudrörelser och subtila mikrouttryck för verklighetstrogna resultat
- Ett specifikt verktyg för läppsynkning, inte en fullständig videogenereringsmodell
Passar för:
- Professionella videor med talespersoner och presentatörer
- Skapa personligt avatarinnehåll i stor skala
- Marknadsförings- och utbildningsvideor med konsekvent karaktärsnärvaro
Kostnad: Varierar beroende på inmatning, inställningar och längd
För bästa resultat bör bilden innehålla ett tydligt synligt ansikte.
Sync 3
Den senaste generationens modell för videoläppsynkning från Sync, som ger synkning i studiokvalitet för många olika typer av innehåll.
Inmatning för generering:
- Källvideo
- Talljud
Funktioner:
- Läppsynkning med hög precision som bevarar unika ansiktsdetaljer, naturliga tänder och hudtextur
- Optimerad för alla innehållstyper, inklusive live action, 3D-animation och AI-genererad video
- Ett video-till-video-verktyg för läppsynkning, inte en fullständig videogenerator
Passar för:
- Professionell dubbning och lokalisering för film och reklam
- Förbättra eller korrigera dialog i alla videoformat
- Arbetsflöden för översättning av stora mängder innehåll
Kostnad: Varierar beroende på inmatning, inställningar och längd
För bästa resultat bör videon innehålla en identifierbar person.
Sync Lipsync 2 Pro
En avancerad videoredigeringsmodell för läppsynkning i studiokvalitet som bevarar unika ansiktsdetaljer och kan skalas till utdata med hög upplösning.
Inmatning för generering:
- Källvideo
- Talljud
Funktioner:
- Har avancerad uppskalning som stöder 4K-utdata och samtidigt behåller skarpa, naturliga texturer
- Skyddar unika ansiktsdrag som naturliga tänder, fräknar, smink och komplex ansiktsbehåring utan att tydligheten försämras
- Optimerad för alla innehållstyper, inklusive live action, 3D-animation och AI-genererad video
- Ger uttrycksfulla, synkroniserade resultat direkt utan träning för en specifik talare eller finjustering av modellen
- Generera upp till 4 variationer samtidigt
Passar för:
- Dubbning i professionell kvalitet och lokaliserat innehåll för film och exklusiv reklam
- Förbättra eller korrigera dialog för 3D-animerade och AI-genererade karaktärer
- Projekt i hög upplösning som kräver pixelperfekt konsekvens och detaljrikedom i ansiktet
Kostnad: Varierar beroende på inmatning, inställningar och längd
OmniHuman 1.5
En specialiserad verktygsmodell för att skapa exceptionellt realistisk, människolik läppsynkning.
Inmatning:
- Statisk källbild
- Talljudfil
Funktioner:
- Animerar munnen i källbilden så att den matchar angivet ljud
- Skapar högkvalitativ “talande” video från stillbilder
- Ett specifikt verktyg för läppsynkning, inte en fullständig videogenereringsmodell
Passar för:
- Skapa talande avatarer
- Lägga till dialog i stillbilder
- Professionella arbetsflöden för dubbning
Kostnad: Varierar beroende på inmatning, inställningar och längd
För bästa resultat bör bilden innehålla en identifierbar person.
OmniHuman 1.5 är inte tillgängligt i USA.
MiniMax H3 Max Lip Sync
Animerar en stillbild utifrån ett talklipp, med utdata upp till 2K.
Inmatning:
- Källbild
- Talljud (5 s till 14,8 s)
Funktioner:
- Ett specifikt verktyg för läppsynkning, inte en fullständig videogenereringsmodell
Passar för:
- Talande porträtt från en stillbild och ett kort ljudklipp
Kostnad: Varierar beroende på inmatning, inställningar och längd
Veed Lipsync
En snabb, prisvärd och exakt verktygsmodell för att lägga till realistisk läppsynkning i videor.
Inmatning:
- Källvideo
- Ny talljudfil
Funktioner:
- Animerar om munrörelserna i källvideon så att de matchar det nya ljudet
- Ett video-till-video-verktyg för läppsynkning, inte en fullständig videogenerator
Passar för:
- Kostnadseffektiv dubbning i stora volymer
- Översätta innehåll
- Korrigera ljud i videoklipp med realistiska resultat
Kostnad: Varierar beroende på inmatning, inställningar och längd
För bästa resultat bör videon innehålla en identifierbar person.
Veed Lipsync 2.0
Uppföljaren till Veed Lipsync med högre kvalitet för att lägga till realistisk läppsynkning i befintliga videor.
Inmatning:
- Källvideo
- Ny talljudfil
Funktioner:
- Animerar om munrörelserna i källvideon så att de matchar det nya ljudet
- Ett video-till-video-verktyg för läppsynkning, inte en fullständig videogenerator
- Batchskapande med upp till 4 genereringar åt gången
Passar för:
- Dubbning och översättning där utdatakvalitet är viktigare än kostnad
- Korrigera dialog i färdiga klipp
Kostnad: Varierar beroende på inmatning, inställningar och längd
För bästa resultat bör videon innehålla en identifierbar person.
Verktygsmodeller
Topaz Image Upscale
Ökar upplösningen på en bild samtidigt som detaljerna bevaras.
Inmatning:
- Källbild
Funktioner:
- Uppskalningsfaktorer: 1.25x, 1.5x, 2x, 3x, 4x
Passar för:
- Förbereda bilder för skärmar med hög upplösning
Kostnad: Varierar beroende på inmatning
Topaz Video Upscale
Ökar upplösningen på en video samtidigt som detaljerna bevaras.
Inmatning:
- Källvideo
Funktioner:
- Uppskalningsfaktorer: 1.25x, 1.5x, 2x, 3x, 4x
- Snabba och exakta bearbetningslägen
- Valfri konvertering av bildfrekvens till 24, 25, 30, 48, 50 eller 60 fps
Passar för:
- Förbereda video för skärmar med hög upplösning
Kostnad: Varierar beroende på inmatning
Borttagning av bakgrund
Tar bort bakgrunden från en bild och returnerar den med alfatransparens.
Inmatning:
- Källbild
Funktioner:
- Ingen prompt krävs
- En utdata per körning
Passar för:
- Produktfriläggning och kompositering
- Förbereda motiv för användning som referenser i andra genereringar
Kostnad: Varierar beroende på inmatning
Borttagning av videobakgrund
Tar bort bakgrunden från en video.
Inmatning:
- Källvideo
Funktioner:
- Ingen prompt krävs
- Utdatabakgrunden kan vara transparent, svart eller grön
Passar för:
- Frilägga ett motiv från befintligt videomaterial
- Förbereda video för kompositering
Kostnad: Varierar beroende på inmatning
Runway Ruby
Konverterar video med standarddynamiskt omfång till HDR.
Inmatning:
- Källvideo (upp till 30 s)
Funktioner:
- Ingen prompt krävs
- En utdata per körning; längd och bildutsnitt följer källan
Passar för:
- Förbereda videomaterial för HDR-skärmar
- Färgkorrigera genererad video på nytt inför leverans
Kostnad: Varierar beroende på videons längd
Vanliga frågor
|
|