Obrazy i wideo
Kompletny przewodnik po tworzeniu i edycji obrazów oraz wideo w ElevenLabs.
Omówienie
Obrazy i wideo pozwalają tworzyć wysokiej jakości materiały wizualne z prostych opisów tekstowych lub obrazów referencyjnych. Generuj statyczne obrazy lub dynamiczne wideo w dowolnym stylu, a potem dopracowuj je kolejnymi promptami, zwiększaj rozdzielczość i dodawaj synchronizację ruchu ust z audio. Gotowe materiały możesz eksportować jako osobne pliki lub importować bezpośrednio do projektów ElevenCreative Studio.
Niektóre modele Obrazy i wideo oraz funkcje przesyłania materiałów są ograniczone w Stanach Zjednoczonych ze względu na wymogi prawne lub dostawców. Sprawdź opisy poszczególnych modeli, aby poznać ich dostępność.
Użytkownicy planu darmowego mogą generować tylko obrazy i są ograniczeni do trzech próśb o obraz dziennie. Generowanie wideo wymaga płatnego planu.
Przewodnik
Wykonaj te kroki, aby utworzyć pierwszy materiał wizualny:
Wybierz tryb
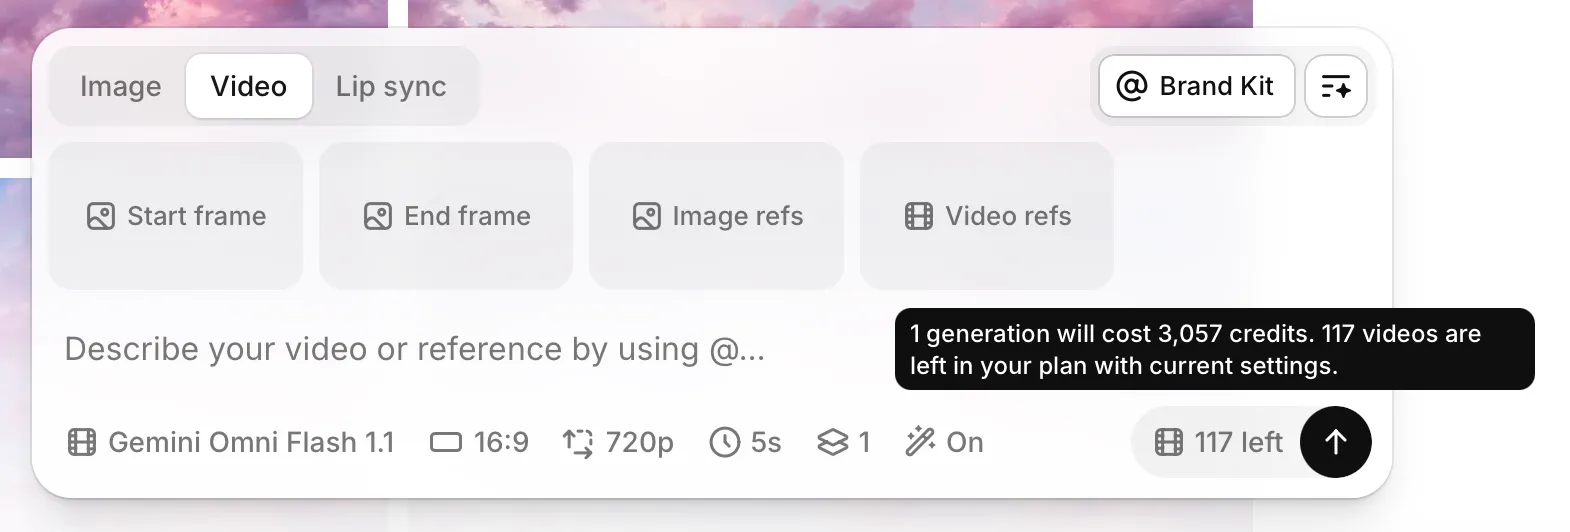
Użyj przełącznika w prawym górnym rogu pola promptu, aby wybrać generowanie Obrazu lub Wideo.
Podaj prompt lub materiał referencyjny
Opisz oczekiwany wynik językiem naturalnym w polu promptu. Aby mieć większą kontrolę, przeciągnij istniejące obrazy lub wideo z kart Explore albo History do pól referencyjnych lub prześlij własne obrazy referencyjne w wielu formatach, w tym JPG, PNG, WEBP i innych.
Wybierz model i ustawienia
Wybierz model generatywny najlepiej pasujący do celu (np. Google Veo 3.1, Kling 2.5, Flux 1 Kontext Pro). Szczegółowe informacje o każdym modelu znajdziesz w sekcji Modele. Dostosuj ustawienia, takie jak proporcje obrazu, rozdzielczość, czas trwania (dla wideo) i liczbę generowanych wariantów.
Wygeneruj materiał
Kliknij przycisk Generate. Twoje materiały zostaną utworzone i wyświetlone na karcie History do sprawdzenia.
Ulepsz i dopracuj
Użyj narzędzi ulepszania, aby dopracować materiały. Upscale zwiększa rozdzielczość, LipSync dodaje realistyczną synchronizację ruchu ust z audio, a Recreate generuje nowy wariant z tymi samymi ustawieniami.
Workflow
Proces tworzenia prowadzi od inspiracji do gotowego materiału w czterech etapach:
Explore
Odkrywaj materiały społeczności, aby znaleźć inspirację, analizować skuteczne prompty lub przenosić materiały referencyjne bezpośrednio do własnej pracy.
Generate
Użyj pola promptu, aby opisać, co chcesz stworzyć, wybierz model, dopracuj ustawienia i zrealizuj swój pomysł.
History
Przeglądaj generacje na karcie History, aby je rozwijać i ulepszać. Twórz warianty ponownie, wykorzystuj prompty i stosuj ulepszenia, takie jak zwiększanie rozdzielczości czy synchronizacja ruchu ust.
Export
Pobieraj gotowe materiały w różnych formatach lub wysyłaj je bezpośrednio do ElevenCreative Studio, aby użyć ich w projektach.
Explore
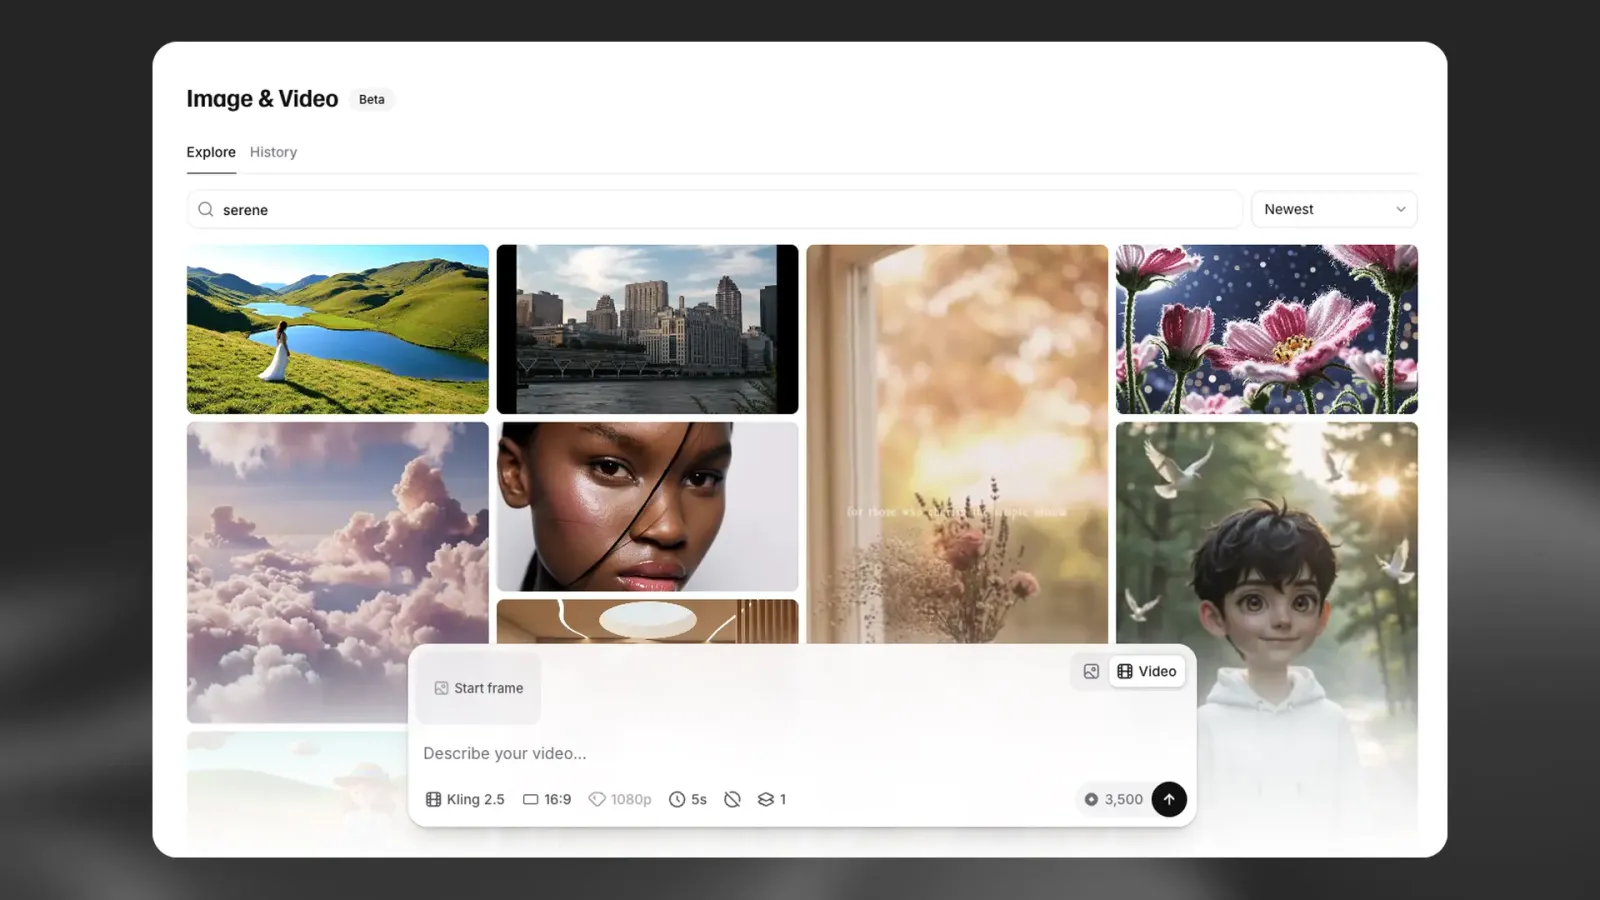
Karta Explore wyświetla galerię materiałów społeczności, w której możesz szukać inspiracji i materiałów wizualnych do użycia jako referencje.
Szukaj: Użyj paska wyszukiwania, aby znajdować obrazy i wideo na podstawie słów kluczowych.
Sortuj: Przełączaj między Trending i Newest, aby zobaczyć popularne lub niedawno dodane materiały.
Przeciągnij i upuść: Przeciągnij dowolny wynik z siatki bezpośrednio do pola promptu, aby użyć go jako klatki początkowej, końcowej lub referencji stylu.
Podgląd szczegółów: Kliknij dowolny kafelek, aby zobaczyć pełny prompt i ustawienia użyte do jego utworzenia.
Generate
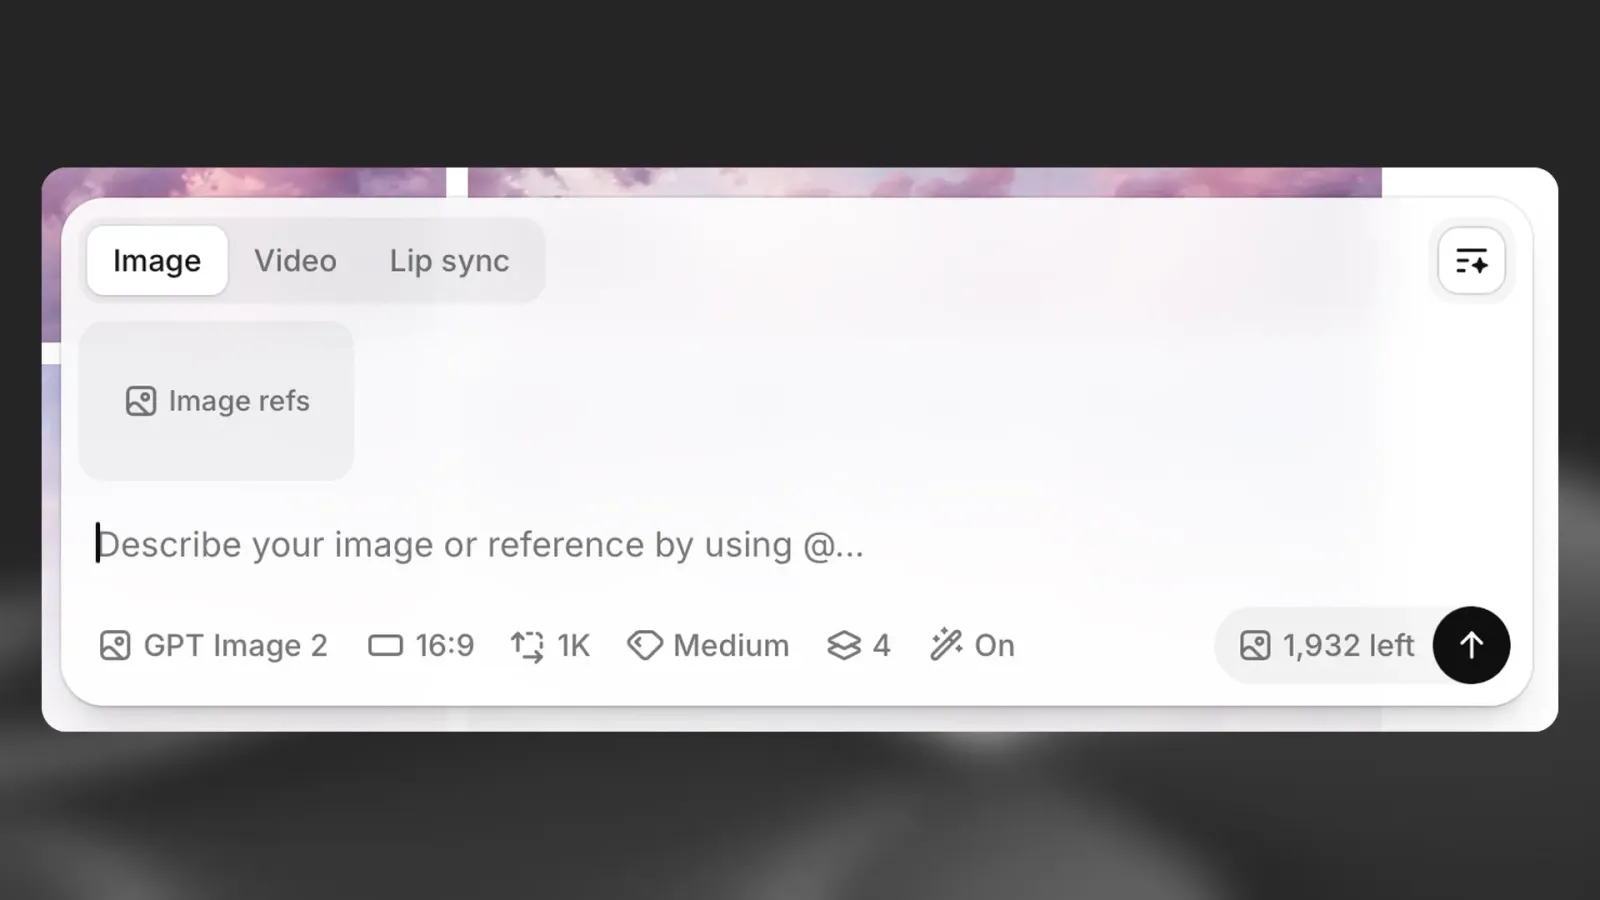
Pole promptu jest zakotwiczone na dole strony i zawiera wszystkie elementy sterujące do tworzenia materiałów wizualnych.
Ustaw tryb i prompt
Wybierz tryb: Użyj przełącznika w prawym górnym rogu, aby zmieniać generowanie między Obrazem a Wideo.
Napisz prompt: W głównym polu opisz językiem naturalnym, co chcesz wygenerować. Aby uzyskać najlepsze wyniki, pisz jasno i szczegółowo.
Wybierz modele i ustawienia
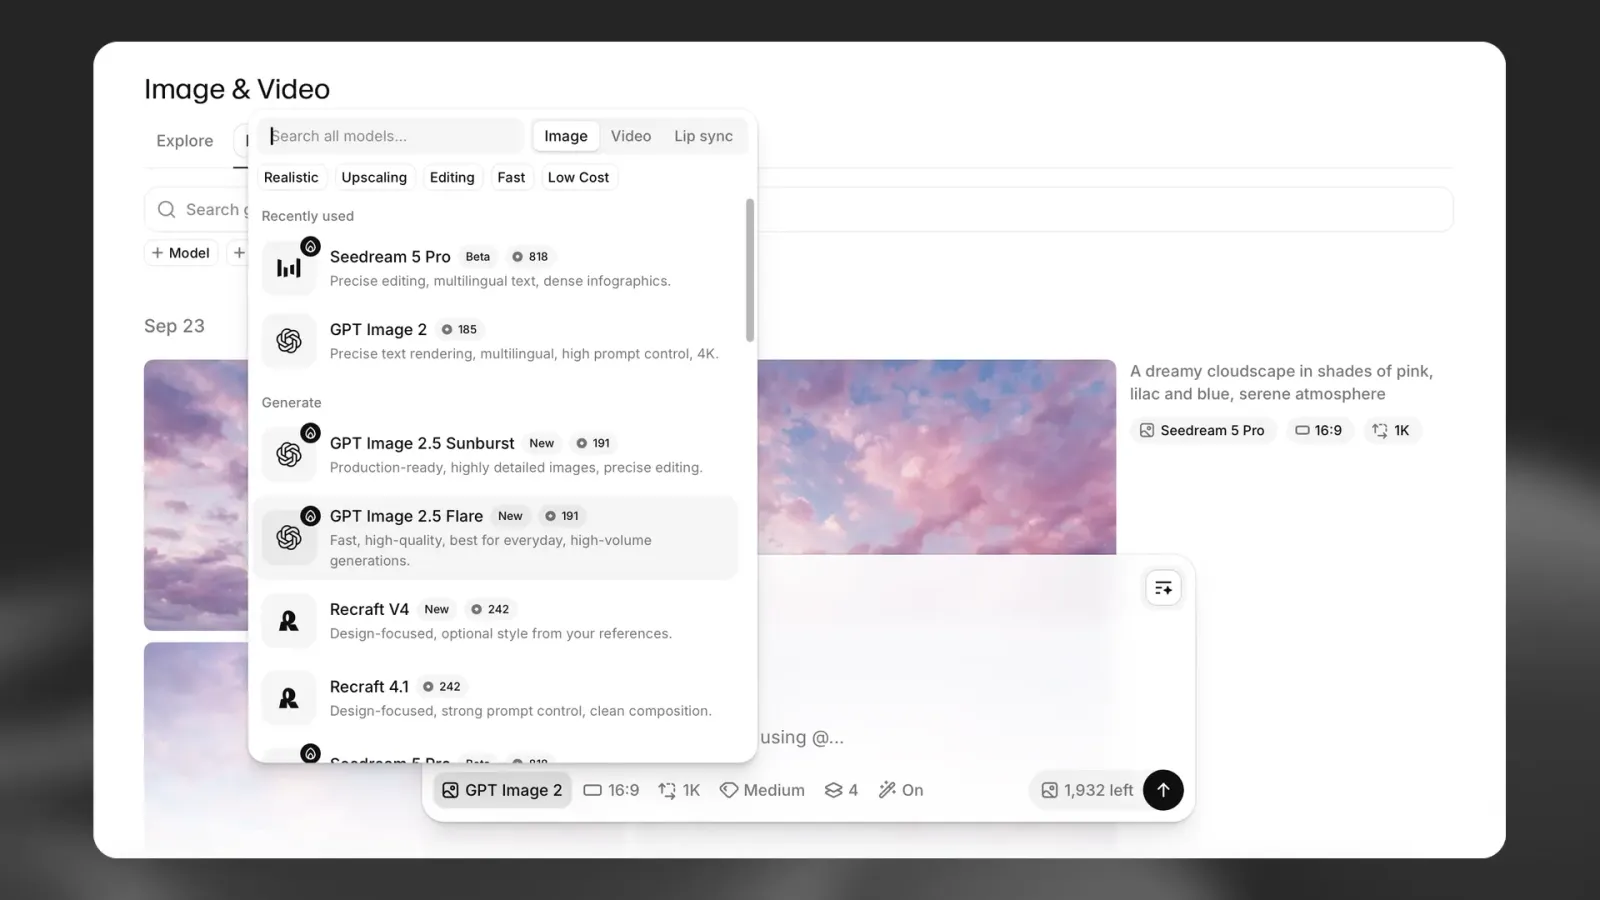
Wybierz model: Otwórz menu modeli, aby przejrzeć dostępne opcje, takie jak Google Veo 3.1, Kling 2.5 lub Flux 1 Kontext Pro. Każdy model ma unikalne mocne strony i możliwości, które ułatwiają porównanie. Szczegółowe informacje znajdziesz w sekcji Modele.
Dostosuj ustawienia: Dopracuj generowanie za pomocą ustawień pod promptem. Różnią się one zależnie od modelu, ale często obejmują:
- Proporcje obrazu: Kontroluj wymiary wyniku
- Rozdzielczość: Ustaw poziom jakości
- Czas trwania: Określ długość wideo (w trybie wideo)
- Liczba generacji: Utwórz do 4 wariantów naraz
Użyj ustawień: W obsługiwanych modelach włącz Audio, dodaj Negative Prompt, aby wykluczyć niepożądane elementy, lub dostosuj Sound Control.
Dodaj materiały referencyjne
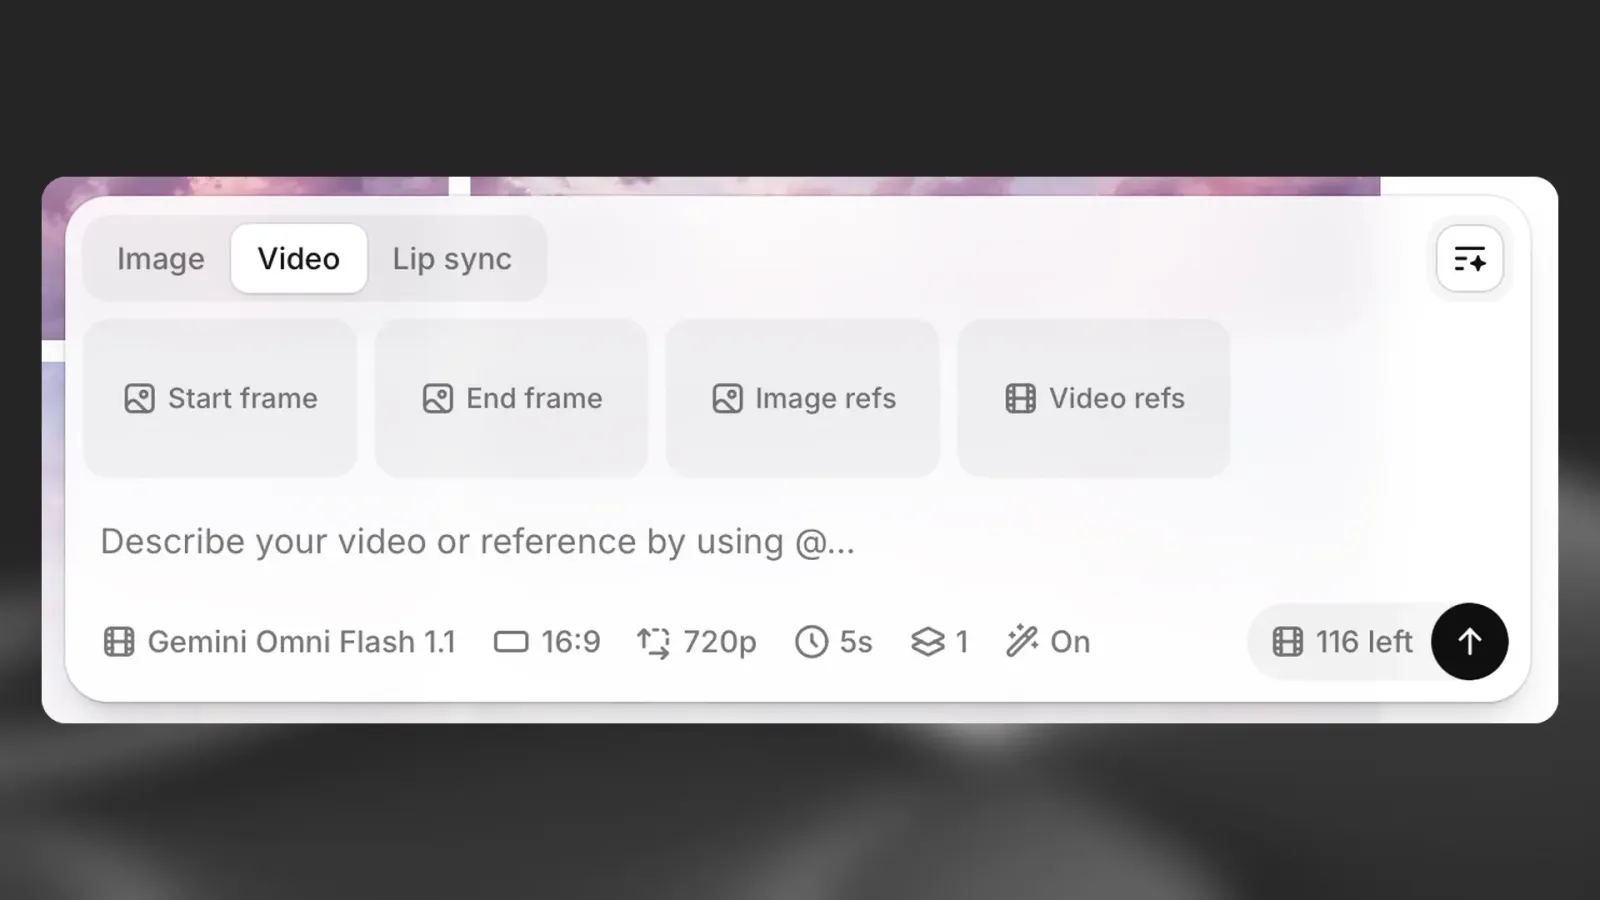
Aby lepiej kontrolować wynik, dodaj referencje wizualne kierujące generowaniem. Ich dostępność zależy od wybranego modelu. Obsługujemy wiele formatów obrazów, w tym JPG, PNG, WEBP i inne.
Klatka początkowa (wideo): Ustawia pierwszy obraz wideo.
Klatka końcowa (wideo): Ustawia ostatni obraz i wpływa na przejście.
Referencje obrazów (obraz lub wideo): Dodaj jeden lub więcej obrazów, aby określić ogólny styl i wygląd.
Przeciągaj elementy bezpośrednio z kart Explore lub History do pól referencyjnych, aby przyspieszyć workflow.
Generuj
Przed generowaniem wskaźnik kosztu pokazuje łączny koszt wybranej liczby materiałów. Gdy wszystko jest gotowe, kliknij Generate. Nowe materiały pojawią się na karcie History.
History
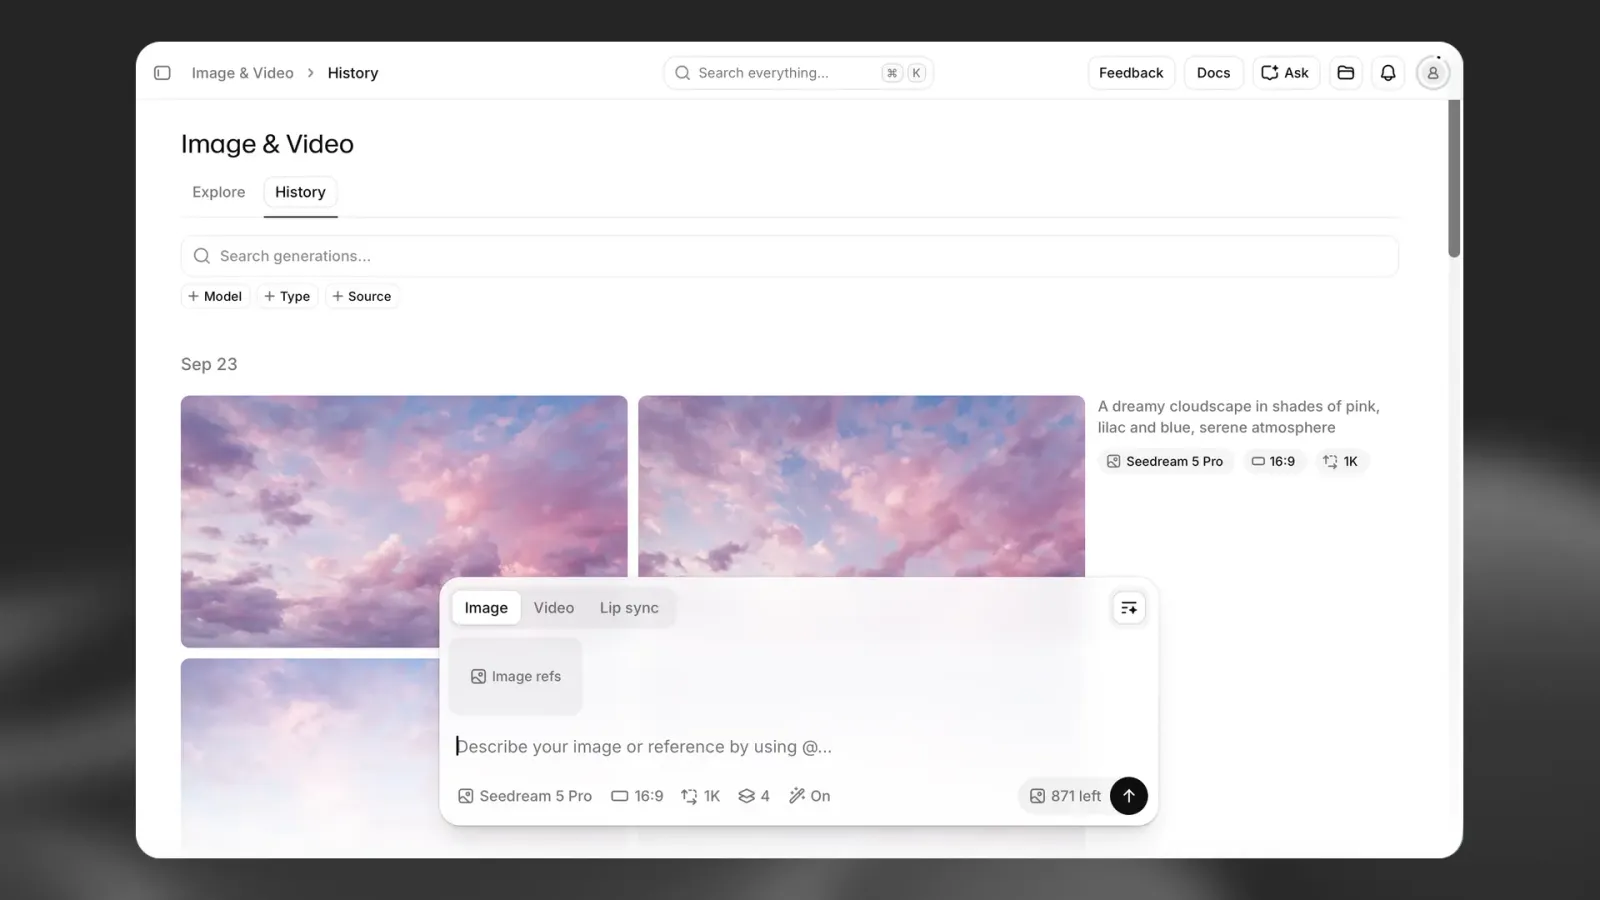
Karta History zawiera chronologiczny zapis wszystkich generacji i jest przestrzenią do dopracowywania wcześniejszych prac.
Przeglądaj: Zobacz wszystkie wcześniejsze obrazy i wideo.
Sprawdź: Kliknij dowolny materiał, aby zobaczyć oryginalny prompt, model i ustawienia użyte do jego utworzenia.
Wykorzystaj ponownie: Przeciągnij elementy z History z powrotem do pola promptu, aby użyć ich jako referencji przy nowych generacjach.
Dopracuj: Kliknij Recreate, aby ponownie użyć tego samego promptu i ustawień do utworzenia nowego wariantu, lub zmień ustawienia, aby nadać generowaniu nowy kierunek.
Udostępnij: Kliknij Share, aby utworzyć unikalny link do materiału. Wyślij go członkom zespołu i współpracownikom po opinię.
Eksportuj: Pobierz materiał jako osobny plik lub kliknij Edit in Studio, aby zaimportować go bezpośrednio do ElevenCreative Studio.
Eksport
Gdy masz generację, z której jesteś zadowolony, użyj wbudowanych narzędzi ulepszających przed eksportem.
Ulepszanie materiałów
Upscale: Użyj Topaz Upscale, aby zwiększyć rozdzielczość maksymalnie 4 razy, zachowując ostre detale.
LipSync: Dodaj realistyczną synchronizację ruchu ust do materiałów wizualnych:
- Omnihuman 1.5: Animuj statyczny obraz za pomocą ścieżki audio
- Veed LipSync: Zdubbinguj istniejące wideo nowym audio
Eksportowanie materiałów
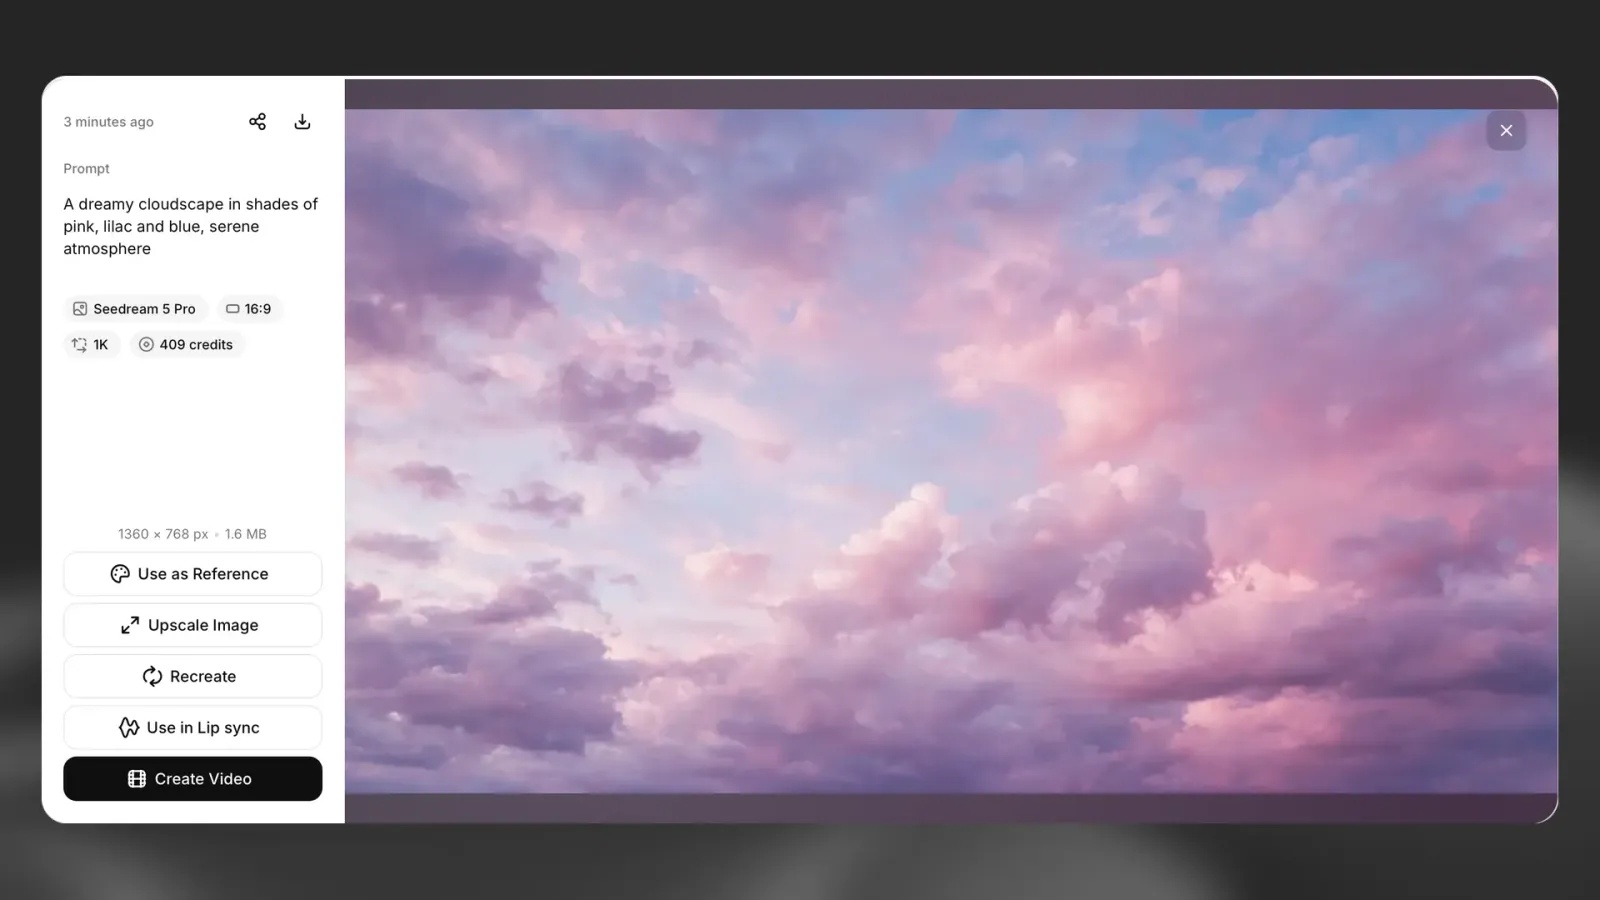
Eksportuj gotowe materiały, pobierając je lokalnie lub wysyłając bezpośrednio do ElevenCreative Studio.
Edit in Studio: Zaimportuj materiał bezpośrednio do projektu ElevenCreative Studio.
Download: Zapisz materiał na urządzeniu.
Obsługiwane formaty pobierania
Wideo:
- MP4: Kodeki H.264, H.265. Jakość do 4K (z upscalingiem)
Obraz:
- PNG: Wynik w wysokiej rozdzielczości, bez strat
Modele
Image & Video zapewnia dostęp do wyspecjalizowanych modeli zoptymalizowanych pod różne zastosowania. Każdy model oferuje inne możliwości — od szybkich iteracji po jakość gotową do produkcji.
Modele postprocessingu wymagają istniejącego wygenerowanego materiału, ale możesz też przesłać własny plik obrazu lub wideo.
Administratorzy przestrzeni roboczych Enterprise mogą kontrolować, które modele generowania obrazów i wideo są dostępne dla członków przestrzeni roboczej. Domyślnie wszystkie modele są wyłączone w przestrzeniach roboczych Enterprise i muszą zostać ręcznie włączone przez administratorów. Dowiedz się więcej o zatwierdzaniu modeli.
W przypadku żądań API modele ByteDance są domyślnie wyłączone i wymagają wyraźnej zgody przed użyciem. Klienci Enterprise mogą skontaktować się z pomocą, aby poprosić o dostęp.
Modele generowania wideo
Seedance 2.0
Uniwersalny multimodalny model wideo ze wspólnym generowaniem audio i wideo, oferujący kontrolę na poziomie reżysera nad grą, oświetleniem, cieniem i ruchem kamery, aby uzyskać ultrarealistyczne, filmowe efekty.
Dane wejściowe generowania:
- Tekst na wideo
- Klatka początkowa
- Klatka końcowa
- Referencje obrazów
- Referencje wideo
- Referencje audio
Funkcje:
- Ujednolicona architektura multimodalna, która generuje zsynchronizowane audio i wideo w jednym przebiegu
- Wiodące w branży możliwości pracy z referencjami multimodalnymi i edycji, z jednoczesną obsługą tekstu, obrazu, audio i wideo
- Wyjątkowa stabilność ruchu z realizmem filmowej jakości zgodnym ze standardami branżowymi
- Kreatywna kontrola na poziomie reżysera nad grą, oświetleniem, cieniem i ruchem kamery
- Elastyczna długość generowania od 4 s do 15 s
- Natywna kontrola dźwięku z możliwością włączenia lub wyłączenia audio dla każdego generowania
- Tworzenie wsadowe do 4 generowań jednocześnie
Opcje wyjściowe:
- Rozdzielczości: 480p, 720p, 1080p
- Proporcje obrazu: 21:9, 16:9, 4:3, 1:1, 3:4, 9:16
Idealny do:
- Filmowych historii wymagających zsynchronizowanego audio i obrazu
- Treści opartych na referencjach, z wiernym odwzorowaniem źródłowych obrazów, wideo lub audio
- Profesjonalnych produkcji wymagających precyzyjnej kontroli nad oświetleniem i pracą kamery
Koszt: zależy od wybranych ustawień i czasu trwania
Seedance 2.0 Fast
Szybszy i tańszy wariant Seedance 2.0 z tymi samymi multimodalnymi danymi referencyjnymi, ograniczony do wyjścia 720p.
Dane wejściowe generowania:
- Tekst na wideo
- Klatka początkowa
- Klatka końcowa
- Referencje obrazów (do 9)
- Referencje wideo (do 3, łącznie 15 s)
- Referencje audio (do 3, łącznie 15 s)
Funkcje:
- Taka sama obsługa referencji jak w Seedance 2.0, z łącznym limitem 12 referencji na generowanie
- Klatki i referencje wzajemnie się wykluczają: użyj klatki początkowej lub końcowej albo referencji, nie obu naraz
- Elastyczna długość generowania od 4 s do 15 s
- Natywna kontrola dźwięku z możliwością włączenia lub wyłączenia audio dla każdego generowania
- Tworzenie wsadowe do 4 generowań jednocześnie
Opcje wyjściowe:
- Rozdzielczości: 480p, 720p
- Proporcje obrazu: 21:9, 16:9, 4:3, 1:1, 3:4, 9:16
Idealny do:
- Dopracowywania promptów Seedance 2.0 przed renderowaniem w pełnej rozdzielczości
- Klipów opartych na referencjach, dla których wyjście 720p jest wystarczające
Koszt: zależy od wybranych ustawień i czasu trwania
API: bytedance-seedance-v2-fast
Seedance 2.0 Fast nie jest dostępny w Stanach Zjednoczonych.
Seedance 2.0 Mini
Najmniejszy wariant Seedance 2.0: około dwa razy szybszy od Seedance 2.0 i kosztujący mniej więcej połowę, z tymi samymi danymi wejściowymi i wyjściem 720p.
Dane wejściowe generowania:
- Tekst na wideo
- Klatka początkowa
- Klatka końcowa
- Referencje obrazów (do 9)
- Referencje wideo (do 3, łącznie 15 s)
- Referencje audio (do 3, łącznie 15 s)
Funkcje:
- Taka sama obsługa referencji jak w Seedance 2.0, z łącznym limitem 12 referencji na generowanie
- Klatki i referencje wzajemnie się wykluczają: użyj klatki początkowej lub końcowej albo referencji, nie obu naraz
- Elastyczna długość generowania od 4 s do 15 s
- Natywna kontrola dźwięku z możliwością włączenia lub wyłączenia audio dla każdego generowania
- Tworzenie wsadowe do 4 generowań jednocześnie
Opcje wyjściowe:
- Rozdzielczości: 480p, 720p
- Proporcje obrazu: 21:9, 16:9, 4:3, 1:1, 3:4, 9:16
Idealny do:
- Szkiców i podglądów tworzonych na dużą skalę
- Workflowów wrażliwych na koszty, które nadal potrzebują audio i danych referencyjnych
Koszt: zależy od wybranych ustawień i czasu trwania
API: bytedance-seedance-v2-mini
Seedance 2.0 Mini nie jest dostępny w Stanach Zjednoczonych.
Seedance 2.5
Następca Seedance 2.0 z bardziej wyrazistym realizmem, do 50 łącznymi referencjami obrazów, wideo i audio oraz generowaniem do 30 sekund.
Dane wejściowe generowania:
- Tekst na wideo
- Klatka początkowa
- Klatka końcowa
- Referencje obrazów (do 30)
- Referencje wideo (do 10, łącznie 30 s)
- Referencje audio (do 10, łącznie 30 s)
Funkcje:
- Brak łącznego limitu między typami referencji; referencje zawierające tylko audio są akceptowane bez obrazu lub wideo
- Klatki i referencje wzajemnie się wykluczają
- Elastyczna długość generowania od 4 s do 30 s
- Proporcje obrazu są pobierane z klatki początkowej lub referencyjnego wideo, jeśli je podano
- Natywna kontrola dźwięku z możliwością włączenia lub wyłączenia audio dla każdego generowania
- Tworzenie wsadowe do 4 generowań jednocześnie
Opcje wyjściowe:
- Rozdzielczości: 480p, 720p
- Proporcje obrazu: 21:9, 16:9, 4:3, 1:1, 3:4, 9:16
Idealny do:
- Dłuższych klipów, które muszą zachować spójność z wieloma referencjami
- Scen dialogowych i aktorskich opartych na referencyjnym audio
Koszt: zależy od wybranych ustawień i czasu trwania
Seedance 2.5 nie udostępnia kontroli seed.
Seedance 2.5 Video Edit
Edytuje istniejące wideo na podstawie opisu zmian. Długość wyjścia i proporcje obrazu są zgodne z wejściowym wideo.
Dane wejściowe generowania:
- Wideo do edycji (wymagane, do 30 s)
- Prompt tekstowy opisujący edycję
- Referencje obrazów (do 30)
- Dodatkowe referencje wideo (do 10, łącznie 30 s)
- Referencje audio (do 10, łącznie 30 s)
Funkcje:
- Brak kontroli czasu trwania: wyjście ma długość wejściowego wideo
- Proporcje obrazu są pobierane z wejściowego wideo
- Natywna kontrola dźwięku z możliwością włączenia lub wyłączenia audio dla każdego generowania
- Tworzenie wsadowe do 4 generowań jednocześnie
Opcje wyjściowe:
- Rozdzielczości: 480p, 720p
Idealny do:
- Zmiany ubioru, rekwizytów, oświetlenia lub otoczenia w istniejącym materiale
- Transferu stylu z zachowaniem oryginalnego ruchu
Koszt: zależy od wybranych ustawień i czasu trwania
Seedance 2.5 Video Extend
Kontynuuje istniejące wideo od miejsca, w którym się kończy, zgodnie z promptem i opcjonalnymi referencjami.
Dane wejściowe generowania:
- Wideo do rozszerzenia (wymagane, do 30 s)
- Prompt tekstowy opisujący kontynuację
- Referencje obrazów (do 30)
- Dodatkowe referencje wideo (do 10, łącznie 30 s)
- Referencje audio (do 10, łącznie 30 s)
Funkcje:
- Długość rozszerzenia od 4 s do 30 s
- Proporcje obrazu są pobierane z wejściowego wideo
- Natywna kontrola dźwięku z możliwością włączenia lub wyłączenia audio dla każdego generowania
- Tworzenie wsadowe do 4 generowań jednocześnie
Opcje wyjściowe:
- Rozdzielczości: 480p, 720p
Idealny do:
- Wydłużania ujęcia, które kończy się zbyt wcześnie
- Łączenia kilku generowań w dłuższą sekwencję
Koszt: zależy od wybranych ustawień i czasu trwania
Kling 3.0
Zaawansowany model wideo działający jak reżyser AI, zachowujący wysoką spójność postaci, obiektów i scen podczas złożonych ruchów kamery.
Dane wejściowe generowania:
- Tekst na wideo
- Klatka początkowa
- Klatka końcowa
Funkcje:
- Wierne zachowanie postaci i scen dzięki referencjom obrazów lub wideo z wielu ujęć
- Natywne wspólne generowanie audio i obrazu z wielojęzycznym synchronizowaniem ruchu ust oraz dźwiękiem otoczenia
- Elastyczna długość generowania od 3 s do 15 s
- Generowanie do 4 wariantów jednocześnie
- Lepsza obsługa tekstu, dynamiki płynów i złożonych interakcji fizycznych
Opcje wyjściowe:
- Rozdzielczości: tylko 1080p
- Proporcje obrazu: 16:9, 1:1, 9:16
Idealny do:
- Historii opartych na postaciach, wymagających ciągłości wizualnej
- Reklam i materiałów wymagających precyzyjnego renderowania tekstu
Koszt: zależy od wybranych ustawień i czasu trwania
Obsługuje negatywne prompty, które dają precyzyjną kontrolę. Dźwięk można włączać lub wyłączać dla każdego generowania.
Kling 3.0 nie jest dostępny w Stanach Zjednoczonych.
Kling O3
Model wideo o wysokiej spójności, działający jak reżyser AI i zachowujący tożsamość postaci, obiektów oraz scen podczas złożonych ruchów kamery.
Dane wejściowe generowania:
- Tekst na wideo
- Klatka początkowa
- Klatka końcowa
- Referencja wideo
- Referencja obrazu
Funkcje:
- Zachowuje precyzyjną tożsamość wizualną głównych postaci i obiektów dzięki referencjom z wielu ujęć
- Obsługuje płynne generowanie o długości od 3 s do 15 s
- Generowanie do 4 wariantów jednocześnie
- Dokładne modelowanie interakcji elementów i spójności ruchu
- Natywna obsługa włączonego lub wyłączonego audio dla każdego generowania
Opcje wyjściowe:
- Rozdzielczości: tylko 1080p
- Proporcje obrazu: 16:9, 1:1, 9:16
Idealny do:
- Historii opartych na postaciach, wymagających ścisłej ciągłości wizualnej
- Profesjonalnych materiałów marketingowych i brandowych ze spójnym renderowaniem obiektów
Koszt: zależy od wybranych ustawień i czasu trwania
Kling O3 nie jest dostępny w Stanach Zjednoczonych.
Kling O3 Edit
Model do edycji wideo na wideo oparty na języku naturalnym i architekturze O3, umożliwiający złożone transformacje wizualne — takie jak zamiana postaci i otoczenia — bez ręcznego maskowania lub dopasowywania klatka po klatce.
Dane wejściowe generowania:
- Wideo źródłowe
- Referencje obrazów (do 4 odrębnych elementów/kątów)
- Opis tekstowy (instrukcje w języku naturalnym)
Funkcje:
- Interpretuje konwersacyjne prompty, aby zmieniać obiekty lub otoczenie z zachowaniem oryginalnej struktury ruchu
- Zachowuje oryginalne kąty kamery, wzorce ruchu i relacje przestrzenne przez całą edycję
- Łączy do 4 elementów łącznie (w tym obrazy frontalne i z wielu ujęć), aby zapewnić wysoką spójność postaci
- Opcja zachowania oryginalnego audio źródłowego lub generowania cichego wyjścia dla każdego generowania
- Generowanie do 4 edytowanych wariantów jednocześnie
Opcje wyjściowe:
- Rozdzielczości: zależne od wideo źródłowego
- Proporcje obrazu: zgodne z wideo źródłowym
Idealny do:
- Wiernej zamiany postaci w istniejącym materiale z zachowaniem oryginalnych ruchów
- Pełnej transformacji otoczenia sceny (np. zmiany miasta za dnia w futurystyczny nocny krajobraz)
- Stosowania transferu stylu wymagającego ścisłego zachowania istniejącej dynamiki kamery
Koszt: zależy od długości wideo i wybranych ustawień
Kling O3 Edit nie jest dostępny w Stanach Zjednoczonych.
Google Veo 3.1
Profesjonalny model do generowania wysokiej jakości filmowego wideo.
Dane wejściowe generowania:
- Tekst na wideo
- Klatka początkowa
- Klatka końcowa
- Referencje obrazów
Funkcje:
- Doskonała jakość i kreatywna kontrola dzięki negatywnym promptom
- W pełni zintegrowane i zsynchronizowane audio
- Realistyczne dialogi, synchronizacja ruchu ust i efekty dźwiękowe
- Stałe długości: 4 s, 6 s i 8 s
- Tworzenie wsadowe do 4 generowań jednocześnie
- Osobna kontrola dźwięku
Opcje wyjściowe:
- Rozdzielczości: 720p, 1080p
- Proporcje obrazu: 16:9, 9:16
Idealny do:
- Generowania wysokiej jakości filmowego wideo z pełną kontrolą kreatywną
Koszt: zależy od wybranych ustawień i czasu trwania
API: veo-3.1-generate-001
Włączenie lub wyłączenie dźwięku zmieni liczbę kredytów za generowanie.
Google Veo 3.1 Fast
Szybki model zoptymalizowany pod szybkie podglądy i generowanie, zapewniający ostrzejszy obraz przy mniejszych opóźnieniach.
Dane wejściowe generowania:
- Tekst na wideo
- Klatka początkowa
- Klatka końcowa
Funkcje:
- Zaawansowana kontrola kreatywna z negatywnymi promptami i osobną kontrolą dźwięku
- Stałe długości: 4 s, 6 s i 8 s
- Tworzenie wsadowe do 4 generowań jednocześnie
- Precyzyjnie modeluje fizykę świata rzeczywistego, zapewniając realistyczny ruch i interakcje
Opcje wyjściowe:
- Rozdzielczości: 720p, 1080p
- Proporcje obrazu: 16:9, 9:16
Idealny do:
- Szybkich iteracji i testów A/B materiałów wizualnych
- Szybkiego tworzenia treści do mediów społecznościowych
Koszt: zależy od wybranych ustawień i czasu trwania
Google Veo 3.1 Lite
Ekonomiczny, szybki wariant Veo 3.1 zoptymalizowany pod szybkie generowanie przy mniejszym zużyciu zasobów obliczeniowych.
Dane wejściowe generowania:
- Tekst na wideo
- Klatka początkowa
Funkcje:
- Precyzyjna kontrola kreatywna z negatywnymi promptami i osobną kontrolą dźwięku
- Stałe długości: 4 s, 6 s i 8 s
- Tworzenie wsadowe do 4 generowań jednocześnie
Opcje wyjściowe:
- Rozdzielczości: 720p
- Proporcje obrazu: 16:9, 9:16
Idealny do:
- Tworzenia dużej liczby treści, gdy priorytetem są szybkość i niskie koszty
- Szybkiego testowania koncepcji i podglądów
Koszt: zależy od wybranych ustawień i czasu trwania
Gemini Omni Flash 1.1
Model wideo Google uwzględniający fizykę, z natywnym audio, wyjściem do 4K oraz interpolacją klatek i generowaniem kierowanym referencjami.
Dane wejściowe generowania:
- Tekst na wideo
- Klatka początkowa
- Klatka końcowa
- Referencje obrazów (do 10)
- Referencje wideo (do 3, każda do 10 s)
Funkcje:
- Klatki i referencje wzajemnie się wykluczają: interpoluj między klatkami lub kieruj generowaniem za pomocą referencji
- Stałe długości od 3 s do 10 s; czas trwania jest zgodny z referencyjnym wideo, gdy je dołączysz
- Dobre renderowanie krótkiego tekstu i etykiet na ekranie
- Tworzenie wsadowe do 4 generowań jednocześnie
Opcje wyjściowe:
- Rozdzielczości: 360p, 720p, 1080p, 4K
- Proporcje obrazu: 16:9, 9:16
Idealny do:
- Materiałów wyjaśniających i typografii kinetycznej z czytelnym tekstem
- Ruchu opartego na fizyce ze spójnymi obiektami między referencjami
Koszt: zależy od wybranych ustawień i czasu trwania
Gemini Omni Flash 1.1 Extend
Kontynuuje istniejące wideo od miejsca, w którym się kończy, za pomocą Gemini Omni Flash 1.1, do łącznej długości 40 sekund.
Dane wejściowe generowania:
- Wideo do rozszerzenia (wymagane, do 30 s)
- Prompt tekstowy opisujący kontynuację
Funkcje:
- Długość rozszerzenia od 3 s do 10 s
- Proporcje obrazu są zgodne z wejściowym wideo
- Tworzenie wsadowe do 4 generowań jednocześnie
Opcje wyjściowe:
- Rozdzielczości: 360p, 720p, 1080p, 4K
Idealny do:
- Wydłużania generowań Gemini Omni Flash bez widocznego cięcia
- Tworzenia sekwencji dłuższych, niż pozwala pojedyncze generowanie
Koszt: zależy od wybranych ustawień i czasu trwania
Gemini Omni Flash
Pierwszy model wideo Gemini Omni: ruch uwzględniający fizykę, natywne audio i najlepsze renderowanie tekstu na ekranie spośród dostępnych modeli wideo, w 720p.
Dane wejściowe generowania:
- Tekst na wideo
- Referencje obrazów (do 8)
- Referencja wideo (1, do 10 s)
Funkcje:
- Stałe długości od 3 s do 10 s; czas trwania jest zgodny z referencyjnym wideo, gdy je dołączysz
- Brak klatki początkowej ani końcowej; zamiast tego użyj referencji obrazów, aby zakotwiczyć obiekt
- Tworzenie wsadowe do 4 generowań jednocześnie
Opcje wyjściowe:
- Rozdzielczości: 720p
- Proporcje obrazu: 16:9, 9:16
Idealny do:
- Krótkich podpisów, tytułów i materiałów wyjaśniających z etykietami
- Spójności wielu obrazów w 720p
Koszt: zależy od wybranych ustawień i czasu trwania
Seedance 1.5 Pro
Ulepszony, wyspecjalizowany model do tworzenia dynamicznych sekwencji o wysokiej jakości, z lepszą stabilnością czasową i precyzyjną kontrolą przejść między klatkami kluczowymi.
Dane wejściowe generowania:
- Tekst na wideo
- Klatka początkowa
- Klatka końcowa
Funkcje:
- Płynnie łączy klatkę początkową i końcową w spójne sekwencje z wieloma ujęciami
- Wysokiej jakości modelowanie złożonych działań i spójności otoczenia
- Obsługuje stałe długości generowania od 4 s do 12 s
- Generuj do 4 wariantów naraz
- Natywna obsługa włączania lub wyłączania dźwięku dla każdego generowania
Opcje wyjściowe:
- Rozdzielczości: 420p, 720p
- Proporcje obrazu: 21:9, 16:9, 4:3, 1:1, 3:4, 9:16
Idealny do:
- Opowiadania historii i scen akcji wymagających stabilnej fizyki między konkretnymi punktami wizualnymi
- Filmowych przejść i profesjonalnych materiałów wideo z określonymi wymaganiami dotyczącymi początku i końca
Koszt: Zależy od wybranych ustawień i długości
Seedance 1.5 Pro został wycofany. ByteDance wycofa model 11 listopada 2026 r. i nie jest on już dostępny dla nowych generowań. Zamiast niego użyj modelu Seedance 2.0. Seedance 1.5 Pro nie jest dostępny w Stanach Zjednoczonych.
FLUX 3
Model wideo Black Forest Labs z naturalnym ruchem, scenami z wieloma ujęciami, generowanym dźwiękiem i rozszerzaniem wideo.
Dane wejściowe generowania:
- Tekst na wideo
- Klatka początkowa
- Klatka końcowa
- Wideo do rozszerzenia (1, do 15 s)
Funkcje:
- Rozszerzanie wideo wyklucza użycie klatek początkowej i końcowej
- Elastyczne długości generowania od 5 s do 20 s
- Natywna kontrola dźwięku z możliwością włączenia lub wyłączenia dźwięku dla każdego generowania
- Tworzenie wsadowe: do 4 generowań naraz
Opcje wyjściowe:
- Rozdzielczości: 720p, 1080p
- Proporcje obrazu: 21:9, 2:1, 16:9, 4:3, 1:1, 3:4, 9:16
Idealny do:
- Scen z wieloma ujęciami na podstawie jednego promptu
- Rozszerzania istniejącego klipu z dopasowanym ruchem i dźwiękiem
Koszt: Zależy od wybranych ustawień i długości
FLUX 3 Edit
Edytuje istniejące wideo na podstawie promptu tekstowego. Długość i kadrowanie wyniku są zgodne z wideo źródłowym, do 15 s.
Dane wejściowe generowania:
- Wideo do edycji (wymagane, do 15 s)
- Prompt tekstowy opisujący zmiany
Opcje wyjściowe:
- Rozdzielczość i proporcje obrazu są zgodne z wideo źródłowym
Idealny do:
- Zmian istniejącego materiału na podstawie promptu
Koszt: Zależy od wybranych ustawień i długości
MiniMax H3
Flagowy model wideo MiniMax z multimodalnymi materiałami referencyjnymi, generowanym dźwiękiem i wynikiem do 4K.
Dane wejściowe generowania:
- Tekst na wideo
- Klatka początkowa
- Klatka końcowa
- Materiały referencyjne w postaci obrazów (do 9)
- Materiały referencyjne w postaci wideo (do 3, każdy od 2 s do 15 s, łącznie 15 s)
- Materiały referencyjne audio (do 3, każdy od 2 s do 15 s, łącznie 15 s)
Funkcje:
- Łączny limit to 12 materiałów referencyjnych na generowanie; materiały audio wymagają co najmniej jednego obrazu lub wideo referencyjnego
- Klatki i materiały referencyjne wzajemnie się wykluczają
- Elastyczne długości generowania od 5 s do 15 s
- Generuje zsynchronizowany dźwięk
- Tworzenie wsadowe: do 4 generowań naraz
Opcje wyjściowe:
- Rozdzielczości: 480p, 768p, 2K, 4K (2K i 4K są skalowane w górę z 768p)
- Proporcje obrazu: 21:9, 16:9, 4:3, 1:1, 3:4, 9:16
Idealny do:
- Scen opartych na materiałach referencyjnych, wymagających wysokiej rozdzielczości
- Klipów dialogowych opartych na referencyjnym audio
Koszt: Zależy od wybranych ustawień i długości
MiniMax H3 nie jest dostępny w Stanach Zjednoczonych.
MiniMax H3 Max
Niemal natychmiastowy wariant MiniMax H3 z tymi samymi danymi wejściowymi i dobrą estetyką, renderowany natywnie w rozdzielczości do 768p.
Dane wejściowe generowania:
- Tekst na wideo
- Klatka początkowa
- Klatka końcowa
- Materiały referencyjne w postaci obrazów (do 9)
- Materiały referencyjne w postaci wideo (do 3, każdy od 2 s do 15 s, łącznie 15 s)
- Materiały referencyjne audio (do 3, każdy od 2 s do 15 s, łącznie 15 s)
Funkcje:
- Łączny limit to 12 materiałów referencyjnych na generowanie; materiały audio wymagają co najmniej jednego obrazu lub wideo referencyjnego
- Klatki i materiały referencyjne wzajemnie się wykluczają
- Elastyczne długości generowania od 5 s do 15 s
- Generuje zsynchronizowany dźwięk
- Tworzenie wsadowe: do 4 generowań naraz
Opcje wyjściowe:
- Rozdzielczości: 480p, 768p
- Proporcje obrazu: 21:9, 16:9, 4:3, 1:1, 3:4, 9:16
Idealny do:
- Szybkiego iterowania promptów i materiałów referencyjnych
- Podglądów przed renderowaniem w MiniMax H3
Koszt: Zależy od wybranych ustawień i długości
MiniMax H3 Max nie jest dostępny w Stanach Zjednoczonych.
MiniMax H3 Max Recast
Zmienia osoby w źródłowym wideo na podstawie od 1 do 4 zdjęć. Długość jest zgodna ze źródłem, do 30 s, a oryginalny dźwięk zostaje zachowany.
Dane wejściowe generowania:
- Wideo źródłowe (do 30 s)
- Zdjęcia osób do zastąpienia (od 1 do 4)
Funkcje:
- Długość wyniku jest zgodna z wideo źródłowym
- Zachowuje dźwięk źródłowy
Opcje wyjściowe:
- Rozdzielczości: do 1080p
- Proporcje obrazu są zgodne z wideo źródłowym
Idealny do:
- Zastępowania osób w istniejącym materiale postaciami ze zdjęć referencyjnych
Koszt: Zależy od wybranych ustawień i długości
Kling O1
Zaawansowany model wideo z rozumowaniem, stworzony z myślą o doskonałej zgodności z promptem i złożonej symulacji świata fizycznego. Wykorzystuje zaawansowane przetwarzanie logiczne do interpretowania i wykonywania złożonych instrukcji.
Dane wejściowe generowania:
- Tekst na wideo (opis)
- Klatka początkowa i klatka końcowa
- Wideo referencyjne
- Obraz referencyjny
Funkcje:
- Wyjątkowo dobrze interpretuje wielowarstwowe prompty i wykonuje złożone działania w kolejności chronologicznej
- Wykorzystuje obrazy i wideo jako wizualne punkty odniesienia, aby zachować wysoką spójność postaci i scen
- Doskonałe modelowanie interakcji fizycznych, związków przyczynowo-skutkowych i dynamiki płynów
- Obsługuje generowanie wysokiej jakości klipów 5 s i 10 s
- Generuj do 4 wariantów naraz
Opcje wyjściowe:
- Rozdzielczości: zależne od danych wejściowych
- Proporcje obrazu: 16:9, 1:1, 9:16
Idealny do:
- Bardzo konkretnych koncepcji kreatywnych wymagających ścisłej zgodności z długimi, szczegółowymi opisami
- Profesjonalnego storytellingu, gdzie kluczowe są realizm fizyczny i spójność wielu materiałów referencyjnych
Koszt: Zależy od wybranych ustawień i długości
Kling O1 nie jest dostępny w Stanach Zjednoczonych.
Kling O1 Edit
Model do edycji wideo na wideo sterowany językiem naturalnym, który umożliwia złożone transformacje wizualne — takie jak zastępowanie postaci i zmiana otoczenia — bez ręcznego maskowania ani zmian klatka po klatce.
Dane wejściowe generowania:
- Wideo źródłowe
- Obrazy referencyjne (do 4 różnych elementów/kątów)
- Opis tekstowy (instrukcje w języku naturalnym)
Funkcje:
- Interpretuje konwersacyjne prompty, aby zastępować obiekty lub otoczenie z zachowaniem oryginalnej struktury ruchu
- Zachowuje oryginalne kąty kamery, wzorce ruchu i relacje przestrzenne w całej edycji
- Łączy do 4 elementów łącznie (w tym obrazy z przodu i z wielu kątów), aby zapewnić wysoką spójność postaci
- Możliwość zachowania oryginalnego dźwięku źródłowego lub wygenerowania cichego wyniku dla każdego generowania
- Generuj do 4 edytowanych wariantów naraz
Opcje wyjściowe:
- Rozdzielczości: zależne od wideo źródłowego
- Proporcje obrazu: zgodne z wideo źródłowym
Idealny do:
- Wysokiej jakości zastępowania postaci w istniejącym materiale z zachowaniem oryginalnych ruchów
- Pełnej transformacji otoczenia sceny (np. zmiany miasta za dnia w futurystyczny nocny krajobraz)
- Stosowania transferu stylu wymagającego ścisłej zgodności z istniejącą dynamiką kamery
Koszt: Zależy od długości wideo i wybranych ustawień
Kling O1 Edit nie jest dostępny w Stanach Zjednoczonych.
Kling 2.6 Motion Control
Wyspecjalizowany model do precyzyjnego transferu ruchu, który pozwala sterować obrazem postaci za pomocą referencyjnego wideo, aby odtworzyć konkretne ruchy, gesty i kąty kamery.
Dane wejściowe generowania:
- Obraz postaci (źródło)
- Wideo ruchu (materiał referencyjny)
- Opis tekstowy (opcjonalnie)
Funkcje:
- Wybierz “Dopasuj wideo”, aby dokładnie odtworzyć ruch, lub “Dopasuj obraz”, aby dodać postaci nowy kreatywny ruch
- Obsługuje do 30 s w trybie Dopasuj wideo i 10 s w trybie Dopasuj obraz
- Wysokiej jakości mapowanie ruchu człowieka z materiału referencyjnego na nieruchomą postać
- Natywna obsługa włączania lub wyłączania dźwięku dla każdego generowania
- Generuj do 4 wariantów naraz
Opcje wyjściowe:
- Rozdzielczości: zależne od źródła
- Proporcje obrazu: zależne od źródła
Idealny do:
- Odtwarzania złożonej choreografii lub konkretnych ruchów na własnej postaci
- Długich animacji postaci wymagających dużej wierności ruchu
- Treści na media społecznościowe opartych na popularnych ruchach z wideo
Koszt: Zależy od wybranych ustawień i długości
Kling 2.6 Motion Control nie jest dostępny w Stanach Zjednoczonych.
Kling 3.0 Motion Control
Wyspecjalizowany model do precyzyjnego transferu ruchu oparty na architekturze Kling 3.0, który pozwala sterować obrazem postaci za pomocą referencyjnego wideo, aby z większą wiernością odtworzyć konkretne ruchy, gesty i kąty kamery.
Dane wejściowe generowania:
- Obraz postaci (źródło)
- Wideo ruchu (materiał referencyjny)
- Opis tekstowy (opcjonalnie)
Funkcje:
- Wybierz “Dopasuj wideo”, aby dokładnie odtworzyć ruch, lub “Dopasuj obraz”, aby dodać postaci nowy kreatywny ruch
- Obsługuje do 30 s w trybie Dopasuj wideo i 10 s w trybie Dopasuj obraz
- Wysokiej jakości mapowanie ruchu człowieka z materiału referencyjnego na nieruchomą postać
- Natywna obsługa włączania lub wyłączania dźwięku dla każdego generowania
- Generuj do 4 wariantów naraz
Opcje wyjściowe:
- Rozdzielczości: zależne od źródła
- Proporcje obrazu: zależne od źródła
Idealny do:
- Odtwarzania złożonej choreografii lub konkretnych ruchów na własnej postaci
- Długich animacji postaci wymagających dużej wierności ruchu
- Treści na media społecznościowe opartych na popularnych ruchach z wideo
Koszt: Zależy od wybranych ustawień i długości
Kling 3.0 Motion Control nie jest dostępny w Stanach Zjednoczonych.
Kling 2.6
Zoptymalizowany model generatywny zaprojektowany dla większej wierności ruchu i płynniejszych przejść, zapewniający równowagę między szybkimi iteracjami a jakością wizualną gotową do produkcji.
Dane wejściowe generowania:
- Tekst na wideo
- Klatka początkowa (obraz na wideo)
Funkcje:
- Lepsza dynamika ruchu: znaczące usprawnienia płynności ruchu i realistycznych interakcji fizycznych
- Elastyczna kontrola dźwięku: natywna obsługa włączania lub wyłączania dźwięku dla każdego generowania
- Tworzenie wsadowe: generuj do 4 wariantów jednocześnie
- Precyzyjne dopracowanie: zaawansowana kontrola kreatywna dzięki obsłudze negatywnych promptów
- Stałe długości: obsługuje generowanie o długości 5 s i 10 s
Opcje wyjściowe:
- Rozdzielczości: zależne od danych wejściowych
- Proporcje obrazu: 16:9, 1:1, 9:16
Idealny do:
- Dynamicznych klipów wymagających płynnego ruchu postaci
- Profesjonalnych treści na media społecznościowe z wysoką zgodnością z promptem
Koszt: Zależy od wybranych ustawień i długości
Kling 2.6 nie jest dostępny w Stanach Zjednoczonych.
Kling 2.5
Zrównoważony i wszechstronny model do wysokiej jakości generowania wideo w Full HD.
Dane wejściowe generowania:
- Tekst na wideo
- Klatka początkowa
Funkcje:
- Doskonale symuluje złożony ruch i realistyczną fizykę
- Precyzyjnie modeluje dynamikę płynów i ekspresję
- Stałe długości: 5 s i 10 s
- Tworzenie wsadowe: do 4 generowań naraz
Opcje wyjściowe:
- Rozdzielczości: 1080p
- Proporcje obrazu: 16:9, 1:1, 9:16
Idealny do:
- Realistycznych symulacji fizyki i złożonego ruchu
Koszt: Zależy od wybranych ustawień i długości
Klatka końcowa nie jest obecnie obsługiwana. Nie można podać obrazów referencyjnych. Kontrola dźwięku jest niedostępna.
Kling 2.5 nie jest dostępny w Stanach Zjednoczonych.
Runway Gen-4.5
Najwyższa jakość ruchu, zgodność z promptem i wierność wizualna dla filmowego, bardzo realistycznego wideo.
Dane wejściowe generowania:
- Tekst na wideo
- Klatka początkowa (obraz na wideo)
Funkcje:
- Wyjątkowa jakość ruchu z czołowym w branży realizmem i symulacją fizyki
- Doskonała zgodność z promptem dla precyzyjnej kontroli kreatywnej nad złożonymi scenami
- Wysoka wierność wizualna zapewniająca filmową jakość wyniku
- Generuj do 4 wariantów jednocześnie
Opcje wyjściowe:
- Rozdzielczości: 720p
- Proporcje obrazu: 16:9, 9:16
Idealny do:
- Filmowych treści wymagających najwyższej jakości ruchu i realizmu
- Profesjonalnych produkcji wymagających precyzyjnej zgodności z promptem
- Wizualnego storytellingu o wysokiej jakości
Koszt: Zależy od wybranych ustawień i długości
Runway Gen-4 Turbo
Zaawansowany model wideo stworzony do szybkich iteracji i oszczędnego tworzenia, zdolny generować wideo wysokiej jakości.
Dane wejściowe generowania:
- Tekst na wideo
- Klatka początkowa (obraz na wideo)
Funkcje:
- Zoptymalizowany pod kątem ultraszybkiego generowania, zapewnia wyniki nawet cztery razy szybciej niż wcześniejsze wersje
- Pozwala precyzyjnie kierować ruchami postaci, kątami kamery i kompozycją scen
- Doskonale utrzymuje spójność wizualną i stabilność w dynamicznych scenach
- Obsługuje długości generowania od 2 s do 10 s
- Generuj do 4 wariantów jednocześnie
Opcje wyjściowe:
- Rozdzielczości: 720p
- Proporcje obrazu: 21:9, 16:9, 4:3, 1:1, 3:4, 9:16
Idealny do:
- Szybkiego prototypowania i kreatywnych eksperymentów wymagających niemal natychmiastowej informacji zwrotnej
- Profesjonalnych projektów wymagających szybkiej realizacji materiałów marketingowych w wysokiej rozdzielczości
- Filmowych treści ze szczególnymi wymaganiami dotyczącymi ruchu kamery
Koszt: Zależy od wybranych ustawień i długości
Runway Gen-4 Aleph
Zaawansowany kontekstowy model wideo do wielozadaniowego generowania wizualnego, zdolny wykonywać złożone edycje przy zachowaniu podstawowej struktury materiału źródłowego.
Dane wejściowe generowania:
- Wideo źródłowe
- Obraz referencyjny
- Opis tekstowy
Funkcje:
- Płynnie dodawaj, usuwaj lub przekształcaj obiekty i postacie w scenie z naturalnym oświetleniem, cieniami i perspektywą
- Zmieniaj lokalizacje, pory roku i porę dnia (np. zmieniaj pochmurny materiał w dramatyczny zachód słońca) z realistyczną korektą temperatury barwowej
- Zmieniaj wiek i wygląd aktorów albo teksturę ubrań i postaci za pomocą prostych promptów w języku naturalnym
- Zastosuj konkretny ruch i ścieżkę kamery z referencyjnego wideo do statycznego obrazu, aby precyzyjnie kontrolować animację
- Generuj całkowicie nowe kąty kamery, takie jak ujęcia odwrotne lub z niskiego kąta, na podstawie jednej istniejącej sekwencji wideo
- Obejmuje precyzyjne green screen (izolację z wykrywaniem krawędzi), generowanie kolejnego ujęcia dla kontynuacji historii i transfer stylu estetycznego
- Generuj do 4 wariantów jednocześnie
Opcje wyjściowe:
- Rozdzielczości: 720p
- Proporcje obrazu: automatyczne
Idealny do:
- Profesjonalnych zadań z zakresu efektów wizualnych, takich jak cyfrowe odmładzanie, zmiana oświetlenia i usuwanie obiektów
- Szybkiego prototypowania filmowego i generowania alternatywnych ujęć z jednego kadru
- Kreatywnych treści marketingowych wymagających radykalnych zmian środowiska lub stylu
Koszt: Zależy od wybranych ustawień i długości
Runway Aleph 2.0
Model Runway do edycji wideo: przekształca istniejące wideo w kierunku docelowego wyglądu, zachowując ruch i spójność.
Dane wejściowe:
- Wideo źródłowe (wymagane, od 2 s do 30 s)
- Obraz docelowego wyglądu (wymagany)
- Prompt tekstowy opisujący zmiany
Funkcje:
- Długość i kadrowanie wyniku są zgodne z wideo źródłowym
- Transfer stylu prowadzony przez obraz docelowego wyglądu
- Tworzenie wsadowe: do 4 generowań naraz
Idealny do:
- Zmiany oświetlenia, stylu lub otoczenia w istniejącym materiale
- Zastosowania wyglądu obrazu referencyjnego do całego klipu
Koszt: Zależy od wybranych ustawień i długości
Runway Act-Two
Wyspecjalizowany model transferu ruchu, który animuje postacie, przenosząc ruch, mowę i mimikę z nagrania prowadzącego na obraz lub wideo postaci.
Dane wejściowe generowania:
- Materiał prowadzący (wideo)
- Materiał postaci (obraz lub wideo)
Funkcje:
- Przenosi subtelną mimikę, synchronizację ruchu ust z mową i zsynchronizowane audio bezpośrednio z aktora źródłowego na dowolną postać
- Automatycznie dodaje ruch wtórny i delikatne drgania kamery do statycznych obrazów postaci, by wyglądały bardziej naturalnie
- Precyzyjny przełącznik do włączania lub wyłączania ruchów ciała i dłoni przy użyciu obrazu postaci
- Regulowane ustawienia pozwalające wyważyć intensywną ekspresję emocji i spójność wyglądu postaci
- Możliwość zmiany głosu postaci po wygenerowaniu przy zachowaniu idealnego dopasowania do materiału prowadzącego
Opcje wyjściowe:
- Rozdzielczości: 720p
- Proporcje obrazu: Automatycznie
Idealne do:
- Ożywiania statycznych portretów postaci realistycznym ludzkim ruchem i mową
- Animowania nieludzkich postaci lub stylizowanych awatarów z wierną mimiką
- Szybkiego tworzenia materiałów typu talking head ze zintegrowanymi gestami ciała
Koszt: Zależy od wybranych ustawień i czasu trwania
Seedance 1 Pro
Wyspecjalizowany model do tworzenia dynamicznych, wieloujęciowych sekwencji z dużą ilością ruchu i akcji.
Dane wejściowe generowania:
- Tekst na wideo
- Klatka początkowa
- Klatka końcowa
Funkcje:
- Bardzo stabilna fizyka i płynne przejścia między ujęciami
- Stałe czasy trwania: 3 s, 4 s, 5 s, 6 s, 7 s, 8 s, 9 s, 10 s, 11 s i 12 s
- Tworzenie wsadowe do 4 generacji naraz
- Maksymalna swoboda twórcza dzięki wielu opcjom proporcji obrazu
Opcje wyjściowe:
- Rozdzielczości: 480p, 720p, 1080p
- Proporcje obrazu: 21:9, 16:9, 4:3, 1:1, 3:4, 9:16
Idealne do:
- Storytellingu i scen akcji wymagających stabilnej fizyki
Koszt: Zależy od wybranych ustawień i czasu trwania
Proporcje obrazu i rozdzielczość nie wpływają na liczbę kredytów za generowanie, ale czas trwania już tak.
Seedance 1 Pro nie jest dostępny w Stanach Zjednoczonych.
LTX Audio-to-Video
Bazowy model oparty na DiT, zaprojektowany do jednoczesnego generowania zsynchronizowanego wideo i audio, zapewniając spójną mowę i realistyczny ruch.
Dane wejściowe generowania:
- Tekst na wideo
- Obraz na wideo
- Audio na wideo
- Głębia na wideo
Funkcje:
- Jednocześnie generuje dialog, ruch ust i dźwięk otoczenia, zapewniając idealne dopasowanie bez zewnętrznych narzędzi
- Dynamiczne sceny ze stabilnym ruchem, spójną tożsamością i wysoką spójnością między klatkami
- Obsługuje wierne, zsynchronizowane generowanie do 20 sekund
- Zaawansowane kierowanie kreatywne dzięki szczegółowej obsłudze negatywnych promptów
- Generowanie do 4 wariantów naraz
Opcje wyjściowe:
- Rozdzielczości: 720p, 1080p
- Proporcje obrazu: 16:9, 4:3, 1:1, 3:4, 9:16
Idealne do:
- Spójnej mowy i ekspresyjnych występów postaci
- Treści narracyjnych wymagających zintegrowanego dźwięku otoczenia i spójnego tempa
- Dynamicznych scen ze złożoną logiką ruchu uwzględniającą kamerę
Koszt: Zależy od wybranych ustawień i czasu trwania
LTX 2 Pro
Wierny model generatywny zoptymalizowany pod kątem maksymalnej szczegółowości obrazu i stabilności struktury, zdolny tworzyć materiały 4K gotowe do produkcji z płynnym ruchem.
Dane wejściowe generowania:
- Tekst na wideo
- Klatka początkowa (obraz na wideo)
Funkcje:
- Priorytetowo traktuje jakość i spójność obrazu, a nie szybkość, zapewniając stabilne wyniki w dłuższych sekwencjach
- Obsługuje 25 FPS i 50 FPS, zapewniając wyjątkowo płynny, profesjonalny ruch
- Zintegrowane generowanie audio-wideo z przełącznikiem dźwięku
- Obsługuje natywne wyjście 1080p, 2k i 4k bez utraty szczegółów
- Generowanie do 4 wariantów naraz
Opcje wyjściowe:
- Rozdzielczości: 1080p, 2k, 4k
- Liczba klatek: 25 FPS, 50 FPS
- Proporcje obrazu: 16:9 (domyślne)
- Czasy trwania: 6 s, 8 s, 10 s
Idealne do:
- Filmów w wysokiej rozdzielczości wymagających wyrazistości 4K
- Profesjonalnych treści wymagających płynnego ruchu 50 FPS
- Szczegółowych sekwencji, w których kluczowe są stabilność obrazu i spójność strukturalna
Koszt: Zależy od wybranych ustawień i czasu trwania
LTX 2 Retake
Precyzyjne narzędzie AI do reżyserii, które pozwala zmieniać dialogi, emocje i akcję w istniejących ujęciach bez naruszania ciągłości ani ponownego generowania całej sekwencji.
Dane wejściowe generowania:
- Wideo źródłowe
- Opis tekstowy
Funkcje:
- Modyfikowanie konkretnych fragmentów przy zachowaniu kontekstu z otaczających klatek
- Przeformułowywanie kwestii przy zachowaniu głosu, gry i otoczenia postaci
- Wiele trybów edycji: wybierz „Audio i wideo”, „Tylko audio” lub „Tylko wideo”, by wyodrębnić i ponownie wygenerować konkretne elementy ujęcia
- Nowa zawartość naturalnie dziedziczy oryginalny ruch, oświetlenie i ton, zapewniając płynne przejścia
- Natychmiastowe testowanie alternatywnych reakcji postaci, akcentów emocjonalnych lub ruchów kamery w jednym ujęciu
- Jednoczesne generowanie do 4 wariantów, by łatwo porównać je obok siebie
Opcje wyjściowe:
- Proporcje obrazu: tylko 16:9
Idealne do:
- Dostosowywania scenariuszy i dopracowywania dialogów bez ponownych zdjęć czy nagrań
- Poprawiania akcentów emocjonalnych lub tempa w postprodukcji
- Testowania wielu komunikatów marki i wezwań do działania w jednym materiale marketingowym
Koszt: Zależy od wybranych ustawień i czasu trwania
LTX 2 Fast
Model generatywny zoptymalizowany pod kątem szybkości, stworzony do krótkich pętli informacji zwrotnej i szybkiego tworzenia treści. Dostarcza obrazy w wysokiej rozdzielczości przy znacznie krótszym czasie renderowania.
Dane wejściowe generowania:
- Tekst na wideo
- Klatka początkowa (obraz na wideo)
Funkcje:
- Zaprojektowany z myślą o szybkości i szybkich iteracjach, pozwala na błyskawiczne eksperymenty wizualne i niemal natychmiastowe podglądy
- Obsługuje natywne wyjście 1080p, 2k i 4k przy mniejszym zapotrzebowaniu na moc obliczeniową niż model Pro
- Obsługuje 25 FPS i 50 FPS, zapewniając płynny ruch przy dużej szybkości
- Umożliwia szybkie generowanie zsynchronizowanych treści audio-wideo do 20 sekund
- Natywna obsługa włączania lub wyłączania audio dla każdej generacji
- Jednoczesne generowanie do 4 wariantów
Opcje wyjściowe:
- Rozdzielczości: 1080p, 2k, 4k
- Liczba klatek: 25 FPS, 50 FPS
- Proporcje obrazu: 16:9 (domyślne)
- Czasy trwania: 6 s, 8 s, 10 s, 12 s, 14 s, 16 s, 18 s, 20 s
Idealne do:
- Szybkiego prototypowania i eksploracji kreatywnej, gdy szybkość jest ważniejsza niż maksymalna szczegółowość
- Wielu treści do mediów społecznościowych wymagających szybkiej realizacji
- Testów A/B różnych koncepcji wizualnych i stylów ruchu
Koszt: Zależy od wybranych ustawień i czasu trwania
Wan 3.0
Filmowy model wideo z referencjami obrazów, wideo i audio, generowanym audio oraz generacjami do 30 sekund.
Dane wejściowe generowania:
- Tekst na wideo
- Klatka początkowa
- Klatka końcowa
- Referencje obrazów (do 10)
- Referencje wideo (do 5, łącznie 15 s)
- Referencje audio (do 5, łącznie 15 s)
Funkcje:
- Klatki i referencje wzajemnie się wykluczają
- Stałe czasy trwania: 5 s, 10 s, 15 s, 20 s i 30 s
- Natywne sterowanie dźwiękiem z włączonym lub wyłączonym audio dla każdej generacji
- Opcjonalne ulepszanie promptu
- Tworzenie wsadowe do 4 generacji naraz
Opcje wyjściowe:
- Rozdzielczości: 480p, 720p, 1080p
- Proporcje obrazu: Automatycznie, 16:9, 4:3, 1:1, 3:4, 9:16
Idealne do:
- Dłuższych filmowych ujęć dobrze zgodnych z promptem
- Scen opartych na referencjach z audio
Koszt: Zależy od wybranych ustawień i czasu trwania
Wan 3.0 nie jest dostępny w Stanach Zjednoczonych.
Wan 3.0 Prime
Szybszy wariant Wan 3.0 z tymi samymi danymi wejściowymi i opcjami wyjściowymi, odpowiedni do opracowywania pomysłów.
Dane wejściowe generowania:
- Tekst na wideo
- Klatka początkowa
- Klatka końcowa
- Referencje obrazów (do 10)
- Referencje wideo (do 5, łącznie 15 s)
- Referencje audio (do 5, łącznie 15 s)
Funkcje:
- Czas generowania to około połowa czasu Wan 3.0
- Stałe czasy trwania: 5 s, 10 s, 15 s, 20 s i 30 s
- Natywne sterowanie dźwiękiem z włączonym lub wyłączonym audio dla każdej generacji
- Tworzenie wsadowe do 4 generacji naraz
Opcje wyjściowe:
- Rozdzielczości: 480p, 720p, 1080p
- Proporcje obrazu: Automatycznie, 16:9, 4:3, 1:1, 3:4, 9:16
Idealne do:
- Eksplorowania pomysłów przed finalnym renderem Wan 3.0
- Workflowów, w których liczy się czas realizacji
Koszt: Zależy od wybranych ustawień i czasu trwania
Wan 3.0 Prime nie jest dostępny w Stanach Zjednoczonych.
Wan 2.6
Filmowa platforma wideo nowej generacji, która wykorzystuje jednolitą architekturę multimodalną do tworzenia treści 1080p gotowych do produkcji, z natywną synchronizacją audio i inteligentnym sekwencjonowaniem wielu ujęć.
Dane wejściowe generowania:
- Tekst na wideo
- Klatka początkowa (obraz na wideo)
- Referencja wideo (wideo na wideo)
- Referencja audio (opcjonalne tło dźwiękowe lub dialog)
Funkcje:
- Jednolity system multimodalny: przetwarza tekst, obrazy, wideo i audio w jednym zintegrowanym środowisku, zapewniając spójną jakość wyników
- Natywna synchronizacja audio: automatycznie generuje i dopasowuje dialogi, narrację oraz efekty dźwiękowe otoczenia do ruchu na ekranie
- Inteligentne sekwencjonowanie wielu ujęć: automatycznie układa powiązane sekwencje wideo w spójną narrację, zachowując zgodność postaci
- Dłuższe czasy trwania: obsługuje stabilne, wysokiej jakości generowanie o stałej długości 5 s, 10 s i 15 s
- Zaawansowana kontrola kreatywna: obsługuje negatywne prompty do szczegółowego zarządzania detalami oraz tworzenie wsadowe do 4 wariantów
Opcje wyjściowe:
- Rozdzielczości: 720p, 1080p
- Proporcje obrazu: 16:9, 4:3, 1:1, 3:4, 9:16
Idealne do:
- Profesjonalnego storytellingu i złożonych, filmowych sekwencji wieloujęciowych
- Reklam w mediach społecznościowych i treści marketingowych wymagających zintegrowanego audio wysokiej jakości
- Treści opartych na postaciach, wymagających ścisłej spójności obrazu i ruchu dzięki referencjom wideo
Koszt: Zależy od wybranych ustawień i czasu trwania
Wan 2.6 nie jest dostępny w Stanach Zjednoczonych.
Wan 2.5 Video
Wszechstronny model, który tworzy filmowy ruch i wiernie realizuje prompt na podstawie tekstu lub obrazu początkowego.
Dane wejściowe generowania:
- Tekst na wideo
- Klatka początkowa (obraz na wideo)
Funkcje:
- Szczegółowa kontrola kreatywna dzięki negatywnym promptom i dedykowanemu sterowaniu dźwiękiem
- Stałe czasy trwania: 5 s i 10 s
- Tworzenie wsadowe do 4 generacji naraz
Opcje wyjściowe:
- Rozdzielczości: 480p, 720p, 1080p
- Proporcje obrazu: 16:9, 1:1, 9:16
Idealne do:
- Filmowych treści dobrze zgodnych z promptem
Koszt: Zależy od wybranych ustawień i czasu trwania
Koszt generowania zależy od wybranych ustawień.
Wan 2.5 Video nie jest dostępny w Stanach Zjednoczonych.
Generatywne modele obrazów
GPT Image 2.5 Sunburst
Gotowy do produkcji model obrazów OpenAI do bardzo szczegółowych wyników i precyzyjnej edycji.
Dane wejściowe generowania:
- Tekst na obraz
- Referencje obrazów (do 10)
Funkcje:
- Pięć poziomów jakości: od niskiej do maksymalnej
- Własna rozdzielczość do 3840 px na bok, przy proporcjach obrazu do 3:1
- Tworzenie wsadowe do 4 generacji naraz
Opcje wyjściowe:
- Rozdzielczości: 1K, 2K, 4K lub własna
- Proporcje obrazu: 3:1, 21:9, 2:1, 16:9, 3:2, 4:3, 5:4, 1:1, 4:5, 3:4, 2:3, 9:16, 1:2, 1:3
Idealne do:
- Finalnych materiałów, w których liczą się detale i wierność
- Precyzyjnej edycji istniejących obrazów
Koszt: Zależy od wybranych ustawień i liczby wariantów
GPT Image 2.5 Flare
Szybki wariant GPT Image 2.5 z takimi samymi kontrolkami jak Sunburst, dostosowany do codziennego generowania na dużą skalę.
Dane wejściowe generowania:
- Tekst na obraz
- Referencje obrazów (do 10)
Funkcje:
- Pięć poziomów jakości: od niskiej do maksymalnej
- Własna rozdzielczość do 3840 px na bok, przy proporcjach obrazu do 3:1
- Tworzenie wsadowe do 4 generacji naraz
Opcje wyjściowe:
- Rozdzielczości: 1K, 2K, 4K lub własna
- Proporcje obrazu: 3:1, 21:9, 2:1, 16:9, 3:2, 4:3, 5:4, 1:1, 4:5, 3:4, 2:3, 9:16, 1:2, 1:3
Idealne do:
- Generowania dużej liczby obrazów
- Szybkich iteracji, które nadal wymagają 4K i własnych rozmiarów
Koszt: Zależy od wybranych ustawień i liczby wariantów
API: gpt-image-2.5-flare
GPT Image 2
Zaawansowany model AI zaprojektowany do precyzyjnego generowania obrazów, z lepszym renderowaniem tekstu i możliwością tworzenia w wysokiej rozdzielczości.
Funkcje:
- Precyzyjna kontrola tekstu do tworzenia obrazów z czytelną, dokładną typografią
- Wynik PNG w wysokiej rozdzielczości, odpowiedni do zastosowań profesjonalnych i komercyjnych
- Obsługuje wiele referencji obrazów, które pomagają określić styl i kompozycję
- Generuje do 4 obrazów naraz
Opcje wyjściowe:
- Proporcje obrazu: 3:2, 1:1, 2:3
- Opcje jakości: niska, średnia, wysoka
Idealne do:
- Materiałów marketingowych i projektowych wymagających precyzyjnego rozmieszczenia tekstu
- Profesjonalnych treści wymagających wysokiej rozdzielczości
- Projektów kreatywnych wymagających dokładnej kontroli obrazów opartych na tekście
Koszt: Zależy od wybranych ustawień i liczby wariantów
API: gpt-image-2
Nano Banana 2.1
Model obrazów z natywnym wyjściem 4K i obsługą do 14 referencji obrazów.
Dane wejściowe generowania:
- Tekst na obraz
- Referencje obrazów (do 14)
Opcje wyjściowe:
- Rozdzielczości: 4K
- Proporcje obrazu: od 8:1 do 1:8 oraz automatycznie
Idealne do:
- Obrazów opartych na referencjach, które wymagają natywnego 4K
Koszt: Zależy od wybranych ustawień i liczby wariantów
Nano Banana 2
Zaawansowany model AI do generowania obrazów, łączący jakość gotową do produkcji z ultraszybkim przetwarzaniem oraz lepszą wiedzą o świecie i spójnością obiektów.
Funkcje:
- Natywne wyjście w rozdzielczości 4K bez skalowania, zapewniające krystalicznie wyraźne detale
- Błyskawiczne generowanie obrazów w zaledwie 1–2 sekundy
- Lepsza zgodność z promptami dzięki zaawansowanemu rozumowaniu i wykonywaniu instrukcji
- Wyraźne, dokładne renderowanie tekstu w wielu językach do makiet, oznakowania i infografik
- Spójna stylizacja wielu obiektów zachowująca tożsamość wielu postaci i przedmiotów
- Lepsza wiedza o świecie dla dokładniejszego generowania scen
- Obsługuje wiele referencji obrazów pomocnych w generowaniu
- Generuje do 4 obrazów naraz
Opcje wyjściowe:
- Proporcje obrazu: 21:9, 16:9, 5:4, 4:3, 3:2, 1:1, 2:3, 3:4, 4:5, 9:16
- Rozdzielczości: do 4K
Idealne do:
- Szybkich workflowów kreatywnych wymagających iteracji w czasie rzeczywistym
- Treści marki i storytellingu ze spójną tożsamością postaci
- Profesjonalnych materiałów wizualnych z dokładnym tekstem i typografią
Koszt: Zależy od wybranych ustawień i liczby wariantów
Nano Banana 2 Lite
Szybki, niedrogi wariant Nano Banana 2 do szybkiego generowania i edycji w 1K.
Dane wejściowe generowania:
- Tekst na obraz
- Referencje obrazów (do 14)
Funkcje:
- Stałe wyjście 1K dla spójnej szybkości i kosztów
- Ta sama obsługa 14 referencji obrazów co w Nano Banana 2
- Tworzenie wsadowe do 4 generacji naraz
Opcje wyjściowe:
- Rozdzielczości: 1K
- Proporcje obrazu: 21:9, 16:9, 5:4, 4:3, 3:2, 1:1, 2:3, 3:4, 4:5, 9:16
Idealne do:
- Szybkich iteracji i wersji roboczych
- Masowej edycji, gdy 1K wystarcza
Koszt: Zależy od wybranych ustawień i liczby wariantów
Krea 2 Medium
Wszechstronny, gotowy do produkcji model generowania obrazów od Krea AI, łączący jakość i szybkość w wielu workflowach kreatywnych.
Funkcje:
- Wierne generowanie obrazów z wysoką zgodnością z promptem
- Obsługuje wiele referencji obrazów pomocnych w generowaniu
- Generuje do 4 obrazów naraz
Opcje wyjściowe:
- Proporcje obrazu: 16:9, 4:3, 1:1, 3:4, 9:16
Idealne do:
- Profesjonalnego tworzenia treści wymagającego stałej jakości
- Szybkich iteracji w różnych koncepcjach kreatywnych
Koszt: Zależy od wybranych ustawień i liczby wariantów
Krea 2 Large
Flagowy model Krea AI do generowania obrazów, zapewniający najwyższą wierność wizualną i zaawansowaną kontrolę twórczą w profesjonalnych workflow.
Funkcje:
- Wyjątkowe detale i realizm na poziomie profesjonalnym
- Zaawansowana kontrola stylu z obsługą wielu obrazów referencyjnych
- Generuje do 4 obrazów naraz
Opcje wyjściowe:
- Proporcje obrazu: 16:9, 4:3, 1:1, 3:4, 9:16
Idealny do:
- Wysokiej klasy komercyjnej i redakcyjnej produkcji obrazów
- Złożonych kompozycji kreatywnych wymagających najwyższej wierności
Koszt: Zależy od wybranych ustawień i liczby wariantów
Recraft V4.1
Model zamiany tekstu na obraz skoncentrowany na designie, z dobrą kontrolą promptów i czystą kompozycją.
Dane wejściowe generowania:
- Zamiana tekstu na obraz
Funkcje:
- Wyjście 2K korzysta z wariantu modelu Pro
- Tworzenie wsadowe do 4 generacji naraz
Opcje wyjściowe:
- Rozdzielczości: 1K, 2K
- Proporcje obrazu: 2:1, 16:9, 3:2, 14:10, 4:3, 5:4, 1:1, 4:5, 3:4, 10:14, 2:3, 6:10, 9:16, 1:2
Idealny do:
- Grafik, ikon i plakatów opartych na układzie
- Czystych kompozycji tworzonych wyłącznie z tekstu
Koszt: Zależy od wybranych ustawień i liczby wariantów
Recraft V4.1 Flash
Szybki model zamiany tekstu na obraz skoncentrowany na designie.
Dane wejściowe generowania:
- Zamiana tekstu na obraz
Opcje wyjściowe:
- Proporcje obrazu: 16 proporcji
Idealny do:
- Grafik opartych na układzie, tworzonych wyłącznie z tekstu
Koszt: Zależy od wybranych ustawień i liczby wariantów
Recraft V4
Model obrazów skoncentrowany na designie, który może dopasować styl obrazów referencyjnych.
Dane wejściowe generowania:
- Zamiana tekstu na obraz
- Referencje stylu (do 10)
Funkcje:
- Kontrola dopasowania stylu: Precise dokładnie odwzorowuje styl referencji, Flexible dopasowuje ogólny wygląd
- Wyjście 2K korzysta z wariantu modelu Pro
- Tworzenie wsadowe do 4 generacji naraz
Opcje wyjściowe:
- Rozdzielczości: 1K, 2K
- Proporcje obrazu: 2:1, 16:9, 3:2, 14:10, 4:3, 5:4, 1:1, 4:5, 3:4, 10:14, 2:3, 6:10, 9:16, 1:2
Idealny do:
- Grafik spójnych z marką na podstawie zestawu referencji stylu
- Ilustracji i projektów graficznych
Koszt: Zależy od wybranych ustawień i liczby wariantów
Seedream 5 Lite
Lekki model obrazów od ByteDance do szybkiego generowania, zapewniający wysoką jakość przy mniejszym zapotrzebowaniu na moc obliczeniową.
Funkcje:
- Szybkie generowanie do błyskawicznego iterowania pomysłów
- Obsługuje wiele obrazów referencyjnych, które kierują generowaniem
- Generuje do 4 obrazów naraz
Opcje wyjściowe:
- Proporcje obrazu: 16:9, 4:3, 1:1, 3:4, 9:16
Idealny do:
- Workflow tworzenia dużej liczby obrazów wymagających szybkości
- Szybkiego odkrywania koncepcji i podglądów
Koszt: Zależy od wybranych ustawień i liczby wariantów
API: bytedance-seedream-5-lite
Seedream 5 Lite nie jest dostępny w Stanach Zjednoczonych.
Seedream 5 Pro
Wariant Seedream 5 o wyższej wierności, przeznaczony do precyzyjnej edycji, wielojęzycznego tekstu i gęstych infografik.
Dane wejściowe generowania:
- Zamiana tekstu na obraz
- Obrazy referencyjne (do 10)
Funkcje:
- Dokładne renderowanie wielojęzycznego tekstu
- Obsługuje gęste układy, takie jak infografiki i plakaty
- Tworzenie wsadowe do 4 generacji naraz
Opcje wyjściowe:
- Rozdzielczości: 1K, 2K
- Proporcje obrazu: 16:9, 4:3, 1:1, 3:4, 9:16
Idealny do:
- Projektów z dużą ilością tekstu w wielu językach
- Edycji wielu obrazów ze ścisłym trzymaniem się referencji
Koszt: Zależy od wybranych ustawień i liczby wariantów
Seedream 5 Pro nie jest dostępny w Stanach Zjednoczonych.
GPT Image 1.5
Szybki flagowy model do precyzyjnego generowania obrazów na podstawie tekstu oraz złożonej, nieniszczącej edycji zdjęć, która zachowuje oryginalne szczegóły.
Funkcje:
- Niezawodnie wprowadza żądane zmiany, zachowując oświetlenie, kompozycję i wygląd obiektu na obrazach źródłowych
- Obsługuje złożone zadania edycyjne, w tym dodawanie, usuwanie, łączenie i mieszanie elementów
- Zapewnia wyniki do 4 razy szybciej niż poprzednie wersje
- Generuje do 4 obrazów naraz
Opcje wyjściowe:
- Proporcje obrazu: 3:2, 1:1, 2:3
- Opcje jakości: niska, średnia, wysoka
Idealny do:
- Praktycznej korekty zdjęć i realistycznego wirtualnego przymierzania ubrań lub fryzur
- Transformacji koncepcyjnych i filtrów stylistycznych, które zachowują charakter obrazu wejściowego
- Szybkiego iterowania koncepcji zamiany tekstu na obraz
Koszt: Zależy od wybranych ustawień i liczby wariantów
API: gpt-image-1.5
GPT Image 1
Model obrazów pierwszej generacji OpenAI, z dobrym trzymaniem się promptów, czytelnym tekstem i szczegółową edycją.
Dane wejściowe generowania:
- Zamiana tekstu na obraz
- Obrazy referencyjne (do 5)
Funkcje:
- Trzy poziomy jakości: niski, średni, wysoki
- Tworzenie wsadowe do 4 generacji naraz
Opcje wyjściowe:
- Proporcje obrazu: 3:2, 1:1, 2:3
Idealny do:
- Workflow opartych już na wynikach GPT Image 1
- Prostych edycji i zadań z tekstem na obrazie w standardowej rozdzielczości
Koszt: Zależy od wybranych ustawień i liczby wariantów
API: gpt-image-1
Seedream 4.5
Wydajny multimodalny model bazowy, który łączy syntezę tekstu na obraz, precyzyjną edycję obrazów i złożoną kompozycję wielu obrazów w jednym wydajnym rozwiązaniu.
Funkcje:
- Natywna obsługa szybkiego generowania obrazów o wysokiej wierności w rozdzielczości do 4K
- Wyjątkowo dobrze zachowuje rysy twarzy, oświetlenie, ton kolorów i drobne detale podczas edycji opartej na referencjach
- Dokładnie rozpoznaje i łączy docelowe elementy z wielu obrazów wejściowych, zapewniając kontrolowane i spójne wyniki
- Oferuje możliwości kompozycji na poziomie projektanta oraz wyraźne, dokładne renderowanie małego tekstu na plakatach i materiałach marki
- Generuje do 4 obrazów naraz
Opcje wyjściowe:
- Proporcje obrazu: 16:9, 4:3, 1:1, 3:4, 9:16
- Rozdzielczości: 2K, 4K
Idealny do:
- Profesjonalnych workflow projektowania graficznego wymagających precyzyjnego układu i typografii
- Złożonej edycji zdjęć wymagającej ścisłego zachowania tożsamości i oświetlenia z referencji
- Kreatywnych kompozycji w wysokiej rozdzielczości z użyciem wielu źródeł wizualnych
Koszt: Zależy od wybranych ustawień i liczby wariantów
Seedream 4.5 nie jest dostępny w Stanach Zjednoczonych.
Kling O1 Image
Model do generowania obrazów o wysokiej wierności z zaawansowanymi zdolnościami rozumowania, stworzony z myślą o doskonałym trzymaniu się promptów i precyzyjnej spójności wizualnej w złożonych kompozycjach.
Funkcje:
- Wyjątkowo dobrze interpretuje i realizuje złożone, wielowarstwowe opisy tekstowe z dużą dokładnością
- Wykorzystuje obrazy referencyjne, by zachować tożsamość obiektu, oświetlenie i styl estetyczny w kolejnych generacjach
- Zoptymalizowany pod realistyczne tekstury, złożone relacje przestrzenne i profesjonalne efekty oświetleniowe
- Generuje do 4 obrazów naraz
Opcje wyjściowe:
- Proporcje obrazu: Auto, 16:9, 9:16, 1:1, 4:3, 3:4, 3:2, 2:3, 21:9
- Rozdzielczości: 1K, 2K
Idealny do:
- Profesjonalnych materiałów kreatywnych wymagających ścisłego trzymania się szczegółowych i technicznych promptów tekstowych
- Spójnej edycji obrazów i projektowania postaci z użyciem referencji wizualnych
Koszt: Zależy od wybranych ustawień i liczby wariantów
Kling O1 Image nie jest dostępny w Stanach Zjednoczonych.
FLUX.2 [Pro]
Produkcyjny model do generowania i edycji obrazów, stworzony dla profesjonalnych workflow, oferujący najnowocześniejszą jakość wizualną z naciskiem na szybkość, precyzję i spójność.
Funkcje:
- Odwołuj się do wielu obrazów jednocześnie, by uzyskać czołową w branży spójność postaci i tożsamości w setkach materiałów
- Zapewnia bezprecedensowy skok jakości detali, zbliżając efekty do prawdziwej fotografii — od tekstur tkanin po elementy architektoniczne
- Oferuje gotowe do produkcji renderowanie tekstu dla złożonej typografii, makiet UI i infografik
- Obsługuje precyzyjne określanie kolorów marki za pomocą kodów hex, bez przybliżeń
- Zapewnia dokładne pozycjonowanie obiektów, realistyczną fizykę, spójne oświetlenie i właściwą perspektywę w złożonych scenach
- Zoptymalizowany pod większą dokładność i lepszą reakcję na ustrukturyzowane, złożone instrukcje
- Generuje do 4 obrazów naraz
Opcje wyjściowe:
- Proporcje obrazu: 16:9, 4:3, 1:1, 3:4, 9:16
- Rozdzielczości: 720p, 1080p, 2K
Idealny do:
- Prowadzenia kampanii ze spójnymi postaciami i dokładnego umieszczania produktów w każdym kontekście
- Tworzenia makiet interfejsów z czytelnym tekstem i spójnymi systemami projektowania wizualnego
- Generowania na skalę fotografii produktowej i kontekstowych ujęć lifestyle’owych
Koszt: Zależy od wybranych ustawień i liczby wariantów
Nano Banana Pro
Profesjonalny model oparty na rozumowaniu do generowania i edycji obrazów, stworzony do produkcji materiałów o wysokiej wierności, zaawansowanej kontroli twórczej i precyzyjnego wykonywania instrukcji.
Dane wejściowe:
- Obraz referencyjny
- Opis tekstowy (obsługuje złożone, wielowarstwowe prompty)
Funkcje:
- Planuje sceny przed renderowaniem, zapewniając zgodne z fizyką oświetlenie, dokładne relacje między obiektami i doskonałe trzymanie się promptów
- Generuje wyraźny, czytelny wielojęzyczny tekst w różnych stylach fontów i pisma odręcznego do efektownych plakatów i makiet produktów
- Zachowuje wysoką wierność i podobieństwo dla maksymalnie 5 osób oraz wielu obiektów w różnorodnych materiałach kreatywnych
- Integruje Google Search, by wzbogacać obrazy o faktyczne dane, wiedzę o świecie i informacje w czasie rzeczywistym, takie jak pogoda czy wyniki sportowe
- Dostosowuj kąty kamery, punkty ostrości i oświetlenie sceny (np. zmieniając dzień w noc) za pomocą zaawansowanych narzędzi lokalnej edycji
- Doskonałe rozumienie przestrzeni umożliwia generowanie dokładnych infografik, diagramów technicznych i slajdów prezentacji
- Generuje do 4 wariantów naraz
Opcje wyjściowe:
- Rozdzielczości: 1K, 2K, 4K
- Proporcje obrazu: Auto, 21:9, 16:9, 5:4, 4:3, 3:2, 1:1, 2:3, 3:4, 4:5, 9:16
Idealny do:
- Profesjonalnych reklam, materiałów marki i wysokiej klasy fotografii produktów e-commerce
- Materiałów edukacyjnych, infografik opartych na danych i złożonej dokumentacji technicznej
- Szybkiego prototypowania projektów wizualnych w wysokiej rozdzielczości ze spójną tożsamością postaci lub marki
Koszt: Zależy od wybranych ustawień i liczby wariantów
API: gemini-3-pro-image
Nano Banana
Szybki model do sprawnego generowania i edycji obrazów wysokiej jakości bezpośrednio na podstawie promptów tekstowych.
Funkcje:
- Obsługuje wiele obrazów referencyjnych, które kierują generowaniem
- Generuje do 4 obrazów naraz
Opcje wyjściowe:
- Proporcje obrazu: 21:9, 16:9, 5:4, 4:3, 3:2, 1:1, 2:3, 3:4, 4:5, 9:16
Idealny do:
- Szybkiego tworzenia i iterowania obrazów
Koszt: Zależy od wybranych ustawień i liczby wariantów
Runway Gen-4 Image
Zaawansowany model bazowy do generowania obrazów o wysokiej wierności, oferujący bezprecedensową kontrolę stylistyczną i pamięć wizualną, która pozwala zachować spójność między scenami.
Funkcje:
- Zakotwicz postacie, style lub konkretne obiekty za pomocą obrazów wejściowych, by zachować profesjonalną spójność w wielu wynikach
- Zoptymalizowany do interpretowania złożonych opisów w języku naturalnym, zapewniając precyzyjną kontrolę szczegółów wizualnych, oświetlenia i emocji
- Potrafi generować wysokiej jakości materiały wizualne do różnych zastosowań — od filmowych storyboardów po profesjonalną fotografię produktową
- Generuje do 4 obrazów naraz
Opcje wyjściowe:
- Proporcje obrazu: 16:9, 4:3, 1:1, 3:4, 9:16
- Rozdzielczości: 720p, 1080p
Idealny do:
- Zachowania wyglądu głównych postaci w różnych środowiskach i oświetleniu
- Szybkiego tworzenia materiałów marki w wysokiej rozdzielczości, wirtualnych przymiarek i skalowalnych wizualizacji produktów
- Eksplorowania różnych kierunków artystycznych przy zachowaniu kluczowej tożsamości wizualnej dzięki referencjom obrazów
Koszt: Zależy od wybranych ustawień i liczby wariantów
Runway Gen-4 Image Turbo
Zoptymalizowany model do generowania obrazów, stworzony z myślą o szybkości, który zapewnia wyniki 2,5 raza szybciej niż standardowy Gen-4 Image przy identycznej jakości wyjściowej.
Funkcje:
- Zoptymalizowane przetwarzanie umożliwia szybką eksplorację kreatywną i generowanie obrazów o wysokiej wierności w ułamku czasu
- Prześlij do trzech obrazów referencyjnych, aby pomóc modelowi zrozumieć konkretne postacie, środowiska i style artystyczne
- Rozwiązuje problem dryfu wizualnego, kodując konkretne cechy wizualne z obrazów referencyjnych, by zachować tożsamość w wielu generacjach
- Z łatwością stosuj estetykę, oświetlenie i teksturę obrazu referencyjnego do całkiem nowych obiektów i scen
- Korzystaj z parametrów seed, aby systematycznie eksplorować warianty lub precyzyjnie odtwarzać konkretne wyniki
- Generuje do 4 obrazów naraz
Opcje wyjściowe:
- Proporcje obrazu: 16:9, 4:3, 1:1, 3:4, 9:16
- Rozdzielczości: 720p, 1080p
Idealny do:
- Szybkiego tworzenia na skalę materiałów wizualnych zoptymalizowanych pod platformy, takich jak Instagram Stories (9:16) lub standardowe posty (1:1)
- Zachowania ścisłej tożsamości wizualnej w kampaniach dzięki użyciu ksiąg identyfikacji marki jako obrazów referencyjnych
- Tworzenia spójnych póz postaci i ustawień przy jednoczesnym zachowaniu rozpoznawalności głównego bohatera
- Dokładnego tworzenia różnorodnych lifestyle’owych i sezonowych ujęć produktów z wykorzystaniem referencji
Koszt: Zależy od wybranych ustawień i liczby wariantów
Seedream 4
Specjalistyczny model obrazów do generowania sekwencji wielu ujęć lub scen z dużą ilością ruchu i akcji.
Funkcje:
- Doskonale tworzy obrazy ze stabilną fizyką i spójnymi przejściami
- Obsługuje wiele obrazów referencyjnych, które kierują generowaniem
- Generuje do 4 obrazów naraz
Opcje wyjściowe:
- Proporcje obrazu: auto, 16:9, 4:3, 1:1, 3:4, 9:16
Idealny do:
- Scen akcji i dynamicznych kompozycji
Koszt: Zależy od wybranych ustawień i liczby wariantów
Seedream 4 nie jest dostępny w Stanach Zjednoczonych.
Wan 2.5 Image
Wariant obrazu Wan 2.5, z wysoką wiernością promptów i obsługą obrazów referencyjnych.
Dane wejściowe generowania:
- Zamiana tekstu na obraz
- Obrazy referencyjne (do 2)
Funkcje:
- Kontrola promptu negatywnego i seed
- Tworzenie wsadowe do 4 generacji naraz
Opcje wyjściowe:
- Proporcje obrazu: 16:9, 4:3, 1:1, 3:4, 9:16
Idealny do:
- Obrazów statycznych pasujących do wyglądu generacji wideo Wan
- Obrazów koncepcyjnych wiernych promptom
Koszt: Zależy od wybranych ustawień i liczby wariantów
Wan 2.5 Image nie jest dostępny w Stanach Zjednoczonych.
FLUX 3 Image
Model obrazów z obsługą do 10 obrazów referencyjnych i wyjściem 4K.
Dane wejściowe generowania:
- Zamiana tekstu na obraz
- Obrazy referencyjne (do 10)
Opcje wyjściowe:
- Rozdzielczości: 4K
- Proporcje obrazu: 16 proporcji
Idealny do:
- Obrazów 4K tworzonych na podstawie referencji
Koszt: Zależy od wybranych ustawień i liczby wariantów
FLUX.1 Kontext [Pro]
Profesjonalny model do zaawansowanego generowania i edycji obrazów, oferujący wysoką spójność scen i kontrolę stylu.
Funkcje:
- Kontrola stylu oparta na obrazie, wymagająca obrazu referencyjnego do określenia estetyki wizualnej
- Generuje do 4 obrazów naraz
Opcje wyjściowe:
- Proporcje obrazu: 21:9, 16:9, 4:3, 3:2, 1:1, 2:3, 3:4, 4:5, 9:16, 9:21
Idealny do:
- Profesjonalnych treści z precyzyjnymi wymaganiami dotyczącymi stylu
Koszt: Zależy od wybranych ustawień i liczby wariantów
Modele synchronizacji ruchu ust z dźwiękiem
Creatify Aurora
Najnowocześniejszy model transformera dyfuzyjnego (DiT) do renderowania ultrarealistycznych, reagujących awatarów na podstawie dźwięku i wskazówek tekstowych.
Dane wejściowe generowania:
- Awatar (obraz źródłowy)
- Mowa (plik audio)
- Opis tekstowy (wskazówki)
Funkcje:
- Wykracza poza podstawową synchronizację ruchu ust z dźwiękiem, uwzględniając świadome kontekstu mruganie, oddychanie i naturalną mimikę
- Automatycznie synchronizuje ruchy dłoni i całego ciała na podstawie tonu i intonacji głosu, zapewniając studyjną jakość
- Dokładnie interpretuje intensywność i wysokość głosu, aby oddać emocje zgodne z występem
- Zachowuje wysoką wierność postaci i spójność zachowania nawet w długich dialogach lub występach muzycznych
- Zoptymalizowany pod różne scenariusze, w tym prezentacje z boku, dialogi w stylu podcastu i stylizowane animacje
- Generuj do 4 wariantów naraz
Opcje wyjściowe:
- Rozdzielczości: 480p, 720p
Idealne do:
- Profesjonalnych reklam wideo z awatarami i treści marketingowych
- Wirtualnego storytellingu o wysokiej wierności i ekspresyjnych występów muzycznych
- Długich filmów edukacyjnych lub szkoleniowych wymagających stałej obecności postaci
Koszt: Zależy od danych wejściowych, ustawień i czasu trwania
API: creatify-aurora
Veed Fabric
Szybki i precyzyjny model synchronizacji ruchu ust z dźwiękiem z obrazu do wideo, który animuje statyczny obraz zgodnie z podanym dźwiękiem.
Dane wejściowe:
- Obraz źródłowy
- Plik audio z mową
Funkcje:
- Animuje usta i mimikę na obrazie źródłowym, aby pasowały do podanego dźwięku
- Tworzy wysokiej jakości „mówiące” wideo ze statycznych obrazów
- Narzędzie do synchronizacji ruchu ust z dźwiękiem, a nie pełny model generowania wideo
Idealne do:
- Tworzenia mówiących awatarów ze statycznych obrazów
- Dodawania dialogów do portretów postaci
- Profesjonalnych workflow treści opartych na awatarach
Koszt: Zależy od danych wejściowych, ustawień i czasu trwania
Aby uzyskać najlepsze wyniki, obraz powinien zawierać wykrywalną postać.
HeyGen Avatar 4
Najnowszy model awatarów HeyGen do generowania bardzo realistycznych, ekspresyjnych filmów z mówiącą twarzą na podstawie jednego obrazu i dźwięku.
Dane wejściowe:
- Obraz źródłowy
- Plik audio z mową
Funkcje:
- Animuje mimikę i ruchy ust, aby z dużą wiernością pasowały do podanego dźwięku
- Tworzy naturalne ruchy głowy i subtelną mikroekspresję, zapewniając realistyczne rezultaty
- Narzędzie do synchronizacji ruchu ust z dźwiękiem, a nie pełny model generowania wideo
Idealne do:
- Profesjonalnych filmów ze spikerami i prezenterami
- Tworzenia spersonalizowanych treści z awatarami na dużą skalę
- Filmów marketingowych i szkoleniowych ze stałą obecnością postaci
Koszt: Zależy od danych wejściowych, ustawień i czasu trwania
Aby uzyskać najlepsze wyniki, obraz powinien zawierać wyraźnie widoczną twarz.
Sync 3
Model synchronizacji ruchu ust z dźwiękiem do wideo najnowszej generacji od Sync, zapewniający studyjną synchronizację w szerokim zakresie typów treści.
Dane wejściowe generowania:
- Wideo źródłowe
- Audio z mową
Funkcje:
- Synchronizacja ruchu ust z dźwiękiem o wysokiej precyzji, która zachowuje unikalne detale twarzy, naturalne zęby i teksturę skóry
- Zoptymalizowany dla wszystkich typów treści, w tym materiałów aktorskich, animacji 3D i wideo generowanego przez AI
- Narzędzie do synchronizacji ruchu ust z dźwiękiem między filmami, a nie pełny generator wideo
Idealne do:
- Profesjonalnego dubbingu i lokalizacji filmów oraz reklam
- Ulepszania lub poprawiania dialogów w każdym formacie wideo
- Workflow tłumaczenia dużej liczby treści
Koszt: Zależy od danych wejściowych, ustawień i czasu trwania
Aby uzyskać najlepsze wyniki, wideo powinno zawierać wykrywalną postać.
Sync Lipsync 2 Pro
Najnowocześniejszy model edycji wideo zaprojektowany do synchronizacji ruchu ust z dźwiękiem na poziomie studyjnym, który zachowuje unikalne detale twarzy i obsługuje wyjścia w wysokiej rozdzielczości.
Dane wejściowe generowania:
- Wideo źródłowe
- Audio z mową
Funkcje:
- Wykorzystuje zaawansowane skalowanie w górę, aby obsługiwać wyjście 4K przy zachowaniu ostrych, naturalnych tekstur
- Chroni unikalne cechy twarzy, takie jak naturalne zęby, piegi, makijaż i złożony zarost, bez utraty wyrazistości
- Zoptymalizowany do pracy ze wszystkimi typami treści, w tym materiałami aktorskimi, animacją 3D i wideo generowanym przez AI
- Zapewnia ekspresyjne, zsynchronizowane rezultaty od razu, bez treningu dla konkretnego mówcy ani dostrajania modelu
- Generuj do 4 wariantów jednocześnie
Idealne do:
- Profesjonalnego dubbingu i lokalizowanych treści do filmów oraz reklam premium
- Ulepszania lub poprawiania dialogów postaci animowanych 3D i generowanych przez AI
- Projektów w wysokiej rozdzielczości wymagających idealnej spójności i detali twarzy na poziomie pikseli
Koszt: Zależy od danych wejściowych, ustawień i czasu trwania
OmniHuman 1.5
Specjalistyczny model narzędziowy do generowania wyjątkowo realistycznej, ludzkiej synchronizacji ruchu ust z dźwiękiem.
Dane wejściowe:
- Statyczny obraz źródłowy
- Plik audio z mową
Funkcje:
- Animuje usta na obrazie źródłowym, aby pasowały do podanego dźwięku
- Tworzy wysokiej jakości „mówiące” wideo ze statycznych obrazów
- Narzędzie do synchronizacji ruchu ust z dźwiękiem, a nie pełny model generowania wideo
Idealne do:
- Tworzenia mówiących awatarów
- Dodawania dialogów do statycznych obrazów
- Profesjonalnych workflow dubbingowych
Koszt: Zależy od danych wejściowych, ustawień i czasu trwania
Aby uzyskać najlepsze wyniki, obraz powinien zawierać wykrywalną postać.
OmniHuman 1.5 nie jest dostępny w Stanach Zjednoczonych.
MiniMax H3 Max Lip Sync
Animuje statyczny obraz na podstawie klipu mowy, z wyjściem do 2K.
Dane wejściowe:
- Obraz źródłowy
- Audio z mową (od 5 s do 14,8 s)
Funkcje:
- Narzędzie do synchronizacji ruchu ust z dźwiękiem, a nie pełny model generowania wideo
Idealne do:
- Mówiących portretów ze statycznego obrazu i krótkiego klipu audio
Koszt: Zależy od danych wejściowych, ustawień i czasu trwania
Veed Lipsync
Szybki, niedrogi i precyzyjny model narzędziowy do stosowania realistycznej synchronizacji ruchu ust z dźwiękiem w filmach.
Dane wejściowe:
- Wideo źródłowe
- Nowy plik audio z mową
Funkcje:
- Ponownie animuje ruchy ust w wideo źródłowym, aby pasowały do nowego dźwięku
- Narzędzie do synchronizacji ruchu ust z dźwiękiem między filmami, a nie pełny generator wideo
Idealne do:
- Dubbingu dużej liczby materiałów przy niskich kosztach
- Tłumaczenia treści
- Poprawiania audio w klipach wideo z realistycznym efektem
Koszt: Zależy od danych wejściowych, ustawień i czasu trwania
Aby uzyskać najlepsze wyniki, wideo powinno zawierać wykrywalną postać.
Veed Lipsync 2.0
Wyższej jakości następca Veed Lipsync do stosowania realistycznej synchronizacji ruchu ust z dźwiękiem w istniejących filmach.
Dane wejściowe:
- Wideo źródłowe
- Nowy plik audio z mową
Funkcje:
- Ponownie animuje ruchy ust w wideo źródłowym, aby pasowały do nowego dźwięku
- Narzędzie do synchronizacji ruchu ust z dźwiękiem między filmami, a nie pełny generator wideo
- Tworzenie wsadowe do 4 generacji naraz
Idealne do:
- Dubbingu i tłumaczeń, gdy jakość wyniku jest ważniejsza niż koszt
- Poprawiania dialogów w gotowych klipach
Koszt: Zależy od danych wejściowych, ustawień i czasu trwania
Aby uzyskać najlepsze wyniki, wideo powinno zawierać wykrywalną postać.
Modele narzędziowe
Topaz Image Upscale
Zwiększa rozdzielczość obrazu przy zachowaniu szczegółów.
Dane wejściowe:
- Obraz źródłowy
Funkcje:
- Współczynniki skalowania: 1.25x, 1.5x, 2x, 3x, 4x
Idealne do:
- Przygotowywania obrazów do wyświetlaczy o wysokiej rozdzielczości
Koszt: Zależy od danych wejściowych
Topaz Video Upscale
Zwiększa rozdzielczość wideo przy zachowaniu szczegółów.
Dane wejściowe:
- Wideo źródłowe
Funkcje:
- Współczynniki skalowania: 1.25x, 1.5x, 2x, 3x, 4x
- Szybkie i precyzyjne tryby przetwarzania
- Opcjonalna konwersja liczby klatek na sekundę do 24, 25, 30, 48, 50 lub 60 fps
Idealne do:
- Przygotowywania wideo do wyświetlaczy o wysokiej rozdzielczości
Koszt: Zależy od danych wejściowych
Usuwanie tła
Usuwa tło z obrazu i zwraca go z przezroczystością kanału alfa.
Dane wejściowe:
- Obraz źródłowy
Funkcje:
- Nie wymaga promptu
- Jeden wynik na uruchomienie
Idealne do:
- Wycinania produktów i kompozycji
- Przygotowywania obiektów do użycia jako referencje w innych generacjach
Koszt: Zależy od danych wejściowych
Usuwanie tła z wideo
Usuwa tło z wideo.
Dane wejściowe:
- Wideo źródłowe
Funkcje:
- Nie wymaga promptu
- Tło wyjściowe może być przezroczyste, czarne lub zielone
Idealne do:
- Wycinania obiektu z istniejącego materiału
- Przygotowywania wideo do kompozycji
Koszt: Zależy od danych wejściowych
Runway Ruby
Konwertuje wideo o standardowym zakresie dynamiki do HDR.
Dane wejściowe:
- Wideo źródłowe (do 30 s)
Funkcje:
- Nie wymaga promptu
- Jeden wynik na uruchomienie; długość i kadrowanie są zgodne ze źródłem
Idealne do:
- Przygotowywania materiału do wyświetlaczy HDR
- Ponownej korekcji kolorów wygenerowanego wideo przed dostarczeniem
Koszt: Zależy od długości wideo
Najczęściej zadawane pytania
|
|