

Voice Changer
Przewodnik po zmianie głosu w audio z zachowaniem emocji i sposobu mówienia.
Przegląd
Voice Changer (wcześniej Speech to Speech) pozwala zmienić jeden głos (głos źródłowy) w inny (sklonowany głos), zachowując ton i sposób mówienia oryginalnego głosu.
Voice Changer może uzupełniać Text to Speech (TTS), poprawiając błędy wymowy lub dodając szczególną interpretację, na której ci zależy. Voice Changer jest szczególnie przydatny do odwzorowywania subtelnych, charakterystycznych cech głosu, które nadają mu więcej emocji i naturalności. Kluczowe funkcje:
- Większa dokładność przy szeptaniu
- Możliwość tworzenia słyszalnych westchnień, śmiechu i płaczu
- Znacznie lepsze rozpoznawanie tonu i emocji
- Dokładnie zachowuje tempo mowy wejściowej
- Zachowanie języka i akcentu
Zobacz Voice Changer w akcji
Przewodnik
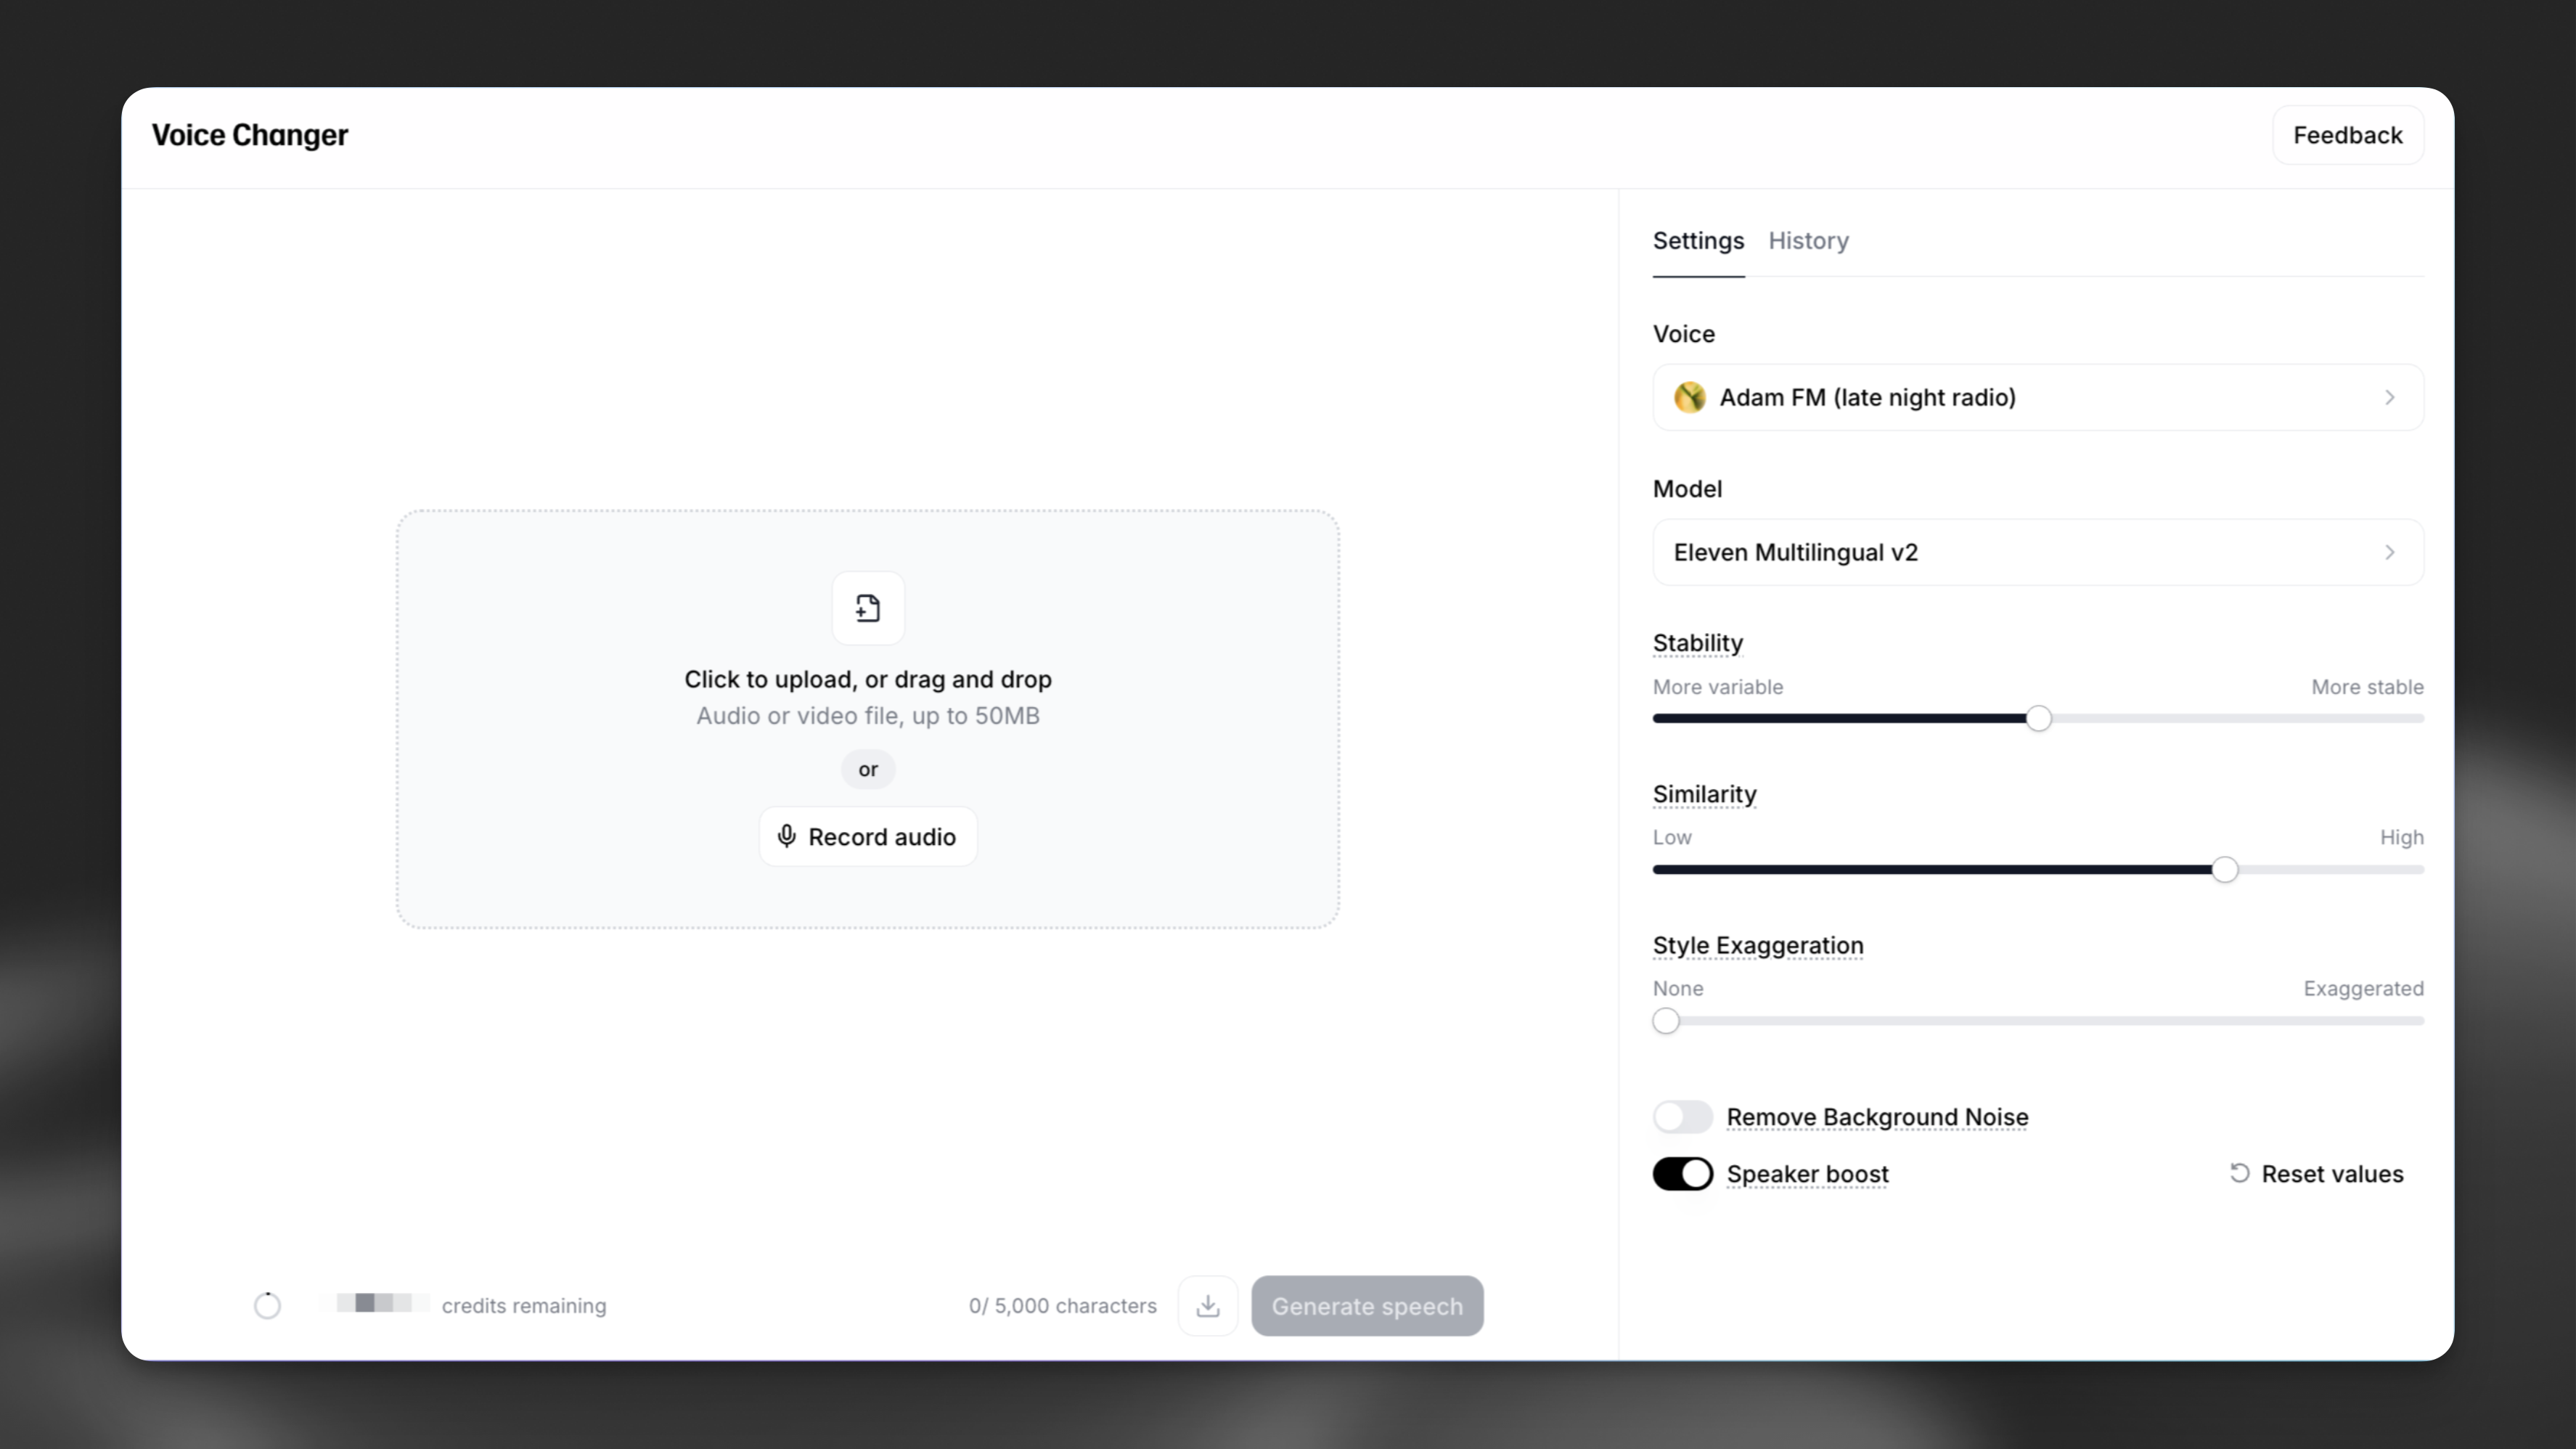
Audio możesz przesłać bezpośrednio jako plik albo nagrać na żywo przez mikrofon. Plik audio musi mieć mniej niż 50 MB, a plik lub nagranie na żywo nie może trwać dłużej niż 5 minut.
Jeśli materiał trwa dłużej niż 5 minut, podziel go na mniejsze części i wygeneruj je osobno. Jeśli plik jest zbyt duży, może być konieczne jego skompresowanie lub przekonwertowanie do formatu mp3.
Istniejący plik audio
Aby przesłać istniejący plik audio, kliknij pole audio lub przeciągnij do niego plik.
Nagrywanie na żywo
Kliknij przycisk Nagraj audio w polu audio, a gdy będziesz gotowy do nagrywania, kliknij przycisk Mikrofon, aby rozpocząć. Po zakończeniu kliknij przycisk Stop.
Zobaczysz potem plik audio z nagraniem, który możesz odtworzyć. Dzięki temu sprawdzisz, czy nagranie i wykonanie ci odpowiadają. Koszt w znakach zobaczysz w lewym dolnym rogu. Samo nagrywanie nie zużywa limitu — zostanie on naliczony dopiero po kliknięciu „Generuj”.
Koszt generowania w Voice Changer zależy wyłącznie od czasu trwania i wynosi 1000 znaków na minutę.
Ustawienia
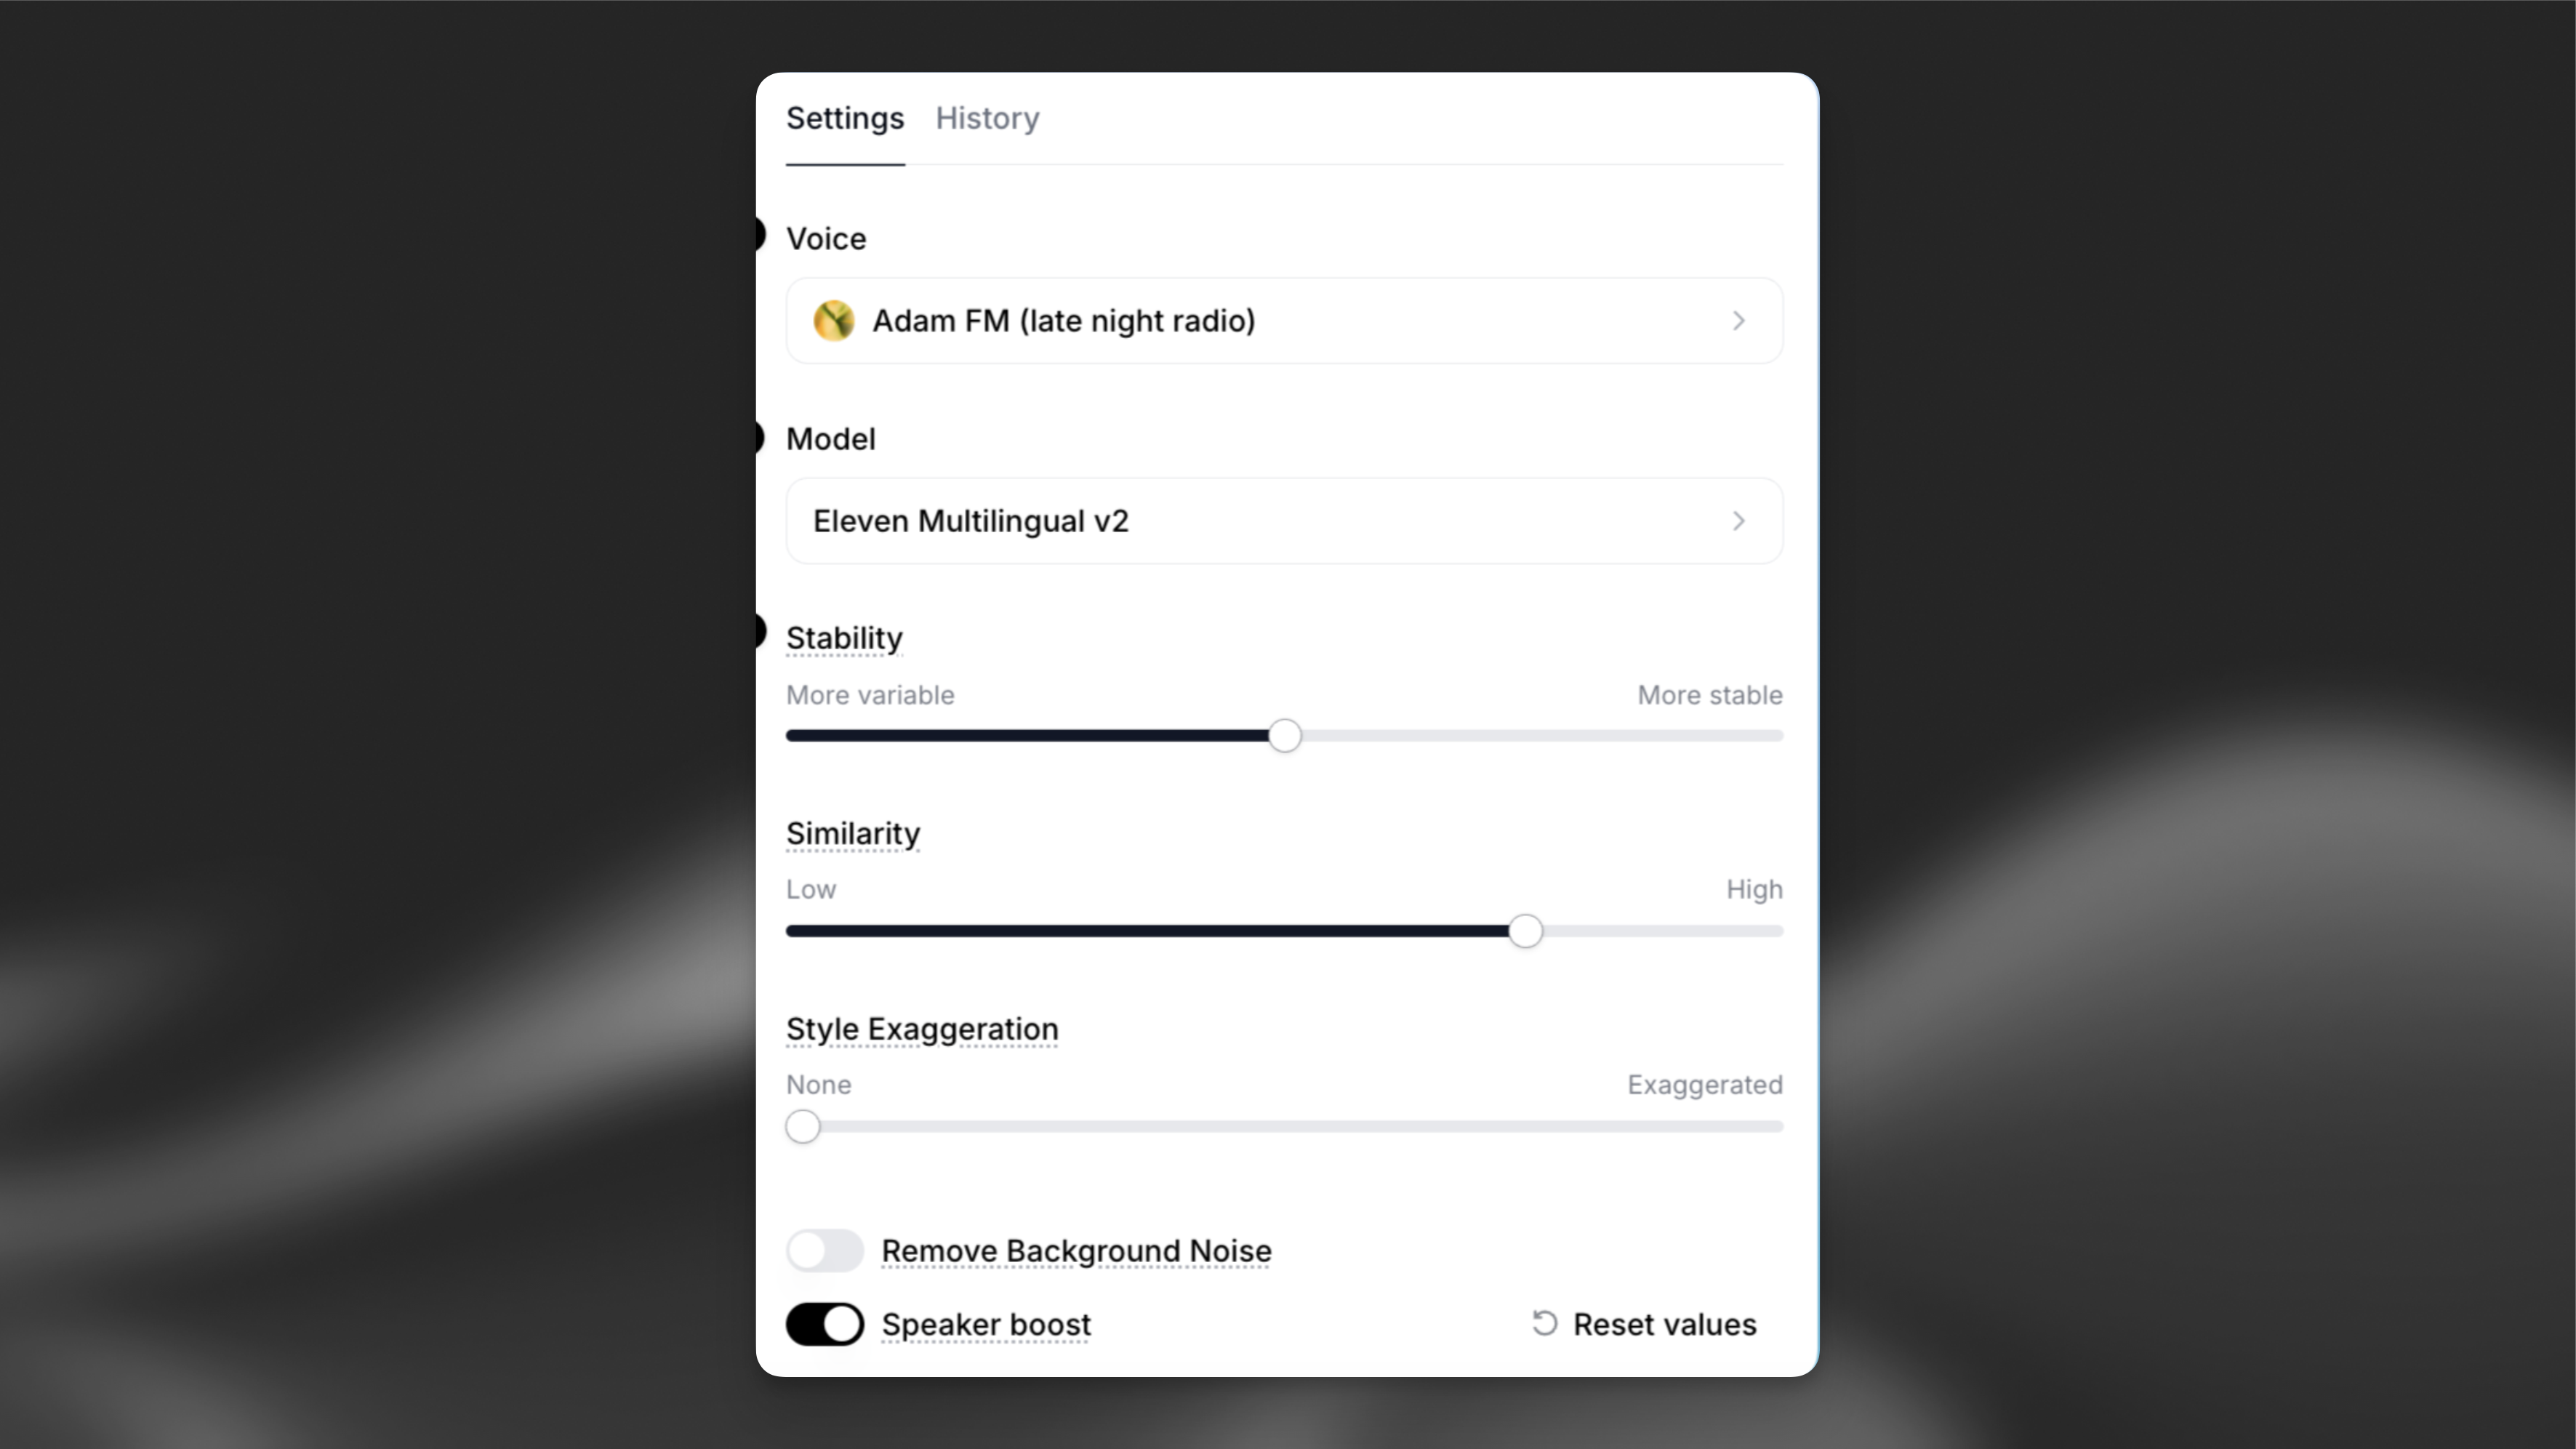
Więcej o różnych ustawieniach głosu tutaj.
Voice Changer dodaje ustawienie automatycznego usuwania szumu tła z nagrania.
Obsługiwane języki
eleven_english_sts_v2
Nasze wielojęzyczne modele v2 obsługują 29 języków:
angielski (USA, Wielka Brytania, Australia, Kanada), japoński, chiński, niemiecki, hindi, francuski (Francja, Kanada), koreański, portugalski (Brazylia, Portugalia), włoski, hiszpański (Hiszpania, Meksyk), indonezyjski, niderlandzki, turecki, filipiński, polski, szwedzki, bułgarski, rumuński, arabski (Arabia Saudyjska, ZEA), czeski, grecki, fiński, chorwacki, malajski, słowacki, duński, tamilski, ukraiński i rosyjski.
Model eleven_english_sts_v2 obsługuje tylko język angielski.
Dobre praktyki
Voice Changer świetnie zachowuje akcenty i naturalne tempo mowy w różnych głosach wyjściowych. Na przykład, jeśli prześlesz próbkę audio z portugalskim akcentem, wynik zachowa ten język i akcent. Próbka wejściowa jest kluczowa, ponieważ określa cechy wyniku. Jeśli wybierzesz brytyjski głos, taki jak „George”, ale nagrasz się z amerykańskim akcentem, wynikiem będzie głos George’a z amerykańskim akcentem.
- Ekspresja: Wyrażaj emocje w nagraniach. Niezależnie od tego, czy krzyczysz, płaczesz czy się śmiejesz, Voice Changer dokładnie odtworzy twoje wykonanie. To narzędzie zwiększa realizm AI i daje więcej swobody twórczej.
- Wzmocnienie mikrofonu: Ustaw odpowiednie wzmocnienie wejściowe. Ciche nagranie może utrudnić rozpoznawanie przez AI, a zbyt głośne może powodować przesterowanie.
- Szum tła: Włącz opcję Usuń szum tła, aby automatycznie usunąć szum tła z nagrania.