

Modificador de voz
Um guia sobre como transformar áudios entre vozes, preservando a emoção e a interpretação.
Visão geral
O Modificador de Voz (anteriormente Speech-to-Speech) permite converter uma voz (voz de origem) em outra (voz clonada), preservando o tom e a interpretação da voz original.
O Modificador de Voz pode ser usado para complementar o Text to Speech (TTS), corrigindo erros de pronúncia ou adicionando aquela performance especial que você quer transmitir. O Modificador de Voz é especialmente útil para reproduzir aquelas características sutis e particulares da voz que dão um toque mais emotivo e humano. Alguns recursos principais incluem:
- Maior precisão com sussurros
- Capacidade de criar suspiros, risadas ou choros audíveis
- Detecção de tom e emoção muito aprimorada
- Segue com precisão a cadência da fala de entrada
- Preservação de idioma/sotaque
Assista a um vídeo do Modificador de Voz em ação
Guia
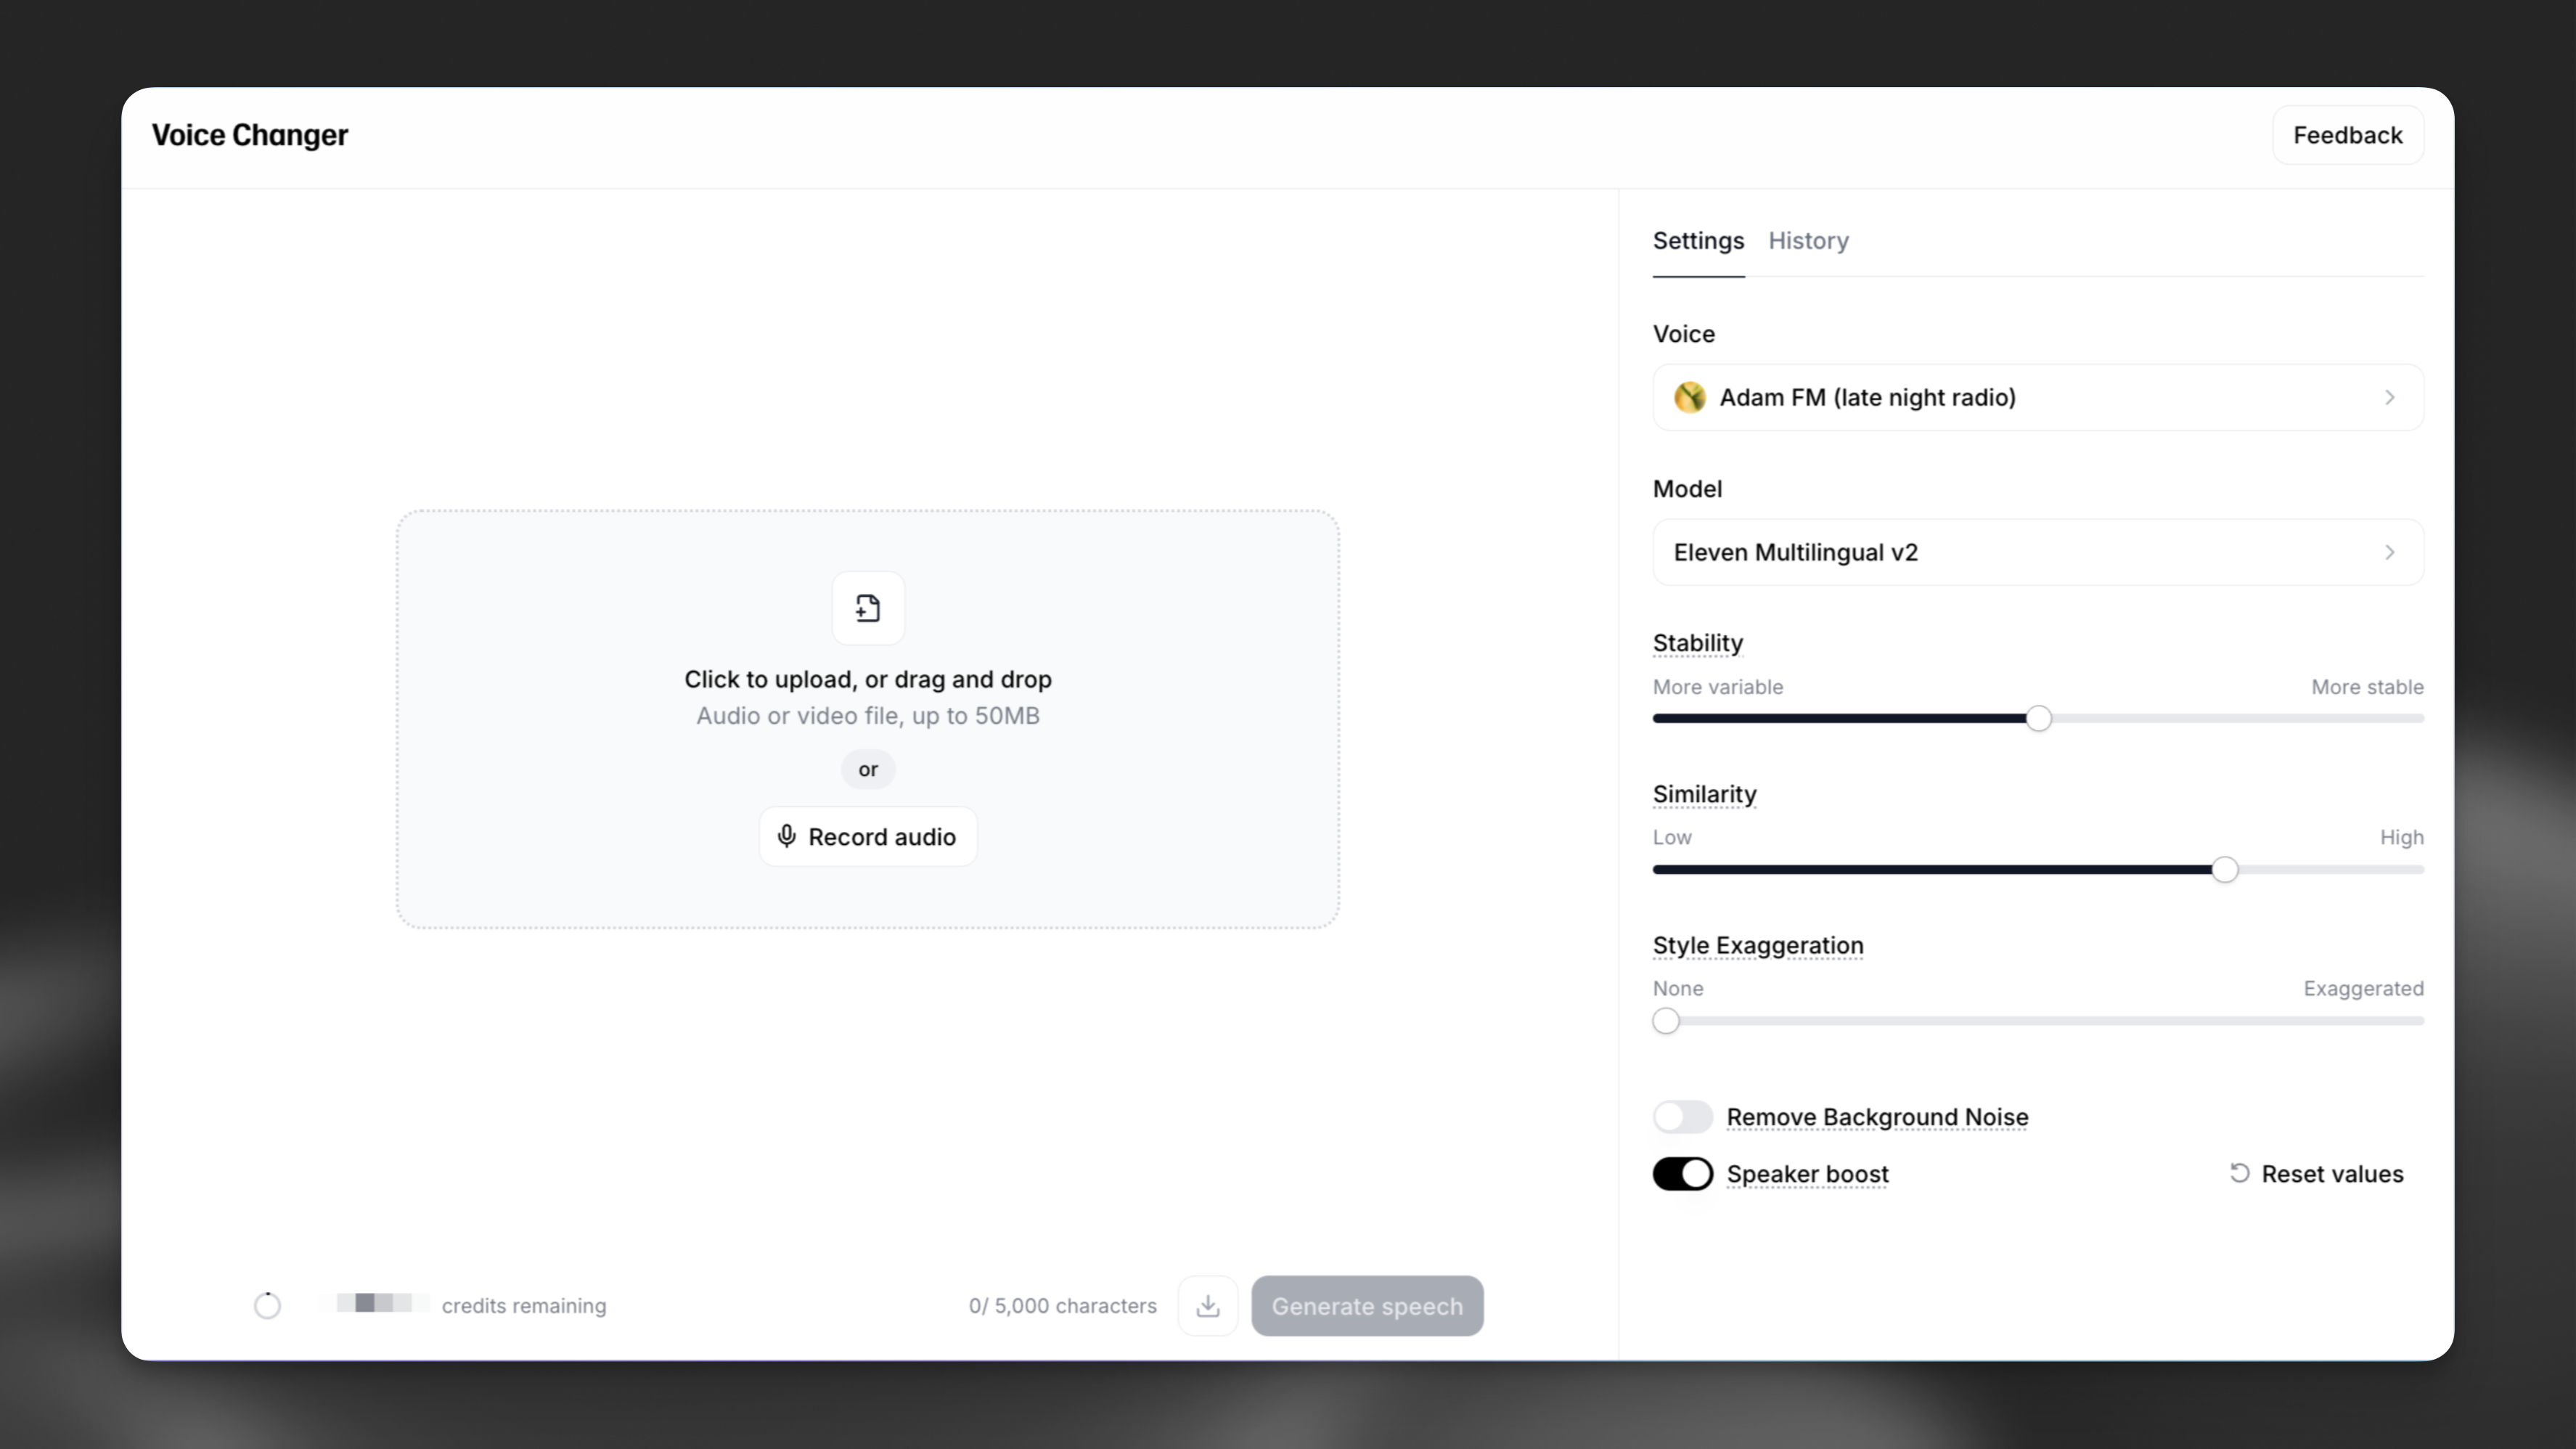
O áudio pode ser enviado diretamente por meio de um arquivo de áudio ou gravado ao vivo usando um microfone. O arquivo de áudio deve ter menos de 50 MB, e tanto o arquivo de áudio quanto a gravação ao vivo não podem exceder 5 minutos de duração.
Se você tiver material com mais de 5 minutos, recomendamos dividi-lo em seções menores e gerá-las separadamente. Além disso, se o tamanho do arquivo for muito grande, talvez seja necessário compactá-lo ou convertê-lo para MP3.
Arquivo de áudio existente
Para enviar um arquivo de áudio existente, clique na caixa de áudio ou arraste e solte o arquivo diretamente nela.
Gravar ao vivo
Pressione o botão Gravar áudio na caixa de áudio e, quando estiver pronto para iniciar a gravação, pressione o botão Microfone. Quando terminar de gravar, pressione o botão Parar.
Em seguida, você verá o arquivo de áudio dessa gravação e poderá reproduzi-lo para ouvir — isso ajuda a determinar se está satisfeito com sua performance/gravação. O custo em caracteres será exibido no canto inferior esquerdo, e você não consumirá essa cota ao gravar — somente ao pressionar “Gerar”.
O custo de uma geração com o Modificador de Voz é baseado exclusivamente na duração, a 1.000 caracteres por minuto.
Configurações
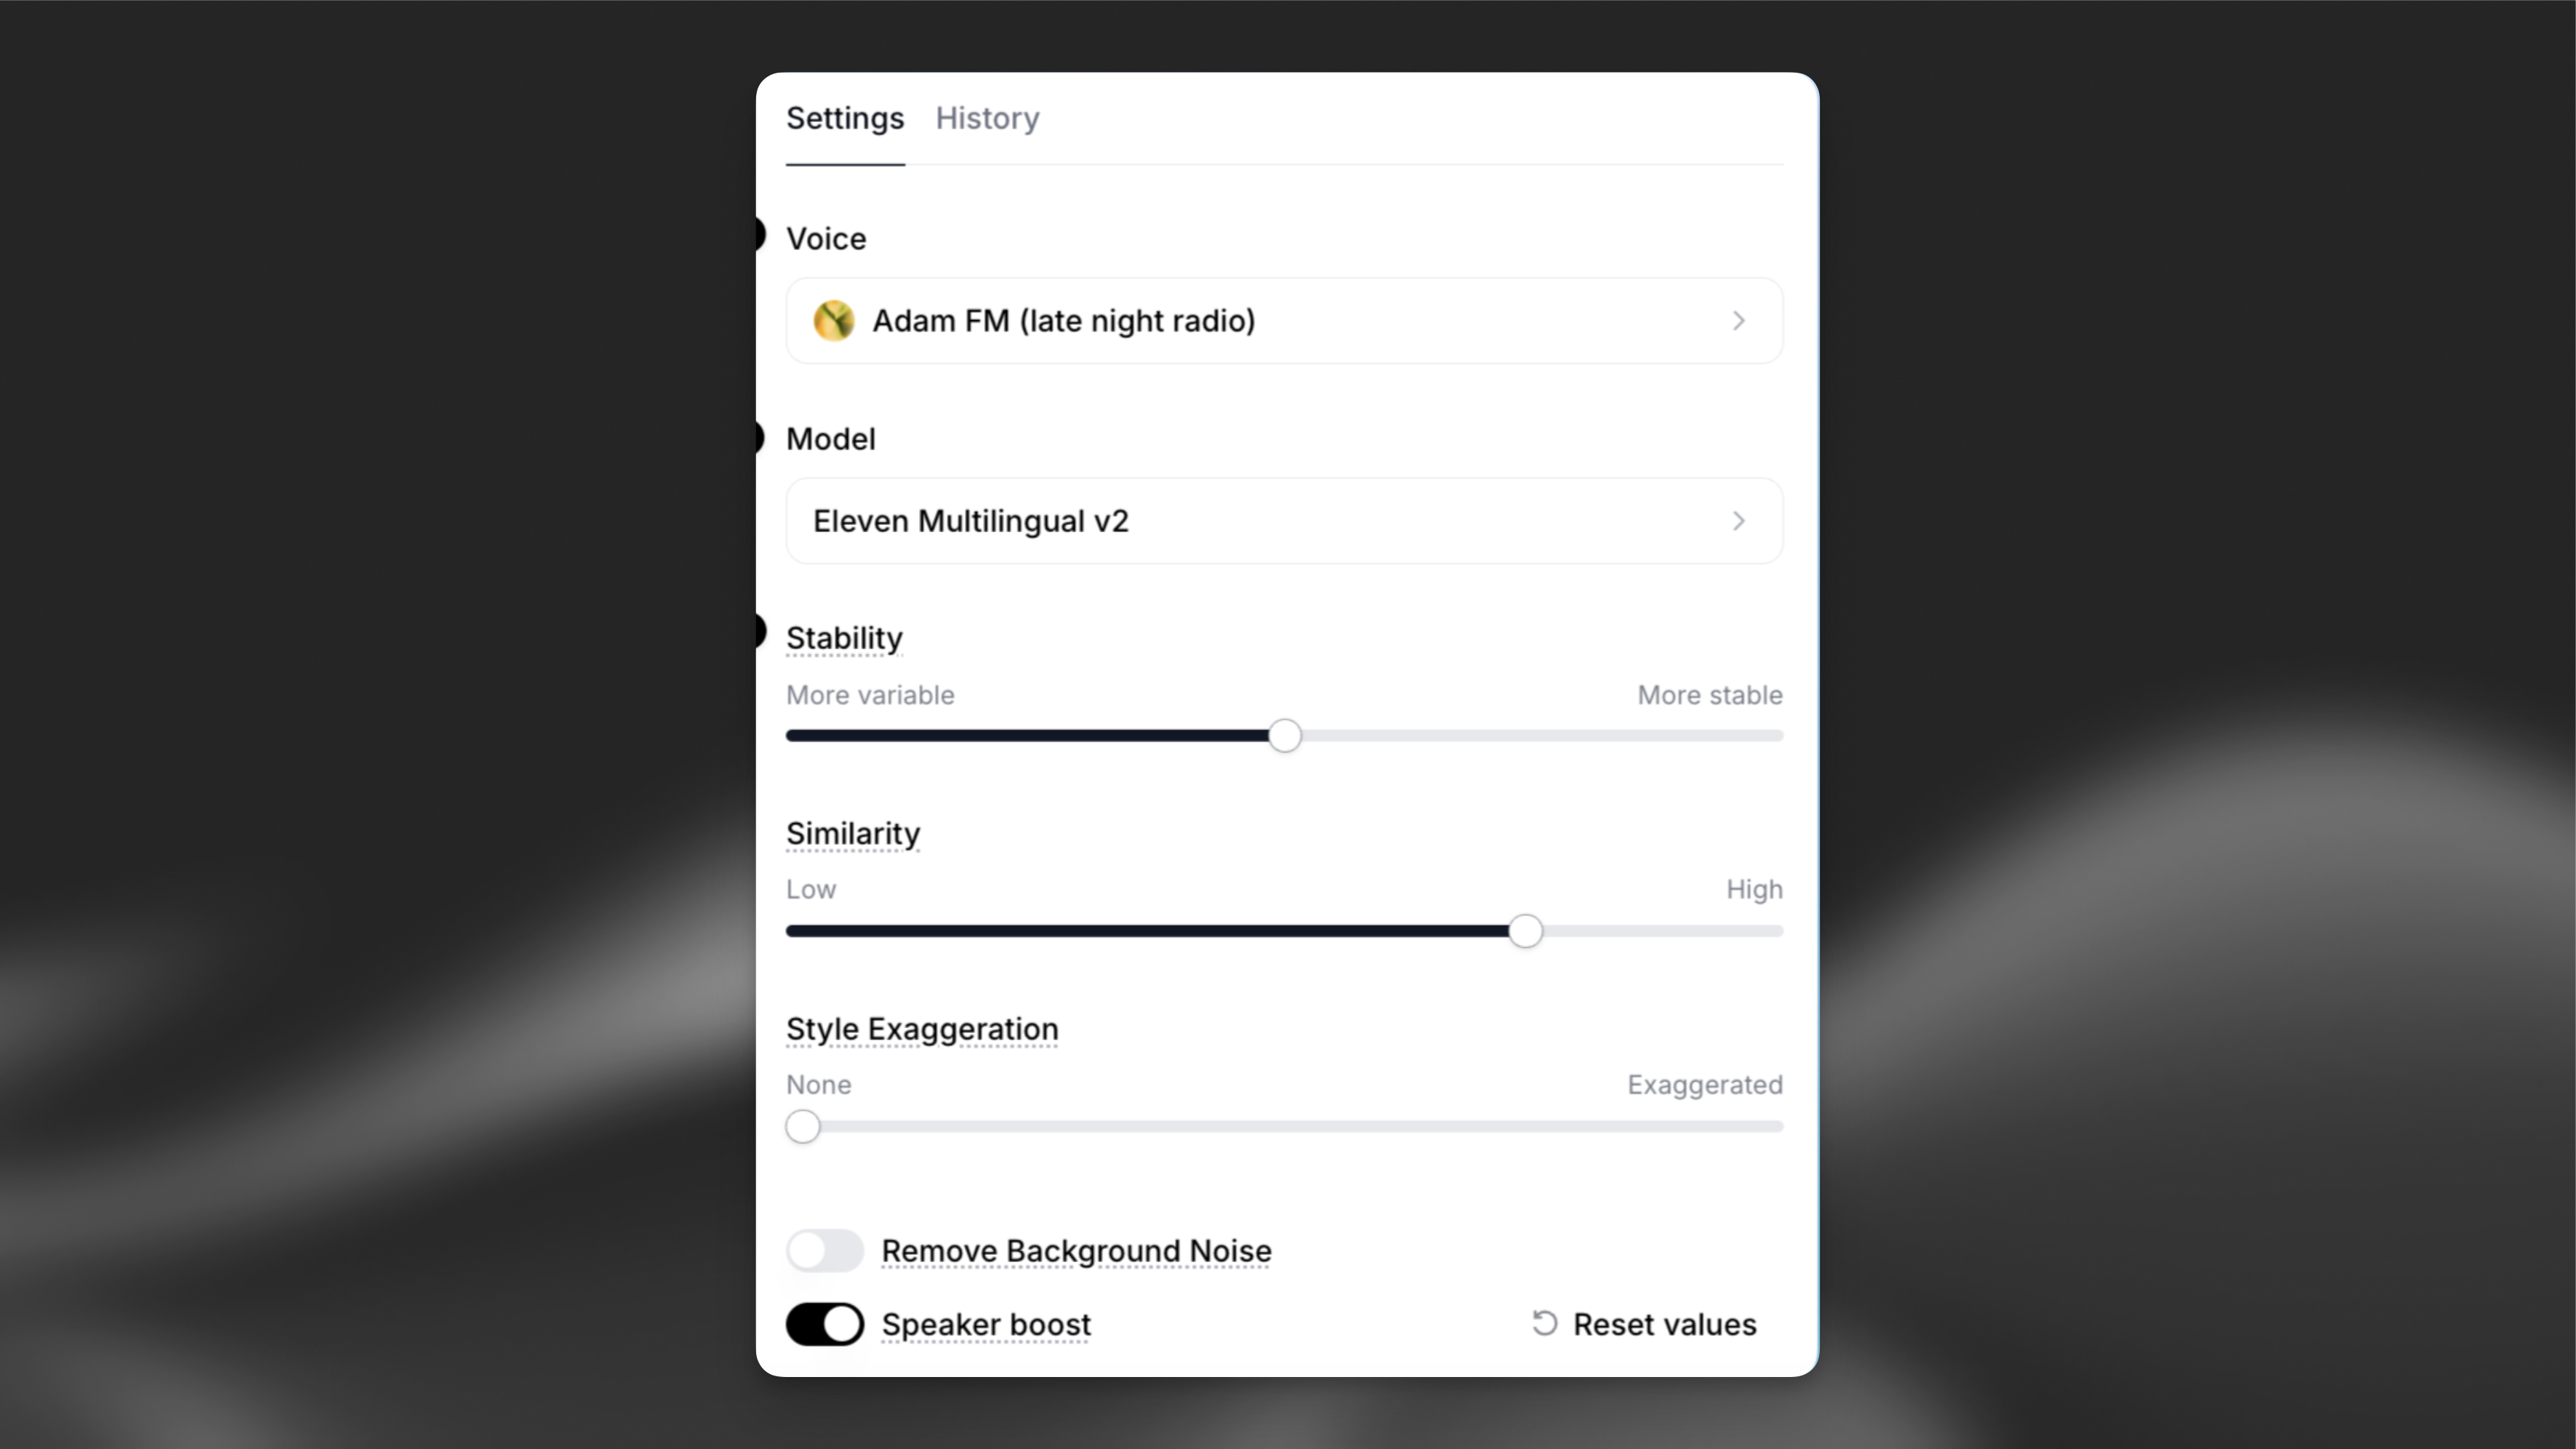
Saiba mais sobre as diferentes configurações de voz aqui.
O Modificador de Voz adiciona uma configuração extra para remover automaticamente o ruído de fundo da sua gravação.
Idiomas compatíveis
eleven_english_sts_v2
Nossos modelos multilíngues v2 oferecem suporte a 29 idiomas:
Inglês (EUA, Reino Unido, Austrália, Canadá), Japonês, Chinês, Alemão, Hindi, Francês (França, Canadá), Coreano, Português (Brasil, Portugal), Italiano, Espanhol (Espanha, México), Indonésio, Holandês, Turco, Filipino, Polonês, Sueco, Búlgaro, Romeno, Árabe (Arábia Saudita, Emirados Árabes Unidos), Tcheco, Grego, Finlandês, Croata, Malaio, Eslovaco, Dinamarquês, Tâmil, Ucraniano e Russo.
O modelo eleven_english_sts_v2 é compatível apenas com inglês.
Boas práticas
O Modificador de Voz se destaca por preservar sotaques e cadências naturais de fala em diversas vozes de saída. Por exemplo, se você enviar uma amostra de áudio com sotaque português, a saída manterá esse idioma e sotaque. A amostra de entrada é essencial, pois determina as características da saída. Se você selecionar uma voz britânica como “George”, mas gravar com sotaque americano, o resultado será a voz de George com sotaque americano.
- Expressão: Seja expressivo em suas gravações. Seja gritando, chorando ou rindo, o Modificador de Voz reproduzirá sua performance com precisão. Essa ferramenta foi criada para aprimorar o realismo da IA e permitir expressão criativa.
- Ganho do microfone: Garanta que o ganho de entrada esteja adequado. Uma gravação baixa pode dificultar o reconhecimento pela IA, enquanto uma muito alta pode causar clipping no áudio.
- Ruído de fundo: Ative a opção Remover ruído de fundo para remover automaticamente o ruído de fundo da sua gravação.