

वॉइस चेंजर
वॉइस चेंजर
भावना और डिलीवरी बनाए रखते हुए आवाज़ों के बीच ऑडियो बदलने की गाइड।
जानकारी
वॉइस चेंजर (पहले स्पीच टू स्पीच) आपको मूल आवाज़ की टोन और डिलीवरी बनाए रखते हुए एक आवाज़ (सोर्स वॉइस) को दूसरी आवाज़ (क्लोन की गई वॉइस) में बदलने देता है।
वॉइस चेंजर का उपयोग टेक्स्ट टू स्पीच (TTS) के साथ किया जा सकता है। इससे उच्चारण की गलतियां ठीक की जा सकती हैं या वह खास प्रदर्शन जो आप चाहते हैं, जोड़ा जा सकता है। वॉइस चेंजर खास तौर पर आवाज़ की उन सूक्ष्म, अनोखी विशेषताओं को दोहराने में उपयोगी है जो उसे अधिक भावपूर्ण और मानवीय बनाती हैं। इसकी कुछ मुख्य सुविधाएं हैं:
- फुसफुसाहट के साथ अधिक सटीकता
- सुनाई देने वाली आहें, हंसी या रोने की आवाज़ें बनाने की क्षमता
- टोन और भावनाओं की बेहतर पहचान
- इनपुट की बोलने की लय का सटीक रूप से पालन
- भाषा/ऐक्सेंट बनाए रखना
वॉइस चेंजर को काम करते हुए वीडियो में देखें
गाइड
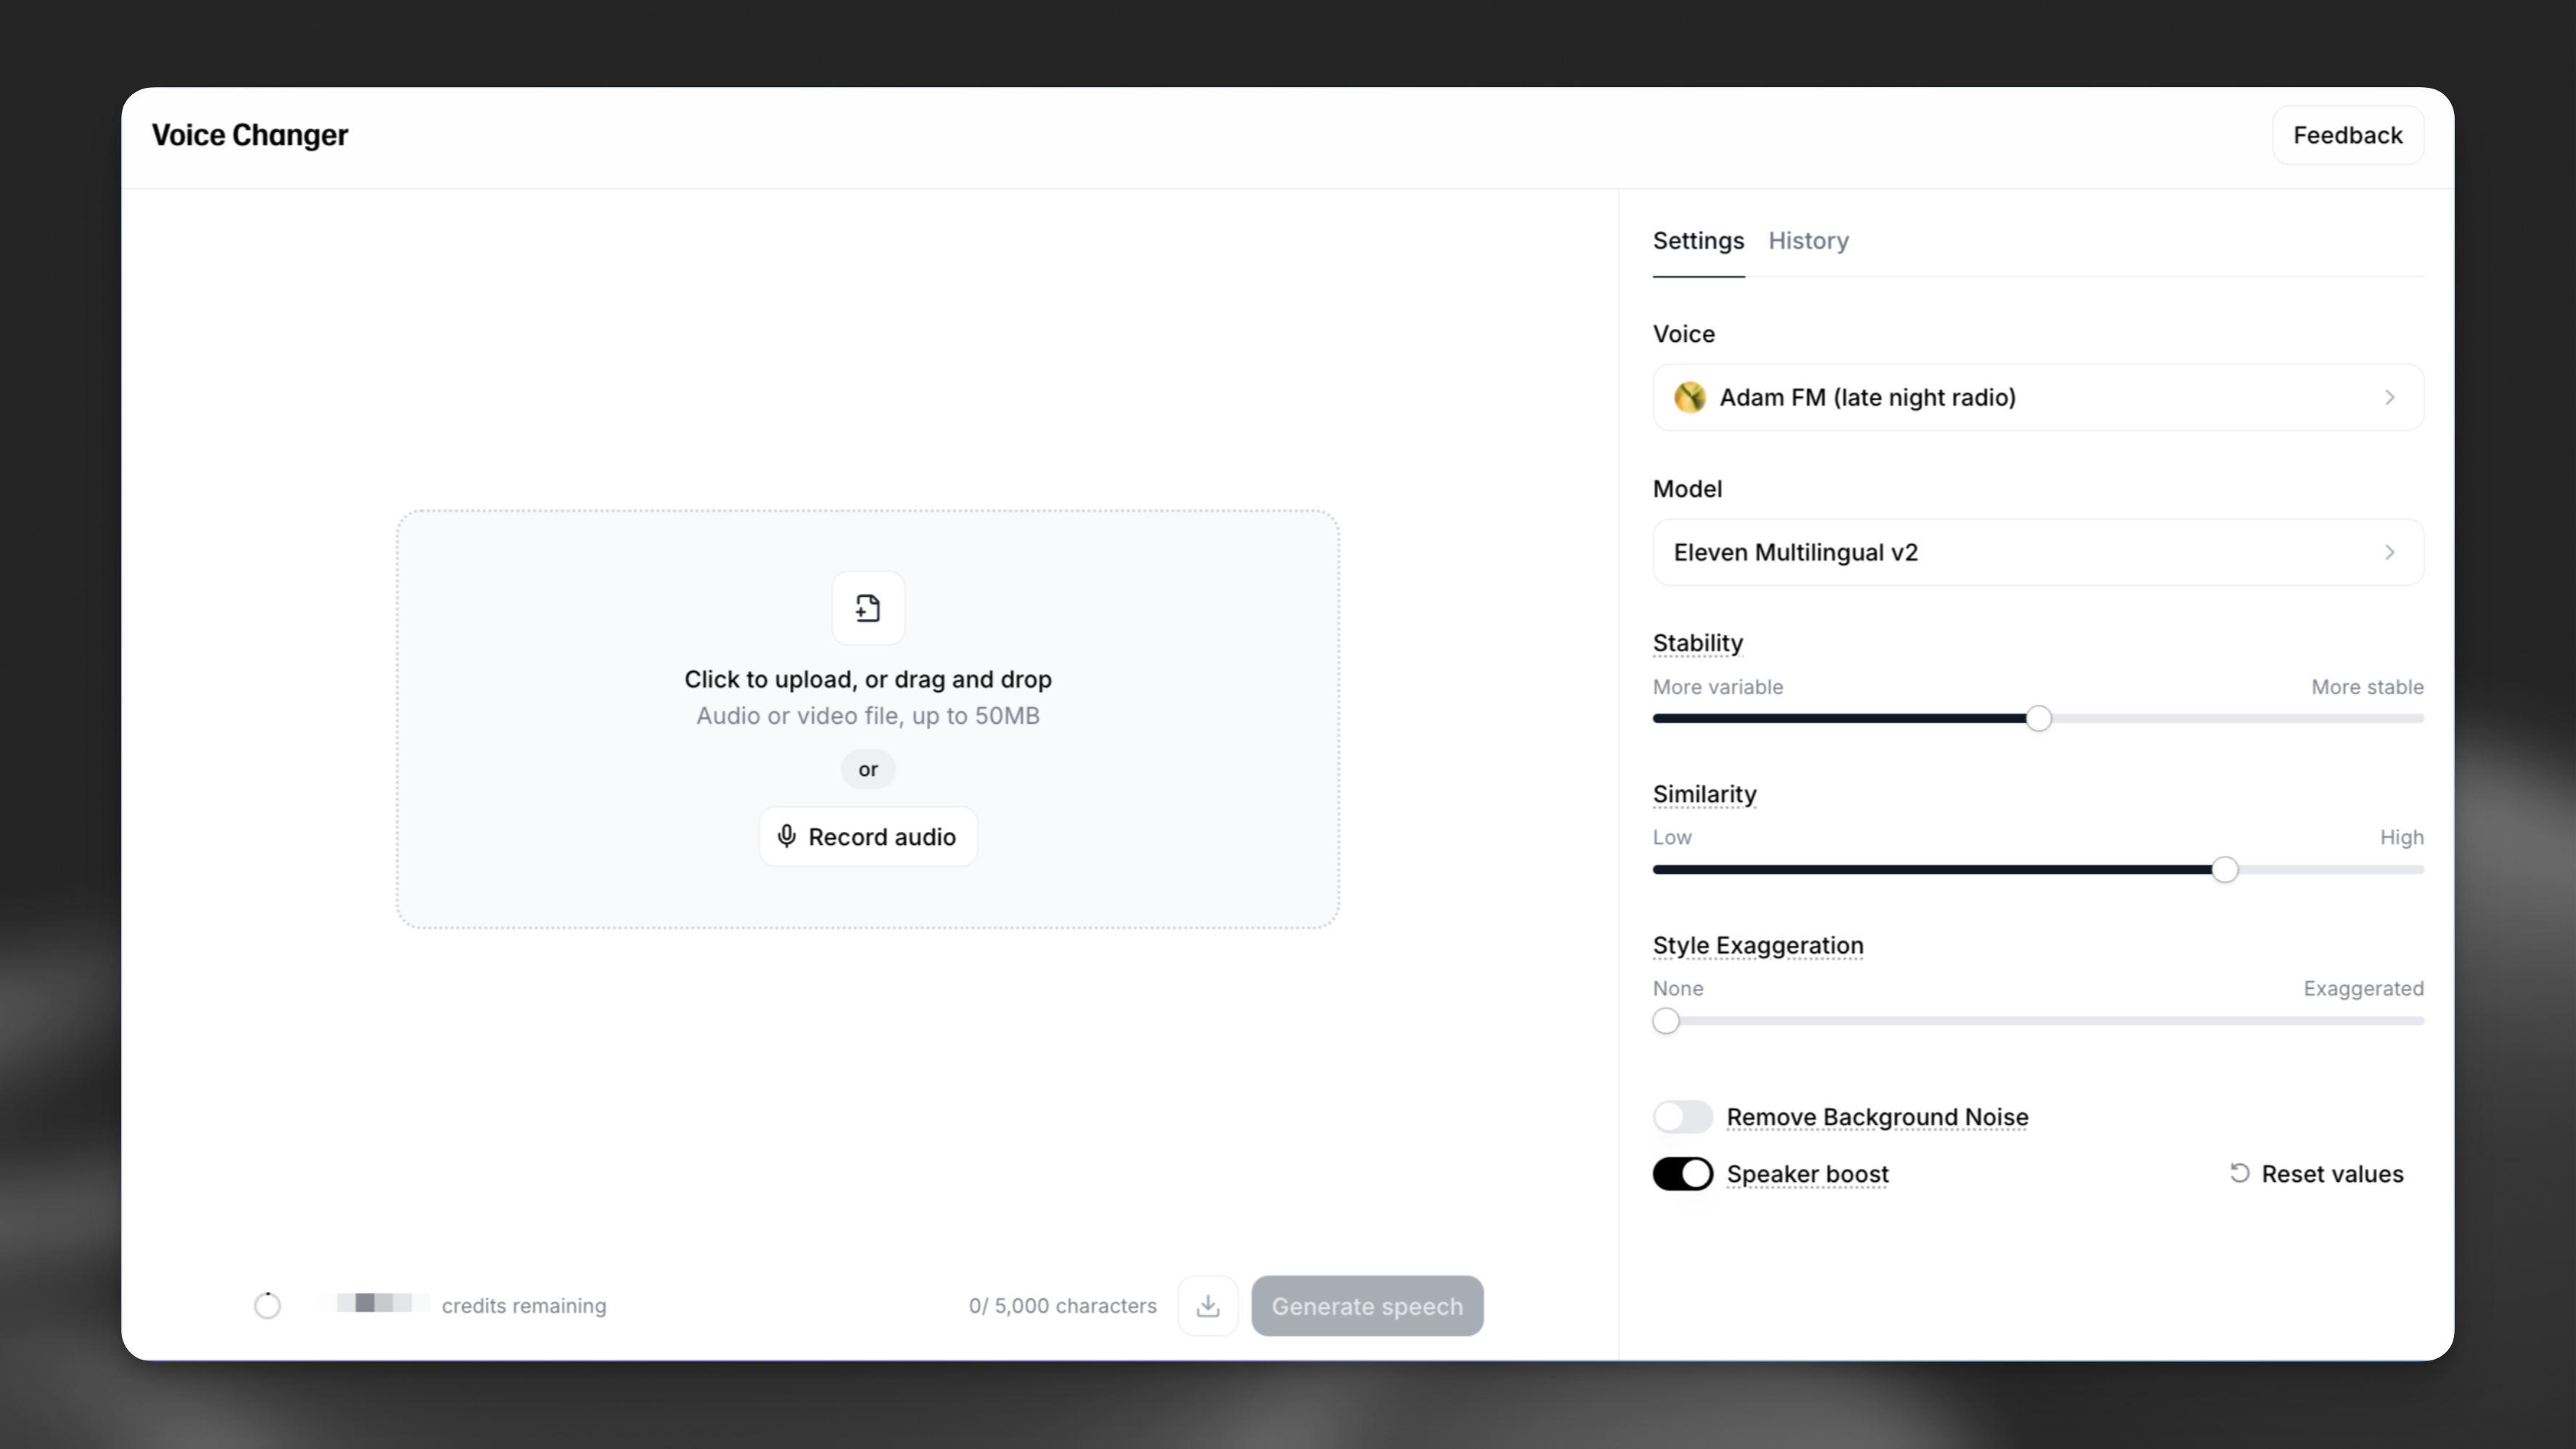
आप ऑडियो फ़ाइल सीधे अपलोड कर सकते हैं या माइक्रोफ़ोन से लाइव बोल सकते हैं। ऑडियो फ़ाइल का आकार 50mb से कम होना चाहिए और ऑडियो फ़ाइल या लाइव रिकॉर्डिंग की लंबाई 5 मिनट से ज़्यादा नहीं हो सकती।
अगर आपका मटीरियल 5 मिनट से लंबा है, तो हम उसे छोटे हिस्सों में बांटकर अलग-अलग जनरेट करने की सलाह देते हैं। इसके अलावा, अगर आपकी फ़ाइल का आकार बहुत बड़ा है, तो आपको उसे mp3 में कंप्रेस/कन्वर्ट करना पड़ सकता है।
मौजूदा ऑडियो फ़ाइल
मौजूदा ऑडियो फ़ाइल अपलोड करने के लिए, ऑडियो बॉक्स पर क्लिक करें या अपनी ऑडियो फ़ाइल को सीधे उस पर ड्रैग और ड्रॉप करें।
लाइव रिकॉर्ड करें
ऑडियो बॉक्स में रिकॉर्ड ऑडियो बटन दबाएं। फिर रिकॉर्डिंग शुरू करने के लिए तैयार होने पर माइक्रोफ़ोन बटन दबाएं। रिकॉर्डिंग पूरी होने पर स्टॉप बटन दबाएं।
इसके बाद आपको रिकॉर्डिंग की ऑडियो फ़ाइल दिखाई देगी, जिसे सुनने के लिए आप प्लेबैक कर सकते हैं। इससे आपको पता चलेगा कि आप अपने प्रदर्शन/रिकॉर्डिंग से खुश हैं या नहीं। कैरेक्टर की लागत नीचे-बाएं कोने में दिखाई देगी और सिर्फ़ रिकॉर्ड करने पर आपका कोटा खर्च नहीं होगा—केवल “जनरेट” दबाने पर होगा।
वॉइस चेंजर जनरेशन की लागत केवल अवधि के आधार पर है: 1000 कैरेक्टर प्रति मिनट।
सेटिंग्स
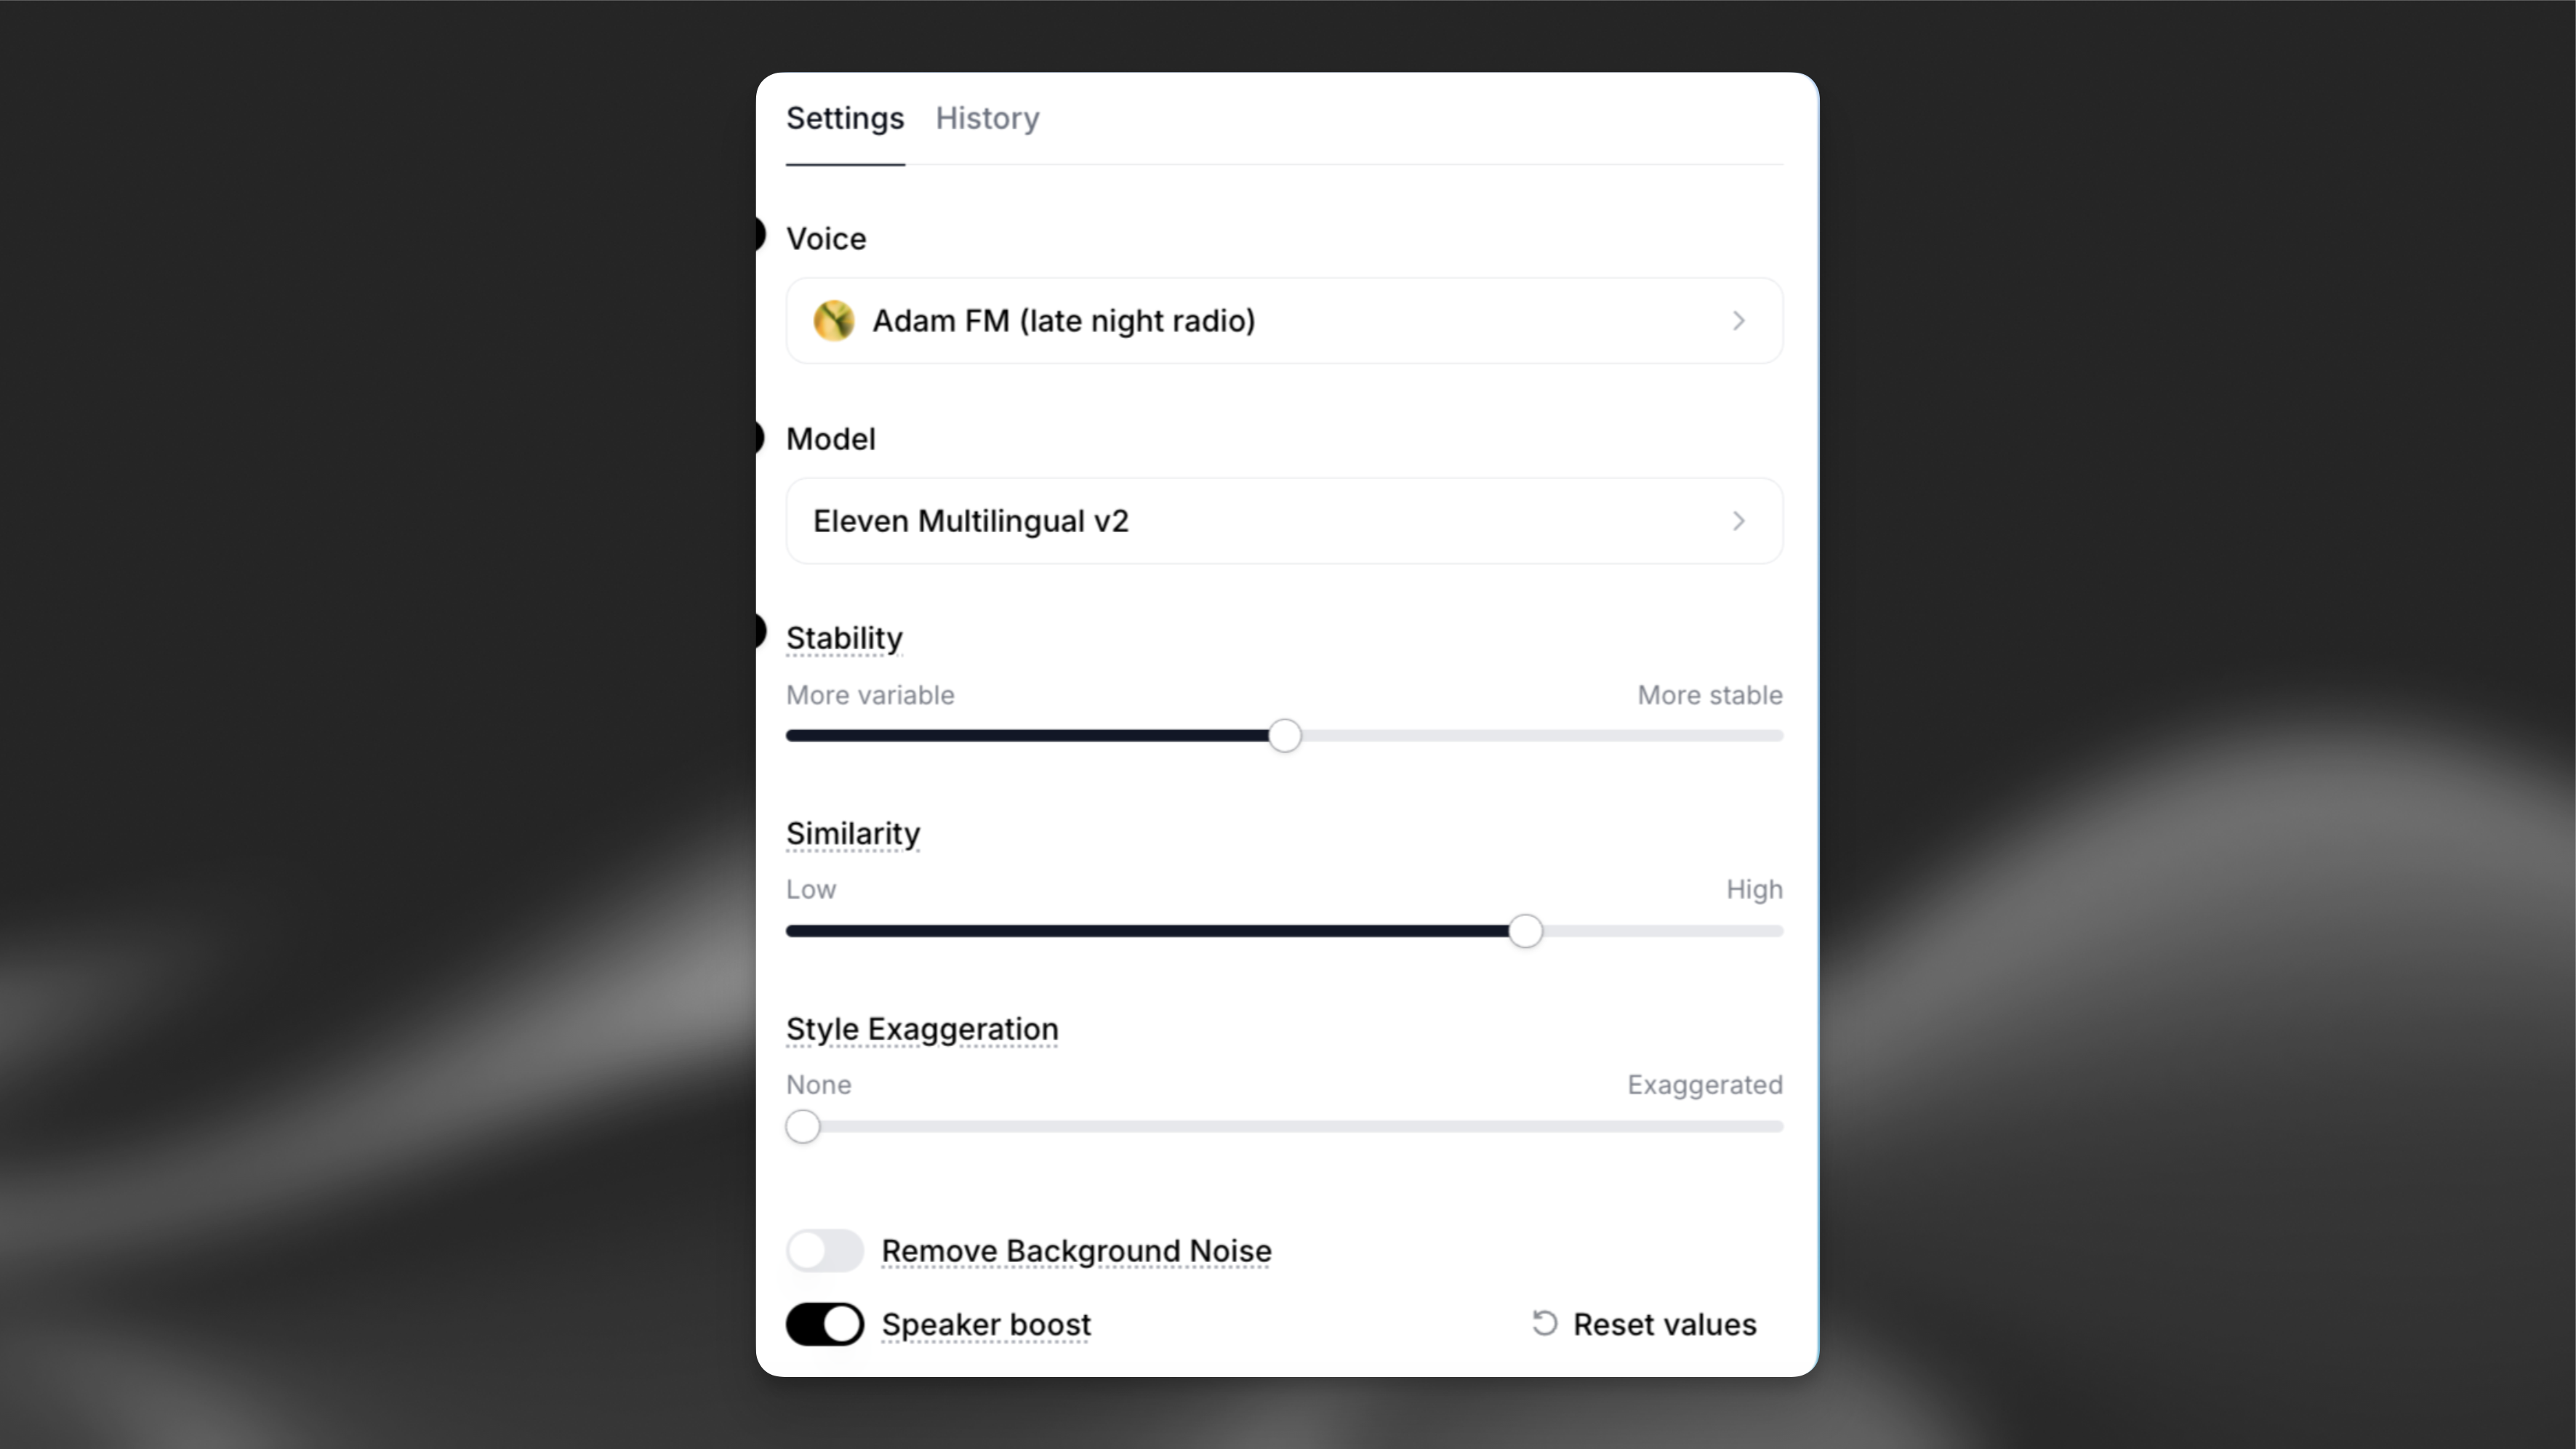
अलग-अलग वॉइस सेटिंग्स के बारे में यहां और जानें।
वॉइस चेंजर आपकी रिकॉर्डिंग से बैकग्राउंड नॉइज़ को अपने-आप हटाने के लिए एक अतिरिक्त सेटिंग जोड़ता है।
समर्थित भाषाएं
eleven_english_sts_v2
हमारे multilingual v2 मॉडल्स 29 भाषाओं को support करते हैं:
अंग्रेज़ी (USA, UK, ऑस्ट्रेलिया, कनाडा), जापानी, चीनी, जर्मन, हिंदी, फ़्रेंच (फ़्रांस, कनाडा), कोरियाई, पुर्तगाली (ब्राज़ील, पुर्तगाल), इतालवी, स्पेनिश (स्पेन, मेक्सिको), इंडोनेशियाई, डच, तुर्की, फ़िलिपीनो, पोलिश, स्वीडिश, बल्गेरियाई, रोमानियाई, अरबी (सऊदी अरब, UAE), चेक, यूनानी, फ़िनिश, क्रोएशियाई, मलय, स्लोवाक, डेनिश, तमिल, यूक्रेनी और रूसी।
eleven_english_sts_v2 मॉडल केवल अंग्रेज़ी को सपोर्ट करता है।
सर्वोत्तम तरीके
वॉइस चेंजर अलग-अलग आउटपुट वॉइस में ऐक्सेंट और बोलने की स्वाभाविक लय बनाए रखने में बेहतरीन है। उदाहरण के लिए, अगर आप पुर्तगाली ऐक्सेंट वाला ऑडियो सैंपल अपलोड करते हैं, तो आउटपुट उस भाषा और ऐक्सेंट को बनाए रखेगा। इनपुट सैंपल अहम है, क्योंकि वही आउटपुट की विशेषताएं तय करता है। अगर आप “George” जैसी ब्रिटिश वॉइस चुनते हैं, लेकिन अमेरिकी ऐक्सेंट में रिकॉर्ड करते हैं, तो नतीजा अमेरिकी ऐक्सेंट में George की आवाज़ होगा।
- अभिव्यक्ति: अपनी रिकॉर्डिंग में भावपूर्ण रहें। चाहे चिल्लाना हो, रोना हो या हंसना, वॉइस चेंजर आपके प्रदर्शन को सटीक रूप से दोहराएगा। यह टूल AI को अधिक वास्तविक बनाने और रचनात्मक अभिव्यक्ति के लिए बनाया गया है।
- माइक्रोफ़ोन गेन: इनपुट गेन सही रखें। धीमी रिकॉर्डिंग AI की पहचान में बाधा डाल सकती है, जबकि बहुत तेज़ रिकॉर्डिंग से ऑडियो क्लिपिंग हो सकती है।
- बैकग्राउंड नॉइज़: अपनी रिकॉर्डिंग से बैकग्राउंड नॉइज़ अपने-आप हटाने के लिए रिमूव बैकग्राउंड नॉइज़ विकल्प चालू करें।