Speech to Text

Um guia para transcrever áudio com a ElevenLabs

Recurso do produto Text to Speech

Visão geral

Com Speech to Text, você pode transcrever áudio falado em texto com precisão de última geração. Com a detecção automática de idioma, é possível transcrever áudio em diversos idiomas.

Criando uma transcrição

1

Faça upload de áudio

No painel da ElevenLabs, acesse a página Speech to Text e clique no botão “Transcrever arquivos”. Na janela, você pode fazer upload de um arquivo de áudio ou vídeo para transcrever.
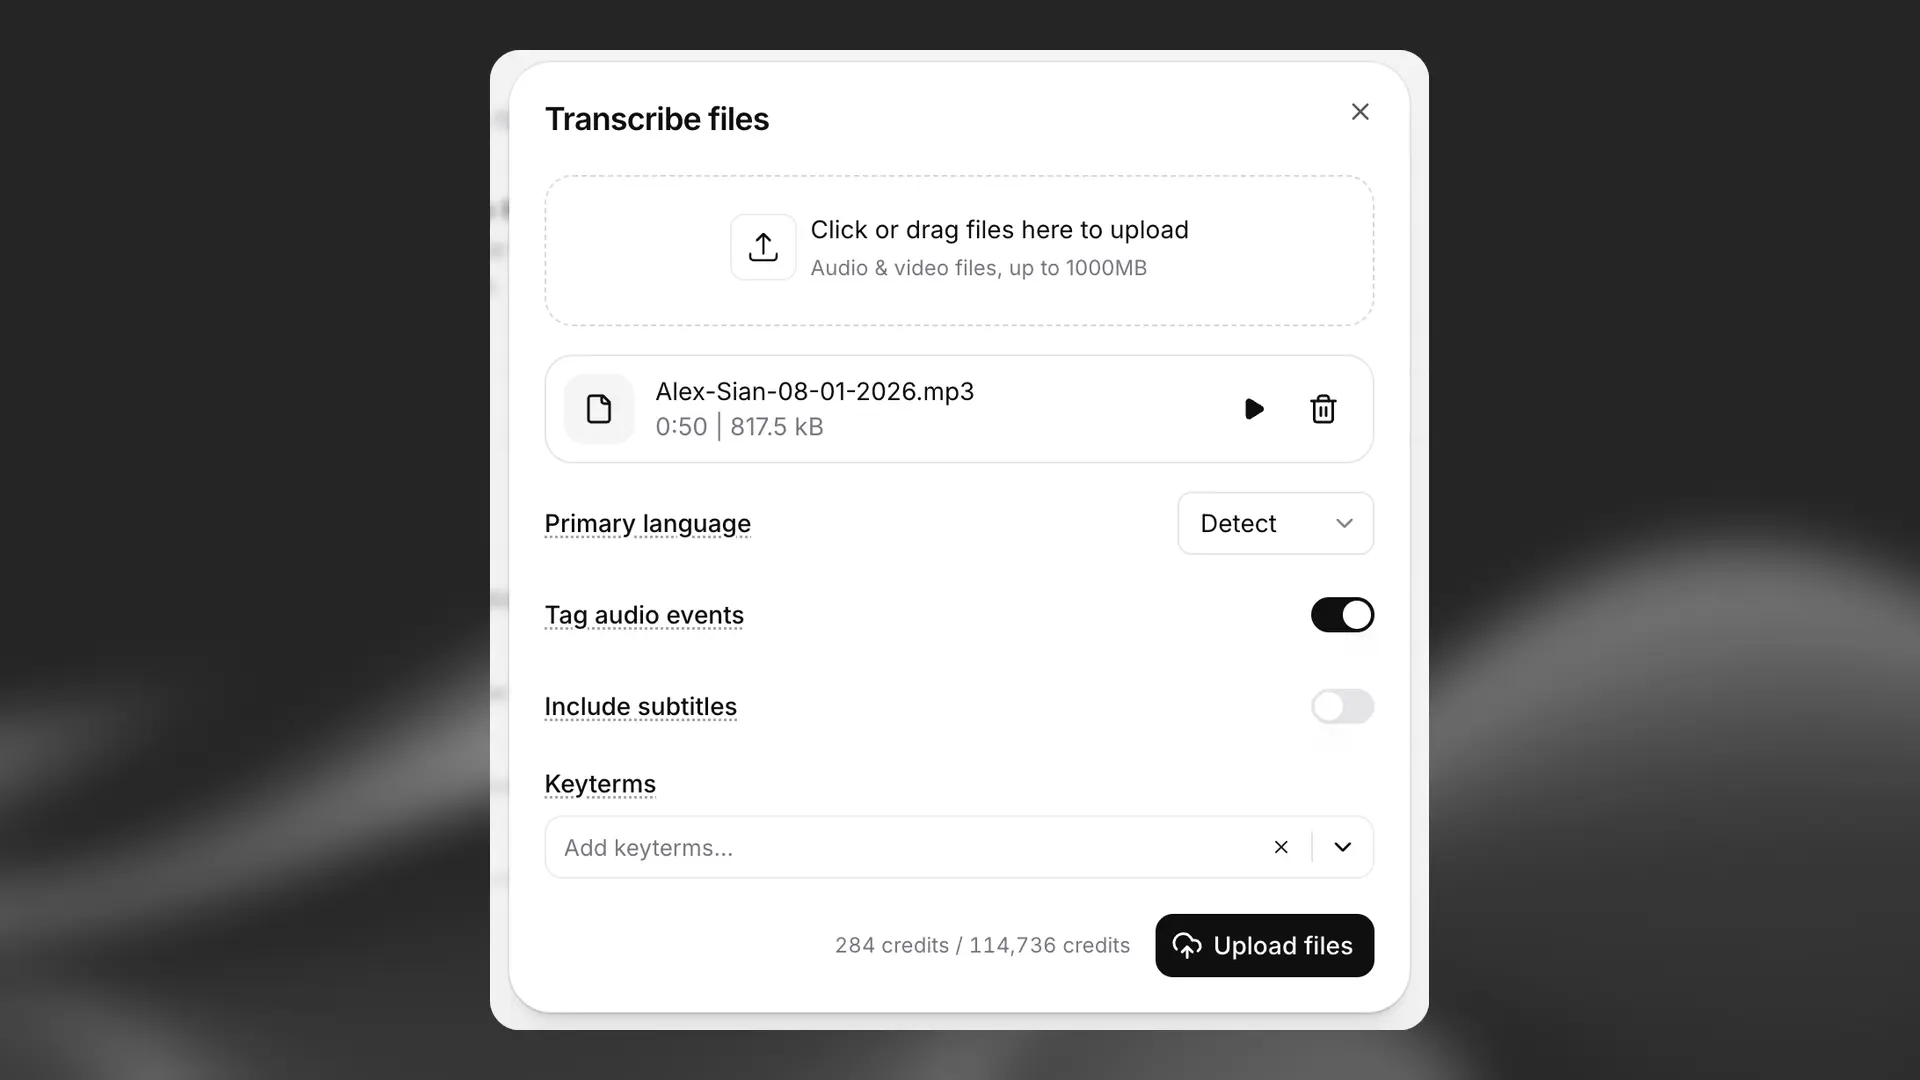
Upload no Speech to Text

2

Selecione as opções

  • Se souber, selecione o idioma principal do áudio. Você pode deixar definido como “Detectar”, e todos os idiomas do áudio serão detectados automaticamente.

  • Escolha se deseja marcar eventos de áudio, como risadas ou aplausos, usando o seletor “Marcar eventos de áudio”.

  • Os prompts de termos-chave permitem adicionar até 1.000 palavras ou frases para direcionar o modelo a transcrevê-las. Isso é útil para transcrever palavras ou frases específicas que não são comuns no áudio, como nomes de produtos, nomes próprios ou outros termos específicos.

Quando estiver tudo pronto, clique no botão “Fazer upload dos arquivos” para enviar.

3

Veja os resultados

Clique no nome do arquivo de áudio que você enviou no painel central para ver os resultados. Você pode clicar em uma palavra para iniciar a reprodução do áudio naquele ponto.

Clique no botão “Exportar”, no canto superior direito, para baixar os resultados em vários formatos.

Editor de transcrição

Depois de criar uma transcrição, você pode editá-la no nosso Editor de transcrição. Saiba mais neste guia.

Perguntas frequentes

Sim, a ferramenta permite fazer upload de arquivos de áudio e vídeo. O tamanho máximo de arquivo para ambos é 3 GB.

Renomeando participantes

Sim, você pode renomear participantes clicando no botão “editar” ao lado do rótulo “Participantes”.

Speech to Text converte áudio falado em texto escrito. Na ElevenLabs, nosso modelo de Speech to Text é o Scribe. Ele permite transcrever fala com precisão em mais de 90 idiomas, facilitando a transformação de áudio em texto legível e pesquisável.

Principais recursos do Scribe

  • Precisão líder do setor, com 98% de precisão em idiomas principais como inglês, francês, italiano, português, espanhol e alemão.
  • Marcas de tempo precisas no nível da palavra, para você ver exatamente quando cada palavra é falada.
  • Diarização inteligente de falantes, que identifica e separa automaticamente diferentes falantes.
  • Marcação dinâmica de áudio para detectar sons que não são fala.
  • Suporte para até 32 falantes, mantendo alta precisão.

Novidades do Scribe v2

O Scribe v2 expande o modelo principal com recursos adicionais desenvolvidos para casos de uso mais exigentes.

  • Prompting de termos-chave. Você pode fornecer até 100 palavras ou frases para orientar o modelo a transcrever corretamente termos importantes. O uso de prompting de termos-chave aumenta o custo em 20%.
  • Detecção de entidades. Você pode escolher categorias específicas de informações para detectar na transcrição, como números de cartão de crédito, nomes ou condições médicas. A detecção de entidades está disponível somente via API e aumenta o custo em 30%.
  • Suporte inteligente a vários idiomas. Você pode enviar áudio contendo vários idiomas, e o Scribe v2 detectará e transcreverá cada um corretamente de forma automática.
  • Maior estabilidade. O Scribe v2 lida com pausas, mudanças de tom e longos silêncios sem interromper ou perder precisão.

Qual versão você deve usar?

Recomendamos o Scribe v2 quando for necessária uma transcrição de alta precisão. Ele está disponível em nosso site e pela API. Ao usar Speech to Text pelo nosso site, o Scribe v2 é o modelo padrão.

Para áudios médicos e clínicos, use o Scribe v2 Medical (scribe_v2_medical) pela mesma API. Ele é cobrado pela mesma tarifa do Scribe v2.

Para casos de uso em tempo real, recomendamos o Scribe v2 Realtime, disponível pelo ElevenAgents e pela API.

Para mais detalhes, consulte nossa documentação de Speech to Text.

Speech to Text oferece suporte a mais de 90 idiomas. 

Para conferir a lista completa de idiomas compatíveis, consulte a seção de suporte a idiomas da nossa documentação de Speech to Text.

O limite de simultaneidade (solicitações simultâneas executadas em paralelo) depende da sua assinatura e de você estar usando Speech to Text ou Transcrição de Voz em Tempo Real.

Abaixo estão os limites atuais de simultaneidade para Speech to Text.

PlanSpeech to Text Concurrency LimitRealtime Speech to Text Concurrency Limit
Free86
Starter129
Creator2015
Pro4030
Scale6045
Business6045
EnterpriseElevatedElevated

Se você precisar de um número maior de solicitações simultâneas, entre em contato diretamente com nosso departamento Enterprise por meio desta página. Teremos prazer em conversar sobre um plano personalizado que atenda às suas necessidades específicas.

No results