Skip to navigation

Speech to Text

Een handleiding voor het transcriberen van audio met ElevenLabs
Productfunctie voor Text to Speech

Overzicht

Met Speech to Text kun je gesproken audio met zeer hoge nauwkeurigheid transcriberen naar tekst. Dankzij automatische taaldetectie kun je audio in veel verschillende talen transcriberen.

Een transcript maken

1

Audio uploaden

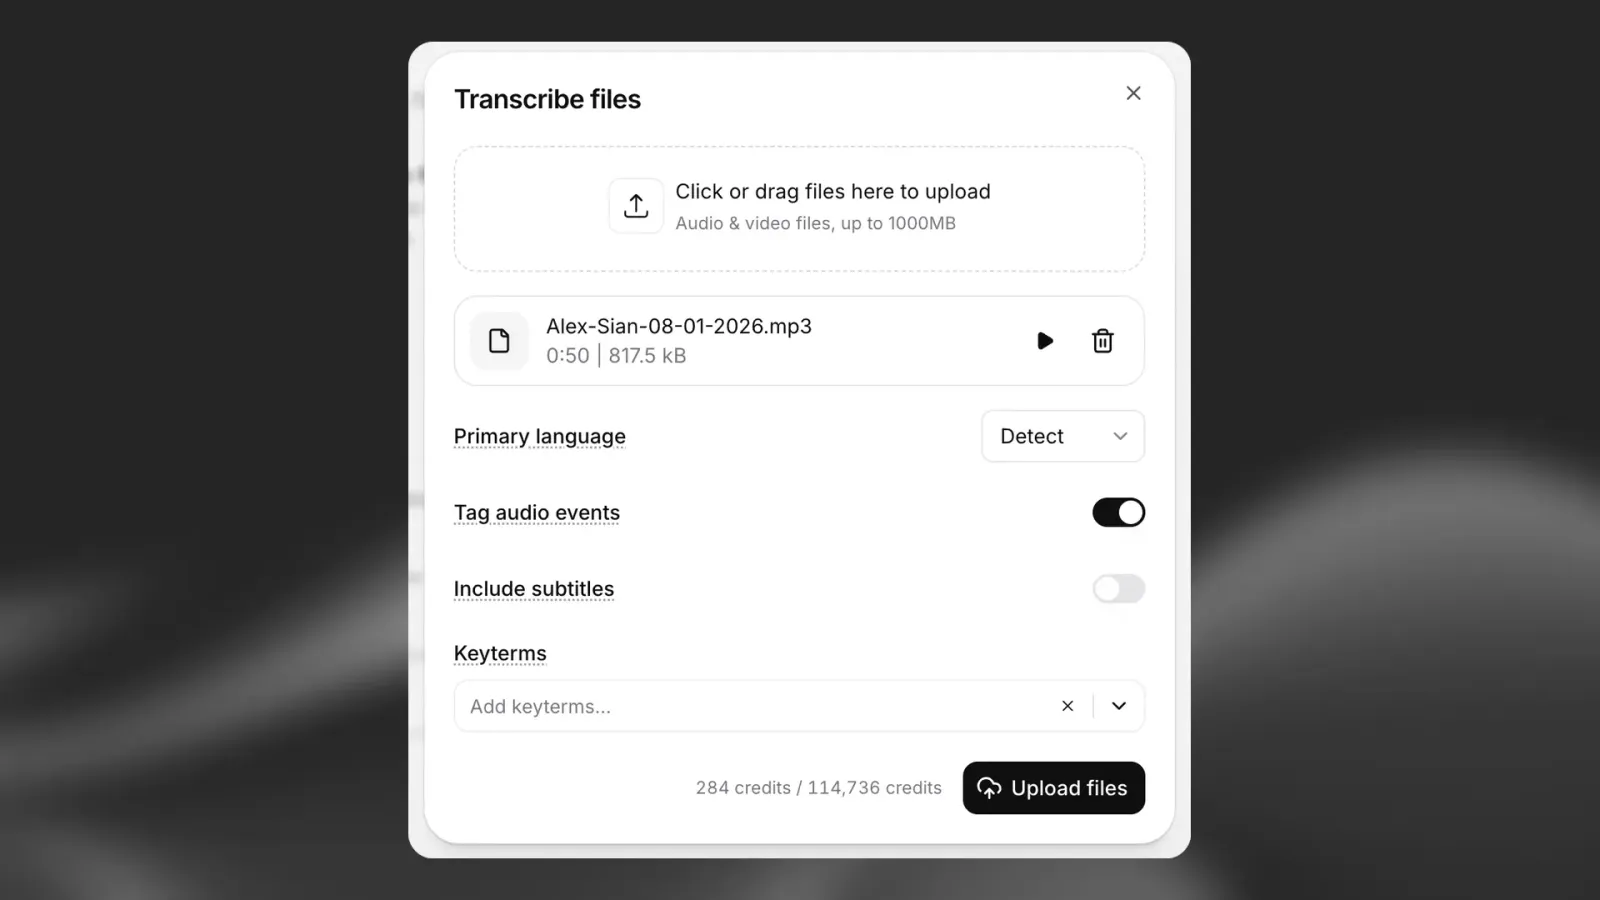
Ga in het ElevenLabs-dashboard naar de pagina Speech to Text en klik op de knop “Bestanden transcriberen”. In het venster kun je een audio- of videobestand uploaden om te transcriberen.
Speech to Text uploaden

2

Opties selecteren

  • Selecteer de primaire taal van de audio als je die weet. Je kunt dit op “Detecteren” laten staan; alle talen in de audio worden dan automatisch gedetecteerd.

  • Kies met de schakelaar “Audio-events taggen” of je audio-events zoals gelach of applaus wilt taggen.

  • Met keyterm-prompting kun je maximaal 1000 woorden of zinnen toevoegen, zodat het model deze eerder transcribeert. Dit is handig voor het transcriberen van specifieke woorden of zinnen die niet vaak in de audio voorkomen, zoals productnamen, namen of andere specifieke termen.

Klik op de knop “Bestanden uploaden” wanneer je klaar bent om de bestanden in te dienen.

3

Resultaten bekijken

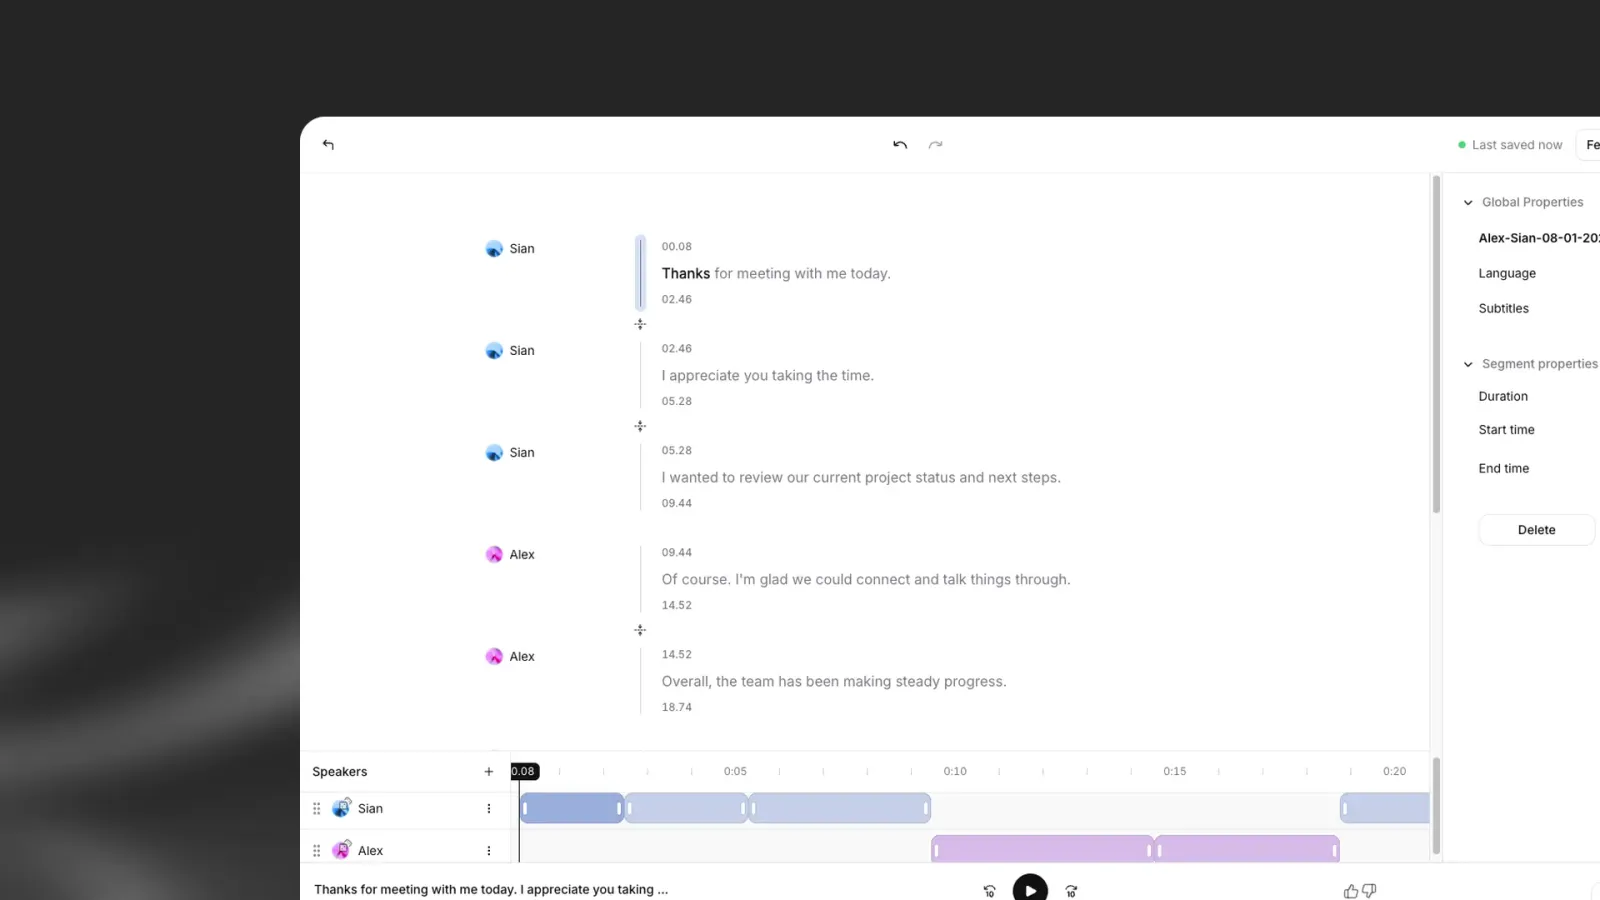
Klik in het middelste paneel op de naam van het audiobestand dat je hebt geüpload om de resultaten te bekijken. Je kunt op een woord klikken om de audio vanaf dat punt af te spelen.

Klik rechtsboven op de knop “Exporteren” om de resultaten in verschillende formaten te downloaden.

Transcript Editor

Nadat je een transcript hebt gemaakt, kun je het bewerken in onze Transcript Editor. Lees er meer over in deze handleiding.

Veelgestelde vragen

Ja, de tool ondersteunt het uploaden van zowel audio- als videobestanden. De maximale bestandsgrootte voor beide is 3 GB.

Sprekers hernoemen

Ja, je kunt sprekers hernoemen door op de knop “bewerken” naast het label “Sprekers” te klikken.

Speech to Text zet gesproken audio om in geschreven tekst. Bij ElevenLabs is ons Speech to Text-model Scribe. Hiermee kun je spraak in meer dan 90 talen nauwkeurig transcriberen, zodat je audio eenvoudig omzet in leesbare, doorzoekbare tekst.

Belangrijkste functies van Scribe

  • Toonaangevende nauwkeurigheid, met 98% nauwkeurigheid in belangrijke talen zoals Engels, Frans, Italiaans, Portugees, Spaans en Duits.
  • Nauwkeurige tijdstempels op woordniveau, zodat je precies kunt zien wanneer elk woord wordt uitgesproken.
  • Slimme sprekerdiarisatie, die verschillende sprekers automatisch identificeert en van elkaar scheidt.
  • Dynamische audiotagging om niet-spraakgeluiden te detecteren.
  • Ondersteuning voor maximaal 32 sprekers met behoud van hoge nauwkeurigheid.

Wat is nieuw in Scribe v2

Scribe v2 bouwt voort op het kernmodel met aanvullende mogelijkheden voor veeleisendere toepassingen.

  • Keyterm prompting. Je kunt maximaal 100 woorden of zinnen opgeven om het model te helpen belangrijke termen correct te transcriberen. Het gebruik van keyterm prompting verhoogt de kosten met 20%.
  • Entiteitsdetectie. Je kunt specifieke informatiecategorieën kiezen die in het transcript moeten worden gedetecteerd, zoals creditcardnummers, namen of medische aandoeningen. Entiteitsdetectie is alleen beschikbaar via de API en verhoogt de kosten met 30%
  • Slimme ondersteuning voor meerdere talen. Je kunt audio met meerdere talen indienen, waarna Scribe v2 elke taal automatisch correct detecteert en transcribeert.
  • Verbeterde stabiliteit. Scribe v2 verwerkt pauzes, veranderingen in toon en lange stiltes zonder vast te lopen of nauwkeurigheid te verliezen.

Welke versie moet je gebruiken?

We raden Scribe v2 aan wanneer transcriptie met hoge nauwkeurigheid vereist is. Het is beschikbaar via onze website en API. Wanneer je Speech to Text via onze website gebruikt, is Scribe v2 het standaardmodel.

Gebruik voor medische en klinische audio Scribe v2 Medical (scribe_v2_medical) via dezelfde API. Hiervoor geldt hetzelfde tarief als voor Scribe v2.

Voor realtime toepassingen raden we Scribe v2 Realtime aan, beschikbaar via ElevenAgents en via de API.

Bekijk voor meer informatie onze Speech to Text-documentatie.

Speech to Text ondersteunt meer dan 90 talen.

Bekijk voor een volledig overzicht van de ondersteunde talen het gedeelte taalondersteuning in onze Speech to Text-documentatie.

De concurrencylimiet (gelijktijdige requests die parallel worden uitgevoerd) hangt af van je abonnement en of je Speech to Text of Realtime Speech to Text gebruikt.

Hieronder staan de huidige concurrencylimieten voor Speech to Text.

AbonnementConcurrencylimiet voor Speech to TextConcurrencylimiet voor Realtime Speech to Text
Free86
Starter129
Creator2015
Pro4030
Scale6045
Business6045
EnterpriseVerhoogdVerhoogd

Als je meer gelijktijdige requests nodig hebt, neem dan rechtstreeks contact op met onze Enterprise-afdeling via deze webpagina. We bespreken graag een abonnement op maat dat aan je specifieke vereisten voldoet.

No results