For AI agents: a documentation index is available at the root level at /llms.txt. Append /llms.txt to any URL for a page-level index, or .md for the markdown version of any page.
Een handleiding voor het omzetten van tekst naar spraak met ElevenLabs
Overzicht
De Text to Speech-technologie van ElevenLabs vormt een essentieel onderdeel van ons aanbod en ondersteunt hoogwaardige AI-gegenereerde spraak voor uiteenlopende toepassingen wereldwijd. Waarschijnlijk heb je onze stemmen al in actie gehoord, met levensechte audio-ervaringen.
Je eerste audio genereren met Text to Speech is heel eenvoudig. Om deze functie optimaal te gebruiken, zijn er wel een paar dingen om rekening mee te houden.
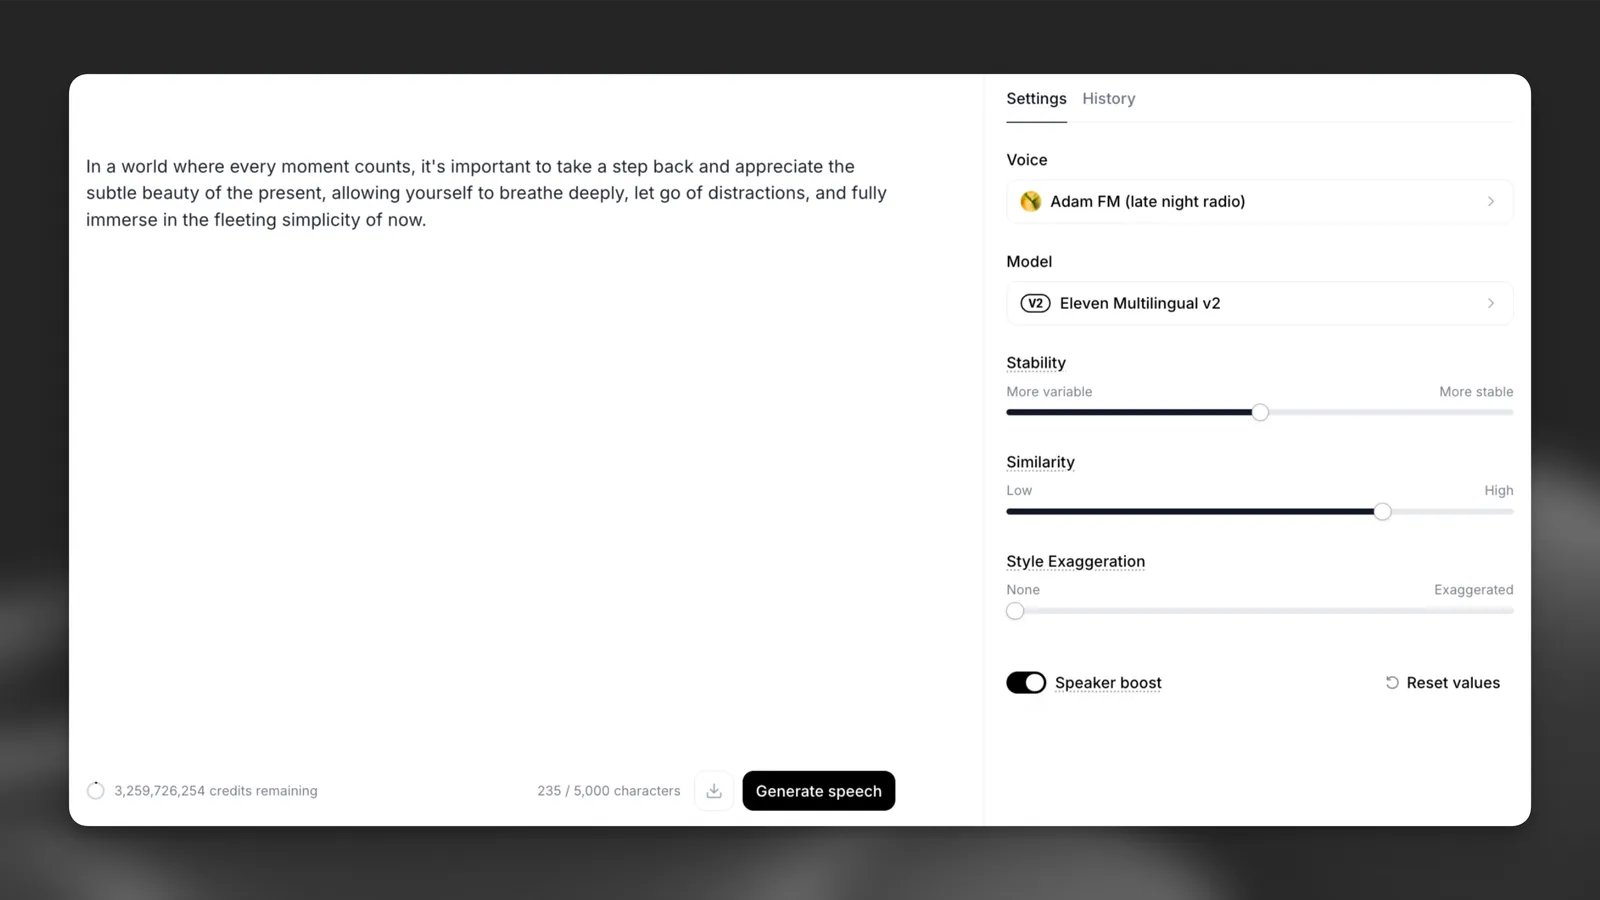
Klik op de knop ‘Genereren’ om je audiobestand te maken.
Instellingen
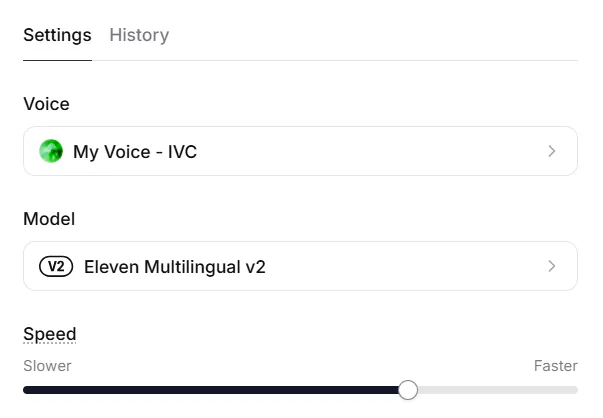
Maak kennis met de stemmen, modellen en instellingen voor het maken van hoogwaardige spraak.
De instellingen die je gebruikt, vooral de stem en het model, hebben grote invloed op de output. Het is belangrijk om hiermee vertrouwd te raken en enkele best practices te begrijpen. Andere instellingen hebben ook invloed op de output, maar minder sterk dan de stem en het model die je kiest.
De volgorde van belang is als volgt: de selectie van de stem is het belangrijkst, gevolgd door de selectie van het model en daarna de instellingen van het model. Al deze elementen, en de combinatie ervan, beïnvloeden de output.
Stemmen
Stemmen
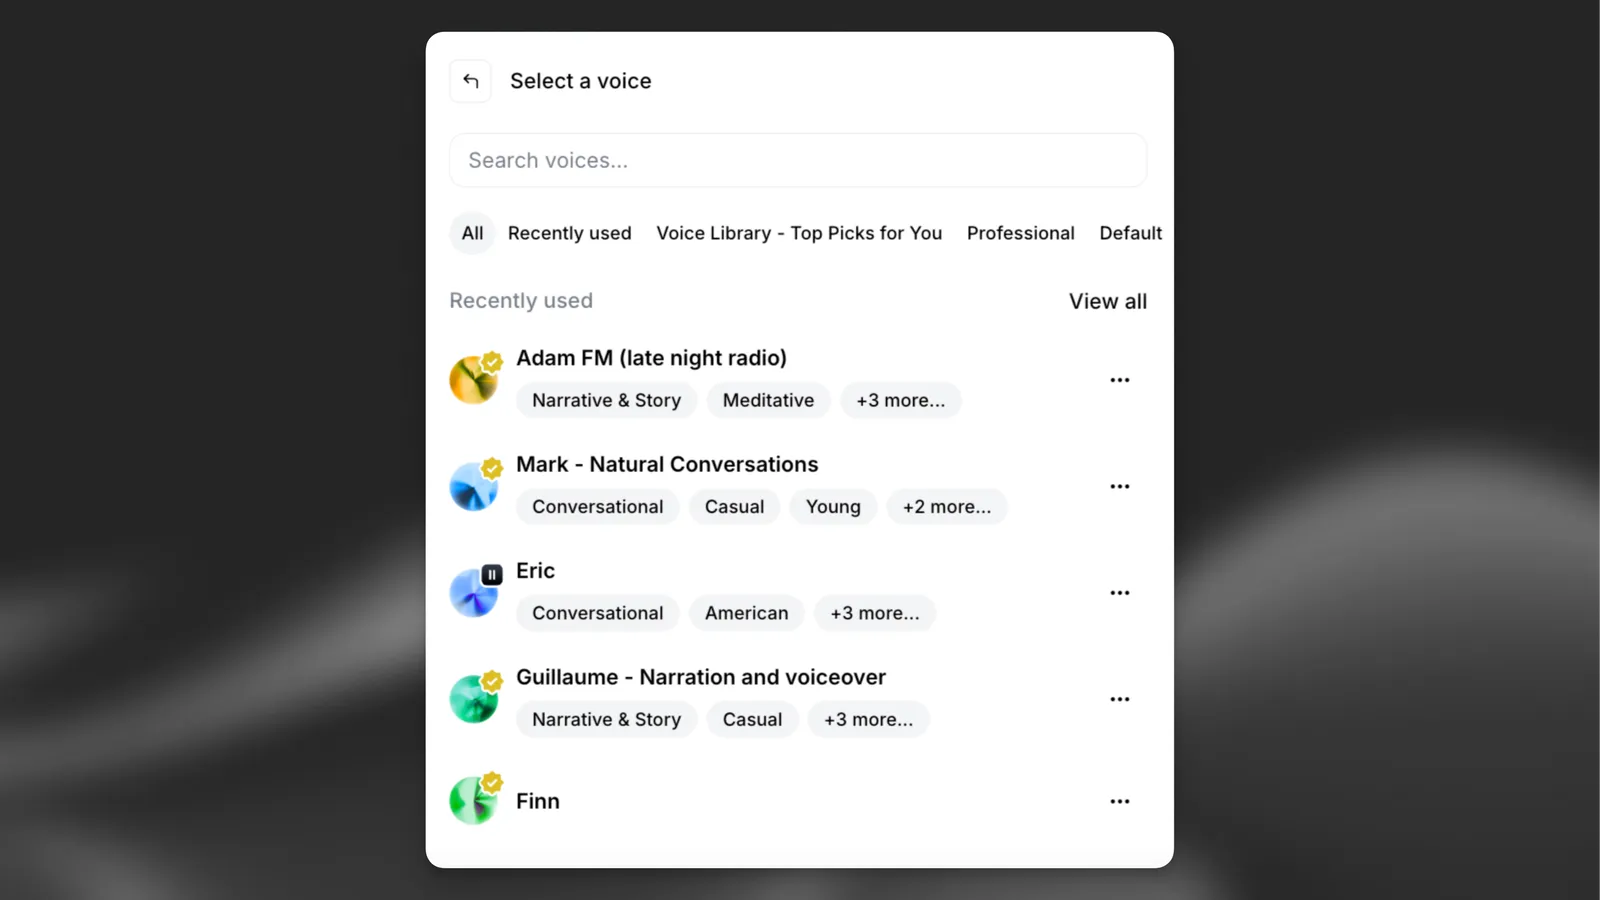
We bieden veel soorten stemmen, waaronder de zorgvuldig geselecteerde Default Voices, onze uitgebreide Voice Library wet vrijwel elke stem die je je kunt voorstellen, volledig synthetische stemmen die zijn gemaakt met onze tool Voice Design, en je kunt je eigen verzameling gekloonde stemmen maken met onze twee technologieën: Instant Voice Cloning en Professional Voice Cloning.
Niet alle stemmen zijn gelijk, en veel hangt af van de bron-audio die is gebruikt om ze te maken. Sommige stemmen leveren een betere, menselijkere performance en voordracht, terwijl andere stabieler zijn.
Het kiezen van de juiste stem voor je specifieke content is cruciaal. Dit is waarschijnlijk de belangrijkste beslissing en heeft de grootste invloed op de uiteindelijke output. De stem bepaalt het geslacht, de toon, het accent, het ritme en de voordracht. Het is de moeite waard om extra tijd te besteden aan het selecteren en goed testen van de perfecte stem, zodat je zeker weet dat deze consistent is en aan je verwachtingen voldoet.
Voor het genereren van spraak in een specifieke taal krijg je de beste resultaten met een native stem uit de Voice Library of door een stem te klonen die de betreffende taal met het juiste accent spreekt. Technisch gezien kan elke stem elke taal spreken, maar de stem behoudt het oorspronkelijke accent. Als je bijvoorbeeld een native Engelse stem gebruikt om Franse spraak te genereren, is de output waarschijnlijk wel Frans, maar met een Engels accent, omdat de AI moet generaliseren hoe die stem zou klinken in een taal waarop deze niet is getraind.
Heb je een stem die je goed vindt, maar wil je een andere voordracht? Dan kan onze tool Voice Remixing helpen. Hiermee gebruik je prompts in natuurlijke taal om de voordracht, het ritme, de toon, het geslacht en zelfs accenten van een stem te wijzigen. Bij het wijzigen van accenten zijn de basisstem en het doelaccent erg belangrijk. Resultaten kunnen verschillen: soms werkt het perfect, terwijl je het andere keren een paar keer moet proberen om het goed te krijgen.
Met Voice Remixing kun je erg goede resultaten behalen, maar die zijn doorgaans niet zo goed als met een correct gekloonde Professional Voice Clone. Ze liggen dichter bij die van een Instant Voice Clone.
Houd er rekening mee dat voice remixing alleen werkt voor specifieke stemmen. Je kunt bijvoorbeeld geen stemmen uit de Voice Library remixen; je kunt alleen stemmen remixen die je zelf hebt gemaakt of de standaardstemmen.
Modellen
Modellen
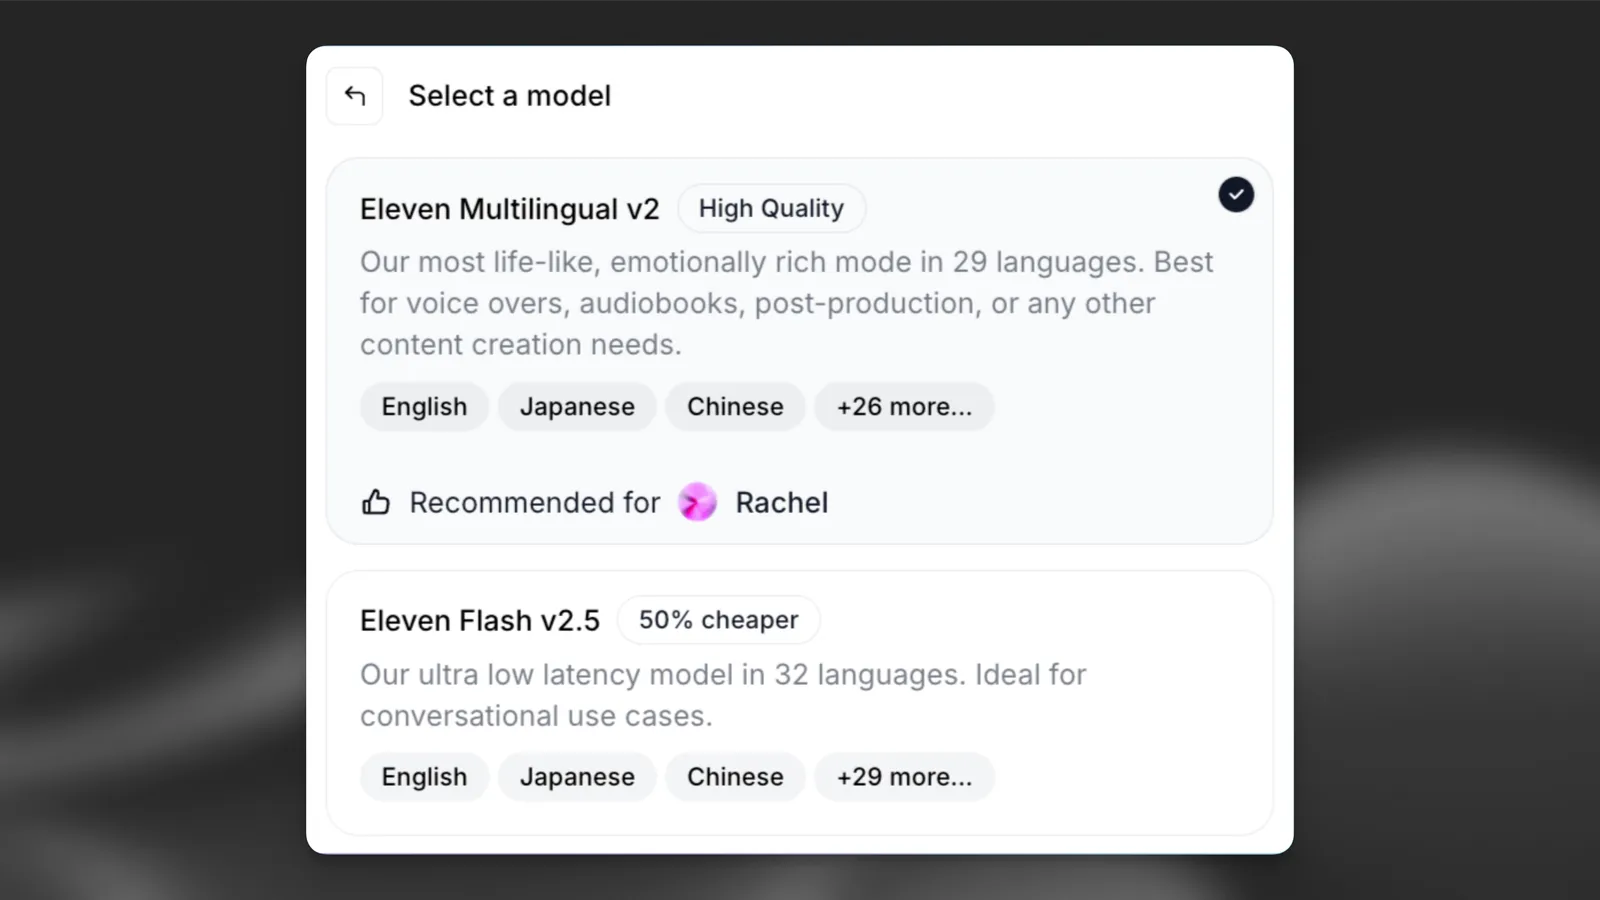
We bieden twee modelfamilies: Standard-modellen (hoge kwaliteit) en Flash-modellen, die zijn geoptimaliseerd voor extreem lage latentie. De meeste families bevatten zowel uitsluitend Engelse als meertalige versies.
Eleven v4 is ons nieuwste model. Het is beschikbaar in twee varianten: Eleven v4 en Eleven v4 Turbo.
De modelkeuze heeft, na de stemselectie, de grootste invloed op je uiteindelijke audio-output. We raden je aan om even verschillende modellen met je gekozen stem te testen, zodat je de beste combinatie vindt. Al onze modellen hebben sterke en zwakke punten en werken beter met bepaalde stemmen dan met andere, dus het is belangrijk om een goede combinatie te vinden.
Als je output uitsluitend Engels is, raden we sterk aan om een van onze modellen voor uitsluitend Engels te gebruiken. Ze zijn vaak eenvoudiger te gebruiken, stabieler en bieden doorgaans betere prestaties voor uitsluitend Engelse content. Is je content in een andere taal of mogelijk meertalig, dan moet je een van de meertalige modellen gebruiken.
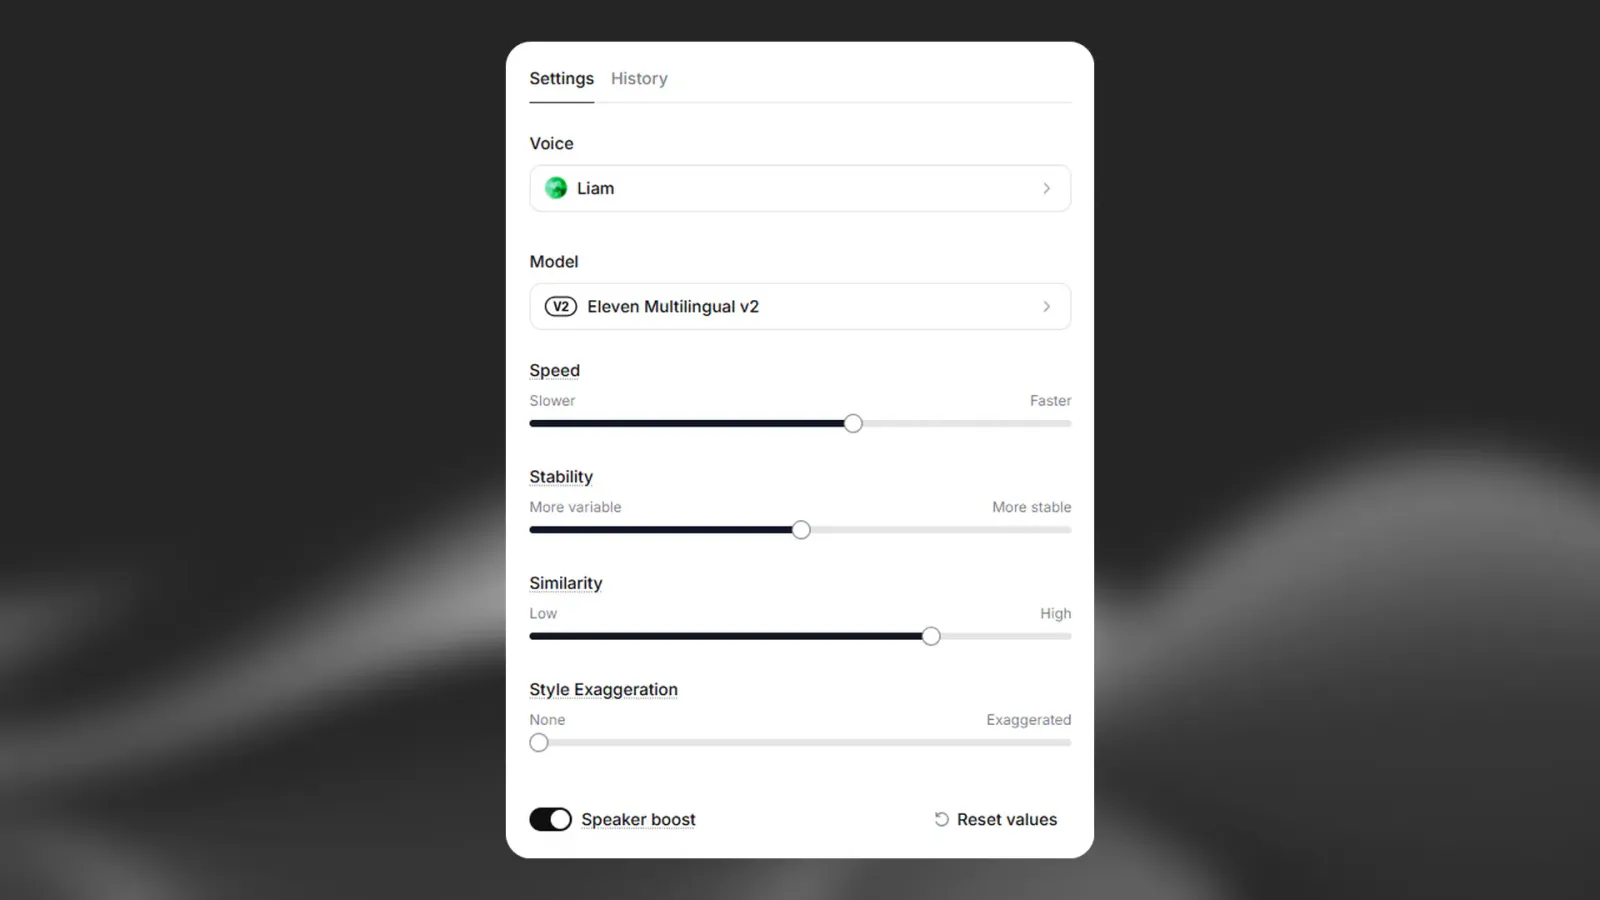
De meest gebruikte instelling is stabiliteit rond 50, gelijkenis rond 75 en stijl op 0, met daarna minimale wijzigingen. Dit hangt natuurlijk allemaal af van de oorspronkelijke stem en de gewenste stijl van de performance.
Het is belangrijk om te weten dat de AI niet-deterministisch is; als je de sliders op specifieke waarden zet, krijg je niet elke keer dezelfde resultaten. De sliders functioneren meer als een bereik en bepalen hoe groot de willekeur tussen generaties kan zijn.
Snelheid
Met de snelheidsinstelling kun je de snelheid van de gegenereerde spraak verhogen of verlagen. De standaardwaarde is 1.0; de snelheid wordt dan niet aangepast. Waarden onder 1.0 vertragen de stem, tot minimaal 0.7. Waarden boven 1.0 versnellen de stem, tot maximaal 1.2. Extreme waarden kunnen de kwaliteit van de gegenereerde spraak beïnvloeden.
Snelheid is niet beschikbaar voor het model Eleven v3.
Stabiliteit
De stabiliteitsslider bepaalt hoe stabiel de stem is en hoeveel willekeur er tussen generaties zit. Door deze slider te verlagen, krijgt de stem een breder emotioneel bereik. Zoals eerder vermeld, wordt dit ook sterk beïnvloed door de oorspronkelijke stem. Als je de slider te laag zet, kan dit leiden tot vreemde performances die te willekeurig zijn en ertoe leiden dat het personage te snel spreekt. Als je de slider te hoog zet, kan dit daarentegen leiden tot een monotone stem met weinig emotie.
Voor een levendigere en dramatischere performance raden we aan om de stabiliteitsslider lager te zetten en een paar keer te genereren totdat je een performance vindt die je goed vindt.
Wil je daarentegen een serieuzere performance, die bij zeer hoge waarden zelfs monotoon kan worden, dan raden we aan om de stabiliteitsslider hoger te zetten. Omdat de output consistenter en stabieler is, hoef je doorgaans niet zo veel samples te genereren om het gewenste resultaat te bereiken. Experimenteer om te ontdekken wat het beste voor je werkt!
Gelijkenis
De gelijkenisslider bepaalt hoe nauw de AI zich aan de oorspronkelijke stem moet houden wanneer deze die probeert na te bootsen. Als de oorspronkelijke audio van slechte kwaliteit is en de gelijkenisslider te hoog staat, kan de AI artefacten of achtergrondgeluid reproduceren wanneer deze de stem probeert na te bootsen, als die in de oorspronkelijke opname aanwezig waren.
Gelijkenis is niet beschikbaar voor het model Eleven v3.
Stijloverdrijving
Met de introductie van de nieuwere modellen hebben we ook een instelling voor stijloverdrijving toegevoegd. Deze instelling probeert de stijl van de oorspronkelijke spreker te versterken. Hiervoor zijn extra rekenresources nodig en de latentie kan toenemen als de waarde niet 0 is. Het is belangrijk om te weten dat deze instelling het model iets minder stabiel kan maken, doordat het de stijl van de oorspronkelijke stem nadrukkelijker probeert te benadrukken en na te bootsen.
Over het algemeen raden we aan deze instelling altijd op 0 te houden.
Speaker Boost
Deze instelling vergroot de gelijkenis met de oorspronkelijke spreker. Het gebruik ervan vereist echter iets meer rekenkracht, waardoor de latentie toeneemt. De verschillen die deze instelling veroorzaakt, zijn doorgaans vrij subtiel.
Speaker Boost is niet beschikbaar voor het model Eleven v3.
Genereren
Zodra je je stem hebt geselecteerd, een model hebt gekozen en je instellingen hebt geconfigureerd, is het generatieproces eenvoudig: je voert tekst in, drukt op “Spraak genereren” en de audio wordt gegenereerd.
Hoewel het proces aan de oppervlakte heel eenvoudig is, is de tekstinvoer die je geeft erg belangrijk om de gewenste output te bereiken. Wanneer je woorden gebruikt die mogelijk “buiten de distributie” vallen — dus zaken die de AI tijdens de training zelden is tegengekomen — zoals vreemde namen, ongebruikelijke afkortingen, symbolen of zelfs emoji’s, loop je het risico de AI in de war te brengen en de output instabieler te maken. Vooral emoji’s en bepaalde symbolen zijn moeilijk voor de AI om correct te interpreteren.
Wanneer je Text to Speech via de UI gebruikt, voeren we automatisch een normalisatiestap uit op je invoer om de leesbaarheid van de tekst te verbeteren en de verwerking voor de AI te vergemakkelijken. Over het algemeen zet deze stap symbolen en cijfers om in uitgeschreven tekst, zodat de AI weet wat de juiste uitspraak is.
Een best practice die we sterk aanbevelen, is om getallen niet als cijfers te schrijven en geen symbolen te gebruiken, vooral wanneer je meertalige modellen gebruikt (maar dit geldt ook voor modellen voor uitsluitend Engels). Omdat getallen en symbolen in veel talen hetzelfde worden geschreven maar anders worden uitgesproken, ontstaat er voor de AI ambiguïteit wanneer je cijfers gebruikt. Het getal “1” wordt bijvoorbeeld identiek geschreven in het Engels en veel andere talen, maar anders uitgesproken. Door het getal uit te schrijven, zoals “one”, hoeft de AI niet te interpreteren wat deze moet doen.
We werken aan geavanceerdere workflows waarmee je de voordracht en performance van de AI kunt beïnvloeden met wat we Audio Tags noemen. Deze functie is beschikbaar in Eleven v4 en Eleven v3. Wil je meer weten over deze functie, dan raden we aan onze promptinggids te lezen.
Veelgestelde vragen
Goede invoer levert goede output op
De eerste en een van de belangrijkste factoren is dat goede, hoogwaardige en consistente invoer leidt tot goede, hoogwaardige en consistente output.
Als je de AI audio geeft die niet ideaal is — bijvoorbeeld audio met veel ruis, galm op heldere spraak, meerdere sprekers of inconsistentie in volume, performance of voordracht — wordt de AI instabieler en is de output minder voorspelbaar.
Als je van plan bent je eigen stem te klonen, raden we sterk aan om de richtlijnen in onze documentatie voor het maken van goede stemklonen door te nemen. Daarmee leg je de best mogelijke basis. Ook als je alleen Instant Voice Clones wilt gebruiken, raden we aan om de sectie over Professional Voice Cloning te lezen. Deze sectie bevat waardevolle informatie over het maken van stemklonen, ook al verschillen de vereisten voor deze twee technologieën enigszins.
Gebruik de juiste stem
De tweede factor om rekening mee te houden, is dat de stem die je selecteert een enorme invloed heeft op de output. Zoals bij de eerste factor vermeld, zijn niet alleen de kwaliteit en consistentie van de samples waarmee die specifieke kloon is gemaakt erg belangrijk, maar ook de taal en tonaliteit van de stem.
Wil je een stem die vrolijk en opgewekt klinkt, gebruik dan een stem die is gekloond met vrolijke en opgewekte samples. Wil je juist een stem die introspectief en somber klinkt, kies dan een stem met die kenmerken.
Het is echter ook cruciaal om een stem te gebruiken die in de juiste taal is getraind. Alle professionele stemklonen die we als standaardstemmen aanbieden, zijn bijvoorbeeld Engelse stemmen die zijn getraind op Engelse samples. Als je ze andere talen laat spreken, kan hun performance in die talen daarom onvoorspelbaar zijn. Het is essentieel om een stem te gebruiken die is gekloond op basis van samples waarin de stem de taal sprak die je de AI vervolgens wilt laten spreken.
Gebruik de juiste opmaak
Dit lijkt misschien wat triviaal, maar het kan een groot verschil maken. De AI probeert te begrijpen hoe iets moet worden voorgelezen op basis van de context van de tekst zelf. Dat betekent niet alleen de gebruikte woorden, maar ook hoe ze zijn samengesteld, hoe interpunctie wordt toegepast, de grammatica en de algemene opmaak van de tekst.
Dit kan een kleine maar merkbare invloed hebben op de voordracht van de AI. Als je een woord verkeerd spelt, corrigeert de AI het niet en probeert deze het te lezen zoals het is geschreven.
Niet-deterministisch
De instellingen van de AI zijn niet-deterministisch. Dit betekent dat je zelfs met dezelfde beginvoorwaarden (stem, instellingen, model) een enigszins andere output krijgt, vergelijkbaar met hoe een stemacteur elke keer een iets andere performance levert.
Deze variatie kan door verschillende factoren ontstaan, zoals de eerder genoemde opties: stem, instellingen en model. Over het algemeen kun je de omvang van die variatie bepalen met de stabiliteitsslider. Een lagere stabiliteitsinstelling betekent een breder bereik aan variatie tussen generaties, maar introduceert ook variatie tussen generaties, waardoor de AI wat expressiever kan zijn.
Een grotere variatie kan vaak wenselijk zijn, omdat een te hoge stabiliteit bepaalde stemmen monotoon kan laten klinken: de AI krijgt dan niet dezelfde ruimte om meer gevarieerde content te genereren. Een te lage stabiliteit kan echter ook andere problemen veroorzaken, waarbij de generaties instabiel worden, vooral bij bepaalde stemmen waarvoor tijdens het kloonproces mogelijk minder ideale audio is gebruikt.
De standaardinstelling van 50 is doorgaans een uitstekend uitgangspunt voor de meeste toepassingen.
Wat is Eleven v4?
We raden aan om over te stappen op Eleven v4 en deze met je eigen content te testen.
Eleven v4 is ons nieuwste en meest geavanceerde Text to Speech-model en het eerste van een nieuwe generatie modellen. Het verbetert de uitvoerkwaliteit, stemnauwkeurigheid, emotie, audiotags en taalondersteuning ten opzichte van Eleven v3.
De nauwkeurigheid van stemklonen maakt met Eleven v4 een grote sprong vooruit. Gekloonde stemmen leggen de kenmerken van de bronstem — timbre, cadans en voordracht — getrouwer vast dan met elk voorgaand model.
Instant Voice Clones (IVCs) zijn in Eleven v4 nauwkeuriger dan ooit. Ze leggen de bepalende kenmerken van een bronstem getrouwer vast, waardoor je eenvoudiger snel een overtuigend kloon kunt maken op basis van een kort audiosample.
Professional Voice Clones (PVCs) worden volledig ondersteund in Eleven v4. Ze bouwen voort op dezelfde verbeteringen in stemnauwkeurigheid en bieden een getrouwere reproductie van de bronstem voor workflows die de hoogste mate van consistentie en controle vereisen.
Eleven v4 is beschikbaar in twee varianten, zodat je de juiste balans tussen kwaliteit en snelheid voor je use case kunt kiezen:
Eleven v4 (eleven_v4) — ons model met de hoogste kwaliteit, ideaal voor contentcreatie, luisterboeken, character voice-overs en alle use cases waarin kwaliteit de hoogste prioriteit heeft.
Eleven v4 Turbo (eleven_v4_turbo) — uitzonderlijk hoge kwaliteit met een indrukwekkend lage latentie, speciaal ontwikkeld voor realtime use cases zoals conversationele agents en interactieve stemervaringen.
Beide varianten gebruiken twee steminstellingen: Stability en Similarity. De schuifregelaars Style en Speed zijn niet beschikbaar in Eleven v4 en SSML wordt niet ondersteund.
Wanneer de taal die je genereert overeenkomt met de taal van je referentiestem, blijft het oorspronkelijke accent precies zoals voorheen behouden. Wanneer de taal die je genereert verschilt van de taal van de referentiestem, genereert Eleven v4 vloeiende, natuurlijk klinkende spraak in de doeltaal — in plaats van het accent van de referentiestem uit de oorspronkelijke taal over te nemen.
Bekijk Eleven v4 voor klonen, accenten, vergelijkingen en de volledige beschrijving. Bekijk Prompting voor Eleven v4 voor tags en prompting.
Wat is Eleven v3?
We raden aan om over te stappen op Eleven
v4 en deze met je eigen content te testen. Veel van de promptingtechnieken voor Eleven
v4 gelden ook voor
Eleven v3.
Eleven v3 is een emotioneel rijk, expressief Text to Speech-model. Het produceert natuurlijke, levensechte spraak met een groot emotioneel bereik en begrip van context in meer dan 70 talen.
Spraaksnelheidsregeling is beschikbaar voor Text to Speech via Speech Synthesis, Studio, ElevenAgents en onze API.
Je kunt de snelheid van de stem regelen met de instelling Speed.
Mogelijke waarden lopen van 0,7 tot 1,2. Waarden onder 1 vertragen de spraak en waarden boven 1 versnellen deze. Extreme waarden kunnen de kwaliteit van de gegenereerde spraak beïnvloeden.
Deze instelling is beschikbaar voor alle stemmen en alle modellen. Je vindt deze in de steminstellingen.
Zie onze API-referentie voor informatie over het regelen van spraak via de API.
Kan ik dezelfde gekloonde/ontworpen stem in verschillende talen gebruiken?
Elke stem kan alle ondersteunde talen spreken.
Bij de werking van het huidige model selecteer je geen specifieke taal. Je schrijft in plaats daarvan in de taal die je de AI wilt laten spreken, waarna de AI dit automatisch begrijpt. Omdat er echter overlap kan zijn tussen verschillende talen die vergelijkbare woorden en woordenschat gebruiken, maar met sterk verschillende uitspraken en accenten, kun je het beste een gekloonde stem gebruiken die is gekloond terwijl deze de taal met het juiste accent sprak.
De taal wordt bepaald door de tekst; het accent en de uitspraak worden bepaald door de stem zelf. Voor optimale werking heeft het model beide contexten nodig.
We onderzoeken de ontwikkeling van nieuwe technologie om taalkeuze mogelijk te maken, maar door de manier waarop de AI is opgebouwd, is dit alles nog in ontwikkeling.
Hoe download ik gegenereerde bestanden uit Text to Speech?
Je kunt de gegenereerde bestanden op twee manieren downloaden:
Je kunt een gegenereerd bestand direct downloaden door na het genereren van de content rechtsonder op de downloadknop te klikken.
Eerder gegenereerde bestanden kun je downloaden vanuit je geschiedenis.
Log in op je account en selecteer Text to Speech in de zijbalk om je geschiedenis te openen. Klik vervolgens op het tabblad Geschiedenis in het paneel aan de rechterkant van het scherm. Op smalle schermen open je je geschiedenis door op het geschiedenisicoon boven de knop Generate speech te klikken.
In je geschiedenis kun je op het downloadicoon klikken om het bestand te downloaden als MP3-bestand (128 kbps) of WAV-bestand.
Je kunt ook op Advanced klikken om aanvullende bestandsindelingen te downloaden:
MP3 (192 kbps)
MP3 (256 kbps)
M4A
FLAC
Kun je stemmen het geluid van ademhalen laten produceren?
Ja. Met Eleven v4 en Eleven v3 kun je audiotags zoals [sighs] of [exhales] gebruiken om ademhaling en vergelijkbare reacties aan gegenereerde spraak toe te voegen.
Zie de promptinggids voor meer informatie over audiotags en het regelen van de voordracht.
Bieden jullie een AI-model voor conversationele doeleinden of chatbots?
Onze Flash- en Turbo-modellen zijn speciaal ontwikkeld voor toepassingen met lage latentie.
Flash v2 en Flash v2.5 zijn onze modellen met ultralage latentie en genereren audio in minder dan 75 ms. Flash v2 is alleen beschikbaar in het Engels, terwijl Flash v2.5 32 talen ondersteunt. Bekijk de volledige lijst met alle ondersteunde talen
hier.
Onze Turbo-modellen hebben ook lage latentie, maar omdat de Flash-modellen zeer vergelijkbare resultaten leveren, raden we aan Flash-modellen te gebruiken in plaats van Turbo. Turbo v2 is alleen beschikbaar in het Engels, terwijl Turbo v2.5 32 talen ondersteunt en 25% sneller is dan Turbo v2; het genereert audio in ongeveer 300 ms.
Zowel Flash als Turbo zijn sterk geoptimaliseerde modellen, specifiek afgestemd op toepassingen met lage latentie zonder in te leveren op stemkwaliteit, en in lijn met de kwaliteitsstandaard die mensen van onze modellen verwachten.
Voor beide modellen geldt korting wanneer je via de API genereert. Zie onze API-prijzen voor meer informatie.
We bieden ook ElevenAgents, ons platform voor het implementeren van aangepaste, interactieve stemagenten. Bezoek onze ElevenAgents-documentatie voor meer informatie.
Hoe kan ik pauzes toevoegen?
Er zijn verschillende manieren om een pauze of onderbreking toe te voegen en het ritme en tempo van de spreker te beïnvloeden. Welke methode je gebruikt, hangt af van het model.
Audiotags (Eleven v4 en Eleven v3)
Gebruik met Eleven v4 en Eleven v3 audiotags en leestekens om het tempo en de voordracht te regelen. Deze modellen ondersteunen geen SSML-breaktags.
Zie de promptinggids voor richtlijnen voor het prompten van pauzes en voordracht.
Breaktags (Multilingual v2, Flash v2 en Flash v2.5)
De meest consistente manier om een pauze toe te voegen in Multilingual v2, Flash v2 en Flash v2.5 is met de SSML-breaktagsyntaxis <break time="1.5s" />. Hiermee creëer je een exacte en natuurlijke pauze in de spraak. Er wordt niet alleen stilte tussen woorden ingevoegd: het model begrijpt de syntaxis en voegt een natuurlijke pauze toe.
De manier waarop het model met deze pauzes omgaat, kan verschillen. De gebruikte stem speelt een doorslaggevende rol in de output. Sommige stemmen, die zijn getraind met een paar “uh’s” en “ah’s”, kunnen tijdens pauzes die vocale gewoonten invoegen, zoals een echte spreker dat zou kunnen doen.
Een voorbeeld:
“Geef me even de tijd om erover na te denken.” <break time="1.0s" /> “Ja, dat zou werken.”
De breektijd moet je in seconden beschrijven. De AI kan pauzes van maximaal 3 seconden verwerken en kan worden gebruikt in Text to Speech en via de API.
Als je een buitensporig aantal SSML-breaks in je tekst gebruikt, kan dat problemen veroorzaken. De spraak kan sneller worden of de audio kan meer ruis en andere artefacten bevatten. We werken eraan om dit op te lossen.
Leestekens
Deze opties zijn minder consistent dan breaktags of audiotags, maar kunnen het tempo nog steeds beïnvloeden.
Een eenvoudig streepje - of een gedachtestreepje — werkt vaak goed. Je kunt meerdere streepjes toevoegen, zoals -- --, voor een langere pauze.
“Het - wordt - laat.”
Een beletselteken ... kan soms een pauze tussen woorden toevoegen, maar het voegt meestal ook enige aarzeling of nervositeit toe aan de stem, wat niet altijd passend is.
“Ik… ja, dat denk ik wel…”
Hoe kan ik een bepaalde uitspraak van een woord of naam afdwingen?
Eleven v3 biedt native ondersteuning voor het Internationaal Fonetisch Alfabet (IPA). Lees meer in IPA met Eleven v3.
SSML-foneemtags (alleen Flash v2 en Turbo v2)
In Flash v2 en Turbo v2 kun je met SSML-foneemtags een bepaalde uitspraak afdwingen. We ondersteunen zowel IPA als CMU. CMU is met de huidige implementatie doorgaans iets voorspelbaarder en consistenter. Lees meer in onze uitspraakgids.
Alternatieve spellingen
Als alternatief kun je een alternatieve spelling zoeken en een woord fonetischer schrijven. Je kunt verschillende trucs gebruiken, zoals hoofdletters, streepjes, apostrofs of zelfs enkele aanhalingstekens rond één letter of meerdere letters.
Een woord als “trapezii” kun je bijvoorbeeld schrijven als “trapezIi” om meer nadruk te leggen op de “ii” in het woord.
Hoe werken audiotags met Eleven v3 en v4?
Eleven v4 en Eleven v3 ondersteunen audiotags. We raden Eleven v4 aan. Zet een korte instructie tussen vierkante haken en plaats die in de tekst waar de voordracht moet veranderen. Dezelfde tags werken met beide modellen.
Bestanden die je met Text to Speech of Voice Changer hebt gegenereerd, kun je downloaden als MP3-, WAV-, M4A- of FLAC-bestand. WAV-, M4A- en FLAC-bestanden moet je downloaden vanuit je geschiedenis.
WAV-bestanden downloaden
Selecteer Text to Speech of Voice Changer in de zijbalk en open vervolgens je geschiedenis door te klikken op het tabblad Geschiedenis in het paneel aan de rechterkant van het scherm. Op smalle schermen open je je geschiedenis door op het geschiedenisicoon boven de knop Generate speech te klikken.
In je geschiedenis kun je op het downloadicoon klikken om het bestand als MP3- of WAV-bestand te downloaden.
FLAC- of M4A-bestanden downloaden
Selecteer Text to Speech of Voice Changer in de zijbalk en open vervolgens je geschiedenis door te klikken op het tabblad Geschiedenis in het paneel aan de rechterkant van het scherm. Op smalle schermen open je je geschiedenis door op het geschiedenisicoon boven de knop Generate speech te klikken.
In je geschiedenis kun je op het downloadicoon klikken om het bestand als MP3- of WAV-bestand te downloaden. Klik op Advanced en selecteer je voorkeursindeling om aanvullende bestandsindelingen, waaronder FLAC en M4A, te openen.
Hoe selecteer ik de taal en het accent?
Taal bij genereren via de website
Wanneer je audio genereert op de ElevenLabs-website, detecteert onze AI automatisch de taal op basis van de context van de tekst in je prompt. Daarom kun je beter geen meerdere talen in één prompt gebruiken, omdat dit verwarring kan veroorzaken over welke taal moet worden gebruikt. Op dit moment kun je geen taal opgeven wanneer je op de website genereert.
Taal bij genereren via de API
Als je audio via de API genereert, kun je de taal van je prompt handmatig opgeven met de parameter language_code. Dit is een optionele parameter die ISO 639-1-taalcodes accepteert.
Dit kan nuttig zijn voor korte of dubbelzinnige prompts, bijvoorbeeld wanneer de tekst alleen cijfers bevat. Door de taal op te geven, weet je zeker dat de normalizer de juiste regels voor die taal toepast.
Zie dit artikel. voor meer informatie over normalisatie.
Accent
Het accent dat voor je generatie wordt gebruikt, komt van de stem die je gebruikt. Als je een stem gebruikt die niet is getraind in de taal waarin je genereert, kun je een licht accent uit de oorspronkelijke taal van de stem opmerken.
Voor de beste resultaten raden we aan een stem te gebruiken die is getraind met audio in de taal waarin je genereert, met het accent van je voorkeur. Dit helpt de AI om uitspraak en intonatie nauwkeuriger te begrijpen.
Dit is vooral belangrijk voor talen die op elkaar lijken of veel woorden gemeen hebben. Door een stem te kiezen die is getraind in de juiste taal, zorg je ervoor dat de AI de juiste uitspraak en het juiste accent gebruikt.
Je kunt:
Een gekloonde stem maken met audio in de taal en het accent van je voorkeur.
In de Voice Library zoeken en de zoekfilters gebruiken om geschikte stemmen te vinden die
aan je behoeften voldoen.
Hoeveel kost het om met Eleven v3 (Alpha) te genereren?
De kosten voor genereren met Eleven v3 zijn op de website 1 credit per teken. API-generaties zijn goedkoper - bekijk de API-prijzen voor meer informatie.
Met Eleven v4 en Eleven v3 kun je audiotags zoals [laughs] gebruiken om gelach en andere reacties toe te voegen aan gegenereerde spraak. Bekijk de handleiding voor prompting voor meer informatie.
Bij andere modellen hangt de emotionele voordracht af van de context, interpunctie en steminstellingen. Bekijk Hoe genereer ik emoties?.
Hoe produceer ik emoties?
Het model is gevoelig voor de bredere context van elke uiting: het beoordeelt of iets logisch is aan de hand van de relatie met de voorafgaande en volgende tekst. Dankzij dit bredere perspectief kan het langere fragmenten goed intoneren door een gedachtegang die zich over meerdere zinnen uitstrekt te voorzien van een samenhangend emotioneel patroon.
Tips voor het genereren van emoties:
Context is essentieel om specifieke emoties te genereren. Als je lachende of grappige tekst invoert, krijg je mogelijk een vrolijk resultaat. Hetzelfde geldt voor boosheid, verdriet en andere emoties — de context bepalen is essentieel.
Interpunctie en steminstellingen spelen de belangrijkste rol in de manier waarop de uitvoer wordt uitgesproken.
Leg nadruk door de relevante woorden of zinnen tussen aanhalingstekens te zetten.
Bij spraak die met een gekloonde stem wordt gegenereerd, wordt de spreekstijl in de samples die je voor het klonen uploadt gereproduceerd in de uitvoer. Als de spraak in het geüploade sample monotoon is, zal het model moeite hebben om expressieve uitvoer te produceren.
Met Eleven v4 en Eleven v3 kun je ook audiotags gebruiken om emotie en voordracht directer te sturen, bijvoorbeeld [happy], [sad], [angry], [whispers] en [laughs]. Bekijk de handleiding voor prompting voor meer informatie.
Deze tips helpen de emotionele voordracht te sturen, maar garanderen geen specifiek resultaat.
Kan ik audio vooraf beluisteren zonder vóór het downloaden quota te verliezen?
Helaas bieden we momenteel geen aftrek bij downloaden als alternatief voor aftrek bij genereren. Er is momenteel geen manier om generaties vooraf te beluisteren zonder quota af te trekken.
Wanneer je op de website op ‘Genereren’ drukt, worden credits afgetrokken, omdat de servers moeten opstarten en de audio moet worden gegenereerd. Er is geen manier om een stem met je eigen tekst te testen of vooraf te beluisteren zonder credits te gebruiken.
We staan in de volgende omstandigheden twee gratis regeneraties in Text to Speech via de website toe:
De prompt (voor Text to Speech) of het bestand (voor Voice Changer), de stem en het model blijven hetzelfde. Je kunt de schuifregelaars voor steminstellingen wijzigen.
De eerste generatie is minder dan twee uur geleden gemaakt.
Je hebt de pagina niet vernieuwd sinds je de oorspronkelijke audio hebt gegenereerd.
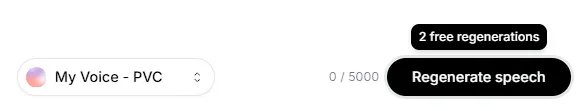
Als dit het geval is, zie je ‘Spraak opnieuw genereren’. Als je de muisaanwijzer boven de knop ‘Spraak opnieuw genereren’ houdt, wordt het aantal resterende gratis regeneraties weergegeven:
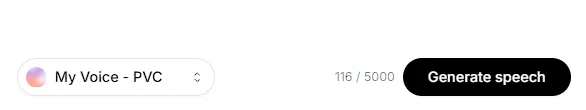
Zodra je gratis regeneraties zijn verbruikt, verandert de knop weer in ‘Spraak genereren’ en wordt het aantal credits weergegeven dat voor de generatie wordt gebruikt:
Gratis regeneraties zijn alleen beschikbaar in Text to Speech via de website. Ze zijn niet beschikbaar via de API.
We onderzoeken of we previews met deze kwaliteit kunnen aanbieden zonder prijzen of kosten te verhogen. We onderzoeken ook manieren om de AI beter bestuurbaar te maken, zodat je niet eerst hoeft te previewen en hopelijk meteen bij de eerste poging het gewenste resultaat krijgt.
Wat is de dialoogmodus?
Eleven v4 en Eleven v3 bieden een dialoogmodus waarmee je dynamische gesprekken met meerdere sprekers kunt genereren, met een natuurlijk tempo en verwerking van onderbrekingen, toonwisselingen en emotionele signalen op basis van de gesprekscontext.
De dialoogmodus is beschikbaar wanneer je via de website meerdere sprekers gebruikt.
Je kunt ook de API-endpoints voor Text to Dialogue gebruiken om interacties met meerdere sprekers te genereren. Bekijk onze API-documentatie voor meer informatie:
Elke stem kan elke taal spreken die momenteel door de AI wordt ondersteund. Als je echter geen stem gebruikt die de taal die je de AI wilt laten spreken als moedertaal heeft, bijvoorbeeld een gegenereerde stem of een stemkloon die Engels spreekt, kan de AI een licht Engels accent hebben of af en toe overschakelen naar vergelijkbare talen.
Bij het huidige model selecteer je geen specifieke taal. In plaats daarvan schrijf je in de taal die je de AI wilt laten spreken, en de AI begrijpt dit automatisch. Omdat er echter overlap kan zijn tussen verschillende talen waarin vergelijkbare woorden en woordenschat worden gebruikt, maar met heel andere uitspraken en accenten, kun je het beste een stemkloon gebruiken die is gekloond terwijl die de taal met het juiste accent sprak. Zo heeft de AI de meeste context voor hoe en in welke taal iets moet worden uitgesproken.
De taal wordt bepaald door de tekst, terwijl het accent en de uitspraak worden bepaald door de
stem zelf.
We onderzoeken de ontwikkeling van nieuwe technologie om taalselectie mogelijk te maken, maar door de manier waarop de AI is gebouwd, is dit nog in ontwikkeling.
Wat is het maximale aantal tekens en de maximale hoeveelheid tekst die ik kan genereren?
In Text to Speech kun je via de website met elk betaald abonnement maximaal 5.000 tekens per generatie genereren en met alle gratis abonnementen maximaal 2.500 tekens.
Als je echter langere content van meer dan enkele duizenden tekens wilt genereren, raden we je sterk aan om Studio te gebruiken. Daarmee kun je heel eenvoudig zeer lange content, zoals boeken en romans, genereren. Lees er hier meer over.
Als je via de API genereert, verschilt de maximale invoerlengte per model:
Welke stemmen in de Voice Library zijn native in een specifieke taal?
Alle vooraf gemaakte en gegenereerde stemmen zijn Engels. Dit betekent dat ze mogelijk niet het juiste accent of de juiste uitspraak hebben wanneer ze andere talen spreken.
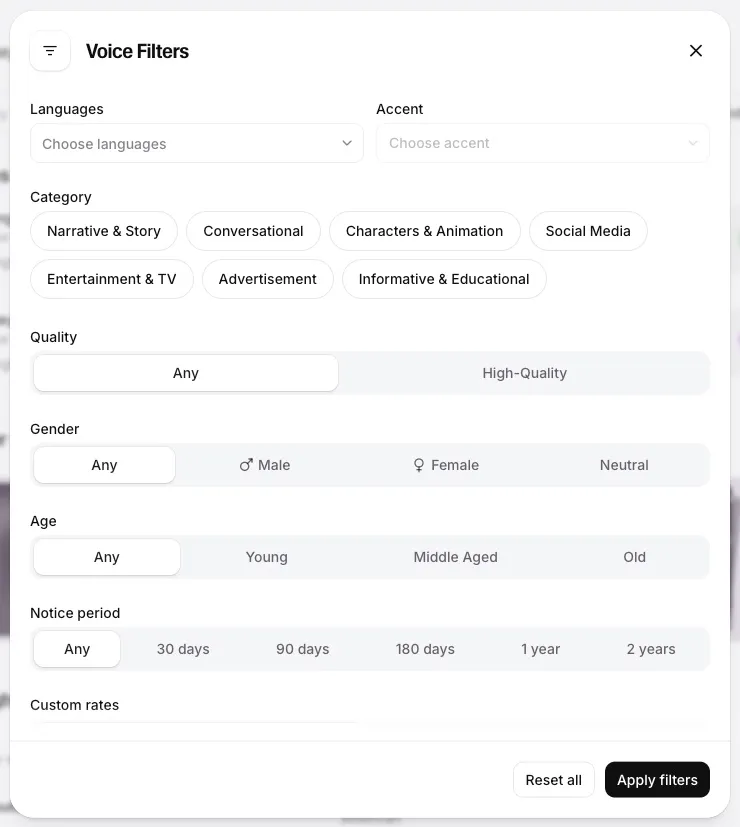
In de professionele categorie van de Voice Library vind je stemmen die de community met ons heeft gedeeld. Deze stemmen zijn hun eigen Professional Voice Clones. Deze stemmen hebben doorgaans een taaltag die aangeeft in welke taal ze zijn gekloond, waardoor ze die taal als moedertaal hebben. Je kunt ook het taalzoekfilter gebruiken om op specifieke talen te filteren.
Waarom worden getallen, datums, symbolen en acroniemen niet goed uitgesproken of niet in de juiste taal uitgesproken?
Getallen, datums, symbolen en acroniemen kunnen een uitdaging vormen voor de AI, omdat ze vaak op meerdere manieren correct kunnen worden uitgesproken. Dit kan ook afhangen van de gebruikte taal. Zo kan “11” worden gelezen als “Eleven”, maar in het Spaans kan het ook “Once” zijn en in het Duits “Elf”.
Er zijn verschillende manieren waarop je ervoor kunt zorgen dat getallen, datums, acroniemen en symbolen correct worden uitgesproken.
Volledig uitschrijven
Voor de beste resultaten raden we aan getallen, acroniemen, datums en symbolen volledig uit te schrijven, op de manier waarop je wilt dat de AI ze uitspreekt. Zo heeft de AI de meeste context om de juiste output te geven. Voor “$100” raden we bijvoorbeeld aan om “a hundred dollars” of “one hundred dollars” te schrijven, zodat je het gewenste resultaat krijgt.
Een LLM gebruiken
Als je een groot taalmodel gebruikt om je tekstprompts te genereren, bijvoorbeeld bij ElevenAgents, kun je het model instrueren om getallen, datums, symbolen en acroniemen altijd voluit te schrijven op de manier waarop je wilt dat de AI ze uitspreekt.
Normalisatie
Als je via de API genereert, kun je met de parameter apply_text_normalization aangeven of tekstnormalisatie moet worden toegepast. Tekstnormalisatie schrijft getallen en datums voluit voor een betere uitspraak. Deze optie voegt wel latentie toe, omdat het normalisatieproces extra verwerkingstijd kost.
De parameter apply_text_normalization heeft drie modi:
on: altijd toepassen
off: nooit toepassen
auto: de AI bepaalt automatisch wanneer tekstnormalisatie wordt toegepast
Je kunt ook de taal van je prompt aangeven met de parameter language_code. Dit is een optionele parameter die ISO 639-1-taalcodes accepteert.
Dit kan nuttig zijn voor korte of dubbelzinnige prompts, bijvoorbeeld wanneer de tekst alleen getallen of symbolen bevat. Door de taal op te geven, weet je zeker dat de normalisator de juiste regels voor die taal toepast.
Normalisatie is standaard ingeschakeld wanneer je via de website met Text to Speech genereert.
In Studio wordt normalisatie standaard automatisch toegepast. Dit betekent dat de AI bepaalt wanneer tekstnormalisatie moet worden toegepast. Je kunt normalisatie ook altijd laten toepassen. Deze optie vind je in Projectinstellingen op het tabblad Geavanceerd.
Verkeerde uitspraken kunnen verschillende oorzaken hebben. De meest voorkomende is dat het woord gewoon verkeerd is gespeld. De AI probeert verkeerd gespelde woorden niet te corrigeren, maar leest ze precies zoals ze zijn geschreven. Controleer daarom goed of de tekst is nagekeken en af voordat je de AI hem laat voorlezen.
Als je een bepaalde uitspraak wilt afdwingen, kun je SSML-foneemtags gebruiken met ons Flash v2-model. Lees hierover meer in onze uitspraakgids.
Soms spreekt de AI woorden mogelijk verkeerd uit of heeft deze een vreemd accent dat je niet verwacht. Dit kan verschillende oorzaken hebben en is in de meeste gevallen sterk afhankelijk van de stem en de taal. De beste manier om het juiste accent en de juiste uitspraak te garanderen, is een stem met het juiste accent en de juiste uitspraak te klonen. Dit geeft de AI de meeste context bij het genereren van de audio.
De taal wordt bepaald door de tekst en het accent door de stem. Als je dus schrijft in een taal die mogelijk veel woorden deelt met, of nauw verwant is aan, een andere taal, kan de AI moeite hebben om te begrijpen hoe bepaalde woorden moeten worden uitgesproken of tussen accenten wisselen.
Onder bepaalde omstandigheden kan de AI echter ook correct geschreven woorden verkeerd uitspreken, zelfs in het Engels. Dit lijkt sterk afhankelijk te zijn van de gebruikte stem en tekst, maar zou zelden moeten voorkomen.