Text to Speech
Vue d’ensemble
La technologie Text to Speech d’ElevenLabs est au cœur de nos offres et alimente une parole générée par IA de haute qualité dans diverses applications à travers le monde. Vous avez probablement déjà entendu nos voix, qui offrent des expériences audio réalistes.
Générer votre premier audio avec Text to Speech est très simple. Toutefois, pour tirer le meilleur parti de cette fonctionnalité, vous devez garder quelques éléments à l’esprit.
Guide
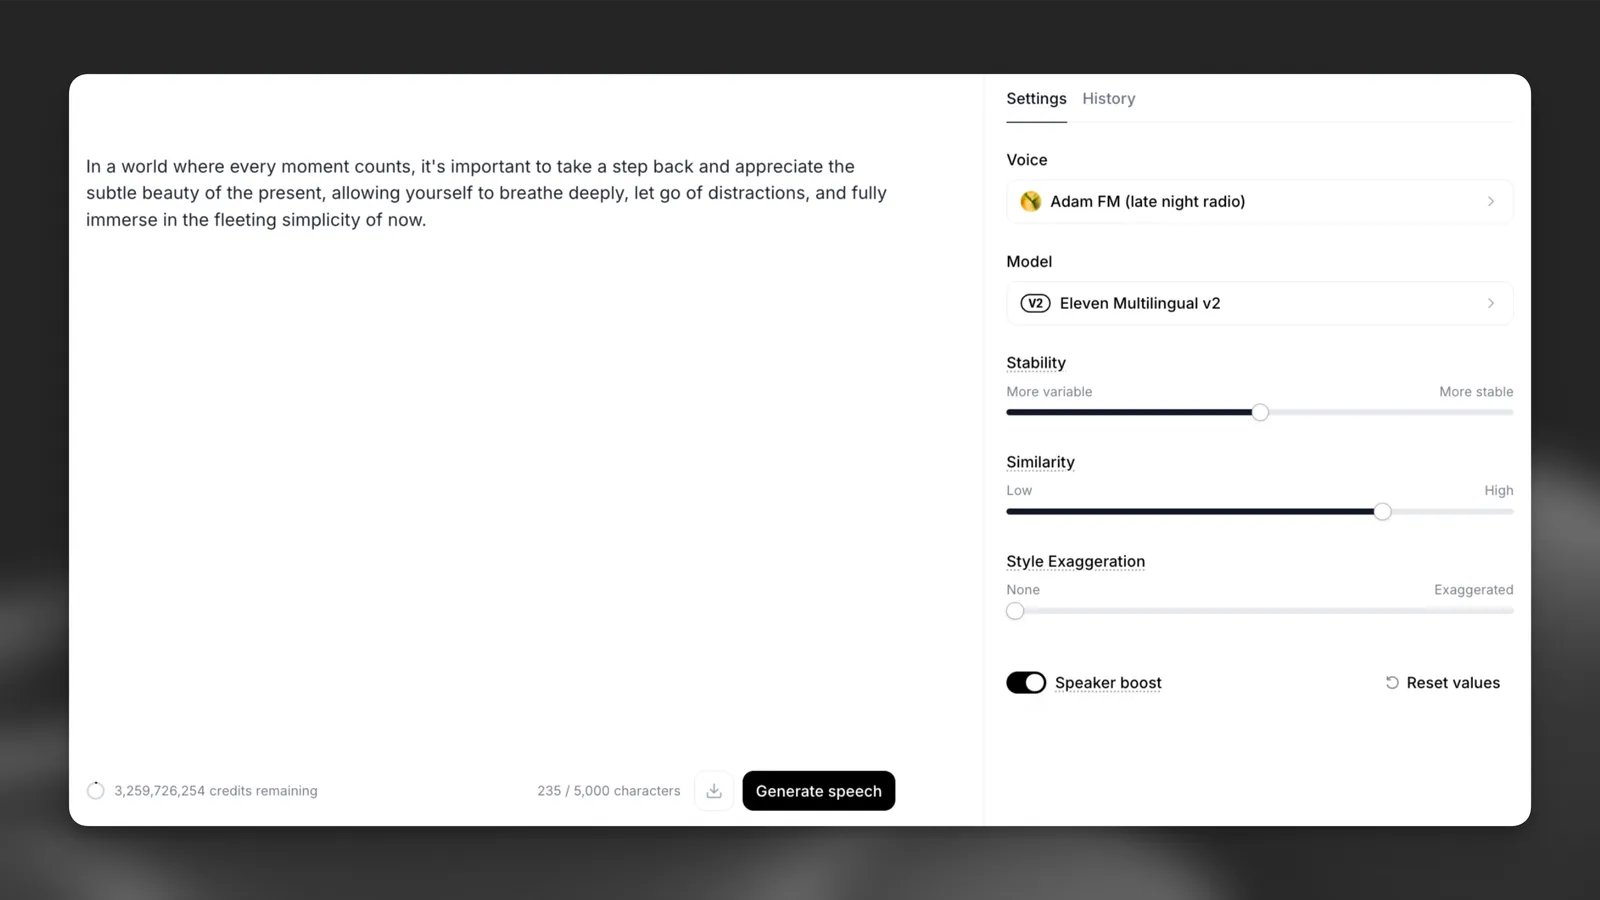
Sélection de la voix
Sélectionnez la voix que vous souhaitez utiliser dans vos Voix, en bas à gauche de l’écran.
Paramètres
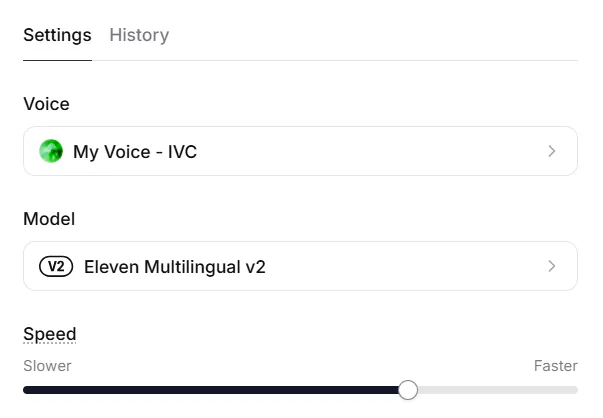
Familiarisez-vous avec les voix, les modèles et les paramètres pour créer une parole de haute qualité.
Les paramètres que vous utilisez, en particulier la voix et le modèle, ont un impact considérable sur le résultat. Il est essentiel de les connaître et de comprendre certaines bonnes pratiques. Les autres paramètres influencent également le résultat, mais leur impact est moins important que celui de la voix et du modèle sélectionnés.
L’ordre d’importance est le suivant : la sélection de la voix est primordiale, suivie de celle du modèle, puis des paramètres du modèle. Tous ces éléments, ainsi que leur combinaison, influencent le résultat.
Voix
Voix
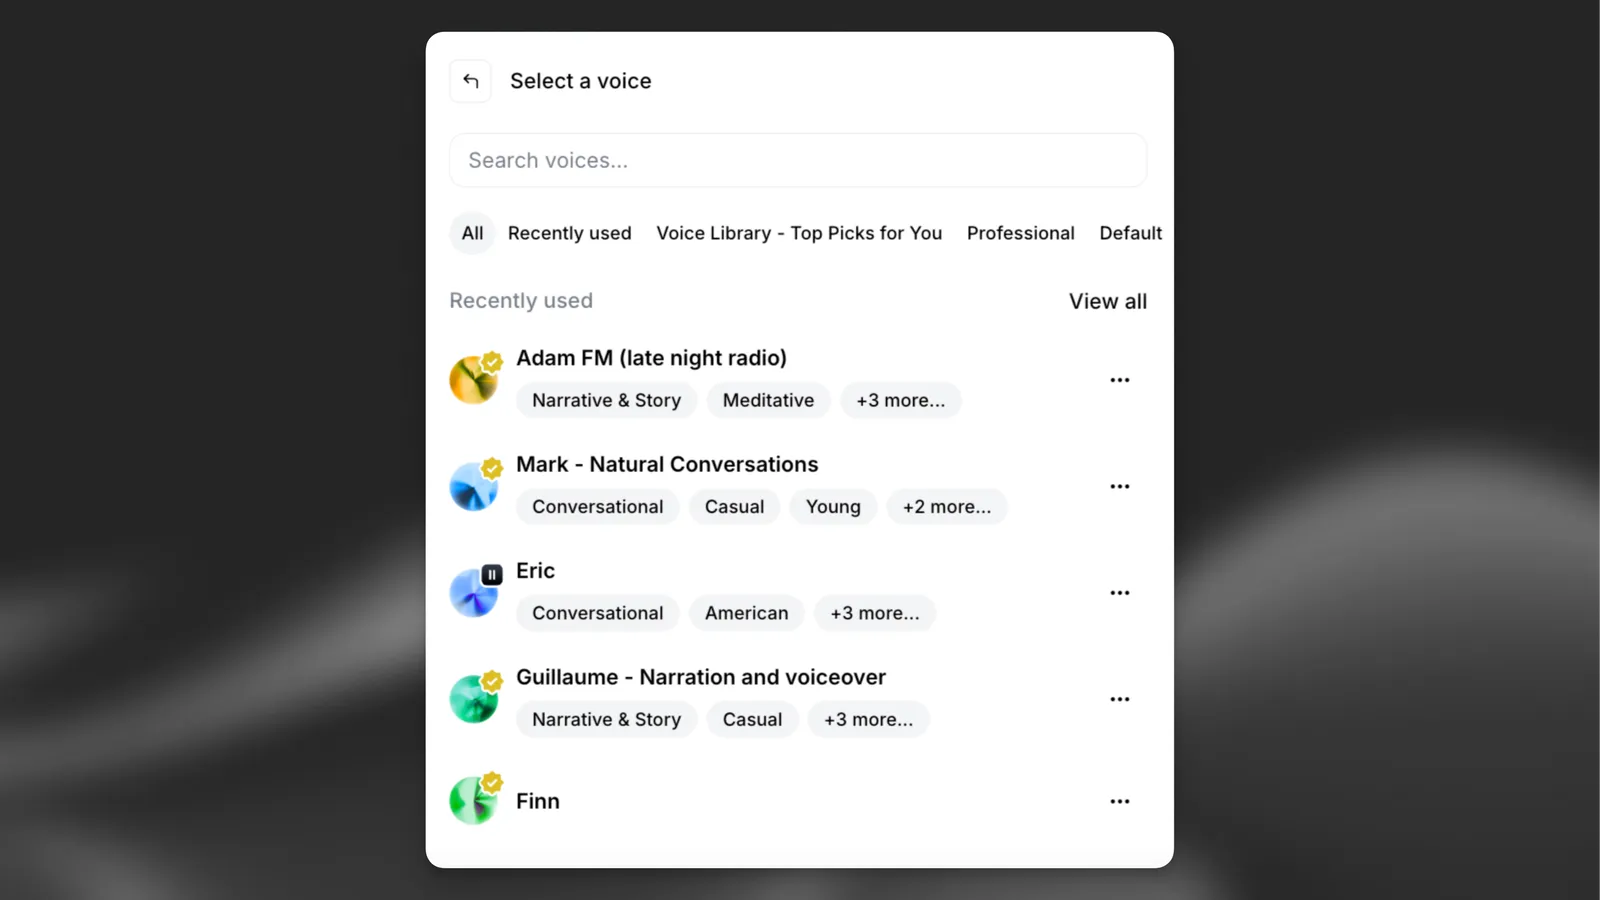
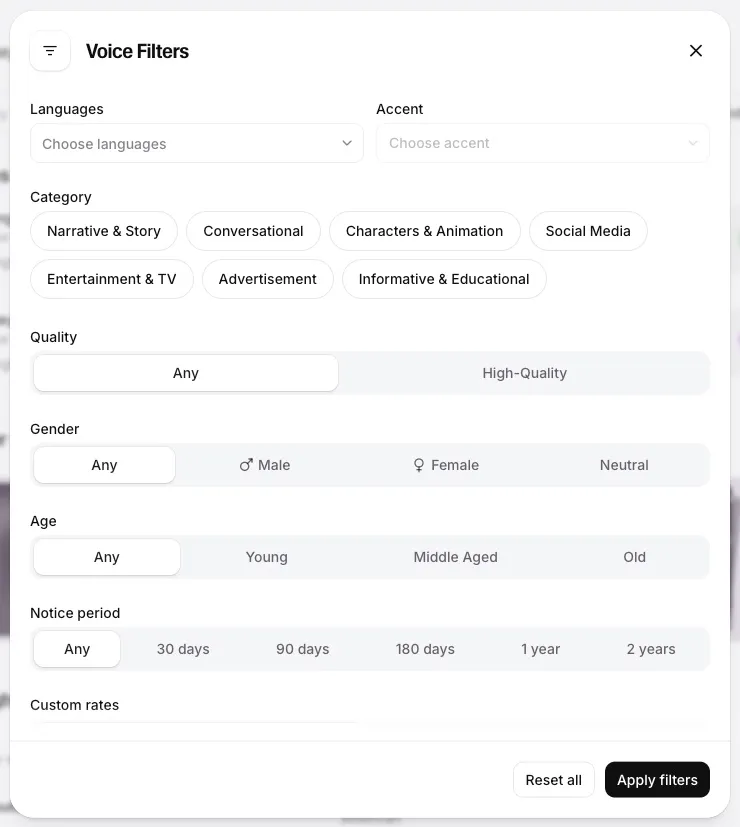
Nous proposons de nombreux types de voix, notamment les voix par défaut sélectionnées avec soin, notre vaste Voice Library with presque toutes les voix imaginables, des voix entièrement synthétiques créées avec notre outil Voice Design, ainsi que votre propre collection de voix clonées grâce à nos deux technologies : le clonage de voix instantané et le clonage de voix professionnel.
Toutes les voix ne se valent pas, et beaucoup dépend de l’audio source utilisé pour les créer. Certaines voix offriront une interprétation et un rendu plus humains, tandis que d’autres seront plus stables.
Choisir la voix adaptée à votre contenu est essentiel. Il s’agit probablement de la décision ayant le plus d’impact sur le résultat final. Elle détermine le genre, le ton, l’accent, le rythme et l’interprétation. Prenez le temps de sélectionner la voix idéale et de la tester correctement afin de vérifier sa cohérence et sa conformité à vos attentes.
Pour générer de la parole dans une langue donnée, vous obtiendrez les meilleurs résultats en utilisant une voix native de la Voice Library ou en clonant une voix qui parle cette langue avec le bon accent. Si toute voix peut techniquement parler n’importe quelle langue, elle conservera son accent d’origine. Par exemple, utiliser une voix anglaise native pour générer de la parole en français produira probablement un résultat en français, mais avec un accent anglais, car l’IA doit généraliser la manière dont cette voix sonnerait dans une langue sur laquelle elle n’a pas été entraînée.
Si vous appréciez une voix, mais souhaitez une interprétation différente, notre outil de remixage de voix peut vous aider. Il vous permet d’utiliser des prompts en langage naturel pour modifier l’interprétation, le rythme, le ton, le genre et même les accents d’une voix. Lors de la modification d’un accent, la voix de base et l’accent cible sont très importants. Les résultats peuvent varier : cela fonctionne parfois parfaitement, tandis que d’autres fois, plusieurs essais sont nécessaires.
Le remixage de voix peut produire d’excellents résultats, mais ils ne seront généralement pas aussi bons qu’un clonage de voix professionnel correctement réalisé. Ils se rapprocheront davantage de ceux d’un clonage de voix instantané.
Gardez à l’esprit que le remixage de voix ne fonctionne qu’avec certaines voix. Par exemple, vous ne pouvez pas remixer les voix de la Voice Library ; vous pouvez uniquement remixer les voix que vous avez créées vous-même ou les voix par défaut.
Modèles
Modèles
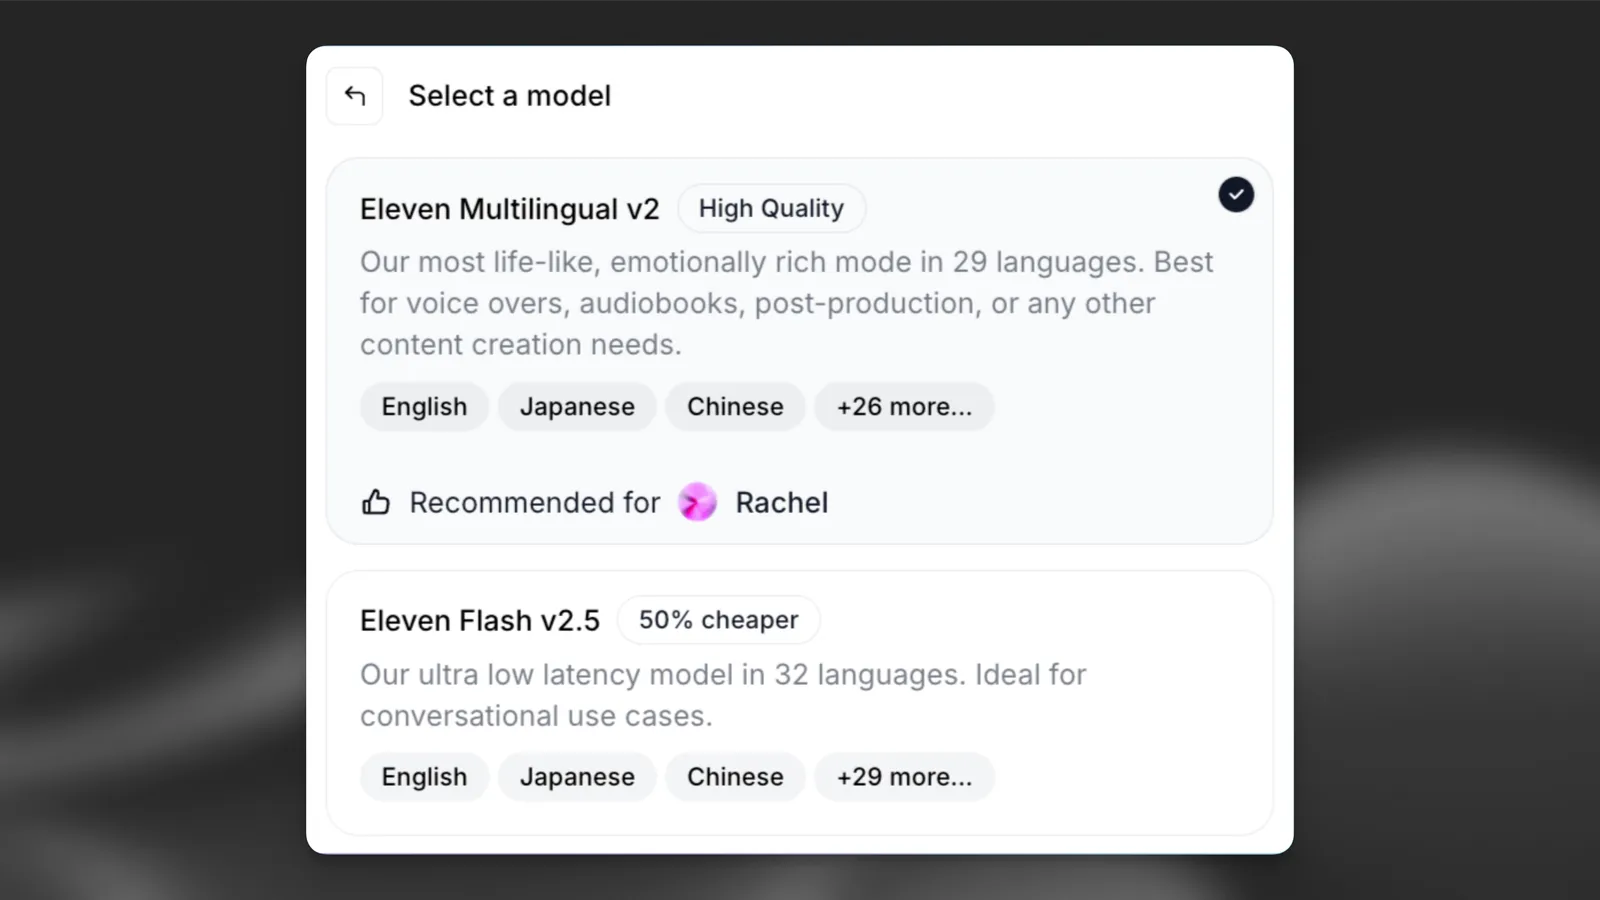
Nous proposons deux familles de modèles : les modèles Standard (haute qualité) et les modèles Flash, optimisés pour une latence extrêmement faible. La plupart des familles comprennent des versions uniquement en anglais et multilingues.
Eleven v4 est notre modèle le plus récent. Il existe en deux variantes : Eleven v4 et Eleven v4 Turbo.
Le choix du modèle est le deuxième facteur ayant le plus d’influence sur votre résultat audio final, après le choix de la voix. Nous vous recommandons de tester les différents modèles avec la voix choisie afin de trouver la meilleure combinaison. Tous nos modèles ont des forces et des faiblesses et fonctionnent mieux avec certaines voix qu’avec d’autres. Il est donc important de trouver une bonne association.
Si votre résultat est exclusivement en anglais, nous vous recommandons vivement d’utiliser l’un de nos modèles uniquement en anglais. Ils sont souvent plus faciles à utiliser, plus stables et offrent généralement de meilleures performances pour le contenu uniquement en anglais. Si votre contenu est dans une autre langue ou potentiellement multilingue, vous devez utiliser l’un des modèles multilingues.
Paramètres de voix
Paramètres de voix
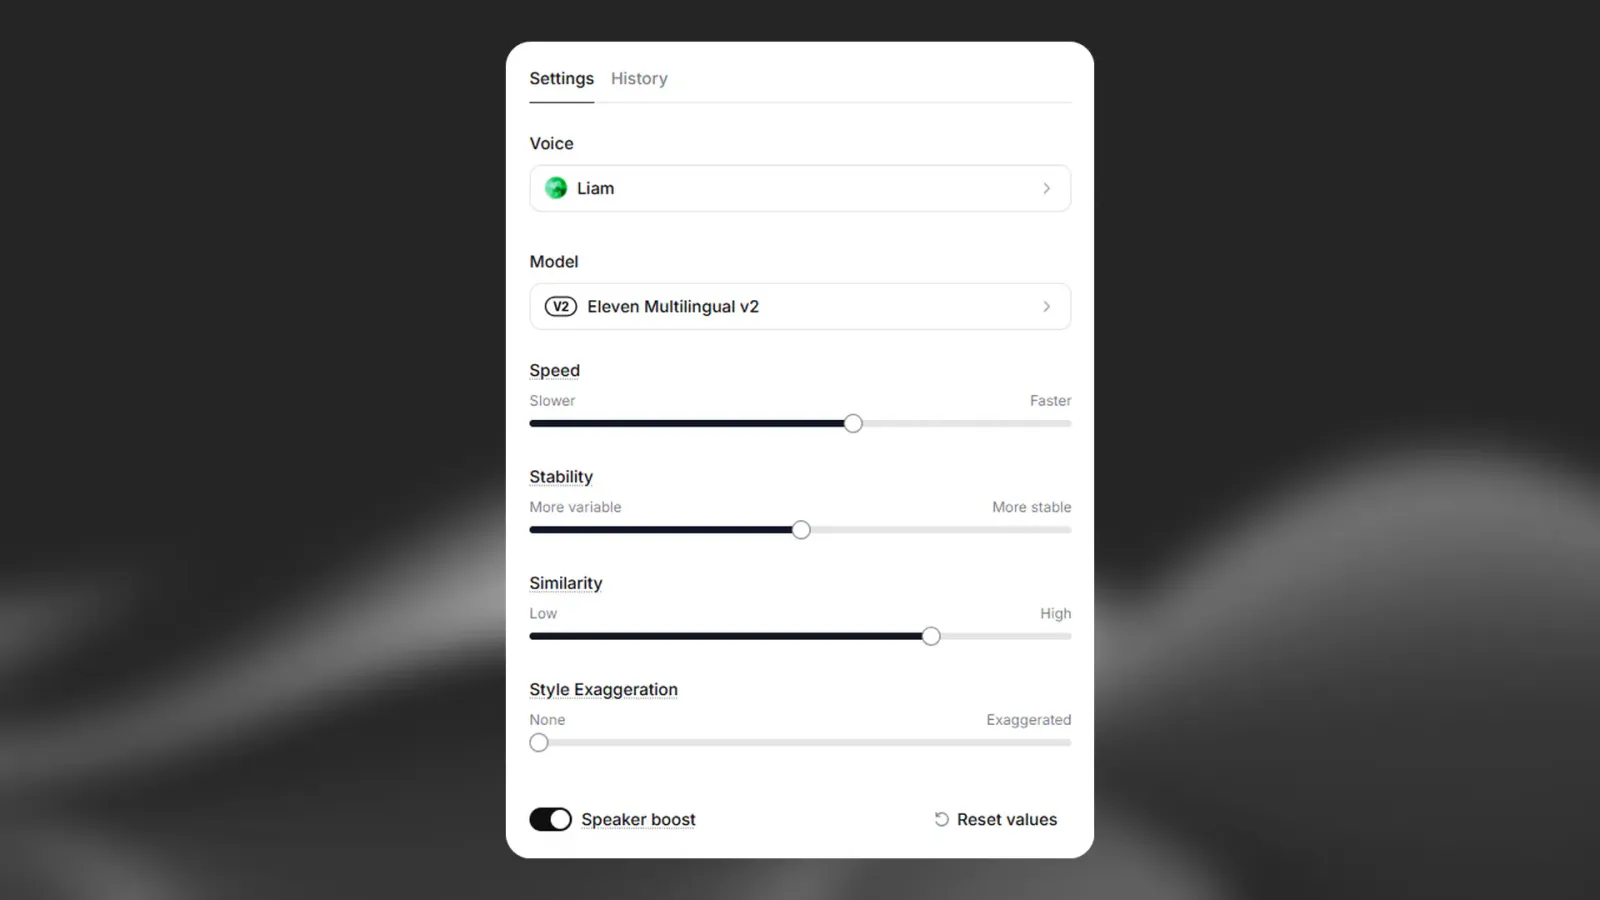
Le réglage le plus courant consiste à définir la stabilité autour de 50, la similarité autour de 75 et le style à 0, puis à n’apporter que des modifications minimes. Bien sûr, tout dépend de la voix d’origine et du style d’interprétation recherché.
Il est important de noter que l’IA est non déterministe : régler les curseurs sur des valeurs précises ne garantit pas les mêmes résultats à chaque fois. Les curseurs fonctionnent plutôt comme une plage qui détermine l’ampleur de la variation aléatoire possible entre chaque génération.
Vitesse
Le paramètre de vitesse permet d’accélérer ou de ralentir la parole générée. La valeur par défaut est 1.0, ce qui signifie que la vitesse n’est pas modifiée. Les valeurs inférieures à 1.0 ralentissent la voix, jusqu’à un minimum de 0.7. Les valeurs supérieures à 1.0 accélèrent la voix, jusqu’à un maximum de 1.2. Les valeurs extrêmes peuvent affecter la qualité de la parole générée.
Stabilité
Le curseur de stabilité détermine la stabilité de la voix et le caractère aléatoire entre chaque génération. Réduire ce curseur élargit la palette émotionnelle de la voix. Comme indiqué précédemment, cela dépend également fortement de la voix d’origine. Régler le curseur trop bas peut entraîner des interprétations étranges, trop aléatoires, et faire parler le personnage trop rapidement. À l’inverse, le régler trop haut peut produire une voix monotone avec peu d’émotion.
Pour une interprétation plus vivante et dramatique, il est recommandé de régler le curseur de stabilité sur une valeur plus basse et de générer plusieurs fois jusqu’à obtenir une interprétation qui vous convient.
À l’inverse, pour une interprétation plus sérieuse, voire monotone à des valeurs très élevées, il est recommandé de régler le curseur de stabilité sur une valeur plus haute. Le résultat étant plus cohérent et plus stable, vous n’avez généralement pas besoin de générer autant d’échantillons pour obtenir le résultat souhaité. Testez différentes options pour trouver celle qui vous convient le mieux.
Similarité
Le curseur de similarité détermine dans quelle mesure l’IA doit respecter la voix d’origine lorsqu’elle tente de la reproduire. Si l’audio d’origine est de mauvaise qualité et que le curseur de similarité est réglé trop haut, l’IA peut reproduire des artefacts ou du bruit de fond lorsqu’elle tente d’imiter la voix, s’ils étaient présents dans l’enregistrement d’origine.
Exagération du style
Avec l’introduction des modèles plus récents, nous avons également ajouté un paramètre d’exagération du style. Ce paramètre tente d’amplifier le style du locuteur d’origine. Il consomme des ressources de calcul supplémentaires et peut augmenter la latence s’il est réglé sur une valeur autre que 0. Il est important de noter que l’utilisation de ce paramètre rend le modèle légèrement moins stable, car il cherche à accentuer et à imiter le style de la voix d’origine.
En règle générale, nous vous recommandons de toujours laisser ce paramètre à 0.
Speaker Boost
Ce paramètre augmente la similarité avec le locuteur d’origine. Toutefois, son utilisation nécessite une charge de calcul légèrement plus élevée, ce qui augmente la latence. Les différences apportées par ce paramètre sont généralement assez subtiles.
Effets audio
Effets audio
Les effets audio traitent la parole générée afin qu’elle donne l’impression d’avoir été enregistrée dans un lieu précis ou avec un appareil particulier. Ils sont appliqués après la génération et ne modifient pas le coût.
Ouvrez la section Effets audio du panneau de paramètres et cliquez sur Ajouter un effet. Chaque type d’effet ne peut être ajouté qu’une seule fois :
- Filtre : colore la voix, par exemple comme une ligne téléphonique, une vieille radio ou un robot.
- Bruit : ajoute en boucle un fond sonore, comme un café, un centre d’appels, une ville ou des frappes au clavier, sous la voix.
- Espace : place la voix dans une pièce ou un espace extérieur avec une réverbération adaptée, d’une petite pièce à une salle ou une forêt.
- Distance : définit la distance entre le locuteur et le microphone : Proche, Moyenne ou Lointaine.
Une fois un effet ajouté, cliquez sur Aperçu pour écouter les effets actuels appliqués à un exemple de voix avant de générer. Pour supprimer un effet, cliquez sur le bouton de suppression de sa ligne.
Les effets audio sont disponibles dans l’onglet Text to Speech. Pour appliquer des effets à un dialogue, utilisez le
paramètre audio_effects
de l’API Text to Dialogue.
Générer
Une fois votre voix sélectionnée, votre modèle choisi et vos paramètres configurés, le processus de génération est simple : saisissez du texte, appuyez sur « Générer la parole », puis l’audio est généré.
Bien que le processus soit très simple en apparence, le texte que vous fournissez est extrêmement important pour obtenir le résultat souhaité. Lorsque vous utilisez des mots qui peuvent être « hors distribution », c’est-à-dire des éléments que l’IA a rarement rencontrés pendant son entraînement, comme des noms étranges, des abréviations inhabituelles, des symboles ou même des émojis, vous risquez de perturber l’IA et de rendre le résultat plus instable. Les émojis et certains symboles sont particulièrement difficiles à interpréter correctement pour l’IA.
Lorsque vous utilisez Text to Speech via l’interface utilisateur, nous appliquons une étape de normalisation automatisée à votre saisie afin d’améliorer la lisibilité du texte et de faciliter son traitement par l’IA. Cette étape convertit généralement les symboles et les nombres en texte rédigé, ce qui indique à l’IA la prononciation correcte.
Nous vous recommandons vivement d’éviter d’écrire les nombres sous forme de chiffres ou d’utiliser des symboles, surtout lorsque vous utilisez des modèles multilingues, même si cela s’applique aussi aux modèles uniquement en anglais. Les nombres et les symboles s’écrivent de la même manière dans de nombreuses langues, mais se prononcent différemment. S’appuyer sur les chiffres crée donc une ambiguïté pour l’IA. Par exemple, le nombre « 1 » s’écrit de manière identique en anglais et dans de nombreuses autres langues, mais se prononce différemment. Écrire le nombre en toutes lettres, comme « un », évite à l’IA d’avoir à interpréter ce qu’elle doit faire.
Nous travaillons sur des flux de travail plus avancés qui vous permettront d’influencer l’interprétation et le rendu de l’IA à l’aide de ce que nous appelons les balises audio. Cette fonctionnalité est disponible dans Eleven v4 et Eleven v3. Si vous souhaitez en savoir plus sur cette fonctionnalité, nous vous recommandons de consulter notre guide de prompting.
FAQ
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|