

Ondersteuning voor meerdere stemmen
Laat je AI-agent schakelen tussen verschillende stemmen voor gesprekken met meerdere personages en betere verhalen.
Overzicht
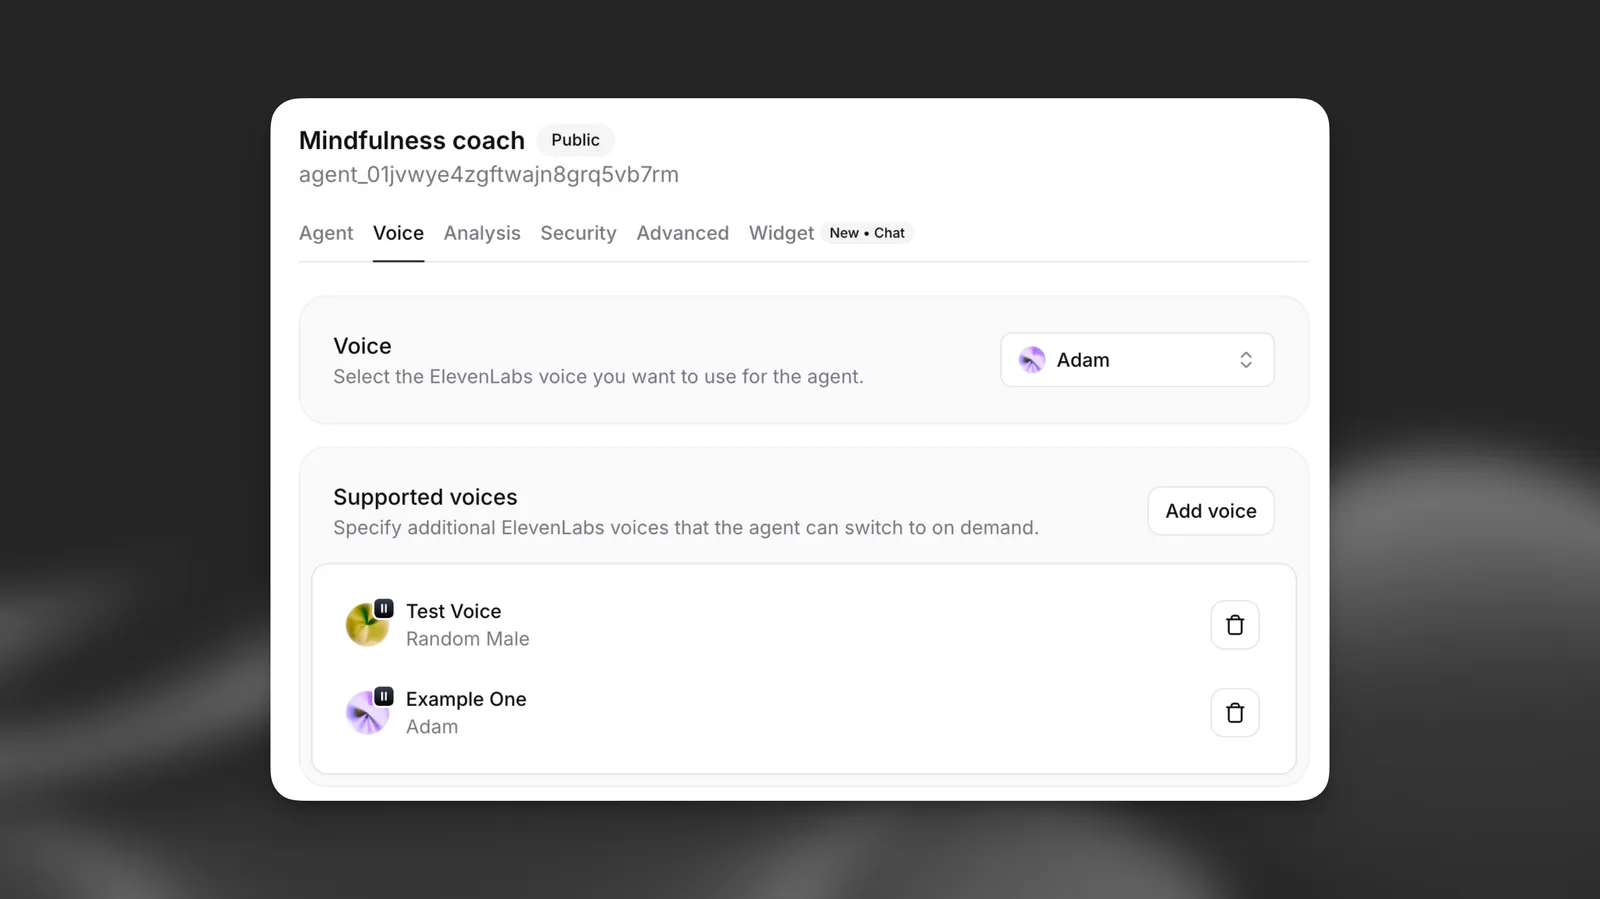
Met ondersteuning voor meerdere stemmen kan je ElevenLabs-agent tijdens één gesprek dynamisch schakelen tussen verschillende ElevenLabs-stemmen. Deze krachtige functie maakt het volgende mogelijk:
- Verhalen met meerdere personages: Verschillende stemmen voor verschillende personages in verhalen
- Taalbegeleiding: Stemmen van moedertaalsprekers voor verschillende talen
- Emotionele agents: Stemwijzigingen op basis van emotionele context
- Rollenspelscenario’s: Onderscheidende stemmen voor verschillende persona’s
Hoe het werkt
Wanneer ondersteuning voor meerdere stemmen is ingeschakeld, kan je agent XML-achtige markup gebruiken om tijdens het genereren van tekst tussen geconfigureerde stemmen te schakelen. De agent keert automatisch terug naar de standaardstem wanneer er geen specifieke stem is opgegeven.
Configuratie
Ondersteunde stemmen toevoegen
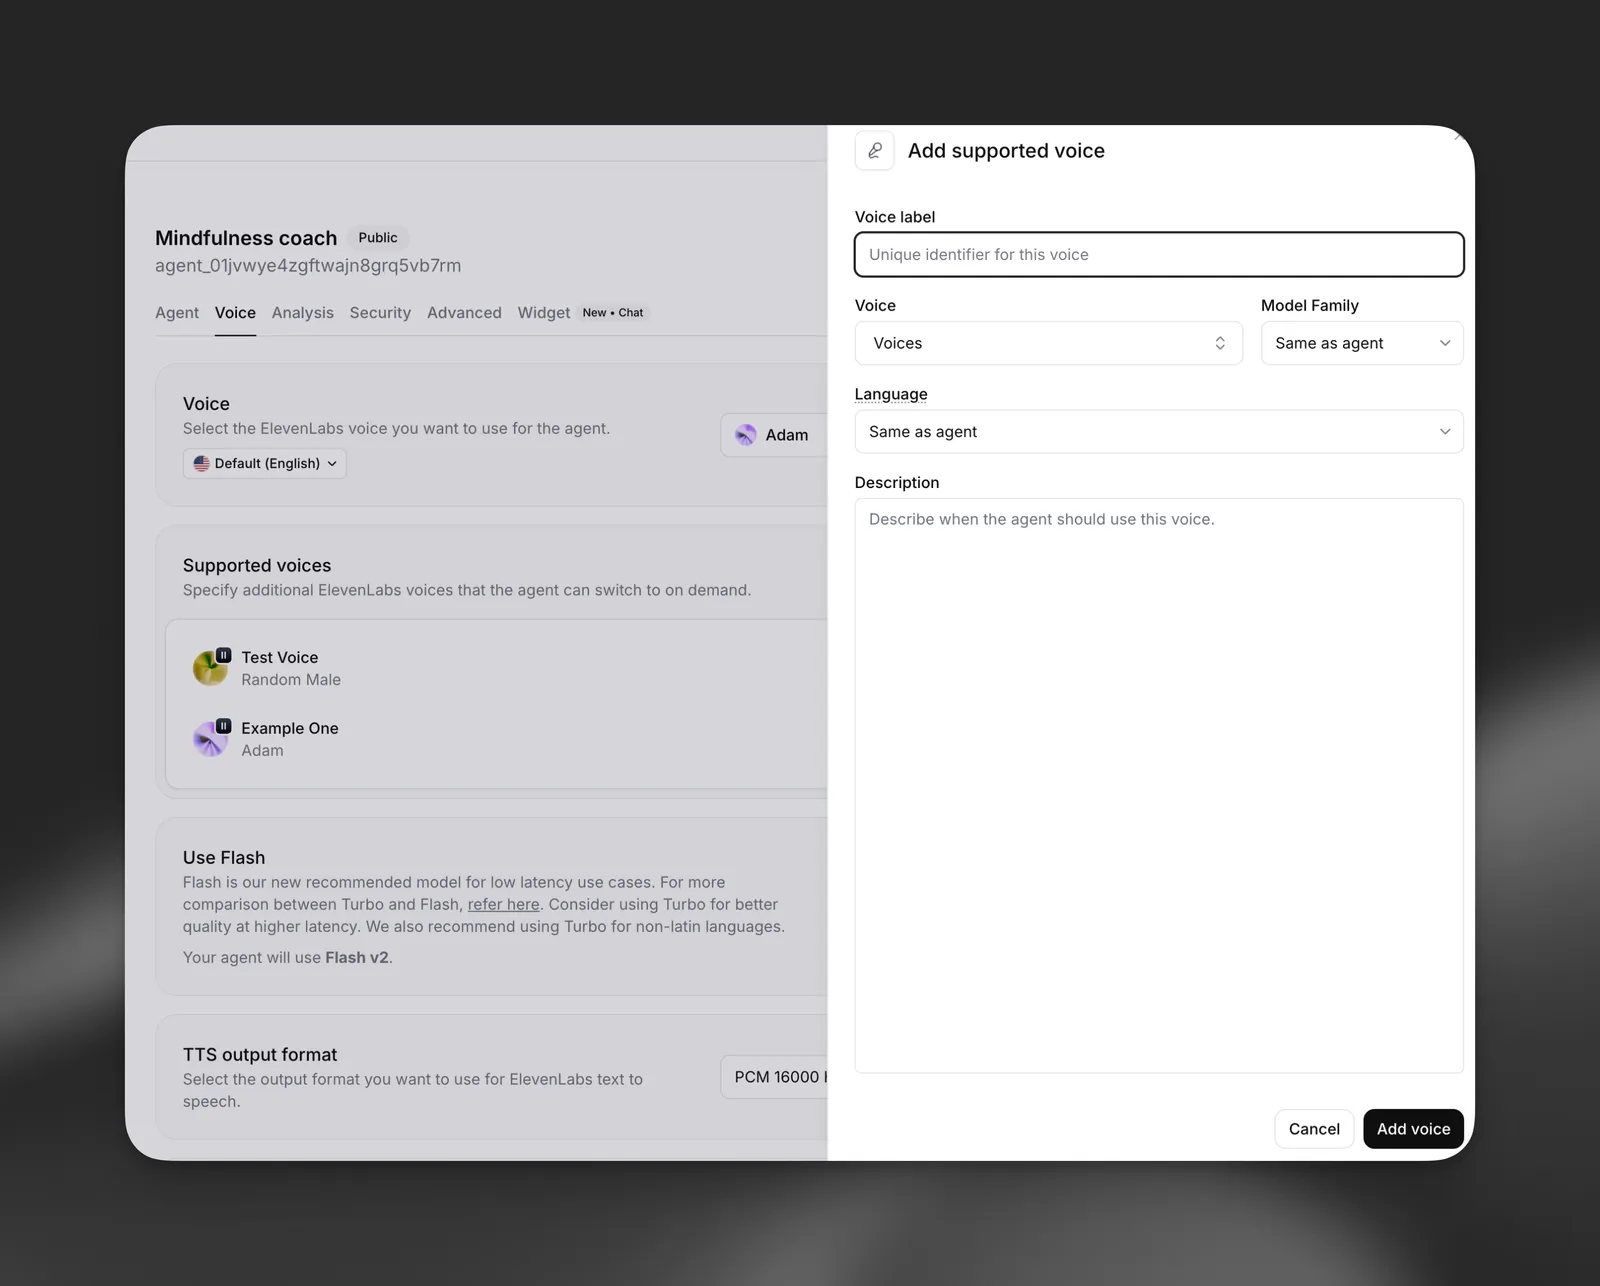
Elke ondersteunde stem heeft de volgende eigenschappen:
- Stemlabel: Unieke identificatie (bijv. “Joe”, “Spaans”, “Blij”)
- Stem: Selecteer uit je beschikbare ElevenLabs-stemmen
- Modelfamilie: Kies Turbo, Flash of Multilingual (optioneel)
- Taal: Overschrijf de standaardtaal voor deze stem (optioneel)
- Beschrijving: Wanneer de agent deze stem moet gebruiken
Bijwerken via het dashboard
Bijwerken via de CLI
Bijwerken via de API
Open je agent in het dashboard, ga naar het tabblad Voice en zoek de sectie Ondersteuning voor meerdere stemmen. Klik op Stem toevoegen om een nieuwe ondersteunde stem te configureren.
Stemeigenschappen
Stemlabel
Een unieke identificatie die de LLM gebruikt om naar deze stem te verwijzen. Kies beschrijvende labels zoals: - Namen van personages: “Alice”, “Bob”, “Verteller” - Talen: “Spaans”, “Frans”, “Duits” - Emoties: “Blij”, “Verdrietig”, “Enthousiast” - Rollen: “Docent”, “Student”, “Gids”
Modelfamilie
Overschrijf de standaardmodelfamilie van de agent voor deze specifieke stem: - Flash: Snelste generatie, geoptimaliseerd voor realtimegebruik - Turbo: Gebalanceerde snelheid en kwaliteit - Multilingual: Hoogste kwaliteit, het beste voor niet-Engelse talen - Zelfde als agent: Gebruik de standaardinstelling van de agent
Taaloverschrijving
Geef een andere taal op voor deze stem, handig voor: - Meertalige gesprekken - Toepassingen voor taalbegeleiding - Regiospecifieke uitspraken
Beschrijving
Geef context voor wanneer de agent deze stem moet gebruiken. Voorbeelden:
- “Voor Spaanse woorden of zinnen”
- “Wanneer de inhoud van het bericht vrolijk of enthousiast is”
- “Wanneer het personage Joe spreekt”
Implementatie
XML-markupsyntaxis
Je agent gebruikt XML-achtige tags om tussen stemmen te schakelen:
Belangrijke punten:
- Vervang
VOICE_LABELdoor het exacte label dat je hebt geconfigureerd - Tekst buiten tags gebruikt de standaardstem
- Tags zijn hoofdlettergevoelig
- Geneste tags worden niet ondersteund
Integratie met system prompts
Wanneer je ondersteunde stemmen configureert, voegt het systeem automatisch instructies toe aan de prompt van je agent:
Voorbeeldgebruik
Taalbegeleiding
Verhalen vertellen
Best practices
Stemselectie
- Kies stemmen die duidelijk onderscheid maken tussen personages of contexten
- Test stemcombinaties om te zorgen dat ze goed samenwerken
- Houd rekening met de emotionele toon en persoonlijkheid van elke stem
- Zorg dat stemmen bij de taal en het accent passen wanneer je van taal wisselt
Labels benoemen
- Gebruik beschrijvende, intuïtieve labels die de LLM kan begrijpen
- Houd labels kort en gemakkelijk te onthouden
- Vermijd speciale tekens of spaties in labels
Prestaties optimaliseren
- Beperk het aantal ondersteunde stemmen tot wat je daadwerkelijk nodig hebt
- Gebruik waar mogelijk dezelfde modelfamilie om de overhead van schakelen te beperken
- Test met je verwachte gesprekspatronen
- Monitor reactietijden bij meerdere stemwisselingen
Richtlijnen voor content
- Geef duidelijke beschrijvingen van wanneer elke stem moet worden gebruikt
- Test edge cases waarin stemwisselingen onduidelijk kunnen zijn
- Houd rekening met fallbackgedrag wanneer stemlabels dubbelzinnig zijn
- Zorg dat stemwisselingen het gesprek verbeteren en niet afleiden
Beperkingen
- Maximaal 10 ondersteunde stemmen per agent (inclusief standaardstem)
- Stemwisselingen voegen tijdens het genereren minimale latentie toe
- XML-tags moeten correct zijn opgemaakt en gesloten
- Stemlabels in markup zijn hoofdlettergevoelig
- Geneste stemtags worden niet ondersteund
Veelgestelde vragen
Wat gebeurt er als ik een niet-gedefinieerd stemlabel gebruik?
Als de agent een stemlabel gebruikt dat niet is geconfigureerd, wordt de tekst uitgesproken met de standaardstem. De XML-tags worden genegeerd.
Kan ik midden in een zin van stem wisselen?
Ja, je kunt binnen één reactie van stem wisselen. Elke getagde sectie gebruikt de opgegeven stem, terwijl tekst zonder tags de standaardstem gebruikt.
Hebben stemwisselingen invloed op de gesprekslatentie?
Stemwisselingen voegen minimale overhead toe. Het eerste gebruik van elke stem in een gesprek kan iets meer latentie hebben wanneer de stem wordt geïnitialiseerd.
Kan ik dezelfde stem met verschillende labels gebruiken?
Ja, je kunt meerdere labels configureren die dezelfde ElevenLabs-stem gebruiken, maar met verschillende modelfamilies, talen of contexten.
Hoe leer ik mijn agent om stemwisselingen effectief te gebruiken?
Geef duidelijke voorbeelden in je system prompt en test grondig. Je kunt specifieke scenario’s opnemen waarin stemwisselingen moeten plaatsvinden en voorbeelden van de XML-markupindeling.