

Uttalslexikon
Lär dig styra hur din AI-agent uttalar specifika ord och fraser.
Översikt
Uttalslexikon gör att du kan anpassa hur din AI-agent uttalar specifika ord eller fraser. Det är särskilt användbart för att:
- Korrigera uttalet av namn, platser eller tekniska termer
- Säkerställa ett konsekvent uttal i alla samtal
- Anpassa regionala uttalsvariationer
Konfiguration
Fonemtaggar i uttalslexikon fungerar endast med modellerna eleven_v4, eleven_flash_v2 och eleven_v3.
Andra modeller hoppar över fonemtaggar i lexikon och använder standarduttalet. För andra modeller använder du i stället aliastaggar för att ersätta stavningar eller fraser som ger det uttal du behöver.
Om du vill använda IPA- och CMU-uttal på andra språk än engelska måste du byta till modellerna eleven_v3 eller eleven_v4.
Koppla ett lexikon till din agent
Uppdatera via dashboarden
Uppdatera via CLI
Uppdatera via API
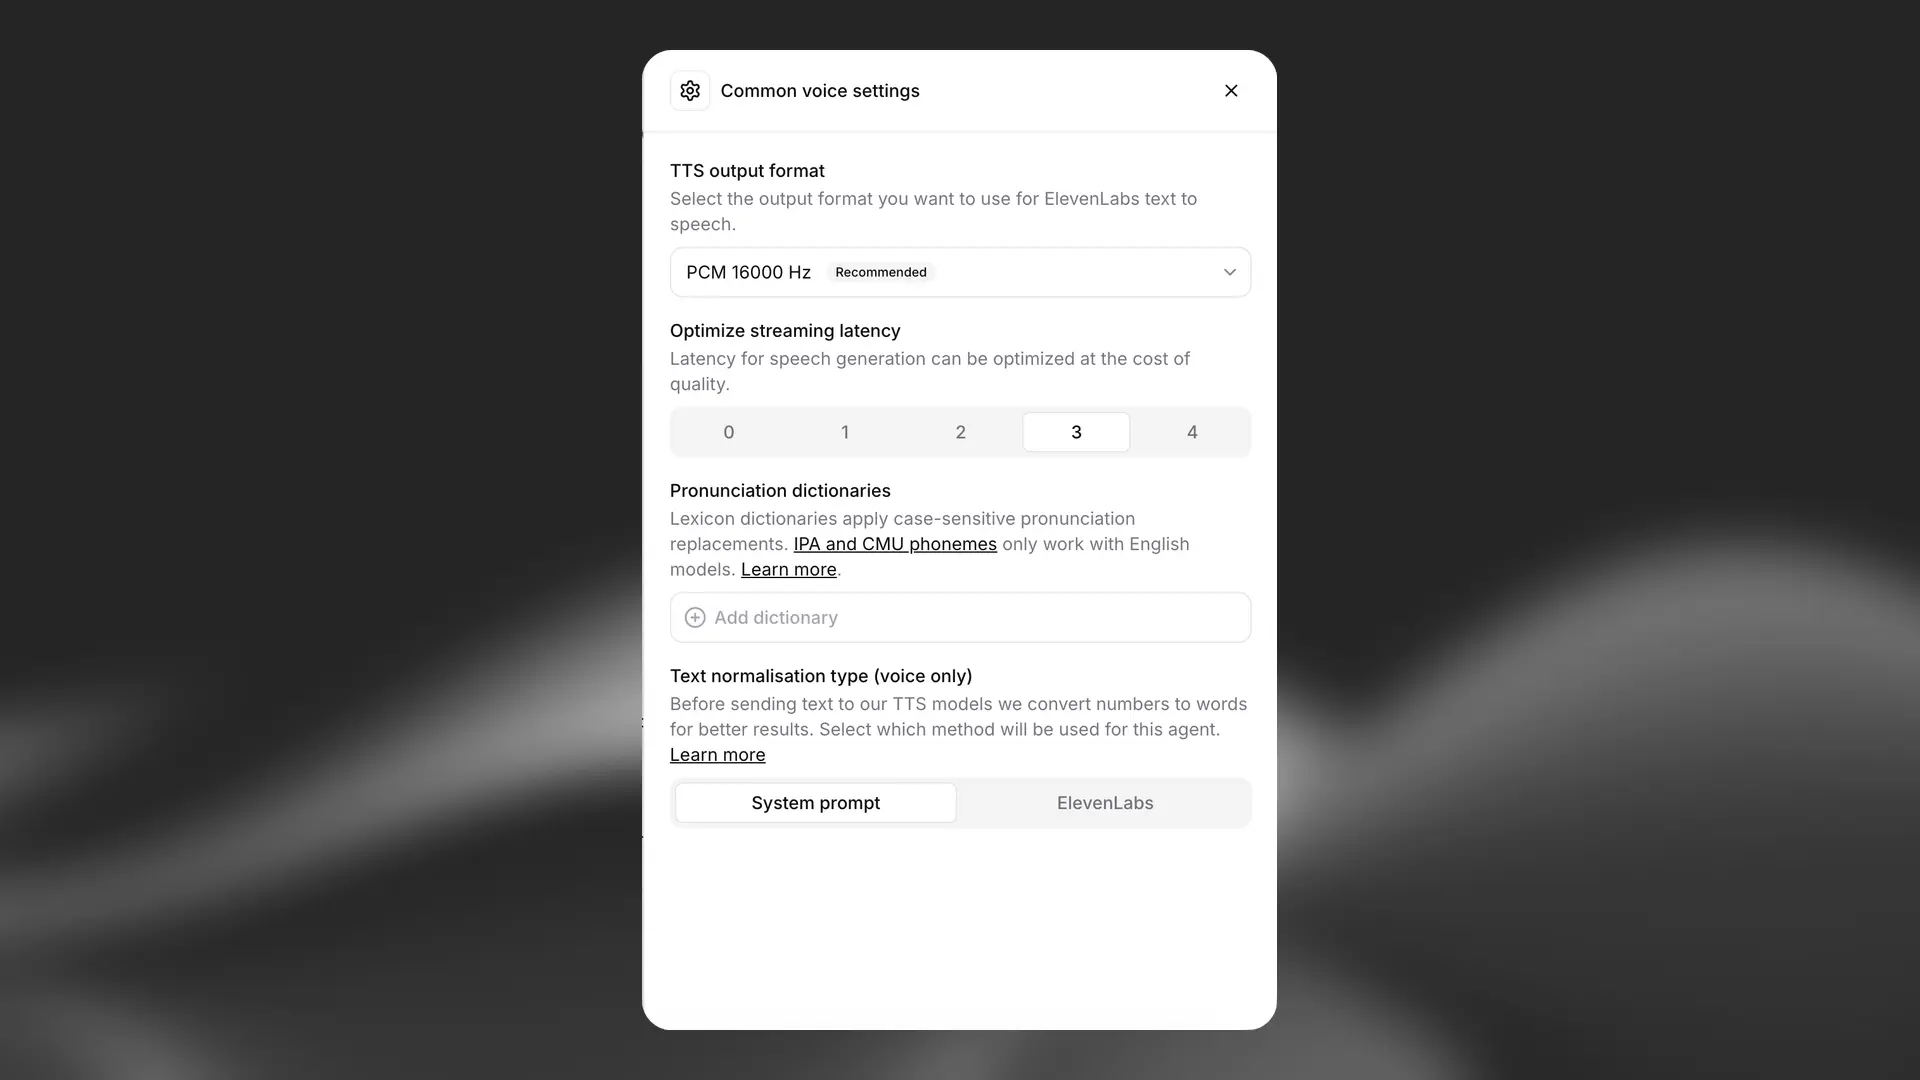
Öppna din agent i dashboarden, gå till Röstinställningar och lägg till ett uttalslexikon. Spara ändringarna.
Lexikonfilformat
Uttalslexikon använder XML-baserade .pls-filer. Här är ett exempel på strukturen:
Format som stöds
Uttalslexikon stöder två typer av uttalsnotation:
-
IPA (International Phonetic Alphabet)
- Mer exakt kontroll över uttal
- Kräver kunskap om IPA-symboler
- Exempel: “nginx” som
/ˈɛndʒɪnˈɛks/
-
CMU-format (Carnegie Mellon University Dictionary)
- Enklare ASCII-baserat format
- Mer tillgängligt för engelska uttal
- Exempel: “tomato” som “T AH M EY T OW”
Du kan använda AI-verktyg som Claude eller ChatGPT för att få hjälp att generera IPA- eller CMU-notationer för specifika ord.
Bästa praxis
- Skiftlägeskänslighet: Skapa separata poster för ord med stor och liten begynnelsebokstav vid behov
- Testning: Testa alltid uttal med den röst och modell du har valt
- Underhåll: Håll ditt lexikon organiserat och dokumenterat
- Omfattning: Fokusera på ord som ofta uttalas fel eller är viktiga för ditt användningsområde
Vanliga frågor
Vilka modeller stöder fonembaserat uttal?
Fonemtaggar i uttalslexikon fungerar endast med modellerna eleven_v4, eleven_flash_v2 och eleven_v3.
Andra modeller hoppar över fonemtaggar i lexikon och använder standarduttalet. För andra modeller använder du i stället aliastaggar för att ersätta stavningar eller fraser som ger det uttal du behöver.
Om du vill använda IPA- och CMU-uttal på andra språk än engelska måste du byta till modellen eleven_v4 eller eleven_v3.
Kan jag använda flera lexikon?
Ja, du kan ladda upp flera lexikonfiler för att hantera olika uppsättningar av uttal.
Vad händer om ett ord inte finns i lexikonet?
Modellen använder sina standardregler för uttal för alla ord som inte anges i lexikonet.