音声AIインフラ:2026年のスタックを解説
- 公開日
音声AIインフラとは、AIエージェントが通話を聞き、次の対応を判断し、他のシステムで処理を実行して、音声で応答するためのモデル、接続、ツール、サービスの一式です。ElevenLabsのような主要プロバイダーを使えば、これらすべてが一瞬で行われます。
本番環境の音声エージェントは、音声認識、ターンテイキング、大規模言語モデル、オーケストレーション、ツール、知識検索、音声合成、電話通信、モニタリングなどのレイヤーで構成されるスタック上で動作します。
このガイドでは、実用的な音声エージェントを支えるAIエージェントアーキテクチャを解説します。各セクションでは、レイヤーの役割、インフラ全体における重要性、ElevenAgentsでの実装方法を説明し、音声レイヤーの例としてEleven v4を取り上げます。
音声AIインフラの仕組み
音声エージェントは、オーディオをテキストに変換し、その入力を基に推論して回答を生成し、顧客が聞くオーディオへ再変換します。この一連の処理は、堅牢なAIエージェントアーキテクチャのスタックで成り立っています。
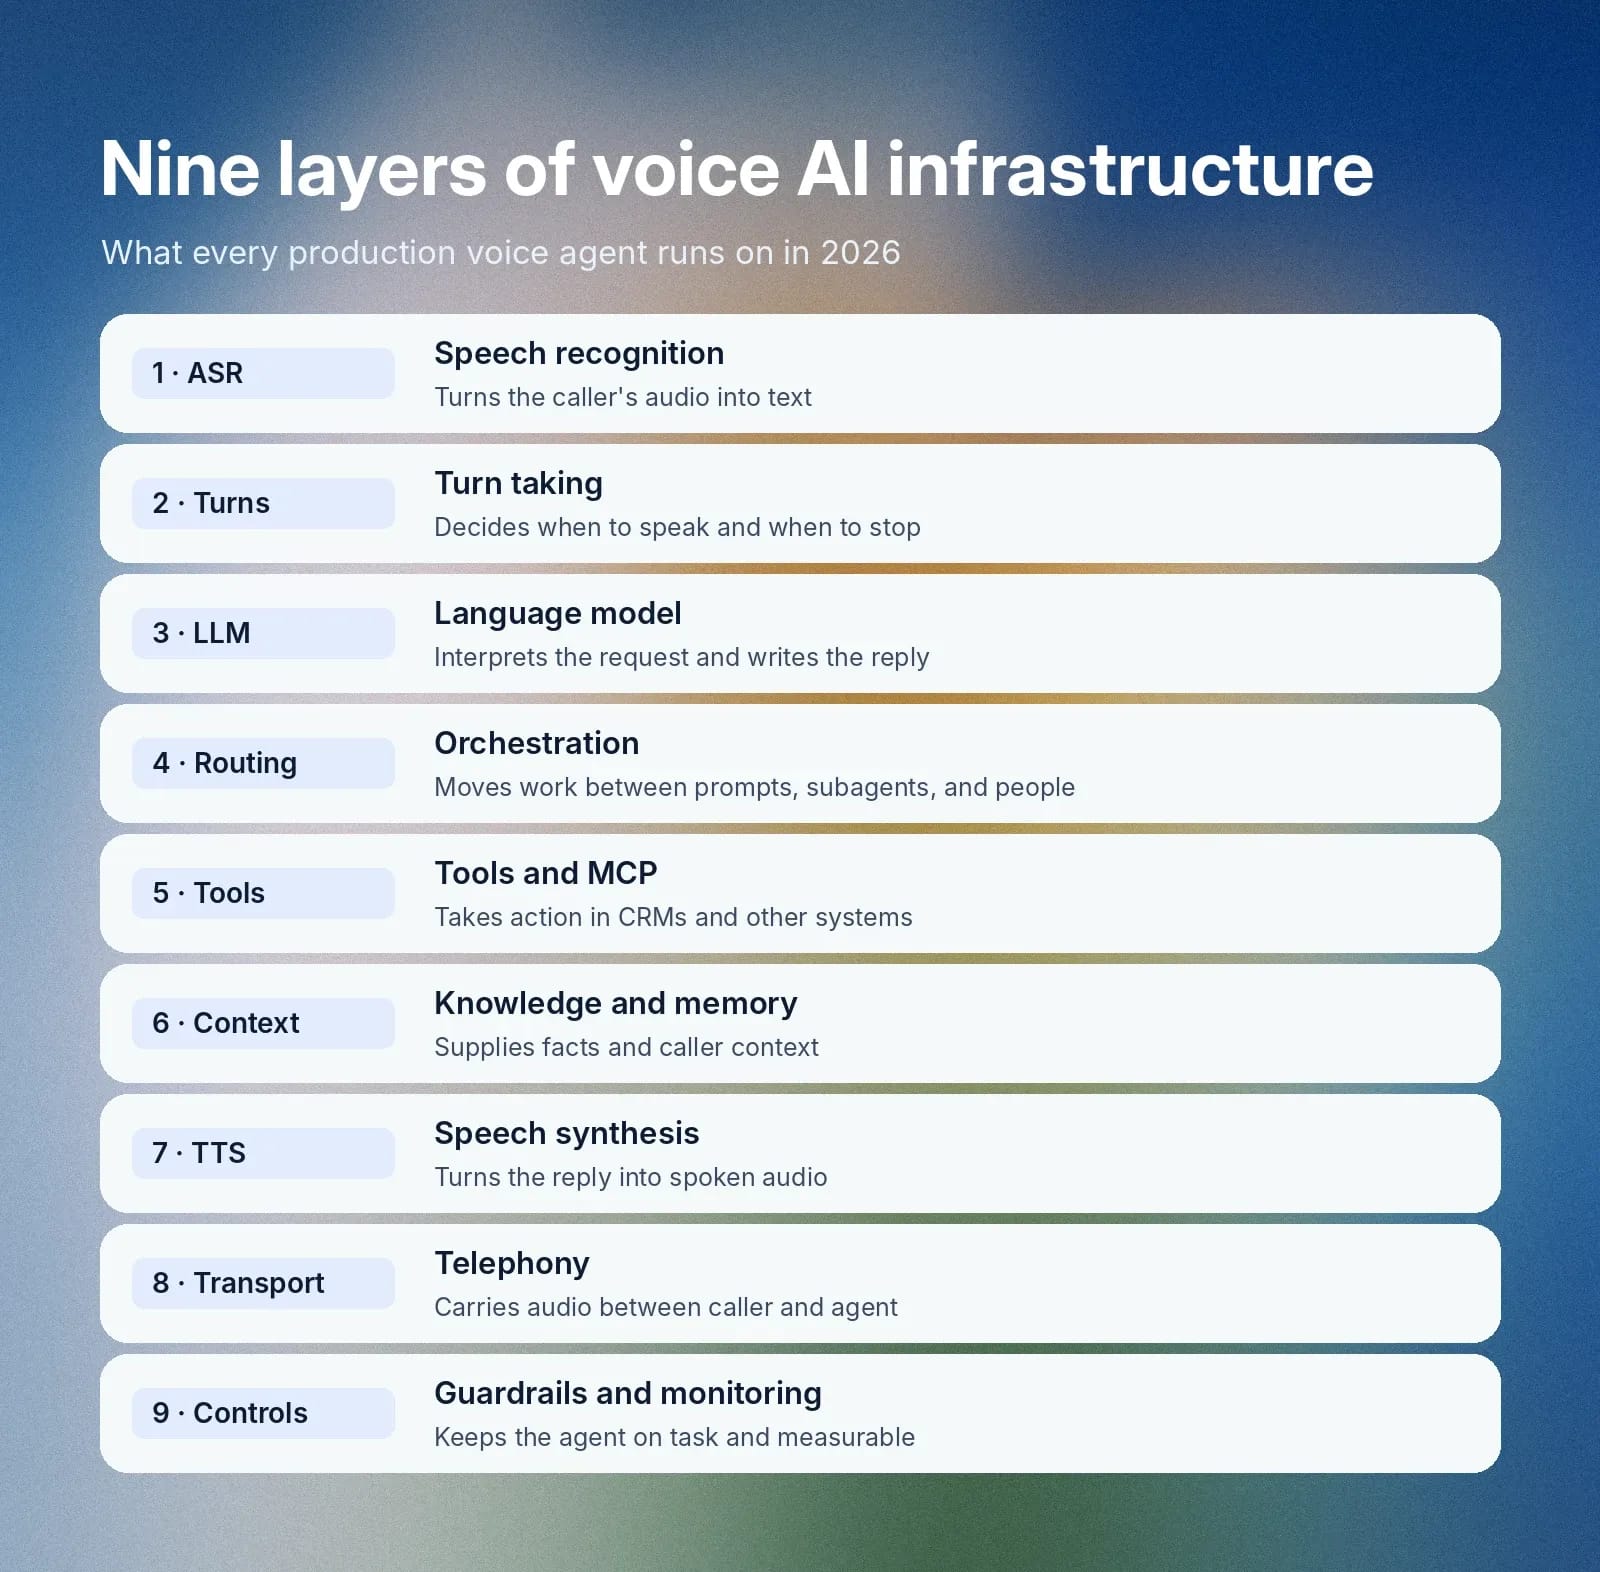
2026年の音声AIインフラを構成する主なレイヤーは次のとおりです。
- 音声認識:自動音声認識(ASR)技術が、発信者の音声を処理用のテキストに変換します。
- ターンテイキング:ターンテイキングにより、発信者が話し終えたタイミングとエージェントが話すのを止めるタイミングを判断し、より自然で応答性の高い会話を実現します。
- 言語モデル:必要なコンテキストを取得したうえで、文字起こしされたリクエストを解釈し、回答を生成します。
- オーケストレーション:AIオーケストレーションレイヤーが、プロンプト、サブエージェント、ツール、人間の間で会話を振り分けます。
- ツールとMCP:エージェントをCRMプラットフォームやコンタクトセンターなどの外部システムに接続し、タスクを実行します。
- 知識とメモリ:検索拡張生成を通じて、事実情報と発信者のコンテキストを提供します。
- 音声合成:テキスト読み上げを使って、生成されたテキストの回答をオーディオに変換します。
- 伝送と電話通信:エージェントと発信者の間でオーディオを伝送します。
- ガードレール、テスト、モニタリング:エージェントを目的に沿って動作させ、測定可能な状態に保ちます。
これらのコンポーネントが連携し、AIエージェントと電話をかけてきた顧客とのリアルタイムな会話を実現します。
音声AIアーキテクチャ図
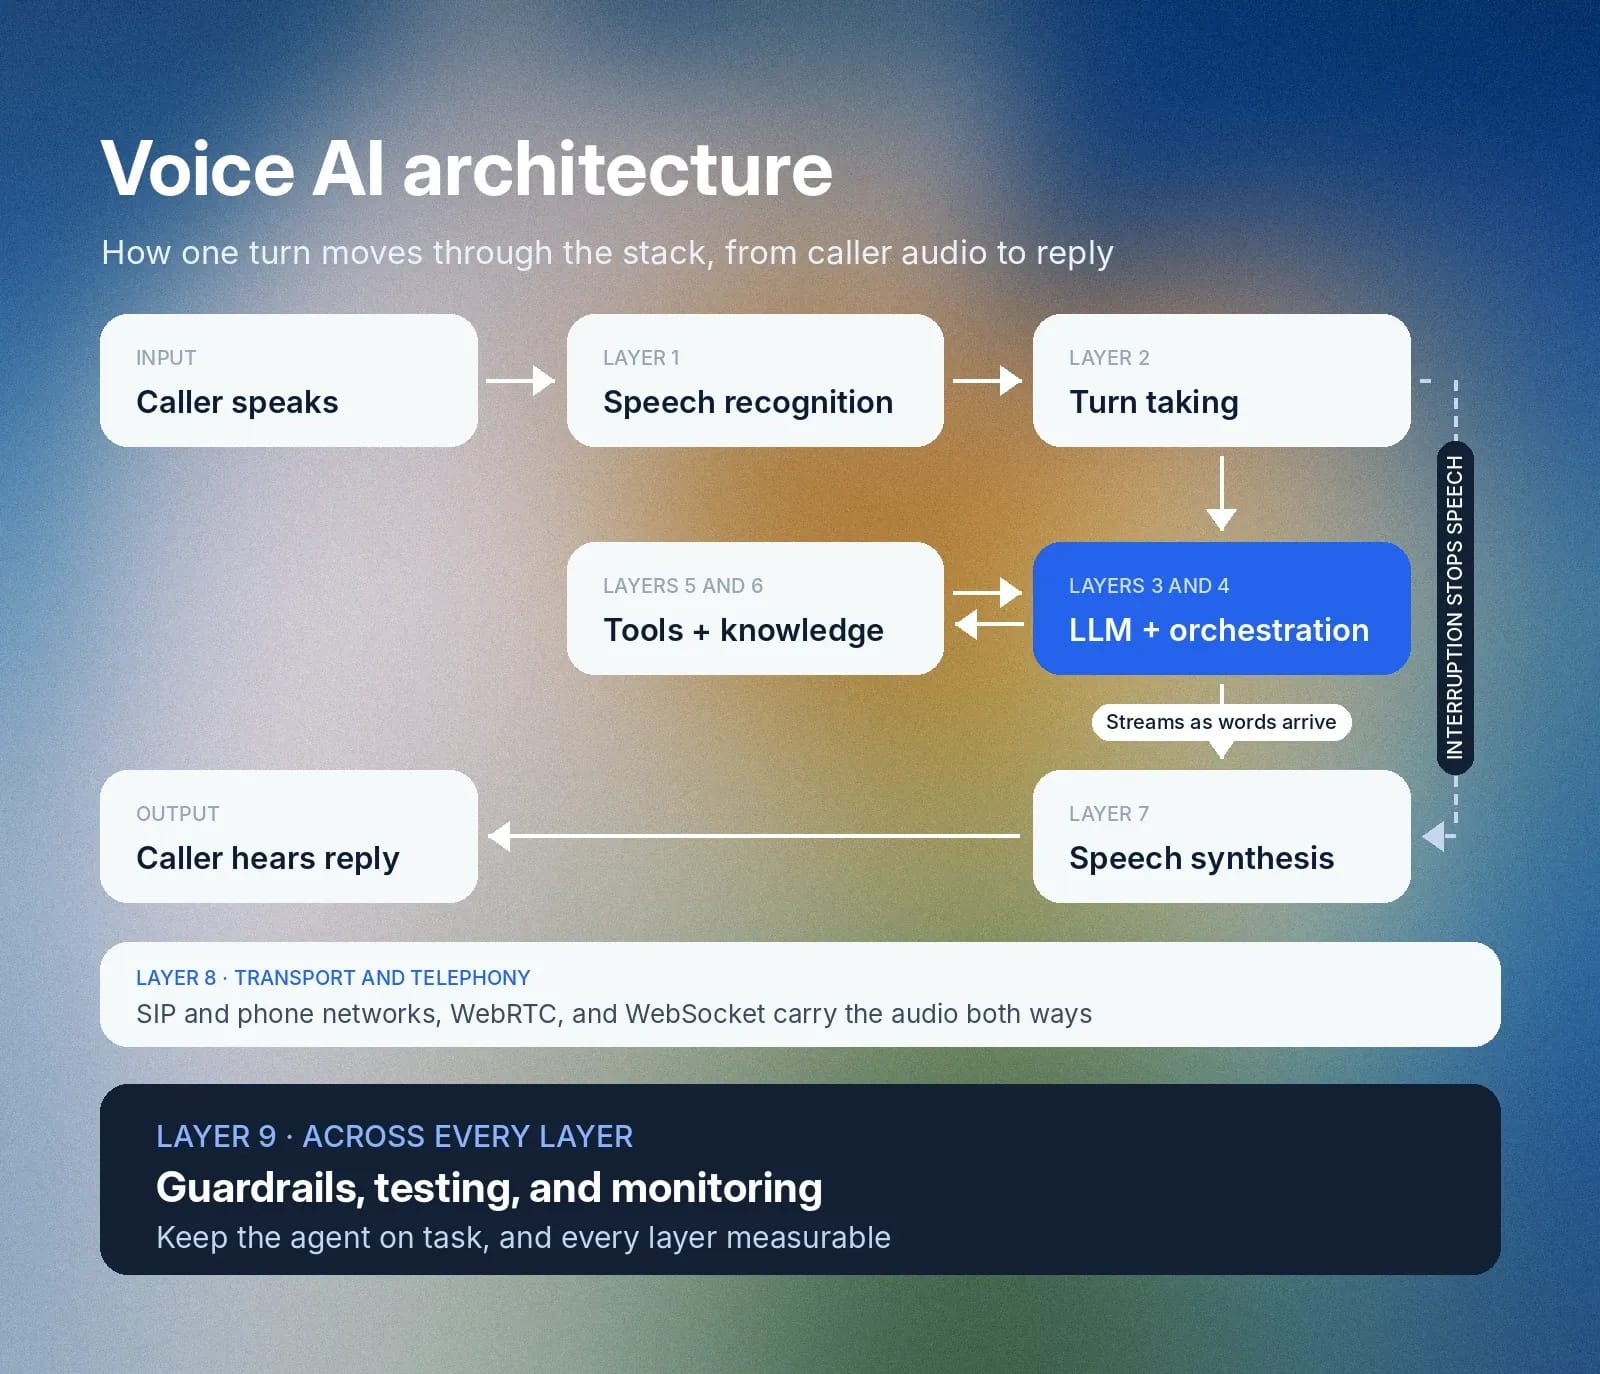
処理フローは一直線ではありません。ElevenAgentsは、言語モデルから「十分な単語とコンマ」を受け取った時点で発話を開始するため、回答全体が完成する前にオーディオが再生されます。ツール呼び出しと検索はターンの途中で実行されます。音声の生成中に割り込みが入っても、エージェントが自然に対応します。
音声AIアーキテクチャを構築する2つの方法
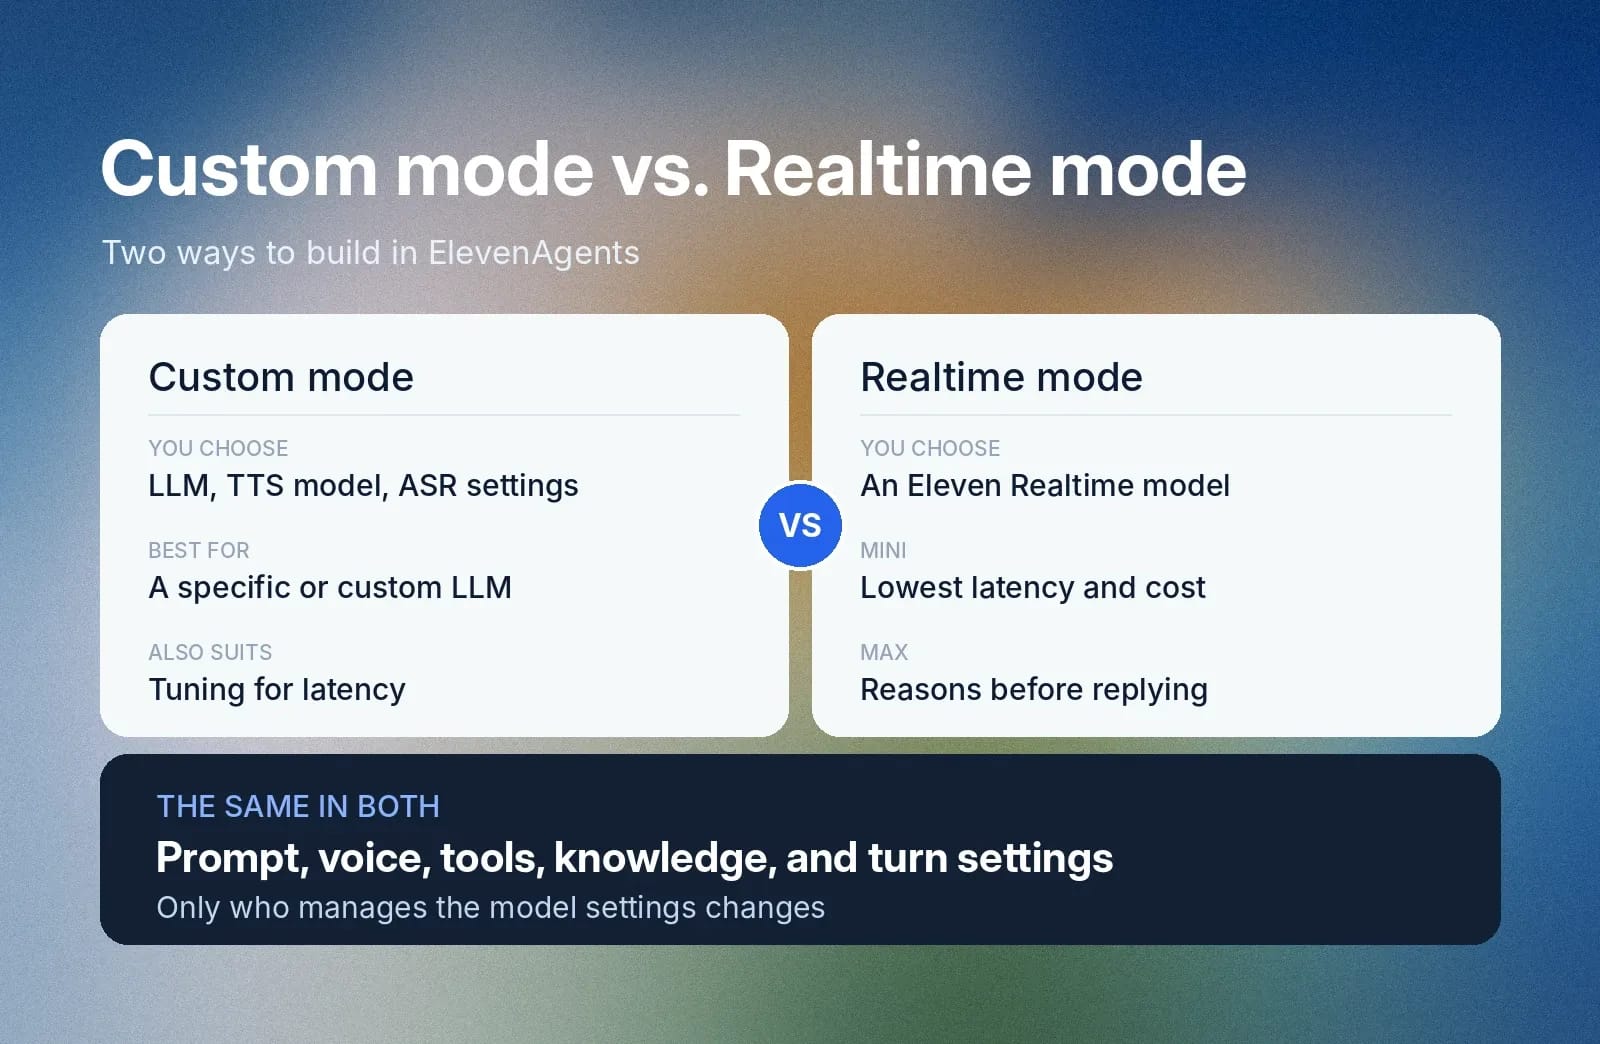
ElevenAgentsは2つの音声モードに対応しています。カスタムモードでは、言語モデル、テキスト読み上げモデル、音声認識設定を自分で選択します。
リアルタイムモードでは、Eleven Realtimeモデルを選択すると、ElevenLabsが設定を管理します。デフォルトのEleven Realtime v1 Miniは、レイテンシとコストが最も低いモデルです。Eleven Realtime v1 Maxは回答前に推論するため、より複雑な指示や複数ステップのツール利用が必要なケースに適しています。
システムプロンプト、選択した音声、ツール、接続したナレッジベース、ターン設定は、どちらのモードでも同じように機能します。特定の言語モデル、カスタムLLM、またはパフォーマンスやレイテンシ最適化のために特定のTTSモデルが必要な場合は、カスタムモードが適しています。
音声認識:オーディオをテキストに変換
ASRまたはスピーチtoテキストとも呼ばれる音声認識は、スタックの最初のレイヤーです。
機能
モデルは、発信者が話している間、その音声を継続的に文字起こしします。継続的に処理することで、文が終わる前にパイプラインの残りの部分が動き始め、レイテンシを短縮できます。高度なモデルは、強いアクセントやさまざまな話速からバックグラウンドノイズまで対応します。
音声AIインフラで重要な理由
文字起こしは、スタックで最も重要なレイヤーの一つです。ここで生じたエラーは、後続のすべての段階に波及するためです。予約番号を聞き間違えれば、誤った顧客レコードが処理されます。薬の名前を間違えれば、重大な事態につながりかねません。
ElevenLabsは医療向けトラストフレームワークで、たった1音節の聞き間違いがどれほど重大になり得るかを、ヒドロキシジンとヒドララジンを例に示しています。
ElevenAgentsでの仕組み
ElevenAgentsは、約150msで音声を文字起こしするScribe v2 Realtimeを使用します。ElevenLabsは、騒がしい環境、多様なアクセント、氏名、メールアドレス、IDなどの識別子に対応できるよう、このモデルをトレーニングしました。30言語を対象としたFLEURS多言語ベンチマークでは、低レイテンシASRモデルの中で最も低い単語誤り率を記録したとElevenLabsは報告しています。
エージェント設定の「詳細」セクションで有効にできます。前述のホワイトペーパーでは、公開されているEka Medical ASRベンチマークにおいて、公開時点でScribe v2 Medicalが単語誤り率7.0%を記録し、すべてのモデルを上回ったとElevenLabsは報告しています。
正確かつ高速な文字起こしにより、大きなレイテンシを加えることなく、後続レイヤーに必要なクリーンな入力を提供できます。
ターンテイキング:話すタイミングと止めるタイミングを判断
ターンテイキングとは、エージェントが応答するタイミングと聞くタイミングを決めるルールの集まりです。会話のターンを正しく理解して対応できることが、自然な会話と従来型のIVR電話メニューを分けます。
機能
ターンテイキングコンポーネントは、音声AIインフラに次のような機能を提供します。
- 音声区間検出(VAD):VADは、受信オーディオを音声または無音として1秒間に数十回分類します。
- ターン終了検出:声の調子、リズム、単語のコンテキストから、発信者が話し終えたかを判断します。
- 割り込み:発信者が途中で割り込めるようにし、その時点でエージェントが発話を止め、ユーザーが話を続けられるようにします。
- 相づち:「はい」など、発話権を取らない短い応答です。
重要な理由
人間同士の会話では、話者間の一般的な間隔は約200msです。エージェントが早すぎるタイミングで答えると発信者の話を遮り、待ちすぎると沈黙が生まれ、通話が途切れた、または反応していないように感じられます。
たとえば、発信者が「金曜の午後に予約したいのですが……」と言って間を置いたとします。無音タイマーはその間で応答を始め、後に続く条件を聞き逃します。単語とリズムを読むモデルなら待機し、「忙しいので、午後3時から5時の間は避けてください」と最後まで話せるようにします。
一方のエージェントは発信者の意図を誤って判断し、間違った時間に予定を入れます。もう一方は、適切なターンテイキングによって指定された時間帯を確実に避けます。
ElevenAgentsでの仕組み
ElevenAgentsは、無音タイマーだけに頼らず、声の調子、リズム、単語のコンテキストを分析する独自のターンテイキングモデルを使用します。発信者が割り込むと、エージェントを停止する信号が200ms未満で届きます。
ElevenLabsの測定では、ElevenAgents上のEleven v4 Turboを使用した場合、リクエストから音声が聞こえるまでの中央値は約150msです。
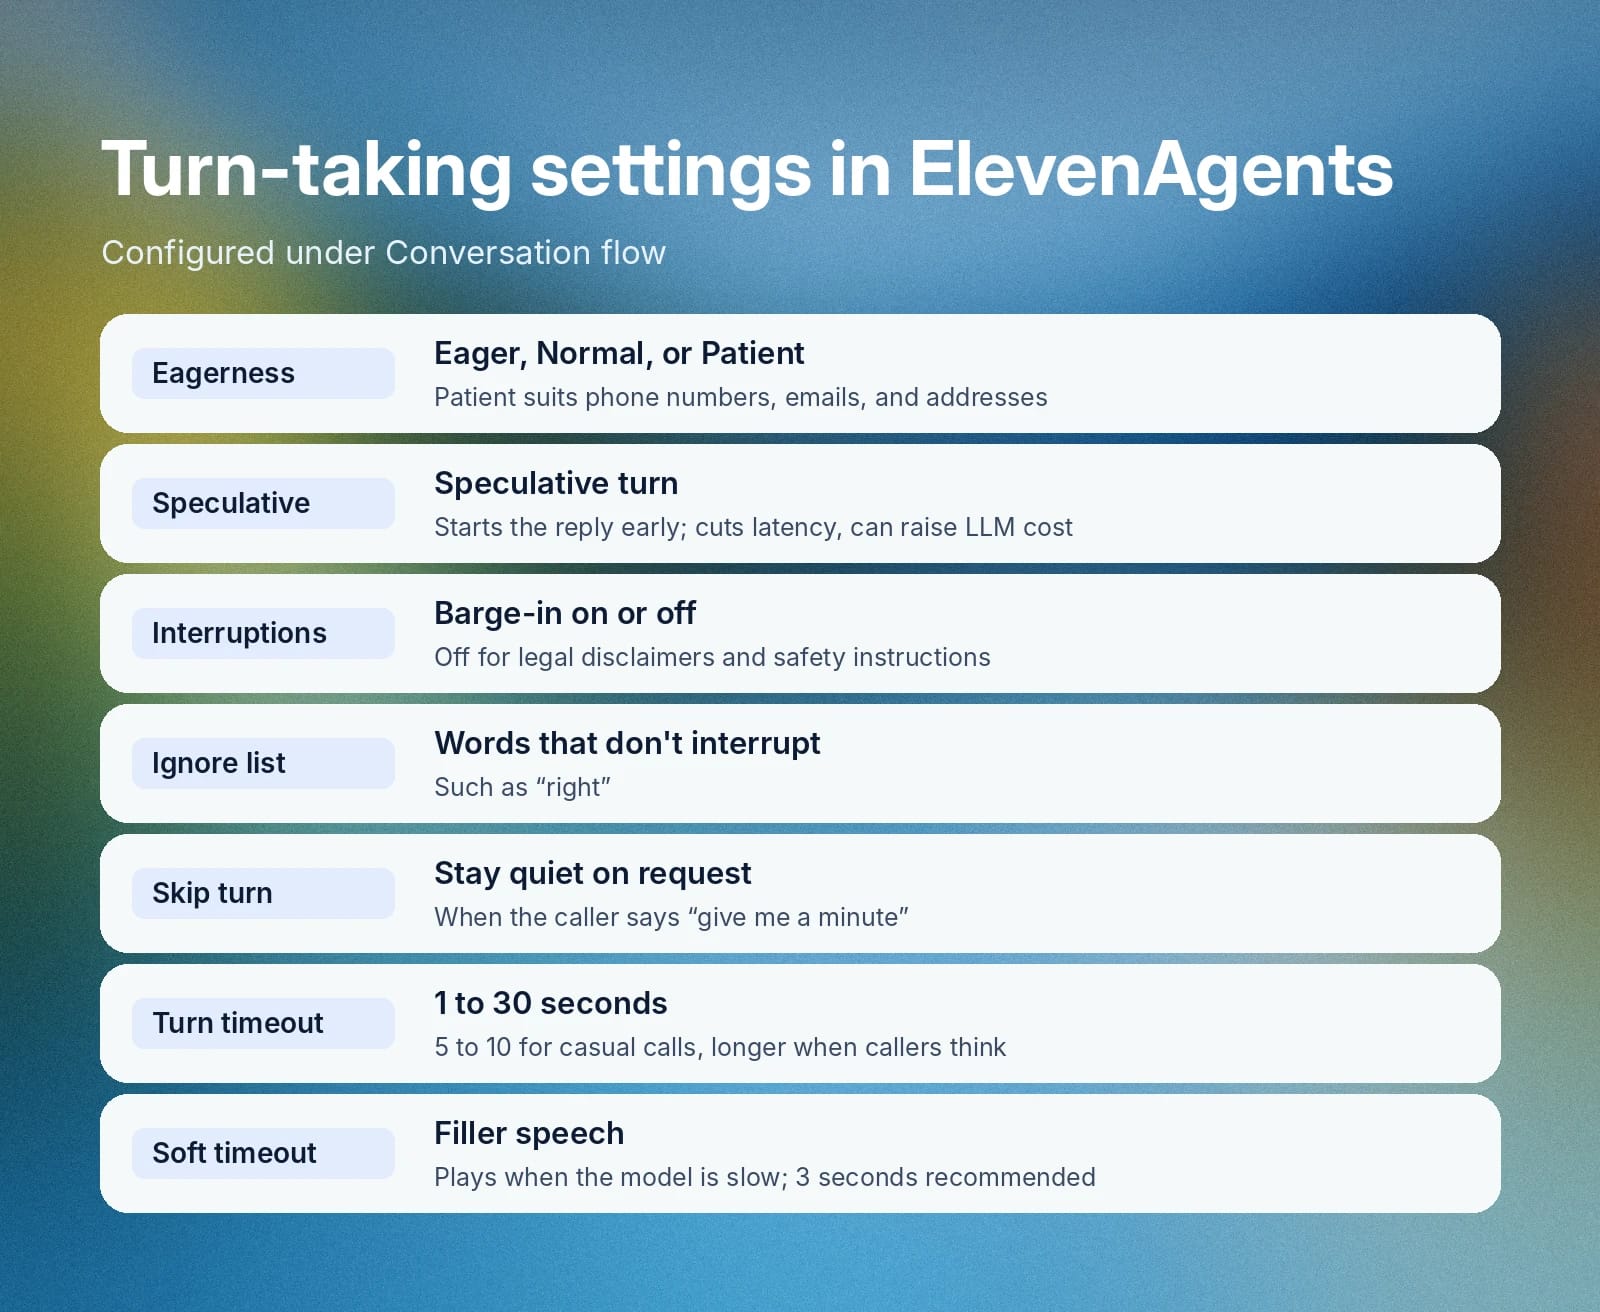
この動作は会話フローで設定できます。
設定
制御する内容
ターンの積極性
「積極的」はできるだけ早く応答します。「標準」はバランスの取れたデフォルト設定です。「慎重」はより長く待つため、電話番号、住所、メールアドレスに適しています。
予測ターン
発信者が話し終えたと確定する前に、言語モデルが回答の生成を開始します。レイテンシを短縮できますが、LLMのコストが増える場合があります。
割り込み
法的免責事項や安全上の指示など、すべての言葉を確実に聞かせる必要がある場合は無効にします。
無視リスト
「そうですね」など、エージェントを中断させない単語を指定します。
ターンスキップツール
発信者が「少し待ってください」と言った場合に、エージェントを待機させます。
ターンタイムアウト
1~30秒の無音後にターンを開始します。日常的な会話には5~10秒、発信者が考える時間を必要とする場合は10~30秒に設定します。
ソフトタイムアウト
モデルの応答が遅い場合に「うーん……そうですね」のようなつなぎの音声を再生します。範囲は0.5~8秒で、推奨値は3秒です。
騒音環境の検出
周囲の話し声を検出し、発信者に静かな場所への移動を依頼するエンタープライズ向け設定です。依頼は1回の会話につき最大1回です。
ワークフローでは、通話中にターンの積極性を変更できます。クライアントは、ユーザーが話している確率を0~1で示すvad_scoreイベントも受信します。
適切に調整されたターンテイキングによって、発信者がエージェントを注意深いと感じるか、唐突だと感じるかが決まります。概念の詳細は、ターンテイキングの完全ガイドをご覧ください。
言語モデル:推論と回答の生成
大規模言語モデル(LLM)は推論を担うレイヤーです。文字起こし、指示、それまでの会話を読み、回答を作成するか、ツールを呼び出すかを判断します。
機能
スクリプト型音声ボットが認識できるコマンドは限られています。LLMはさまざまな表現のリクエストを解釈し、複数ターンにわたってコンテキストを維持し、情報を検索するタイミングや引き継ぐタイミングを判断します。
重要な理由
モデルによって、推論の深さ、速度、コストが異なります。リアルタイムの音声会話では、回答品質と同じくらい応答時間が重要です。そのため、モデルの選択はレイテンシとコストの両方に関わる判断です。
ElevenAgentsでの仕組み
ElevenAgentsでは、Google、OpenAI、Anthropicのモデルに加え、ElevenLabsがホストするオープンモデルを1つのインターフェースから利用できます。エンドポイントを指定し、認証情報をシークレットとして保存すれば、独自のLLMも接続できます。ElevenLabsは、サードパーティーLLMのコストを上乗せせず、プロバイダーの公開料金で請求します。
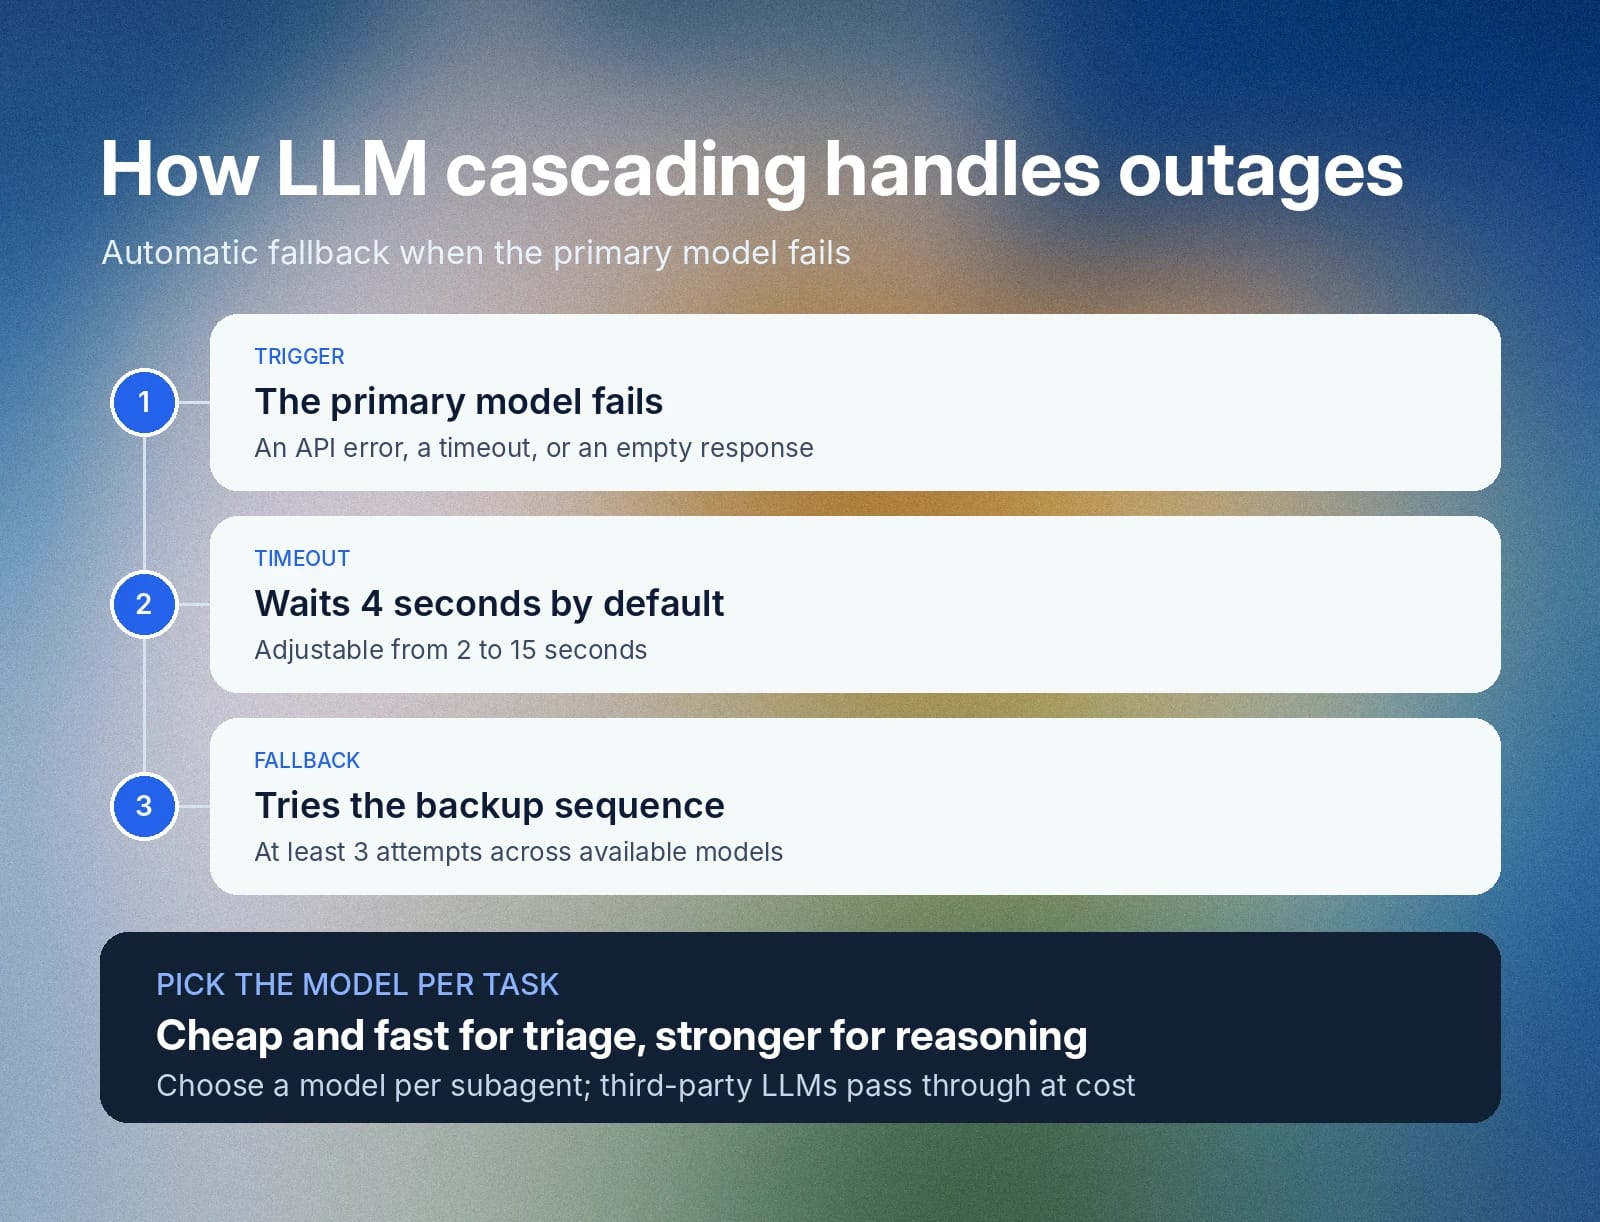
サブエージェントごとにモデルを選択できます。エンタープライズ向け会話型エージェントプレイブック第2巻では、高性能モデルを複雑な推論用に確保し、意図分類やFAQなどには低コストで低レイテンシのモデルを使うことを推奨しています。
プロバイダーで障害が発生することもあります。LLMカスケードは、プライマリモデルがAPIエラーを返した場合、タイムアウトした場合、または空の回答を送信した場合に、バックアップを順番に試します。プライマリからバックアップへ切り替えるデフォルトのタイムアウトは4秒で、2~15秒に調整できます。システムは利用可能なモデル全体で少なくとも3回試行します。
プライマリモデルとして使用するカスタムLLMは、独自のバックアップ順序を設定しない限り、少なくとも3回再試行します。タスクごとに適切なモデルを選ぶことで、エージェントの速度とコスト効率を両立できます。
オーケストレーション:エージェントと人間の間で作業を振り分ける
エージェントオーケストレーションは、タスクの完了に関わるプロンプト、サブエージェント、ツール、人間を調整します。通話の各時点で次に何をするかを決定します。
機能
1つの長いプロンプトを持つ1つのエージェントは、役割が増えるにつれて管理が難しくなります。オーケストレーションは作業を段階に分け、それぞれに指示、モデル、ツールを割り当て、発信者を段階間で移動させます。
重要な理由
短いプロンプトはテストしやすく、各インタラクションで読み込むテキスト量が減るため、実行コストも抑えられます。フローを分割すれば、振り分けやFAQは低コストのモデルで処理し、必要なリクエストだけを高性能モデルに引き継げます。
ElevenAgentsでの仕組み
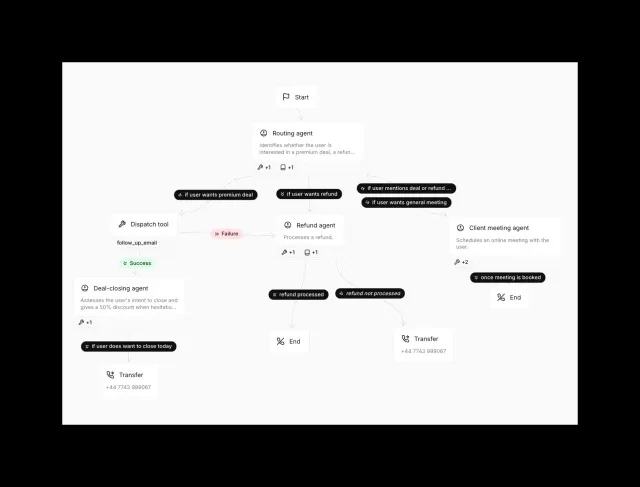
ElevenAgentsのワークフローは、分岐する会話グラフを作成するビジュアルビルダーです。
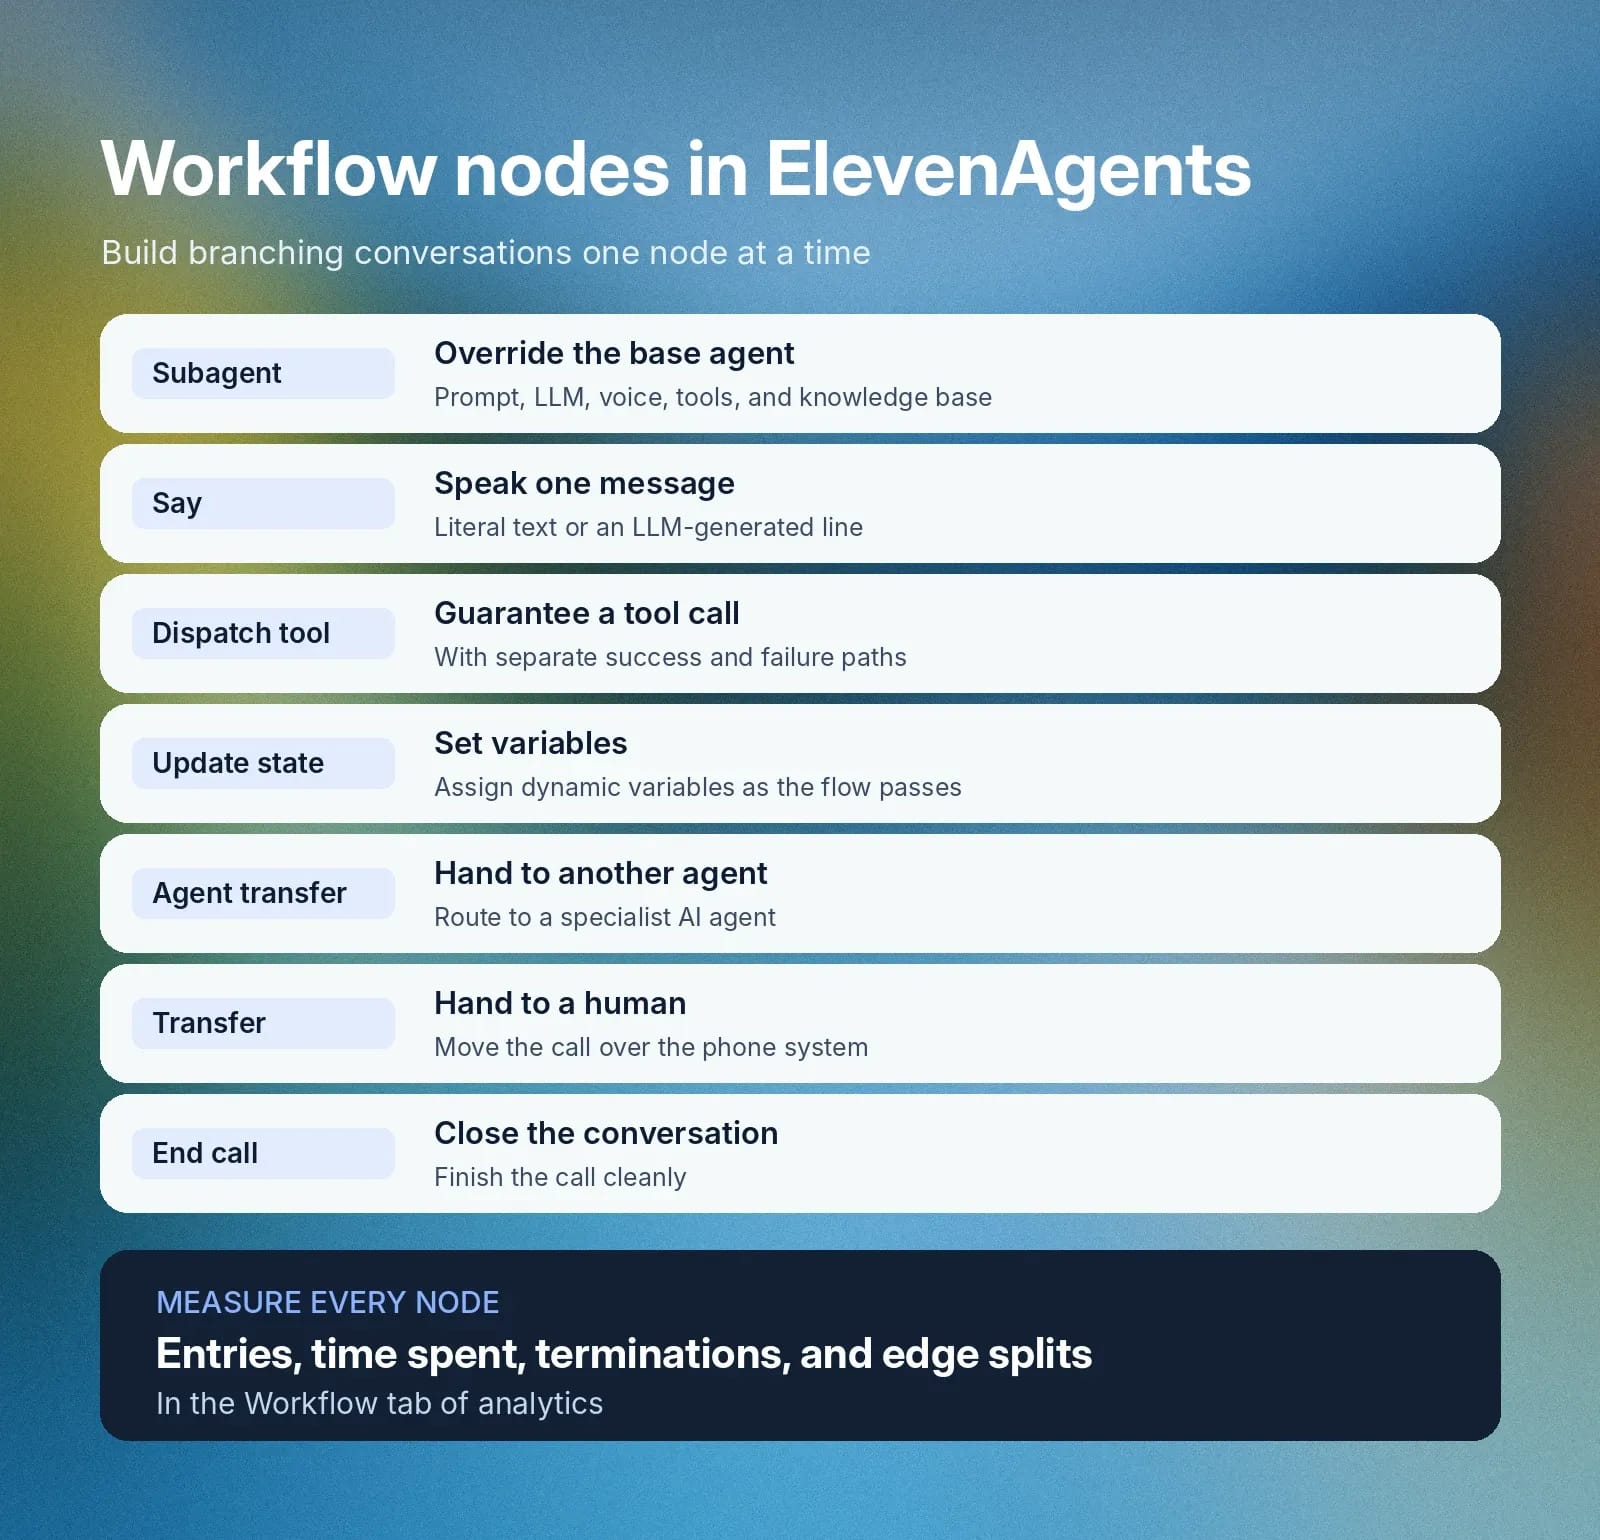
ノードは次のとおりです。
- サブエージェント:プロンプト、LLM、音声、ツール、ナレッジベースなど、ベースエージェントの設定を変更または上書きします。
- 発話:固定テキストまたはLLMが生成した1行のメッセージを読み上げます。
- ツール実行:ツール呼び出しを確実に実行する専用ステップで、成功時と失敗時のパスを分けられます。
- 状態の更新:フローの進行に合わせて動的変数を設定します。
- エージェント転送:通話を別のエージェントに引き継ぎます。
- 番号への転送:電話システムを通じて、AIエージェントから人間の担当者に通話を転送します。
- 通話終了:会話を終了します。
ノード間のエッジには、LLMがリアルタイムで評価する自然言語の条件を設定します。サポートフローでは、高速モデルを使う振り分け用サブエージェントから開始し、請求に関する質問を高性能モデルの請求用サブエージェントに送り、発信者が人間の担当者を求めたら番号転送ノードで終了できます。公開後は、分析画面の「ワークフロー」タブで、各ノードへの進入数、平均滞在時間、終了数、エッジ分布を確認できます。
オーケストレーションにより、単一のエージェントを、ノード単位で設計、測定、改善できるシステムへ変えられます。
ツールとMCP:エージェントに処理を実行させる
ツール呼び出しとも呼ばれる関数呼び出しにより、エージェントは技術スタックに接続された外部ソフトウェアへ処理をリクエストできます。
これにより、質問応答インターフェースが、ユーザーに代わって作業を完了し、他のツールと連携できるエージェント型AIシステムになります。
機能
明日の予約を金曜日に変更したいという発信者を例に考えてみます。エージェントは予約情報を取得し、金曜日の空き状況を確認して、スケジュールシステムを更新し、変更を確定します。各ステップが、実際の処理を行うツール呼び出しです。
重要な理由
ツールは、会話を成果につなげる役割を担います。各ツールには明確な入力と出力が必要であり、エージェントは成功したと発信者に伝える前に、呼び出しが成功したかを把握する必要があります。
ElevenAgentsでの仕組み
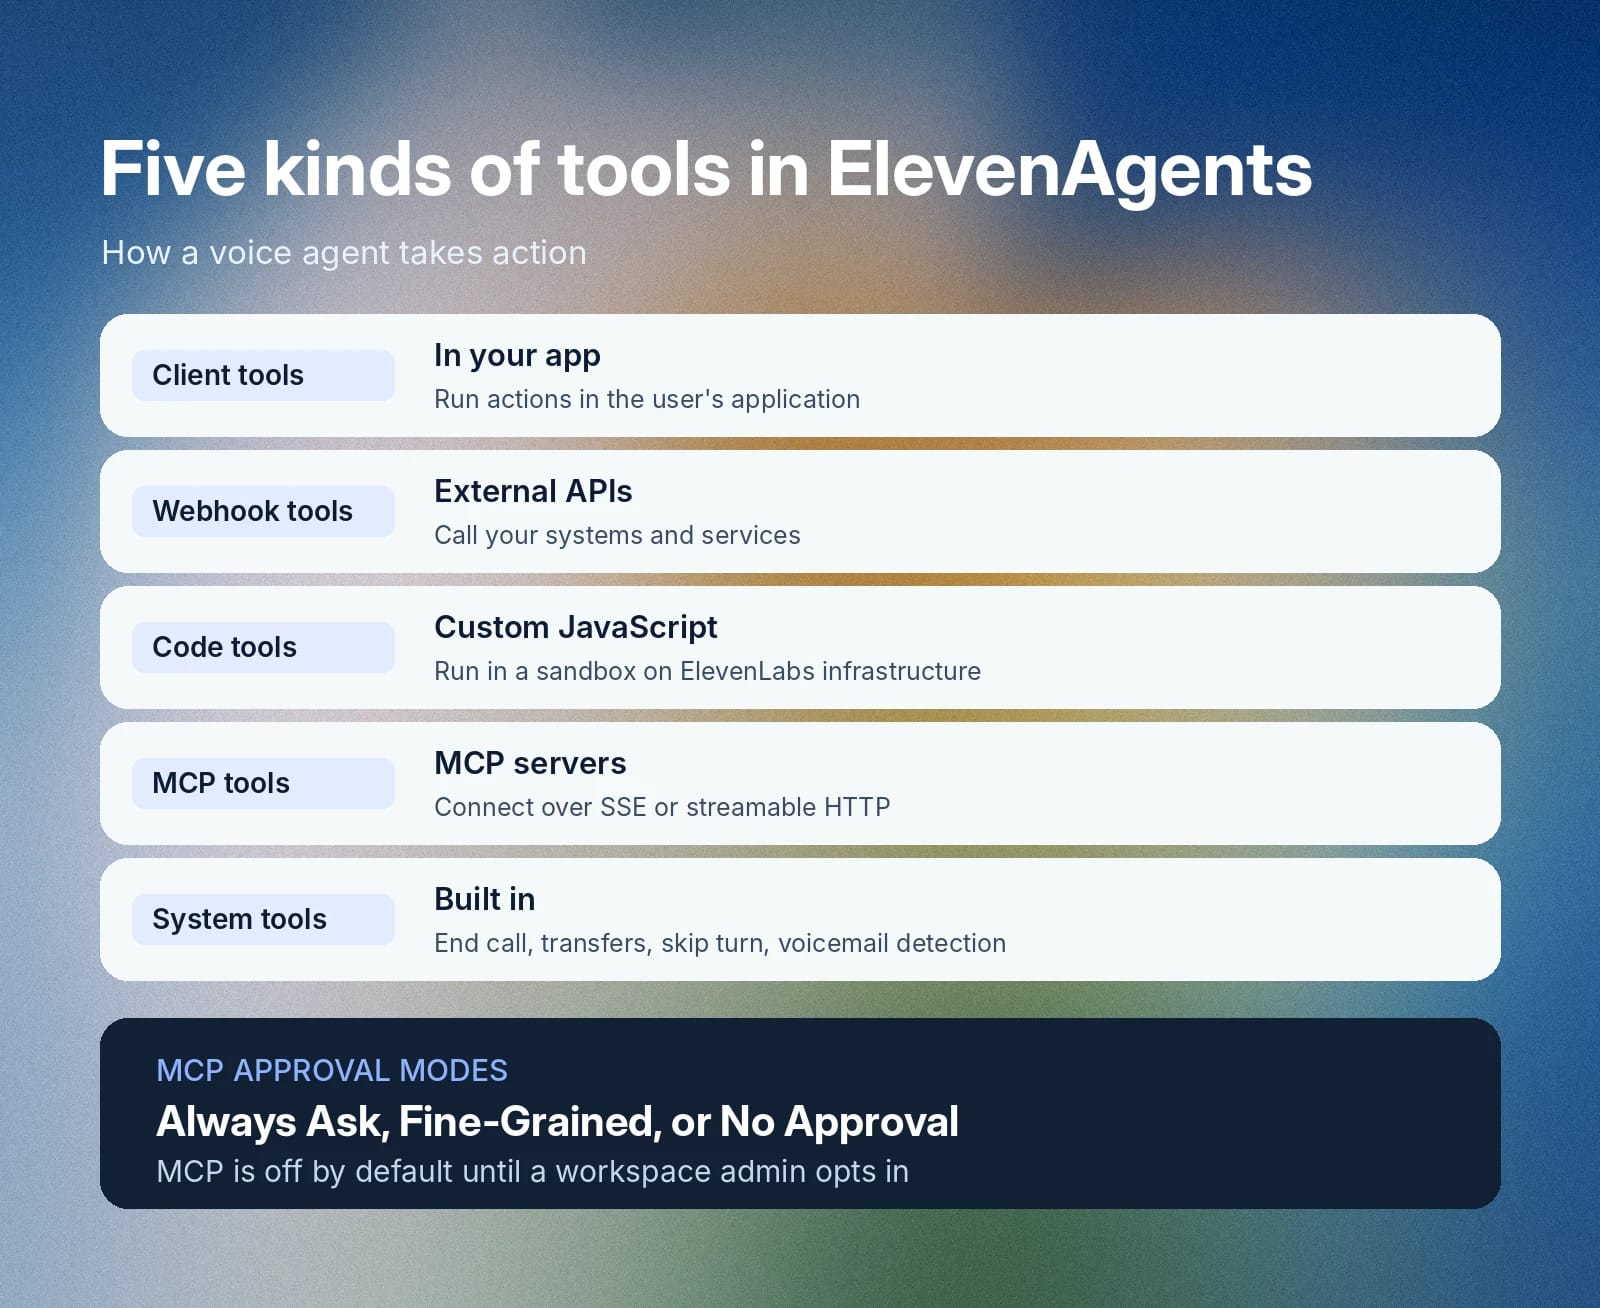
ElevenAgentsは、ユーザーのアプリケーションで動作するクライアントツール、外部APIを呼び出すWebhookツール、ElevenLabsインフラ上のサンドボックスでカスタムJavaScriptを実行するコードツール、MCPツール、組み込みのシステムツールに対応しています。
システムツールには、通話終了、言語検出、エージェント転送、番号への転送、ターンスキップ、キーパッドのタッチトーン再生、ボイスメール検出があります。ツールの実行中に環境音を追加したり、実行中に発信者が割り込めるかを制御したりできます。
Model Context Protocol(MCP)は、アプリケーションが言語モデルにコンテキストとツールを提供する方法を定めたオープン標準です。ElevenAgentsは、SSEとストリーミング可能なHTTPを介してMCPサーバーに接続します。すべてのワークスペースでMCPはデフォルトで無効なため、まずワークスペース管理者が有効にします。その後、サーバーごとに「常に確認」「ツールごとの詳細な承認」「承認不要」のいずれかの承認モードを選択します。
client_tool_callやmcp_tool_callなどのクライアントイベントがツールの動作を通知し、MCPイベントは「読み込み中」「承認待ち」「成功」「失敗」の4状態を報告します。信頼性の高いツールによってエージェントは現実のシステムで処理でき、明確な承認ルールによってその範囲を制御できます。
知識とメモリ:事実情報と発信者のコンテキスト
検索拡張生成(RAG)は、社内の事実データベースや幅広い顧客履歴ログなど、独自コンテンツの事実情報をエージェントに提供します。メモリとパーソナライズは発信者に関するコンテキストを提供し、エージェントの個別対応とビジネス上の有用性を高めます。
機能
言語モデルにはトレーニングデータの期限があり、独自の文書や記録にはアクセスできません。RAGはクエリごとにナレッジベースを検索し、最も関連性の高い文章を取得してモデルに提供することで、有用な回答に必要な追加コンテキストを与えます。
パーソナライズデータは、誰からの電話で、その人に何が関係するかをエージェントに伝えます。
重要な理由
承認済みコンテンツに回答の根拠を置くことで、正確性を維持できます。検索に加わる1ミリ秒ごとに顧客の待ち時間も延びるため、検索速度も重要です。また、新しいセッションの開始時点でエージェントがCRMレコードを参照できるため、パーソナライズ機能によって発信者が通話のたびに情報を繰り返す必要がなくなります。
ElevenAgentsでの仕組み
ナレッジベースには、ファイル(PDF、DOCX、TXT、MD、HTML、EPUB。各20MBまで)、URL、貼り付けたテキストとして文書を追加できます。抽出したテキストがプロンプトに収まる場合、最大約30万文字まで文書全体のコンテキストを使用します。より大きい文書にはRAGを使用します。検索は毎ターンまたはオンデマンドで実行でき、デフォルトの利用モードは「自動」です。RAGが有効で文書がインデックス化されている場合にRAGを使用します。
ElevenLabsは検索速度の改善にも直接取り組んでいます。エンジニアリング記事「RAGのレイテンシを削減した方法」では、ElevenLabsがすでに運用しているインフラ上でセルフホストしたモデルを使い、RAGレイテンシの中央値を326msから155msへ短縮したことを紹介しています。
発信者のコンテキストには、ElevenAgentsは{{ var_name }}形式の動的変数を使用し、メッセージ、システムプロンプト、ツールに値を挿入します。Twilio、SIPトランク、WhatsApp、SMS経由の着信では、会話開始前にサーバーから初期データを取得できます。サーバーはcaller_idで発信者を検索し、CRMなどから変数を返します。応答サイズは最大256KBです。通話後は、通話後Webhookが評価結果と抽出データを外部システムへ送信します。
検索とパーソナライズを組み合わせることで、エージェントは適切な事実情報と発信者情報の両方を得られます。
音声合成:エージェントに声を与える
テキスト読み上げ(TTS)は、言語モデルの回答を音声オーディオに変換します。発信者が実際に耳にするレイヤーです。
機能
モデルは、自然なテンポと感情表現でテキストをオーディオに変換します。リアルタイム通話では、オーディオをチャンク単位でストリーミングし、回答全体が生成される前に再生を開始します。
重要な理由
レイテンシと話し方は、どちらも発信者による通話の評価に影響します。リアルタイム処理では、オーディオの生成時間と、発信者が最初の音を聞くまでの時間という2つの数値が重要です。氏名、薬品名、専門用語も正しく発音する必要があり、間違えるとエージェントへの信頼が失われます。
Eleven v4が音声レイヤーを支える仕組み
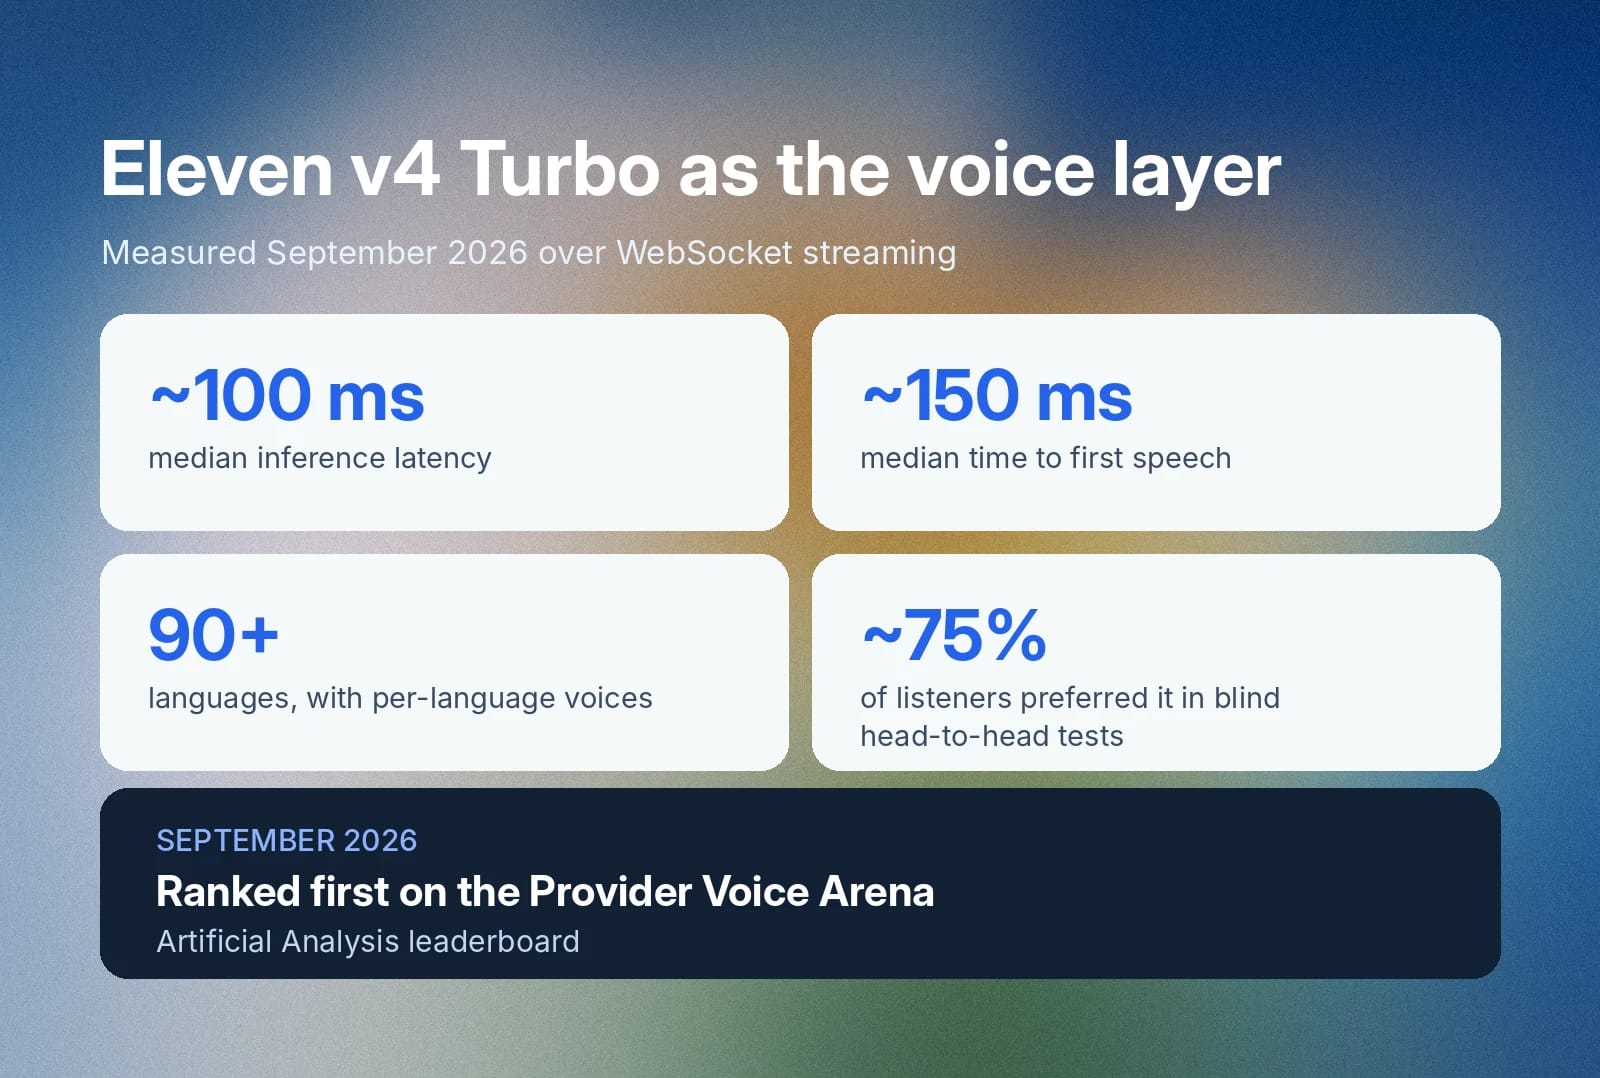
Eleven v4は、まったく新しいアーキテクチャで構築された、ElevenLabs史上最も感情豊かなテキスト読み上げモデルです。Eleven v4 Turboは、エージェントなどのリアルタイム用途向けの低レイテンシ版で、ElevenAgentsと1つのシステムとして最適化されています。
Eleven v4 Turbo
数値
推論レイテンシの中央値
約100ms
最初の発話までの時間の中央値
約150ms
対応言語
90+
ElevenLabsは2026年9月、ネットワークレイテンシを除外したWebSocketストリーミングでレイテンシを測定しました。Eleven v4は2026年9月のArtificial Analysis Provider Voice Arenaランキングで1位を獲得し*、ブラインドテストでは約75%のリスナーに選ばれました**。
* Artificial Analysis「Provider Voice Arena Leaderboard」、2026年9月
** Cartesia Sonic 3.6、Inworld TTS-2、Google Gemini 3.8 Flash-Lite TTS、Google Gemini 3.8 Flash TTSとの一対一のユーザー選好テストに基づきます。
Eleven v4は、話し方を指定する[laughs]などのインラインオーディオタグと、発音を制御するIPA音素に対応しています。医療エージェントでは、医療用語の発音も制御できます。ElevenAgentsでは、さらにエージェント単位の制御を追加できます。マルチ音声対応により、1つのエージェントが複数のキャラクターの会話で音声を切り替えられます。速度は0.7倍~1.2倍です。追加した言語ごとに別の音声を使用できます。発音辞書では、特定の単語にIPAまたはCMU表記を指定できます。
最初の音が素早く再生され、正確で表現豊かな音声を使うことで、エージェントが会話相手のように感じられます。
電話通信と伝送:エージェントと発信者を接続
伝送レイヤーは、発信者とエージェントの間でオーディオを運びます。使用する電話通信チャネルに応じて、音声AIインフラに組み込むインテグレーションは異なります。
機能
電話は電話網とSIPを介して接続され、ブラウザやアプリでの会話はWebRTCまたはWebSocketを介して接続されます。ウェブサイトウィジェットは、ブラウザ接続をすぐに使えるインターフェースにまとめます。
重要な理由
チャネルごとに設定要件とオーディオの制約が異なるため、早い段階でチャネルを決めてください。電話中心の導入ではトランキングと電話番号の管理が必要です。プロダクトへの導入ではSDKが必要です。
ElevenAgentsでの仕組み
- SIPトランキング:電話システムをElevenLabsに直接接続し、着信と発信の両方に対応します。Twilio、Vonage、Sinch、Infobip、Telnyxなどの標準プロバイダーで利用できます。シグナリングはポート5060のTCP、またはポート5061のTLS 1.2以降で行われ、オーディオにはG.711またはG.722を使用します。通話1件あたり少なくとも100Kbpsを確保してください。同時通話数の上限はサブスクリプションプランに従い、通話キューを有効にすると発信者は順番を待ちます。
- ネイティブTwilioインテグレーション:購入済みのTwilio番号をインポートし、着信と発信に使用できます。認証済みの発信者番号は発信時のみ利用できます。
- 一括通話:CSVまたはXLS形式の宛先リストをアップロードすると、追加した各列が動的変数になります。すぐに実行することも、開始時刻を予約することもできます。一括通話では、ワークスペースの同時実行上限の50%と、エージェントの同時実行上限の70%のうち、低い方を使用し、着信通話用の容量を残します。
- WebRTCとWebSocket:SDKはデフォルトで、音声にはWebRTC、テキストのみの会話にはWebSocketを使用します。非公開エージェントは、署名付きURLまたはサーバーで作成した会話トークンで認証します。WebSocketエンドポイントはwss://api.elevenlabs.io/v1/convai/conversationです。
- SDK:Python、JavaScript、React、React Native、Swift、Kotlin、Unity。
- ウィジェット:ページに<elevenlabs-convai>要素を追加します。音声のみ、音声とテキスト、チャットの各モードに対応し、エージェントはクイック返信やカルーセルを表示できます。
1つのエージェントで電話、ウェブ、WhatsApp、SMS、メールに対応できるため、一度構築すれば複数のチャネルに展開できます。
ガードレール:エージェントを目的に沿って動作させる
ガードレールは、エージェントの動作を定義された境界内に保つ制御機能です。グラウンディングと併用されますが、ガードレールは発言内容を制限するものであり、根拠となる事実自体を正しくするものではありません。ガードレールはエージェントの会話と並行して動作し、AIエージェントとの会話のコンプライアンスと正確性の維持に役立ちます。
機能
ElevenAgentsは3つのレベルでガードレールを適用します。システムプロンプトでは、許可する動作と禁止する動作を設定します。# Guardrailsという見出しの下に記述するのが理想的です。ユーザー入力の検証では、プロンプトインジェクションがないかメッセージを確認します。回答の検証では、配信前に各回答を確認します。
重要な理由
エージェントが話題から逸れたり、存在しないポリシーを作り上げたりすると、信頼はすぐに失われます。カスタマーサポートエージェントは、回答前に承認済みの情報源から返金ポリシーを取得する必要があり、ガードレールがその境界を適用します。
ElevenAgentsでの仕組み
ElevenAgentsは2026年9月にGuardrails 2.0を導入しました。新しいシステムでガードレールを効果的に機能させる設定は次のとおりです。
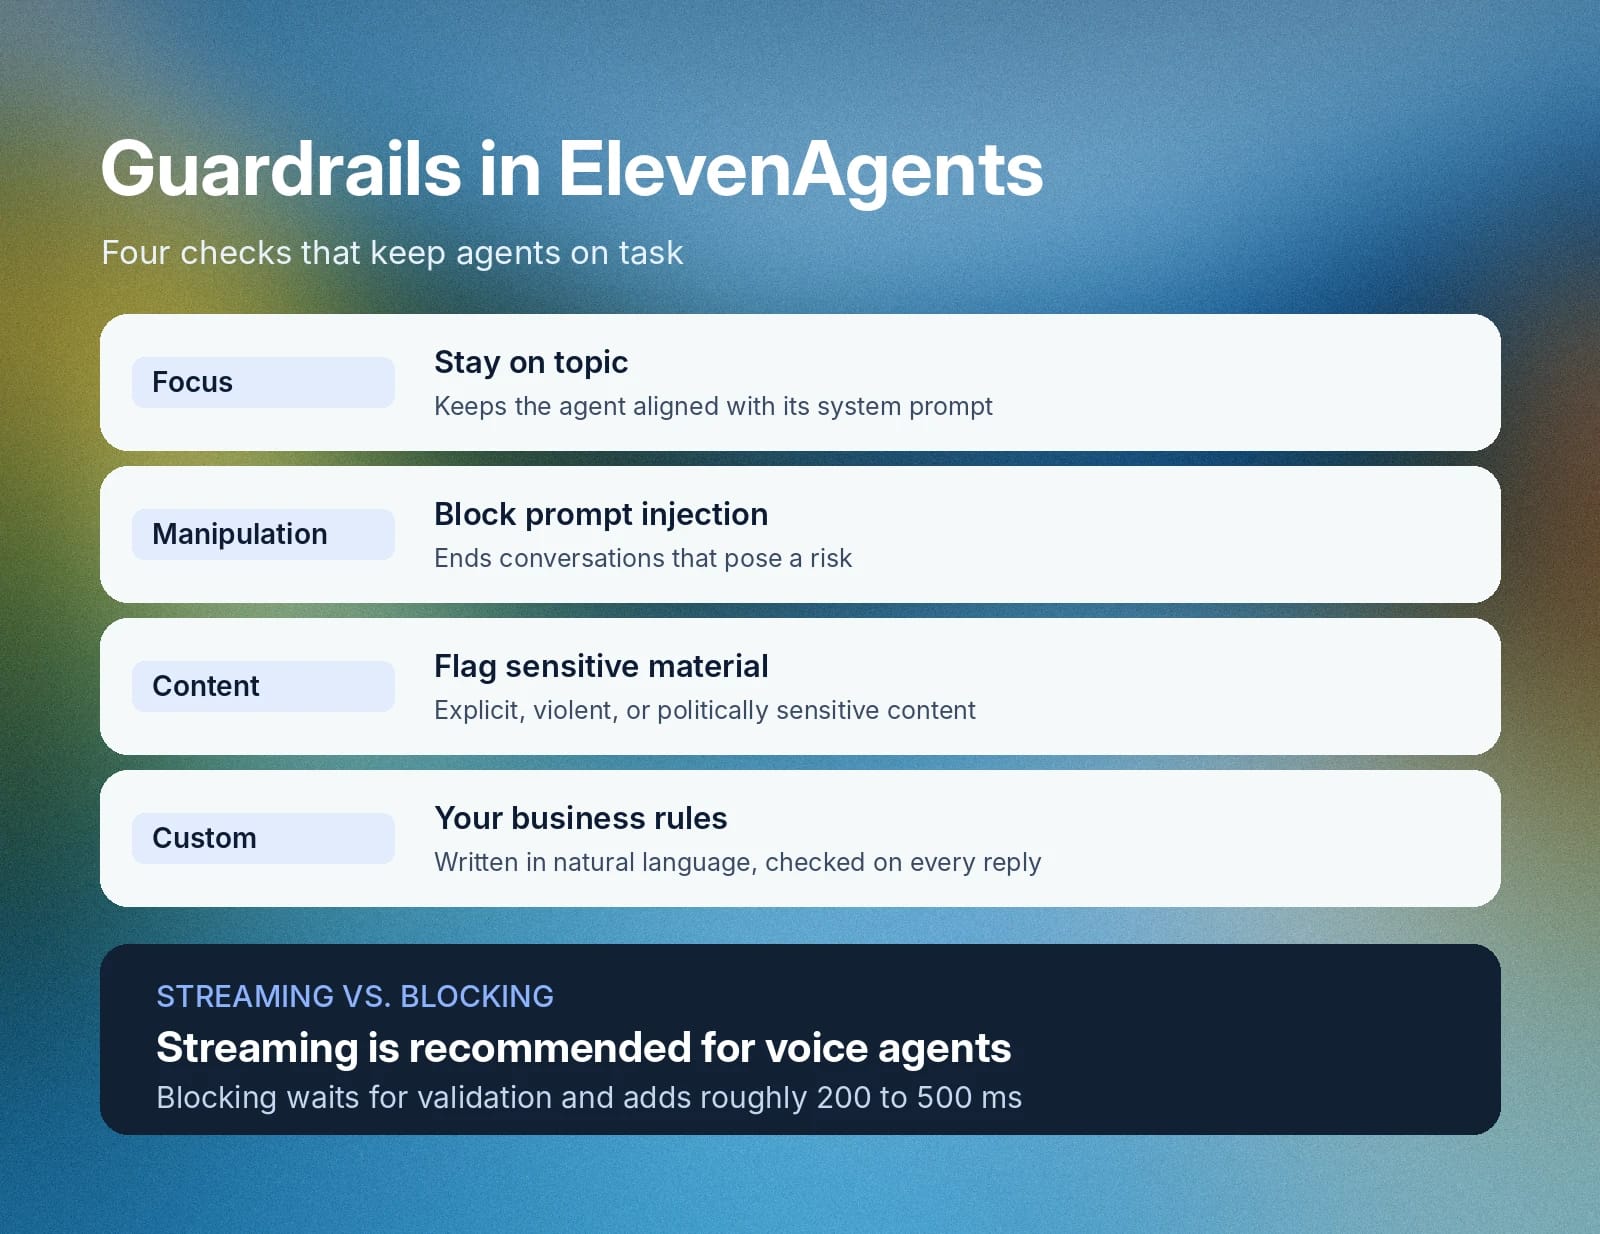
- フォーカス:エージェントを話題に沿わせ、システムプロンプトとの整合性を保ちます。
- 操作:プロンプトインジェクションを検出し、リスクのある会話を終了します。
- コンテンツ:露骨な性的表現、暴力、政治的にセンシティブな内容などのカテゴリーを検出します。
- カスタム:自然言語で記述したビジネスルールを、回答ごとに評価します。
実行モードでは、レイテンシとのバランスを決めます。ストリーミングモードではチェックの完了前に回答を開始できるため、ブロックによって通話が終了するまでに500ms未満のオーディオが再生される場合があります。ElevenLabsは音声エージェントにこのモードを推奨しています。ブロッキングモードは検証を待つため、約200~500msが追加されます。
カスタムガードレールが作動すると、トリガーアクションによって通話を終了するか、設定したフィードバックを使って回答を最大3回再試行します。クライアントはguardrail_triggeredイベントを監視できます。
選択したレイテンシプロファイルで多層のガードレールを使用すれば、すべての回答を遅くすることなく、予測可能な動作を維持できます。
テストと実験:エージェントの動作を検証
テストでは公開前にエージェントを確認します。実験では公開後、実際のトラフィックを使って変更を検証します。
機能
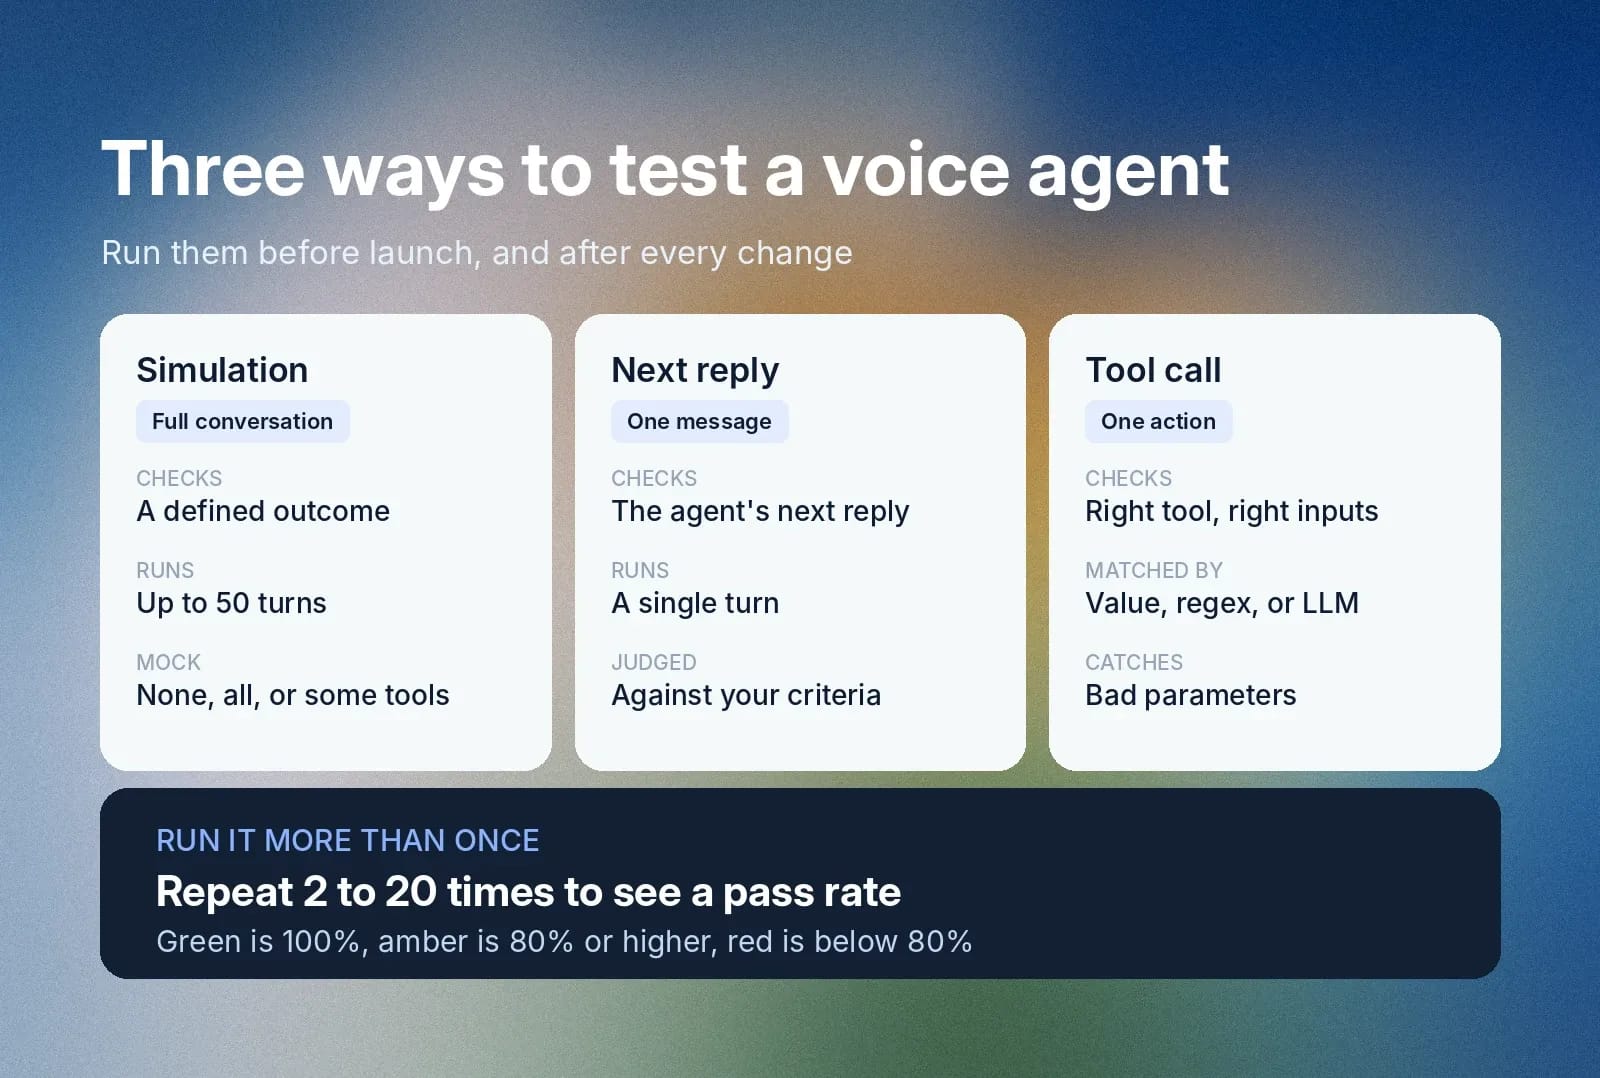
ElevenAgentsには3種類のエージェントテストがあります。シミュレーションでは、模擬ユーザーとの会話全体を実行し、定義した結果に到達したかを最大50ターン(デフォルトは5)で確認します。「次の回答」テストでは、エージェントの次のメッセージだけを基準に照らして評価します。「ツール呼び出し」テストでは、正確な値、正規表現、LLM評価のいずれかで照合し、適切なツールを正しいパラメーターで使用したかを確認します。シミュレーションでは、ツールをモックしない、すべてモックする、選択したツールのみモックする、のいずれかを選べます。
重要な理由
1回の合格は、エージェントが成功できることを示します。テストを繰り返すことで、成功する頻度が分かります。APIのrepeat_countには2~20を指定でき、結果には合格率が表示されます。緑は100%、黄は80%以上、赤は80%未満です。失敗は理由別にグループ化されます。プロンプト、モデル、ワークフロー、インテグレーションはいずれも動作を変えるため、公開後もテストを継続します。
実験の仕組み
実験は、エージェントのバージョン管理を基盤とするA/Bテストです。設定を分岐させ、システムプロンプト、ワークフロー、音声、ツール、ナレッジベース、LLM設定などの変数を1つ変更し、実際のトラフィックの一部をバリエーションに振り分けます。ElevenLabsは5~10%から始めることを推奨しています。
ルーティングは会話IDに基づいて決定されるため、特定のユーザーは同じ分岐に留まり、割合の合計は100%にする必要があります。ElevenLabsの顧客であるCARS24は、レポートで説明されているとおり、各段階を2日間維持しながら、トラフィックを5%、10%、20%、50%、100%へ段階的に増やしました。
公開前のテストと公開後の実験を組み合わせることで、変更を測定可能な改善につなげられます。
オブザーバビリティ:本番環境での動作を測定
オブザーバビリティとは、エージェントが何を行い、どのようなパフォーマンスを示し、問題が起きた場合にどこで失敗したかを把握できることです。テストで動作するエージェントでも、実際の発信者には異なる動作をする可能性があるため、完全な可観測性と監査可能な記録管理が欠かせません。
機能
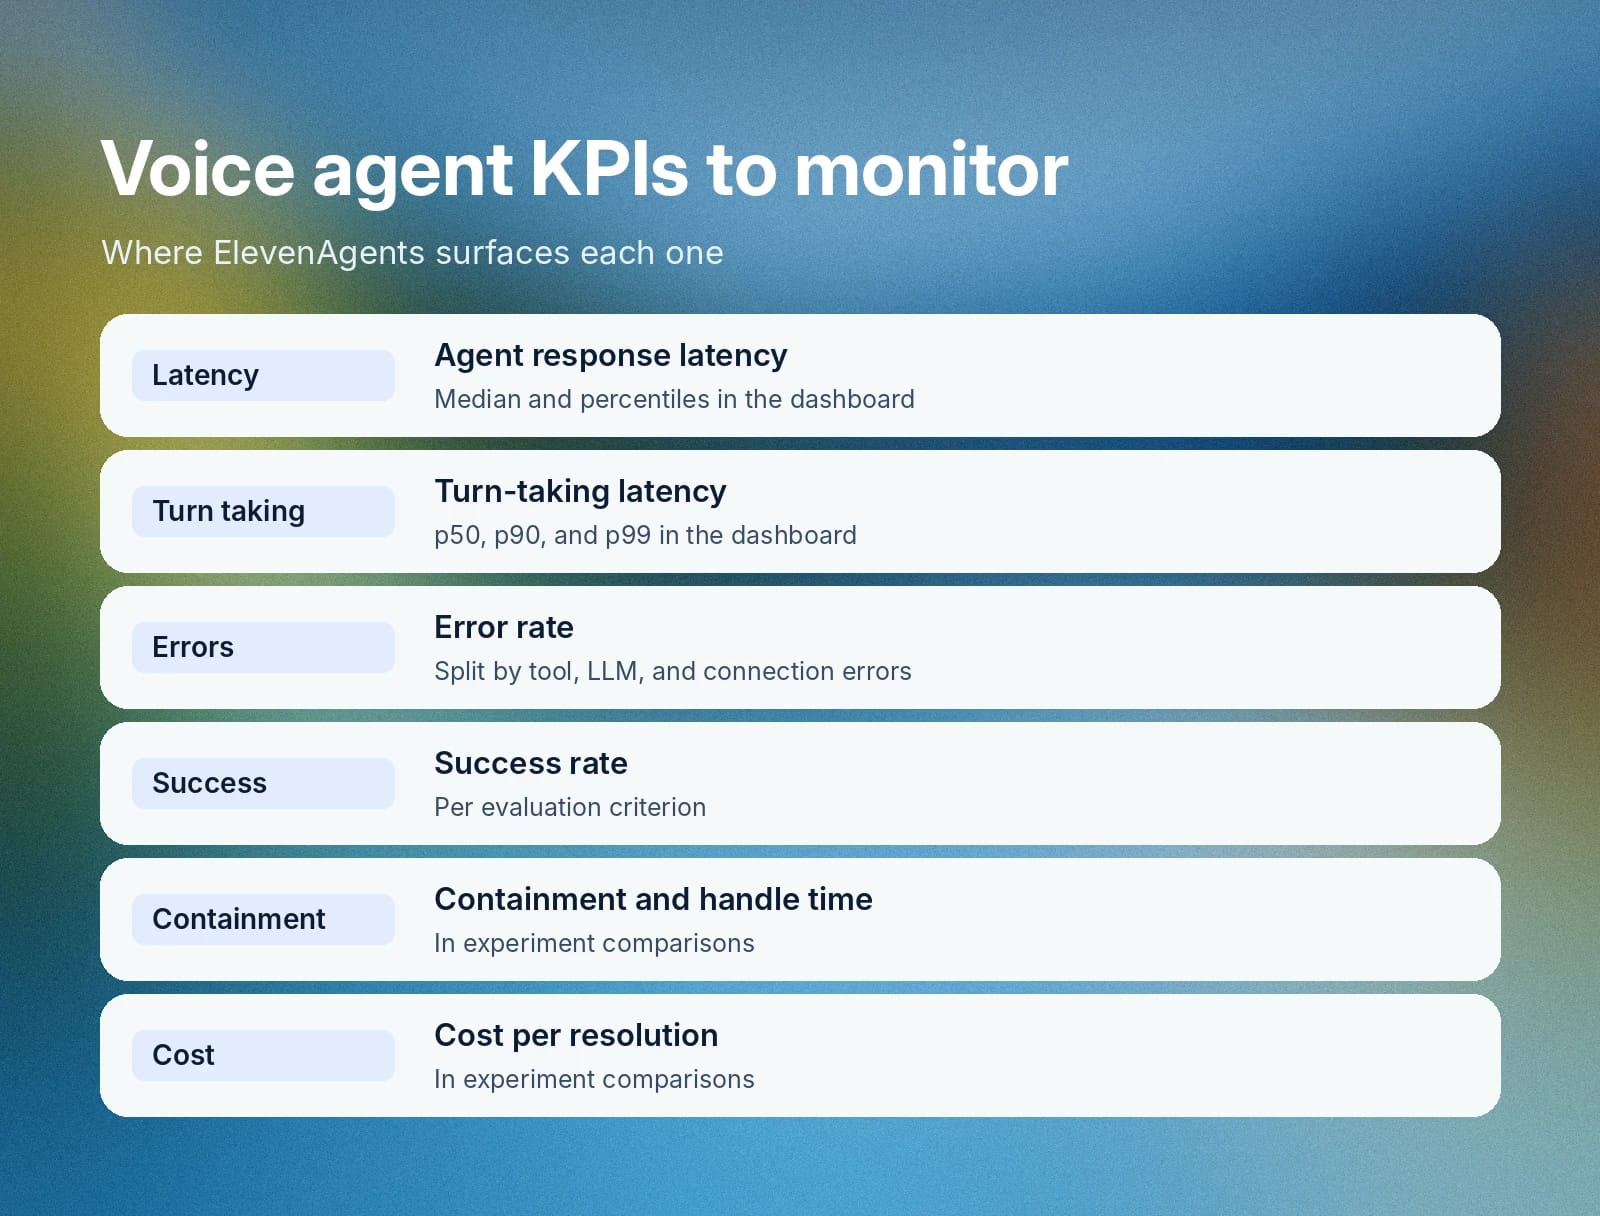
会話分析はすべての通話を評価します。成功評価では、目標達成度と品質について定義した基準を適用し、データ収集では連絡先や問題の種類などの構造化フィールドを抽出します。分析ダッシュボードには、通話量、通話時間、コスト、エラー率、レイテンシも表示されます。進行中の通話はリアルタイムで更新され、エラー率が急上昇するとアラートが発生します。
重要な理由
モニタリングがなければ、問題のある通話は単なる一例にすぎません。モニタリングがあれば、どのノード、ツール、モデルが問題を引き起こしたかを確認できます。
KPI
分かること
ElevenAgentsでの表示場所
エージェントの応答レイテンシ
発信者が回答を待つ時間
分析ダッシュボード、中央値、パーセンタイル
ターンテイキングのレイテンシ
エージェントがどれだけ早く発話を開始するか
分析ダッシュボード、p50、p90、p99
エラー率
エラーが発生した会話の割合
ダッシュボード、ツール、LLM、接続エラー別の内訳
成功率
基準ごとの目標達成度
評価基準、成功、失敗、不明の割合
自己完結率と処理時間
人間を介さずに解決した通話と通話時間
実験の比較
解決1件あたりのコスト
解決した各会話にかかったコスト
実験の比較
想定する業務に最も役立つ指標を選んでください。サポートエージェントでは解決とエスカレーションを重視し、アウトバウンドエージェントでは主に接続率と完了率を重視します。
スケール、信頼性、人間への引き継ぎ
音声AIインフラは、顧客が5人でも50万人でも対応できる必要があります。大規模な運用でも、各コンポーネントは安定して動作し、必要に応じて人間にエスカレーションできなければなりません。
機能
スケールとは、音声認識、LLM推論、音声合成、インテグレーション、電話通信にまたがる多数の同時会話を処理できることです。信頼性とは、それぞれの依存先に明確な障害対応パスがあることです。引き継ぎとは、人間の担当者へつなぐ明確な経路があることです。
厳密には音声AIインフラ内のコンポーネントではありませんが、実用的な優れたシステムにはいずれも欠かせません。
重要な理由
10件のテスト通話を処理できるシステムでも、1万件では異なる動作をする場合があります。予約ツールがタイムアウトした際、実際には完了していない予約をエージェントが確定したと伝えてはいけません。人間の担当者を求める発信者には、通常はウォーム転送を使って、コンテキストを維持したままつなぐ必要があります。
ElevenAgentsでの仕組み
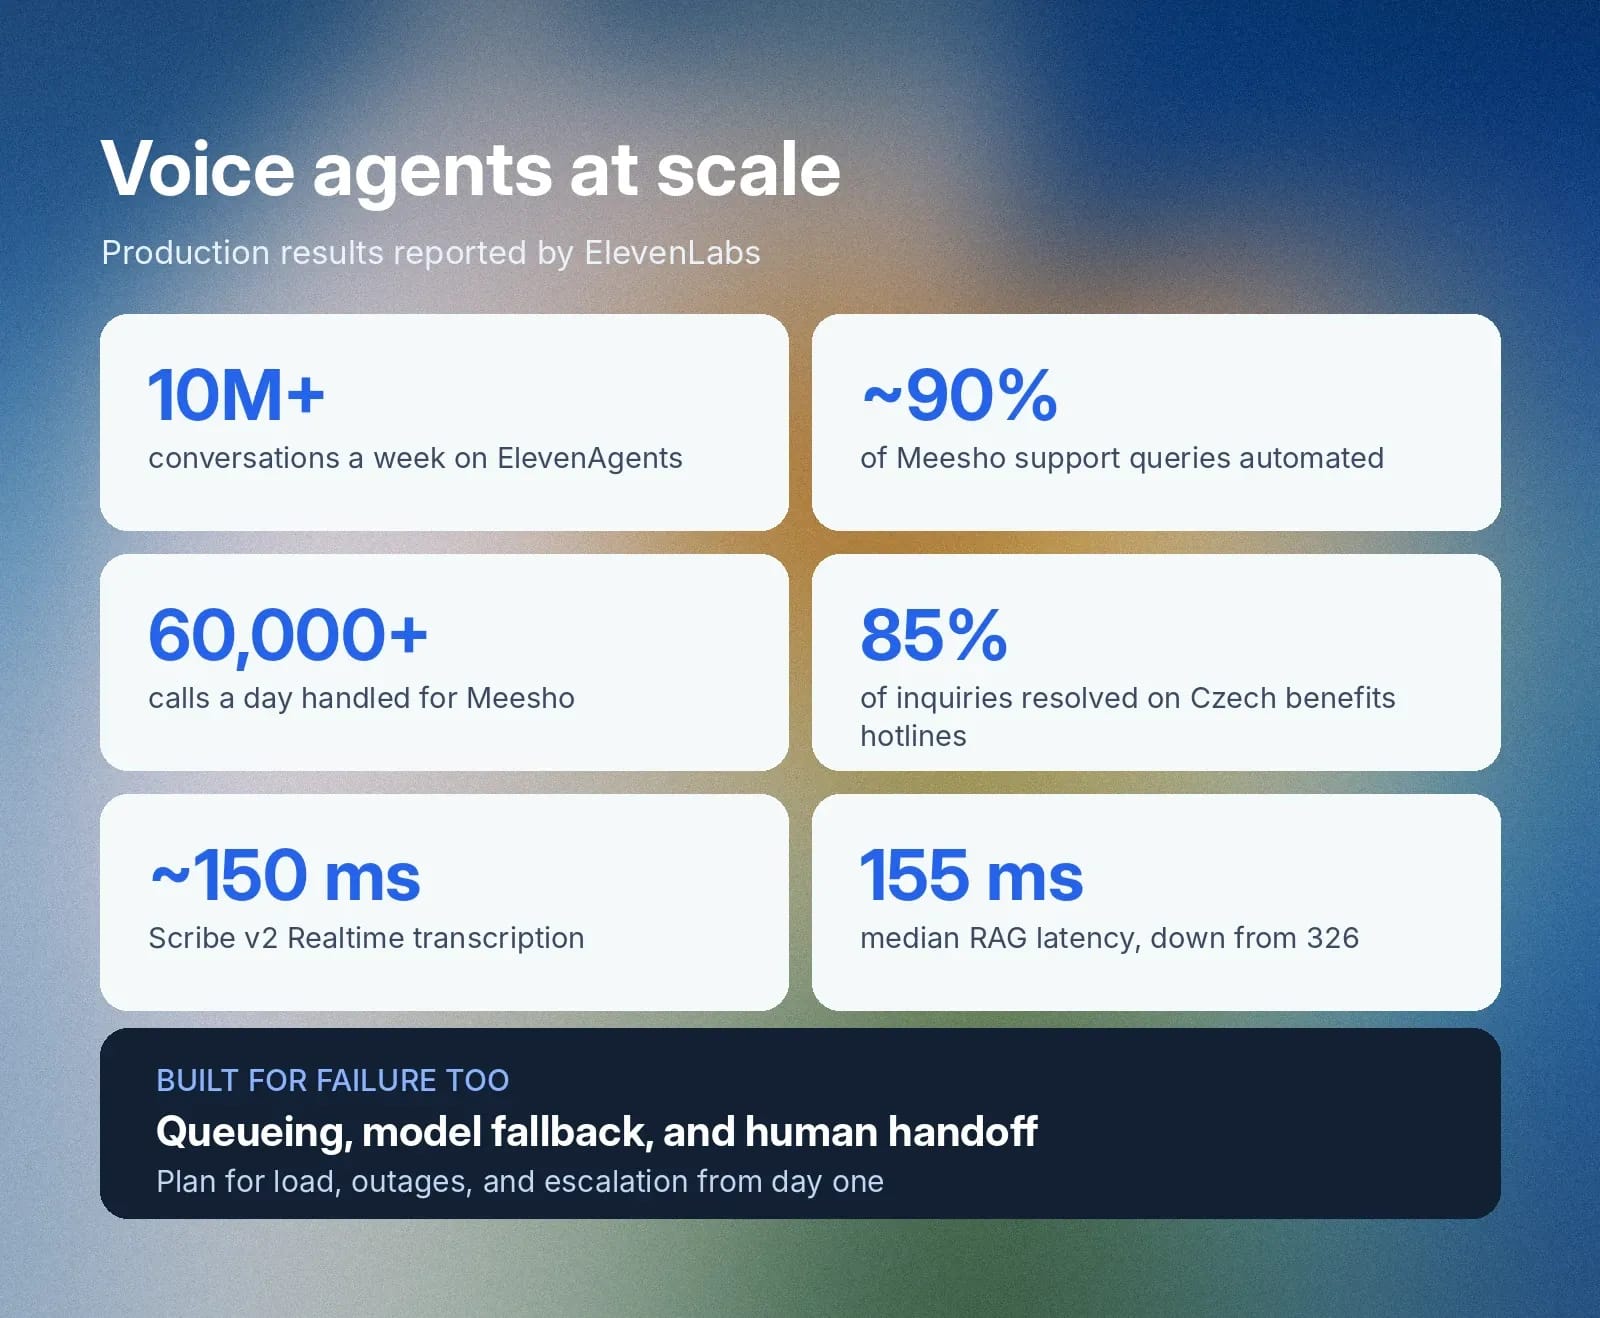
同時実行上限はサブスクリプションプランに従い、上限に達すると通話キューで発信者を待機させます。LLMカスケードはモデル障害に対応します。番号転送ノード、番号転送システムツール、エージェント転送によって引き継ぎに対応し、評価基準に基づいてエスカレーションのタイミングを判断できます。無音時間は通常の1分あたり料金の5%で請求されます。
ElevenLabsは、大規模な本番運用の実績を公表しています。ElevenAgentsは週に1,000万件を超える会話を支えています。「エンタープライズグレードの音声エージェント構築」レポートによると、Meeshoは1日6万件以上の通話で、サポート問い合わせの約90%を自動化しています。チェコ共和国では、「政府における会話型エージェントの現状」レポートによると、ElevenLabsを活用したエージェントが国の給付金ホットラインで1日約5,000件の通話に対応し、問い合わせの85%を自動で解決しています。
負荷、障害、引き継ぎを最初から計画することが、デモと本番導入を分けます。
2026年に本番対応の音声AIインフラで確認すべきポイント
このチェックリストを使い、要件に照らして音声AIプラットフォームを評価してください。
- 音声認識:使用する言語、アクセント、音質に対して正確で、氏名や識別子も認識できる文字起こし。
- ターンテイキング:設定可能なターン終了動作、割り込み、測定済みの割り込み応答時間。
- モデルの選択:エージェントまたはサブエージェントごとに選択できるLLM、カスタムLLMのオプション、自動フォールバック。
- オーケストレーション:複数ステップのワークフローと専門エージェント間のルーティング。
- ツール:Webhook、クライアントツール、MCP対応、承認制御。
- 知識:独自文書と、測定可能な検索レイテンシ。
- パーソナライズ:最初の発話前に利用できる発信者データ。
- 音声:最初の発話までの短い時間と、発音や表現の制御。
- チャネル:SDKとAPIを備えた電話、ウェブ、モバイル、メッセージング対応。
- ガードレール:レイテンシへの影響が明確で、設定可能な動作制限。
- テスト:会話シミュレーション、ツール呼び出しの確認、反復実行。
- 実験と分析:A/Bテスト、パーセンタイルレイテンシ、エラーの内訳。
- スケールと引き継ぎ:文書化された同時実行数、キュー、人間へのエスカレーション。
ElevenAgentsのような主要なAI音声エージェントシステムなら、これらすべてのコンポーネントを1つのプラットフォームで利用できます。
今すぐチームにお問い合わせいただくか、アカウントに登録して独自のAIエージェントシステムを構築してください。
音声AIインフラに関するよくある質問

Jack LimebearはGrowthチームに所属し、ブログやインサイトページのコンテンツライター兼ストラテジストとして活躍しています。ElevenLabsに入社する前は、急成長中のSaaSスタートアップからFortune 500企業まで、さまざまな組織で10年以上にわたりコンテンツ戦略をリードしてきました。ケンブリッジ大学で英文学の修士号を取得しています。