テクノロジーに命を吹き込む
ElevenAgentsによるカスタマーエクスペリエンス、ElevenCreativeによるコンテンツ制作、そして最先端のAI音声ジェネレーターまで、最高のエンタープライズ、クリエイター、デベロッパーを支えています。


大手デベロッパーや企業からの信頼
同じ研究基盤から生まれた2つのプラットフォーム
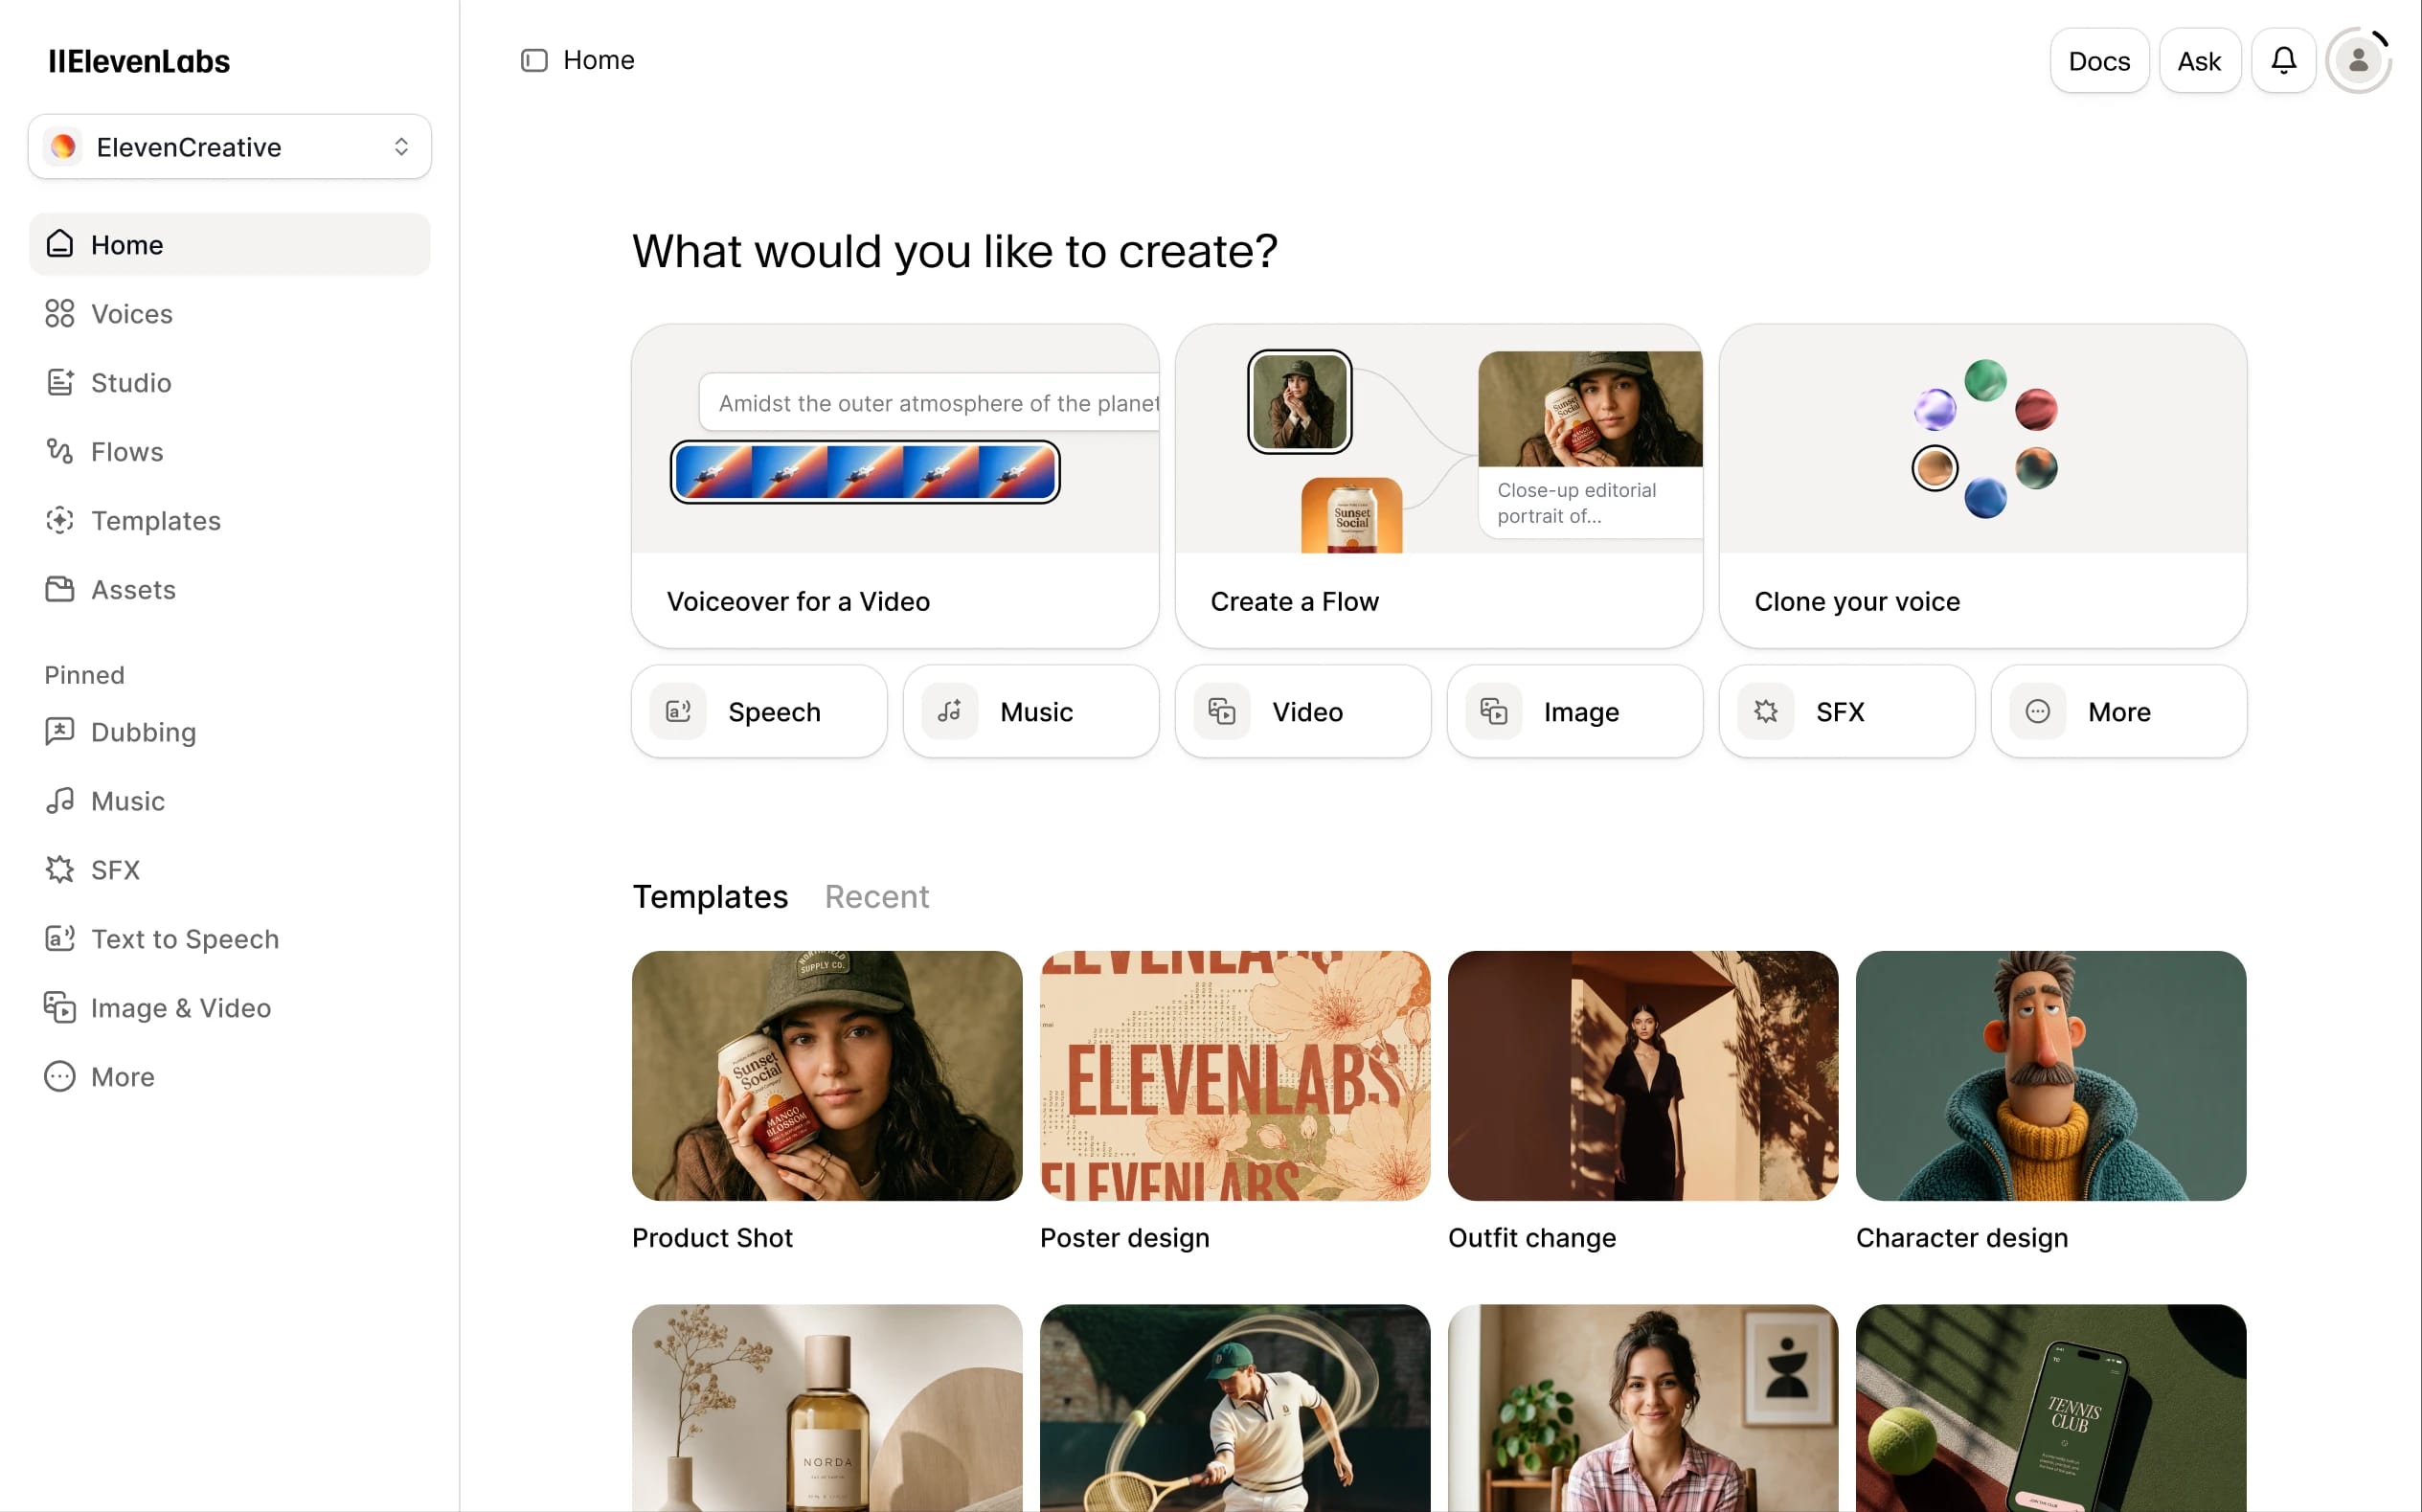

ElevenCreative
1つのAIプラットフォームで作成、編集、ローカライズ
超リアルな音声の作成、アイデアのビデオ化、あらゆるジャンルの作曲、臨場感あふれるサウンドエフェクトのデザインが可能です。クリエイティブプラットフォームで、次の映画、広告、キャンペーン、SNSコンテンツ、オーディオブック、ポッドキャストを制作できます。
オールインワンAIエディター
ElevenLabsのあらゆるオーディオ研究を結集したエディターで、ポッドキャスト、オーディオブック、ボイスオーバーを制作できます。
超リアルな音声
90以上の言語で、コントロール自在な表現力豊かな音声を作成できます。
音楽
あらゆるジャンルやスタイルのスタジオ品質の楽曲を、ボーカル入りでもインストゥルメンタルでも瞬時に生成できます。
SFX
オリジナルのサウンドエフェクト、サウンドスケープ、環境音を作成したり、SFXライブラリから検索したりできます。
音声
自分の声をクローンし、プロンプトから音声をデザインするか、ライブラリにある17,500以上の音声を探せます。
画像&ビデオ
画像を作成・編集し、Veo、Wan、Kling、Seedanceなどの先進モデルでアイデアをビデオにできます。


ElevenAgents
会話し、入力し、行動するエージェントをデプロイ
音声とチャットの両方で、高精度かつ超低レイテンシーの自然で人間らしいエージェントを90以上の言語で設定、デプロイ、監視できます。
オムニチャネルエージェント
エージェントが電話、チャット、メール、WhatsAppで、人間のように聞き、読み、やり取りします。
分析
成功率やCX指標を簡単に測定し、継続的にフローを最適化できます。
テスト
実際の会話をシミュレーションし、デプロイ前にエージェントが想定どおりに動作するか検証できます。
ガードレール
行動とコンプライアンスに関する明確なルールを設定し、エージェントの応答をポリシーに準拠させます。
ワークフロー
複雑な会話フローを処理し、ビジネスロジックを適用して、システムに安全に接続します。


テキスト読み上げ(TTS)API
第三者評価で首位に選ばれたテキスト読み上げモデル。一貫性、レイテンシー、感情表現のコントロールなど、重視する項目に合わせてモデルを選べます。すべて29以上の言語に対応しています。
Eleven Flash
会話用途で75msの低レイテンシー
Eleven Multilingual
最も自然で一貫性の高い音声
Eleven v4
これまでで最も感情豊かなモデル

ミュージックAPI
自然言語のプロンプトで、あらゆるジャンル、スタイル、構成のスタジオ品質の音楽を生成できます。
音楽
アーティスト、レーベル、出版社と共同開発。幅広い商用利用が可能です。商用利用権はサブスクリプションのプランによって異なります。
AIオーディオ研究が世界にもたらすインパクト



技術との関わり方を再定義する研究開発
テクノロジーを使ったコミュニケーションと創作をシームレスにすることが、ElevenLabsのビジョンです。人間らしい音声モデルから始まり、今では音声の枠をはるかに超える独自の基盤モデルを開発しています。
Eleven Multilingual v2
最も一貫性が高く、自然なテキスト読み上げモデル
Aug 2023
Eleven Turbo v2
高品質・低レイテンシーのテキスト読み上げモデル
Nov 2023
Eleven Flash v2.5
超低レイテンシーのテキスト読み上げモデル
Dec 2024
Scribe
初代Scribeモデル。後にScribe v3がその性能を更新
Feb 2025
Eleven v3
これまでにリリースされた中で最も表現力豊かなテキスト読み上げモデル
Jun 2025
ElevenMusic
アーティスト、レーベル、出版社と共同開発した、最高品質クラスのAI音楽モデル。
Aug 2025
Scribe v3 Live
最も高精度なリアルタイム文字起こしモデル
Nov 2025
Scribe v3
これまでにリリースされた中で最も高精度な文字起こしモデル
Jan 2026
エージェント向け表現力強化モード
実際の顧客対応向けに開発された、より表現力豊かな音声エージェント。
Feb 2026
Music v2
あらゆるジャンルで、ボーカル、楽器表現、アレンジが向上。
May 2026
Dubbing v2
初めて、元の話者の感情と表現があらゆる言語に引き継がれます。
May 2026
Eleven v4
これまでで最速かつ最も感情豊かな音声モデル。
Sep 2026

設計段階から安全性を組み込み
モデレーション
ElevenLabsの技術で生成されたコンテンツを積極的に監視しています。

説明責任
不正利用には相応の責任が伴うべきだと考えています。

来歴
オーディオがAI生成かどうかを、誰もが把握できるべきだと考えています。

最新情報
AIのインタラクションレイヤーを構築:ElevenLabs Summit NYCで発表したすべて
- カテゴリ
- 会社
- 日付
最も感情豊かなモデル、Eleven v4のご紹介
- カテゴリ
- リサーチ
- 日付
Eleven Realtimeのご紹介:自然な音声エージェントをより簡単に構築
- カテゴリ
- プロダクト
- 日付
