
- Lovable
- Veed model
- Synthesia
- Stripe
- Perplexity
- Twilio
かつてない文字起こし精度
Scribe v3は、102言語においてScribe v2より単語誤りが27%少なく、テストした他のすべてのバッチモデルを上回っています。
あらゆるシナリオに対応
ノイズの多い環境、バックグラウンド音楽、強いアクセント、低品質な音声にも対応する文字起こし。
タイミング、話者、非音声イベントを細かく制御。
ElevenLabs Transcription APIは、笑い声、感情、サウンドエフェクトを検出できます。キータームプロンプティングを使えば、ドメイン固有の用語に沿って文字起こしを誘導できます。
オーディオとビデオを文字起こし
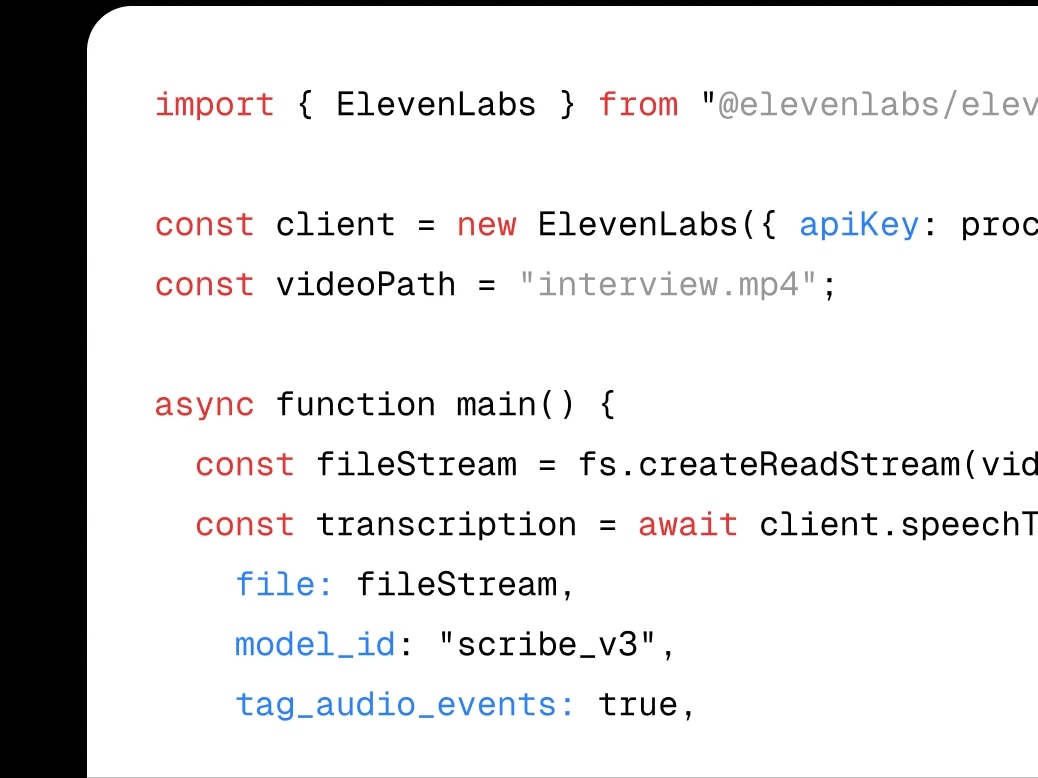
クリーンで編集可能な文字起こし

キータームプロンプティング

動的オーディオタグ付け
笑い声、拍手、音楽、バックグラウンドノイズなどの非音声イベントを捉えます。文字起こしには言葉だけでなく、音声の完全な文脈が含まれます。
スマート話者ダイアライゼーション
最大32人の話者を自動で識別し、ラベル付けします。誰が何を話したかを明確に示し、読みやすい文字起こしにまとめます。
エンティティ検出
文字起こし内の名前、日付、場所、組織などを含む56種類のエンティティを自動で識別・タグ付けします。
Scribe v2 Medicalで臨床音声を文字起こし
医療文字起こしと臨床ワークフロー向けに最適化されたスピーチtoテキストモデルです。薬剤名、解剖学用語、病理学用語の認識を強化しています。
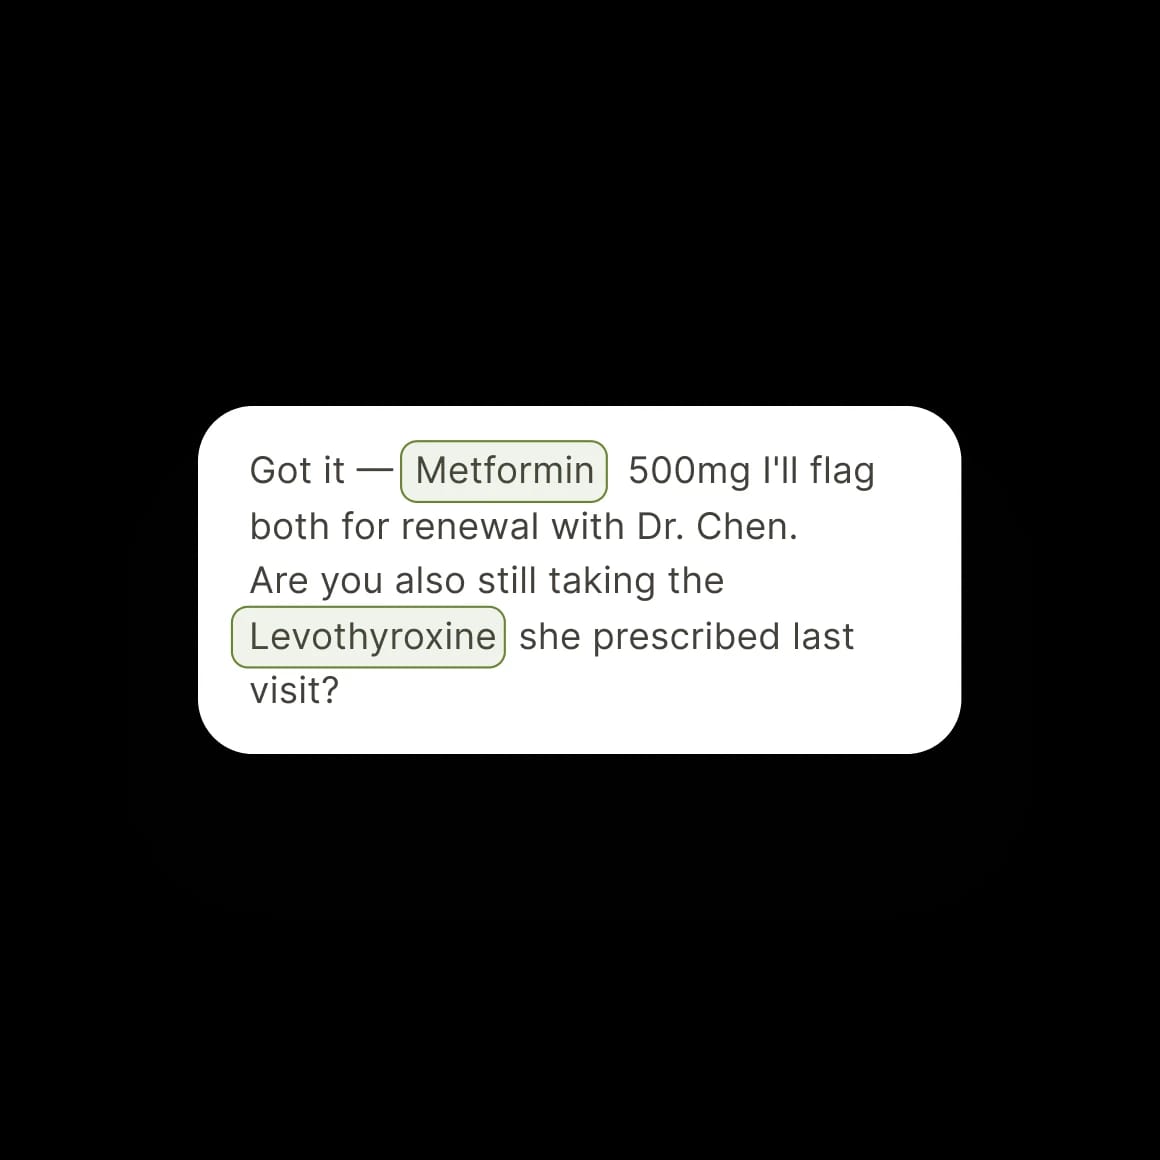
臨床音声を文字起こし
医療従事者と患者の会話、医師の口述、患者の問診内容を正確なテキストに変換。医療従事者による確認や、ノート、コーディング、後続の文書作成ワークフローにすぐ活用できます。
医療用語の誤認識を削減
用語WERでは、Scribe v2 MedicalはEka Medical ASRテスト分割でScribe v2よりエラーを15%削減。臨床用語全般で医療音声認識を向上させています。
Scribe v3
最高精度。バッチワークロード向けに設計。
- Scribe v2より誤りが27%減少
- テストした中で最も低い話者分離エラー
- 数値の書式設定と言語ヒント
- エンティティ検出とキーワードプロンプト
- 90以上の言語に対応
Scribe v3 Live
最小レイテンシー。リアルタイムワークロード向け。
- レイテンシー150ms未満
- v2 Realtimeより誤りが43%減少
- キーワードライブラリと多言語モード
- 発話交代の検出を改善
- 90以上の言語に対応
Scribe v2 Medical
臨床文字起こし向けの医療微調整モデル。
- 医療用語のチューニング
- 90以上の言語で文字起こし
- 日常会話ではScribe v2と同等の精度
- 薬剤名の認識を改善
- エンタープライズのお客様はHIPAA対象
90以上の言語と幅広いアクセントの音声を文字起こし
アクセント、方言、録音条件を問わず、優れた精度を実現します。
languageCodeを変更して言語をプレビュー
import { ElevenLabsClient } from "@elevenlabs/elevenlabs-js";
const elevenlabs = new ElevenLabsClient({
apiKey: "<your_api_key>"
});
const response = await fetch(
"https://storage.googleapis.com/eleven-public-cdn/audio/marketing/nicole.mp3"
);
const audioBlob = new Blob([await response.arrayBuffer()], { type: "audio/mp3" });
const transcription = await elevenlabs
.speechToText.convert({
file: audioBlob,
modelId: "scribe_v3",
tagAudioEvents: true,
languageCode: , // 言語を設定
diarize: true
});
console.log(transcription);


世界をリードする企業やブランドを支援
“ローカル言語でのReelsの吹き替えから、Horizonでの音楽やキャラクターボイスの生成まで、ElevenLabsプラットフォームは、世界中のクリエイター、企業、エンタープライズが音声、音楽、サウンドを大規模に活用して構築できるようにします。”

“多くの言語にわたるScribeの比類ない精度により、Fieldyは日々のあらゆる会話を理解し、大陸をまたいで容易に拡張できるようになりました。ElevenLabs Scribeへの移行後、Fieldyのユーザー継続率は50%向上しました。”

“ElevenLabsにより、強力なテキスト読み上げ機能をSDKにすばやく導入できました。これによりAgentsは、ユーザーの質問への回答や、認識した内容へのフィードバックを、表現力豊かな音声でリアルタイムに返せます。”
“TwilioはElevenLabsの生成AI音声技術をCPaaSに統合し、ConversationRelayを強化しました。この統合により、企業とデベロッパーはTwilio CPaaSプラットフォームから直接、人間らしく表現力豊かでリアルタイムに応答する会話型AI音声インタラクションを作成できます。Twilioが、利用可能な中で最も表現力豊かで人間らしい音声によってConversationRelayを強化するためにElevenLabsを選んだことを、ElevenLabs一同うれしく思います。 ”

本番環境向けに構築されたAPI

データは転送中および保存時に暗号化され、SOC2、HIPAA、GDPRコンプライアンスに対応しています。より厳格なデータ管理のために、EUデータレジデンシーとゼロリテンションモードを利用できます。
データは転送中および保存時に暗号化され、SOC2、HIPAA、GDPRコンプライアンスに対応しています。より厳格なデータ管理のために、EUデータレジデンシーとゼロリテンションモードを利用できます。
型安全性、ストリーミング対応、明確なサンプルを備えた公式PythonおよびTypeScript SDK。
スムーズな導入を支援し、安定したパフォーマンスと安心を提供しながら、運用を確実に継続できるようサポートします。
