最も感情豊かなモデル、Eleven v4のご紹介
- 公開日
- 最終更新日
聴くこの記事を聴く
テキストの一文は、話し方によって大きく印象が変わります。「落ち着いていてください」は、怯えた患者に医師が優しく伝える場合と、ゲーム内のキャラクターが戦闘に飛び込む前に仲間へ叫ぶ場合では、まったく違って聞こえるはずです。
本日、Eleven v4をリリースします。これはこれまでで最も感情表現豊かなテキスト読み上げモデルであり、低レイテンシー版のEleven v4 Turboも同時に提供します。
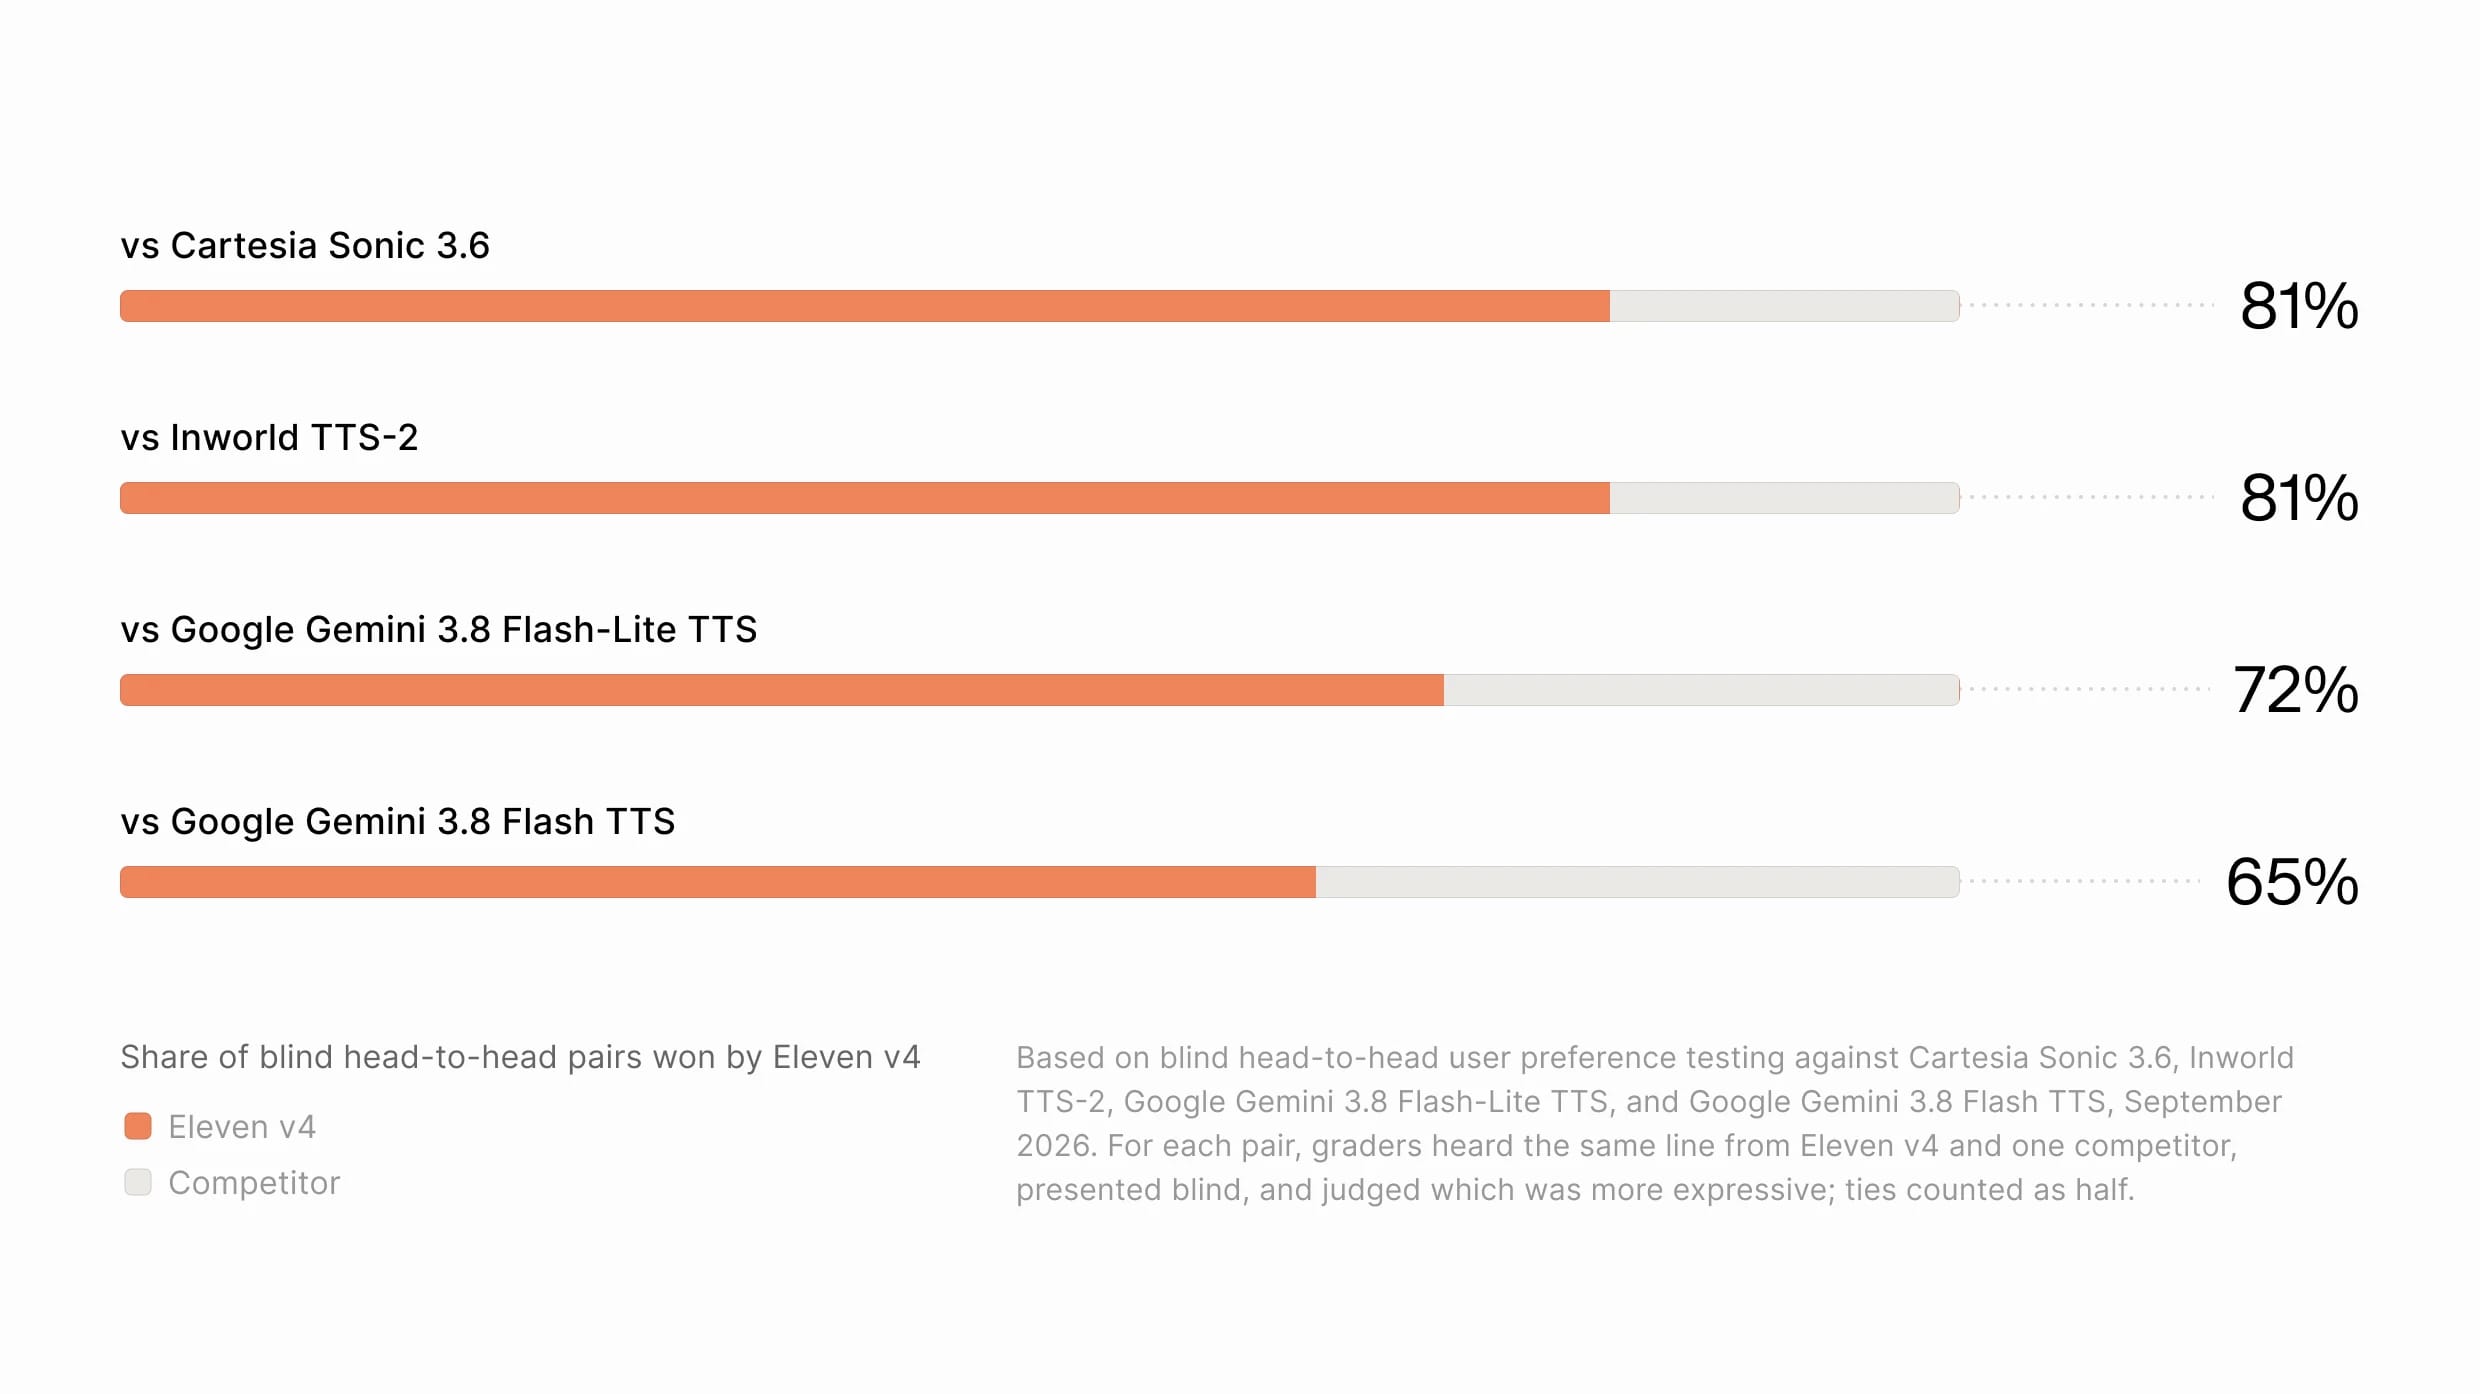
Artificial Analysisで第1位1を獲得し、競合モデルとのブラインド比較テストでは約75%のリスナーに支持された2Eleven v4は、口調、テンポ、感情、キャラクター、文脈を解釈できるよう設計されています。話者のアイデンティティを保ちながら、ドラマチック、優しい、緊迫感のある、コミカル、会話調など、さまざまな表現の音声を生成します。複数話者のやり取りもより自然になり、別々のセリフをつなぎ合わせたようではなく、会話に自然な反応が生まれます。話者は会話の文脈に応じて反応するため、より自然な対話やキャラクター同士のやり取りを実現します。
パフォーマンスを追求した新アーキテクチャ
まったく新しいアーキテクチャを基盤とするEleven v4は、これまでで最も感情表現豊かなテキスト読み上げモデルで、Artificial Analysisで第1位にランクインしています1。Eleven v4 Turboは、エージェントのような低レイテンシー用途にも同じ技術を提供します。推論レイテンシーの中央値は約100msで、2人の会話における平均的な間よりも速く応答できます。
どちらのモデルも、機械的ではなく感情のこもった音声を生成できます。オーディオの忠実度も全体的に向上し、よりクリアで自然な出力を実現しています。
従来のテキスト読み上げモデルでもテキストを音読できますが、Eleven v4ははるかに自然に感じられる感情的な深みを音声にもたらします。意図された口調、話すテンポ、文章のキャラクター、テキストの文脈を解釈し、感情に響く音声を届けます。
出力は細かく制御でき、セリフをどのように話すかを自然言語で指定できます。特定のフレーズの話し方や伝えるべき感情、さらにはサウンドエフェクトも、[laughs]、[said angrily in French accent]、[light rain]、[phone buzzing]のようなインラインタグで指定できます。Eleven v4は、従来のモデルよりもこれらのオーディオタグや指示プロンプトに正確に従うため、指定したとおりの表現を得られます。ナレーションの演出、キャラクターやその会話の作り込みなど、話し方が重要な場面で役立ちます。
ElevenLabsデベロッパードキュメントでは、タグの完全な構文とAPIを通じてこれらのタグを適用する方法を解説しています。国際音声記号(IPA)の音素への対応も大幅に改善され、カスタムの発音をより安定して利用できます。
Eleven v4では、一貫性と複数話者によるダイナミックな会話も改善されています。話者のアイデンティティを捉える新しい手法により、各音声の固有の特性を維持します。エージェントとの会話、オーディオブック、広告でも、音声の一貫性を保てます。シーン全体の文脈を理解するため、孤立したセリフをつなぎ合わせるのではなく、直前に話された内容に話者が反応する自然な対話を生成します。
低レイテンシー用途向けのTurboモデル
高品質な音声モデルは音声生成に時間がかかる傾向があり、ユーザーは高速さと表現力豊かな音声エージェントのどちらかを選ぶ必要がありました。多くの人は、問題を解決したいだけで焦っている顧客にはロボットのように感じられるかもしれない、優秀ながらも単調なエージェントを選んできました。
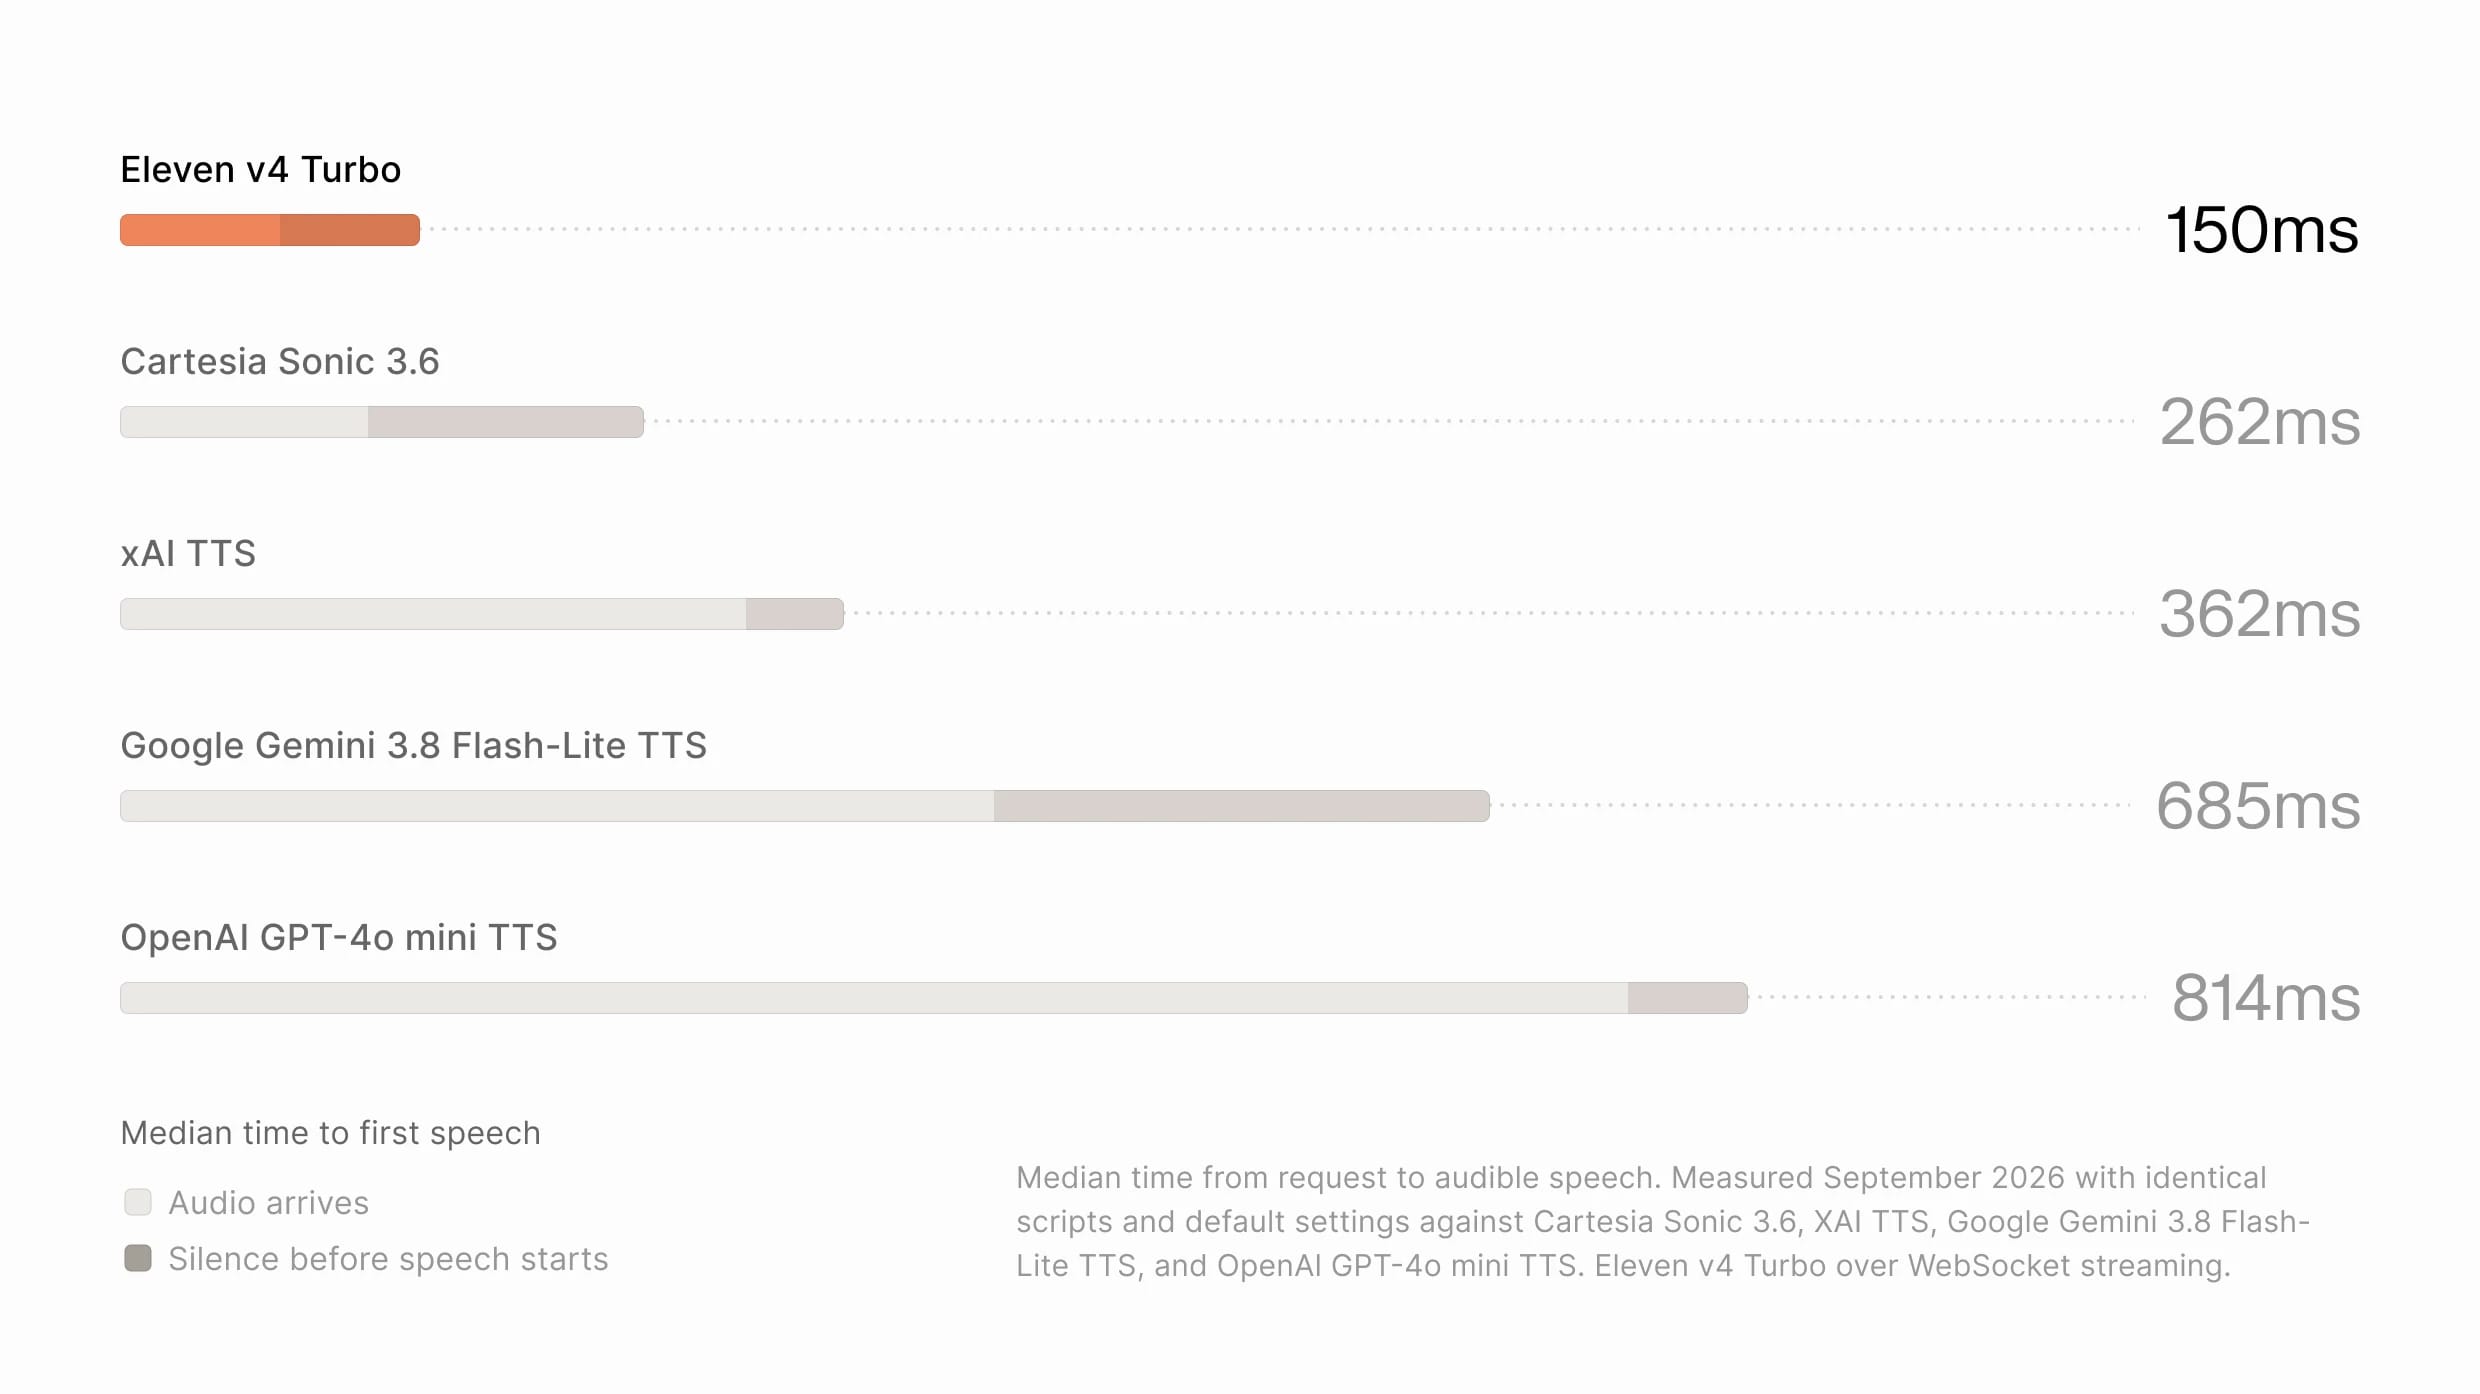
Eleven v4 Turboは、音声が最初に出るまでの時間の中央値約150ms3で、スピードと感情表現を両立します。医療用語を正確に発音して安心感を与える医療エージェントから、ゲームでプレイヤーを楽しませる早口でスラングを使いこなすエージェントまで、数え切れない業界で強力なエージェントを展開できます。
Eleven v4 Turboモデルは、ElevenLabsの会話型エージェントプラットフォームであるElevenAgentsと連携するように設計されています。他社のエージェント構築ツールでは、異なるベンダーのモデルやソフトウェアをつなぎ合わせるため、個々の用途に合わせてモデル出力を調整・改善する手段がユーザーに残されません。ElevenLabsの研究チームとエンジニアリングチームは、Eleven v4 TurboとElevenAgentsを単一のシステムとして最適化し、より表現力豊かで、信頼性が高く、低レイテンシーなエージェントを提供します。
ひとつの声、多彩な言語
コミュニケーションのあり方は、文脈、場所、さらには時間帯によっても変わります。その違いを反映した表現力豊かな音声を言語をまたいで構築することは、AIオーディオにおける最も困難な課題のひとつです。
Eleven v4は、これらすべての領域で進化を遂げており、改善は単にフレーズの発音にとどまりません。言語をまたいでリズム、感情、話し方をより的確に捉え、クリエイターがその言語や文脈に自然になじむ音声を作れるよう支援します。たとえば、日本で初対面の年配者に話しかける方法は、イタリアでの話しかけ方とは大きく異なります。
Eleven v4とEleven v4 Turboはどちらも90以上の言語をサポートしています。ある言語で録音された音声は、元のアイデンティティを保ちながらネイティブ話者のアクセントを取り入れ、他のどの言語も流暢に話せるようになりました。アクセントの再現性は以前よりも明らかに向上しており、生成中に元のアクセントへ戻ってしまうことがなくなります。
カタルーニャ語
スペイン語
吹き替えやローカライゼーションでは、ブランドに選んだ声が、起用している著名な俳優の声であっても、企業スタイルに最も合うトーンであっても、Eleven v4がサポートするあらゆる言語で優れた音声として届けられます。
より本物らしく、一貫性のあるボイスクローン
Eleven v4とEleven v4 Turboでは、ボイスクローンがより本物らしく、強力で、一貫性のあるものになり、元の音声との話者類似性も大幅に向上しています。インスタントボイスクローンでは、わずか10秒のオーディオから高忠実度で声を捉えられるようになりました。
実際の音声
Eleven v4
Eleven v4は、生成結果、対話、ナレーション、再生成したセリフでも、話者のアイデンティティをより確実に維持します。長編プロジェクトでも、キャラクター、ナレーター、クローンされた音声が制作全体を通して一貫します。最高忠実度のクローン用途向けに、プロフェッショナルボイスクローン(PVC)もサポートします。
長編コンテンツ向けに生成結果を連結するリクエストスティッチングも、Eleven v4では大幅に信頼性が向上しました。これにより、ElevenLabs StudioおよびElevenLabs Reader Appでの作業体験が改善されます。
違いをぜひお確かめください
Eleven v4とEleven v4 Turboは、表現力豊かな音声生成に関する最新の研究の集大成です。オーディオブック、キャラクターの演技、ボイスオーバー、吹き替え、会話型エージェントのローカライズなど、言葉そのものと同じくらい話し方が重要なコンテンツのために設計されています。
どちらのモデルも現在、ElevenAgents、ElevenCreative、およびElevenAPIで利用できます。無料アカウントを作成して、今すぐEleven v4またはEleven v4 Turboで生成を始めましょう。
- Artificial Analysis、Provider Voice Arena Leaderboard、2026年9月
- 2026年9月に実施した、Cartesia Sonic 3.6、Inworld TTS-2、Google Gemini 3.8 Flash-Lite TTS、Google Gemini 3.8 Flash TTSとのブラインド比較ユーザー嗜好テストに基づきます。各ペアでは、評価者がEleven v4と競合製品1つによる同一のセリフを、どちらのものか分からない状態で聞き、より表現力豊かな方とより自然に聞こえる方を評価しました。同点は0.5票として集計しています。
- リクエストから音声が聞こえるまでの時間の中央値。2026年9月に、同一スクリプトとデフォルト設定でCartesia Sonic 3.6、xAI TTS、Google Gemini 3.8 Flash-Lite TTS、OpenAI GPT-4o mini TTSと比較して測定しました。すべてのシステムでネットワークレイテンシーを測定し、除外しています。Eleven v4 TurboはWebSocketストリーミングで測定。