自然な合成音声はどのように作られる?
- 公開日
- 最終更新日
現在の高度なAIモデルは、自然な話し声のように聞こえる合成音声を作り出します。実在する人間の膨大な音声データセットで学習したモデルが、高度なニューラルネットワークを使って本物らしい話し方のパターンを特定し、再現します。合成音声を作る技術は「音声合成」または「ボイスシンセシス」とも呼ばれ、生成されるオーディオは「合成音声」と呼ばれます。
新しい合成音声を作るには、まずユーザーが自分の話し声を録音します。AIモデルはその人特有の発音パターンや抑揚を分析し、そのデータを使って声を再現します。その後、アクセント、トーン、話す速さなどの特徴を調整して、最終的な音声を仕上げます。合成音声には、1人の話し声をそのまま複製したものもあれば、複数の声を組み合わせたものもあります。録音を一切使わず、テキストの説明から音声をデザインすることもできます。
合成音声は、ポッドキャスト、オーディオブック、ビデオゲーム、広告など、幅広いクリエイティブな可能性を広げます。この記事では、合成音声がどのように作られるのか、なぜ自然に聞こえるのか、ElevenLabsで独自の合成音声を作る方法を解説します。
まとめ
- 合成音声は、人間の話し方のパターンを分析して再現するニューラルAIモデルによって作られます。
- 合成音声は、オーディオブックのナレーション、ビデオゲームのセリフ生成、ポッドキャストやボイスオーバーの大規模制作、カスタマーサービス向けAIエージェントの作成、さらには失われる可能性のある声の保存にも役立ちます。
- ボイスクローンは、特定の人の音声録音を分析し、その人特有のアクセントや話し方のパターンを再現する技術です。
- 現在のAI音声は、単語や音節を個別に再現するだけでなく、人間のプロソディを再現し、文脈も把握するため、自然に聞こえます。
合成音声が作られるまでの手順
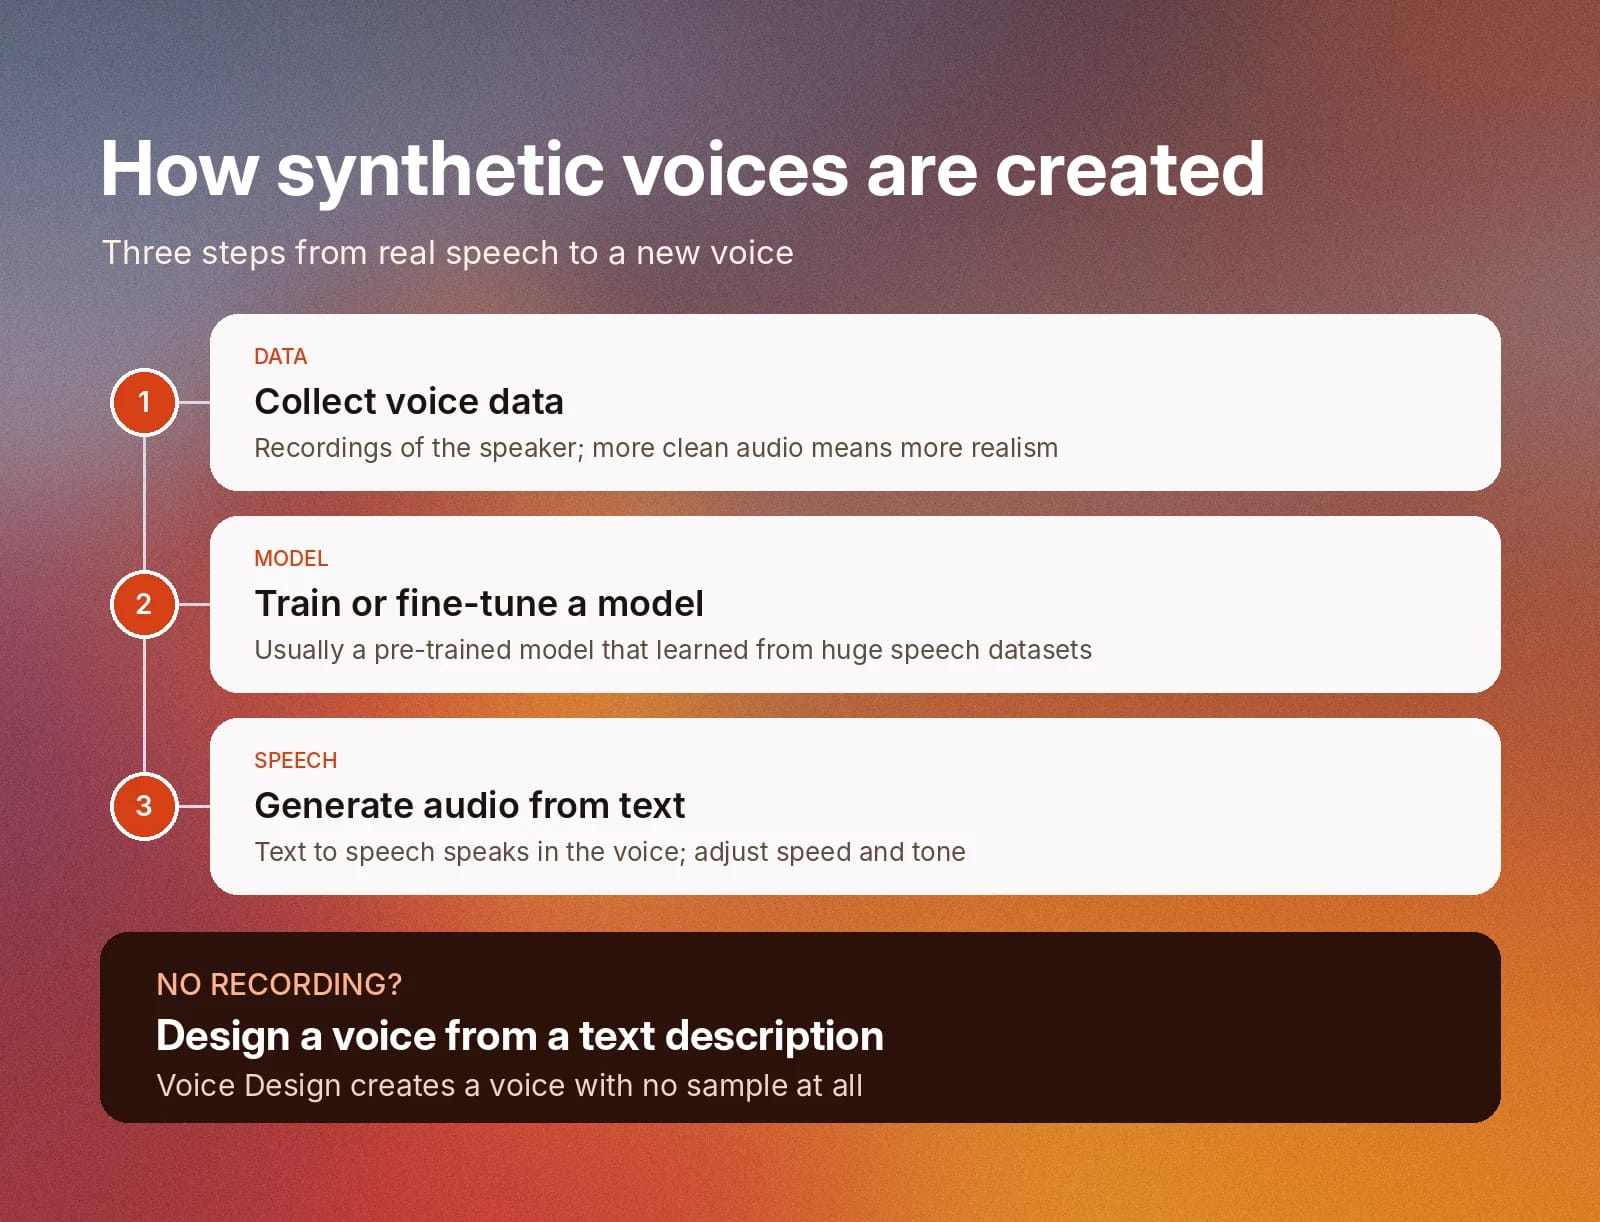
合成音声の作成は3つのステップで進みます。
実際の流れは次のとおりです。
- ステップ1:音声データを収集する:合成音声は、実在する人間の話し声をもとに作られます。新しい音声を作るには、再現したい話者の音声録音が必要です。提供するデータが多いほど、最終的な音声の精度とリアルさが向上します。詳しくは、ボイスクローンのベストプラクティスをご覧ください。
- ステップ2:AIモデルを学習または微調整する:合成音声を作るために、AIモデルはまず、多様な音声録音を含む大規模なデータセットを分析します。このデータから、人間の話し方のパターンを理解します。学習を終えたAIモデルは、1つの音声録音だけでも実在する人の声をクローンできます。通常は、ゼロから独自のモデルを構築するのではなく、事前学習済みモデルを使用します。
- ステップ3:テキストからオーディオを生成する:合成音声は、テキスト読み上げを使ってオーディオを生成します。速度やトーンなどを好みに合わせて調整できます。さらに詳しく知りたい場合は、テキスト読み上げ技術の仕組みに関するガイドをご覧ください。
音声データからニューラルテキスト読み上げまで
ニューラルテキスト読み上げモデルは、実際の音声録音を集めた多数のデータセットで学習します。データセットには、さまざまな言語、アクセント、感情、声の高さの録音が含まれます。ニューラルテキスト読み上げは、現在広く使われている音声合成方式です。
従来のモデルは、録音済みの単語、音節、音素をつなぎ合わせていました。人間らしい話し声を生み出す声の高さ、リズム、表現の変化を再現できなかったため、非常に機械的な音声になっていました。
現在のニューラルテキスト読み上げモデルは、文字や音節の発音だけでなく、人間の自然な発音パターンと話すリズムも学習します。テキストを音声に変換する際は、テキストを解析して音響特徴量に変換し、その特徴量から波形を生成します。
声の高さ、リズム、トーンなどの音響特徴がニューラルAIモデルに組み込まれているため、生成される音声は従来のモデルよりもはるかに自然で本物らしく聞こえます。
生成結果はカスタマイズも可能です。速度、感情、アクセントまで変更できるため、求める声を細かく作り込めます。たとえば、Webサイト全体で同じ合成音声を使いながら、マーケティングコンテンツでは興奮や緊迫感を、カスタマーサービスでは落ち着きを表現できます。
標準、ニューラル、生成型のテキスト読み上げ
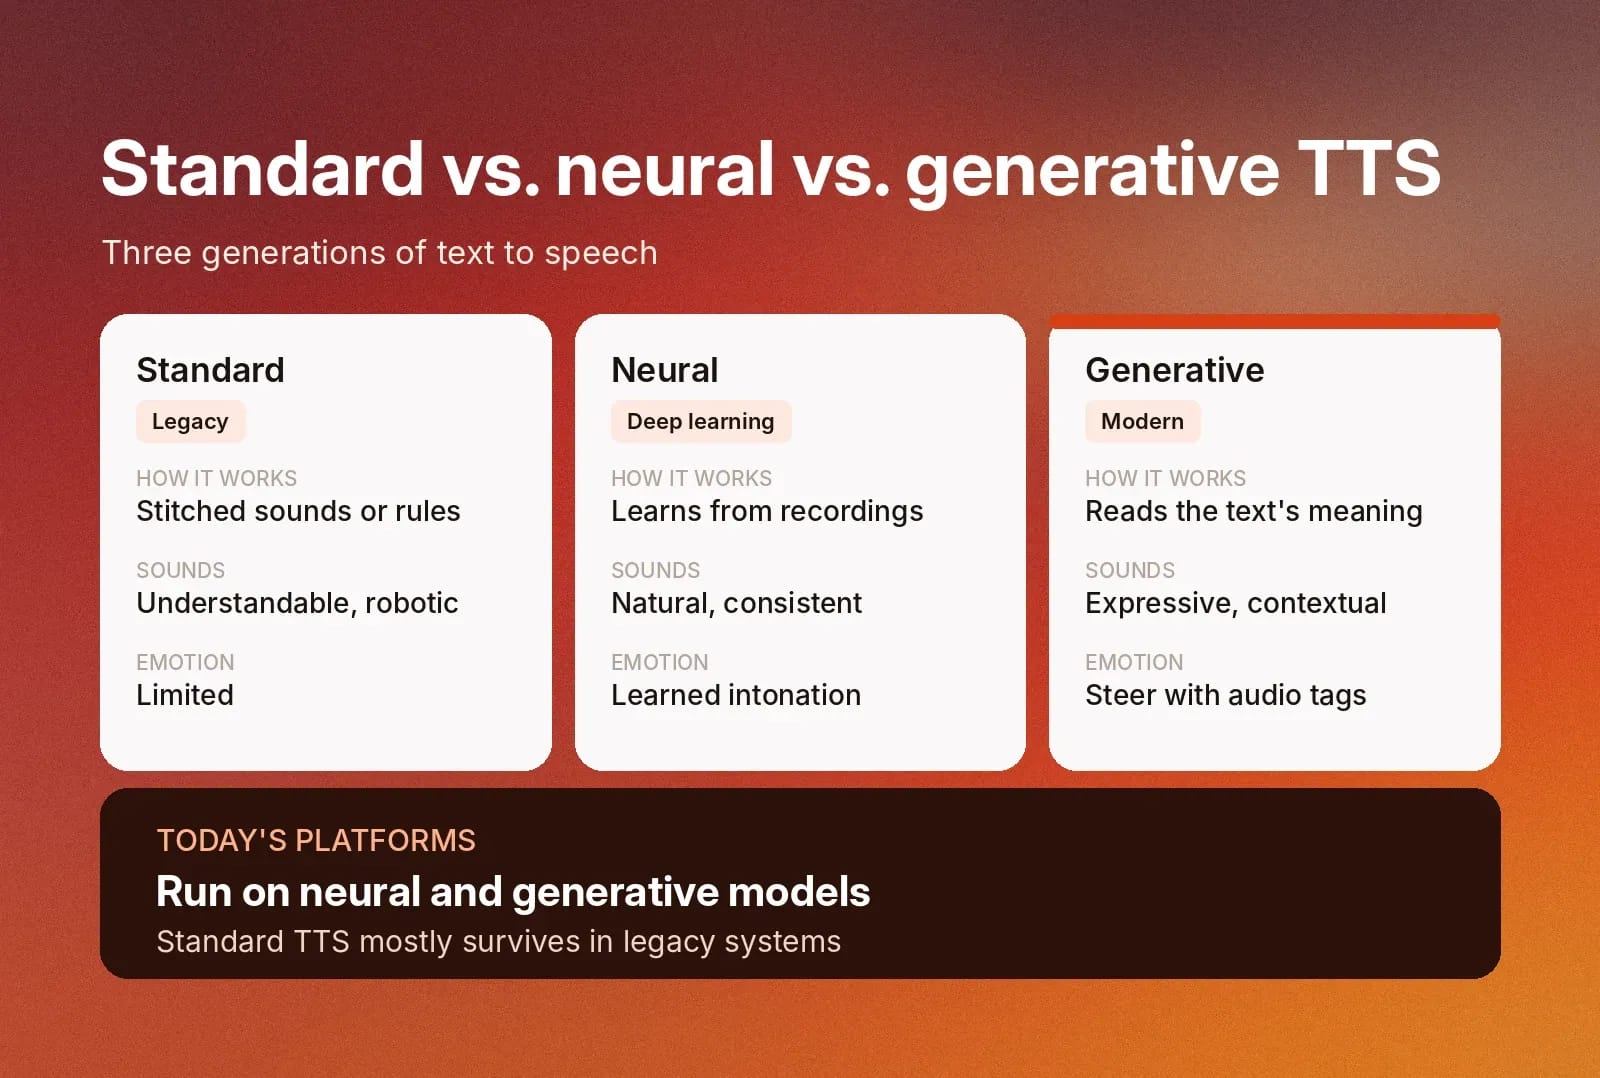
テキスト読み上げモデルは、大きく3つの世代に分けられます。
それぞれの違いを理解すると、ElevenLabsのテキスト読み上げのような現在のモデルがなぜ自然に聞こえるのかが分かります。
- 標準テキスト読み上げ:録音済みの音をつなぎ合わせるか、規則や統計モデルに従ってテキストを発音します。内容は理解できますが、感情表現が乏しく機械的です。
- ニューラルテキスト読み上げ:ディープラーニングモデルが大量の録音から発音、リズム、イントネーションを学び、より自然で一貫性のある音声を生成します。
- 生成型テキスト読み上げ:生成モデルは、さらに大規模で多様な音声データを使って学習し、テキストの意味に基づいて感情、話す速さ、強調箇所を決めます。オーディオタグなどの指示で話し方を調整できます。
現在の音声プラットフォームはニューラルモデルと生成モデルを採用しており、標準テキスト読み上げは主にレガシーシステムに残っています。
AI音声が自然に聞こえる理由
AIが生成する合成音声は、人間の声と非常によく似ています。注意深く聞かなければ、違いを見分けるのが難しいこともあります。
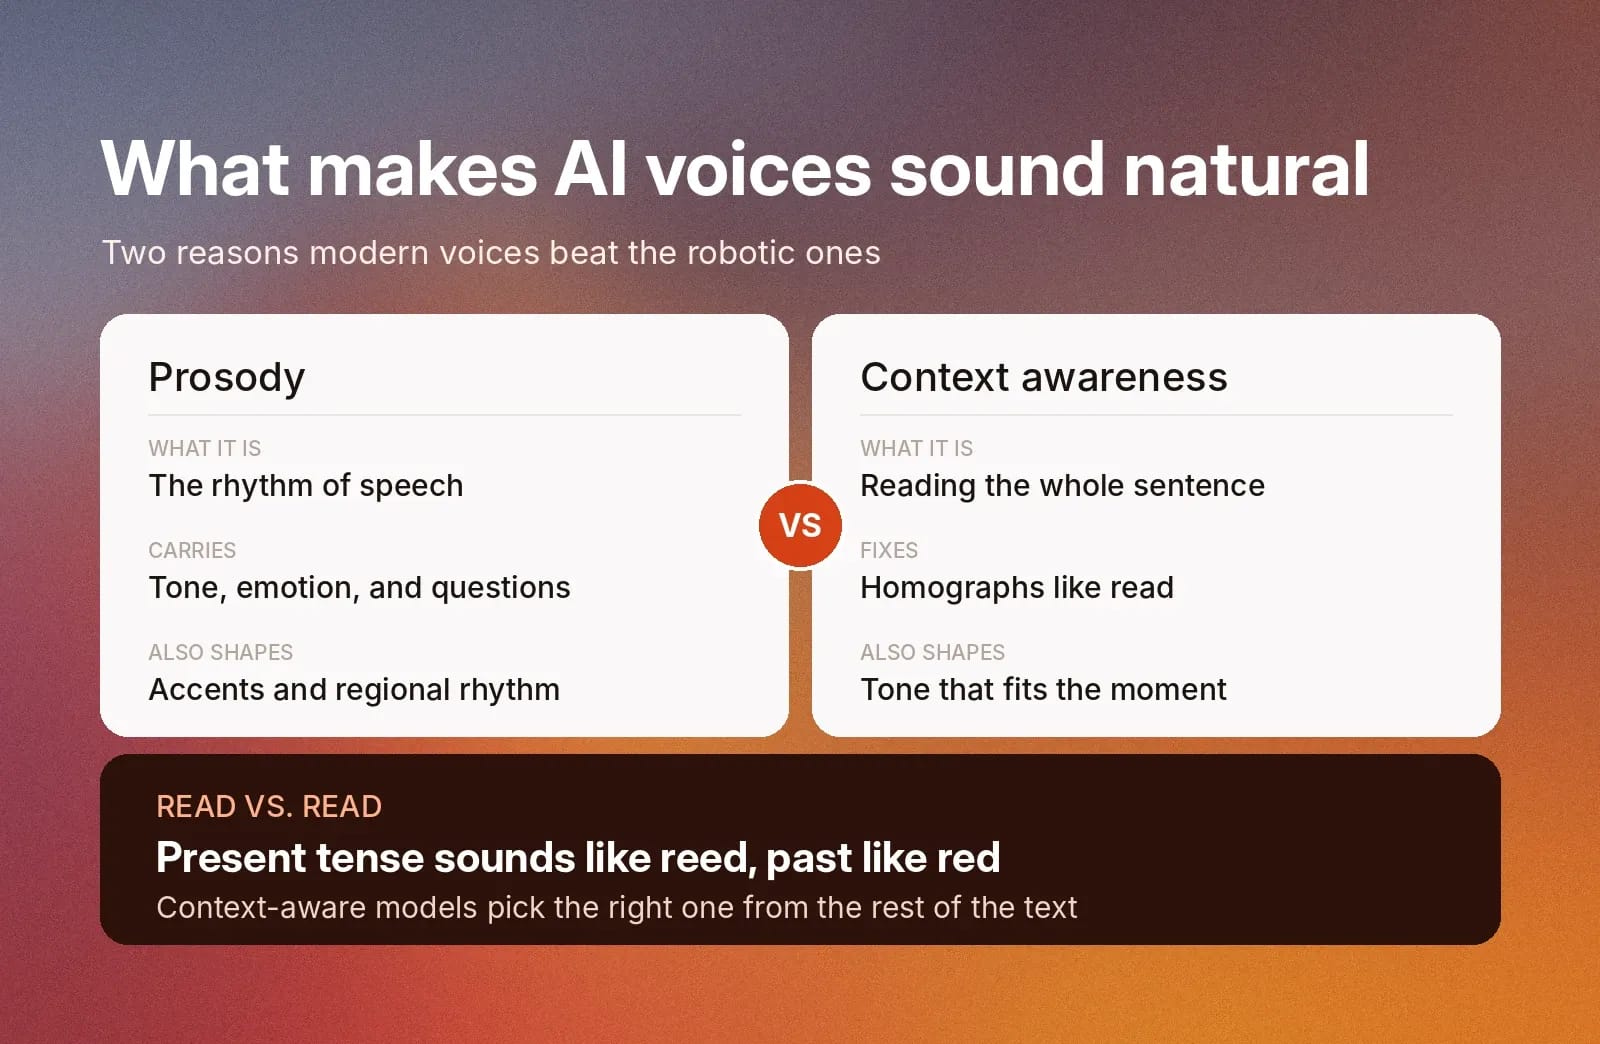
AI生成音声が過去の機械的な音声より自然に聞こえる理由は、プロソディと文脈認識の2つです。
プロソディ
プロソディとは、人間の自然な話し声が持つリズムです。話すときのイントネーションや速度のわずかな変化が、トーンや感情を伝えます。たとえば、早口は緊張や興奮を表し、文末の声を高くすると平叙文が疑問文になります。
現在のAI音声モデルは、プロソディを理解して再現できるように学習しています。そのため、硬く平坦な音声ではなく、人間の自然な会話の流れを反映した音声を生成できます。
合成音声でオーディオブックを朗読したり、ビデオゲームのセリフを作ったりする場合、プロソディによってキャラクターの感情を表現します。教育コンテンツのボイスオーバーやカスタマーサービスのAIエージェントを作る場合は、落ち着きと共感が伝わるようにAIモデルがプロソディを調整します。
AIモデルはプロソディを理解することで、特有のアクセントも再現できます。たとえば、同じ英語でも、北米英語のアクセントのリズムは、イギリス、スコットランド、アイルランドの英語アクセントとは大きく異なります。
文脈認識
AI搭載のTTSモデルは単語を1つずつ処理するのではなく、フレーズ、文、会話全体を解析し、文脈に合わせて話し方を調整します。
たとえば、つづりが同じでも、時制や文脈によって発音が異なる単語は数多くあります。英単語の「read」は、現在形では「reed」のように発音し、過去形では「red」のように発音します。
AI音声は文脈を認識できるため、前後のテキストから適切な発音を判断します。また、状況に合ったトーンや感情になるよう、話し方も調整します。
ボイスクローンの仕組み
ボイスクローンは、AIで実在する人の声を分析し、その声の特徴を合成音声に反映する技術です。
まず、声をクローンする本人が短い音声サンプルを提供します。AIモデルはそのサンプルから、アクセント、声の高さ、トーン、話すリズムを特定します。次に、これらの特徴を使って本人の声をデジタルで再現します。ユーザーはテキスト読み上げ技術を使い、この声で新しい音声を生成できます。
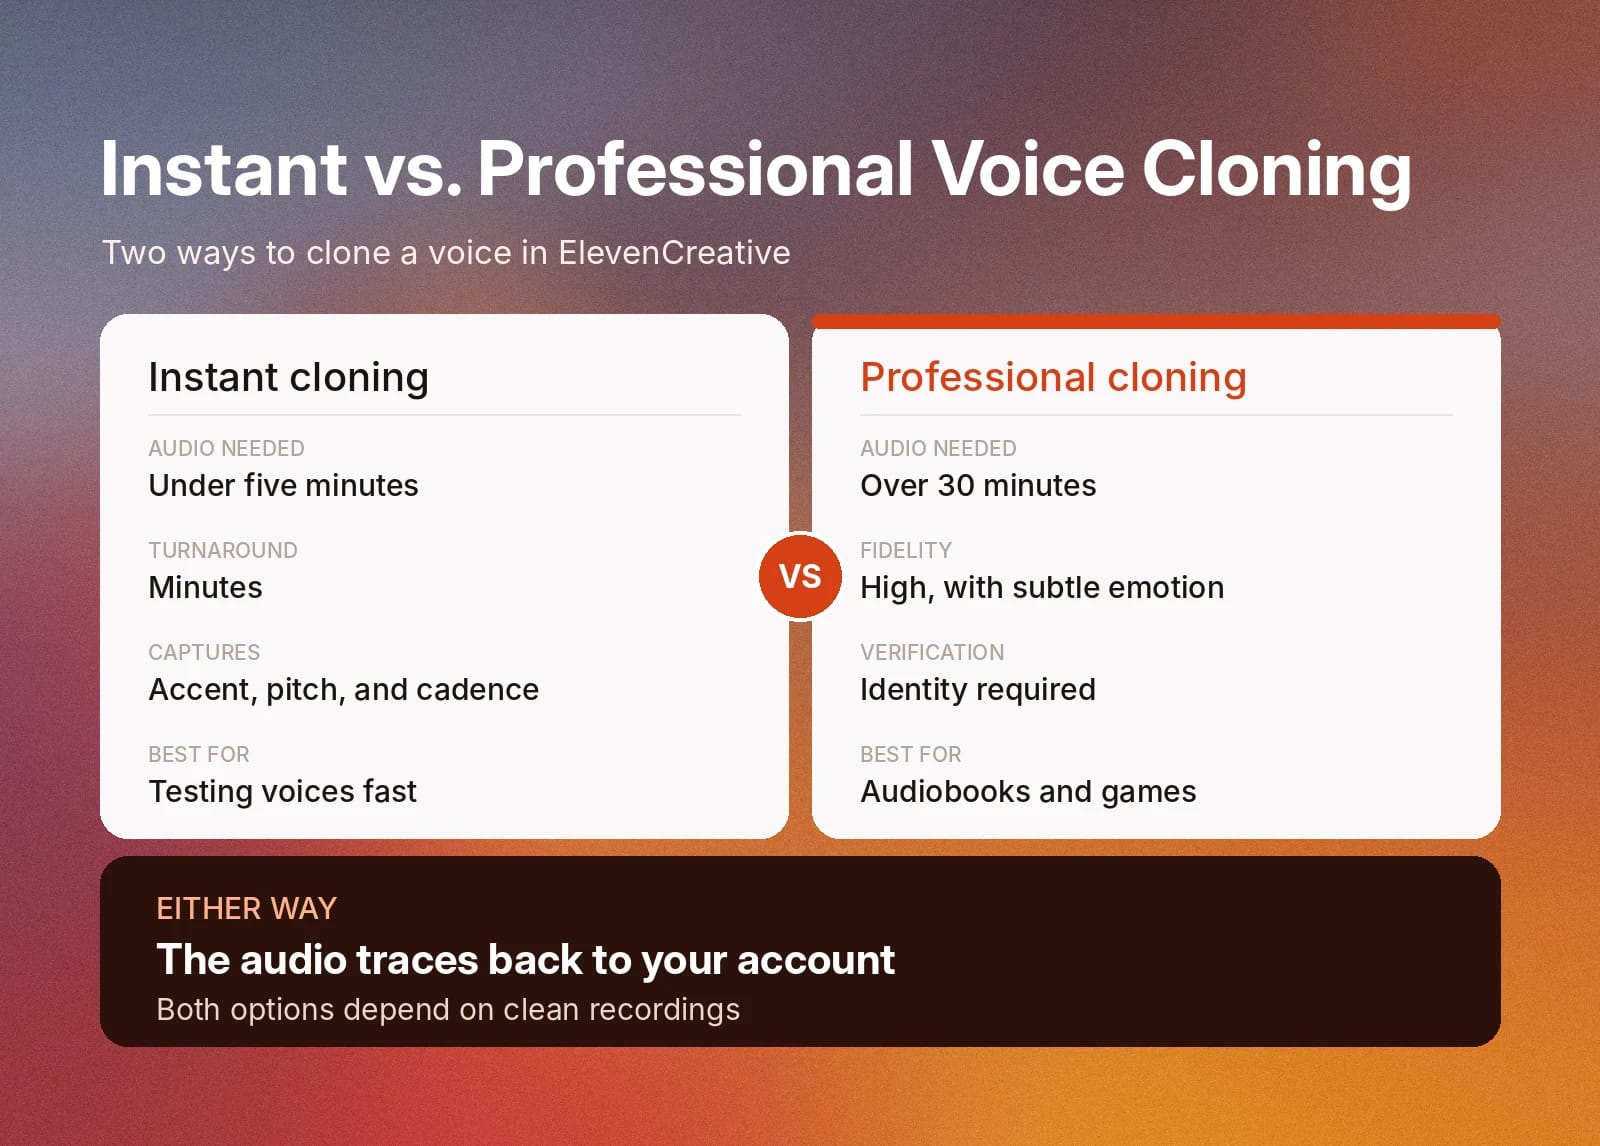
ボイスクローンには、インスタントとプロフェッショナルの2種類があります。インスタントボイスクローンは、2分未満のサンプル音声から声を再現します。そのため、大規模なプロジェクトに取り組む前に、音声の候補を手軽に試せます。
プロフェッショナルボイスクローンでは、30分から3時間の音声サンプルを使い、忠実度の高いクローン音声を作成します。インスタントボイスクローンでは捉えにくい感情やイントネーションなどの細かな特徴も再現できます。また、本人確認が必要です。
ボイスクローンには、ボイスオーバーの迅速な生成から、失われる可能性のある声の保存まで、さまざまな用途があります。
音声合成に適した音声サンプルを録音する方法
クローン音声の品質は、録音の品質に左右されます。高価な録音機器がなくても、いくつかの小さな工夫でクローン音声の仕上がりを改善できます。
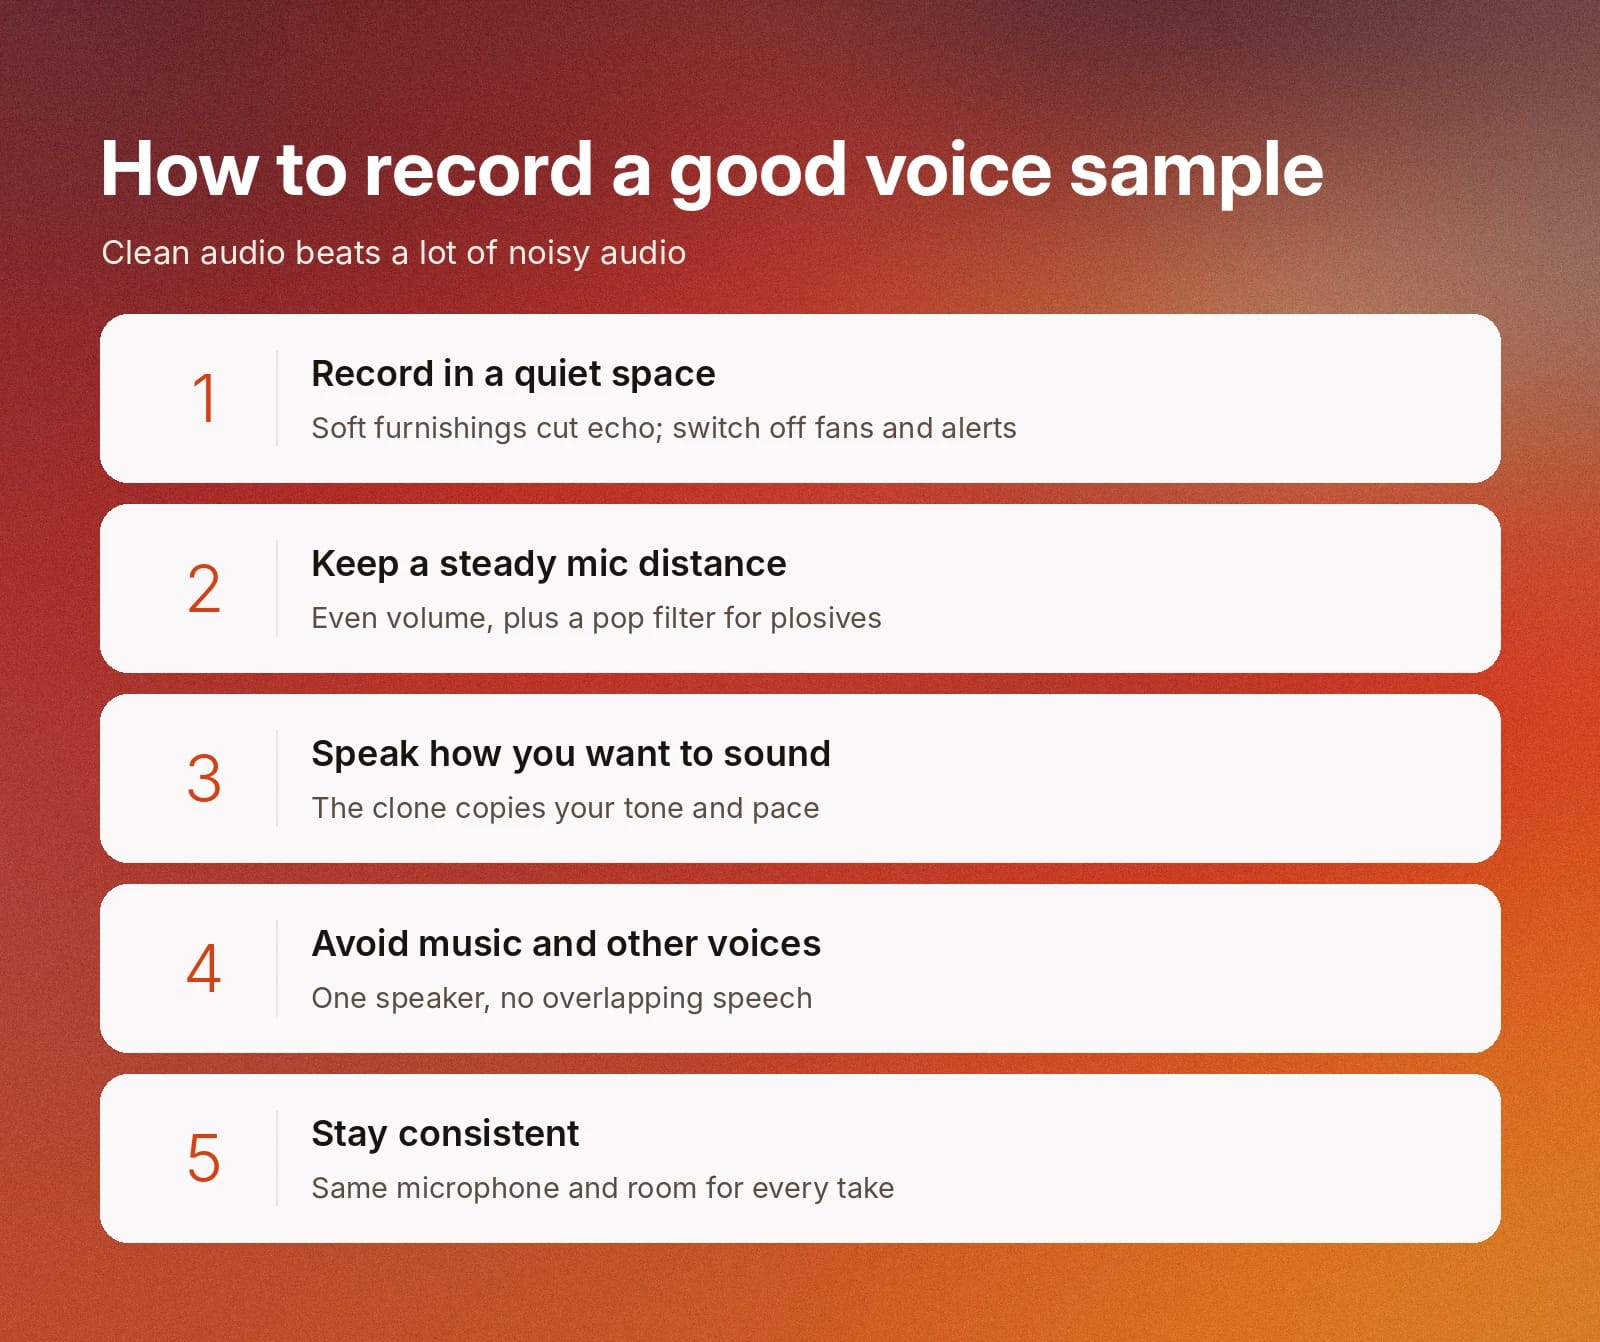
次のポイントを守ると、クリアなサンプルを録音できます。
- 静かな場所で録音する:カーテンやカーペットなどの柔らかい家具や内装材は反響を抑えます。扇風機を止め、通知音をオフにするとバックグラウンドノイズを減らせます。
- マイクとの距離を一定に保つ:距離を一定にすると音量が安定し、ポップフィルターを使うと強い破裂音を抑えられます。
- クローン音声で再現したい話し方で話す:クローン音声は元の話し方を再現します。実際に使う予定のトーンと速度で録音してください。
- 音楽やほかの人の声を入れない:話者は1人だけにし、BGMやほかの人の声が重ならないようにしてください。
- 録音環境を統一する:すべての録音で同じマイクと部屋を使ってください。
インスタントボイスクローンは少量、プロフェッショナルボイスクローンはより多くのオーディオを必要としますが、どちらもクリアな録音が欠かせません。ノイズの多いオーディオを大量に用意するより、適切な長さのクリアなオーディオを用意するほうが良い結果につながります。
録音せずに音声を作る方法:ボイスデザイン
合成音声の作成に、必ずしも録音が必要なわけではありません。ボイスデザインでは、年齢、性別、アクセント、トーン、話す速さなど、求める声の詳細をテキストで説明すると、AIモデルが説明に合う音声候補を生成します。候補を試聴して気に入ったものを選び、ボイスライブラリに保存できます。
ボイスデザインは、キャラクター、ブランド、プロダクト用の声が必要でも、クローン元となる実在の人物がいない場合に役立ちます。効果的な音声の説明を書く方法については、ボイスデザインのドキュメントをご覧ください。
AI生成音声を見分ける方法
AI生成音声だと断定できる決定的な特徴は1つもありません。どれか1つに頼るのではなく、注意深く聞き、検出ツールを使い、オーディオの出所を確認するのが効果的です。
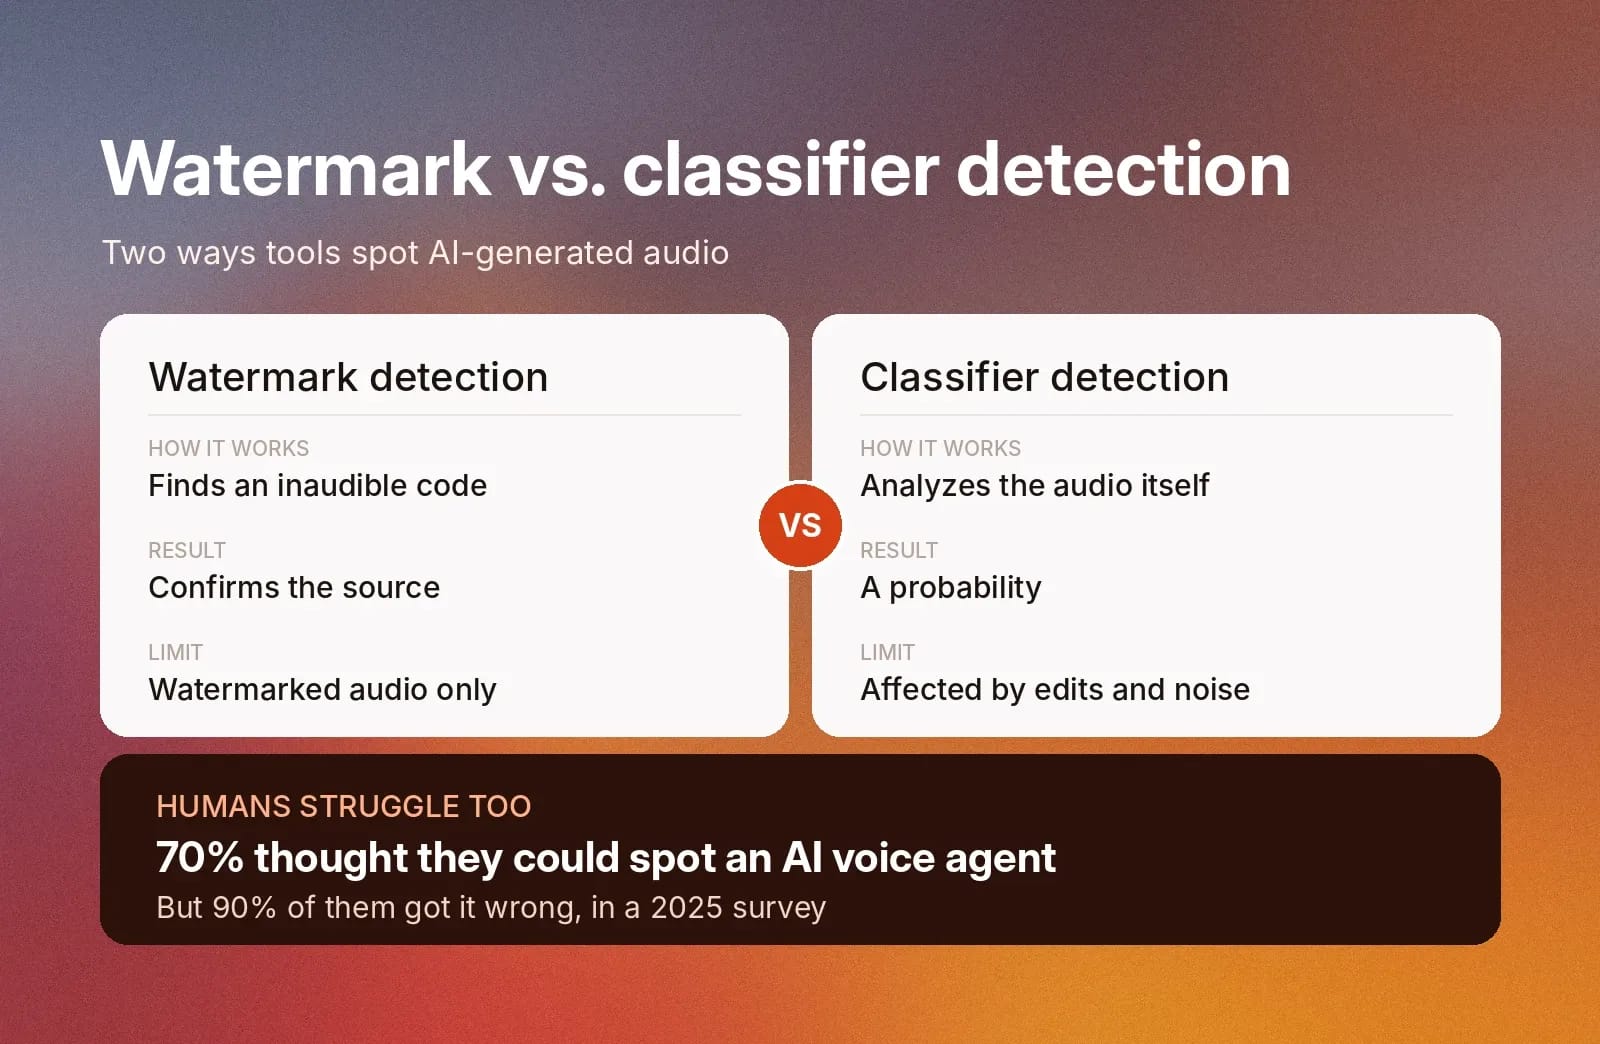
多くの人は本物の声とAI生成音声を見分けられると思っていますが、必ずしも正しく判別できるとは限りません。2025年の調査では、消費者の70%がAI音声エージェントを正しく見分けられると回答しましたが、そのうち90%は正しく判別できませんでした。
人間の耳だけに頼らず、検出ツールを使うこともできます。検出ツールの主な仕組みは2つあります。
- ウォーターマーク検出:一部のAIプロバイダーは、生成するオーディオに、人間には聞こえないコードであるウォーターマークを埋め込みます。検出ツールはウォーターマークを見つけ、オーディオの出所を確認できます。ただし、この方法を使えるのはウォーターマークが含まれるオーディオだけです。
- 分類器ベースの検出:分類器がオーディオを分析し、AIによって生成された確率を推定します。ウォーターマークのないオーディオも判定できますが、結果は確率であり、圧縮、バックグラウンドノイズ、編集の影響を受ける場合があります。
どちらの方法も完璧ではありません。検出結果は証拠の1つとして扱い、出所について分かっている情報と照らし合わせてください。詳しくは、オーディオディープフェイク検出のガイドをご覧ください。
ElevenLabs Speech Classifierは、オーディオサンプルがElevenLabsのAI音声モデルで生成された確率を判定するツールです。また、ElevenLabsはReality Defenderと提携し、音声詐欺の特定と防止に向けたディープフェイク検出の取り組みも進めています。
聞き分けるポイント
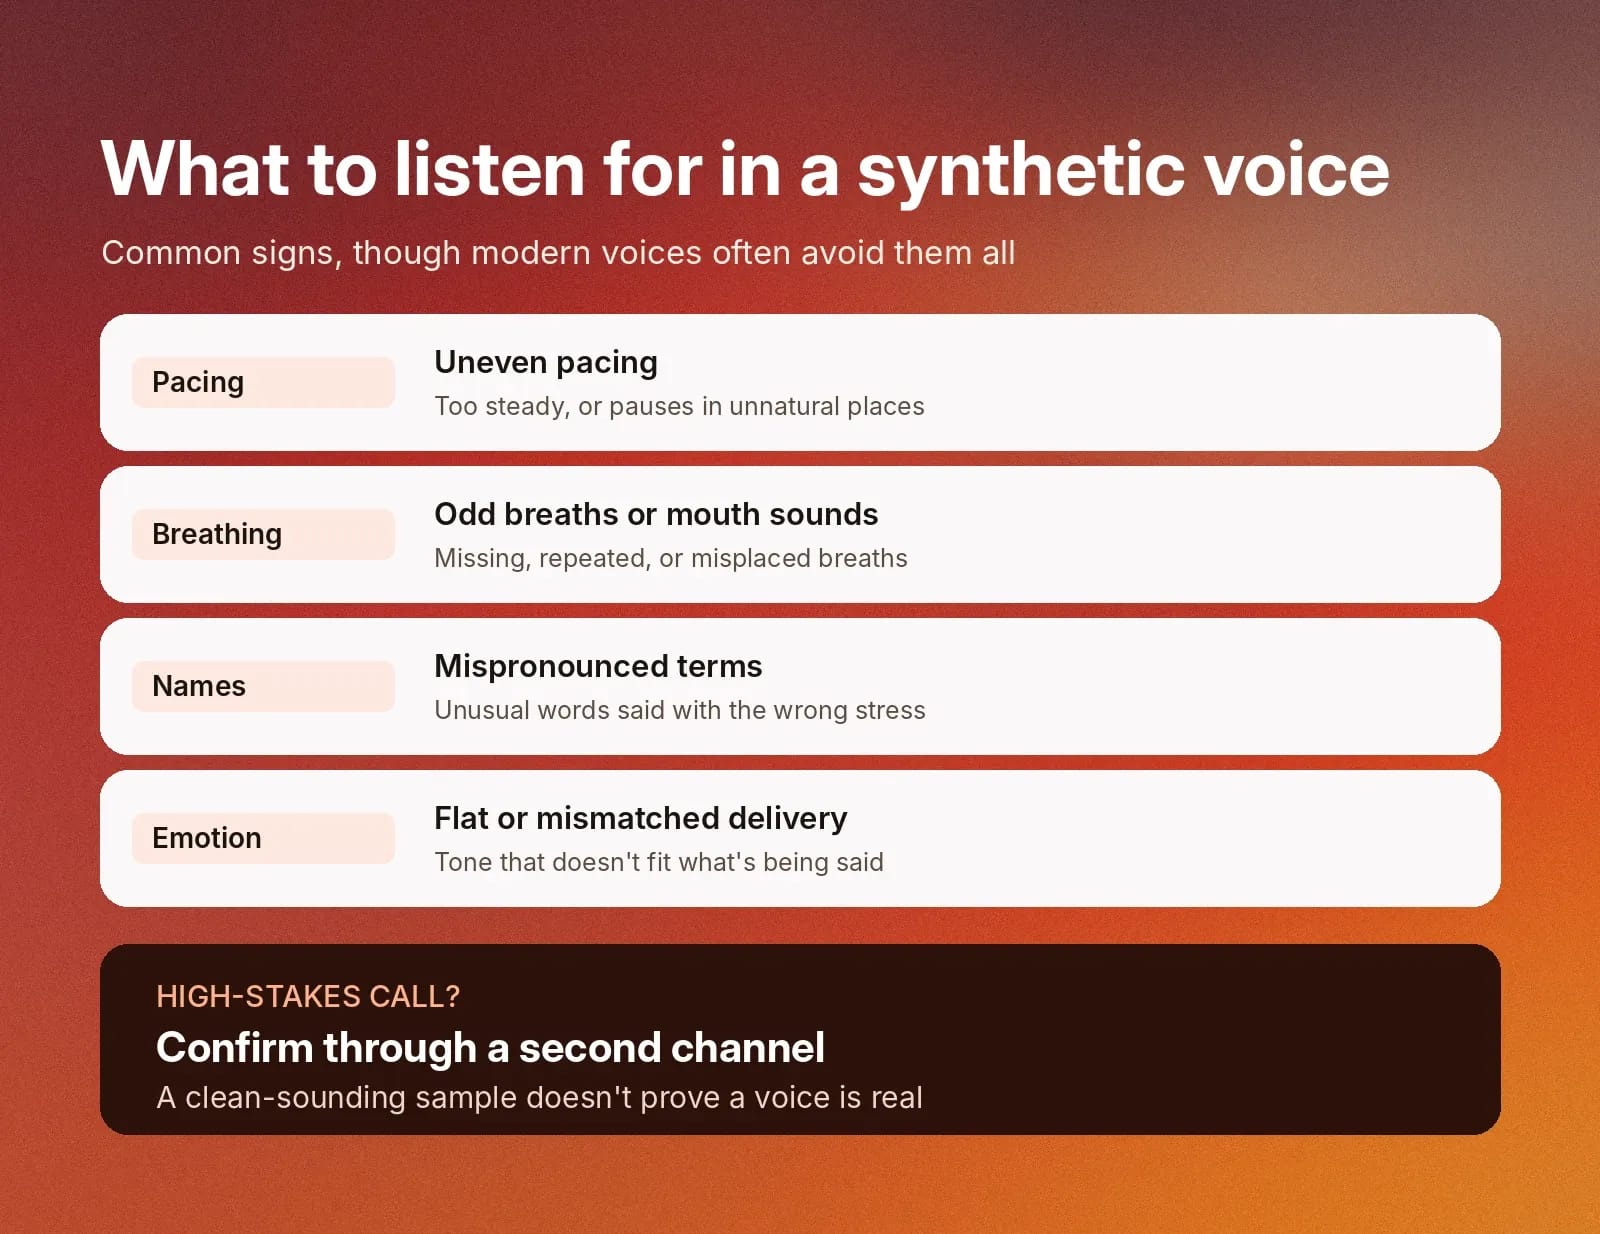
検出ツールをいつでも使えるとは限らないため、合成音声によくある特徴を知っておくと役立ちます。
次の特徴に注意してください。
- 不自然な話す速度:速さが一定すぎる、または不自然な位置で間が入る話し方。
- 不自然な呼吸音や口の音:呼吸音がない、繰り返される、または不適切な位置に入る場合。モデルが意図せず生成したオーディオアーティファクトの可能性があります。
- 名前や用語の誤った発音:珍しい単語のアクセント位置が間違っている場合。スペイン語のように、単語の特定の音節を強調するアクセント記号がある言語では、さらに起こりやすい傾向があります。
- 平坦または不釣り合いな感情:言葉の意味に合わない話し方。これはテキスト自体を理解できていないことを示し、従来のTTSモデルによくある問題です。
現在の合成音声では、こうした特徴が見られないことも少なくありません。クリアに聞こえるサンプルだからといって、本物の声とは限りません。金銭を要求する電話など、重大な影響が考えられる場合は、別の連絡手段でも確認してください。
ElevenCreativeで独自の音声体験を構築
ElevenCreativeを使えば、クリエイティブプロジェクト向けに独自の音声体験を構築できます。2万種類以上の豊富な既成音声ライブラリから選ぶことも、高精度で安全なボイスクローンを使って独自の声を作ることもできます。
ElevenCreativeでは、インスタントボイスクローンまたはプロフェッショナルボイスクローンを使って自分の声を再現できます。インスタントボイスクローンなら数分で作成でき、音声候補を試したり、個人プロジェクトをすぐに始めたりできます。プロフェッショナルボイスクローンは、より長い音声サンプルから高品質な声を作成するため、オーディオブック、ビデオゲーム、ポッドキャストなどの長期プロジェクトに最適です。どちらを選んでも、セキュリティのため、オーディオの生成元をアカウントまで追跡できます。
ElevenCreativeのカスタマイズ可能なボイスライブラリとボイスクローンツールで、クリエイティブなプロジェクトを形にできます。ElevenCreativeに登録して、著名な声を試したり、独自の声を作ったりしましょう。
よくある質問

Jack LimebearはGrowthチームに所属し、ブログやインサイトページのコンテンツライター兼ストラテジストとして活躍しています。ElevenLabsに入社する前は、急成長中のSaaSスタートアップからFortune 500企業まで、さまざまな組織で10年以上にわたりコンテンツ戦略をリードしてきました。ケンブリッジ大学で英文学の修士号を取得しています。