テキスト読み上げ技術の仕組み:テキストから自然な音声へ
- 公開日
テキスト読み上げ(TTS)技術は、書かれた言葉を音声に変換します。システムはまずテキストの内容と読み方を判断し、AIモデルが音声を生成します。
まずTTSエンジンがテキスト入力を正規化し、コンピューターシステムで処理できる数学的トークンとベクトル表現に変換します。次にモデルがこれらの数学的構造をデジタルの音響表現へ変換し、最終的に音声を出力します。
この記事では、さまざまなテキスト読み上げツールの仕組みと、最新世代の生成AIによるニューラル音声合成がこれまでで最も自然な音声を実現する仕組みを解説します。
概要
- テキスト読み上げシステムは、2段階で書かれた言葉を音声に変換します。まずテキストをトークン、つまり言語の数学的表現に変換します。次にトークンを、音として出力される音響表現に変換します。
- 新しいニューラルTTSエンジンは、AIモデルを使って自然な音声を生成します。ビジネスチームは、コンテンツ制作、字幕作成、カスタマーサポートエージェントの運用に活用しています。
- 発音辞書と音声表記タグは、TTS出力を可能な限り自然に調整し、専門用語や名前を正しく発音させるための2つの方法です。
- テキスト読み上げ(TTS)APIを使えば、ビジネスアプリケーションを高品質な音声生成に接続できます。
TTSとは?テキスト読み上げ技術の仕組み
テキスト読み上げは、書かれたテキストを分析して各単語の読み方を判断し、ニューラルモデルとボコーダーを使って音声を生成します。
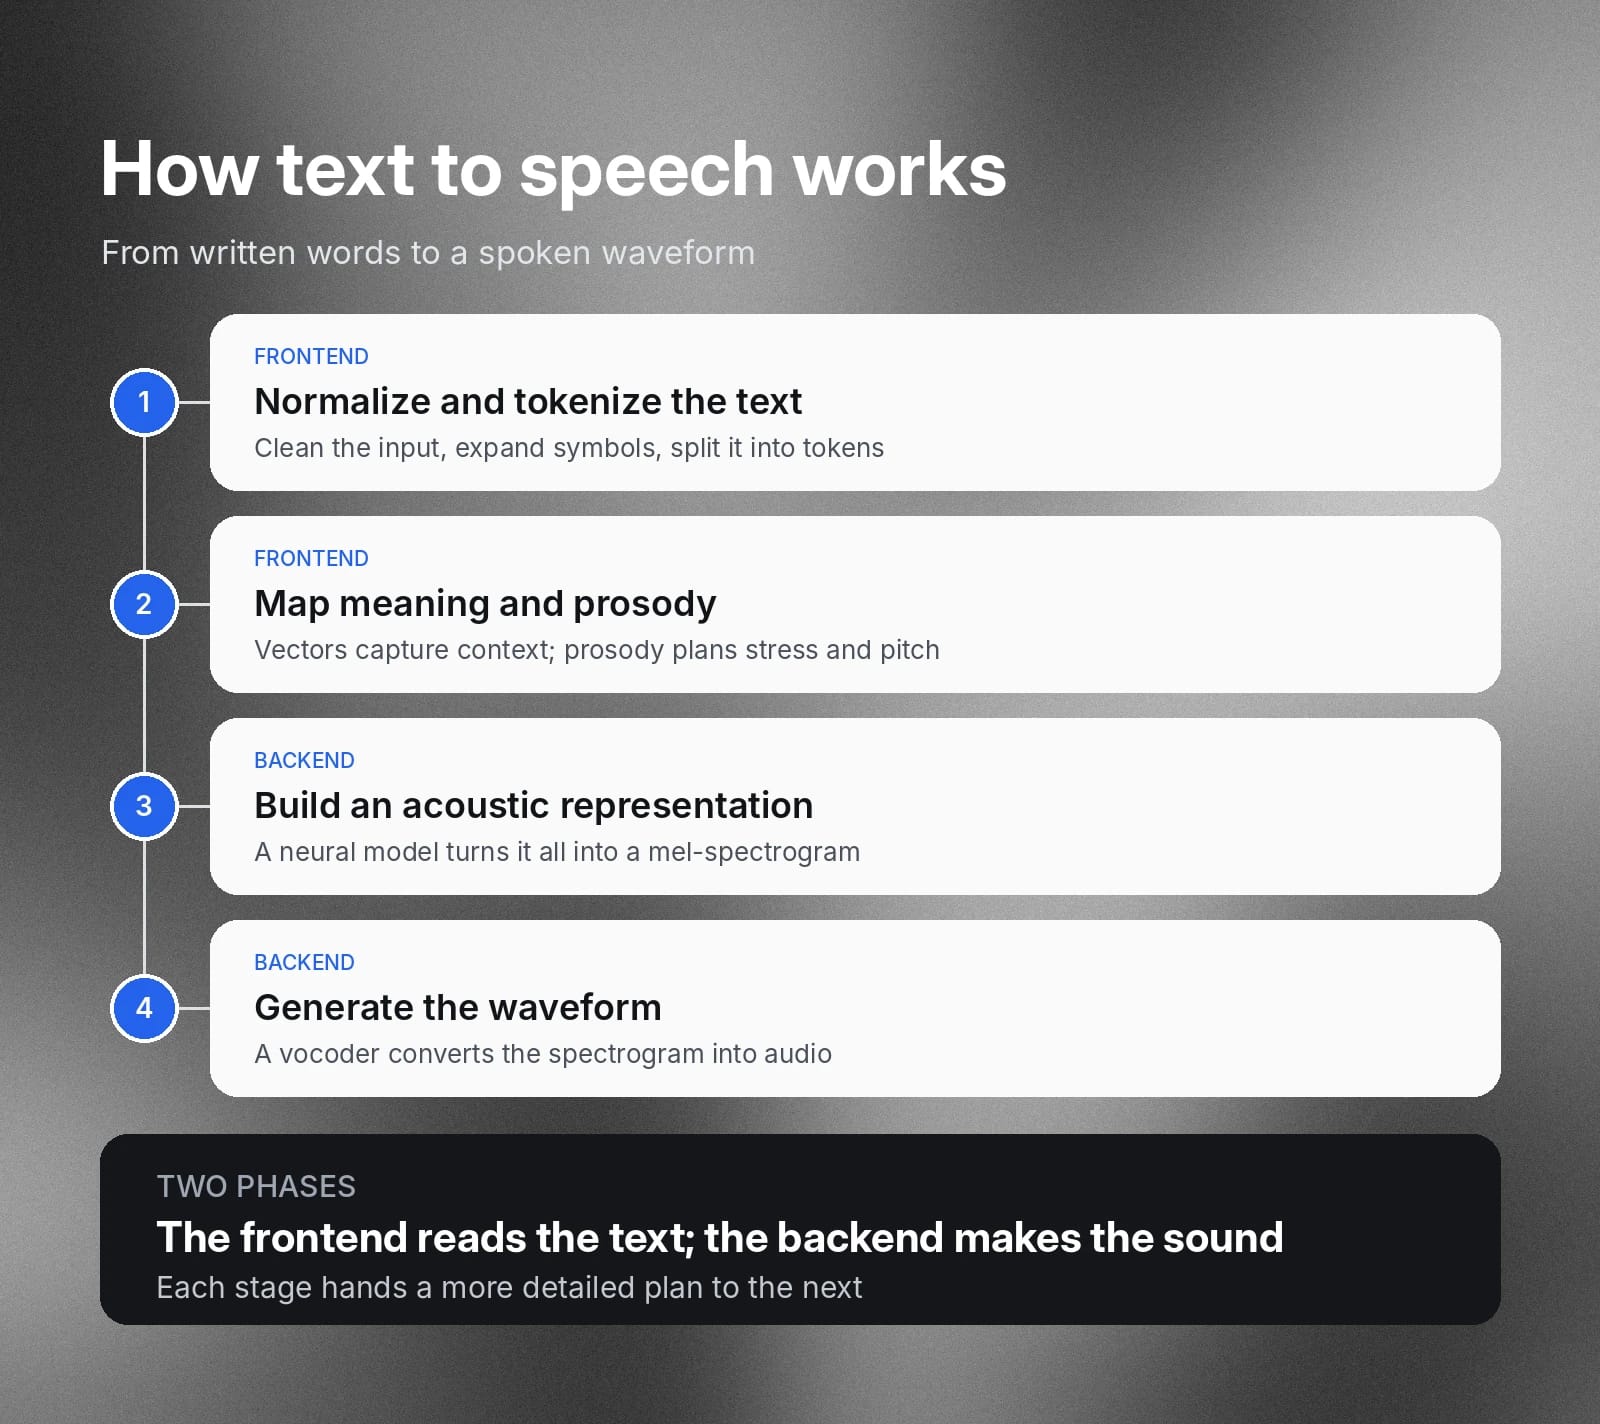
TTSは大きく2つの段階に分かれます。
- フロントエンド:システムがテキストを、TTSエンジンで処理できる数学的形式に変換します。
- バックエンド:システムが第1段階の出力を受け取り、音声を表す波形に変換します。
TTSの仕組みを構成要素ごとに詳しく見ていきましょう。
テキスト正規化と言語解析
TTS処理の最初のステップは、自然言語処理(NLP)です。生のテキスト入力をクリーンアップし、トークン化し、曖昧性を解消します。テキストは、TTSエンジンが操作できる書記言語の個別単位であるトークンに分割されます。トークンは単語全体、「サブワード」単位、句読点の場合があります。
テキストには、略語や数字など、完全な単語以外の記号が含まれることもよくあります。TTSエンジンはこれらをどう発音するかも判断する必要があります。たとえばTTSエンジンは「$11」を読み取り、「11ドル」という音に変換します。
意味とプロソディ
プロソディとは、発話の高低やリズムのことで、TTSを自然に聞こえさせる要素です。エンジンはテキストの処理中に、強勢やイントネーションの変化をテキストに対応付けるプロソディ情報の層も生成し、より自然な音声にします。
TTSエンジンは、文脈に応じてテキスト読み上げの発音も調整する必要があります。この情報は、単語や句の意味的な類似性を対応付ける数値データであるベクトル表現として構成されます。多数の点に沿って線を描くX-Yグラフのようなものですが、実際には2次元をはるかに超える次元で対応付けられます。
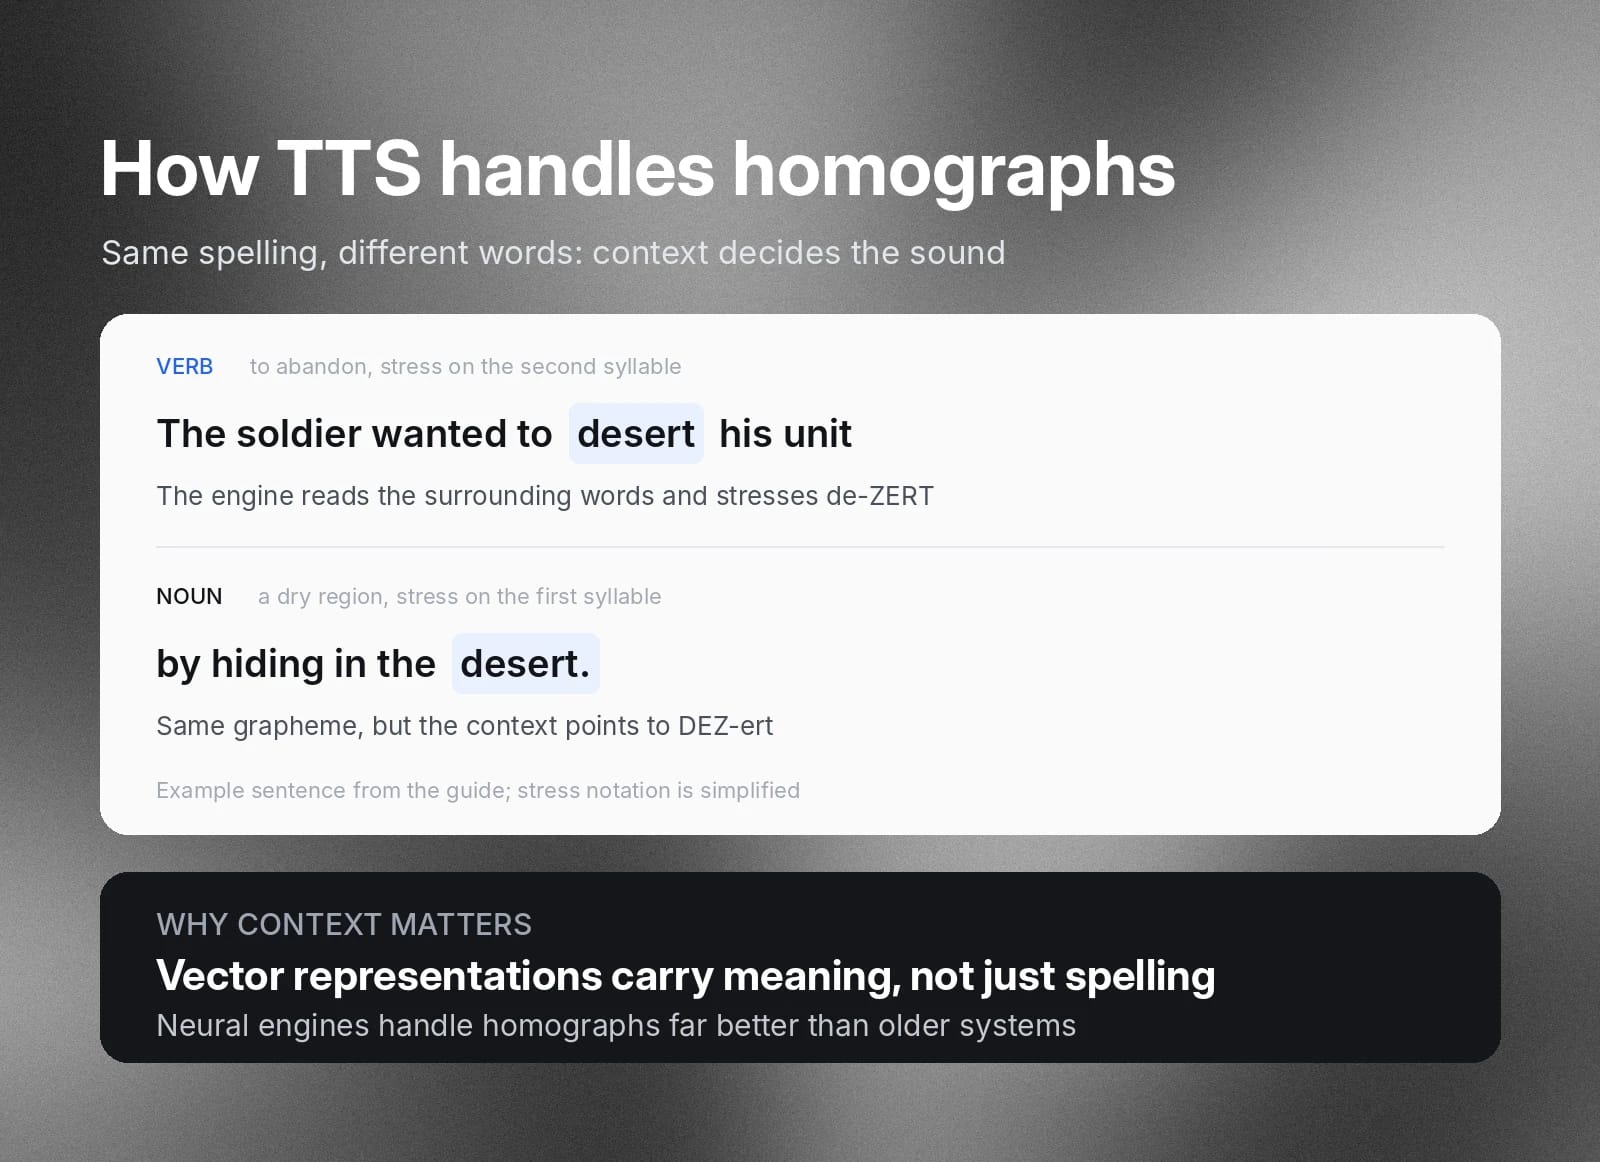
具体例として同綴異義語があります。同じつづりを共有する異なる単語である同綴異義語は、異なる発音が必要になることがあります。TTSエンジンは、発話時にそれぞれに使うイントネーションと強勢を特定しなければなりません。たとえば「The soldier wanted to desert his unit by hiding in the desert.」という文の「desert」という書記素をどう発音するかです。
Eleven v4で、この例を音声でご確認ください。
音響モデリングと波形(音声)合成
TTSエンジンは、数値データになったトークン化情報と文脈ベクトルを受け取り、メルスペクトログラムなどの音響表現に変換します。これには、脳が感情として解釈するさまざまな周波数、エネルギーレベル、音が含まれます。過去には多くのシステムがこの機能に使われてきましたが、現在はニューラルモデルが特に効果的です。
最後のステップでは、ボコーダーがこれらのスペクトログラムを、人が音声として認識するオーディオに変換します。この処理を波形生成と呼びます。
TTSの実際の仕組み:実例
TTSの各段階がどのようにつながるかを理解する最も簡単な方法は、1つの文をパイプラインに通して追うことです。
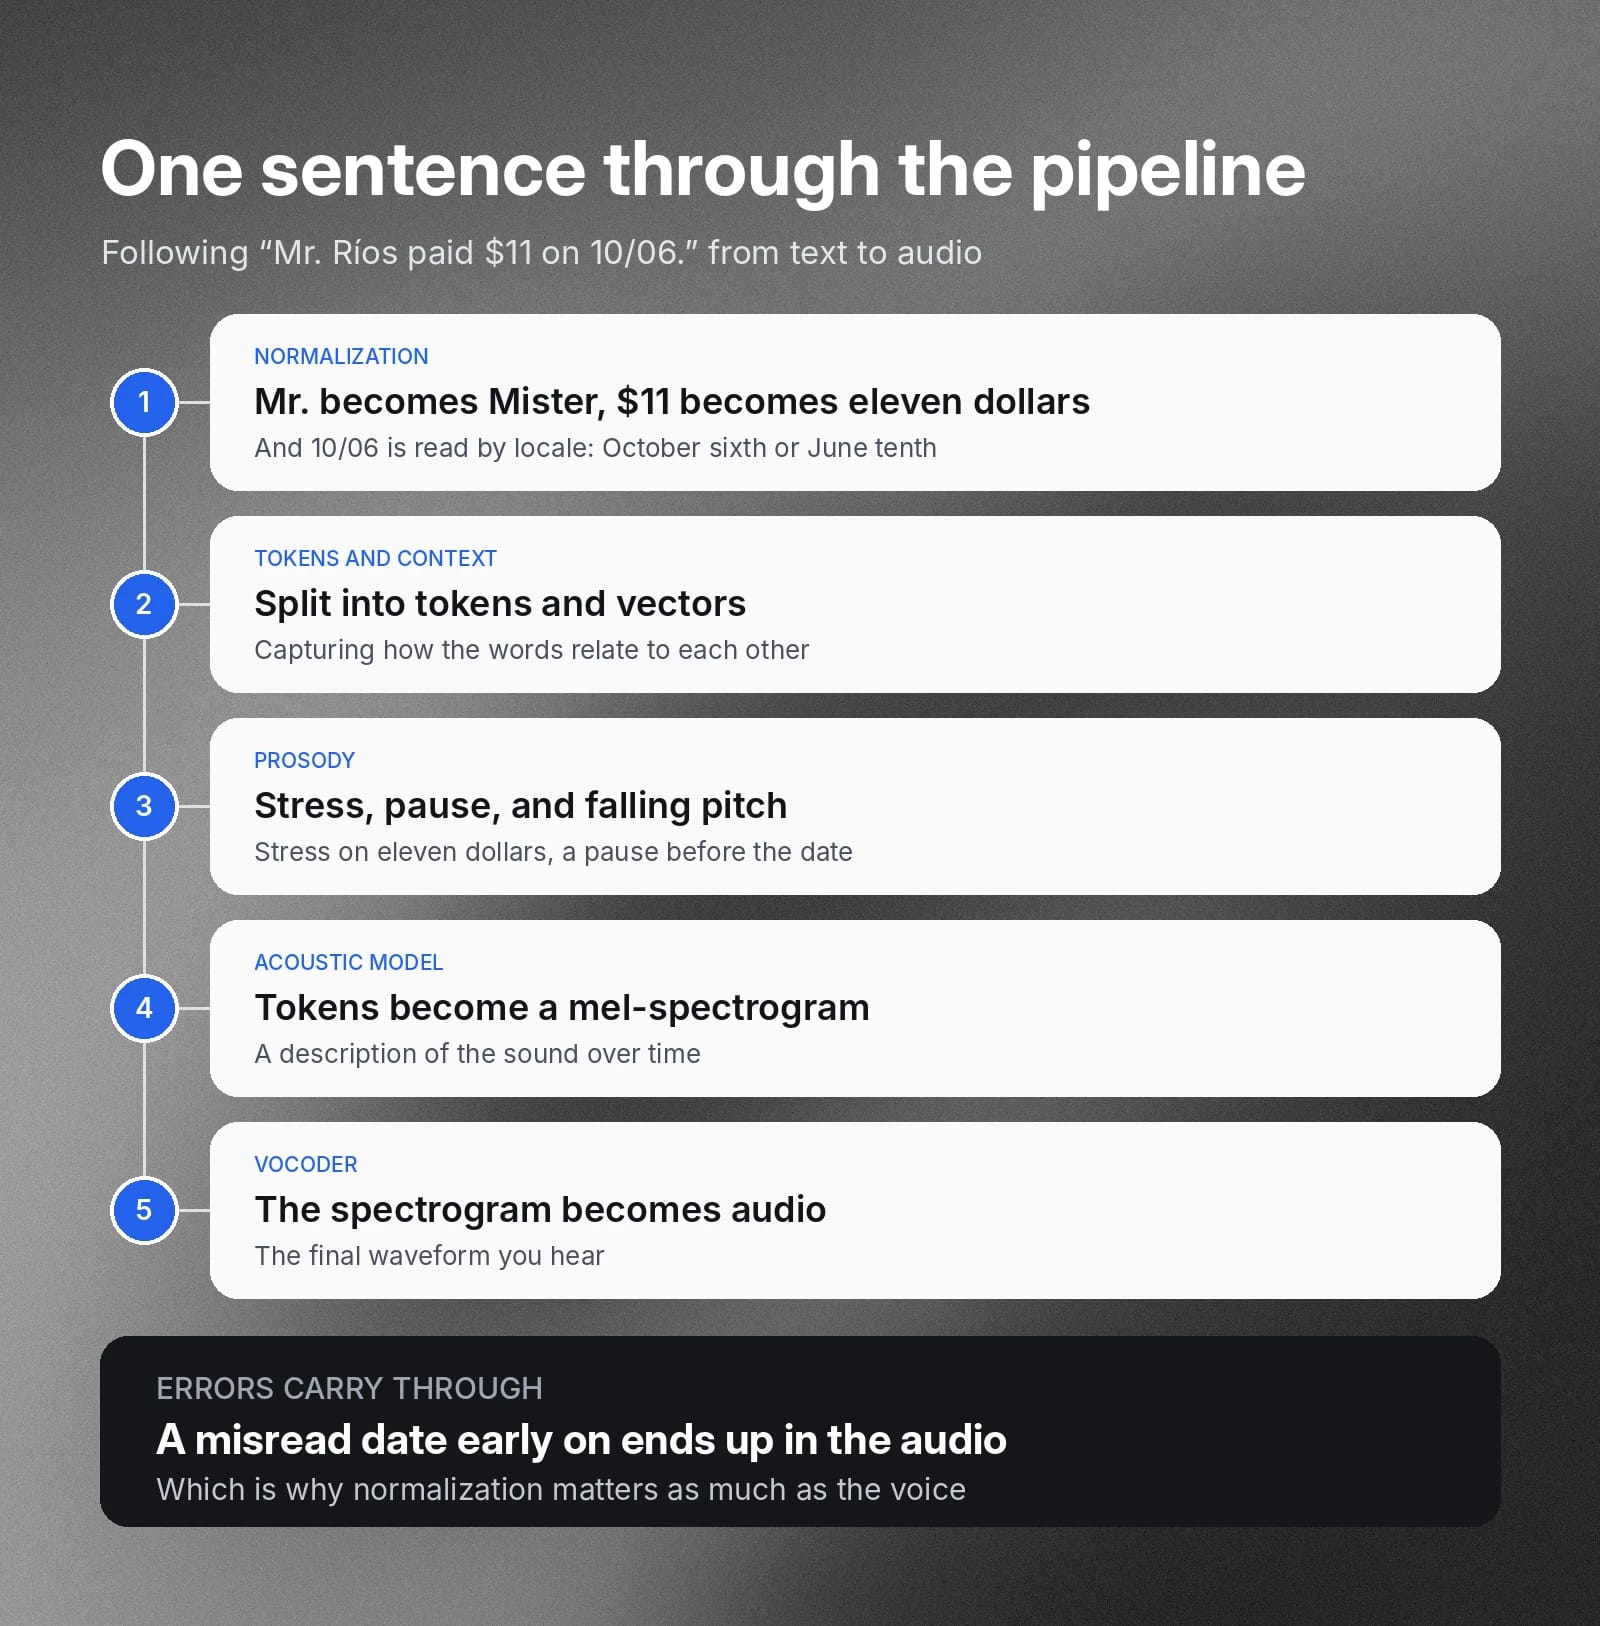
「Mr. Ríos paid $11 on 10/06.」というテキストを例にします。
- 正規化:エンジンは「Mr.」を「Mister」に展開し、「$11」を「eleven dollars」と読み、ロケールと文脈に応じて「10/06」が「October sixth」か「the tenth of June」かを判断します。
- トークン化と文脈:クリーンアップされたテキストはトークンに分割され、単語同士の関係を捉えるベクトルに変換されます。
- プロソディ:エンジンは「eleven dollars」に強勢を置き、日付の前に短い間を入れ、文末でピッチを下げます。
- 音響モデル:ニューラルモデルがトークンとプロソディ計画を、時間に伴う音を表すメルスペクトログラムに変換します。
- ボコーダー:ボコーダーがスペクトログラムを、聞こえる最終的なオーディオ波形に変換します。
各段階はより詳細な計画を次の段階に渡すため、日付の読み違いなど、パイプラインの初期段階でのエラーは完成した音声まで引き継がれます。
ニューラルテキスト読み上げがより人間らしく聞こえる理由
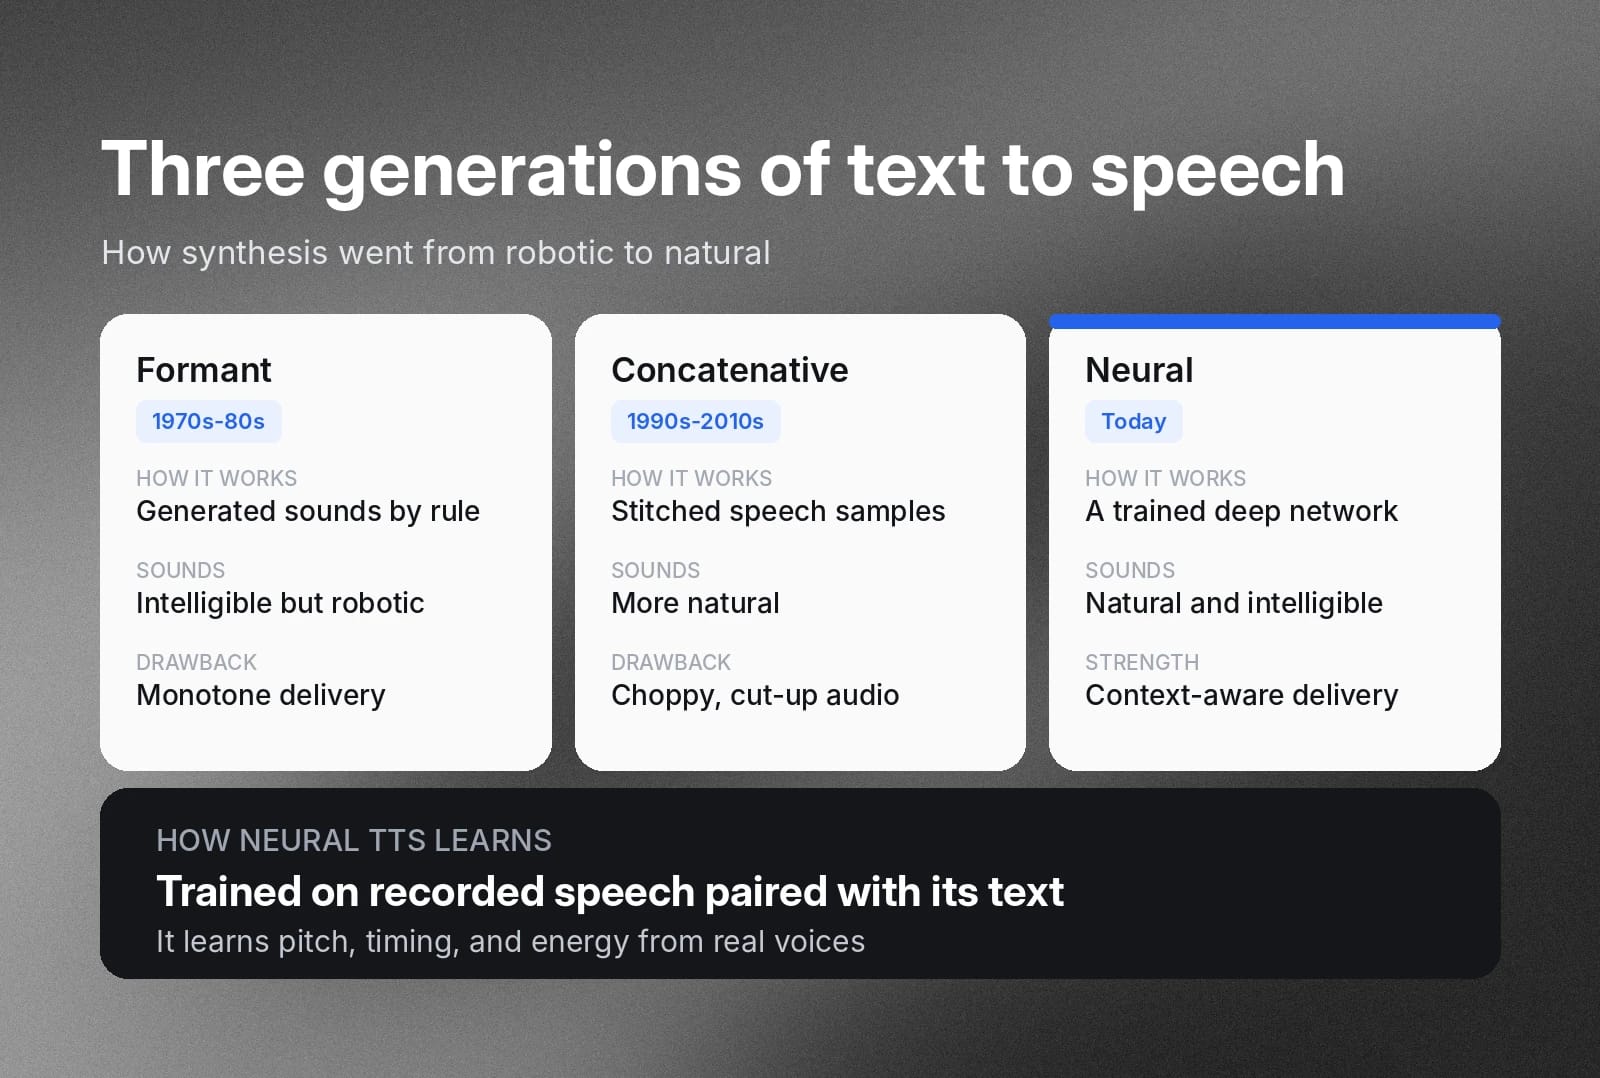
ニューラル音声合成は、自然で明瞭な音声の生成に優れています。これはエンジニアがTTSエンジンの評価に使う品質です。ニューラルTTSでは、テキスト入力から音声を生成するよう深層ニューラルネットワーク(DNN)を学習させます。DNNは、関連するテキストと組み合わせた大量の録音音声で学習します。
ニューラル音声合成エンジンは、エンタープライズ向けTTSの最新世代にすぎません。これ以前には、商用音声合成技術が2世代ありました。
フォルマント合成は、1970年代から80年代にかけて主流でした。実行時出力用に人間の音声をサンプリングするのではなく、音声をモデル化した人工音を生成していました。明瞭ではありましたが、単調でロボットのような音声.
連結合成は1990年代から2010年代に主流となり、初期のフォルマントシステムより自然に聞こえました。数理規則に基づいて音を生成する代わりに、人間の小さな音声サンプルをつなぎ合わせました。これらのシステムは言語ルックアップテーブルで正規化済みテキストと音を対応付け、大規模なライブラリ、つまり「コーパス」から取り出した連結音声の小さな単位を出力しました。フォルマントエンジンの音声より自然でも、連結合成では音声が途切れ途切れに聞こえることがあります。
AI音声ジェネレーターとテキスト読み上げの違いは?
「AI音声ジェネレーター」は、テキスト読み上げを含む幅広い音声技術を説明するために、マーケティングでよく使われる言葉です。テキスト読み上げは、書かれたテキストを入力として受け取り、その意味とプロソディをモデル化し、オーディオ波形を出力するシステムを指します。
AI音声ジェネレーターは、TTSに加え、ボイスデザイン、ボイスクローン、音声スタイル転写のための生成システムを含む、相互に関連した音声技術の包括的なエコシステムです。マーケティングではテキスト読み上げと同義に使われることもありますが、AI音声ジェネレーターは、TTSを含むより広範な生成音声ツール群の呼び名と捉えるのが適切です。
コンテンツ、アクセシビリティ、サポートにテキスト読み上げを活用する方法
テキスト読み上げモデルは、個人利用と商用利用の両方で、世界中のワークフローの中心的な要素になっています。
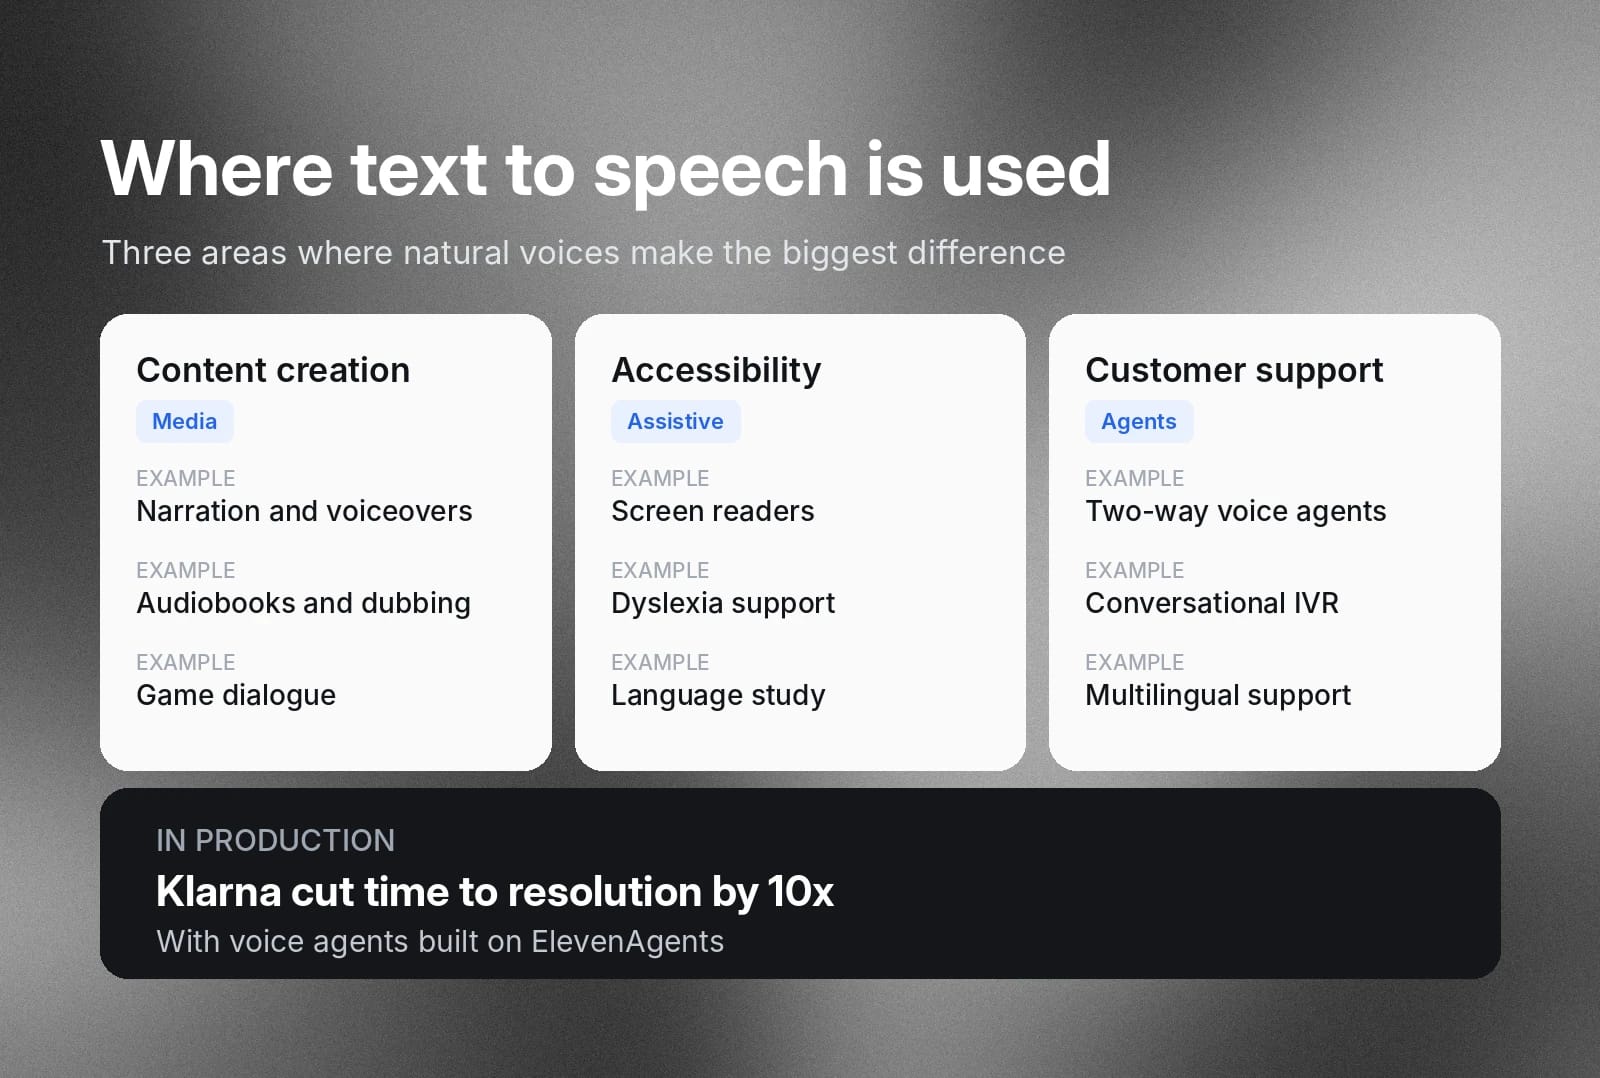
テキスト読み上げの主なユースケースをご紹介します。
コンテンツ制作
テキスト読み上げツールは、大規模なメディア制作のコストを抑え、ナレーションやポストプロダクションの録り直しにかかるスタジオ時間を削減できます。
ユースケースの例:
- ナレーション
- ボイスオーバー
- 吹き替え
- オーディオブック制作
- ゲームの台詞
たとえば、TAPはElevenLabs TTSを使用して教育コンテンツを拡大しました。対象はインド全土の学校です。
アクセシビリティ
テキスト読み上げは、書かれたコンテンツを聞いて理解できるようにするため、最も広く使われている支援技術の1つです。自然な音声はリスナーの関与を高め、長文を聞く際の精神的な疲労を軽減します。
主なTTSアクセシビリティの用途:
- スクリーンリーダー:スクリーンリーダーとTTSでページ全体を読み上げます。
- ディスレクシアと識字支援:読書中にTTS音声を併用し、読む負担を軽減します。
- ロービジョンと視覚障害:スクリーンリーダーがインターフェース要素とページ内容を読み上げるため、画面を見ずにソフトウェアやウェブサイトを操作できます。
- 認知・注意特性の違い:テキストを聞くことで、長い文書を読む負担が減り、集中を維持しやすくなります。
- 学習と言語学習:学習者は新しい語彙の正しい発音を聞けるほか、通学・通勤中や学習中に教科書を聞けます。
スクリーンリーダーは、ボタンやメニューを含め、画面上のすべてを説明する包括的なアクセシビリティツールです。読み上げツールは通常、追従するハイライトとともに内容そのものを読み上げることに重点を置きます。長時間利用されるため、より自然な音声のメリットが大きくなります。
カスタマーサポート
ニューラル音声合成は、エージェント型の対話が可能なLLMと組み合わせることで、高品質なカスタマー体験を提供できます。ElevenAgentsなどのプラットフォームは、音声レイヤー、音声認識、LLM、接続されたツールを組み合わせ、エージェントが発信者のニーズを理解して自然な声で応答できるようにします。
ElevenAgentsで構築したエージェントは、電話、ウェブ、WhatsApp、メール、SMSで利用でき、顧客は同じ説明を繰り返すことなくチャネルをまたいで会話を続けられます。ユースケースの例:
- 双方向音声AIエージェント:ナレッジベースの質問に答えたり、返金や購入などの特定フローへ顧客を案内したりして、ライブ会話に対応します。
- 自動音声応答(IVR)システム:「営業は3を押してください」のような古いメニュー構造を、顧客が自然に話せる会話に置き換えます。
- 多言語サポート:単一のエージェント設定で、顧客それぞれの言語に対応します。
たとえばKlarnaは、ElevenAgentsで解決までの時間を10分の1に短縮しました
テキスト読み上げエンジンは発音をどう制御する?
最新のニューラル音声合成エンジンは非常に自然な音声を生成できますが、人間の言語のように広く、深く、動的なものには常にエッジケースがあります。生成音声でアクセント、スラング、地域特有の発音を保ちたいこともあるでしょう。専門用語に独自の発音がある業界向けに音声を制作している場合もあります。あるいは、ブランド名を特定の一貫した方法で発音させたいだけかもしれません。
発音辞書と音素オーバーライド
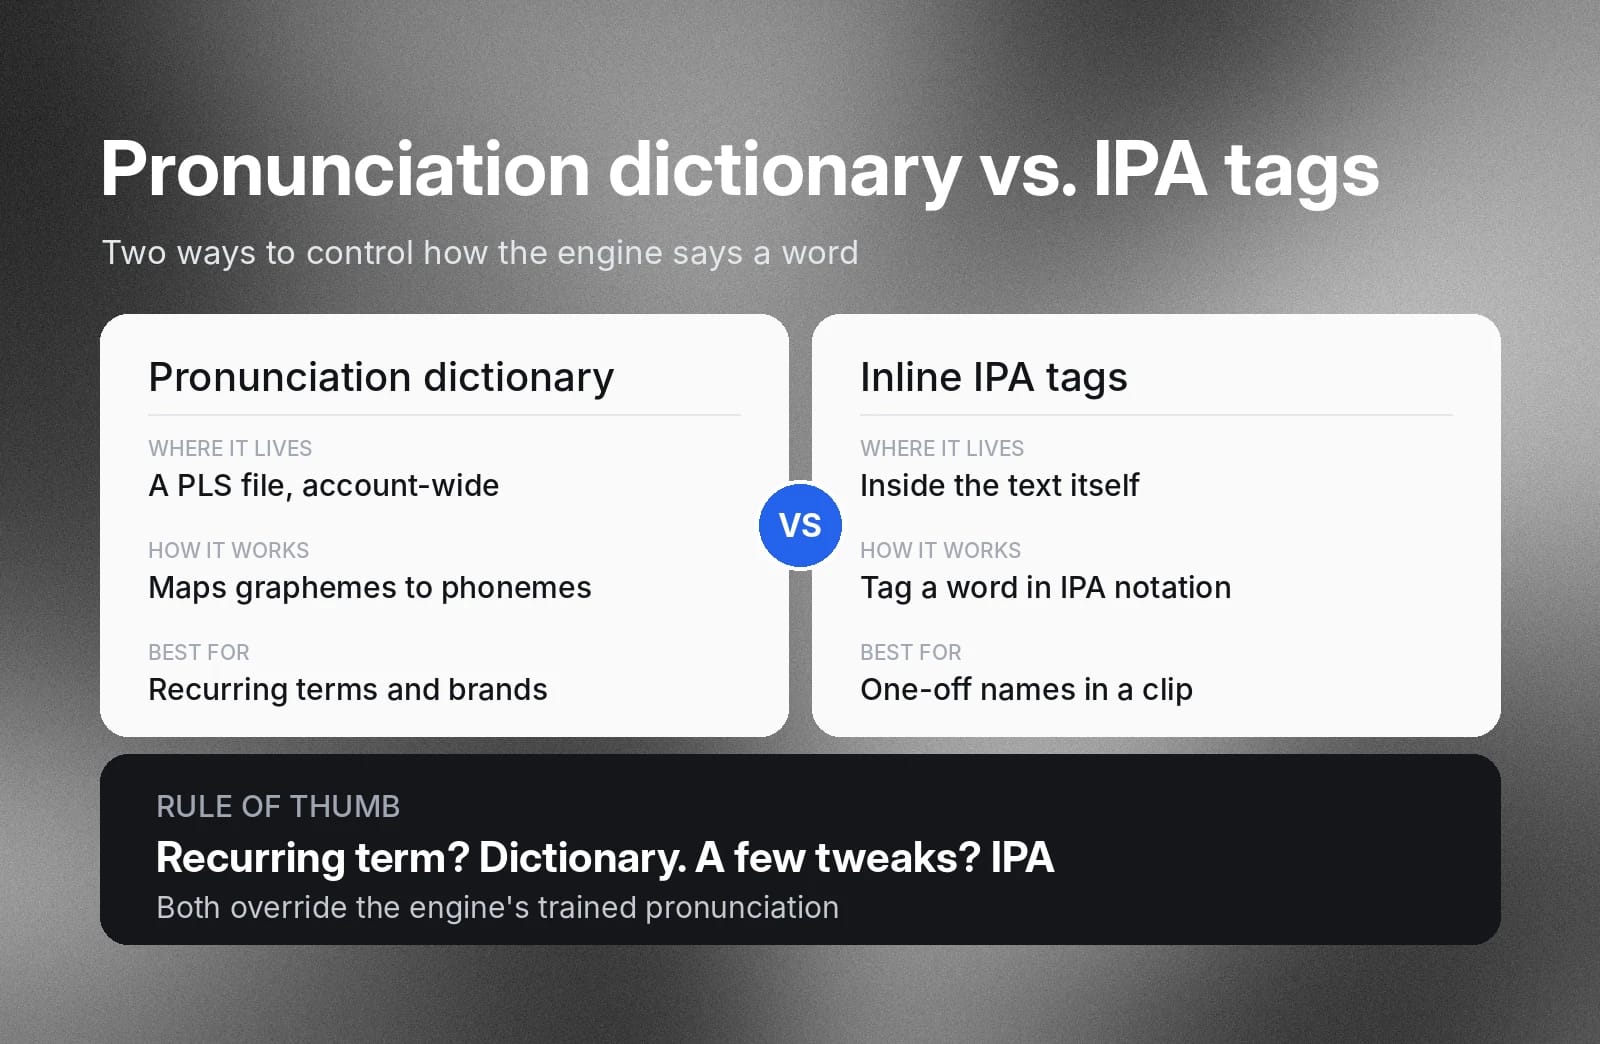
ElevenLabsのElevenAPIには、発音辞書が含まれており、エンジンの発音をカスタマイズできます。W3C標準の発音辞書仕様(PLS)ファイルで、書記素(テキスト内の記号)を音素(発話語を音に分解したもの)へ対応付ける辞書を作成します。TTSエンジンが一覧にある書記素を検出すると、学習済みの発音を上書きし、辞書の音声表記に基づく発音を使います。
ElevenAPIで発音辞書を作成する方法は、発音辞書を使うのドキュメントで確認できます。
ネイティブIPAと音声プロンプティング
一部のTTSモデルは、テキスト入力に直接埋め込まれたインライン発音タグも認識できます。アカウント全体の辞書を作成しなくても、1~2個の音声クリップで発音を調整したいだけなら、テキスト内の単語に標準IPA表記を使ってタグを付けられます。たとえば、オーディオブックを録音中に架空の登場人物の名前を特定の方法で発音させたい場合です。
テキスト読み上げでよくある課題と対処法
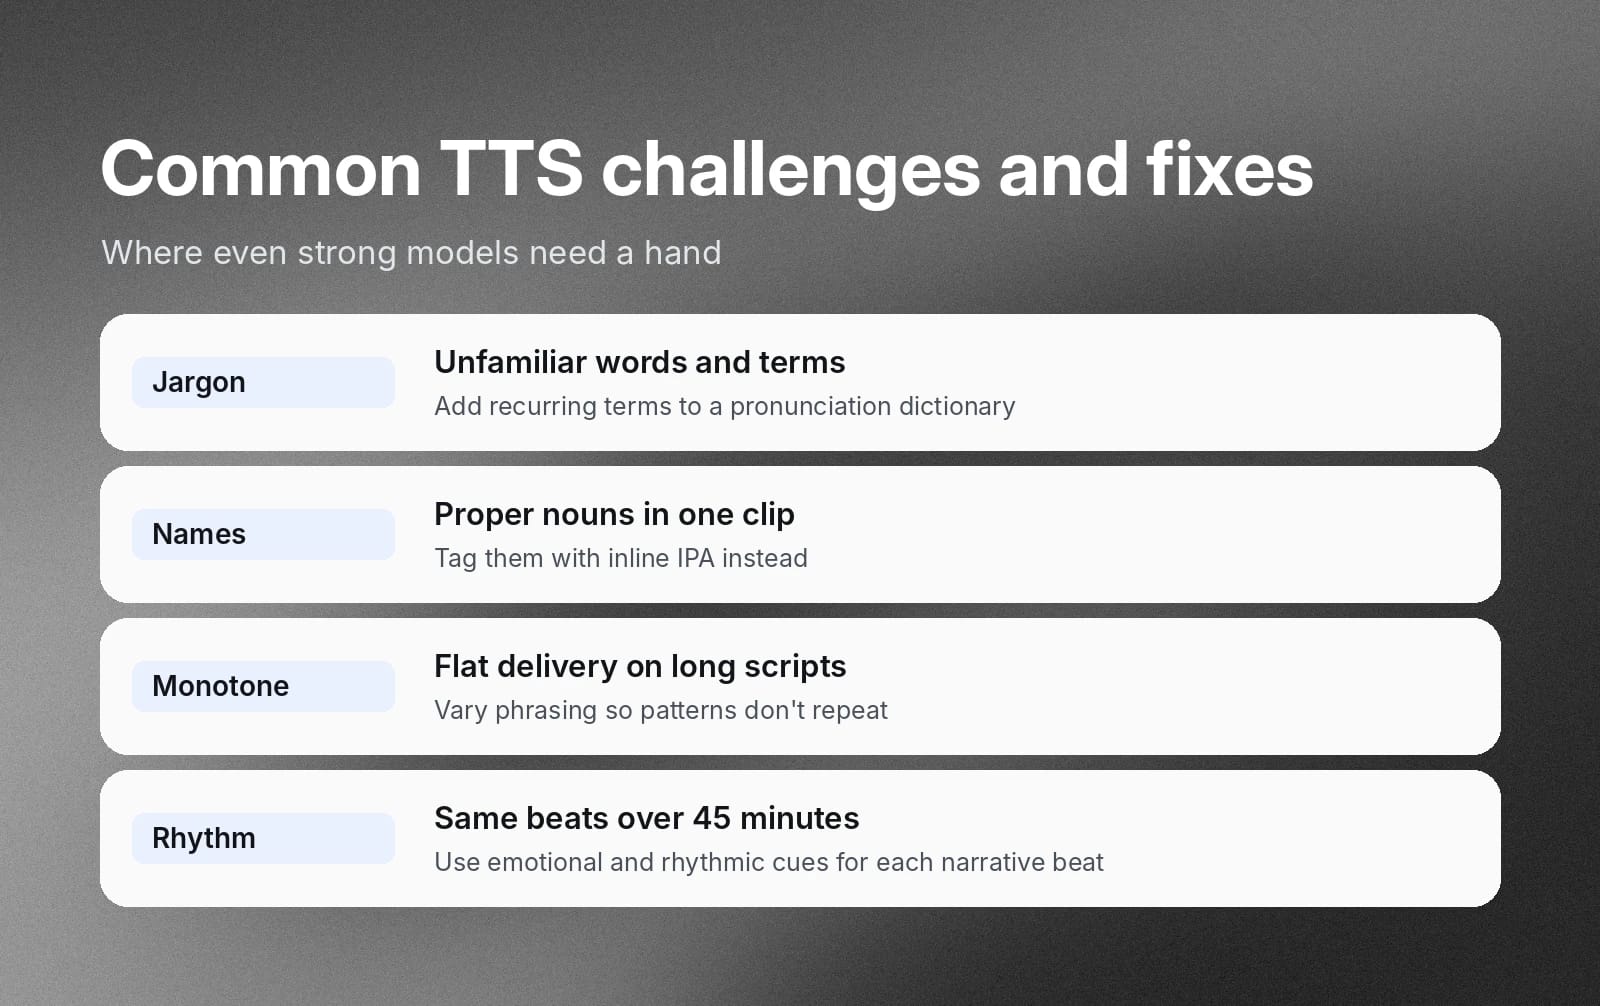
どれほど優れたTTSモデルでも、人間の言語のニュアンスには苦戦することがあります。よくある問題は、新しい単語の誤発音と単調な話し方です。対処法をご紹介します。
未知の単語、専門用語、固有名詞の誤発音
TTSエンジンは、学習データ内で書記素が音素にどう対応するかに基づき、正規化されたテキストの発音を予測するアルゴリズムを使用します。取り込んだテキストと文脈に基づいて最善の推測を行います。ただし前のセクションで説明したように、特定の方法で発音させたいエッジケースは数多くあります。
こうしたエッジケースには、発音辞書または対象を絞ったIPAタグが最適です。一貫して発音させたい頻出用語がある場合は、辞書が最適な解決策です。数語だけを調整したい場合は、音声IPAタグを使いましょう。
単調な話し方
こうした問題は、同じ単語やフレーズが何度も繰り返される長い台本を処理する際に特によく起こります。エンジンの合成音声は10秒の短い音声では優れて聞こえても、45分の講義で同じ機械的な発音やリズムパターンを聞き続けると、リスナーはすぐに疲れてしまいます。
台本の表現に変化を持たせ、音声タグを適切に使って発音を定期的に変えましょう。感情やリズムの手がかりを使い、音声出力をよりダイナミックにして、物語の展開に応じて抑揚をつけます。
テキスト読み上げAPIで自然な音声体験を構築
軽量なウェブツールは小さな音声クリップの制作には便利ですが、より大きなビジネスニーズには拡張しにくいものです。毎分数千件の顧客対応を管理したり、高品質な長尺オーディオコンテンツを生成したりするには、より堅牢なTTSツールが必要です。
ElevenAPIのようなテキスト読み上げAPIを使うと、ソフトウェアをニューラル音声合成モデルに直接接続できます。RESTリクエストまたは永続的なWebSocketを使い、エージェントなどのためにオンデマンドで大規模に音声を生成できます。
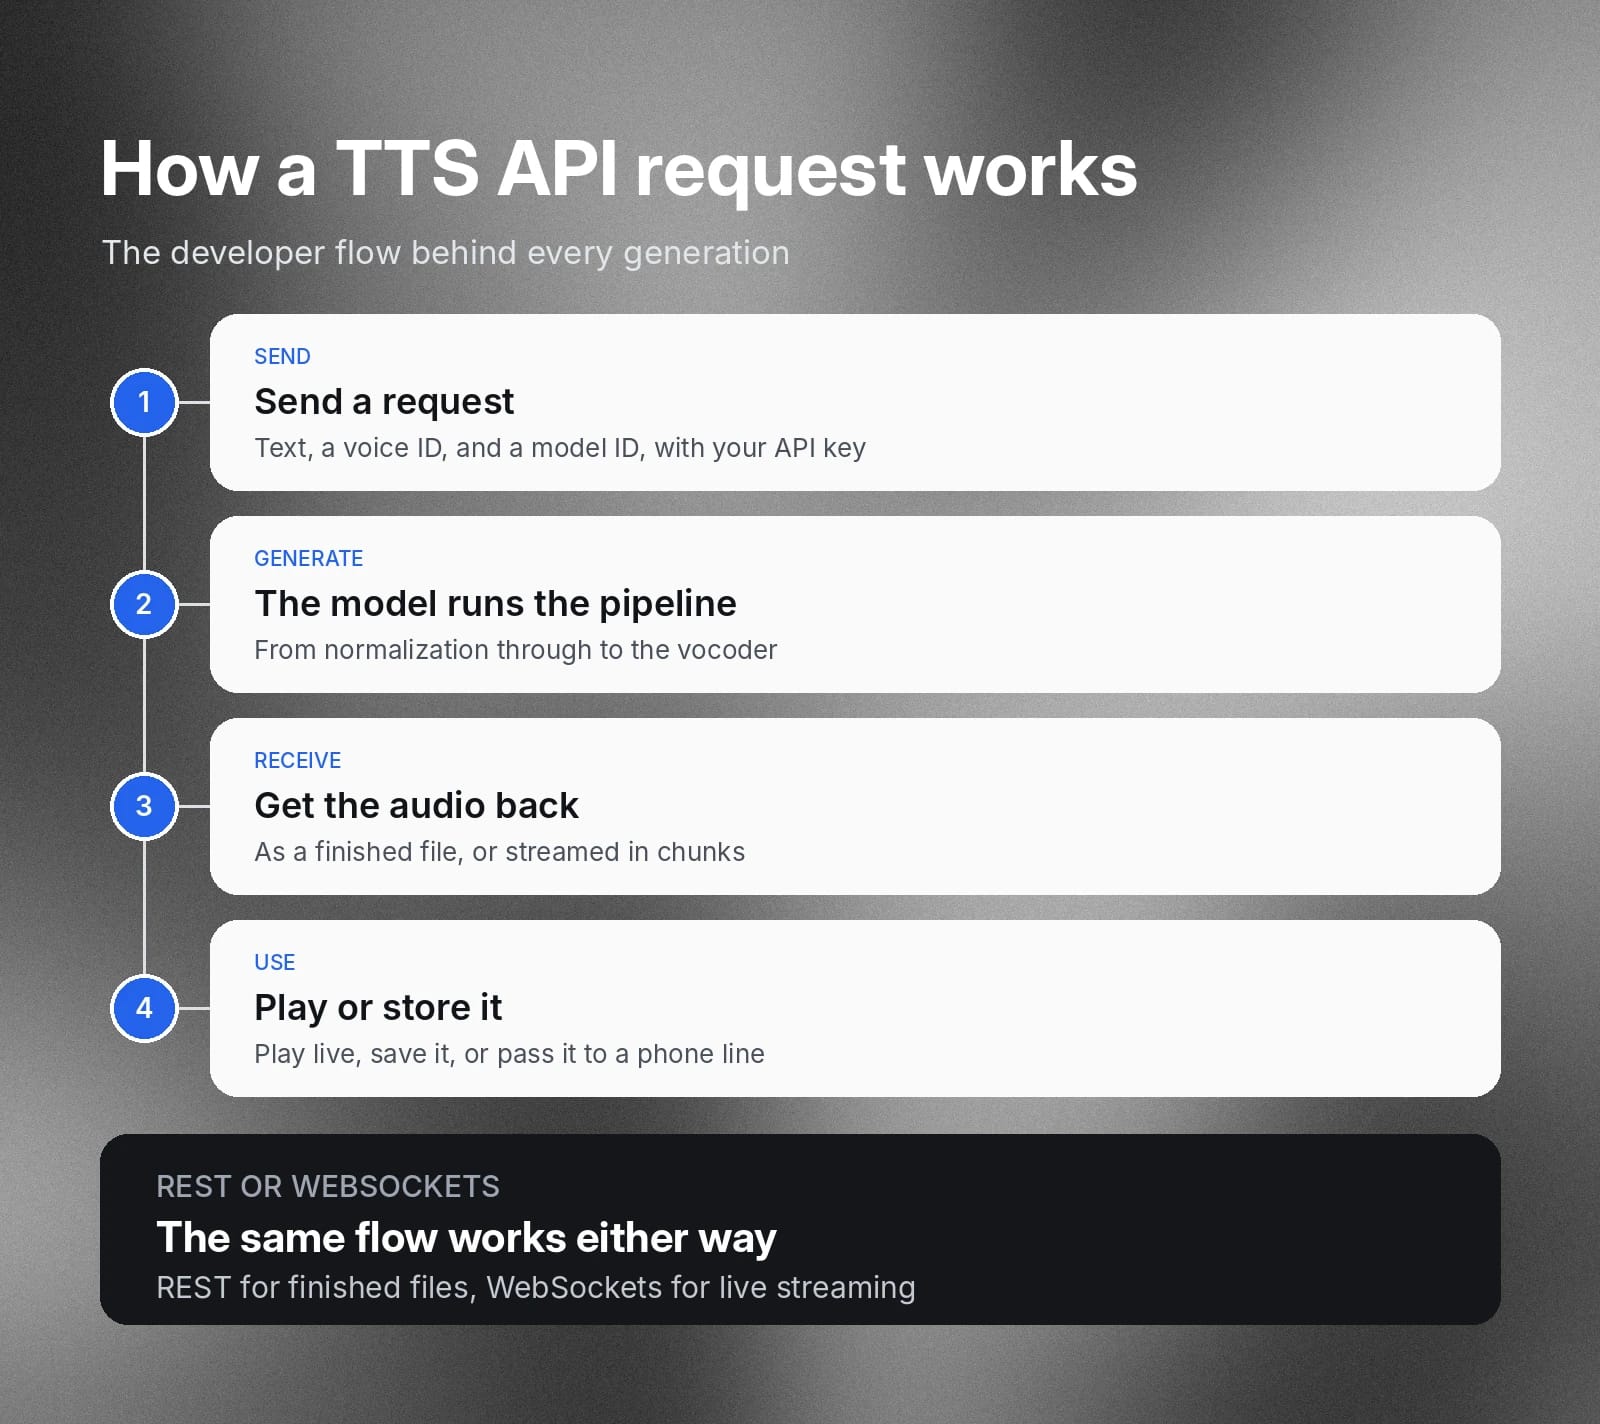
テキスト読み上げAPIリクエストの仕組み
モデルは複雑ですが、デベロッパーフローは理解しやすく、すぐに始められます。
ElevenAPIを使えば、アプリケーションにテキスト読み上げを統合できます。数分で完了します。
- リクエストを送信:アプリケーションがAPIキーとともに、テキスト、音声ID、モデルIDをAPIへ送信します。
- 生成:モデルが、正規化からボコーダーまで、上記のパイプラインを実行します。
- 音声を受信:APIは完成したオーディオファイルを返すか、生成完了前に再生を始められるようチャンク単位でストリーミングします。
- 再生または保存:アプリケーションが音声をライブ再生、保存、または電話回線など別のシステムへ渡します。
完成ファイルにRESTを使う場合も、ライブストリーミングにWebSocketを使う場合も同じフローで、以下のSDKがこれらの呼び出しをラップします。
デベロッパー向けのアーキテクチャ上の考慮事項
ユースケースに応じて、処理速度、オーディオ忠実度、ネットワーク遅延とプロトコル、インテグレーション機能のトレードオフを調整する必要があります。
レイテンシーと忠実度
会話型エージェントを自然に聞こえさせるには、最初の音声まで約100msを目標にします。つまり、ネットワーク全体とTTSエンジンまでのレイテンシーを最小化します。この制約内でエージェントのアーキテクチャから得られるオーディオ出力の品質が重要になります。
一方、ポッドキャストや講義のような長尺オーディオを制作する場合、レイテンシーの重要性は下がります。レイテンシーを最小化するよりも、高忠実度の出力を最大化することを優先しましょう。
ストリーミングプロトコル
API接続に使うプロトコルも、レイテンシーとパフォーマンスに影響します。WebSocketでは真の双方向オーディオストリーミングが可能です。つまり、フィード全体のレンダリングを待つのではなく、テキストを一度にチャンク単位で処理できます。TTSエンジンが後続チャンクを処理している間に、最初のチャンクから再生を開始できます。
SDK
ElevenAPIのようなエンタープライズ向けテキスト読み上げAPIは、完全なソフトウェア開発キット(SDK)をPythonとTypeScript/JavaScript向けに提供し、REST APIも用意しています。これにより、新しいアーキテクチャを迅速に立ち上げられます。開発チームのインテグレーション負荷を減らすために活用してください。
テキスト読み上げ向けElevenAPIを始める
主要な音声モデルによる自然なTTS合成は、エージェントやオーディオ制作に必要な高品質な音声出力を実現し、リスナーを引きつけ続けます。顧客ワークフローを支える高品質な会話型エージェントを探している場合でも、アプリケーションにTTSを組み込みたい場合でも、ElevenLabsには解決策があります。
今すぐElevenAPIで独自の高忠実度オーディオを生成して始めるか、ElevenAgents.
よくある質問

Jack LimebearはGrowthチームに所属し、ブログやインサイトページのコンテンツライター兼ストラテジストとして活躍しています。ElevenLabsに入社する前は、急成長中のSaaSスタートアップからFortune 500企業まで、さまざまな組織で10年以上にわたりコンテンツ戦略をリードしてきました。ケンブリッジ大学で英文学の修士号を取得しています。