アプリケーションにテキスト読み上げを統合する方法
- 公開日
テキスト読み上げをアプリケーションに統合するには、APIキーを作成し、ElevenLabs SDKをインストールして、音声とモデルを指定したテキストをTTSエンドポイントに送信し、返されたオーディオを再生します。
このガイドでは、PythonとTypeScriptで各手順を説明し、最適なTTS統合方法の選び方や、よくあるエラーの解決方法をご紹介します。
テキスト読み上げAPIとは?
テキスト読み上げAPIを使うと、デベロッパーは独自のTTSモデルをホストすることなく、プログラムから書かれたテキストを自然な音声に変換できます。アプリケーションにTTS APIを統合すれば、APIにリクエストを送信してオーディオを受け取るだけで、手軽に音声レイヤーを追加できます。
ElevenAPIのような優れたテキスト読み上げAPIなら、テキストを話す音声の選択から、表現する感情まで、最終的なオーディオの響きを細かく制御できます。アプリケーションのユースケースに応じて、バッチ処理とストリーミング処理のオプションを選び、オーディオサンプルを作成することもできます。
テキスト読み上げAPIリクエストの仕組み
TTS APIを呼び出すと、オーディオを届けるまでにいくつかの処理がバックグラウンドで行われます。
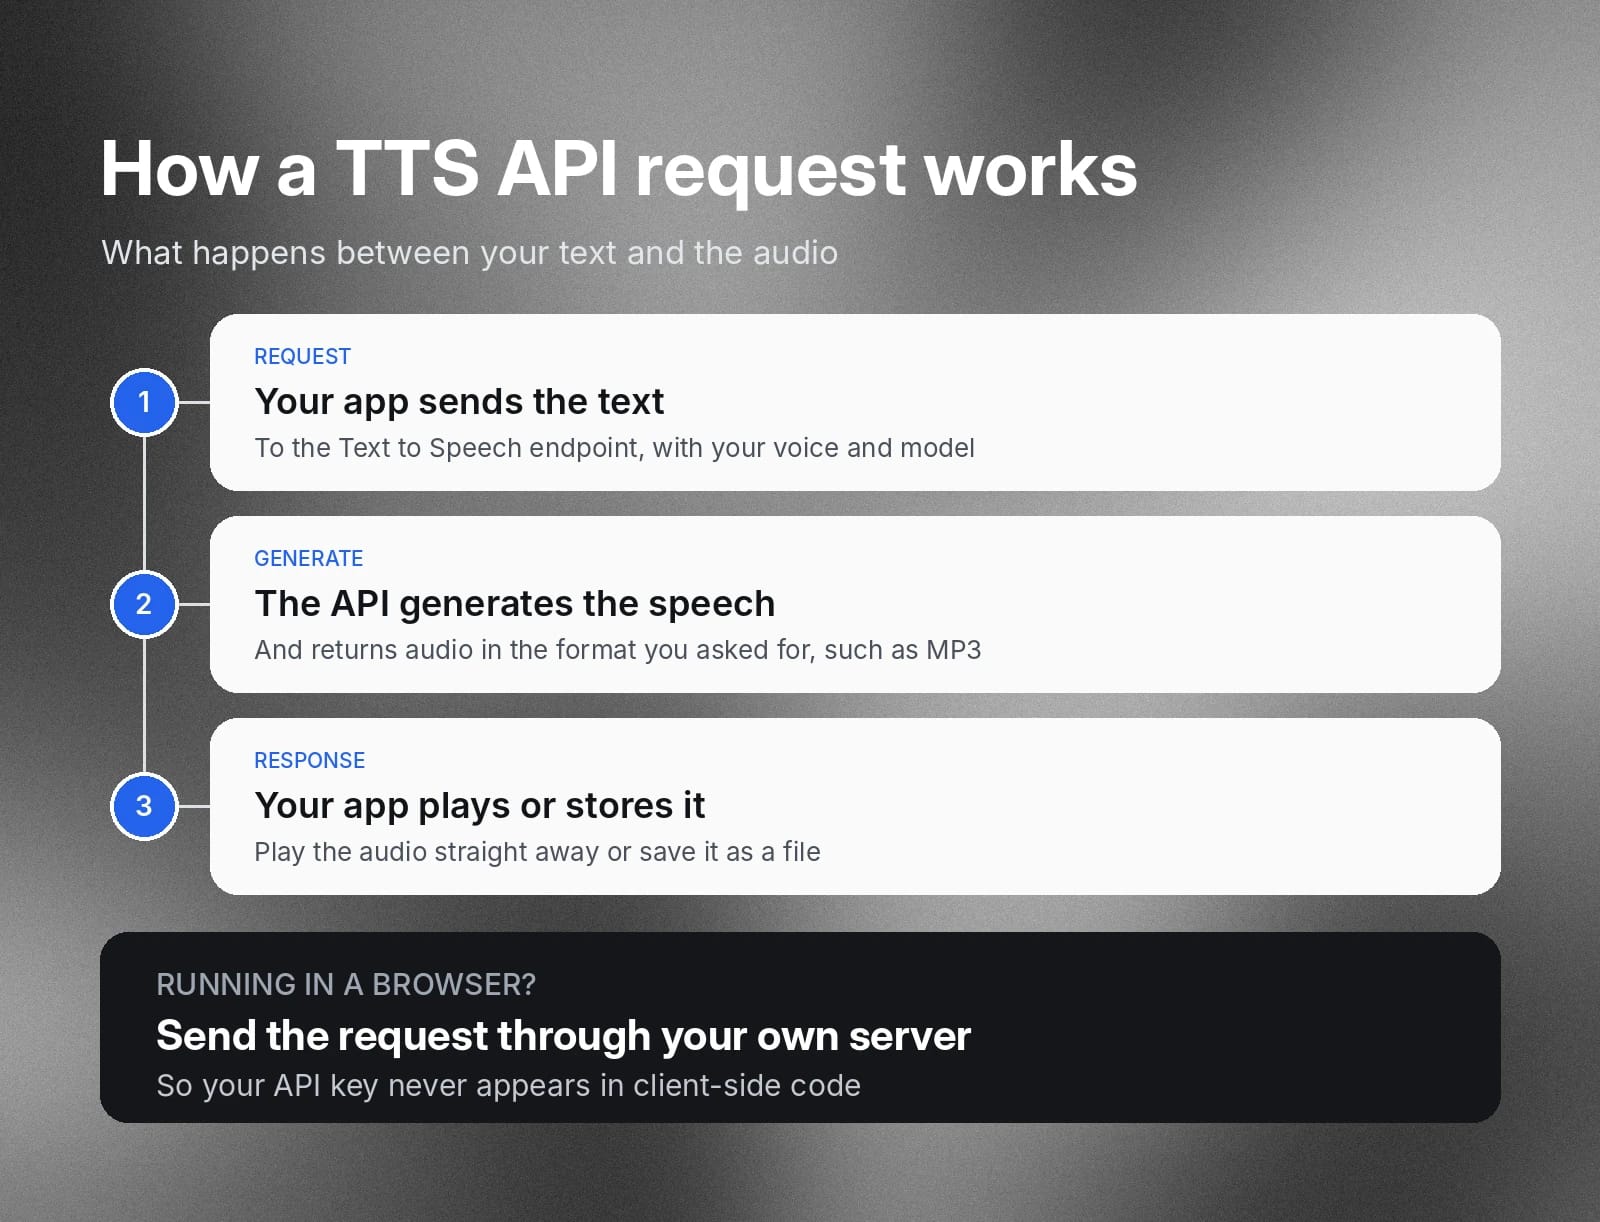
テキスト読み上げAPIリクエストの流れは次のとおりです:
- アプリケーションが、選択した音声とモデルとともにテキストをテキスト読み上げエンドポイントへ送信します。
- APIが音声を生成し、MP3など指定した出力形式でオーディオを返します。
- アプリケーションがオーディオを再生するか、ファイルとして保存します。
なお、アプリケーションがブラウザで動作する場合は、APIキーがクライアント側のコードに表示されないよう、自身のサーバーを経由してリクエストを送信してください。
アプリケーションへのTTS統合を始める前に必要なもののチェックリスト
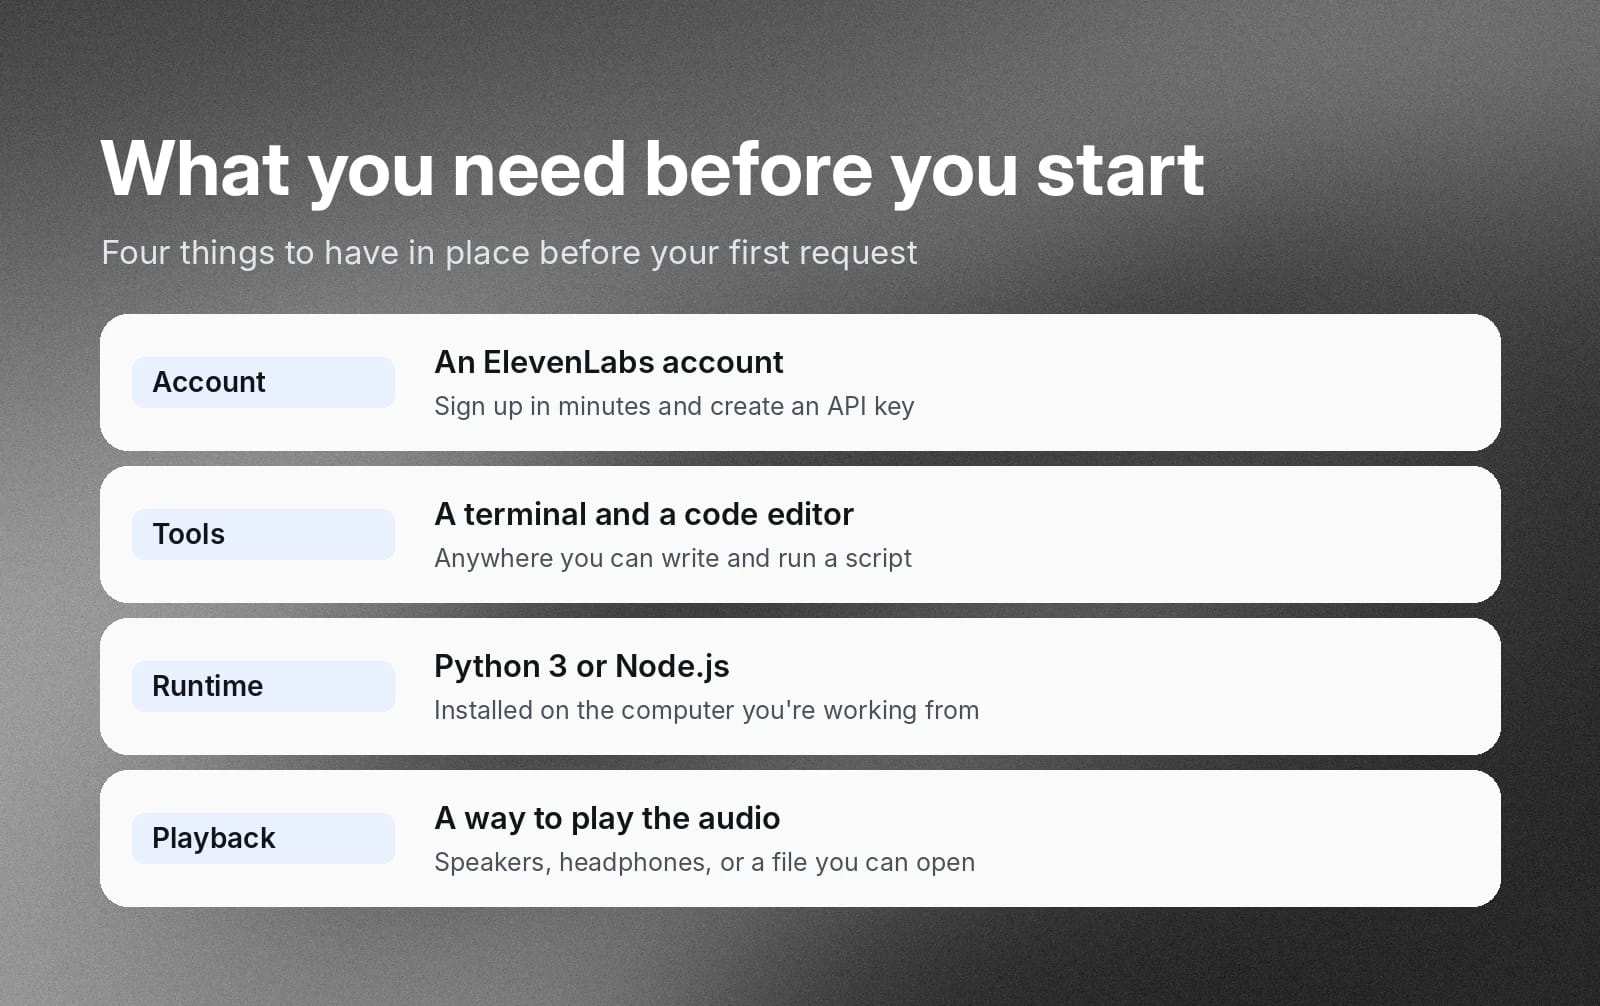
アプリケーションにテキスト読み上げを統合する前に、まず次のものが揃っていることを確認してください:
- ElevenLabsアカウント。数分で登録できます。
- ターミナルとコードエディター。
- 作業するコンピューターにインストールされたPython 3またはNode.js。
- 受け取ったオーディオを再生する手段。
これらがすべて揃えば、アプリにTTSを組み込む準備は完了です。
アプリケーションにテキスト読み上げを統合する方法
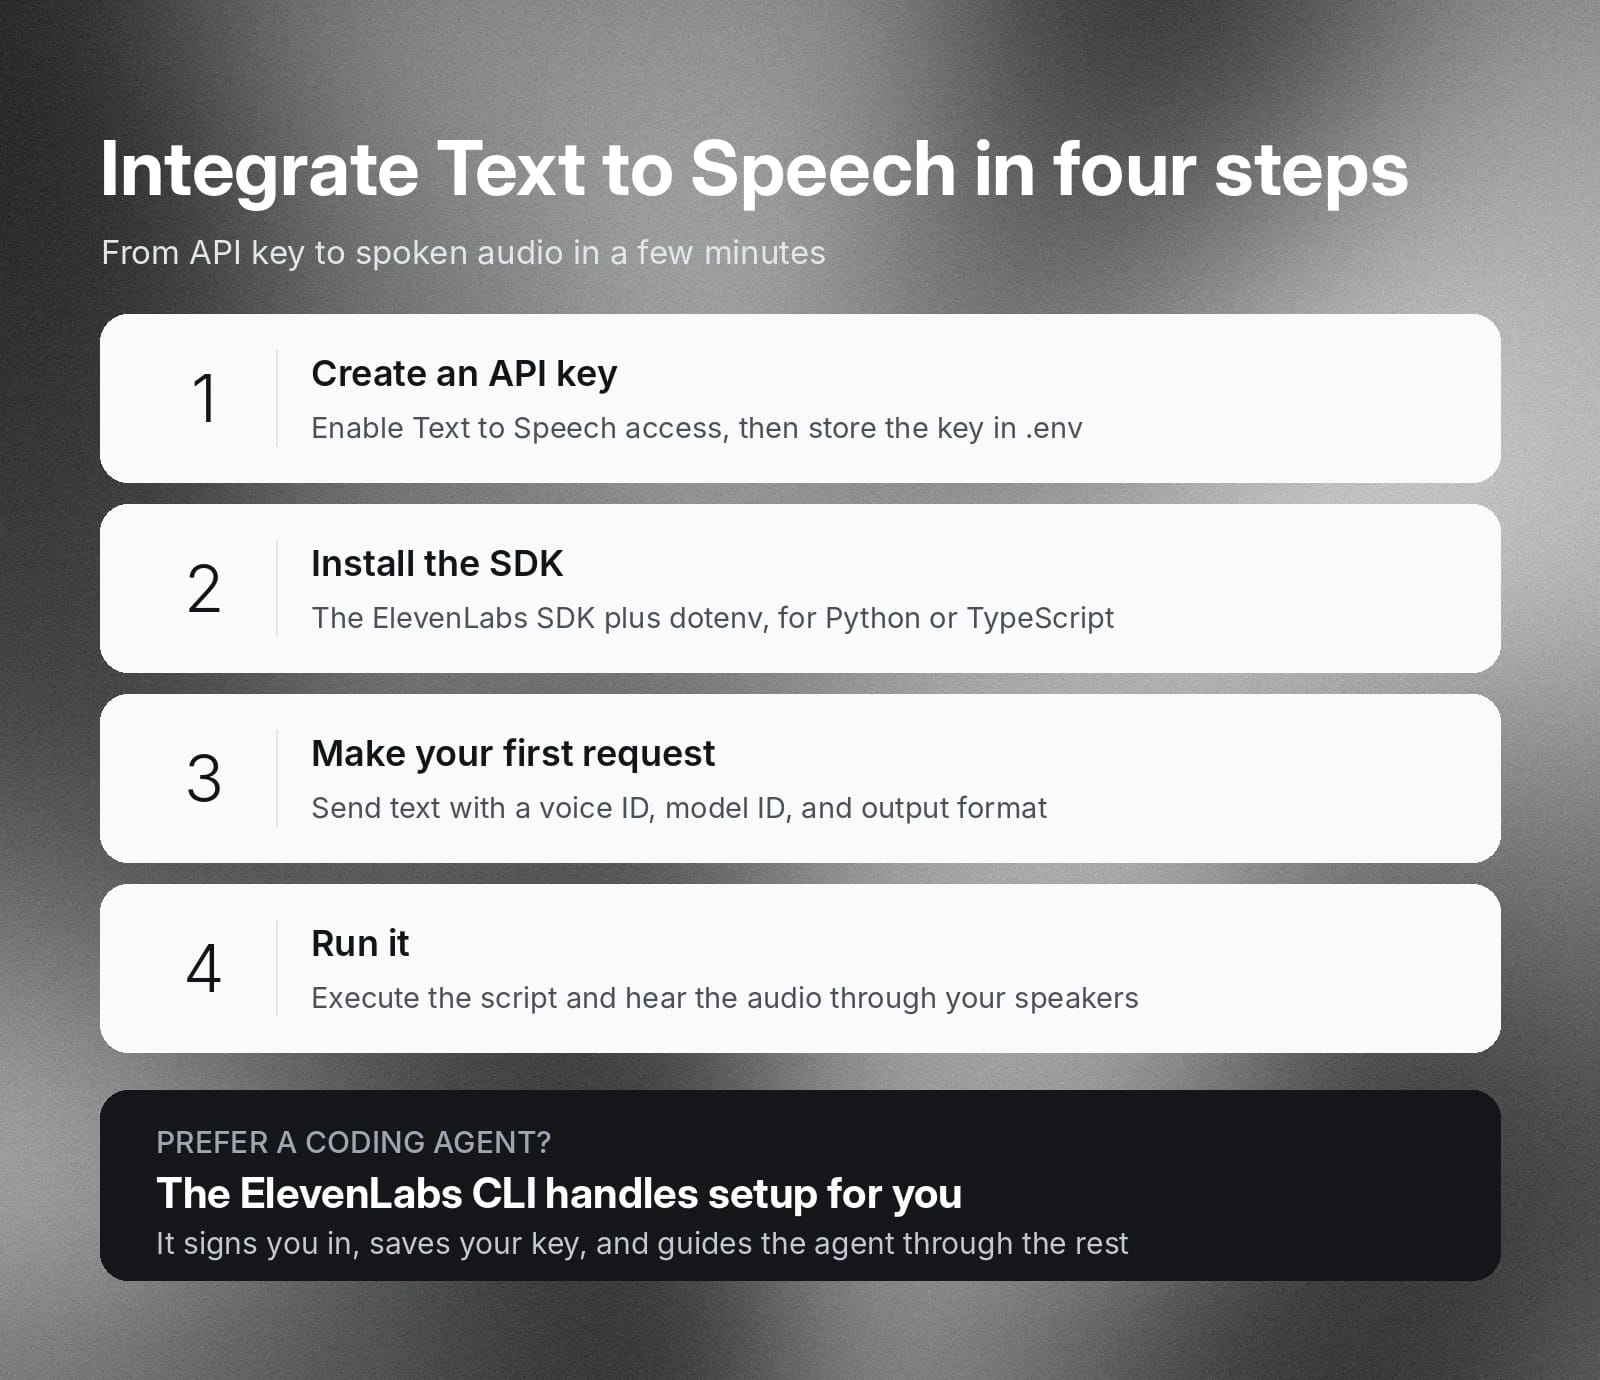
ElevenAPIなら、アプリケーションへのTTS API統合は数分で完了します。すでにアカウントを作成している場合は、以下の手順に進んでください。まだの場合は、まず登録してください。
手順は以下のとおりです:
- APIキーを作成する
- SDKをインストールする
- 最初のリクエストを送信する
- 実行する
それぞれ詳しく見ていきましょう。
APIキーを作成する
ElevenLabs APIダッシュボードからAPIキーを取得します。「Create Key」をクリックすると、設定するAPIの種類を構成できます。このユースケースでは、TTSの「Access」が有効になっていることを確認してください。
APIキーをコピーし、.envの環境変数として貼り付けます(アーキテクチャに応じて、アプリの設定に直接追加することもできます)。.envファイルに保存すると、スクリプトが実行時にキーを読み込みながら、キーを安全に保てます。
コーディングエージェントにセットアップを任せたいですか?エージェントに次を貼り付けてください:npx -y @elevenlabs/cli@latest onboard init。ElevenLabs CLIはブラウザを開いてサインインを促し、キーをプロジェクトのenvファイルに保存して、残りの手順をエージェントに案内します。npxにはNode.jsが必要です。詳しくはクイックスタートをご覧ください。
SDKをインストールする
テキスト読み上げAPIをセットアップする際にインストールする主なパッケージは2つです。1つ目はAPI呼び出しを処理するElevenLabs SDKです。2つ目はdotenvで、手順1で設定した.envファイルからAPIキーを読み込みます。
CLIを使用している場合は、TTS APIドキュメントをご覧ください。より具体的な手順や利用可能なオプションを確認できます。
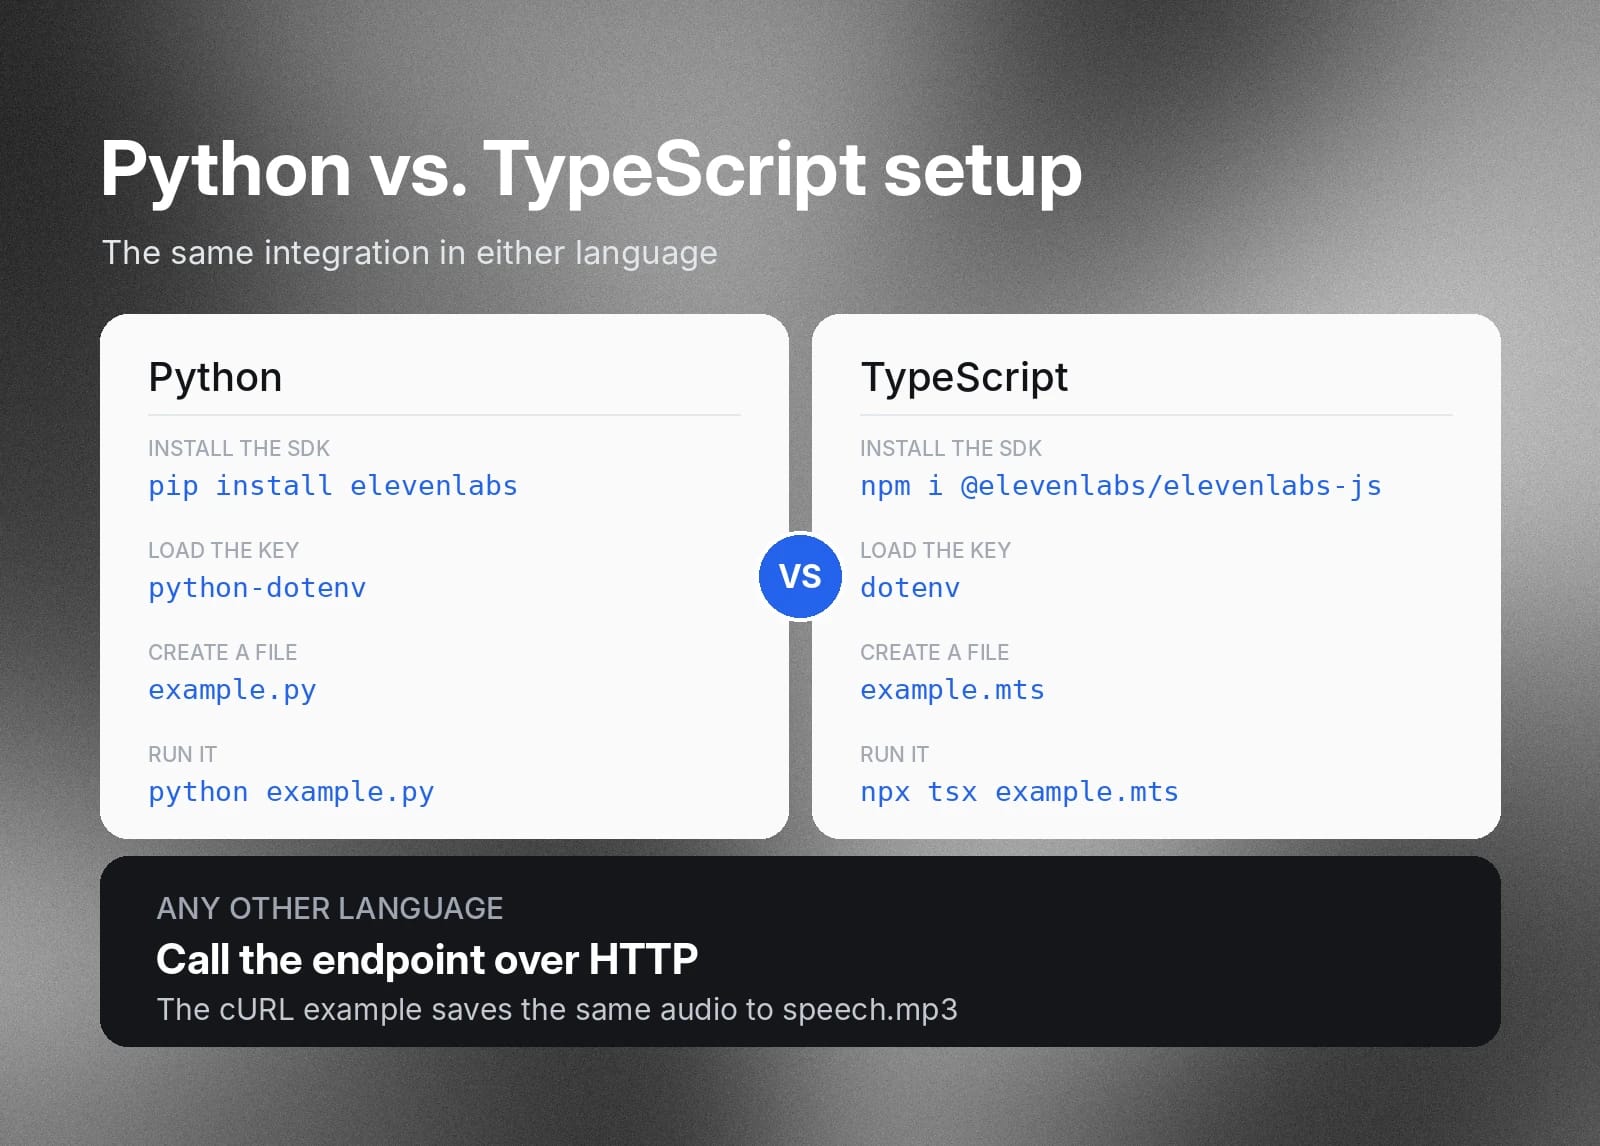
TTS API用のSDKとdotenvをPythonおよびTypeScriptでインストールする方法は次のとおりです。
Python
TypeScript
最初のリクエストを送信する
次に、クライアントを作成します。クライアントはElevenAPIをラップするオブジェクトです。使用するプログラミング言語に応じて、.pyまたは.mtsファイルを作成してください。
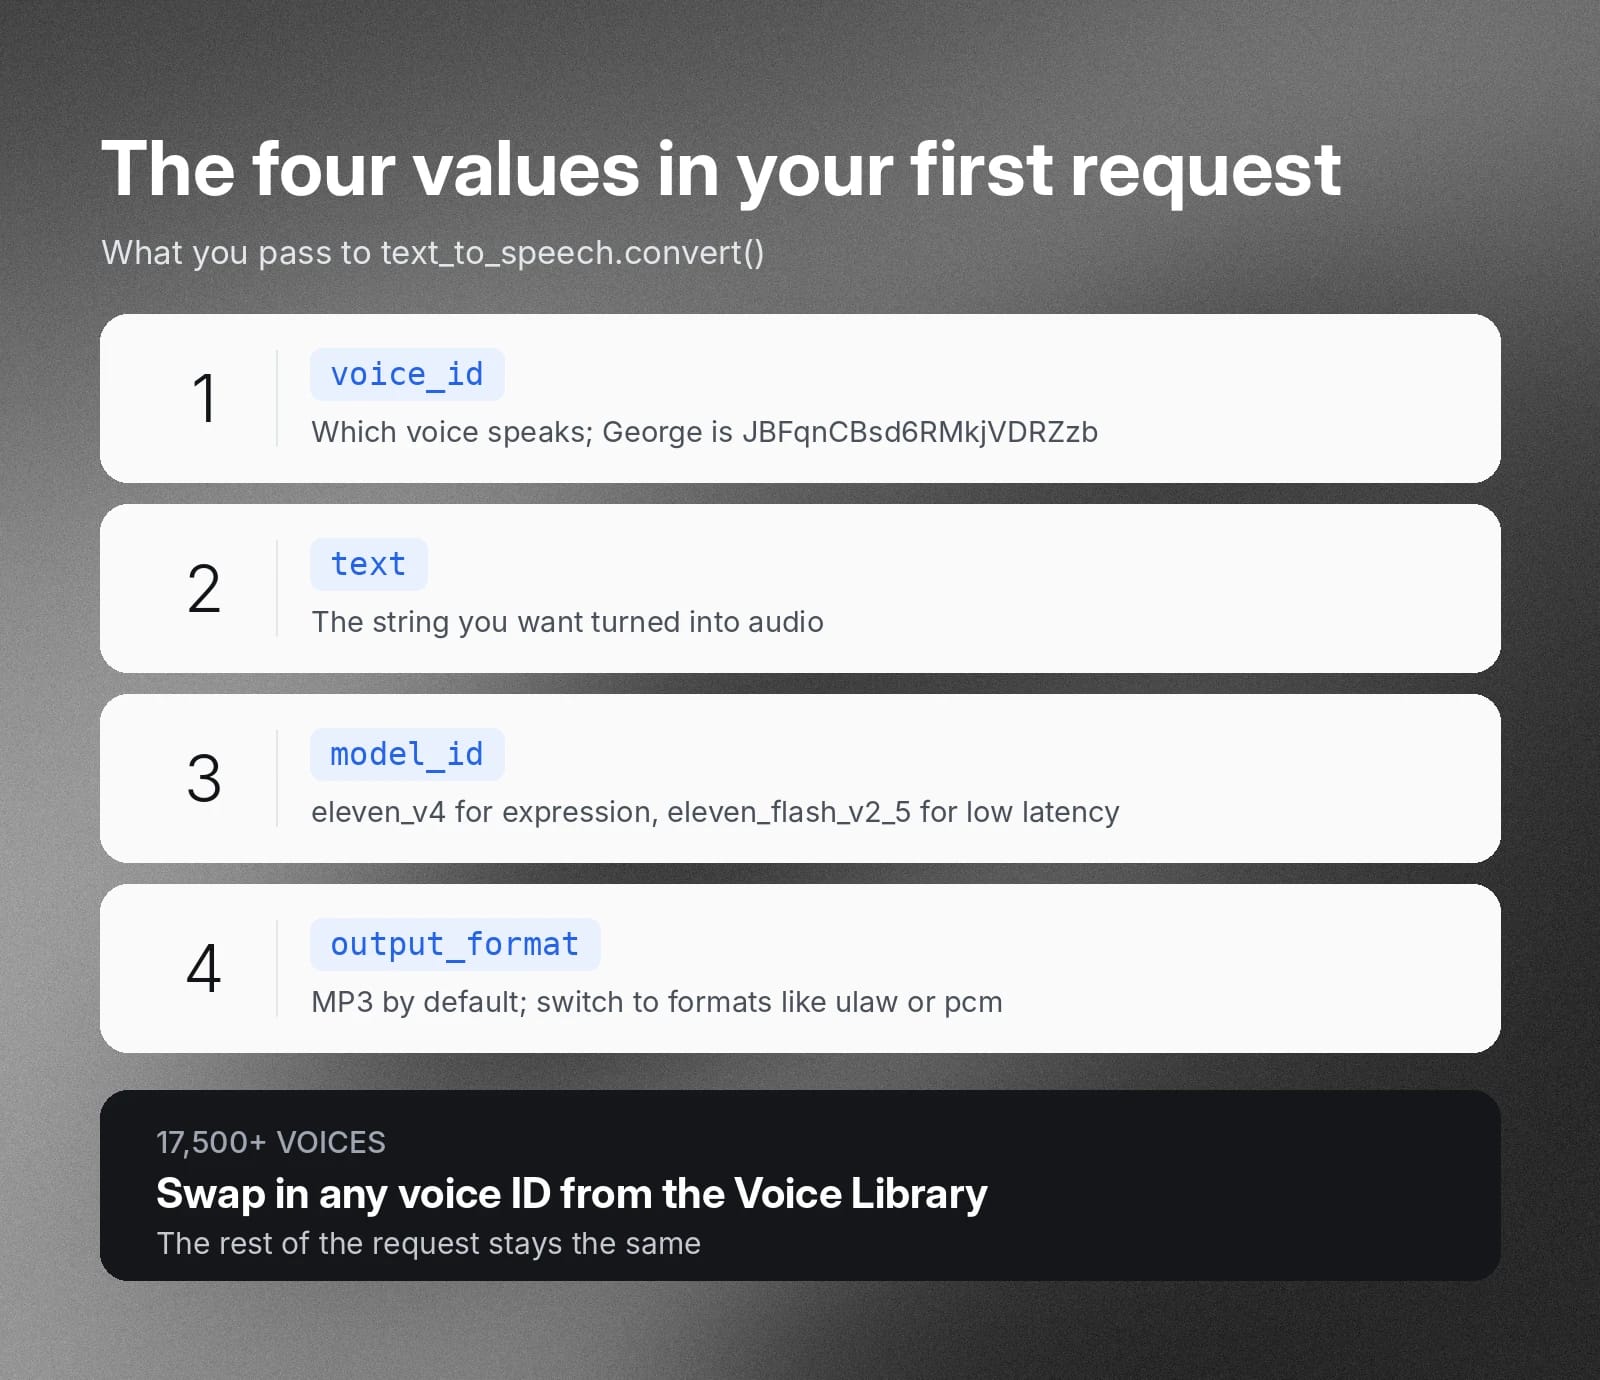
出力に影響する主な値は4つあります:
- 音声ID:ElevenLabsには、ボイスライブラリで選べる17,500以上の音声があります。アプリケーションを最もよく表す音声を選ぶか、ユースケースに合った音声を選択してください。以下のクイックスタートのコードブロックでは、音声ID「JBFqnCBsd6RMkjVDRZzb」の「George」を使用しています。
- テキスト:ElevenAPIのTTSモデルでオーディオファイルに変換するテキスト文字列です。
- モデルID:オーディオ生成に使用する特定のモデルです。以下の例ではeleven_v4を使用していますが、ユースケースにより適したテキスト読み上げモデルを選択することもできます。たとえば、低レイテンシーを重視する場合はEleven Flash v2.5(モデルID欄ではeleven_flash_v2_5)を選択できます。
- 出力形式:TTS APIから受け取るオーディオエンコーディングを指定します。デフォルトではmp3が返されますが、ulawやpcmなどの形式に変更できます。
PythonとTypeScriptでのTTS APIファイルは次のようになります。以下の例はいずれもeleven_v4モデルを使用しています。
Python
TypeScript
cURL
HTTPリクエストを送信できる任意の言語からエンドポイントを呼び出すこともできます。このcURLの例では、同じテキストを送信し、オーディオをファイルに保存します:
実行する
これでTTS APIファイルを実行する準備ができました。PythonまたはTypeScriptのどちらを使用しているかに応じて、次のコマンドのいずれかを実行してください。
Python
TypeScript
スピーカーからオーディオが再生されるはずです。cURLの例では、代わりにspeech.mp3を開いてください。
よくあるTTS統合エラーのトラブルシューティング
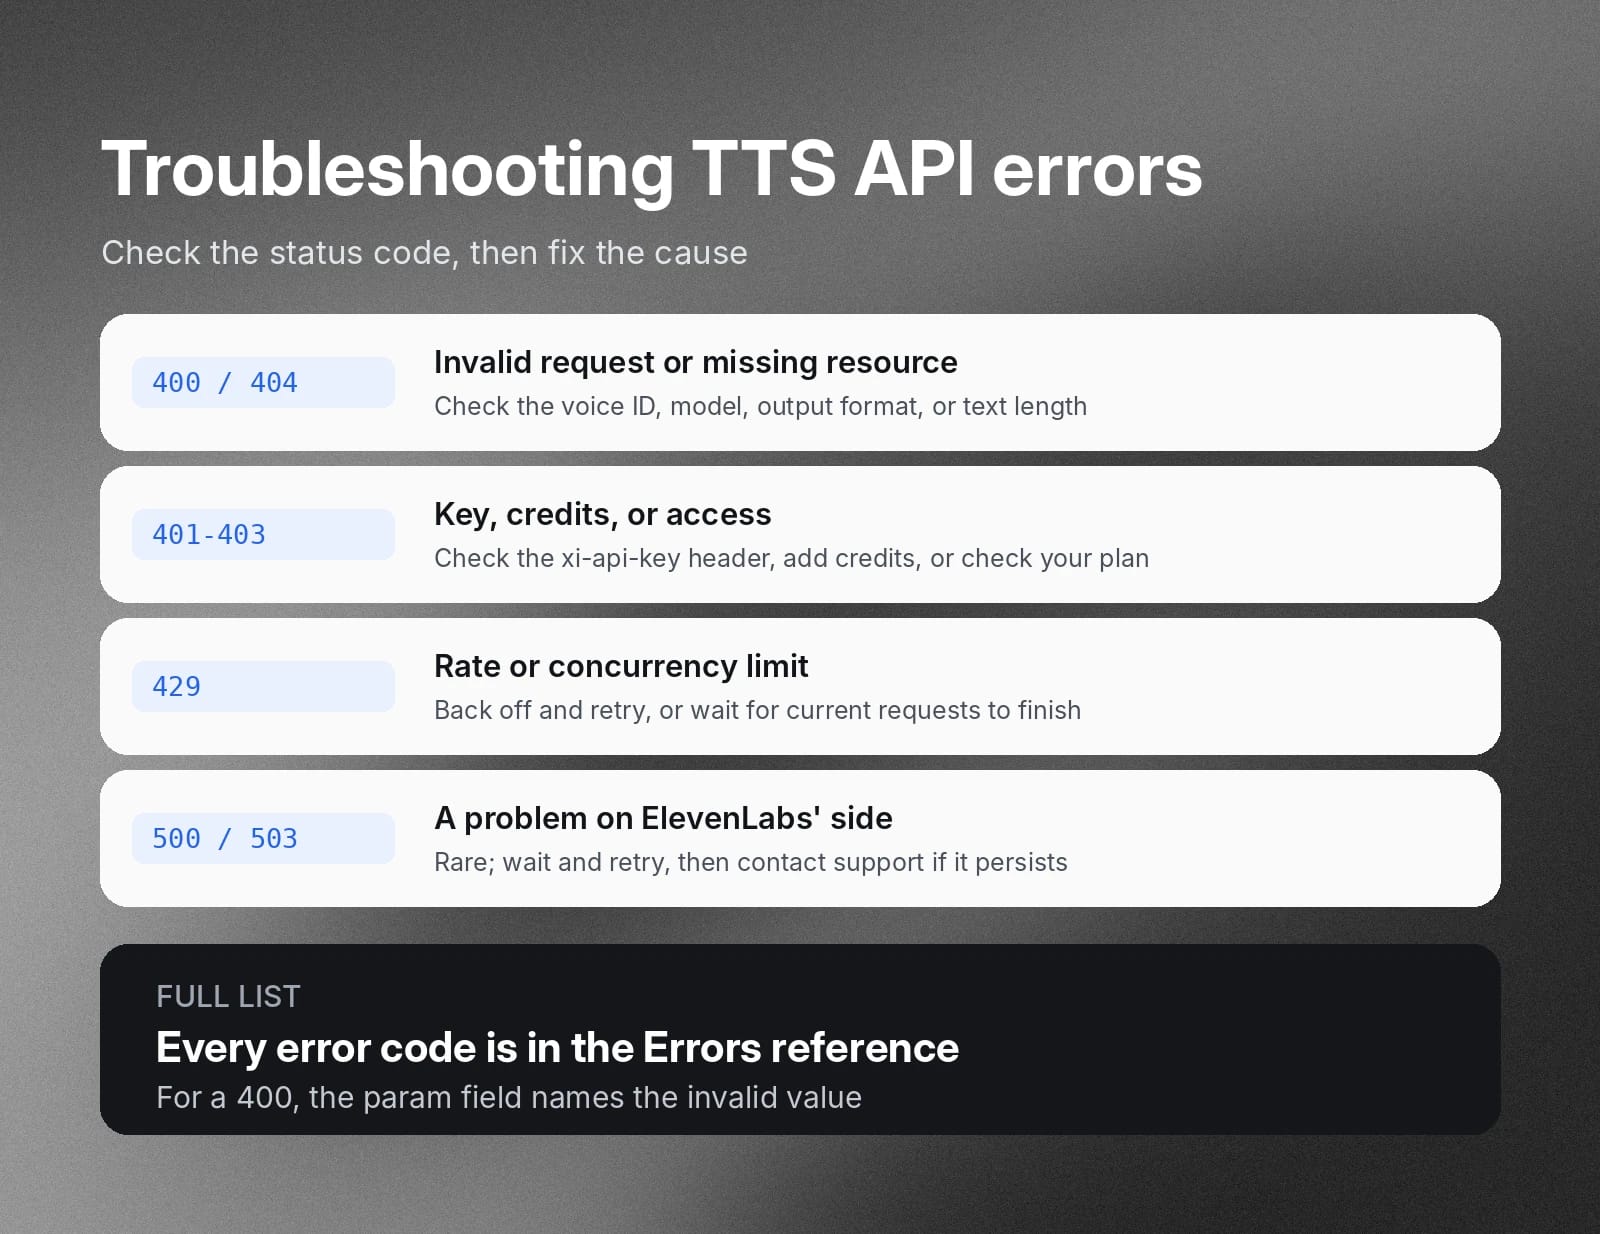
最初のリクエストが失敗した場合は、受け取ったステータスコードを以下のエラー一覧と照らし合わせて確認してください。
ステータス
意味
対処方法
400または404
validation_error、invalid_request、またはnot_found:リクエストが無効、または音声などのリソースが存在しません
再試行する前にリクエストを修正してください。エラー内のparamフィールドは無効な値を示します。一般的な原因として、無効な音声ID(invalid_voice_id、または存在しないIDに対するvoice_not_found)、未対応のモデルまたは出力形式、テキストが長すぎること(text_too_long)が挙げられます。
401、402、または403
authentication_error、payment_required、またはauthorization_error:APIキー、クレジット、またはアクセスに問題があります
401の場合は、APIキーとxi-api-keyヘッダーを確認してください。402の場合は、クレジットを追加します(insufficient_credits)。403の場合は、プランにその機能またはモデルが含まれていることを確認してください(feature_not_availableまたはmodel_access_denied)。
429
rate_limit_error:レート制限(rate_limit_exceeded)または同時実行数の上限(concurrent_limit_exceeded)を超えています
レート制限の場合は、指数バックオフで再試行してください。同時実行数の上限の場合は、現在のリクエストが完了してから新しいリクエストを送信するか、より高い同時実行数上限のプランに変更してください。
500または503
internal_errorまたはservice_unavailable:まれではありますが、ElevenLabs側の問題です
少し待ってから再試行してください。500が継続する場合はサポートにお問い合わせください。
エラーの完全な一覧については、エラーリファレンスページで詳細をご確認ください。
テキスト読み上げAPIを統合するメリット
アプリケーションに音声インターフェースを追加すると、ユーザーに新たな操作手段を提供できます。視覚障害のある方などにとっては、それがアプリケーションを利用する唯一の実用的な方法になる場合もあります。
アプリケーションにTTS APIを統合するメリットは次のとおりです:
- アクセシビリティ:音声により、アプリケーションと新たにインタラクションする方法が生まれ、画面上のテキストを簡単に読めない人も利用できるようになります。
- エンゲージメント:読み上げ・聞きながら利用する機能により、他の作業をしながらコンテンツを楽しめます。これは人々がコンテンツを閲覧する主な方法としてますます広がっています。
- 音声ファーストの体験:音声で応答することで、チャットボットやアプリ内ガイドはユーザーに自然に話しかけられます。
- 多言語対応:Eleven v4は90以上の言語に対応しており、世界中のユーザーに統合機能を提供できます。
セットアップの手軽さを考えると、アプリケーションへのTTS API統合は、よりインタラクティブで表現力豊かなアプリケーションを実現する強力な方法です。
適切な統合方法とモデルの選び方
ElevenAPIはアプリケーションに音声を追加する最速かつ簡単な方法の1つですが、ニーズに応じて選べる他の方法もあります。
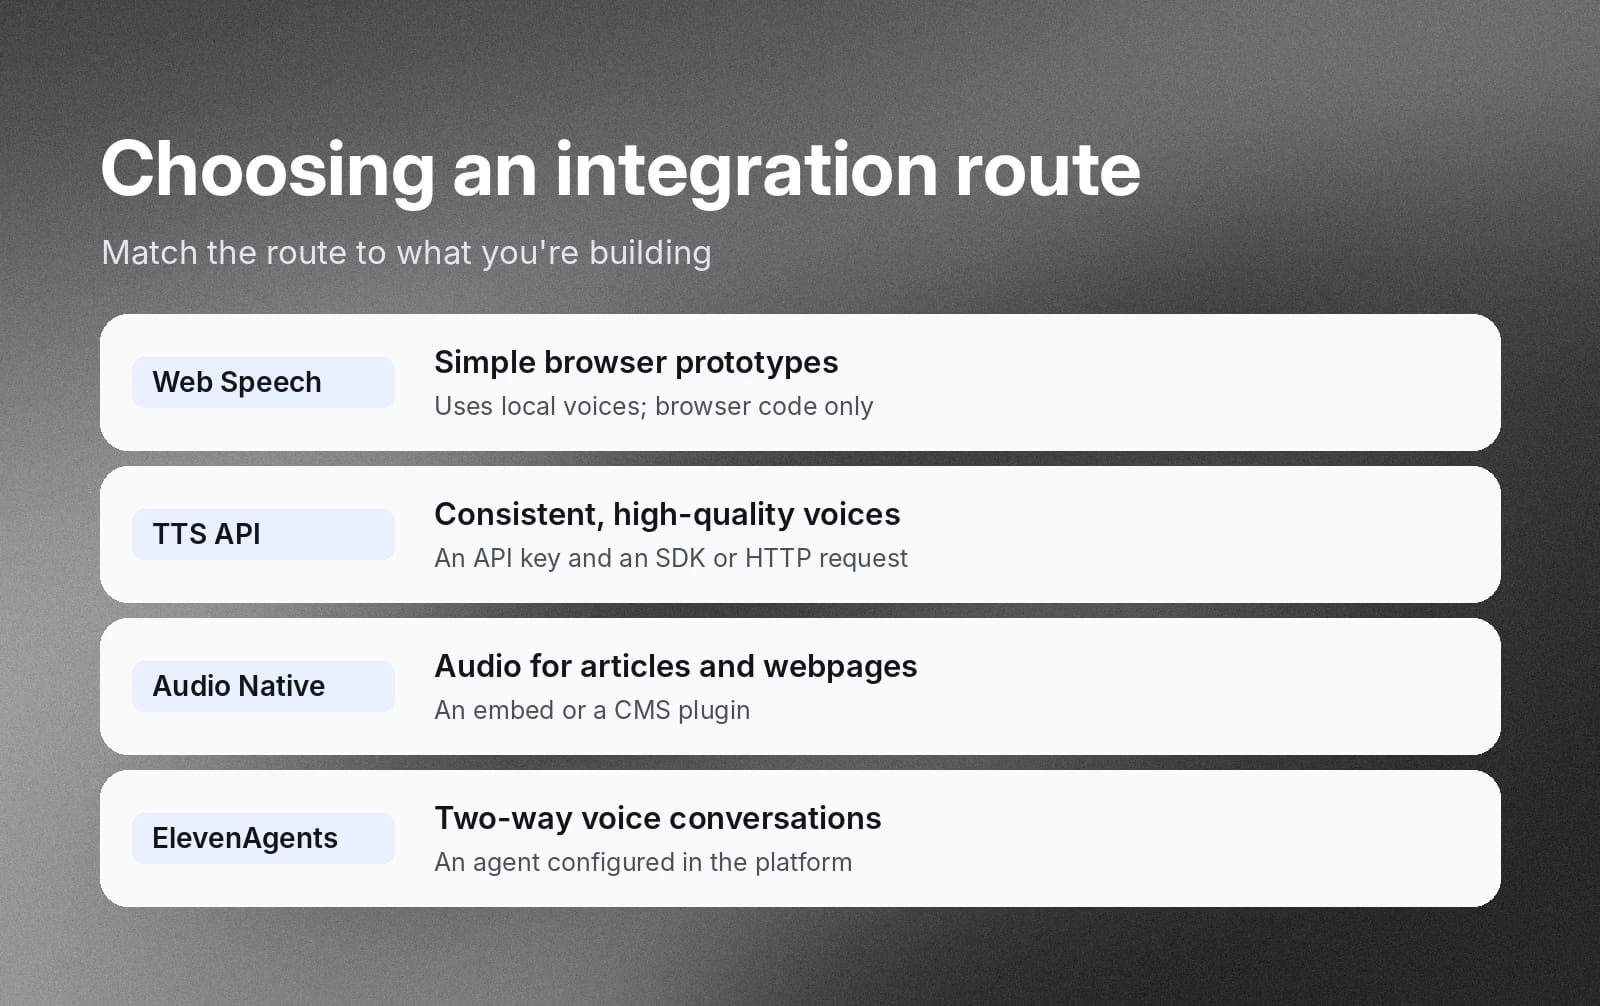
選択できる主なTTS統合方法は次のとおりです:
方法
最適な用途
必要なもの
ブラウザの音声合成(Web Speech API)
ローカルの音声を使うシンプルなブラウザプロトタイプ
ブラウザコードのみ
ElevenAPIを選ぶ場合は、リクエストに含めるモデルも選択する必要があります。利用可能なElevenLabs TTSモデルの簡単なガイドは次のとおりです:
モデル
最適な用途
対応言語
eleven_v4
最も表現力豊かな音声
90以上
eleven_flash_v2_5
リアルタイム用途、エージェント、大量処理
32
eleven_multilingual_v2
安定した高忠実度のナレーション
29
また、ボイスライブラリから17,500以上の音声を選択できます。コードスニペット内のサンプルIDを、希望するIDに置き換えるだけです。
アプリケーションにおけるテキスト読み上げAPIの一般的なユースケース
最初のリクエストが動作すれば、同じ呼び出しで数多くの機能を実現できます。
アプリケーションでTTS APIを使用する例をいくつかご紹介します:
- アプリ内読み上げ:テキストをチャンクに分けて送信し、順番にオーディオを再生します。詳しくは、APIバッチ処理統合ガイドをご覧ください。
- 音声チャットボット応答:チャットボットの各応答をAPIに渡し、オーディオをストリーミングでユーザーに返すことで、よりインタラクティブな体験を提供できます。
- 電話システム:電話用途にはulaw_8000出力形式をリクエストしてください。詳しくは、Twilio TTS統合ガイドをご覧ください。
音声エージェントを構築して双方向の会話を実現したい場合、ElevenAgentsはそのために設計されています。音声パイプライン全体を自分で組み立てる代わりに、プラットフォーム上でエージェントを設定してエージェントをデプロイできます。詳しくは、ElevenAgentsをご覧ください。
ElevenAPIでアプリケーションにTTS APIを組み込む
テキスト読み上げの統合は、APIキーの作成、SDKのインストール、最初のリクエストの送信、実行という4つの主な手順で完了します。同じ呼び出しは、TypeScript、Python、またはHTTPリクエストを送信できる他の言語で使用できます。アプリケーションに適したモデルと音声も選択できます。
アプリケーションにTTSを組み込む準備ができたら、登録して、今すぐElevenAPIで最初のリクエストを送信するか、テキスト読み上げAPIの詳細をご覧ください。
よくある質問

Jack LimebearはGrowthチームに所属し、ブログやインサイトページのコンテンツライター兼ストラテジストとして活躍しています。ElevenLabsに入社する前は、急成長中のSaaSスタートアップからFortune 500企業まで、さまざまな組織で10年以上にわたりコンテンツ戦略をリードしてきました。ケンブリッジ大学で英文学の修士号を取得しています。