
AIダビングAPI:音声やビデオを大規模に吹き替える方法
- 公開日
- 最終更新日
数十年前、動画を吹き替えるには、スタジオを予約し、対象言語のボイスアクターを雇い、すべてのセリフを収録(再収録)して、完成品が届くまで何週間も待つ必要がありました。
AI吹き替えAPIなら、そのプロセスを数回のREST呼び出しに短縮できます。オーディオまたはビデオを送信するだけで、元のタイミングや感情の幅を保ったまま、新しい言語に吹き替えた出力を受け取れます。
このガイドでは、AI吹き替えAPIの仕組みと、本番運用に対応したAPIと寄せ集めのパイプラインとの違いを解説します。また、最新の吹き替えモデルであるDubbing v2をあらゆるワークフローに提供する、ElevenLabsの新しいダビングAPIの統合方法も紹介します。
概要
- AI吹き替えAPIは、元のオーディオまたはビデオを受け取り、新しい言語に吹き替えた出力を返します。
- Dubbing v2は、元の演技を条件として利用するオーディオtoオーディオモデルです。感情、トーン、話し方をすべての吹き替えに引き継ぎます。
- ElevenLabs Dubbing APIは、同期を考慮した翻訳で90以上の言語に対応しています。
- デベロッパーは、数回のREST呼び出しで吹き替えプロジェクトを作成し、対象言語を追加して、完成した吹き替えをダウンロードできます。
- エンタープライズのお客様は、ソースの文字起こしと翻訳を編集し、変更したセグメントだけを再生成できます。
AI吹き替えAPIとは?
AI吹き替えAPIは、ある言語のオーディオまたはビデオを受け取り、対象言語の吹き替えオーディオを返すプログラマティックなインターフェースです。ソースの文字起こし、会話の翻訳、各話者の音声クローン、対象言語での音声生成、元のタイミングへの出力のアラインメントまで、ローカライズの全工程を自動化します。
デベロッパーはこれまで、スピーチtoテキスト、機械翻訳、テキスト読み上げサービスをつなぎ合わせ、簡易的な吹き替えパイプラインを構築してきました。しかし、大規模なワークロードでは信頼性に欠けます。
話者のアイデンティティが工程ごとに分断され、タイミングがずれ、かつて感情豊かだったスクリプトも単調になってしまうことがあります。
専用設計の吹き替えAPIには、こうした問題を解決する多彩な機能が含まれています。話者分離、音声の保持、内部同期、ボイスクローンまで、高品質なAI吹き替えAPIは、平板な翻訳ではなく元の話者らしく聞こえる出力を実現します。
AI吹き替えの仕組み:オーディオtoオーディオとカスケード型パイプラインの違い
ほとんどの自動吹き替えシステムは、カスケード型パイプラインです。ソースオーディオを文字起こしし、その文字起こしを翻訳して、テキストから新たな音声を合成します。ためらい、緊張、皮肉、ささやくような一言など、生の文字起こしに含まれない要素はすべて、合成が始まる前に失われます。
ElevenLabsのDubbing v2は、異なるアプローチを採用しています。
Dubbing v2は、文字起こしではなく元の録音そのものを直接条件として出力を生成するオーディオtoオーディオモデルです。モデルは演技の説明を読むのではなく演技そのものを聞くため、トーン、感情、感情表現まで吹き替えに引き継がれます。
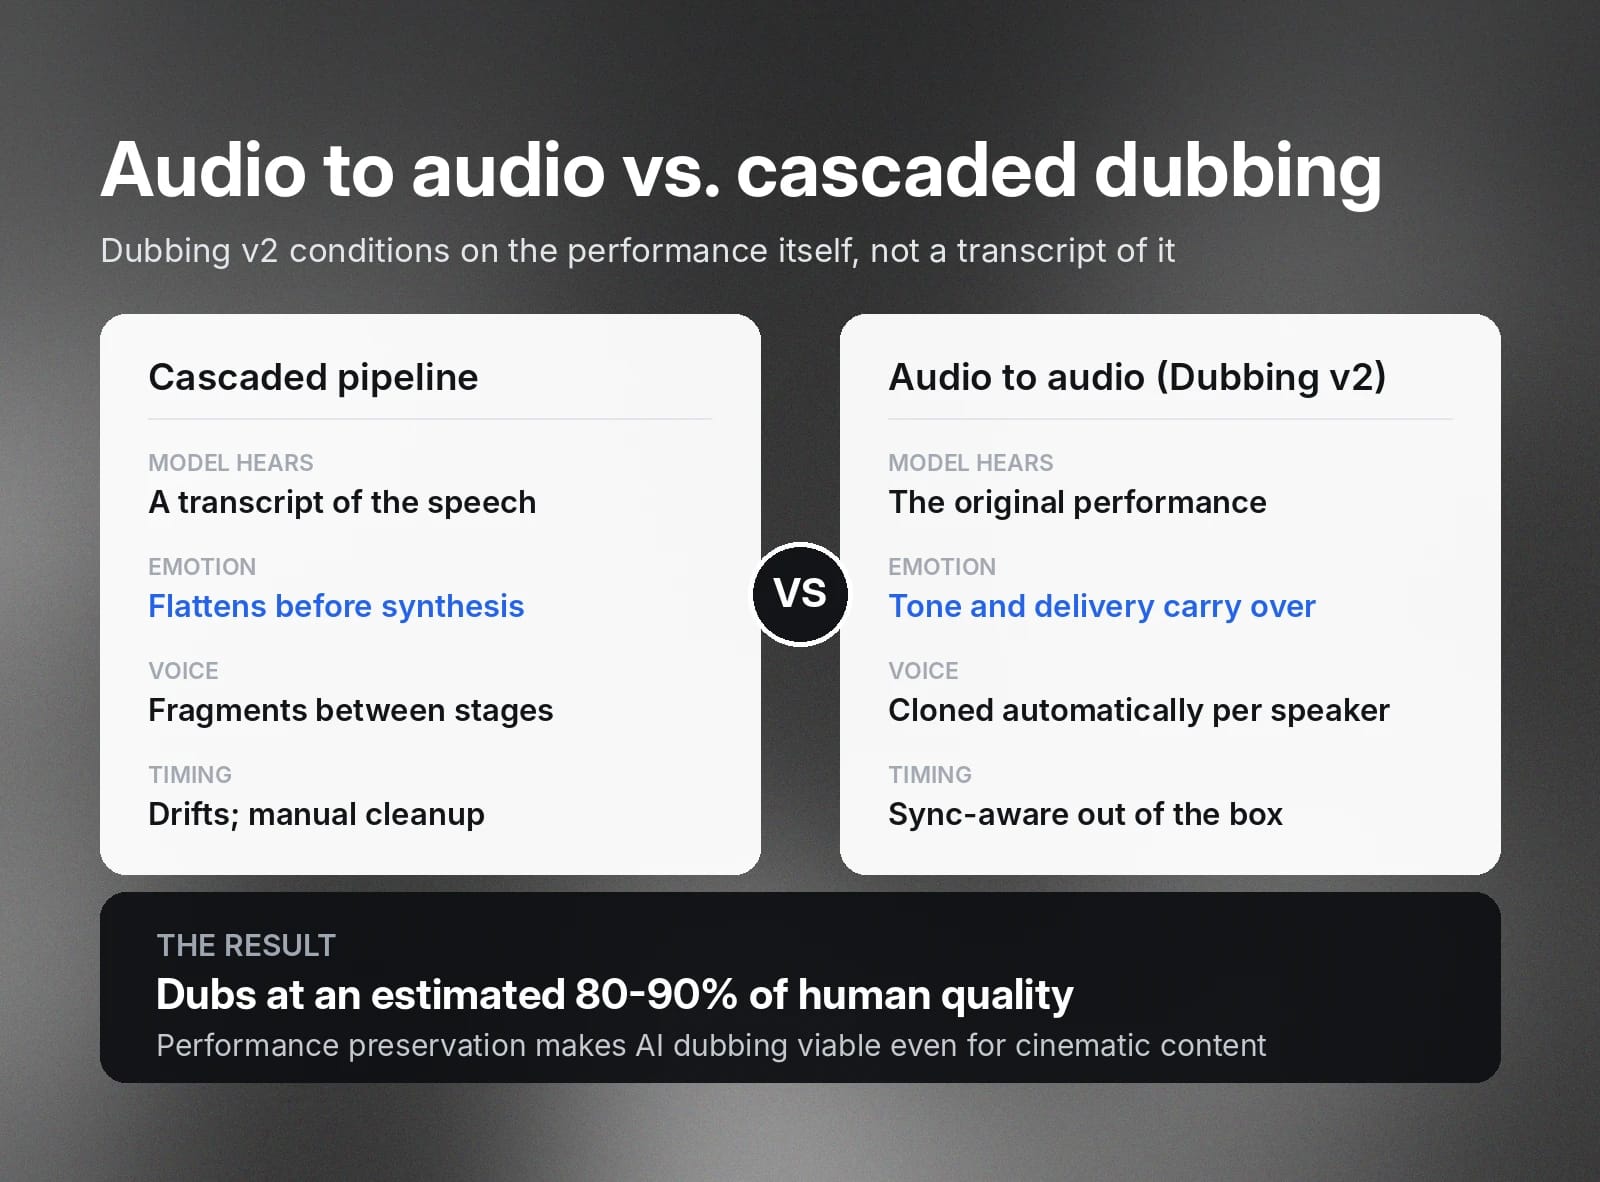
Dubbing v2による吹き替えは、人間の品質の80〜90%に達すると推定しています。つまり、AI吹き替えは映画のようなコンテンツにも対応できるようになりました。
Dubbing v2には、さらに3つの主要な機能があります。
- 同期を考慮した翻訳:モデルはタイミングを考慮して翻訳するため、吹き替えオーディオの開始と終了は、標準で元の音声と一致します。ビデオ編集やリップシンクは必要ありません。オーディオは元のセリフとまったく同じ位置に収まります。
- 自動ボイスクローン:手動でクローンを作成しなくても、すべての翻訳が元の話者の音声クローンで提供されます。複数話者の場合でも、話者のアイデンティティ、ピッチ、音質は、対応するすべての言語で維持されます。
- ロケールレベルの精度:Dubbing v2は、ブラジルポルトガル語のpt-BRのような言語コードによるロケール制御により、ラテンアメリカスペイン語やカスティーリャスペイン語といった地域バリアントを区別します。
AI吹き替えAPIを選ぶ際のポイント
デベロッパー向けパイプラインにAI吹き替えAPIを評価する際は、確認すべき重要な基準がいくつかあります。
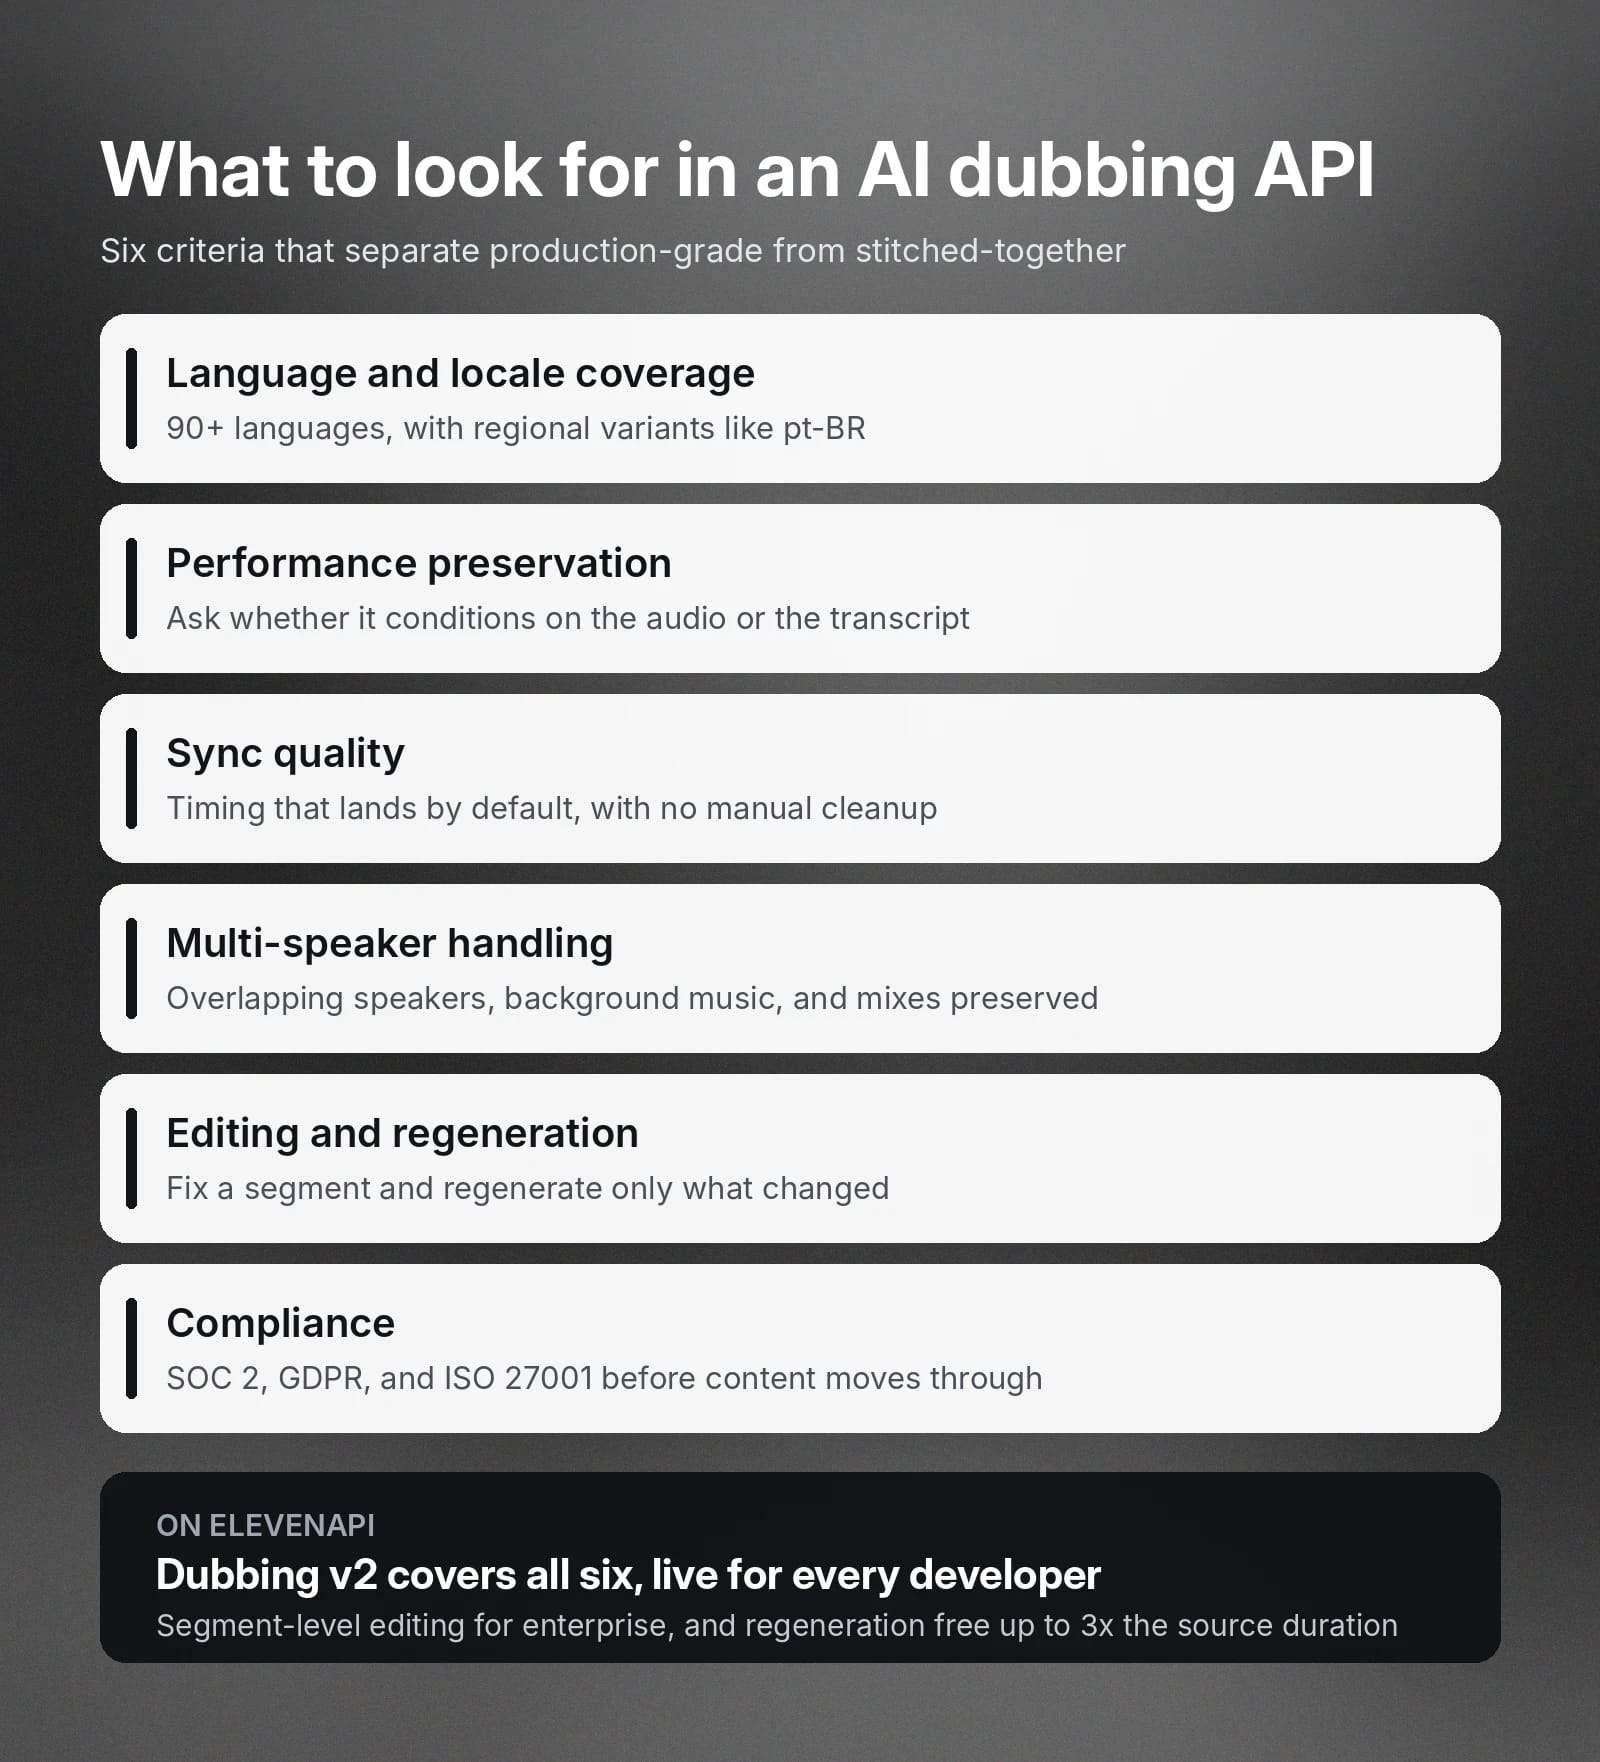
優れたAI吹き替えAPIに備わる主な機能は次のとおりです。
- 幅広い言語・ロケール対応:90以上の言語に対応していることに加え、地域バリアントなどを細かく指定できるかを確認しましょう。
- 演技の保持:システムがソースオーディオと文字起こしのどちらを条件として利用するかを確認してください。感情が吹き替え後も残るかどうかは、オーディオtoオーディオのアーキテクチャによって決まります。
- シームレスな同期品質:吹き替えオーディオが元のタイミングからずれると、何時間もの手作業による修正が必要になります。後処理の負担を避けるには、同期が標準で機能する必要があります。
- 複数話者と背景音への対応:AI吹き替えAPIは、重なり合う話者やサウンドエフェクトを容易に扱えるべきです。また、クリップ内の背景音楽やミックスも保持する必要があります。
- 編集と再生成:文字起こしを修正し、翻訳を改善し、影響を受けたセグメントだけを再生成できる吹き替えAPIなら、ファイル全体を再度吹き替える必要がありません。
- コンプライアンス:エンタープライズのワークロードでは、コンテンツをシステムで扱う前に、SOC 2、GDPR、ISO 27001への準拠が必要です。
このガイドの続きでは、上記のすべての機能を備えたElevenLabsのDubbing APIを詳しく解説します。
ElevenLabs Dubbing APIでオーディオとビデオを吹き替える方法
Dubbing APIはプロジェクト単位で構成されています。各プロジェクトには、1つのソースファイルとその文字起こしが含まれます。その後、吹き替え先の言語ごとに対象言語を1つ追加でき、各言語にはそれぞれの翻訳と出力が作成されます。
以下の基本的な作成・取得ワークフローは、ElevenAPIプラットフォームのすべてのユーザーが利用できます。
1)吹き替えプロジェクトを作成する
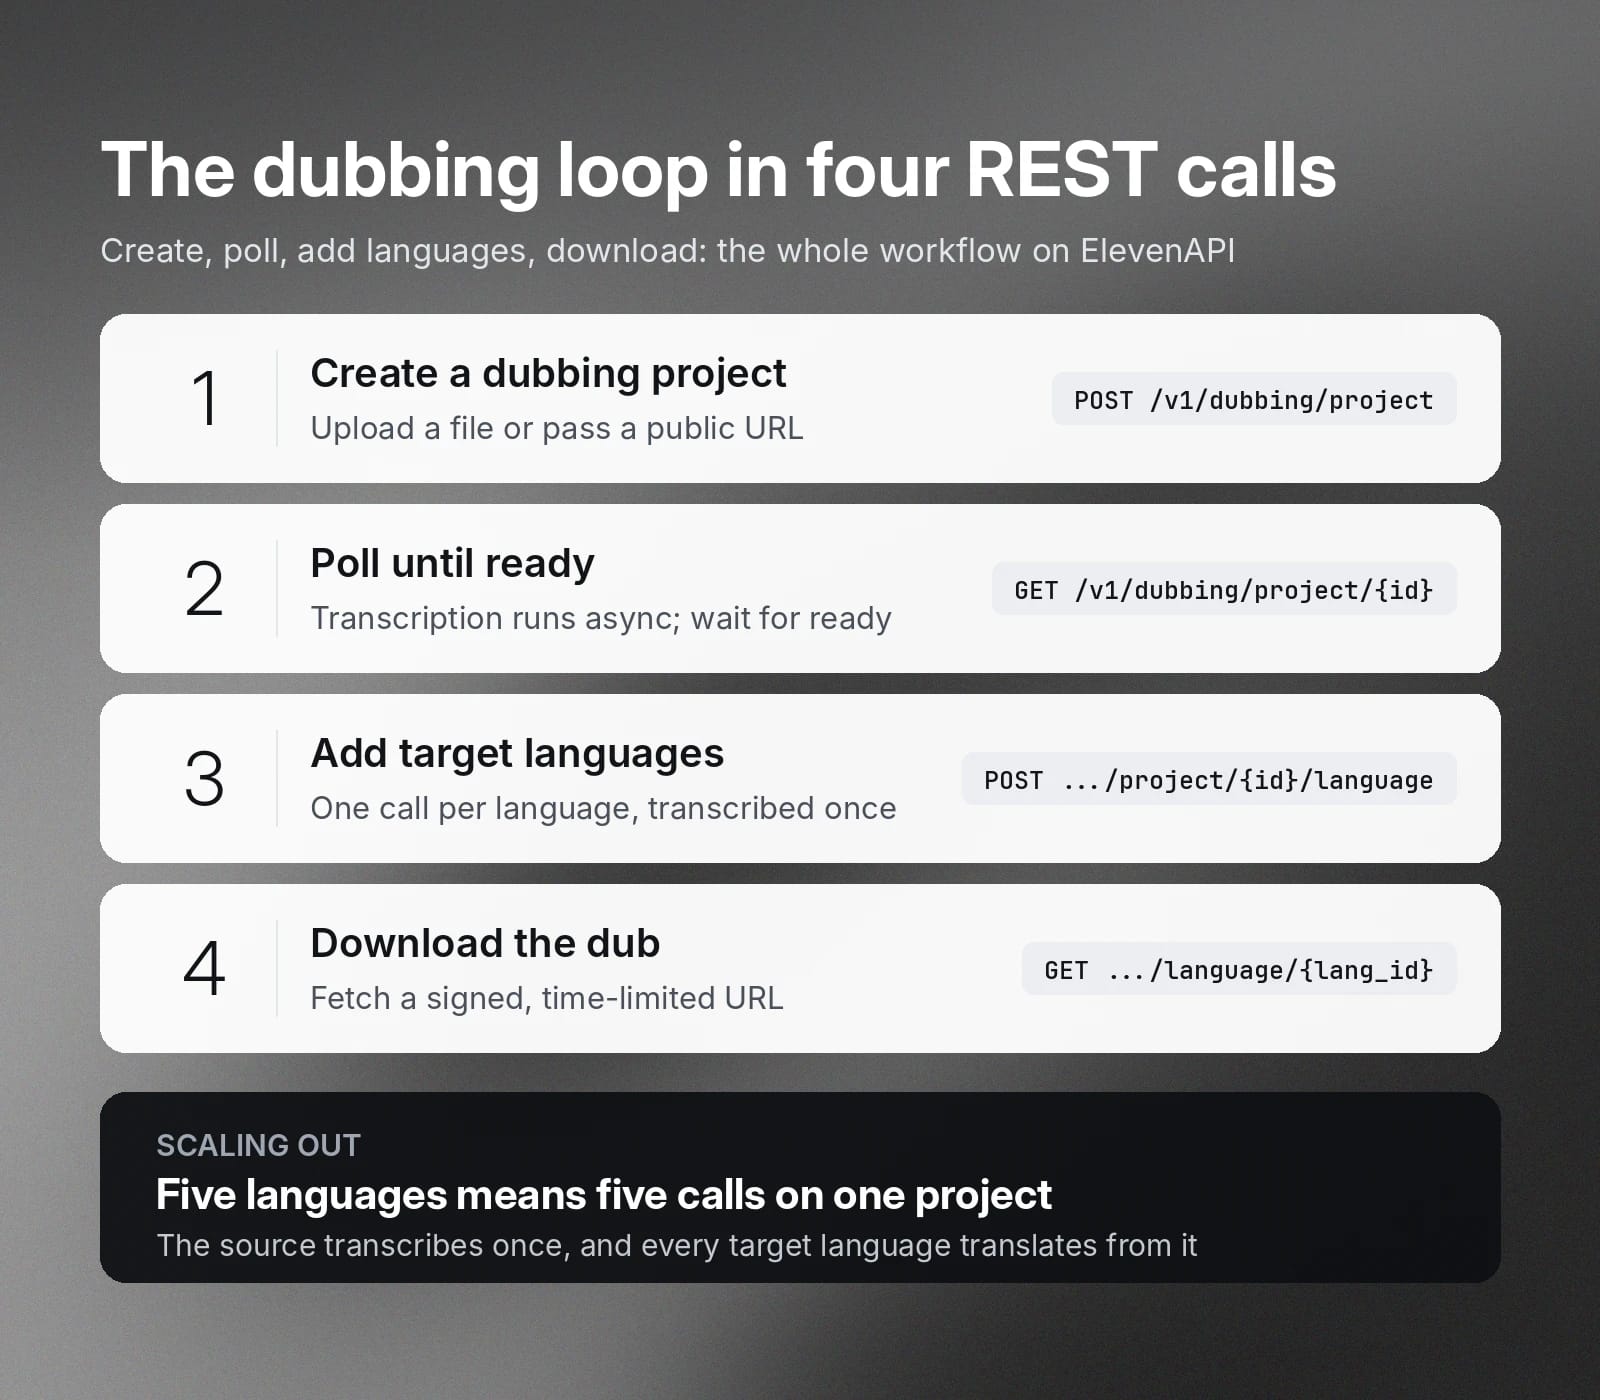
ソースメディアはファイルアップロードまたは公開URLとして送信します。認証には、xi-api-keyヘッダー内のAPIキーを使用します。プロジェクトを管理側で識別するための任意の参照ラベルや、文字起こしと翻訳をプロダクト名・ブランド名に寄せるためのキータームを指定できます。
URLから作成
ファイルアップロードから作成
レスポンスでは、ステータスがqueuedのproject_idが返されます。source_languageを省略すると、モデルが文字起こし時に自動で検出します。
2)プロジェクトの準備が整うまでポーリングする
ソースの文字起こしは非同期で行われるため、ステータスがreadyになるまでプロジェクトをポーリングします。
readyのプロジェクトではソースの文字起こしが準備され、対象言語の追加を待っている状態です。言語ごとの進行状況は各言語自体で管理されるため、この時点以降、プロジェクトはreadyのままです。
3)対象言語を追加する
対象ごとに言語を1つ追加します。cloning_strength設定(0〜10、デフォルトは7)では、元の音声との類似度と対象言語での自然な話し方のバランスを調整します。
各言語は、queued、processingを経てcompletedになります。
5つの言語に吹き替えるには、同じプロジェクトに対して5回呼び出します。ソースの文字起こしは1回だけ行われ、すべての言語はそれをもとに翻訳されます。
4)吹き替え済みの出力をダウンロードする
ステータスがcompletedになった言語を取得します。レスポンスには、吹き替えオーディオ用の署名付きダウンロードURLが含まれます。
ダウンロードURLには有効期限があるため、新しいリンクが必要なときはいつでも言語を再度取得してください。
この4ステップで、完全に自動化された吹き替えループを構築できます。作成、ポーリング、言語追加、ダウンロードです。
APIによる吹き替えの編集と再生成
出力の自動化で多くのユースケースをカバーできますが、プレミアムなローカライズでは、表現を完璧にするために人の目で言葉を確認する必要があることもあります。Dubbing APIは、エンタープライズのお客様に翻訳の両側をセグメント単位で管理する機能を提供します。
ソースの文字起こしは、すべての言語が翻訳の基準とする唯一の信頼できる情報源であり、完全に編集可能です。聞き取り違えたセリフの修正、話者の割り当ての修正、任意のセグメントのタイミング調整を行えます。
各対象言語には専用の文字起こしがあり、各ソースセグメントとその翻訳が対応付けられています。翻訳も同じ方法で編集できます。
独自のソース文字起こしと翻訳を持ち込むこともできます。既存のローカライズワークフローで文言を管理しながら、モデルには音声の処理を任せられます。
吹き替え完了後に文字起こしが変更されると、その言語はstaleとしてマークされ、1回の呼び出しで現在のテキストから再生成できます。
再生成はソースメディアの長さの最大1倍まで無料です。つまり、翻訳を繰り返し調整しても吹き替え料金が増えることはありません。1倍の上限を超えると、再生成には通常の吹き替え料金が適用されます。
AI吹き替えAPIのユースケース
ビデオ吹き替えAPIは、大量のオーディオをローカライズする必要がある場面で役立ちます。手動での吹き替えは時間と手間がかかりますが、AI吹き替えAPIを使えばプロセスを大幅に高速化できます。
AI吹き替えAPIのユースケースをいくつかご紹介します。
- メディア制作プラットフォーム:吹き替えをクリエイターの制作ワークフローに直接組み込み、ユーザーがアプリを離れずに試せるようにします。
- トレーニング・サポートコンテンツ:世界各地から人材を採用する企業は、コンテンツをさまざまな言語にローカライズし、すべてのユーザー向けのオンボーディング研修ビデオを提供できます。
- ストリーミングとメディア:ローカライズパイプラインにより、長編シリーズやその他のメディアを複数地域で公開するために自動で吹き替えられます。
- マーケティング素材:何十もの言語でボイスアクターのセリフを再収録することなく、多言語のビデオキャンペーンを展開できます。
- EdTech:コースプラットフォームは、講師の声を保ちながら、講師のビデオを提供するすべての市場向けに吹き替えます。
吹き替えAPIにより、高品質でローカライズされたコンテンツを大規模に制作することが、あらゆる分野で身近な選択肢になります。
Dubbing v2がElevenAPIで提供開始
Dubbing APIはセルフサービスとエンタープライズの両方のデベロッパー向けに提供中です。Dubbing v2はすべてのユーザーが利用でき、エンタープライズワークスペースには編集用エンドポイントも用意されています。
Dubbing APIで機能の詳細を確認するか、登録してAPIキーを作成して、数分で最初の吹き替えを実行しましょう。
吹き替えAPIに関するよくある質問

Jack LimebearはGrowthチームに所属し、ブログやインサイトページのコンテンツライター兼ストラテジストとして活躍しています。ElevenLabsに入社する前は、急成長中のSaaSスタートアップからFortune 500企業まで、さまざまな組織で10年以上にわたりコンテンツ戦略をリードしてきました。ケンブリッジ大学で英文学の修士号を取得しています。


