
テキスト読み上げAPIの統合:ストリーミング、バッチ処理、リトライ
- 公開日
- 最終更新日
テキスト読み上げ(TTS)APIの統合は簡単です…ただし、いくつかの具体的な判断を済ませた後の話です。どの転送モードを使うか、モデルと出力形式をどう選ぶか、どうストリーミングするか、同時実行数の上限を超えずに大量のリクエストをどう処理するか、同じオーディオのレンダリングに二重で料金を支払わないためにどうキャッシュとリトライを行うか、別のプロバイダーと比較して初回バイト到達時間をどうベンチマークするかを決める必要があります。
テキスト読み上げ(TTS)APIの統合を支援するため、こうしたアーキテクチャ上の判断を一つひとつ分解し、取るべき対応を解説します。このガイドでは、ElevenLabsのテキスト読み上げ(TTS)APIを統合してスケールさせる方法を紹介します。本番環境にそのまま貼り付けて使えるコードスニペットも用意しています。
ここで取り上げる概念を詳しく理解するには、オーディオストリーミングの仕組み、レイテンシの最適化、およびElevenLabsモデルの概要に関するガイドをご覧ください。
概要
- ElevenLabsのテキスト読み上げ(TTS)APIエンドポイントは1つで、バッチ変換、HTTPストリーミング、stream-input WebSocketの3つの方法で利用できます。
- HTTPでは処理中のすべてのリクエストが同時実行数の上限にカウントされますが、WebSocketではアクティブに生成している分だけがカウントされます。
- 並列処理数はプランの上限を少し下回るように制限し、出力に影響するすべてのパラメーターのハッシュをキャッシュしてください。これにより、同じテキストに二重で課金されることを防げます。
- 同時実行数の壁に達する前に負荷を下げられるよう、429と5xxは指数バックオフとフルジッターでリトライしてください。
テキスト読み上げ(TTS)APIを統合する3つの方法
テキスト読み上げ(TTS)エンドポイントは1つですが、統合方法によってレイテンシ、複雑さ、コストが変わります。
同じPOST /v1/text-to-speech/{voice_id}呼び出しを、用途が少しずつ異なる3つの形で利用できます。テキスト読み上げ(TTS)APIを統合する3つの方法を見ていきましょう。
- バッチ(convert)は最もシンプルな統合方法です: リクエストを1つ送信し、オーディオレスポンスを1つ受け取ります。最も複雑さが少ない選択肢ですが、バイトが返る前にクリップ全体が合成されるため、最初のオーディオが届くまでの時間は最も長くなります。
- HTTPストリーミング(stream)は同じリクエストを使い、レスポンスをチャンク化します: パスに/streamを追加してstreamメソッドを呼び出すと、オーディオがチャンク化されたレスポンスとして返されます。コードはほぼ同じで、体感レイテンシは大幅に低くなります。
- WebSocket(stream-input)は永続的な接続を維持します: テキストを段階的に送信し、その都度オーディオチャンクを受信します。インタラクティブなエージェント向けに設計されており、文が完成する前、LLMがトークンを生成する段階から出力を音声に流し込めます。
ストリーミングによってモデルのオーディオ生成が速くなるわけではありません。推論時間は変わりません。ストリーミングで変わるのは最初のチャンクを受け取るタイミングです。クリップ全体が完了する前に送られるため、総処理量が同じでもユーザーが感じる待ち時間は短くなります。
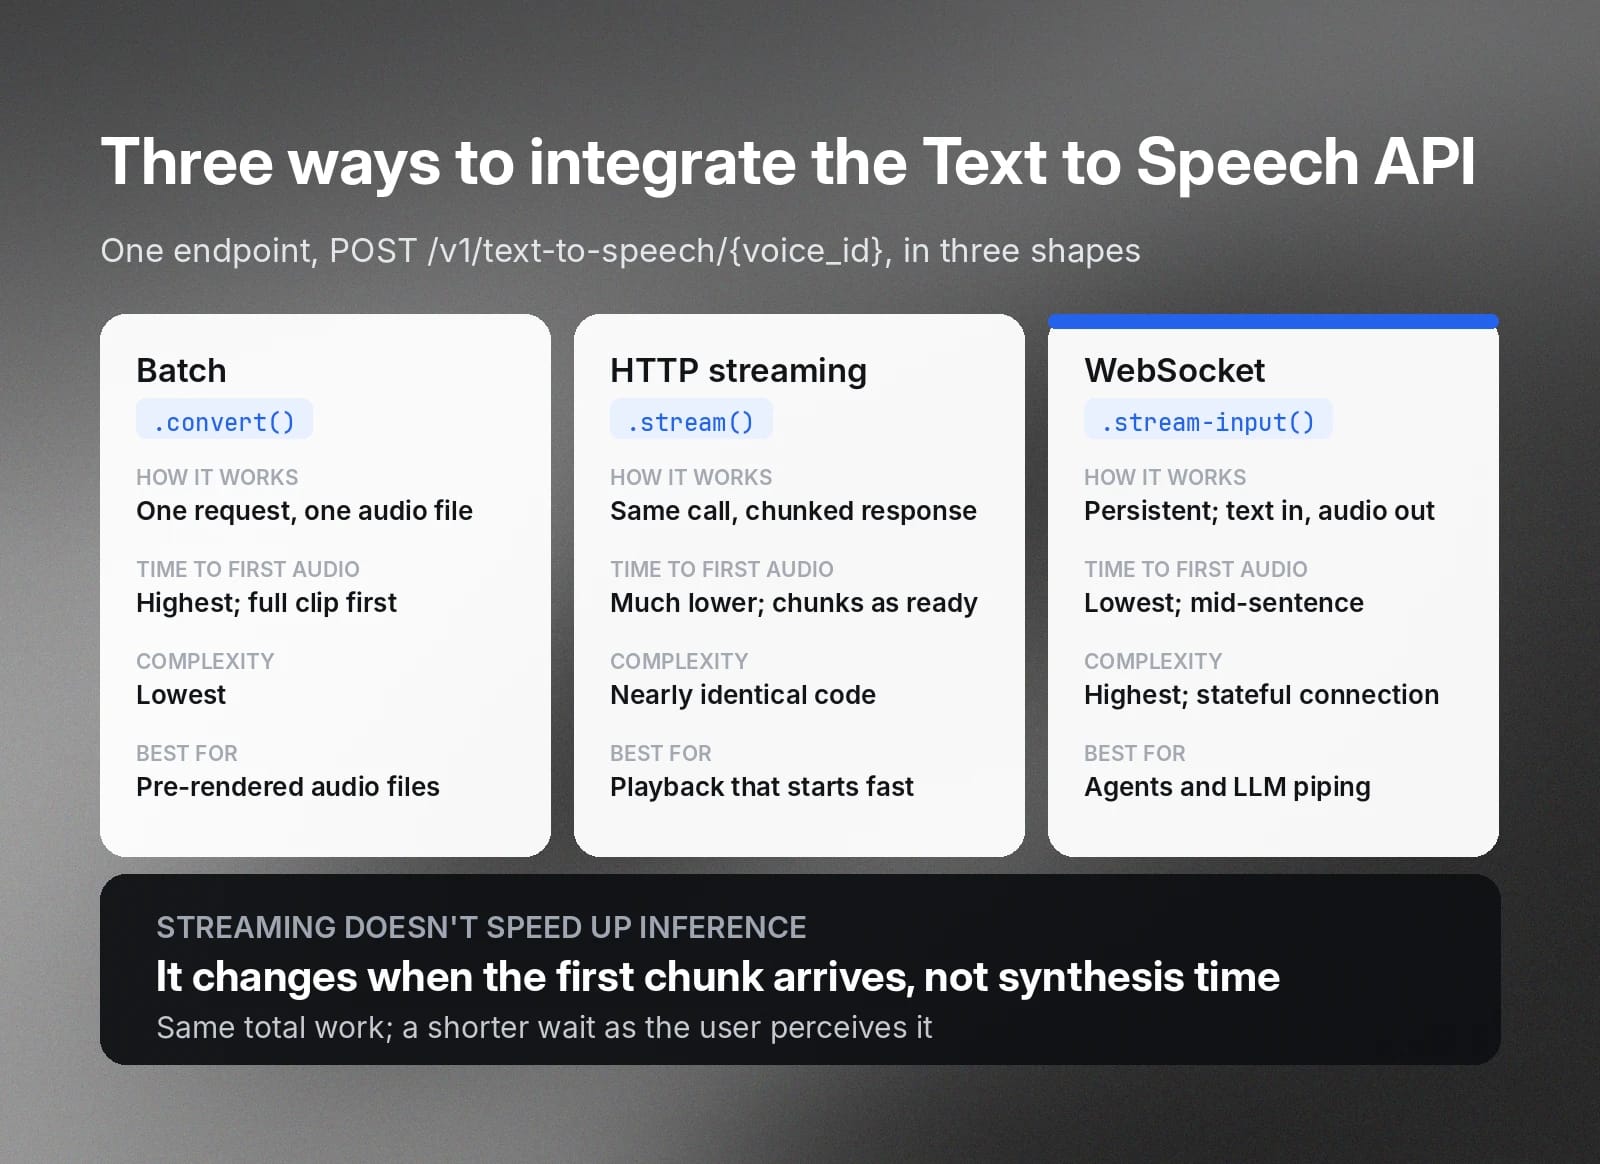
バッチ、ストリーミング、WebSocketの選択表
この3つの方法を選ぶ際には、考慮すべき要素がいくつかあります。
簡単な目安として、オフラインレンダリングにはバッチ、ユーザーが待っている既知のテキストにはHTTPストリーミング、エージェントやリアルタイムのLLMから音声への変換にはWebSocketを選びます。
以下の表では、大規模運用で重要となる観点ごとのトレードオフを整理しています。
HTTPでは、バッチでもストリーミングでも、処理中の各リクエストがその全期間にわたりプランの同時実行数上限にカウントされます。WebSocketでは、モデルが実際にオーディオを生成している時間だけがカウントされます。接続が開いていてもアイドル状態のソケットには、ほとんどコストがかかりません。
カスケード型音声エージェントでは、会話全体を通じて接続を開いたままにしながら、オーディオを生成するのはエージェントの発話時だけです。この違いは大きく、エージェントを構築する際にWebSocketを使う主な理由になります。プロトコルの詳細は、リアルタイムのテキスト読み上げ(TTS)WebSocketガイドに記載されています。
モデルと出力形式を選ぶ
TTS API統合で返されるオーディオは、2つの選択によって決まります。1つ目は品質と速度を決めるモデル、2つ目はコンテナ、ビットレート、サンプルレートを決める出力形式です。
この2つを最初から適切に選べば、レイテンシや電話システムとの互換性など、後続する要素もスムーズに整います。
モデル
複数のテキスト読み上げ(TTS)モデルを提供しています。優劣順ではなく、それぞれ異なるトレードオフがあります。
補足すると、約75msという数値は、ネットワークとアプリケーションのレイテンシを除いた、代表的な条件でのモデル推論時間です。入力が長い場合や負荷がかかっている場合は長くなります。ベンチマークの数値ではなく、必ずご自身のアプリケーションから計測してください。
Flashモデルは小型で、推論時間を短縮するためにより積極的な近似を使用します。Eleven v4とMultilingual v2は大型モデルで、より豊かな出力を生成するために1文字あたりの処理時間が長くなります。
リアルタイム用途やエージェント用途には、最も低レイテンシな多言語オプションであるeleven_flash_v2_5を使用してください。ナレーション、オーディオブック、またはマーケティング用のボイスオーバーには、安定した高忠実度が必要ならeleven_multilingual_v2、最大限の表現力と感情の幅が必要ならeleven_v4を使用してください。
電話番号、日付、通貨など、発音が重要な場合は、テキストがAPIに届く前にアプリケーション側で数値の正規化を行ってください。発話させたい形式をそのまま書き出します。
アプリケーション側で正規化すれば、モデル間で発音の予測可能性を保ち、変更される可能性があるモデル固有のデフォルト設定への依存を避けられます。
出力形式
output_formatパラメーターは、返されるオーディオのコンテナ、サンプルレート、ビットレートを制御します。主に使用する値は次のとおりです。
音声設定
次の設定で、生成される音声の話し方を制御します。
- Stability: 一貫性と表現力のバランスを制御します。値を低くすると変化に富んだ表現豊かな音声になり、高くするとより安定し予測可能な話し方になります。
- SimilarityBoost: 出力が参照音声にどの程度忠実に従うかを制御します。
- Style: 値を上げると、音声本来の話し方のスタイルを強調します。
- useSpeakerBoost: わずかなレイテンシ増加と引き換えに、元の話者への類似性を高めます。
- Speed: デフォルトの1.0を基準に、話す速度を調整します。
これらの設定のうち、通常はStabilityが知覚品質に最も大きく影響します。低い値では表現力が高まる一方で一貫性が下がり、高い値では一貫性と予測可能性が優先されます。
音声を選ぶ際、最も低レイテンシな組み合わせはFlashとInstant ボイスクローン、またはデフォルト音声の組み合わせです。プロフェッショナルボイスクローンは優れた音質ですが、生成ごとのオーバーヘッドを考慮する必要があります。
このガイドでは、サンプルのvoice IDとしてJBFqnCBsd6RMkjVDRZzb(George)を使用します。
ストリーミング統合(HTTPとWebSocket)
このセクションでは、テキスト読み上げ(TTS)API統合の実践的な中核を扱います。SDKのインストール、ストリームの開始、到着するオーディオの消費について解説します。HTTPは大半のWeb・アプリでの再生を対象とし、WebSocketはエージェントとリアルタイムのLLM出力を対象とします。
どちらの方法でも、以下のようにElevenLabsクライアントが初期化済みであることを前提とします。
ストリーミングではストリームを開き、到着したチャンクを消費します。voiceIdは最初の位置引数で、その後にキャメルケースのキー(modelId、outputFormat、voiceSettings)を持つオプションオブジェクトを指定します。
WebSocket版では、wss://api.elevenlabs.io/v1/text-to-speech/{voice_id}/stream-inputに接続します。まず音声設定と先頭のスペースを含むメッセージを送信し、その後テキストが利用可能になった時点でテキストメッセージを送信します。audioフィールドにBase64エンコード済みチャンクを持つJSONフレームを読み取ります。
高スループットのためのバッチ処理と同時実行数の上限
高スループットの統合では、同時にオーディオを生成するリクエスト数である同時実行数が重要です。各プランには、モデルファミリーごとの上限があります。
各プランには固有の同時実行数上限があります。
- 無料: Flashリクエストを4件まで同時実行。
- スターター: Flashリクエストを6件まで同時実行。
- クリエイター: Flashリクエストを10件まで同時実行。
- プロ: Flashリクエストを20件まで同時実行。
- スケールとビジネス: Flashリクエストを30件まで同時実行。エンタープライズの上限はカスタムです。
Multilingual v2の上限は、上記のおよそ半分です。
同時に実行するリクエスト数を制限するプールを使うと、この問題を軽減できます。
MAX_CONCURRENCYは、プランの上限ちょうどではなく、少し低く設定してください。この余裕により、同じキーを共有する他のトラフィックを吸収し、429が返されるしきい値を下回れます。
文字数制限と長文テキストの分割
各モデルには、1回のリクエストで受け付ける文字数の上限があります。長文を扱う統合では、テキストを分割し、オーディオをつなぎ合わせる必要があります。
モデルごとの1リクエストあたりの文字数上限は次のとおりです。
- Flash v2.5: 1リクエストあたり最大40,000文字を受け付けます。
- Flash v2: 1リクエストあたり最大30,000文字を受け付けます。
- Multilingual v2: 1リクエストあたり最大10,000文字を受け付けます。
- Eleven v3: 1リクエストあたり最大5,000文字を受け付けます。
- Eleven v4: 1リクエストあたり最大10,000文字を受け付けます。
それより長いテキストは、複数のリクエストに分割する必要があります。チャンクのつなぎ目でもプロソディを維持できるよう、文の境界で分割するようにしてください。
チャンクを順番にレンダリングし、オーディオを連結します。各チャンクが独立した長文ナレーションでは、この2つは直接組み合わせられます。splitTextの出力を上記の制限付きプールに渡せば、残りを処理できます。
キャッシュとべき等性
テキスト読み上げ(TTS)の出力は十分に決定論的であるため、同じテキストを同じ音声、モデル、設定で再レンダリングするのは無駄です。オーディオに影響する入力のハッシュをキーにして結果をキャッシュし、そのキーをリトライ時のべき等性トークンとしても使います。
両方を実現する方法は次のとおりです。
これを機能させるルールは、outputFormatや音声設定を含め、オーディオを変更するすべてのパラメーターをキーに含めることです。正しく実装すれば、同じキーをべき等性トークンとしても使えます。すでに成功したリクエストをクライアントがリトライした場合、再生成するのではなく、キャッシュ済みのバイト列を返します。
エラー処理とレート制限(429)
本番クライアントには、バックオフとジッターを使ったリトライに加え、ステータスコード別の処理が必要です。リトライする価値がある失敗と、そうでない失敗があるためです。
以下の表は、各ステータスに適した対応を示しています。また、このセクションでは、429が絶対的な壁ではなくソフトリミットである理由を説明します。
429は絶対的な壁ではなく、その仕組みを理解しておくと役立ちます。同時実行数の上限を超えると、リクエストはまず優先度に応じてキューに入り、通常は約50msの遅延が追加されます。その後も容量を超えている場合にのみ、429を受け取ります。
レスポンスには、現在の余裕を示すcurrent-concurrent-requestsヘッダーとmaximum-concurrent-requestsヘッダーも含まれます。これらを読み取り、上限に達する前に負荷を下げられます。
リトライ動作の改善ではなく、より大きな余裕が必要な場合はプランをアップグレードしてください。エンタープライズのお客様は、アカウントマネージャーを通じて上限の引き上げをリクエストできます。
レイテンシと初回バイト到達時間のベンチマーク
レイテンシは、リージョン、入力、現在の負荷に依存します。つまり、信頼する価値がある唯一のレイテンシ数値は、ご自身の環境で計測したものです。
このセクションでは、Flashストリーミングエンドポイントの初回バイト到達時間(TTFB)を扱います。同じテストハーネスを別のプロバイダーに向け、同一条件で比較できるように構成されています。
これは公表された結果ではなく、手法として扱ってください。1回の実行結果が何かを保証することはありません。
テキスト読み上げ(TTS)API統合のレイテンシをベンチマークする際に重要な注意点をいくつか紹介します。
- ネットワーク往復時間を含める: TTFBは地理的な位置とプロバイダーの最寄りのクラスターに依存するため、通常サーバーを稼働させている場所からテストを実行してください。
- ウォームアップ実行を除外する: コールド接続への最初のリクエストは遅く、数値を歪める可能性があります。
- 入力を固定する: 入力の長さ、音声、モデル、負荷はすべて結果に影響するため、プロバイダー間で同一に保ってください。
- 分布を報告する: 数値は実行ごとに変動するため、単一の値ではなく中央値とp95を公開してください。
これらを考慮すれば、ベンチマークの準備は完了です。
別のプロバイダーと比較するには、同じ形の関数を書いてください。次に、ウォームアップ呼び出しを1回除外し、相互に競合しないよう間隔を空けて約20件の時間計測サンプルを取得し、中央値とp95をミリ秒単位で報告する小さなランナーで両方を実行します。
公平な比較には、変数を制御することが不可欠です。
両方のプロバイダーを同じマシンとネットワークから実行してください。理想的には、家庭用ブロードバンド上のノートPCではなく、実際にデプロイするリージョン内のサーバーを使います。同じ入力テキストを使用し、生成時間ではなくモデル推論が数値の中心になるよう、オーディオは短く保ってください。単一の測定値はノイズなので、多数回の実行における中央値とp95を報告します。
パブリックインターネット上のTTFBには、モデルとは無関係な20〜200msのネットワーク往復時間が含まれることに注意してください。北米、欧州、東南アジアのクラスターから最寄りの場所へルーティングしているため、テストクライアントもそれに応じて近くに配置してください。そうしないと、主にデータセンターまでの距離をベンチマークすることになります。
テキスト読み上げ(TTS)API統合の重要ポイント
本番環境向けのテキスト読み上げ(TTS)API統合は、影響の大きいいくつかの判断に集約されます。
これらを正しく選べば、ほかの要素も自然に整います。
- 用途に応じてモデルを選ぶ: インタラクティブな用途にはFlash v2.5を、レイテンシの重要度が低いオフラインレンダリングにはMultilingual v2のような高忠実度モデル、またはEleven v4を使用します。
- ユーザーが待っている場合は必ずストリーミングする: 既知のテキストにはHTTPストリーミングを、エージェントにはWebSocketを使用し、アイドル時間が同時実行数の予算を消費しないようにします。
- 並列処理数をプランの上限内に収める: 同時リクエスト数はプランの上限より少し低く制限し、出力に影響するすべてのパラメーターのハッシュをキーにキャッシュしてください。これにより、同じオーディオに二重で課金されることを防げます。
- 429と5xxは指数バックオフとフルジッターでリトライする: 429と5xxではフルジッターを使ってバックオフし、同時実行数ヘッダーで上限までの余裕を確認してください。
- 長文テキストは文の境界で分割する: 各モデルの文字数上限内で文の境界で分割し、プロソディがつなぎ目を越えて維持されるようにします。
さらに詳しく知りたい場合は、ストリーミングのハウツー、オーディオストリーミングの概念、認証、およびクライアントサイド利用のための使い捨てトークンをご覧ください。
ElevenAPIでテキスト読み上げ(TTS)統合を構築する
このガイドを読めば、本番環境向けのテキスト読み上げ(TTS)API統合に必要なすべてのパターンを把握できます。ストリーミング、バッチ処理、キャッシュ、リトライ、さらにベンチマークまで、運用に移す準備は整っています。
テキスト読み上げ(TTS)APIについて詳しく確認するか、登録して、ElevenAPIで今日から最初の呼び出しを行いましょう。
テキスト読み上げ(TTS)API統合に関するよくある質問

Tadas Petraは、ElevenLabsのプロダクトスイートを使った開発をサポートするデベロッパーリレーションズエンジニアです。また、デベロッパー向け教育プラットフォーム「Hungrimind」の創設者でもあります。以前はAgoraでリードデベロッパーアドボケイト、Zero To Masteryでインストラクターを務めていました。



