カスケード型 vs 融合型モデル:アーキテクチャが音声エージェントのエンタープライズ対応を左右する理由
- 公開日
- 最終更新日
聴くこの記事を聴く
多くの人は、音声エージェントはカスケード型または融合型のアーキテクチャで構築されると考えています。実際には、エージェントは両者の間にあるスペクトラム上で設計され、用途に応じて通常5つのアーキテクチャが使われます。
エージェントのアーキテクチャは、本番環境での信頼性の高い動作、特定のビジネス要件への適応、会話での自然さを左右します。OpenAIのRealtimeモデルのような融合型アーキテクチャは、短いやり取りでは驚くほど人間らしく聞こえるかもしれません。しかし、コンプライアンスのガードレールを適用したり、失敗した応答をデバッグしたり、来月より強力なLLMが登場したときに切り替えたりする必要がある場合、単一の融合ネットワークでは打つ手がほとんどありません。
ElevenLabsでは、高度なカスケード型アーキテクチャを採用しています。音声認識、推論、音声生成に特化したコンポーネントを活用し、高い知能と信頼性を実現しています。会話が自然に流れるよう、文脈に応じたプロソディ、低レイテンシーの最適化、インテリジェントなターンテイキングを組み込んでいます。このように構築したのは、私たちが支援する企業や政府機関には、リアルに聞こえるだけでなく、複雑なタスクを本番環境で安心して任せられるエージェントが求められているためです。
この記事では、主要な5つのアーキテクチャ、それぞれの得意なことや限界、そして重要なワークフローに導入するエージェントの基盤についての考え方を解説します。
アーキテクチャ選定でチームが評価すること
チームが検討するポイントは、通常3つのカテゴリに分けられます。
複雑なタスクに対応できるか?
- 推論とモデルの柔軟性:最も強力なLLMを含め、ユースケースに最適なモデルを選び、より優れた選択肢が登場したらアップグレードできますか?
- エージェントロジック:エージェントが従う会話フロー、判断ルール、エスカレーション経路を定義・制御できますか?
- ツール利用:このアーキテクチャは、複数ステップのツール呼び出しや外部システムとのインテグレーションに対応できますか?
人間らしく聞こえ、感じられるか?
- プロソディ:エージェントは自然なリズム、イントネーション、感情のトーンを表現できますか?
- レイテンシー:会話として自然に感じられるほど、応答は速いですか?
- ターンテイキング:エージェントは、話すべきとき、間を取るべきとき、相手に譲るべきときを判断できますか?
本番環境で信頼できるか?
- 信頼性:エージェントは予測可能で一貫した動作をしますか?それとも時間とともに挙動が変化しますか?
- ガードレール:このアーキテクチャは、意図しない応答や敵対的なユーザーに対する保護を適用できますか?
- 透明性:このアーキテクチャは中間出力を生成しますか?それともブラックボックスですか?
カスケード型と融合型アーキテクチャのトレードオフ
カスケード型アーキテクチャは、特化型コンポーネントを連結して構築されます:スピーチtoテキスト(STT)、大規模言語モデル、そしてテキスト読み上げ(TTS)です。各ステージは個別に最適化、テスト、アップグレードできます。
カスケード型アーキテクチャ
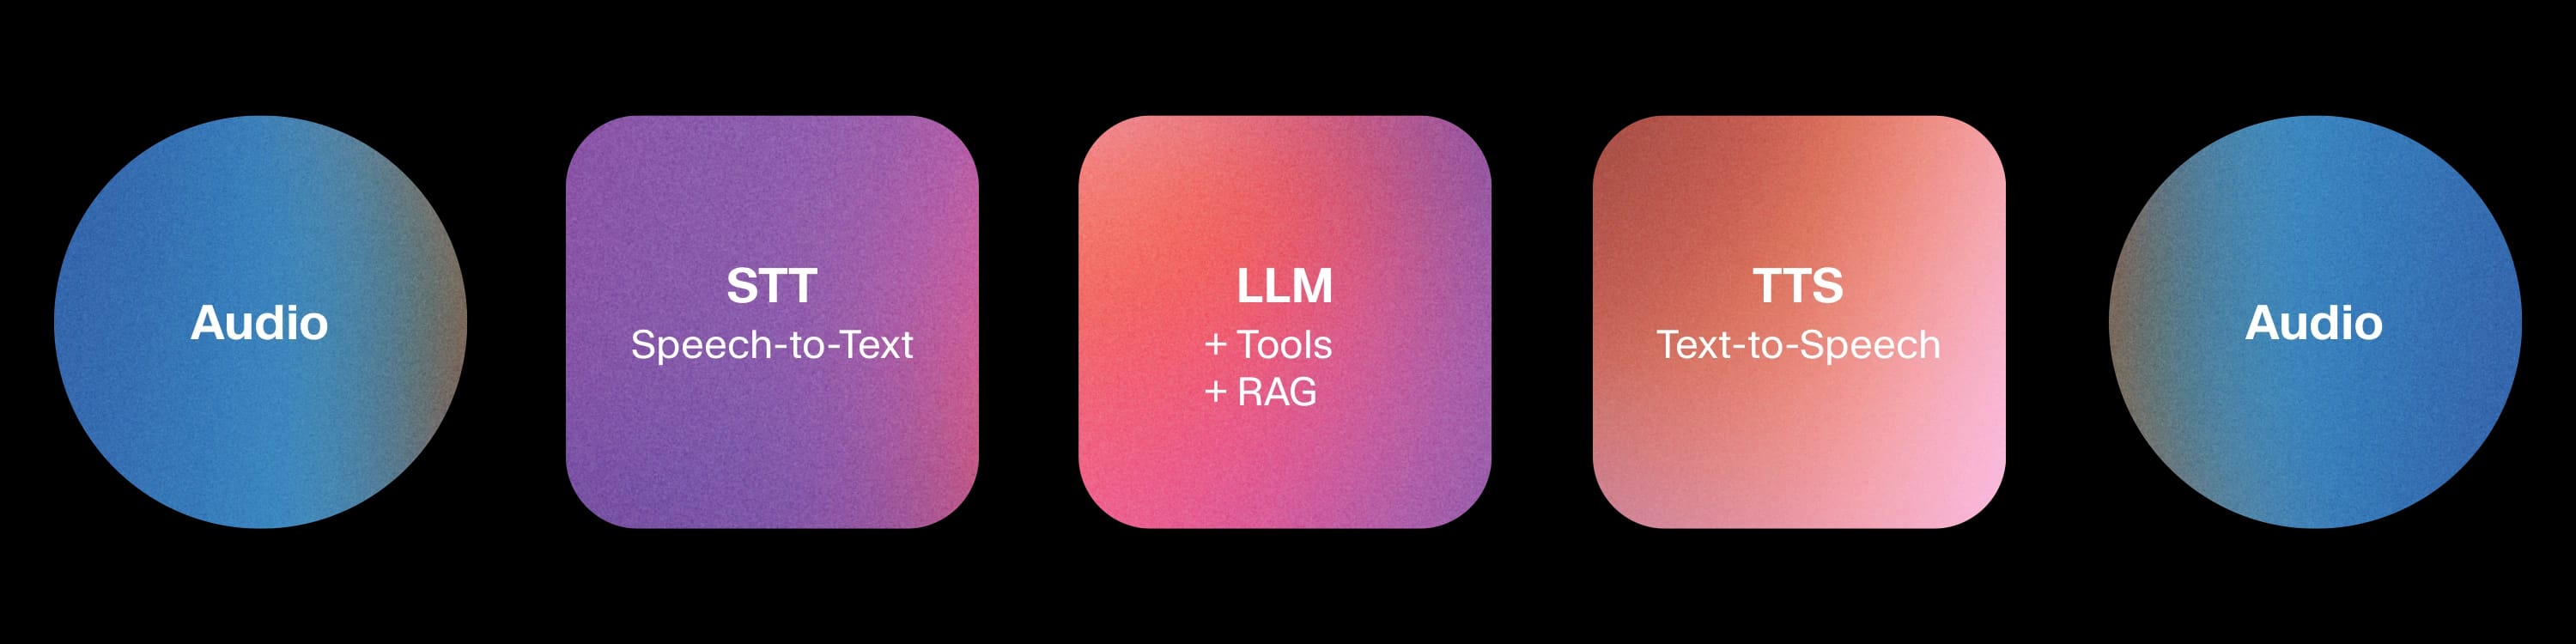
このモジュール性こそが、カスケード型アーキテクチャを大半のエンタープライズグレードのエージェントの基盤にしています。すべてのステージで検査可能な出力が得られます。つまり、STTとLLMの間、LLMとTTSの間に可読なテキストがあります。テキスト層でガードレールを適用でき、音声モデルを変更せずに最新のフロンティアLLMを統合できます。また、何か問題が起きた場合も、一般に原因を特定できます。
カスケード型アーキテクチャに対する長年の批判は、プロソディの手がかりが失われることです。音声はテキストへと還元され、イントネーション、リズム、感情は出力側で再構築する必要があります。これらの手がかりは明示的なモデリングによって部分的に復元できますが、融合型アプローチほど自然には捉えられません。レイテンシーやターンテイキングといった他の要素は、通常どちらのアプローチでも同等のパフォーマンス水準まで最適化できます。
融合モデル
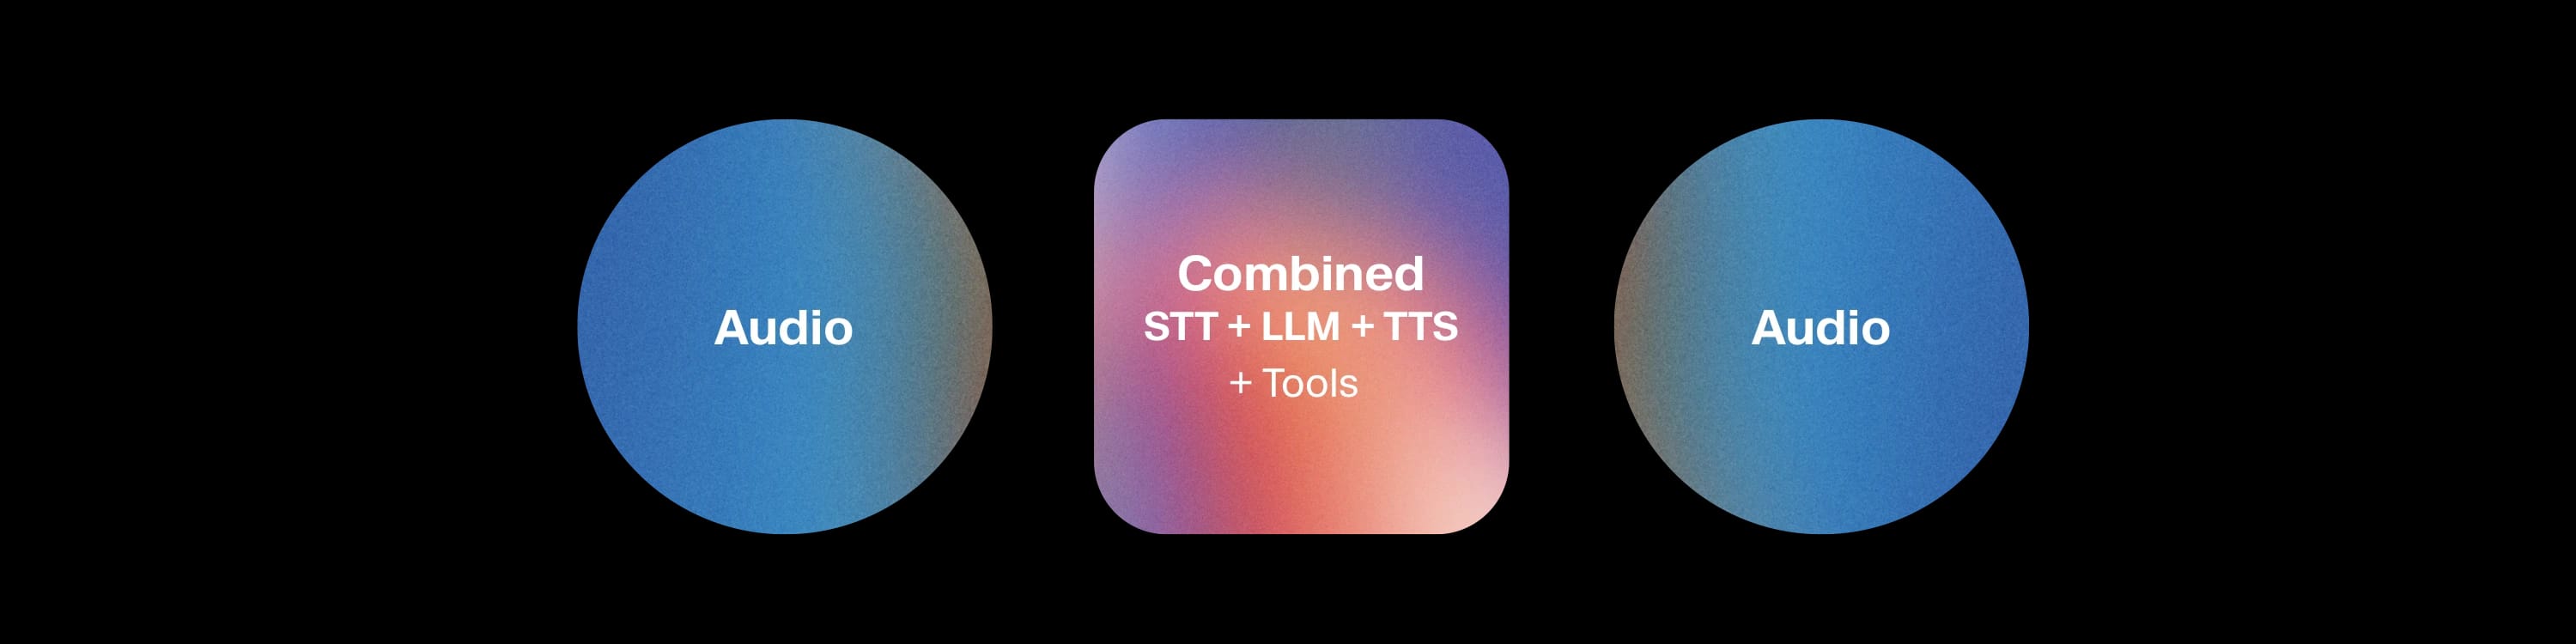
融合型アーキテクチャは、根本的に異なるアプローチを取ります。認識、推論、生成のすべてが、単一のマルチモーダルネットワーク内で行われます。音声が入力され、音声が出力され、その間に検査可能な層はありません。
中間ステージがないことは、魅力であると同時に制約でもあります。融合型アーキテクチャでは、音声がテキストに分解されないため、プロソディの手がかりを自然に保持できます。しかし、ガードレールの適用、個別コンポーネントの入れ替え、デバッグのための中間出力の検査には限界があります。また、業界固有の用語に合わせたSTTの微調整や、より強力な推論とツール呼び出しのための別のLLMの統合にも制約があります。システムは単一のネットワークであり、チームが利用できるのは提供される推論能力に限られます。現在は軽量なコアが中心で、複雑なタスクではフロンティアLLMに匹敵しません。
5つのアーキテクチャ
1. 基本カスケード型
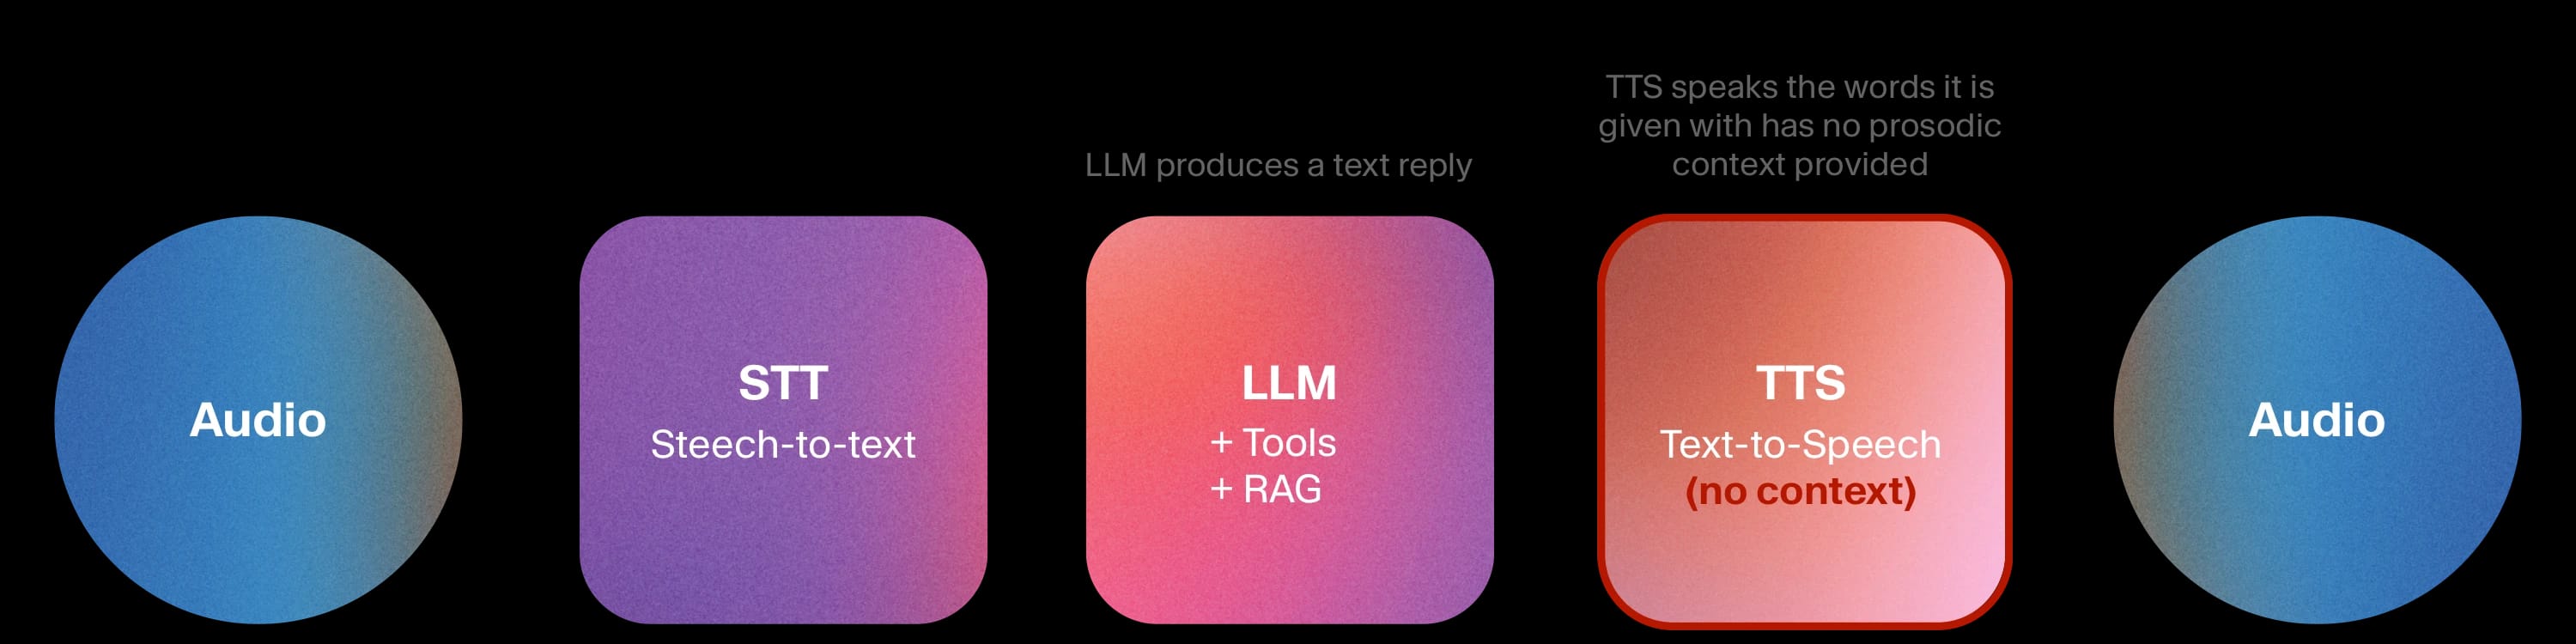
音声を文字起こしし、LLMがテキストで応答を生成し、TTSがそれを読み上げます。すべてのステージはプレーンテキストで動作するため、すべてを確認、テスト、制御できます。
信頼性における利点は明確です。テキスト層でのガードレール、決定論的な会話フロー、完全な監査証跡を実現できます。LLMは独立したコンポーネントなので、最も強力な推論またはツール呼び出し能力を持つフロンティアモデルをエージェントと組み合わせ、より優れたモデルが登場した瞬間にアップグレードできます。弱点は会話品質です。文脈対応TTSがなければ、エージェントは機能的ではあっても平板に聞こえます。感情への適応やプロソディの変化がないため、口座残高を読み上げる用途には適していますが、不満を抱えた顧客への対応には不十分です。
ユースケースの例:
- 通信・公益事業におけるIVRの置き換え
- SaaSオンボーディングのFAQ対応
- 温かみよりも一貫性が重要な、予約確認、処方薬のリマインダー、配送通知などの発信通知
2. 高度なカスケード型
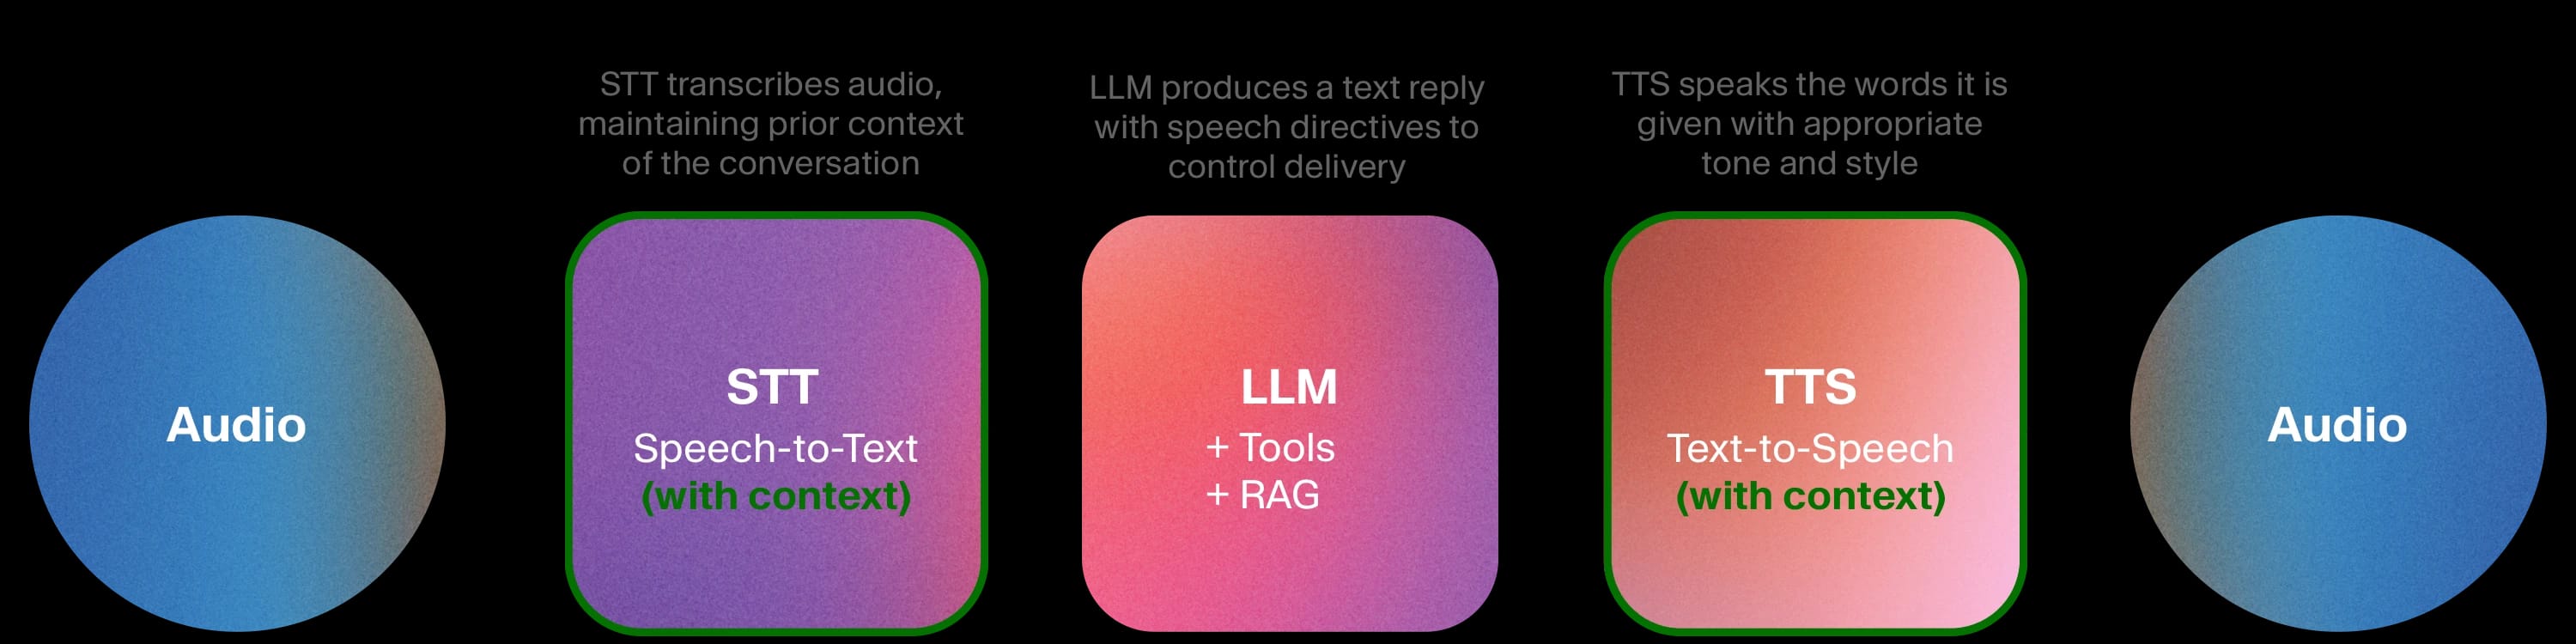
同じモジュール型アーキテクチャですが、複数のコンポーネントがより豊富なコンテキストで動作します。これはExpressive ModeをElevenAgentsに実装したものです。
Scribe v2 Realtime STTモデルは、会話のこれまでのコンテキストを活用し、高速かつ正確な文字起こしを生成します。テキストをもとに、LLMはTTSに対して、何を言うかだけでなく、どのように話すかも指示します。たとえば「安心させるように」「強調して」「緊急性を持って」といった指示により、会話を通じてトーンを動的に調整します。ターンテイキングシステムも同じシグナルを利用し、エージェントが応答すべきときと相手に譲るべきときを判断します。音声モデルはコンポーネント間のネットワークホップがない単一のスタック内に配置されるため、レイテンシーを低く保てます。
このアーキテクチャは、基本カスケード型のすべてを維持します。完全な透明性、テキスト層のガードレール、コンポーネントの入れ替え可能性、ドメインチューニング、利用可能な最も強力なツール呼び出し・推論モデルへのアクセスです。さらに、大幅に向上したプロソディ、レイテンシー、ターンテイキングも追加されます。チームは、新しいフロンティアLLMがリリースされた週に統合したり、他のコンポーネントを再構築することなく医療向けSTTを医療用語に合わせて微調整したりできます。
ユースケースの例:
- カスタマーサポート:金融サービスにおいて、不正請求に関する電話での共感的な応対と、厳格なコンプライアンスガードレール、完全なやり取りのログ記録を両立
- 適切な緊急度で患者の電話をトリアージし、HIPAA準拠のフローと医療用語に合わせた音声認識を備えた医療受付
- 構造化されたプレイブックに従いながら、温かく説得力のあるトーンを保ち、CRMに更新を反映する営業アシスタント
3. ハイブリッド・カスケード型/融合型
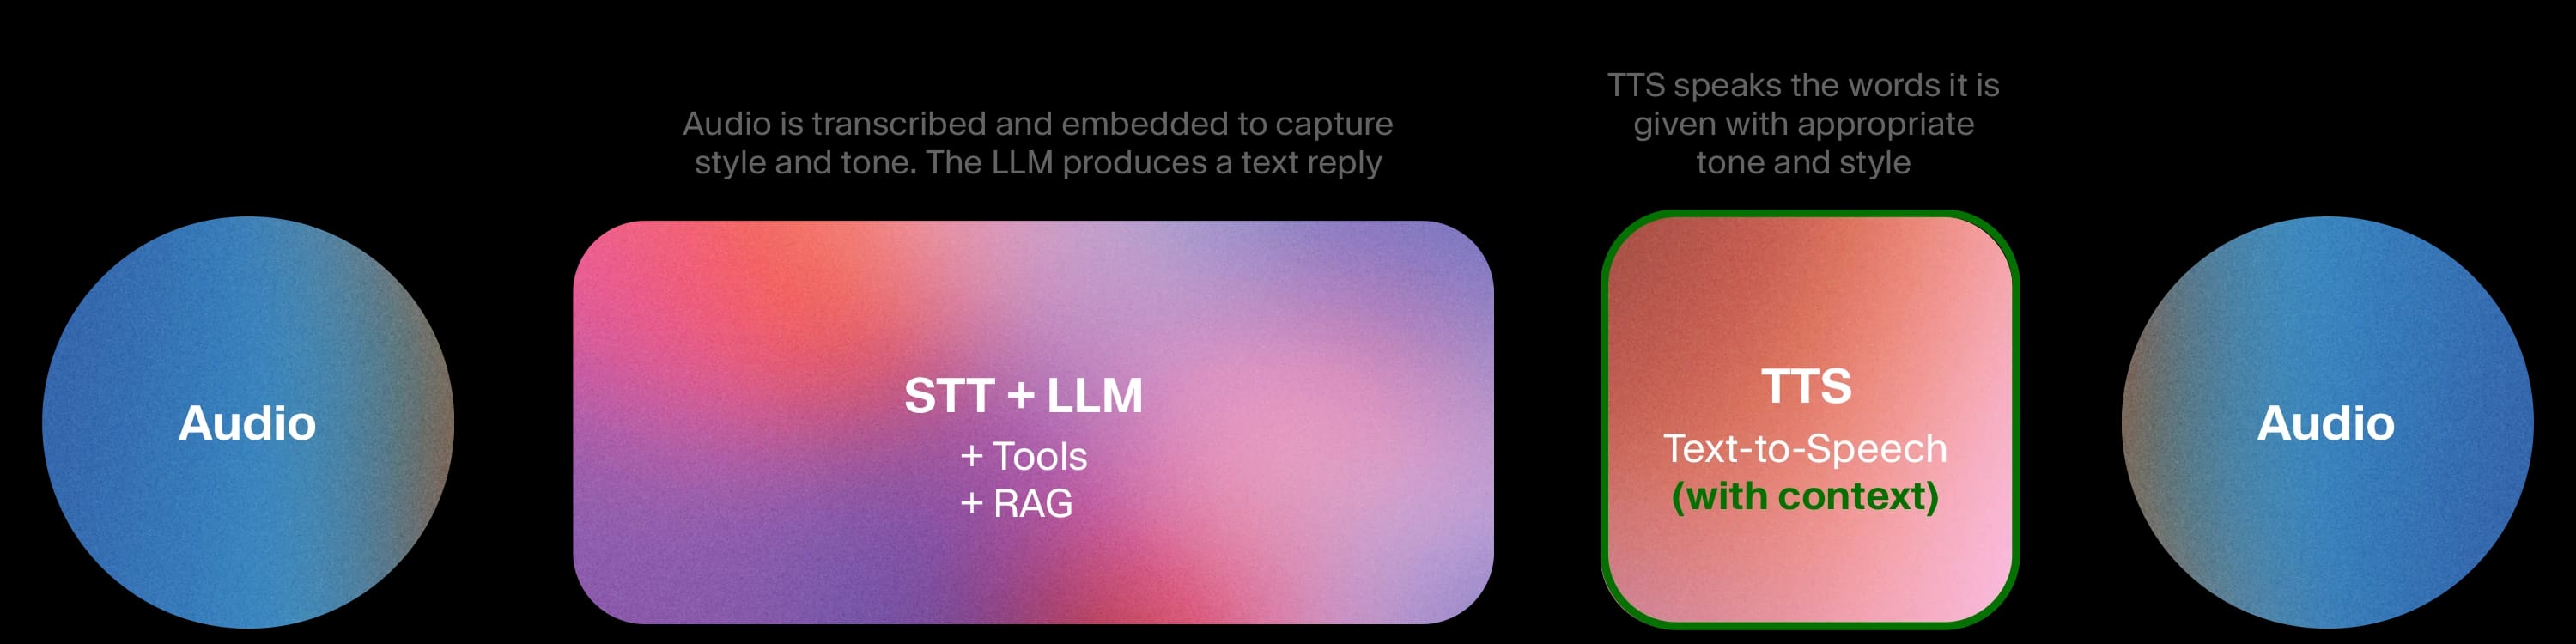
一部のアーキテクチャでは、入力音声の音響特徴(発音、感情、トーン)を、まずテキストに変換するのではなく、埋め込みとしてLLMに直接入力します。TTSはモジュール型のままです。
これによりLLMは、何が言われたかだけでなく、どのように言われたかについても、より豊富な入力を得られます。これは特定の用途で有用です。融合されたASR+LLMブロックは、中間表現が人間に読めるものではなく埋め込みであるため、明確なテキストの受け渡しよりも監査が困難です。また、LLMを簡単に入れ替えられなくなるため、推論とツール呼び出しの能力は、融合ブロックの基盤となるモデルに制約されます。
ユースケースの例:
- 学習者がどのように話すかを聞き取ることが、何を話すかと同じくらい重要な語学学習と発音コーチング
- 不満の検知は重要だが、タスク自体はシンプルな、低複雑性のトーン感応型サポート
4. 逐次融合型
単一のマルチモーダルモデルが、認識、推論、生成を1回の処理で、1ターンずつ行います。
プロソディは優れたものになり得ます。音声がテキストへ分解されないため、モデルは話すペース、イントネーション、感情の手がかりを自然に保持します。短い会話は非常に滑らかに聞こえます。
ただし、テキスト層がなければガードレールを適用する能力は限られ、デバッグ用の中間出力も限られます。また、より優れたLLMへの切り替えや、ドメインに合わせたSTTの微調整の柔軟性も限定的です。推論コアはフロンティアLLMより軽量な傾向があるため、複雑なツール呼び出しや複数ステップのタスクは性能が低下します。複雑な問題の解決が必要なタスクでは、プロソディだけでは不十分です。
ユースケースの例:
- 表現力がエンゲージメントを左右し、コンプライアンス要件が最小限のパーソナルコンパニオン、エンターテインメントチャットボット、アプリケーション。
5. 双方向同時融合型
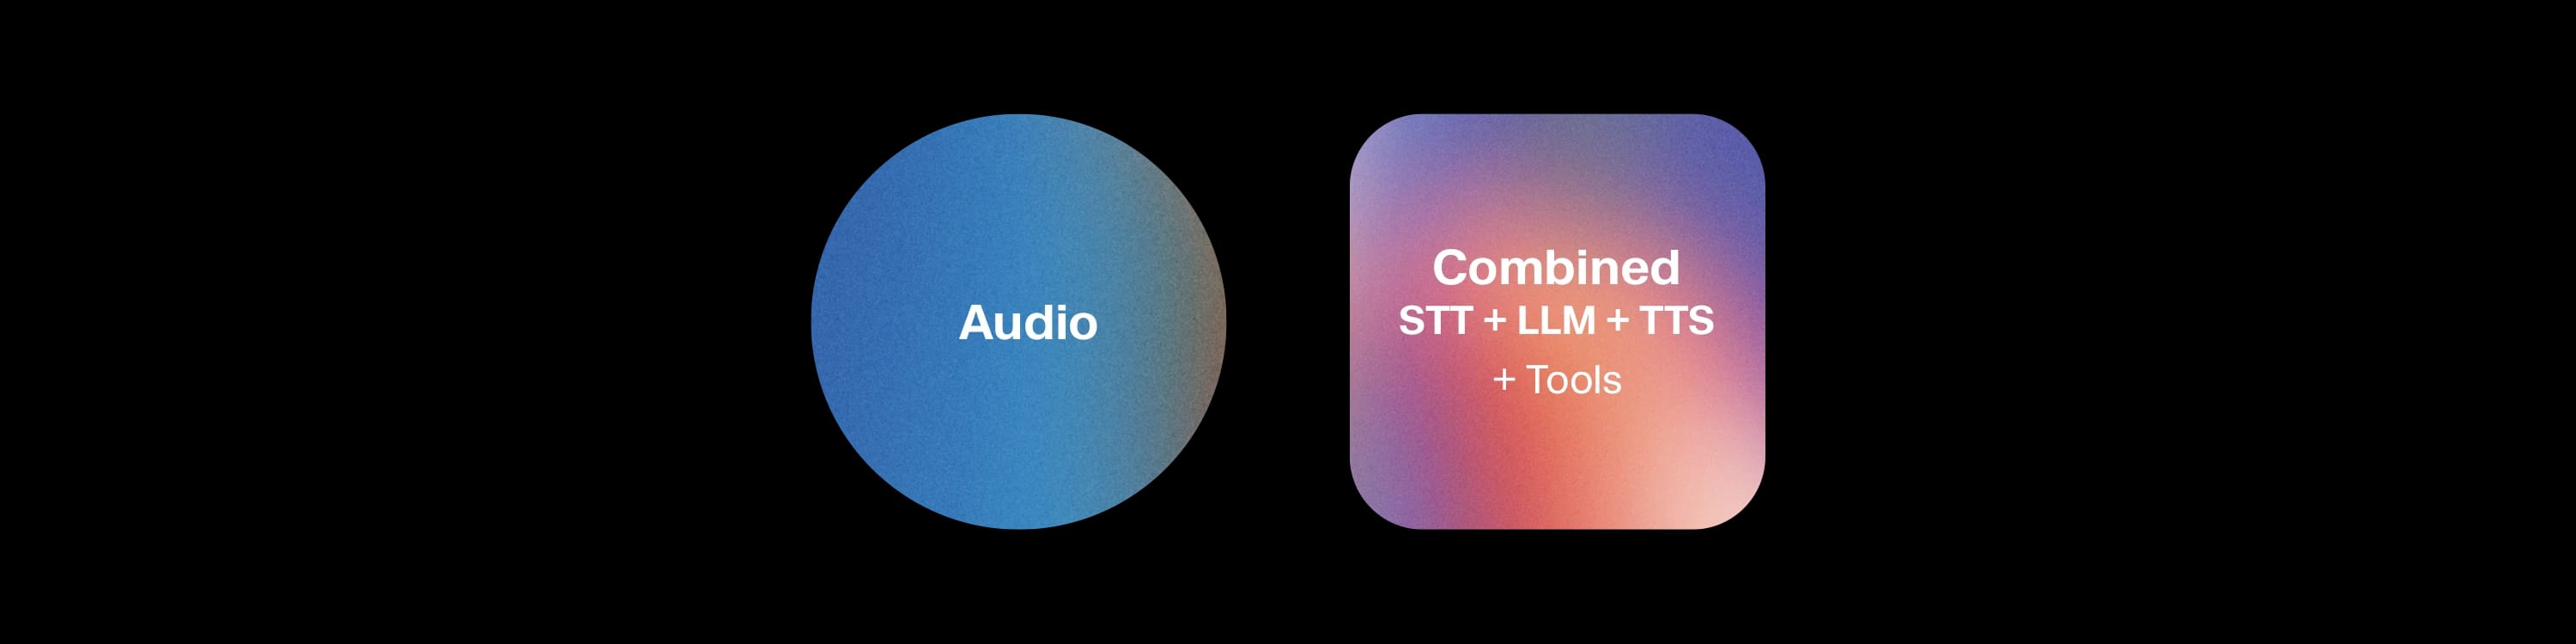
入力と出力を同時に処理し、モデルは聞きながら同時に話します。これにより、本物の発話の重なりや滑らかなターン遷移を伴う短いやり取りが、際立って自然に感じられます。
これは制御が最も難しいアーキテクチャでもあり、ガードレールの適用は非常に困難で、クロストークにより予測不能なエラーが生じます。検査、ログ記録、デバッグは極めて困難で、システムは大部分がクローズドです。コンポーネントの入れ替え、ドメインチューニング、カスタマイズの選択肢も最小限にとどまります。同時処理では複雑なロジックに割ける能力が少なくなるため、推論とツール利用は逐次融合型モデルよりさらに制約されます。また、短いやり取りを自然に聞かせる同じ同時処理が、長い会話を不安定にします。
ユースケースの例:
- 予測不能な動作を許容できる、実験的なコンパニオンアプリ、ソーシャル音声プラットフォーム、研究デモ。
ユースケースに適したアーキテクチャの選び方
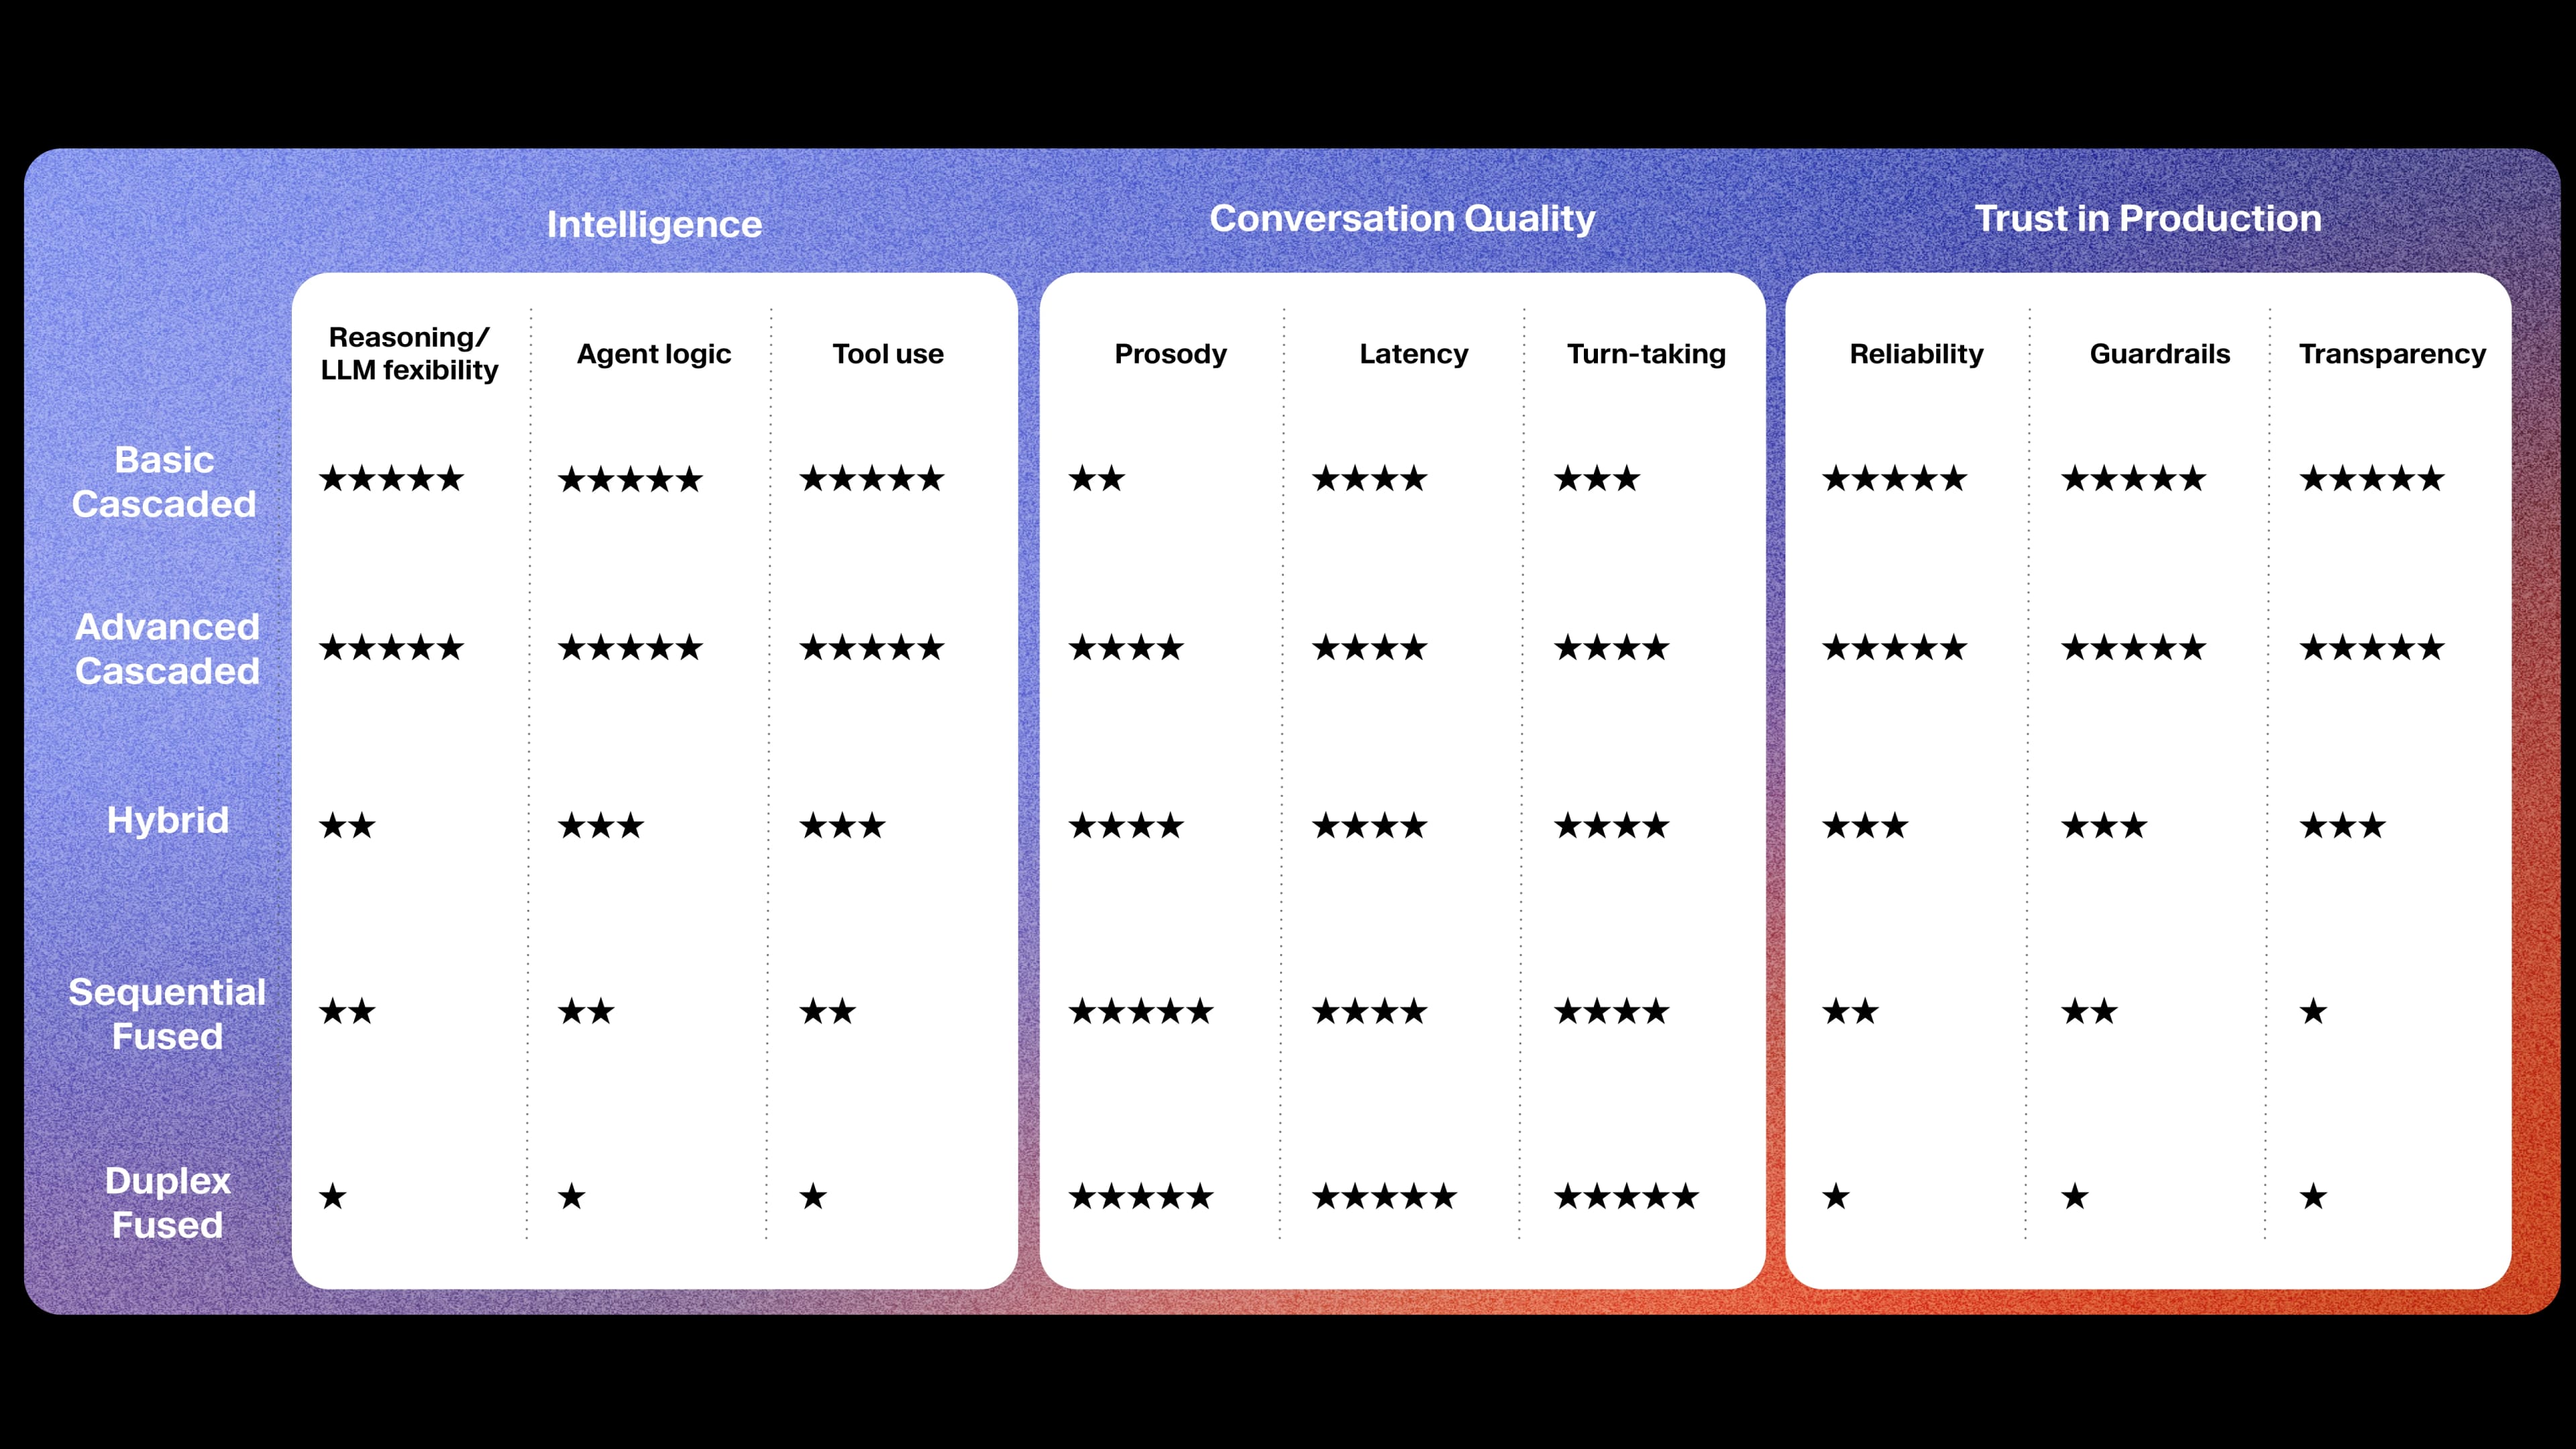
適切なアーキテクチャは、アプリケーションに何が求められるかによって決まります。自然に聞こえる音声を主要な機能とする体験を構築する場合、フロンティアレベルの推論、ガードレール、透明性を妥協できるなら、融合型アーキテクチャには確かな強みがあります。融合モデルはプロソディで先行していますが、高度なカスケード型システムは四半期ごとに近づいています。一方、融合モデルはアーキテクチャ上の制約により、複雑な推論や信頼性において大きな進歩を遂げていません。
大半の企業や政府機関にとって最適なアーキテクチャは、優れた音質を備え、高性能で、カスタマイズ可能かつ信頼でき、大規模導入の準備が整ったものです。だからこそ、ElevenAgentsを高度なカスケード型アーキテクチャで構築し、Expressive Modeと、最高クラスで共同最適化されたスピーチtoテキストおよびテキスト読み上げモデルに投資しています。これによりチームは、エージェントを構築し、高い知能、信頼性、制御性と、自然で人間らしい音声を両立できます。
AIエージェントがカスタマーサポート、教育、パーソナルアシスタントなどへ広がり続ける中、成功するエージェントはそれぞれの用途に合わせたアーキテクチャの上に構築されるでしょう。