テキスト読み上げとスピーチtoテキストの違いとは?
- 公開日
- 最終更新日
こんな場面を想像してみてください。通勤中に車を運転していると、スマートフォンが未読メールをテキスト読み上げソフトウェア(TTS)で読み上げてくれます。さらに、スマートフォンに触れたり道路から目を離したりせずに返信を送れるのも、スピーチtoテキスト(STT)ソフトウェアのおかげです。
これらのテクノロジーは、単なる楽しい未来的な概念ではありません。日常生活に急速に浸透し、日々の作業を簡単にしながらアクセシビリティを高めています。
AIを活用したTTSとSTTの世界を見ていきましょう。基本的な仕組みや違い、プロバイダー選びのポイント、そしてさまざまな業界での活用方法を紹介します。
TTSと音声からテキストの違い
TTSと音声からテキストのテクノロジーには、いくつかの重要な違いがあります。主な違いは以下のとおりです。
機能
テキスト読み上げ(TTS)は書かれたテキストを音声に変換し、スピーチtoテキスト(STT)はその逆で、話し言葉をテキストに書き起こします。TTSは文章を音声で利用できるようにし、視覚障害や学習障害のある人にとっての音声アシスタントとして機能します。一方のSTTは話し言葉を取り込み、文章の文字起こしに変換するため、ディクテーションや音声コマンドに役立ちます。
利用シーン
TTSは、音声出力を提供するために、電子書籍リーダー、館内放送システム、バーチャルアシスタントに広く組み込まれています。STTは、文字起こしサービス、音声操作アプリケーション、聴覚障害者向けのリアルタイム字幕で活用されています。TTSの利用シーンは主に出力中心で、情報を音声として届けることに重点があります。対してSTTは入力中心で、話し言葉の取り込みと処理に重点を置きます。
技術的アプローチ
TTSテクノロジーには、テキスト分析、言語処理、音声合成が含まれます。イントネーションやリズムを含む話し言葉のニュアンスを正確に伝える必要があります。STTには、さまざまなアクセント、方言、話し方を正確に文字起こしする高度な音声認識機能が必要で、多くの場合リアルタイムで処理されます。
TTS(テキスト読み上げ)とは?
TTS(テキスト読み上げ)は、書かれたテキストを音声に変換するテクノロジーです。その中核では、TTSによってコンピューターがテキストを読み上げ、あらゆる文章を合成音声に変換できます。このテクノロジーは、バーチャルアシスタントから読み書きに困難を抱える人のためのアクセシビリティツールまで、幅広いアプリケーションで活用されています。
高度なTTSテクノロジーの注目すべき例が、ElevenLabsのTTS機能です。ElevenLabsのTTSは、極めて自然で人間らしい音声を生成できる点で際立っています。人の声の音を模倣するだけでなく、自然な話し方を特徴づけるニュアンスや抑揚を理解・再現する高度なAIアルゴリズムによって実現しています。
この高いリアリティにより、ElevenLabsのTTSは、さまざまなメディア向けの魅力的なオーディオコンテンツの作成、音声フィードバックによるユーザーインターフェースの強化、視覚障害のあるユーザーへの利用しやすい読書手段の提供に最適です。
音声からテキスト(スピーチtoテキスト、STT)とは?
音声からテキストは、スピーチtoテキスト(STT)とも呼ばれ、話し言葉を文章に変換するプロセスです。この音声認識テクノロジーは、録音から文字起こしを作成したり、音声コマンドを有効にしたり、アクセシビリティのためのリアルタイム字幕を実現したりするうえで重要です。
ElevenLabsはSTTテクノロジーを大きく進化させました。Scribeモデルは、オーディオとビデオを99言語で効率的にテキストへ変換します。使いやすいインターフェースを備え、オーディオやビデオファイルから会議、講義、インタビューを文章として記録するのに最適です。
TTSの仕組み
テキスト読み上げ(TTS)テクノロジーは、複数の複雑なステップを経て、書かれたテキストを聞き取れる音声へ変換します。
まず、TTSシステムがテキストを分析し、音素に分割します。音素は、あらゆる言語における最小の音の単位です。この分割は、システムがさまざまな単語を正確に発音するうえで不可欠です。
音素への分割後、システムはこれらの音をデジタル音声に変換します。ここでは人工知能(AI)が重要な役割を担います。膨大な話し言葉のデータセットで学習したAIアルゴリズムにより、人間らしい声の調子やリズムを再現する音声を生成できます。生成された音声は識別済みの音素と対応付けられ、自然に聞こえる出力が完成します。
AIと機械学習の進歩により、現代のTTSテクノロジーは大きく進化しました。現在では、文脈上のニュアンスを理解し、複数の言語に対応し、ある程度は感情的な抑揚も再現できます。こうした改善により音声出力は大幅に人間らしくなり、デジタルデバイスとのやり取りがより自然で魅力的なものになっています。
おすすめのTTSプロバイダーは?
The best TTS software solutions are ElevenLabs, Murf, and PlayHT. Here’s a brief rundown of their main features, pros, cons, and rating out of 5.
スピーチtoテキストの仕組み
スピーチtoテキスト(STT)テクノロジーは、複雑な複数ステップのプロセスを通じて、話し言葉を文章に変換します。
まず、通常はマイクで話し言葉を収録します。このオーディオ入力は、システムが処理できるデジタル形式に変換されます。STTの中核は、このデジタルオーディオを分析する機能です。高度なアルゴリズムを使い、音声を認識可能な小さなセグメントに分解します。
これらのセグメントは、発話における最小の音の単位である音素です。STTシステムは、あらかじめ定義された言語モデルとこれらの音素を照合して、単語やフレーズを特定します。このステップは、異なるアクセント、方言、話し方の違いを理解するために重要です。
次に、システムは自然言語処理(NLP)技術を適用します。NLPは話し言葉の文脈や構文の理解を助け、より正確な文字起こしを可能にします。また、複雑な文構造や業界特有の専門用語にも対応できます。
高度なSTTシステムでは、データ量や利用が増えるほど改善する機械学習とディープラーニングのアルゴリズムを活用します。これらのテクノロジーにより、システムは新しい話し方、アクセント、さらには言語も時間とともに学習でき、精度と効率を高めます。
つまり、STTテクノロジーは、機械学習を基盤として、音声収録、音素分析、言語モデリング、NLPを組み合わせ、音声を効果的にテキストへ変換します。
おすすめのスピーチtoテキストプロバイダーは?
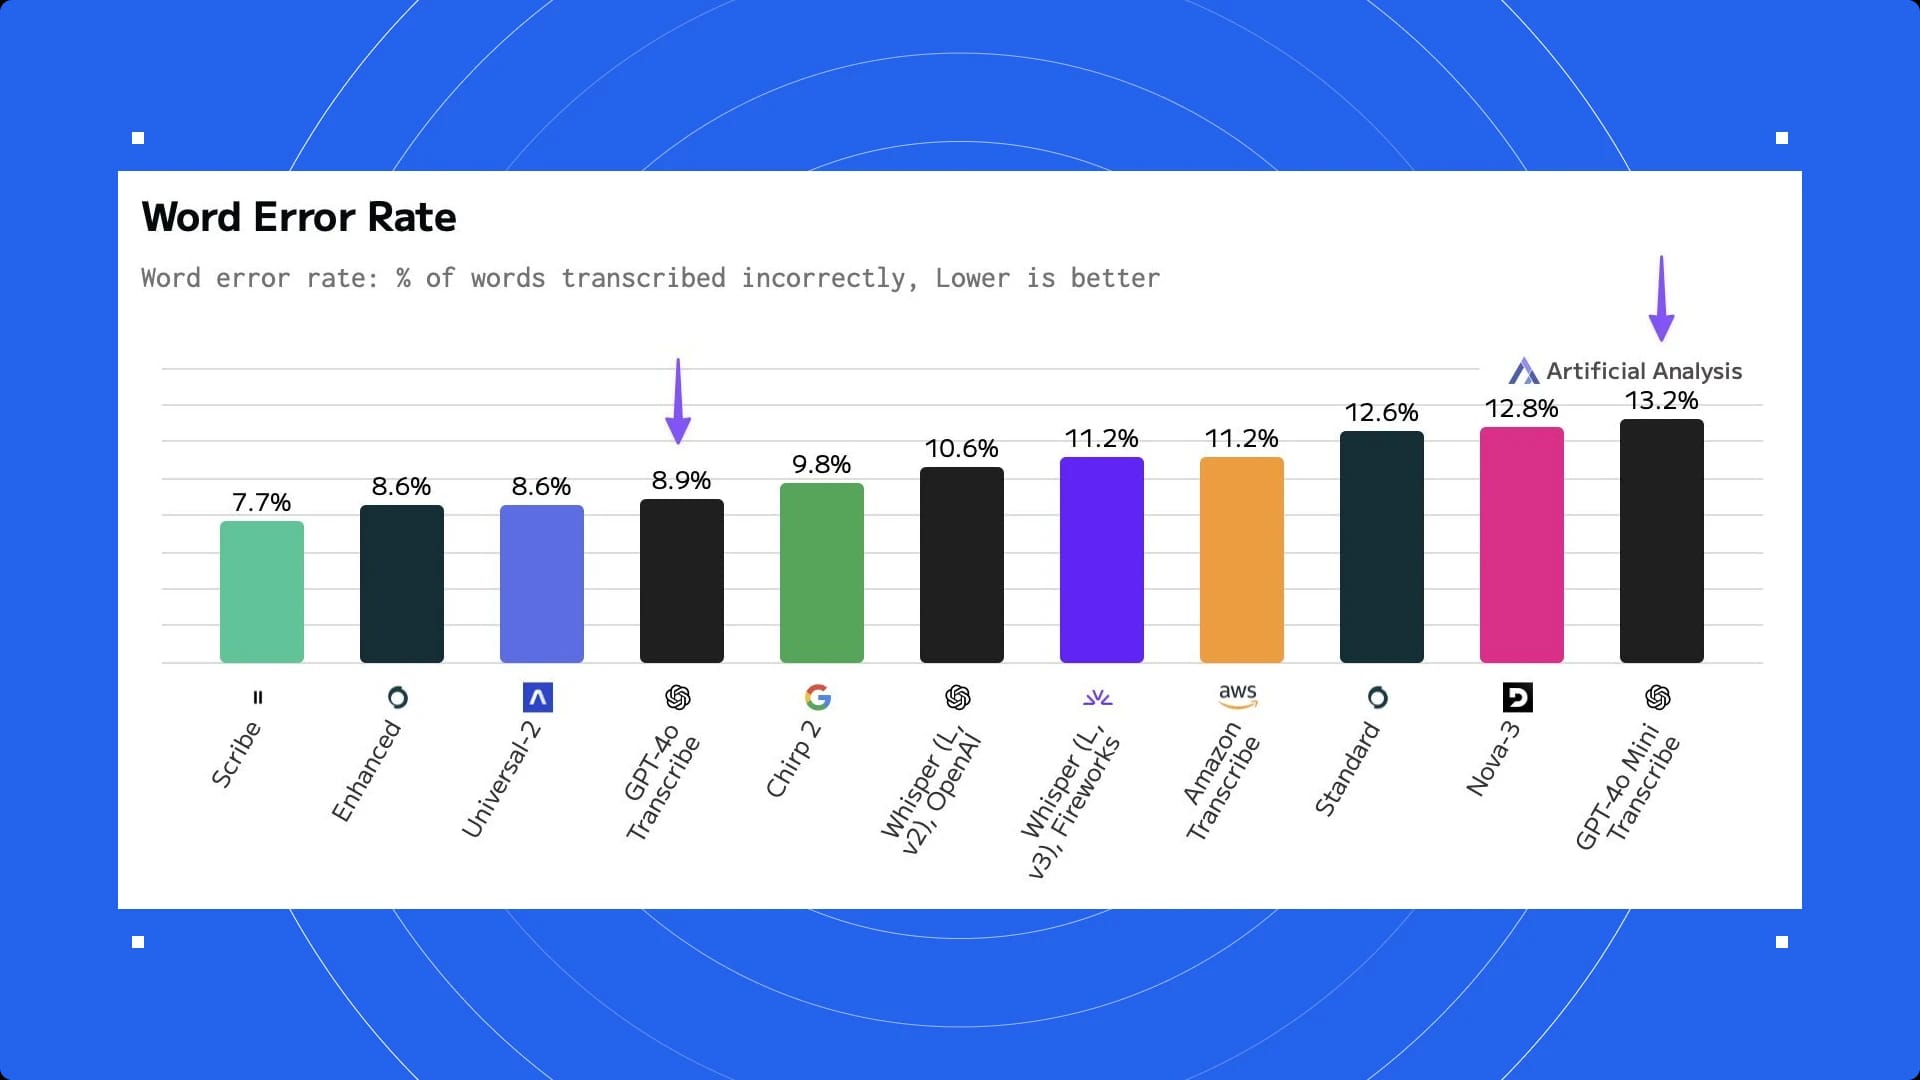
最高のスピーチtoテキストプロバイダーはElevenLabsのScribeで、これに続くのはOpenAIやGoogleなどのプロバイダーです。
TTSとSTT:精度と課題
TTSとスピーチtoテキストのテクノロジーは、人間のような精度を目指しています。精度は継続的に向上していますが、完璧というわけではありません。ここでは、両テクノロジーに期待できる精度と課題を紹介します。
TTS(テキスト読み上げ)の精度と課題
AI音声TTSテクノロジーは大きく進化しましたが、課題も残っています。最大の課題は、自然に聞こえる人間の声を実現することです。現代のTTSシステムは明瞭で理解しやすいオーディオ出力を生成できますが、人間らしい抑揚や感情を加えることは依然として難題です。また、TTSは文脈の解釈にも苦労し、文脈によって単語を誤って発音する場合があります。異なるアクセントや話し方など、多様なニーズに合わせて音声をカスタマイズすることも、グローバルなアクセシビリティに不可欠な課題です。
音声からテキスト/スピーチtoテキスト(STT)の精度と課題
STTテクノロジーは、特にディープラーニングの登場によって精度を高めてきました。しかし、バックグラウンドノイズが音声認識を妨げる可能性がある騒がしい環境では困難に直面します。多様なアクセントや方言を正確に取り込み、文字起こしすることも大きな課題です。さらに、STTシステムは同音異義語(音は同じでも意味が異なる単語)や複雑な構文、スラングの理解に苦労することが多く、実際のアプリケーションにおける全体的な有効性に影響します。
さまざまな業界での活用
TTSとスピーチtoテキストのテクノロジーは、多様な業界で革新的な用途を見出し、情報との関わり方を変えながらアクセシビリティを高めています。
業界におけるTTSの活用
TTSテクノロジーはさまざまな分野で活用されています。教育では、読み書きに困難を抱える学生や視覚障害のある学生のために、利用しやすい学習教材の作成を支援します。たとえば、教科書をオーディオブックに変換できます。
自動車業界では、TTSがナビゲーションシステムの音声応答を支えています。カスタマーサービス分野では、コールセンターの自動応答にTTSを活用し、効率を高めています。また、ゲームやバーチャルアシスタントをはじめとするエンターテインメント業界でも、インタラクティブなユーザー体験の提供にTTSは欠かせません。
業界におけるSTTの活用
STTテクノロジーは、複数の業界で幅広く活用されています。医療では、医師と患者の会話の文字起こしや臨床文書のディクテーションを支援し、効率を向上させます。法務分野では、法廷での審理や法的文書の文字起こしに使われます。また、メディアでは、聴覚障害者向けの放送のリアルタイム字幕を支援する重要な役割を果たします。企業では、STTが効率的な会議の文字起こしを可能にし、記録管理と情報へのアクセス性を高めます。
まとめ
テキスト読み上げ(TTS)とスピーチtoテキスト(STT)は、一見似ているようでも、異なる機能を担います。TTSは書かれたテキストを音声に変換し、人間らしい声で文章に命を吹き込みます。対してSTTはその逆で、話し言葉を文章に変換し、話し言葉のニュアンスをテキスト形式で捉えます。
どちらも高度なAIを活用していますが、対応するニーズは異なります。TTSは書かれた内容を音声で利用するため、STTは話し言葉の記録を作成するために使われます。
始める準備はできましたか?Eleven v3をお試しください。これまでで最も表現力豊かなテキスト読み上げモデルです。
最先端のTTSテクノロジーを体験したい方は、ElevenLabsに登録してください。きっとご満足いただけます。