
ElevenAgentのオーケストレーションエンジンを徹底解説
- 公開日
- 最終更新日
聴くこの記事を聴く
ElevenAgentsは、リアルタイム会話向けに設計された低レイテンシーのオーケストレーションエンジンで動作し、オーバーヘッドは100ms未満です。このアーキテクチャは、ElevenLabsの研究成果に加え、OpenAI、Google、Anthropicなどの主要プロバイダーによる最先端LLMと、ElevenLabsがホストする厳選されたオープンソースモデルを組み合わせています。回答パイプラインのさまざまな段階で複数のモデルを使用することで、エージェントは高い応答性と文脈理解を両立します。各モデルの強みを動的に組み合わせ、インテリジェンス、速度、コストのバランスを最適化しながら、幅広いエンタープライズタスクや会話シナリオで信頼性と拡張性に優れたパフォーマンスを実現します。
この記事では、複雑な環境でエージェントが動作するために必要な中核機能を、これらのモデルがどのように連携して実現するのかを説明します。より具体的には、どのモデルがいつ、どのトークンを見るのかを解説します。その中心となるのが、インタラクションの各時点における会話履歴の管理です。会話履歴がどのように、どこで共有されるのかをあらためて確認し、独立型とマルチエージェントワークフローの両方で、オーケストレーションにおけるその役割を明らかにします。
独立型エージェント
まず、独立型エージェントとその中核コンポーネントを見ていきます。最小限の価値を備えたエージェントには、システムプロンプト、複数のツールへのアクセス、そしてナレッジベースがあればよいと考えられます。ユースケースで厳密な手順の検証があまり必要でない場合や、エージェント内のナレッジサイロを避けることが重要な場合は、ワークフローより独立型エージェントが適しています。ナレッジサイロは、特定のツール、ドキュメント、履歴コンテキストに、一部のサブエージェントはアクセスできても他のサブエージェントはアクセスできない場合に生じます。これはマルチエージェントワークフローに固有のものであり、柔軟性と決定性のトレードオフをもたらします。
ElevenLabsの独立型エージェントでは、次の仕組みを理解することが重要です。
- 効果的な生成リクエストを構築する
- 関連ドキュメントを取得して組み込む
- エージェントの応答に必要なツール呼び出しを生成・実行する
- 評価とデータ収集のために結果を出力する
会話コンテキストの構築
顧客とElevenLabsエージェントの会話は、一連のターンで構成され、各ターンでは両者のメッセージがやり取りされます。エージェントとユーザーのメッセージが交互に並ぶこのリストが、会話コンテキストを構築する出発点となります。各ターンで基盤となるLLMは、前のターンより1メッセージ多い、エージェントとユーザーのメッセージが交互に並んだ生成リクエストを受け取ります。もちろん、このメッセージ列の先頭には、エージェントのシステムプロンプトを表す1つのシステムメッセージが付加されます。
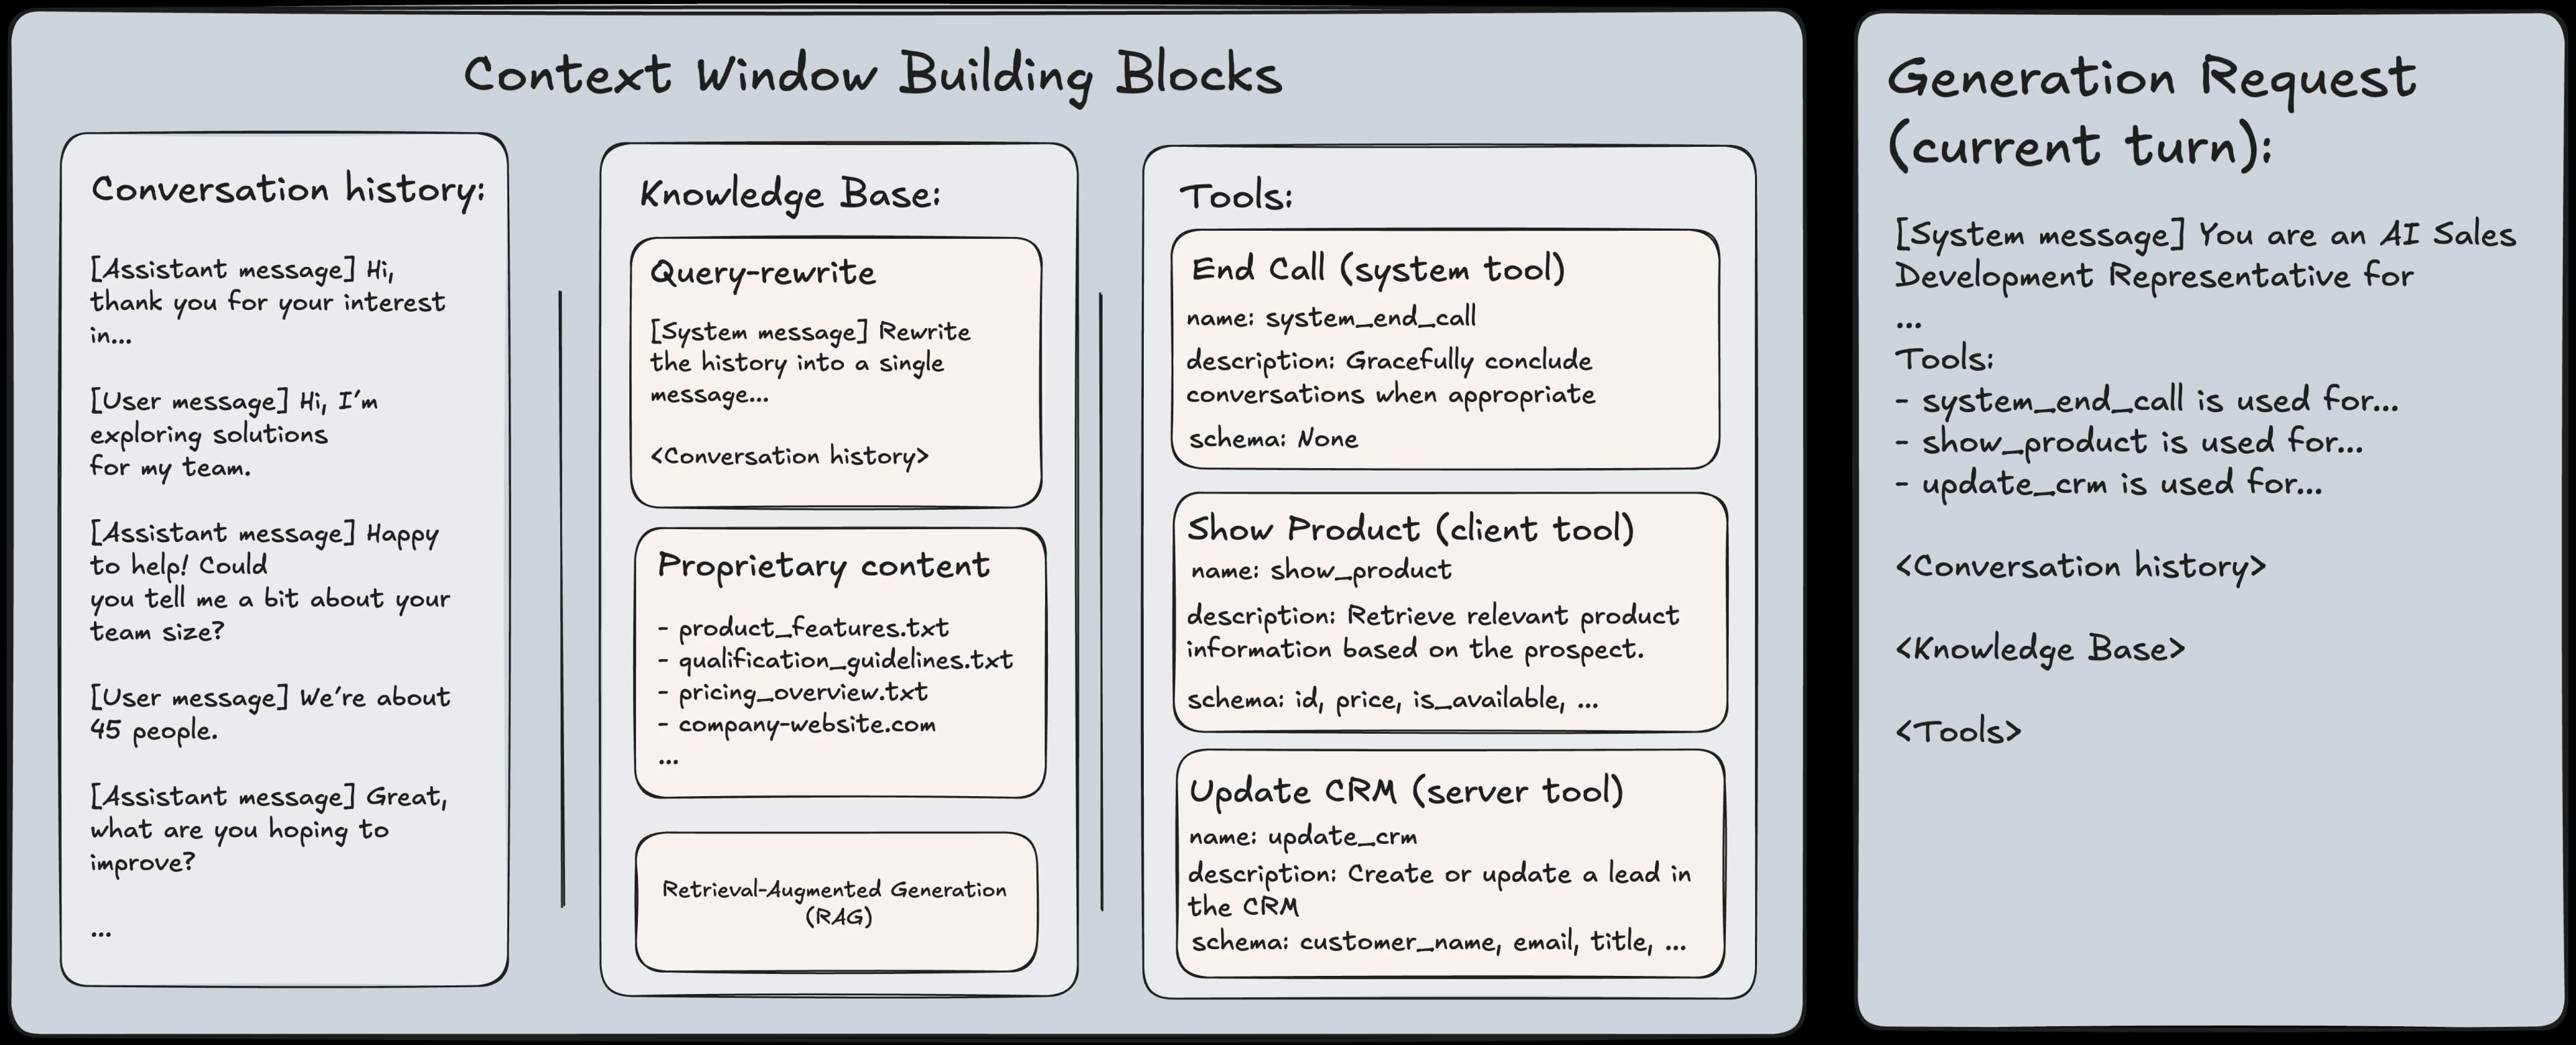
ElevenLabsのオーケストレーターは、ユーザーが話し終えたタイミングを予測することで、体感上のLLMレイテンシーを削減します。そのため、1つのターン内で同じ会話コンテキストを含む複数のLLM生成リクエストが発生する場合があります。 オーケストレーションはエージェントの応答速度を最適化しますが、応答品質はナレッジへのアクセス方法にも同じくらい大きく左右されます。 利用が進むにつれ、顧客は通常、独自ドキュメントと公開コンテンツを組み合わせてエージェントの応答をグラウンディングするようになります。これを実現する標準的なアプローチとして、検索拡張生成(RAG)が長年利用されてきました。ElevenAgentsナレッジベースは、RAGを基盤とし、以前の記事で詳しく説明した最適化済みのマルチモデルアーキテクチャを採用しています。これにより、最新のユーザー入力がフォローアップや説明への了承である場合、または明示的な質問を含まない場合でも、信頼性の高いドキュメント取得が可能になります。
ただし、取得はエージェントが外部システムとやり取りする方法の一つにすぎません。
ツールを使ったアクション実行と情報取得
ElevenLabsエージェントは、柔軟なツールシステムを通じて、会話中に現実世界のアクションを実行し、ライブ情報を取得できます。この機能には重要な設計上の考慮点があります。有効化されたツールごとに、その名前、説明、パラメータスキーマがシステムプロンプトおよび会話履歴とともに含まれるため、シリアライズされたプロンプトのサイズが増加します。 ツールが増えるほど、正しい順序でツールを呼び出すためにモデルへ課される推論負荷も大きくなります。Agent Builderでは、ツールの説明に、ツールの機能と返されるフィールドを記載します。言語モデルはこの情報を用いて、ツールの利用に関するコンテキストを理解します。定義後、ツールを呼び出す具体的な条件はエージェントのシステムプロンプトに記述します。例:
- ツールの説明:lookup_order:「注文IDから顧客の注文詳細を取得します。注文ステータス、購入商品、配送先住所、追跡番号を返します。」
- システムプロンプトの指示:「顧客の本人確認後、】【lookup_orderツールを呼び出して注文詳細を取得してください。」
この関心の分離により、ツール定義は複数のエージェントで再利用可能なまま、各エージェントのシステムプロンプトでツールを呼び出す正確なタイミングを制御できます。顧客がこれらのシステムプロンプトを効果的に設計できるよう、プロンプトガイドでより詳しいガイダンスを提供しています。このフレームワークでは、主に次の種類のツールを定義できます。
- 外部APIを呼び出すWebhookツール。
- 会話のWebSocketを通じてイベントとしてツールリクエストを送信するクライアントツール。
- 通話転送などの組み込みアクション用システムツール。
- Model Context Protocolサーバーに接続するMCPツール。
エージェントがツールの使用を決定すると、会話から必要な詳細を取得し、実行リクエストを送信します。ツールが結果を返すと、その結果は会話に追加され、モデルは次の応答で自然に参照できます。必要に応じて、ツールの出力はエージェントに保存された情報を動的変数として更新することもできます。この保存情報は、事前定義済みのマッピングを使用してツールの応答から抽出された、シンプルなキーと値のペアとして保持されます。設定後、これらの変数はシステムプロンプト、今後のツールパラメータ、ワークフロー条件を通じてエージェントにフィードバックできます。このフィードバックループにより、エージェントは対話に応じて進化するワーキングメモリを持つことができます。
ここまでツールがエージェントの推論に統合される仕組みを説明しましたが、実行タイミングも設定できます。ツールは会話上のニーズに応じた3つの実行モードのいずれかで実行できます。Immediate Modeでは、LLMがリクエストするとすぐにツールが実行されます。注文ステータスの確認など、ユーザーがほぼ即時の応答を期待する高速な検索のデフォルト設定です。ツール実行前の発話と組み合わせると、エージェントはまず「確認します」のような短い応答を生成してユーザーに返し、ツールを並行して実行することで無音時間を最小限に抑えます。低速なツールでは、プラットフォームが予想される待機時間に合わせてこうしたつなぎのメッセージを自動的に延長します。一方、Post-Tool Speech Modeでは、エージェントが話し終えるまで実行を遅らせます。これは、通話の転送、セッションの終了、支払いの送信など、現実世界に影響するアクションに不可欠です。ユーザーは「これから請求部門におつなぎします」といった完全な説明を聞き、アクションが実行される前に中断する機会を得られます。Async Modeでは、会話を止めずにツールを完全にバックグラウンドで実行します。メール送信、外部ワークフローのトリガー、データ記録など、エージェントが応答で結果を参照する必要のない、実行後の確認を要しない操作に最適です。
実行とオーケストレーションを整えたら、次はパフォーマンスの測定方法を理解します。
パフォーマンスの測定
Agentとの通話が完了すると、顧客は追加の分析や保存のために通話から特定の情報を抽出したり、通話が成功したかを判定したりする場合があります。ここでデータ収集と評価基準が役立ちます。データ収集では、後続の分析や集計のために、通話文字起こしから構造化情報を抽出できます。顧客はこうした出力を、レポート作成やデータ拡充ワークフローのためにエンタープライズデータレイクハウスへエクスポートすることがよくあります。たとえば、営業開発Agentは会話から見込み客の詳細を自動抽出し、顧客関係管理(CRM)システムでリードを作成または更新できます。一方、評価基準は通話が成功と見なされるかを判定します。設定された基準をすべて満たす場合は通話自体が成功としてマークされ、それ以外は失敗としてフラグが立てられます。これにより、迅速なフィードバックを提供しながら、会話が定義済みの品質・完全性基準を一貫して満たすことを保証します。通話終了後に通話後Webhookがトリガーされると、エージェントはツール実行とメタデータを含む確定済みの文字起こしを、設定済みのすべてのデータ収集ポイントおよび評価基準とともにLLMで処理します。モデルはこの組み合わせたプロンプトを使用して各評価基準が満たされているかを判定し、後続の分析用に指定されたデータポイントを抽出します。LLMはこれらの設定を入力プロンプトの一部として直接解釈するため、モデルが正確に理解・適用できるよう、明確かつ一貫してフォーマットすることが重要です。そのため、評価基準とデータ収集の説明を記述する際は、次のベストプラクティスを推奨します。
評価基準
- 基準ごとに明確な目標を一つ:一つの基準に複数の目標を含めるよりも、1文または短い箇条書きのほうが適しています。
- 観測可能で文字起こしに基づくこと:文字起こし(発言内容、エージェントの行動、ユーザーの質問)から成功/失敗を判定できるように目標を記述します。LLMが持たない外部コンテキストを必要とする目標は避けてください。
- 成功/失敗/不明の結果を明示すること:LLMは、目標が満たされれば成功、満たされなければ失敗、文字起こしから判定できなければ不明とマークするというコンテキストをすでに持っています。そのため、「満たした」と「満たしていない」が明確に定義されるように目標を記述してください。曖昧な場合、モデルは不明または誤った分類に傾く可能性があります。
- 簡潔に保つこと:複数の評価基準がまとめて送信される場合があります。そのため、長い評価基準はノイズを増やし、ハルシネーションを引き起こす可能性があります。
- 言語も重要:評価基準が満たされたかどうかについてLLMが提供する根拠は、基準の説明と同じ言語で出力されます。この点を考慮することが重要です。
データ収集
- 抽出対象を正確に記述すること:説明はLLMにとって最も重要なシグナルです。フィールドの意味、設定すべき状況、不明な場合の対応を記述します(例:「顧客が希望日を一度も述べなかった場合はnullのままにする」)。
- 想定する型に合わせること:LLMが提供する値は、データ収集ポイントに割り当てられたデータ型(boolean、string、integerなど)に常に一致します。そのため、説明も型に合わせる必要があります。たとえばintegerには「リクエストされた商品の数を抽出」、booleanには「顧客がオファーに同意したかどうかをYes/Noで示す」のように記述できます。
- 可能な場合はenumを使用すること:string型では、値の集合が固定されている場合にスキーマでenumを使用します。これによりモデルの出力が制約され、無効な出力を減らせます。
- 項目ごとに抽出対象を一つにすること:無関係な複数の事実を1項目の説明に詰め込まず、それぞれを別の項目に分けてください。各呼び出しに、単一で明確な抽出対象を持たせます。
- 説明は短く保つこと:説明は数文で十分であり、長い段落は必要ありません。文字起こしはすでにユーザーメッセージ内にあるため、スキーマと短い説明で十分です。
現在、この評価・抽出ステップに使用されるLLMは、迅速な処理を確保するため低レイテンシーモデルに固定されています。近い将来、顧客により高い柔軟性を提供する選択肢を導入する予定です。
次に、構造化されたオーケストレーション、決定性、または複数の会話ロールにまたがる専門性が必要なユースケースに目を向けます。このような場合、顧客は代わりにWorkflowsを使用できます。
ワークフロー
ワークフローは、複雑な会話フローを設計するためのビジュアルインターフェースを提供します。最終的には、独立型エージェントの識別子のもとで複数のサブエージェント、ツール、転送を管理するために、オーケストレーターが使用する論理オブジェクトを生成します。Workflowsでは、独立型エージェントですでに説明した要素に加えて、次の点も考慮する必要があります。
- システムプロンプトとサブエージェントの会話目標がどのように連携するか。
- グラフ内のさまざまな遷移ポイントをどのようにたどるかが決まる仕組み。
専門化された会話目標
Workflowsは、インタラクション全体で一貫した動作を実現するために、独立型エージェントの機能を再利用します。これには、ワークフローのどの部分がアクティブかに関係なく常に利用可能であるべき、基本システムプロンプト、コアツール、グローバルナレッジベースなどの共有要素が含まれます。包括的なシステムプロンプトは通常、グローバルな会話コンテキスト、期待されるトーン、安全上の制約、ブランド固有またはプロダクト全体に関わる指示を定義します。
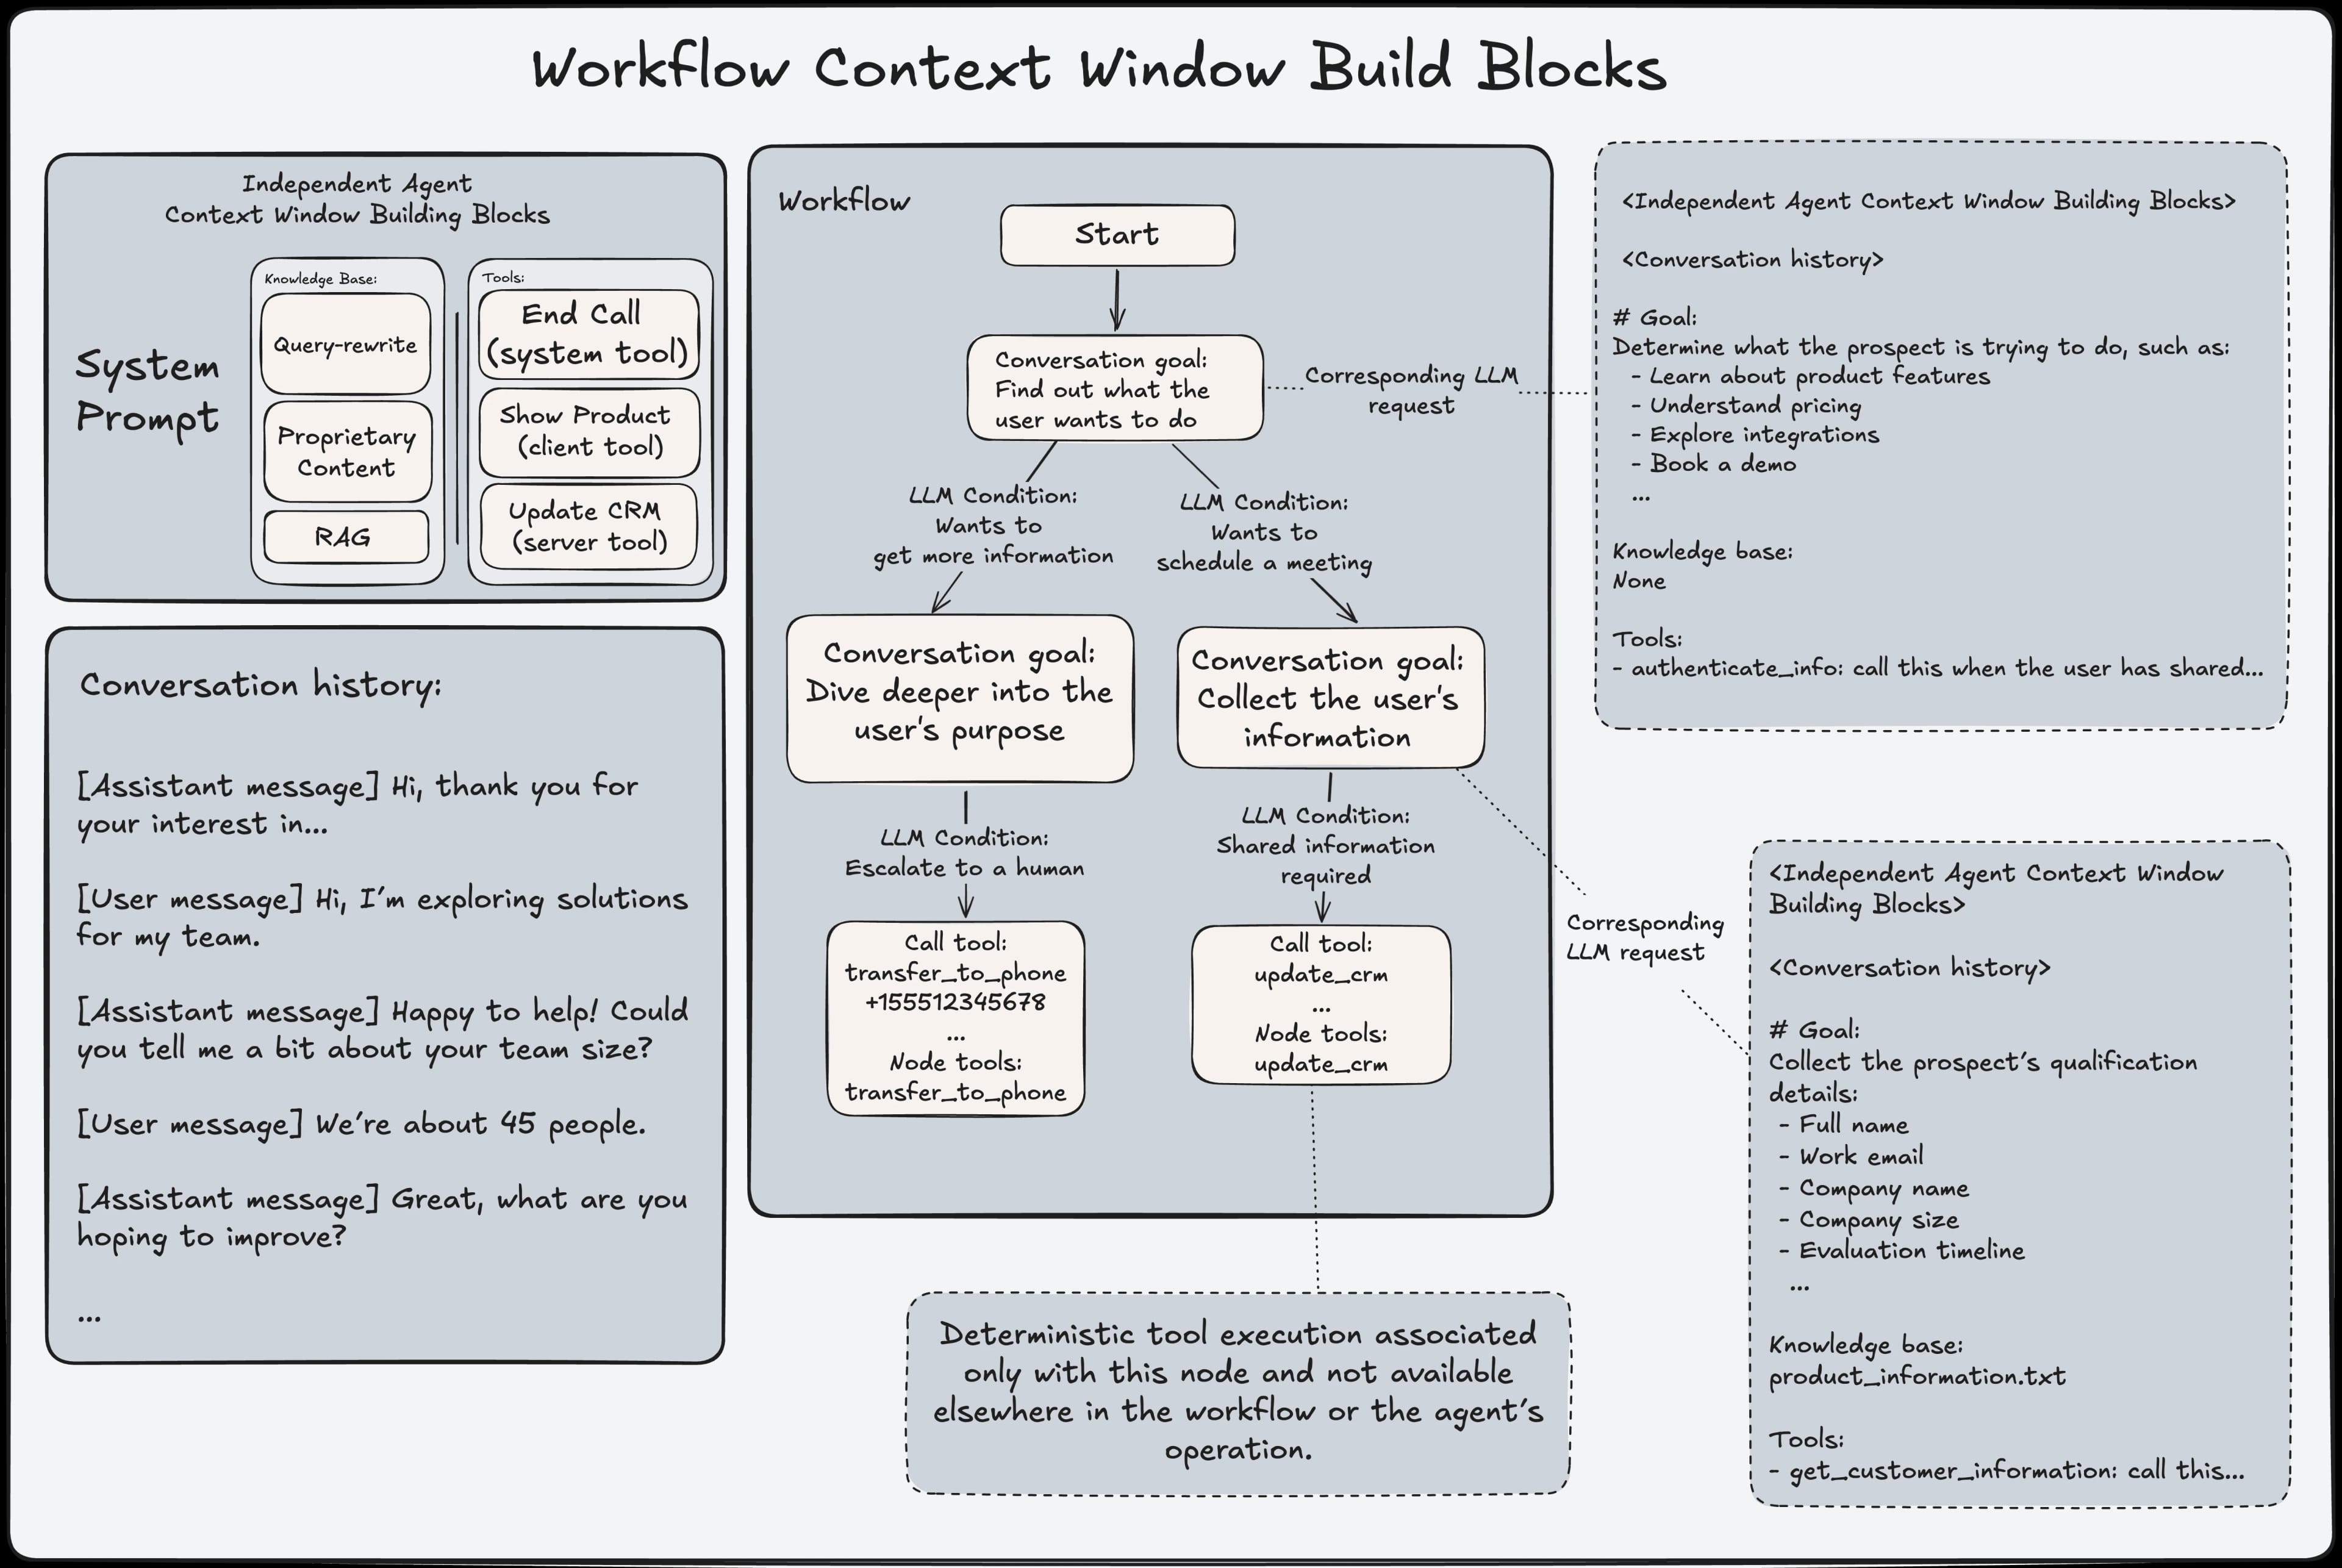
この共有基盤に加えて、Workflowsでは有向グラフ内で動作する専門化されたサブエージェントを導入します。各サブエージェントには範囲を絞った目標が割り当てられ、そのロールにのみ関連する追加のプロンプト指示、ツール、ナレッジソースで基本設定を拡張します。会話設定全体を再定義するのではなく、サブエージェントはプロンプトの構成と選択的なコンテキスト拡張により、基本エージェントにその意図を重ねます。継続性を維持するため、会話履歴はサブエージェント間の遷移をまたいで保持されますが、各サブエージェントは意図的に制限されたシステムビューで動作します。ナレッジベースとツールは選択的に公開され、責任範囲間の情報漏れを防ぐ明確なサイロを作ります。この分離を強化するため、オーケストレーターオブジェクトは遷移のたびに独立型エージェントであるかのように再構築されます。これにより、アクティブなサブエージェントのプロンプト状態、設定、利用可能な機能が完全に決定的に保たれます。この設計により、Workflowsはグローバルな一貫性を維持しつつローカルな専門化をサポートし、予測可能な動作、明確な関心の分離、そしてインタラクションの各段階でコンテキスト、ナレッジ、アクションを適用する方法の精密な制御を実現します。
この制御を可能にする重要なメカニズムの一つが、サブエージェント間の遷移を管理する方法です。
LLM条件によるワークフロー遷移の制御
Workflowsは、サブエージェントの有向グラフをたどって進行します。ノード間の遷移は明示的な条件によって制御されます。これらの条件は、あるサブエージェントから別のサブエージェントへ制御を移すタイミングを決定し、ワークフローがユーザー入力、ツールの結果、動的変数に応答できるようにします。グラフ条件は、決定的なものとLLMで評価されるものがあります。無条件遷移、動的変数の式に基づくチェック、ツール結果条件などの決定的条件は、制御フローに関する強い保証を提供し、ワークフロー内での厳密な進行を強制するのに適しています。対照的に、LLMベースの条件では、ユーザー意図の検出や特定の情報が提供されたことの認識など、自然言語による基準を意味的に評価できます。
重要なのは、LLM条件はアクティブなエージェントのシステムプロンプトの外部で評価され、エージェントの生成動作には影響しないことです。代わりに、オーケストレーターが現在の会話状態に対して並列に評価します。この分離により、遷移ロジックがエージェントのプロンプトを汚染したり、応答の生成方法に影響したりすることなく、ワークフローは柔軟なグラフ走査にLLMの推論を活用できます。決定的条件とLLM評価条件を組み合わせることで、ワークフローは予測可能性と適応性の両方を実現できます。正確性が重要な場合は決定的遷移を、意味的な解釈が必要な場合はLLMベースの遷移を使用します。
会話が新しいステージに進むと、システムはそのステップ専用に調整されたバージョンのエージェントをアクティブにします。各ステージは、焦点を絞った独自の指示と、その責任に関連するナレッジとツールへのアクセスのみで動作します。たとえば、返金処理ステージでは、オンボーディングやトリアージに関する無関係なコンテキストを引き継ぐことなく、返金ポリシーを参照できます。ステージ間の移動は、明示的な遷移条件によって管理されます。これらの条件は責任を移すタイミングを決定し、会話の進行に応じて自然なルーティング判断を可能にします。継続性を維持するため、各ステージは関連する会話コンテキストを継承しつつ、引き継ぎの仕組みを見せないため、ユーザー体験は遷移をまたいでもシームレスに保たれます。また、セーフガードが遷移を監視して非生産的なルーティングループを防ぎ、ワークフローが安定し、目標に沿った状態を維持します。
セーフティとセキュリティ
より高度なセーフティとセキュリティの制御が必要な場合は、オーケストレーターの追加機能を利用できます。
ガードレール
ElevenLabs Agentsは、ユーザーとエージェントのメッセージをリアルタイムで評価する、設定可能なモデレーションおよびアラインメントシステムを通じてセーフティガードレールを実装しています。受信コンテンツは、性的コンテンツ、暴力、嫌がらせ、ヘイト、自傷行為など複数のリスクカテゴリに分類され、各カテゴリのしきい値は個別に設定できます。ガードレールがトリガーされると、会話は即座に終了し、明確な失敗理由がクライアントに通知されます。これにより、プロンプトベースの緩和策だけに依存せず、安全でないやり取りを早期かつ一貫してブロックできます。ガードレールはエージェントのプロンプトロジックの外部で動作し、モデルの挙動やユーザー入力で回避できない信頼性の高い実行レイヤーを提供します。このアプローチにより、顧客は実行時の決定的な適用を維持しながら、自社ドメインに応じてセーフティの感度を調整できます。
コンプライアンスに準拠したデータ管理
話者がエージェントと共有する情報には、厳格な保存・処理要件が適用される機密情報が含まれる場合があります。たとえば、HIPAA準拠の取り扱いが必要な医療データなどです。こうしたユースケースに対応するため、AgentまたはWorkspaceレベルでゼロ保持モード(ZRM)を提供しています。有効にすると、すべての通話データはメモリ内でのみ処理され、永続ストレージに書き込まれることはありません。通話と処理が完了すると、ElevenLabsは情報を一切保持しません。その結果、文字起こし、音声録音、分析出力はAgents Dashboardでは利用できず、このポリシーは顧客向けシステムと内部ログの両方に適用されます。データは保持されませんが、通話中には処理されます。設定済みの通話後Webhookは出力を受け取るため、必要に応じて顧客自身のシステムに文字起こしや分析結果を保存できます。
ZRMが有効な場合、利用可能なLLMを、顧客データでのトレーニングや保持を禁止する契約上のコミットメントを持つプロバイダーに限定することで、サブプロセッサーもデータを保持しないようにします。現在、これにはGoogle GeminiとAnthropic Claudeのモデルが含まれます。ZRMで別のLLMを使用したい顧客は、そのプロバイダーと独自の契約を締結し、その契約の対象となるAPIキーを使用してカスタムLLMとして設定できます。これは標準の信頼境界を超えてデータ処理を拡張するため、有効化前にSafetyチームがユースケースを手動で審査・承認する必要があります。ZRMによりElevenLabsおよびそのサブプロセッサーは通話データを保持しませんが、顧客は、Agentが使用する外部ツールやWebhookが適用される保持要件および規制要件に準拠していることを確認する責任を負います。
今後に向けて
この記事では、ElevenLabs Agentsが会話コンテキスト、ツール、評価、構造化ワークフローを管理し、大規模でも信頼性の高いリアルタイム体験を提供する仕組みを見てきました。顧客がより複雑な環境にエージェントを導入するなか、設定可能な評価モデルやより充実した遷移制御から、ステージ間のプロンプト構成やトークン使用量をより深く可観測にする機能まで、オーケストレーションエンジンの柔軟性を継続的に拡張しています。
Forward Deployed Engineeringチームは、こうした機能が実際の導入環境と足並みをそろえて進化するよう、顧客と密接に連携しています。次世代のAgentsは、リアルタイム会話を可能にする低レイテンシー性能を損なうことなく、さらに高い透明性、決定性、適応性を提供します。


