ElevenLabsとTwilioで20分でボイスエージェントを構築する
- 公開日
- 最終更新日
音声エージェントは、着信電話に応答し、スピーチtoテキスト(STT)で発信者の音声をリアルタイムに文字起こしし、大規模言語モデル(LLM)で応答を生成して、テキスト読み上げ(TTS)モジュールで音声を返せます。ElevenLabsとTwilioを使えば、約20分で実際の電話番号で動作するエージェントを構築できます。
デベロッパー向けの構成は、音声合成(Flash v2.5)と文字起こし(Scribe v2 Realtime)にElevenLabs、電話機能にTwilio、LLMにOpenAIまたはAnthropicを使用します。ただし、これらはすべて入れ替え可能です。最も使い慣れたコンポーネントを選んで使用できます。
この記事では、Node.jsとTypeScriptを使って、20分で音声エージェントを構築する方法を紹介します。カスケードを自分で管理せず、ターンテイキング、中断処理、電話機能を扱えるマネージドな代替手段が必要な場合は、ElevenAgentsをご覧ください。
音声エージェントのアーキテクチャの仕組み
コードを書く前に、技術スタックを構成する3つのサービスがどのように接続するかを理解しておくと役立ちます。
- Twilio:電話とオーディオ転送を処理します。
- ElevenLabs:Scribe v2 RealtimeによるSTTと、Flash v2.5によるTTSを処理します。
- LLM:ツール呼び出しと応答の作成を処理します。
各段階は薄いアダプターで構成されているため、ほかの部分に手を加えずに別のサービスへ入れ替えられます。たとえば、ほかのコンポーネントを書き直すことなく、OpenAIのLLMをAnthropicに切り替えられます。
電話はTwilioを経由してサーバーに届きます。TwilioはPSTN通話に応答し、サーバーへのWebSocketを開き、発信者の音声をbase64エンコードされたmu-lawフレームのストリームとして転送します。サーバーはカスケードを実行し、同じWebSocket経由で合成音声をストリーミングして返し、Twilioが発信者に再生します。
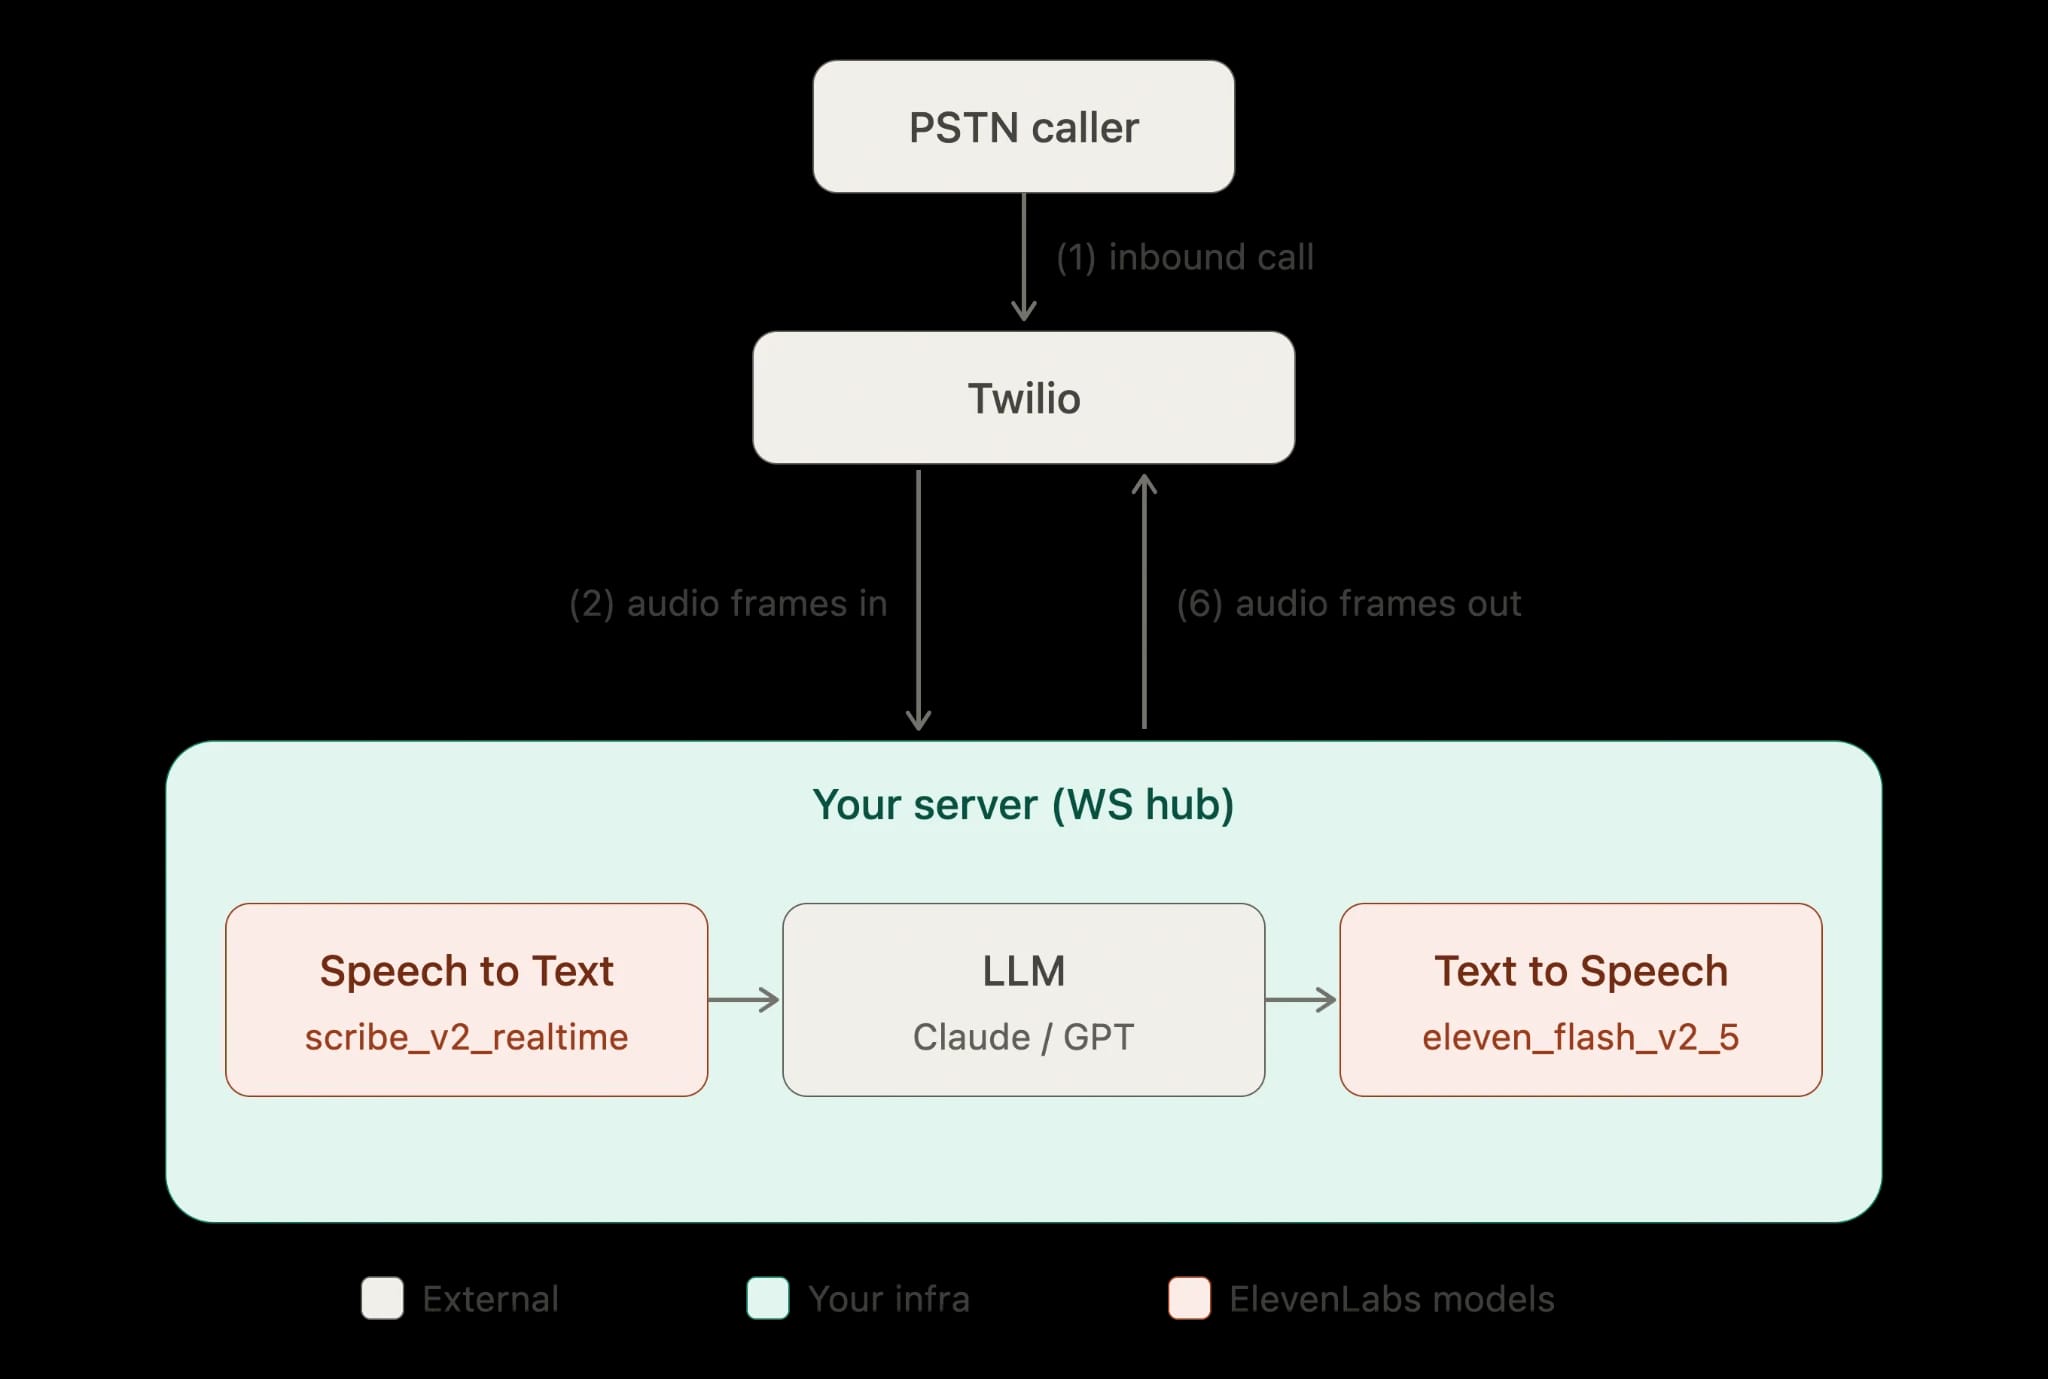
音声エージェントの構築で使用するフローは次のとおりです。
発信者がTwilio番号に電話をかけます。TwilioはWebhookからTwiMLドキュメントを取得します。TwiMLは、WebSocketエンドポイントへのMedia Streamを開くようTwilioに指示します。Twilioは、base64 mu-law(ulaw_8000)ペイロードを含むJSONイベントとして入力音声をストリーミングします。
サーバーはオーディオチャンクをScribe v2 Realtimeに転送してストリーミング文字起こしを行います。発信者のターンが確定したら、文字起こしをLLMに送信し、Flash v2.5でulaw_8000形式の応答を合成します。合成したmu-lawフレームをbase64エンコードしてWebSocket経由でTwilioに返すと、Twilioが発信者に再生します。
Scribe v2 Realtimeは約150msのレイテンシーで部分的な文字起こしを出力し、Flash v2.5のモデル推論はネットワークとアプリケーションのレイテンシーを除いて約75msです。最初の音声が出るまでの時間に最も大きく、予測しにくい影響を与えるのはLLMであり、レイテンシー予算の大半を占めます。間を短く保つため、LLM出力をトークンごとにストリーミングし、モデルが文を生成し終える前に合成を開始します。
こうした選択におけるモデルのトレードオフについては、モデル概要と、レイテンシーを理解するの記事をご覧ください。
音声エージェントの構築前に必要なもの
このガイドでは、4つの準備ができていることを前提としています。いずれもすぐに設定できますが、1つでも欠けるとサーバーを実行できません。
以下の前提条件を確認してください。
- Voice機能を備えたTwilio電話番号:Twilioコンソールで、番号とAccount SID、Auth Tokenを控えてください。
- ElevenLabs APIキー:ElevenLabsダッシュボードで作成します。キーはxi-api-keyヘッダーで送信される秘密情報なので、サーバー側だけで管理してください。API認証も参照してください。
- LLM APIキー:このチュートリアルではAnthropic ClaudeとOpenAIを交換可能なバックエンドとして扱うため、どちらかを選んでください。
- ローカル開発用のNgrok(または任意のトンネル):TwilioがパブリックなHTTPSおよびWSS URL経由でサーバーに到達できる必要があります。ngrokならデプロイせずに実現できます。
シークレットは環境変数として設定し、絶対にコミットしないでください。
次に、サーバーが使用するポートを指すトンネルを開始します。
Twilio Media Streamsプロトコルを理解する
Twilioが提供するのは生のオーディオソケットではありません。代わりに、すべてがWebSocket上の構造化JSONプロトコルにラップされています。4つのイベントタイプと送信形式を理解すれば、書き始める前からステップ2のWebSocketハンドラーを完全に理解できます。
TwilioがWebSocketに接続すると、4種類のイベントタイプを持つ一連のJSONテキストメッセージを送信します。
最初に届くconnectedイベントは、WebSocketが接続されたことを示します。startイベントはメディアストリーム開始時に一度だけ送信されます。音声を返すために保存が必要なstreamSidのほか、start.customParametersとstart.callSidに通話メタデータも含まれます。
mediaイベントは繰り返し発生します。media.payloadは8kHz mu-lawオーディオのbase64エンコード済みチャンクで、1フレームは20msです。media.trackのinboundは発信者の音声を表します。最後に、ストリーム終了時、通常は通話が切断された際にstopが送信されます。
音声を返すには、同じstreamSidとbase64 mu-lawペイロードを含むmediaタイプのメッセージを送信します。すでにキューに入れた音声を中断するには、streamSidを含むclearメッセージを送信します。これによりTwilioの送信バッファーがフラッシュされます。
入力と出力のエンコードは同一です(ulaw_8000)。ElevenLabsテキスト読み上げにulaw_8000をリクエストし、間でリサンプリングせずにバイト列をそのままTwilioへ転送します。
ステップ1:TwiML Webhookを提供する
通話が着信すると、TwilioはWebhookにHTTPリクエストを送信し、Media Streamに通話を接続するTwiMLを返します。<Connect><Stream>動詞は双方向WebSocketを開きます。ここでは<Start>ではなく<Connect>を使用してください。ストリームの間は通話を維持し、音声を返せるようにするためです。これがこの構成の目的です。
Webhookが返すTwiMLは次のとおりです。
Expressでは、ホストを埋め込んでドキュメントを返す単一のPOSTハンドラーになります。
Twilioコンソールで、番号の「A call comes in」Webhookをhttps://your-subdomain.ngrok.app/incoming-callに設定し、HTTP POSTを使用してください。
ステップ2:Media Stream WebSocketを受け付ける
WebSocketハンドラーはTwilioイベントを読み取り、カスケードを駆動し、音声を返します。
通話ごとに少量の状態を保持します。streamSid、STT接続、そしてエージェントが現在発話中かどうかを示すフラグです。ハンドラーは各入力メディアフレームをbase64からデコードし、生のmu-lawバイト列をSTTへ転送します。
ステップ3:Scribe v2 Realtimeで文字起こしする
Scribe v2 Realtimeはストリーミングオーディオチャンクを受け付け、部分的および確定済みの文字起こしを返します。mu-lawエンコードにも直接対応しているため、Twilioのフレームを変更せずに入力できます。
また、無音ベースのセグメンテーション用のVoice Activity Detectionと、セグメントを確定する手動コミット制御も提供します。電話エージェントでは、自然な間が発信者のターン終了を示す最も信頼できるシグナルとなるため、通常はVAD駆動のセグメンテーションが適しています。
手順は次のとおりです。通話開始時にSTTストリームを開きます。すべての入力mu-lawチャンクを送信します。確定した文字起こしに反応してLLMを呼び出します。
リアルタイムSTTクライアントのインターフェースは現在も進化中です。そのため、以下の形は固定されたフィールド名ではなく、ライブAPIに対して実装する小さなTypeScriptアダプター(openRealtimeStt)の背後に置いています。onFinalは、完了した発信者のターンを次の段階に渡すフックとして扱ってください。
リアルタイム認識の部分結果のレイテンシーは約150msで、発信者の発話終了からエージェントの応答開始までの体感的な間を短く保てます。バッチ版と全機能については、スピーチtoテキストのドキュメントおよびリアルタイムスピーチtoテキストのプロダクトページをご覧ください。
ステップ4:LLMで応答を生成する
この段階で応答を生成します。LLMは会話履歴を受け取り、アシスタントのテキストを返します。最初の文から合成を開始できるよう、応答をストリーミングしてください。
ここではOpenAIをバックエンドとして使用します。
上記のモデルIDであるgpt-4.1-miniは低レイテンシーの選択肢の一例です。Anthropic側ではclaude-haiku-4-5が同程度の選択肢となります。どちらのプロバイダーも同じllmReply契約に対応できます。関数本体を入れ替えるだけで、エージェントのほかの部分は変わりません。
システムプロンプトで応答の長さを制限しています。電話では長い応答は遅く感じられ、自然に中断するのも難しいため重要です。
ステップ5:ulaw_8000でFlash TTSを合成する
テキストをTwilioで再生できる音声に変換します。バイト列をTwilioの期待するエンコードに合わせるため、outputFormat: "ulaw_8000"を指定してFlash v2.5をリクエストします。次に音声をストリーミングし、各チャンクをmediaイベントとしてWebSocket経由で返します。
応答全体を待つのではなく、LLMトークンを文単位のフラグメントに蓄積し、各フラグメントが完成した時点で合成します。これにより、モデルが2文目を生成している間に発信者は1文目を聞けるため、最初の音声が出るまでの時間を短縮できます。インクリメンタル合成をより細かく制御するには、リアルタイムTTS WebSocketガイドで、1つの開いた合成ソケットにテキストを入力する方法を確認してください。以下のHTTPストリーミング方式はよりシンプルで、短い会話ターンには十分です。
本番環境向けにAI音声エージェントを強化する
上記の5ステップを完了すれば、動作するエージェントができあがります。しかし、これは本番デプロイと同じではありません。
実際の電話回線でエージェントを運用する前に、把握しておくべき点がいくつかあります。
Twilio Webhook署名を検証する
Webhook URLを知っている人なら誰でもそこへPOSTできるため、まずリクエストが実際にTwilioから来たことを確認する必要があります。TwilioはすべてのリクエストにAuth Tokenを使ってX-Twilio-Signatureヘッダーで署名します。検証に失敗したものは拒否してください。署名は完全なURLとPOSTパラメーターに対して計算されるため、Twilioと同じ方法で計算する必要があります。
Twilioのヘルパーがこれを処理します。
シークレットを適切に管理する
ELEVENLABS_API_KEY、LLMキー、TWILIO_AUTH_TOKENは、ソースコードやリポジトリにコミットされた平文のenvファイルではなく、シークレットマネージャーに保存してください。ElevenLabsキーは、このサービスに必要なエンドポイントだけにスコープを限定し、クレジット上限を設定してください。漏洩時の影響範囲を無制限ではなく限定できます。
エンタープライズプランでは、IP許可リストにより特定のIP範囲にキーをさらに制限できます。このサーバーでは、キーがバックエンドから外部へ出ないためAPIキーを直接使用します。音声処理の一部をブラウザーやモバイルクライアントに移す場合は、キーがクライアント側に公開されないよう、使い捨てトークンに切り替えてください。
同時実行数の上限を理解する
各プランにはモデルファミリーごとに異なる同時実行数の上限があり、同時に音声を生成しているリクエスト数がカウントされます。
電話エージェントでは、この仕組みは有利に働きます。音声生成は再生よりも速いため、各通話でTTSの同時実行数を消費するのは通話全体ではなく、応答を合成している短い時間だけです。大まかな目安として、同時実行数の上限が約5でも、生成は再生よりかなり早く完了するため、約100件の同時会話通話をサポートできます。
ただし、推測ではなく余裕を監視してください。ElevenLabsのレスポンスにはcurrent-concurrent-requestsおよびmaximum-concurrent-requestsヘッダーが含まれます。これらをログに記録し、上限に近づいたらアラートを出してください。上限を超えると、リクエストは優先度に応じてキューに入り、通常は約50msが追加されます。過負荷が継続するとHTTP 429が返されます。
HTTP 429レスポンスには短いバックオフで対応してください。継続する場合は、料金ページでアップグレードするか、エンタープライズのお客様はアカウントマネージャーを通じて上限を引き上げてください。
バージインと中断を処理する
エージェントが話している最中に発信者が話し始めた場合、発信者はエージェントが停止することを期待します。これはバージインと呼ばれ、適切に処理することが、台本どおりではなく自然なエージェントに感じさせる大きな要素です。
STTのVADシグナルを使って、エージェントの再生中に発信者の発話を検出します。検出したら、2つのことを行います。まず、speak内のagentSpeakingフラグがループを中断してすでに処理しているように、TTSチャンクの転送を停止します。次に、Twilio側ですでにキューに入れた音声をフラッシュするため、Twilioにclearメッセージを送信します。
clearを省略すると、送信を停止した後もTwilioはバッファー済みの音声を再生し続けるため、エージェントが発信者にかぶせて話しているように見えます。
ログ、監視、適切な失敗処理を行う
通話が遅く感じられたときにレイテンシーの原因を特定できるよう、各段階を計測してください。確定した文字起こしから最初のLLMトークンまで、最初のLLMトークンから最初のTTSバイトまで、最初のTTSバイトからTwilioにフレームが送信されるまでの時間を計測します。変動するレイテンシーの大部分はLLM段階にあり、STTとTTS段階は比較的安定していることがわかります。
次に、部分的な障害を想定して計画してください。LLMはタイムアウトする可能性があり、STTストリームは切断される可能性があります。また、ElevenLabsへのネットワーク往復時間は、地域に応じてパブリックインターネット上で約20〜200msの範囲で変動します。ElevenLabsはすでに北米、欧州、東南アジアの最寄りのクラスターへルーティングするため、サーバーはElevenLabsの近くだけでなく、発信者の近くにも配置してください。
段階のいずれかで失敗しても、発信者を無音のままにしないでください。短いフォールバック音声(「すみません、もう一度お話しいただけますか?」)を合成し、通話を維持します。1回のターンの失敗でWebSocket全体が切断されないよう、各段階をタイムアウトとtry/catchで囲んでください。
リリース前に、さらにいくつかのデフォルト設定を行うことをおすすめします。
- 前述のとおり、システムプロンプトで応答の長さを制限し、ターンを短く中断可能に保ちます。
- 長時間の通話でLLMコンテキストが無制限に増加しないよう、会話履歴に上限を設けます。
- 停止したセッションが同時実行数を消費し続けないための安全策として、通話時間の上限を設定します。
制御できる部分をさらに調整するには、レイテンシーのドキュメントで最初の音声が出るまでの時間の要因を確認し、モデル概要で速度と品質のトレードオフを確認してください。また、リアルタイムTTS WebSocketガイドでは、インクリメンタルなテキスト入力で合成レイテンシーをさらに下げる方法を紹介しています。
ElevenAPIで本番対応の音声エージェントを構築する
20分が経過した今、本番環境向けの音声エージェントを構成するすべてのレイヤーが揃っています。Twilioが電話機能を処理し、Scribe v2 Realtimeが文字起こしを行い、LLMが応答を生成し、Flash v2.5が同じWebSocket経由で音声を返します。
カスケードを自分で管理したくない場合、ElevenAgentsは、手作業で接続したのと同じモデルを基盤に、ターンテイキング、中断処理、電話機能のインテグレーションをマネージドサービスとして提供します。
自分で制御するスタックをさらに調整するには、ElevenAPIのプロダクトページでプラン、同時実行数の上限、ボイスライブラリをご覧ください。または、登録して、今日から最初の通話を始めましょう。



