Vibe Drawの開発:ElevenLabsとFLUX Kontextを組み合わせた音声による画像制作
- 公開日
- 最終更新日
音声インターフェースによって、AIとのコミュニケーション方法が変わりつつあります。声に出して説明するだけで画像を作れたらどうでしょうか?
このアイデアをもとに、週末のプロジェクトとしてVibe Drawを開発しました。ElevenLabsの音声AIとBlack Forest LabsのFLUX Kontextを組み合わせ、音声プロンプトを画像に変換する、音声を中心としたクリエイティブツールです。
FLUX Kontextは、新しいタイプの画像モデルです。従来のテキストから画像を生成するシステムとは異なり、Kontextは生成と編集の両方に対応しています。プロンプトから新しい画像を作成し、既存の画像を変更できるほか、複数の参照画像を1つの出力にまとめることもできます。
GPT-4oやGemini 2 Flashなどのモデルもマルチモーダル機能を備えていますが、FLUX Kontextは高品質なビジュアル編集に特化して設計されています。テストでは、変更内容を説明するだけで、装飾された文字の一部を変更したり、オブジェクトの位置を移動したりできました。
そこで思いつきました。「これを音声で操作できないだろうか?」その基盤として、ElevenLabsの強力な音声技術ほど適したものはありません。

技術的な課題
音声で操作する画像システムの構築には、5つの重要な課題を解決する必要がありました。
- 自然言語理解 — 新規作成と編集を区別する
- コンテキスト認識 — やり取りを通じて一貫性を保つ
- オーディオ管理 — 応答の重複を防ぎ、キューを管理する
- 画像生成 — 生成と編集をシームレスに切り替える
- ユーザー体験 — 高度なAI操作を直感的に感じられるものにする
アーキテクチャの概要
Vibe Drawはすべてクライアント側で動作し、以下のコンポーネントを統合しています。
- 音声認識用のWeb Speech API
- 音声応答用のElevenLabs TTS API
- 画像の生成・編集用のFLUX Kontext API
- ユーザー入力を理解するための独自の意図検出
この方法ならプロトタイプを軽量に保てますが、本番環境ではセキュリティのため、サーバー側でリクエストをプロキシする必要があります。
ElevenLabsによる音声機能の実装
Vibe Drawでは、会話への応答性を高めるよう調整したElevenLabsのテキスト読み上げ(TTS)APIを使用しています。
応答に変化を持たせるため、事前に用意したテンプレートから音声応答をランダムに選択します。
オーディオ再生の管理
音声応答が重なると、会話している感覚が損なわれます。Vibe Drawでは、オーディオキューシステムによってこの問題を解決しています。
各メッセージを最後まで再生してから、次のメッセージを開始します。
意図検出とコンテキスト管理
キーワードとコンテキストを検出し、ユーザーのプロンプトが新しい画像の作成依頼か、既存画像の編集依頼かを判断します。
この方法により、既存の画像があり、コンテキストから編集であることが明確な場合にのみ変更を適用できます。
FLUX Kontextによる画像生成
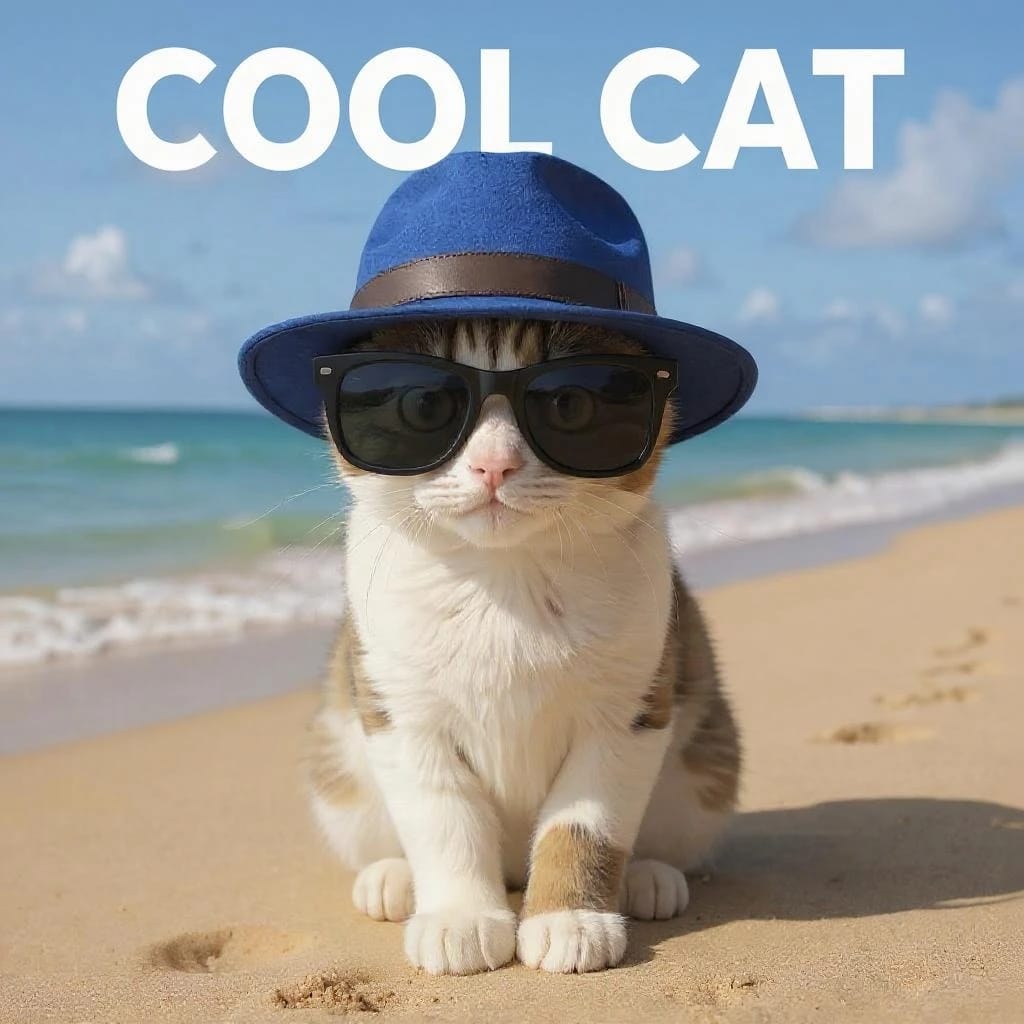
Kontextは、生成と編集の2つのモードに対応しています。
生成(テキストから画像)
編集(コンテキストに基づく変換)
複雑な変換への対応
プロンプトによっては、編集APIの制限を超える変更が求められることがあります。これを検出すると、代替手段を提示します。
体験の最適化
段階的なフィードバック
UIからフィードバックを提供することで、ユーザーはシステムの状態を把握できます。
適切なタイミング
自然な会話には、自然な間合いが欠かせません。
セッション状態
コンテキストを維持するため、セッションデータを保存します。
パフォーマンス上の考慮事項
高い応答性を確保するため、以下の点に対応しています。
- 遅延読み込み — 必要な場合にのみAPIを初期化
- デバウンス — 操作ごとのAPIリクエスト数を制限
- エラー処理 — タイムアウトや障害からスムーズに復旧
- リソースのクリーンアップ — オーディオオブジェクトとイベントリスナーを適切に破棄
今後の展開
会話型UIによって、次のような新しい可能性が広がります。
- マルチモーダル入力 — 「この写真にもっと似せて」
- 共同セッション — 複数のユーザーが1つのデザインを共同制作
- スタイルの記憶 — ユーザーの好みを時間とともに学習
- リアルタイムストリーミング — ユーザーが話している間に画像の更新をストリーミングし、会話型AIを統合して音声もストリーミング
主なポイント
Vibe Drawの開発を通じて、音声を中心としたツールに欠かせない原則がいくつか明らかになりました。
- コンテキストがすべて — 状態を追跡することで、一貫性のあるやり取りを実現
- タイミングが個性を生む — 応答の間合いを調整することで、AIの反応を自然に
- 代替手段で流れを止めない — 生成に失敗した場合は別の選択肢を提示
- 変化が新鮮さを保つ — 同じフレーズの繰り返しは没入感を損なう
まとめ
Vibe Drawは、会話型音声AIとビジュアルクリエイティビティを組み合わせた可能性を示しています。ElevenLabsの自然な音声合成とFLUX Kontextの画像APIを組み合わせることで、クリックもスライダーも使わず、話すだけで制作できる新しい方法が生まれます。
説明するのと同じくらい簡単に制作できれば、想像と実現の間にある壁を取り除けます。
実際に試す
完全なソースコードはGitHubで公開されています。自分の環境で実行するには、以下の手順に従ってください。
- リポジトリをクローンする
- ElevenLabs APIキーを追加する
- FAL.ai APIキーを追加する
- 最新のブラウザでvibe-draw-v2.htmlを開く
- マイクをクリックして制作を始める
独自の音声ファースト体験を構築してみませんか?ElevenLabsの会話型AIをご覧いただくか、お問い合わせください。
ライアンはBBCやFuture Plcでの役職を含む、20年以上のニュースと出版の経験を経てElevenLabsに参加しました。コンテンツ戦略とストーリーテリングに注力し、ElevenLabsの物語を形作り、共有する手助けをしています。