ボイスクローンAPI:仕組みと選び方
- 公開日
- 最終更新日
AIアシスタントからカスタマーサポートまで、音声はデジタルプロダクトの主要なインターフェースです。組織がグローバルなユーザーにサービスを提供し続けるなか、これらの音声アシスタントは複数の言語や地域に対応する必要があります。しかし、テキスト読み上げ(TTS)システムが汎用的または機械的な音声に頼ると、ブランドアイデンティティを弱めてしまいます。
ボイスクローンAPIを使うと、デベロッパーはAPI呼び出しを通じて、特定の人物の声による合成音声を生成できます。汎用的な音声が文章を読み上げる代わりに、対象話者の声で出力されます。TTSシステムの音声と、ブランドをどう表現するかを完全にコントロールできます。
ボイスクローンAPIは、俳優の声を言語をまたいで維持するメディア吹き替えパイプラインから、一貫したブランドボイスを大規模に維持するカスタマーサービスプラットフォームまで、さまざまな分野で新たな可能性を開きます。
このガイドでは、ボイスクローンAPIの仕組み、導入前に評価すべきポイント、この技術に伴う同意とセキュリティの管理方法を解説します。
概要
- ボイスクローンAPIでは、オーディオサンプルをアップロードし、生成されたボイスIDをテキスト読み上げリクエストで指定することで、特定の人物の声による音声を生成します。
- Instant Voice Cloningでは、1~2分のオーディオから数秒で利用可能な音声を作成できます。一方、Professional Voice Cloningでは、30分~3時間のオーディオを3~6時間かけて微調整し、より高品質で一貫性の高い結果を実現します。
- 責任あるボイスクローンの利用には、声の所有者の同意を証明すること、生成されたオーディオを出所まで追跡できるウォーターマーク、要求に応じて音声モデルを完全に削除するワークフローが必要です。
ボイスクローンAPIとは?仕組みは?
ボイスクローンAPIを使うと、デベロッパー向けアプリケーションは外部のボイスクローンシステムを呼び出して合成音声を生成できます。その瞬間に、誰かの声によるオーディオクリップを生成できます。
デベロッパーが対象となる声のオーディオサンプルをアップロードすると、APIが音色、話すリズム、発音といった音声特性を抽出してボイスIDを作成します。
そのボイスIDを指定したテキスト読み上げリクエストでは、クローンした声のオーディオが返されます。モデルのトレーニング、パラメーターの保存、音声合成はすべてプロバイダー側で処理されます。
ElevenAPIには、2つのクローン方法があります。インスタントボイスクローン(IVC)は、アップロードしたオーディオサンプルをリアルタイムで生成の指針として使用するため、利用可能なクローンを数秒で作成できます。プロフェッショナルボイスクローン(PVC)は、オーディオを使ってモデルを微調整し、より深く一貫性のある結果を実現します。
迅速なテストにはIVCを、本番品質のボイスクローンにはPVCを使用してください。
ボイスクローンAPIで検討すべき主な機能
ボイスクローンAPIの機能は大きく異なります。2つのプロバイダーがどちらもボイスクローンAPIを提供していても、ユースケースに必要な速度、品質、制御性が同じとは限りません。
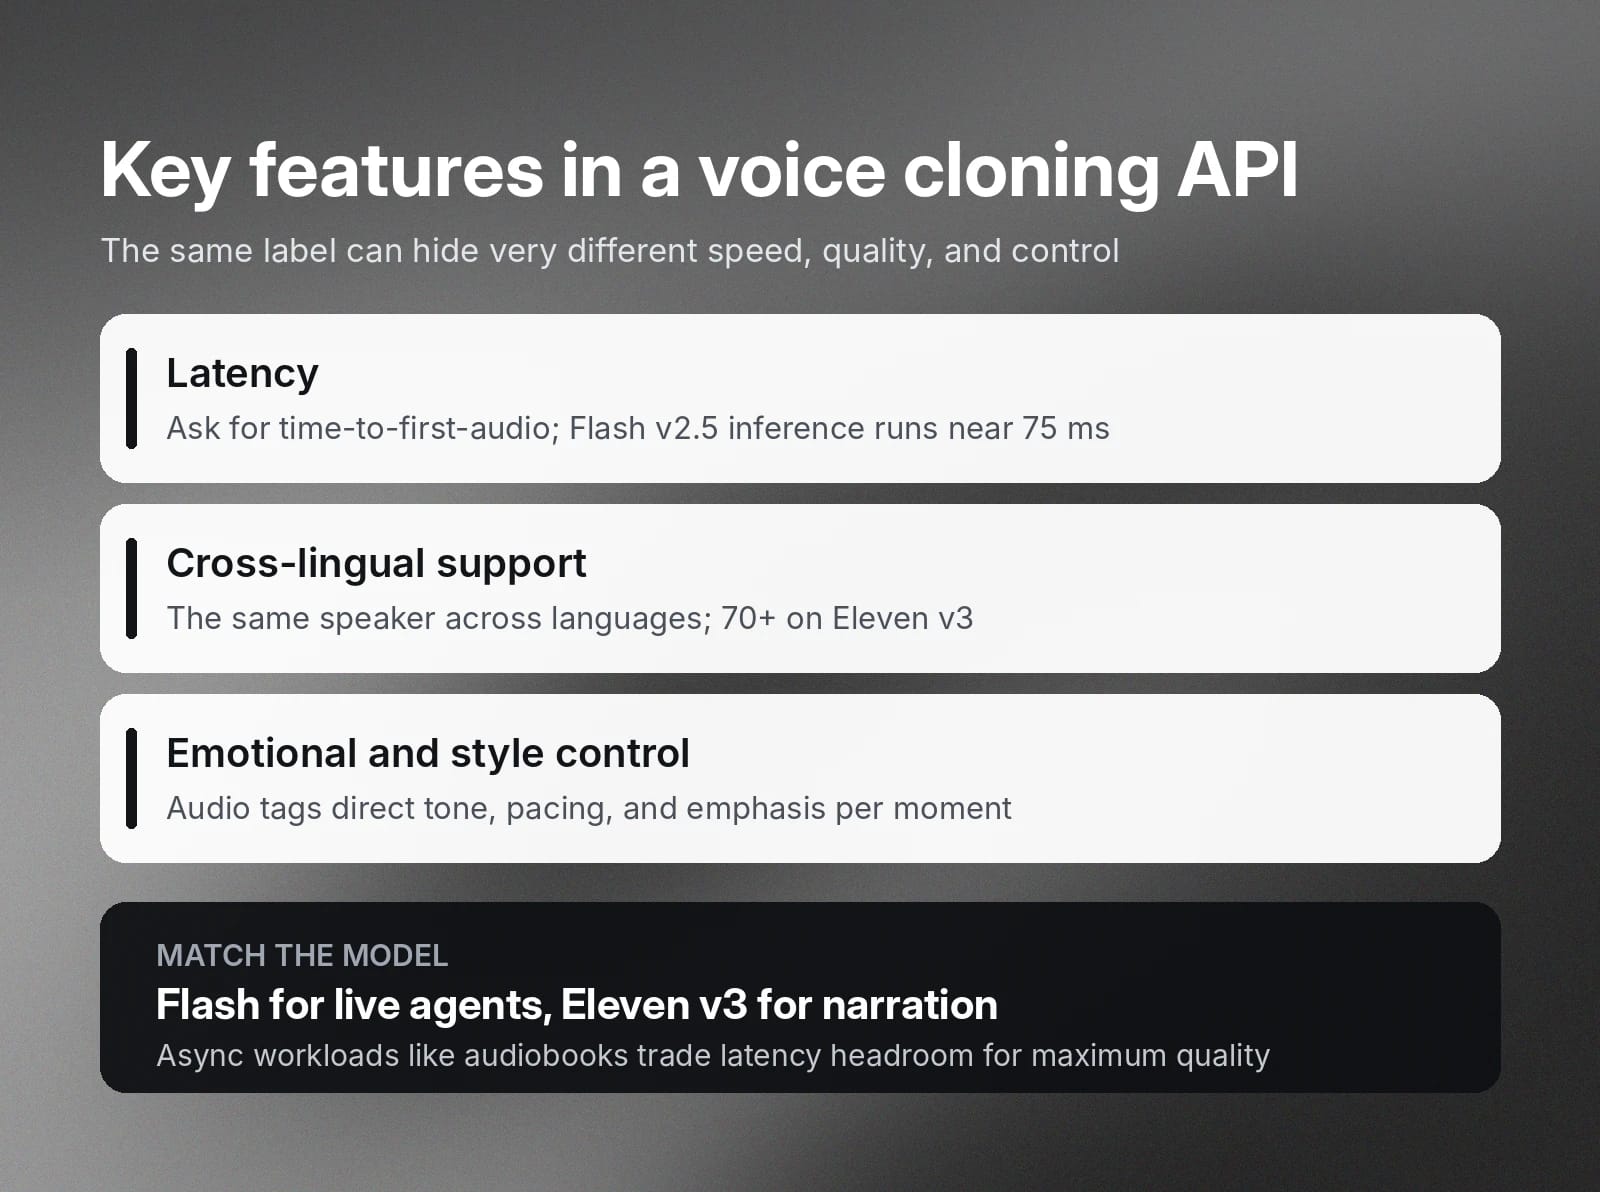
ボイスクローン用APIを評価する際は、以下の機能を特に重視してください。
レイテンシー
アプリケーションに音声エージェント、リアルタイム吹き替え、インタラクティブなキャラクターなどのライブインタラクションが含まれる場合、レイテンシーは重要な要素です。APIプロバイダーのマーケティング上の主張ではなく、公表されている初回オーディオ出力までの時間を確認してください。
Eleven Flash v2.5は、一般的な短い入力に対して約75msのモデル推論時間を実現します。この数値にはネットワークの往復時間やアプリケーションのオーバーヘッドは含まれません。そのため、会話がリアルタイムに感じられるかを左右する初回オーディオ出力までの時間は、本番環境ではより長くなります。それでもFlashは、1ミリ秒単位の差が重要となるリアルタイム用途向けに設計されています。
オーディオブックのナレーションやビデオの吹き替えのような非同期ワークロードでは、レイテンシーの重要性は下がります。こうしたシナリオでは、品質を最適化したモデルであるEleven v4の方が適しています。
言語・クロスリンガル対応
クロスリンガルクローンを使うと、ある言語で声を取得し、別の言語で音声を生成できます。ボイスクローン用APIを評価する際は、言語が変わっても同じ話者らしく聞こえるか、発音が強いなまりや機械翻訳のような不自然さなく聞こえるかを確認してください。
ElevenAPIはEleven v4で90以上の言語、Eleven v3で70以上の言語、Multilingual v2で29言語をサポートしています。Multilingual v2は、言語を切り替えても一貫した音声品質となまりを維持するよう設計されています。
感情とスタイルの制御
1つの話し方でしか話せないボイスクローンでは、すべてのユースケースが平坦で均一な印象になり、構築できるものが限られます。感情のトーン、話す速さ、強調など、話し方を制御できるAPIを選んでください。
Eleven v3はオーディオタグに対応しており、アプリケーションから特定の場面での話し方を指定できます。これは、ナラティブコンテンツ、キャラクターボイス、同じ声を異なるコンテキストで使うアプリケーションで特に重要です。
ボイスクローンAPIの実際のユースケース
ボイスクローンAPIが最も役立つのは、音声そのものがプロダクト体験の一部になるときです。大規模な一貫性を目指す場合もあれば、アイデンティティの維持、アクセシビリティの向上、コンテンツのローカライズのしやすさが目的の場合もあります。
特に有力なユースケースは、目新しさを超えて、サポートチーム、コンテンツチーム、教育者、支援音声技術に依存する人々が抱える実際のワークフロー上の問題を解決します。
カスタマーサービスとコールセンター
ボイスクローンは、IVRメニュー、発信リマインダー、AI音声エージェントにわたり、企業が一貫したブランドボイスを維持するのに役立ちます。チャネル間を移動する顧客は、提供される体験に一貫性を求めます。音声は、異なるタッチポイントで同じようなインタラクションを実現するうえで重要な役割を担います。
TwilioはConversationRelayプラットフォームにElevenLabsを統合し、デベロッパーはTwilioのインフラストラクチャ上で、本番環境の通話量にも対応できる自然な音声による会話体験を直接構築できるようになりました。
ボイスバンキング
ALS、喉頭がん、多発性硬化症(MS)などの進行性疾患に直面する患者にとって、ボイスクローンは発話能力を失う前に、非常に個人的なものを残す手段になります。
Della Larsenさんは2023年にALSと診断され、将来の孫のために30冊の児童書を自分の声で読む様子をボイスバンキングで録音しました。孫たちは彼女の声で本の読み聞かせを聞けます。
高品質な音声により、声を完全に失う可能性がある人も、失う前に自分の声を残せます。長い将来にわたって使える、不変の声の記録を作り出せます。
ボイスバンキングの詳細と、ElevenLabsが100万の声を残すことに取り組む方法については、インパクトページをご覧ください。
教育とeラーニング
ボイスクローンにより、教育プロダクトは親しみがあり信頼できる声で指導を提供できます。特に初学者にとって、より穏やかで優しい声は自信につながる場合があります。
Chess.comはElevenLabsを活用し、Hikaru Nakamura、Levy Rozman、Magnus Carlsenを含むグランドマスターや人気クリエイターの声をPlay Coach機能に導入しました。プレイヤーは、YouTubeやTwitchですでに知っている声で、リアルタイムの指し手フィードバックを受け取れます。
ボイスクローンAPIにおけるデータセキュリティと責任あるAI利用
ボイスクローンは、実在する人物になりすます、詐欺電話を作る、音声サンプルから、そもそもクローンされることを意図していなかった音声を生成するために悪用される可能性があります。プロバイダーは、同意、追跡可能性、保持に関する制御を、プラットフォーム自体に常に組み込むべきです。
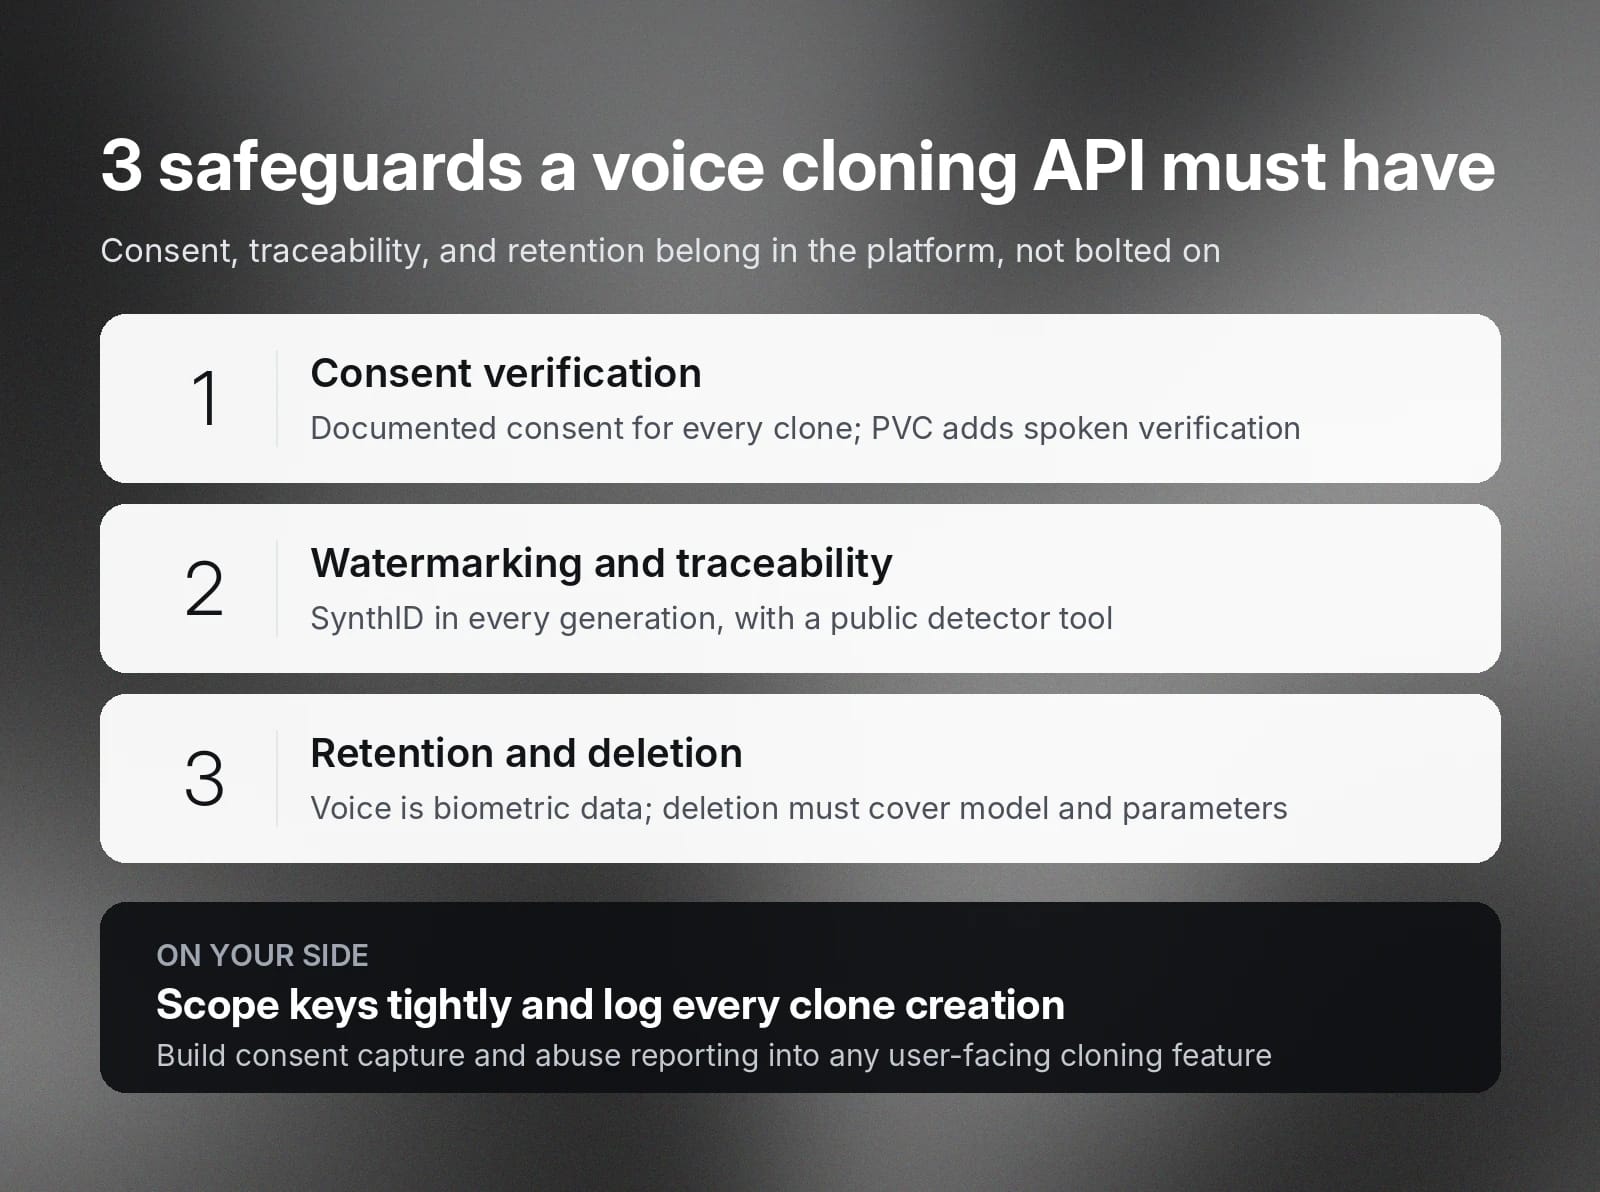
確認すべき3つの保護策を紹介します。
同意の検証
すべてのクローンでは、声の所有者による文書化された同意が必要です。ElevenAPIではすべてのクローンに同意の証明を求め、Professional Voice Cloningでは、話者が本人確認のために特定の声明を録音する検証ステップも追加されます。
エンドユーザーが声をクローンできるアプリケーションでは、独自のフローに同意取得を組み込んでください。同意要件が弱いことは危険信号と捉えるべきです。誰でも簡単にクローンできるプロバイダーは、悪用を招くおそれがあります。
ウォーターマーキングと追跡可能性
生成されたオーディオは、出所を特定できるべきです。プロバイダーを評価する際は、生成後の出所特定をどのようにサポートしているかを具体的に確認してください。ElevenAPIはSynthIDを埋め込みます。これはGoogle DeepMindと開発したデジタルウォーターマーキング技術で、すべての生成物に埋め込まれます。また、オーディオがElevenLabsで生成されたものか確認できる検出ツールも提供しています。
悪用を追跡し、係争中のコンテンツを検証でき、クローンの出所が問われた際にビジネスとして根拠を示せます。
保持と削除に関するポリシー
音声データは生体データに該当します。多くの法域でそう扱われています。プロバイダーごとに、所有権、トレーニングでの利用、保持の扱いは大きく異なります。導入前に、次の質問への明確な回答を得てください。
- クローンした音声モデルの所有者は誰ですか?
- プロバイダーは音声データをトレーニングに使用できますか?
- 削除を要求してから完了するまでの期間はどれくらいですか?
欧州のユーザーを扱うアプリケーションでは、GDPRの消去権は録音から作成された音声モデルにも及びます。プロバイダーには、音声モデル、そのトレーニングデータ、派生パラメーターを削除するワークフローが必要です。
ElevenAPIはZero Retention Modeを提供しており、エンタープライズのお客様はリクエストデータがそもそも保持されないようにできます。データの保存場所を選択するためのデータレジデンシーオプションも用意されています。
責任は、自社のインテグレーションにも及びます。アクセスキーの権限を厳密に絞り、クローン作成イベントをログに記録し、ユーザー向けのクローン機能には不正利用の報告機能を組み込んでください。実装の詳細については、API認証とキー管理のベストプラクティスをご覧ください。
ElevenAPIのボイスクローンを始める
ElevenAPIを始めるには、APIキーを作成し、ボイスクローンエンドポイントから音声サンプルをアップロードして、返されたボイスIDをテキスト読み上げリクエストに指定します。
公式のPythonおよびNode.js SDKはAPIの全機能をサポートしています。また、ボイスライブラリには、クローンを必要としないユースケース向けに11,000以上のすぐに使える音声があります。
このガイドで紹介した同意の証明、検証、検出ツール、削除ワークフローなどのコンプライアンス機能は、プラットフォームに組み込まれています。チームは後からセーフティ制御を追加することなく、プロトタイプから本番環境へ移行できます。利用量を見積もるには、API料金計算ツールを使用してください。利用可能な音声を幅広く確認するには、包括的な音声ガイドをご覧ください。
セットアップが完了すれば、最初の声のクローン作成にかかる時間はわずか数分です。APIキーを取得してクローン作成を始めるか、まずはドキュメントを見ることで詳細をご確認ください。
よくある質問

Jack LimebearはGrowthチームに所属し、ブログやインサイトページのコンテンツライター兼ストラテジストとして活躍しています。ElevenLabsに入社する前は、急成長中のSaaSスタートアップからFortune 500企業まで、さまざまな組織で10年以上にわたりコンテンツ戦略をリードしてきました。ケンブリッジ大学で英文学の修士号を取得しています。