会話型AIのレイテンシーとは?影響する要因を解説
- 公開日
- 最終更新日
聴くこの記事を聴く
会話型AIでは会話型AIのレイテンシーが、優れたアプリケーションと卓越したアプリケーションを分けます。
会話型AIは、本質的に理想を追求するものです。人と話すときと同じ感覚を再現し、同じ感情の幅、声の高さ、話すリズムを再現しようとします。話し終えてからAIエージェントが応答を始めるまでの「自然」に感じられる間も加えると、人間の実際のコミュニケーションに根ざしたレイテンシー目標が見えてきます。
大規模に会話型AIエージェントを導入し、この自然な体験を実現したい企業は、レイテンシーを可能な限り抑える必要があります。この記事では、会話型AIのレイテンシーとは何か、パイプライン全体で遅延が発生する原因、そしてそれらを減らすための概要を解説します。
概要
- 会話型AIのレイテンシーとは、ユーザーが話し終えてからエージェントの最初の言葉を聞くまでの、エンドツーエンドの総遅延時間です。
- 700msを超えるエージェントは不自然に感じられることがあり、1,200msを超えると離脱率が高くなります。
- レイテンシーは、会話型AIパイプラインのすべての段階で積み重なります。
- ElevenAgentsは、単一の統合アーキテクチャでパイプライン全体を処理し、低レイテンシーの会話型AIをビジネスで利用しやすくします。
会話型AIのレイテンシーとは?
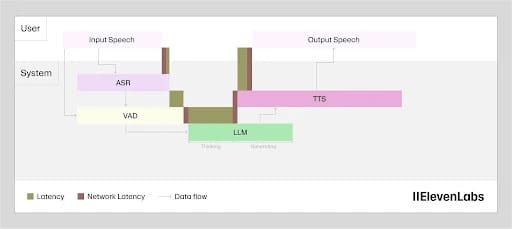
会話型AIのレイテンシーとは、話しかけた後にシステムが応答するまでにかかる合計時間を指します。最新のAIモデルでは、レイテンシーはms単位で測定されます。実際には、総レイテンシーは複数の独立したプロセスから成り、それぞれがエンドツーエンドのパイプラインの一部を担っています。
一般的な会話型AIパイプラインは次のとおりです。
- ユーザーが話す
- スピーチtoテキストモデルがオーディオを文字起こしする
- 文字起こし結果がLLMに渡され、応答が生成される
- 次に、LLMのテキストがテキスト読み上げモデルによってオーディオに合成される
- オーディオがユーザーに再生される
これらのすべての段階が、会話型AIシステムにレイテンシーを加えます。そのため、レイテンシーを説明する際には、明確にしておくべきいくつかの略語があります。
モデル推論レイテンシー
モデル推論レイテンシーとは、外部要因をすべて除外し、内部で測定したモデルの出力生成時間です。一般的な入力に対してエンジンがどれだけ速く動作するかを示す、モデル固有の指標です。たとえば、Flash v2.5のモデル推論レイテンシーは約75msです。この指標を知ることで、競合他社のモデルとの速度を比較できます。
ただし、これはユーザーが実際に体験するレイテンシーではありません。あくまでモデルが出力生成に費やす合計時間に特化した指標です。
LLMの最初のトークン生成時間
大規模言語モデル(LLM)の最初のトークン生成時間(TTFT)とは、LLMがプロンプトを処理し、最初に利用可能な出力トークンを生成するまでの合計時間です。
TTS生成はLLMから最初のトークンが届いた時点で始まるため、これはLLMがTTSモデルの実行を開始させるまでにかかる時間の指標です。ほとんどのエンドツーエンド会話型AIシステムでは、LLMのTTFTが総レイテンシーの大きな割合を占めます。
TTSの最初のオーディオ生成時間(TTFA)
TTSの最初のオーディオ生成時間(TTFA)は、最初のTTSリクエストから、最初のオーディオチャンクが実際にモデルから出力されるまでの時間を測定します。モデル推論レイテンシーを表す指標の一種ですが、TTSエンジンに特化しています。
エンドツーエンドの最初のオーディオ生成時間(TTFA)
エンドツーエンドTTFAは、会話型AIの総レイテンシーです。これは、音声認識、LLMのTTFT、TTS、TTFA、および各ステップ間のすべてのネットワーク通信を含む、パイプラインのすべての要素の合計です。会話型AIのレイテンシー全体を考える際、これはユーザーが体感する指標です。
ユーザーが話すと、エージェントから何らかの応答を聞くまで、エンドツーエンドTTFAの間待つことになります。これは包括的な指標であり、パイプラインのどの部分を改善しても向上します。
会話型AIのレイテンシーが重要な理由
ユーザーがAIエージェントと話すとき、レイテンシーはその体験をどう評価するかの中心的な要素になります。レイテンシーが低いほど応答を待つ時間が短くなり、会話が自然に感じられ、エージェントも有能に見えます。
レイテンシーが高いエージェントは、応答の品質が同じでも、人工的で能力が低いように感じられます。企業にとっては、わずか数百msの差であっても永遠のように長く感じられ、カスタマーサポートエージェントが鈍重で効果のないものに感じられます。
会話型AIのレイテンシーが実際に重要となる理由を、いくつかのシナリオで見てみましょう。
- 500ms未満:会話型エージェントは、応答性が高くスムーズに感じられます。ユーザーは話し終えてから最初の応答を得るまでの遅れに気付かないこともあり、会話が自然に進みます。
- 500ms~1,000ms:ユーザーが話し終えてから応答を受け取るまでの遅れを、はっきり感じるようになる場合があります。ほんの少し長すぎるため、ユーザーは自分の発言を繰り返したり、エージェントが本当に理解したかを確かめるために間を置いたりして、先回りして対応するかもしれません。
- 1,000ms超:遅延が遅く感じられ始め、AIエージェントが会話についていけていないと感じるユーザーも出てきます。文字起こしには、時折の割り込みや人間のエージェントとの会話を求める要望が現れることがあります。場合によっては、ユーザーが通話を途中でやめることもあります。
これらのしきい値はすべて、実際のビジネス成果につながります。
レイテンシーが低い場合は、問い合わせに自然に対応し、追加の支援なしでユーザーの問題解決を助けられるカスタマーサービスエージェントを実現できます。これにより人間のエージェントの負担が減り、顧客満足度を高く保てます。一方、レイテンシーが高い場合は、あまりに長くためらっているように見えるエージェントによって顧客を苛立たせてしまいます。
別の記事で、ボイスエージェントのレイテンシーバジェットのベンチマークを定義し、P50とP95の両方において優れたレイテンシーがどのようなものかを示しています。
会話型AIのレイテンシーは何が原因で発生するのか?
会話型AIのレイテンシーは、複数の異なるプロセスをまとめた用語であり、各セグメントが全体に寄与します。この点を踏まえると、低レイテンシーのボトルネックは、単に優れたモデルを選べば解決する問題ではなく、システムレベルの問題です。結局のところ、パイプラインでは複数のモデルが連携します。
デベロッパー向けに、エンドツーエンドの最初のオーディオ生成時間(TTFA)の各段階を改善するための詳細な技術ガイド「ボイスエージェントのレイテンシー最適化」を用意しています。
コアパイプライン以外にも、電話システムや関数呼び出しなどの要因がレイテンシーを加えます。これらはモデルインフラストラクチャの内部要素ではありません。
会話型AIのレイテンシーに影響するすべての要因を見ていきましょう。
自動音声認識
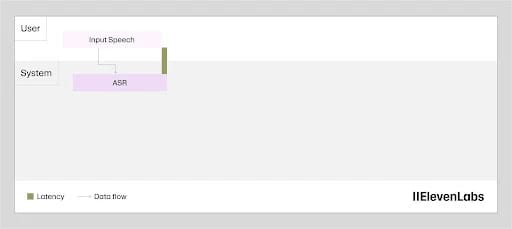
音声認識のレイテンシーは、文字起こしを生成するのにかかる時間ではありません。文字起こし処理はユーザーが話している間にバックグラウンドで実行されるため、発話が終わる時点ではテキストの大部分がすでに準備できています。
ここでのレイテンシーは、発話が終わってから文字起こしが確定され、次の段階に渡されるまでの差です。Scribe v2 Realtimeは継続的にストリーミングすることで、この差を約150msに短縮し、ターンが終わった瞬間に出力を準備します。
ターンテイキングとエンドポインティング
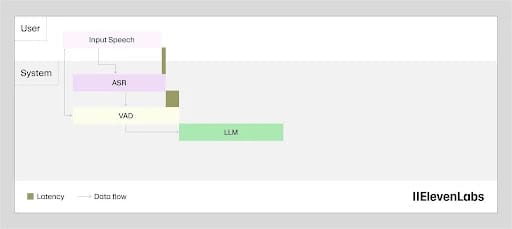
Voice Activity Detector(VAD)は、音声認識と言語モデルの間に配置されます。その役割は、ユーザーが実際に話し終えたタイミングを判断することです。
エラーを避けるため、VADは一定時間の無音状態が続くまで待ってからターンの終了を宣言します。この待機時間は、言語モデルが単語を処理する前に加わるレイテンシーです。このわずかな追加レイテンシーは時間を要しますが、ユーザーがまだ話している間にシステムが応答を始めてしまうのを防ぎます。
技術的に言えば、他の会話型AIコンポーネントのレイテンシーがすべてゼロであれば、ターンテイキングに起因するレイテンシーは良いものです。人間は発話に応答する前に少し間を取ります。機械が同様の間を取ることで、対話にリアリティが生まれます。ただし、会話型AIの他のコンポーネントですでにレイテンシーが発生しているため、レイテンシーは最小限に抑えるのが理想的です。
言語モデルの処理
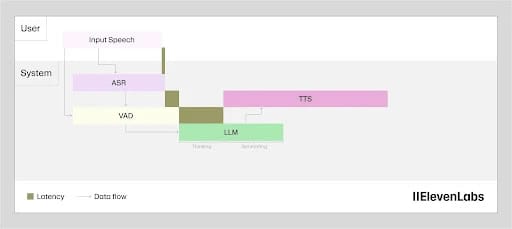
スピーチtoテキスト(STT)エンジンから文字起こし結果が得られると、言語モデルが応答を生成します。ここでのレイテンシーは、応答全体を生成する時間ではなく、トークンの生成を開始するまでの時間です。トークンは到着次第TTS段階に直接ストリーミングされるため、最も重要なのはTTFTです。
モデルの選択に加え、プロンプトの長さとナレッジベースのサイズもこの段階に影響します。LLMが考慮すべきコンテキストが多いほど、時間がかかります。こうしたシステムを大規模に設計する際は、速度を維持するために、有用なナレッジベースと簡潔なプロンプトの適切なバランスを取る必要があります。
音声合成
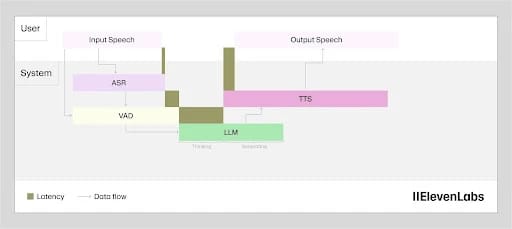
TTSのレイテンシーは、言語モデルから最初のトークンを受け取ってからオーディオが始まるまでの時間です。トークンは人間の発話の再生より速く届くため、合成モデルが応答全体を待つことはありません。TTSのレイテンシーは、厳密には最初のオーディオチャンクが生成されるまでの時間です。
以前はこの段階が会話型AIのレイテンシーにおける最大の要因であり、古いモデルでは音声生成を開始するまでに2~3秒かかっていました。ElevenLabsのFlash v2.5は、この課題に直接対応し、約75msのレイテンシーで音声合成を提供することで、このボトルネックを数秒から1秒未満へと短縮します。
ネットワークレイテンシー
ある場所から別の場所へデータを送信する際には、必ずレイテンシーが発生します。地理的な距離が離れるほど、ネットワークの往復レイテンシーはさらに大きくなります。
エンドツーエンドの応答には複数のコンポーネントが連携するため、複数のネットワークホップを通じて大きなレイテンシーが蓄積する可能性があります。
関数呼び出し
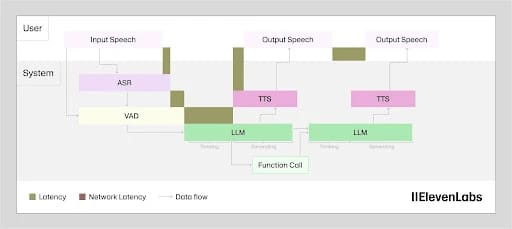
関数呼び出しは、LLM段階でAPIの往復通信を追加します。高速な内部検索なら数十ミリ秒で済みますが、決済処理システムや在庫管理システムでは数秒かかる可能性があります。レイテンシーは呼び出すサービスに完全に依存するため、これが直接最適化するのが最も難しい段階です。
最も効果的な方法は、ツール呼び出しが完了する前にLLMが応答するようにプロンプトを設定することです。「確認しますね」のような言葉を使えば、無音のままにせず、外部呼び出しの解決中もユーザーの関心を保てます。ツールが並行して実行される間に、音声応答が始まります。
会話型AIのレイテンシーを減らす方法
会話型AIのレイテンシーを減らすには、影響の大きい順にパイプラインの各段階に取り組む必要があります。個別の改善もレイテンシーに影響しますが、最大の変化を得るにはパイプライン全体を包括的に改善する必要があります。
会話型AIのレイテンシーを大きく減らすための指針をいくつか紹介します。
- TTSモデルの選択:Flash v2.5のように速度を最適化したTTSモデルは、Eleven v3やEleven v4のように品質を最適化したモデルとは異なるアーキテクチャを使用します。リアルタイムボイスエージェントでは、レイテンシー目標を満たす最高品質のモデルを選ぶべきであり、ほとんどの場合それは速度最適化モデルです。
- LLMモデルの選択:一般に、小さく高速なLLMほど、大規模なLLMよりも最初のトークン生成時間が短くなります。タスクに求められる品質基準を満たす中で最速のLLMを選ぶことは、TTSモデルの選択と同じくらい重要です。
- ストリーミング:ストリーミングTTSは、合成の進行に合わせてオーディオをチャンク単位で返すため、モデルが残りを生成している間にユーザーは最初の言葉を聞けます。この考え方はLLM出力にも当てはまり、言語モデルが後続の文を生成している間に最初の文でTTS合成を開始すれば、パイプラインのレイテンシーを短縮できます。
- システムプロンプトの設計:システムプロンプトを簡潔にするには、すべての判断ステップに含めるのではなく、指示を手順やワークフローに移します。これにより、各ターンでモデルが推論する必要のあるコンテキスト量を減らせます。
- ガードレール:ガードレールをストリーミングモデルで実行すると、チェックが完了するまで再生をブロックするのではなく、ガードレールチェックの完了前に出力の再生を開始できます。
- モデルのコロケーション:ElevenLabs Agentsスタックのように、可能な場合はコロケーションされたモデルを使用することで、コンポーネント同士を近くに配置し、別々にホストされたモデル間のホップによるレイテンシーを防げます。
- 地理的要因:サーバーとユーザーを近い場所に配置すると、ネットワークがエンドツーエンドTTFAに与える影響を直接減らせるため、レイテンシーを大幅に削減できます。
これらの要因に加え、詳細についてはこのレイテンシー最適化の技術ガイドをご覧ください。
ElevenAgentsで低レイテンシーの会話型AIを始める
会話型AIのレイテンシーは、エージェントを構築・導入する際に考慮すべき非常に重要な要素です。ElevenAgentsでは、レイテンシー最適化がプロセスに組み込まれています。時間を取り戻すためのオーバーラップ技術から、個々のコンポーネントにおける低いモデル推論レイテンシーまで、ElevenAgentsはビジネス向けに低レイテンシーの会話型AIスタックを構築します。
最終的な目標は、リアリティを生み出すことです。ユーザーは、コンピュータープログラムの利点を得ながら、人と話す気軽さを感じる必要があります。サブプロセスを最適化することで、これは今や実現可能です。
ElevenAgentsの詳細を確認するか、】【営業に問い合わせることで、今すぐ始められます。
会話型AIのレイテンシーに関するよくある質問

Jack LimebearはGrowthチームに所属し、ブログやインサイトページのコンテンツライター兼ストラテジストとして活躍しています。ElevenLabsに入社する前は、急成長中のSaaSスタートアップからFortune 500企業まで、さまざまな組織で10年以上にわたりコンテンツ戦略をリードしてきました。ケンブリッジ大学で英文学の修士号を取得しています。