Audio Tagsとは?感情豊かなTTSの完全ガイド
- 公開日
- 最終更新日
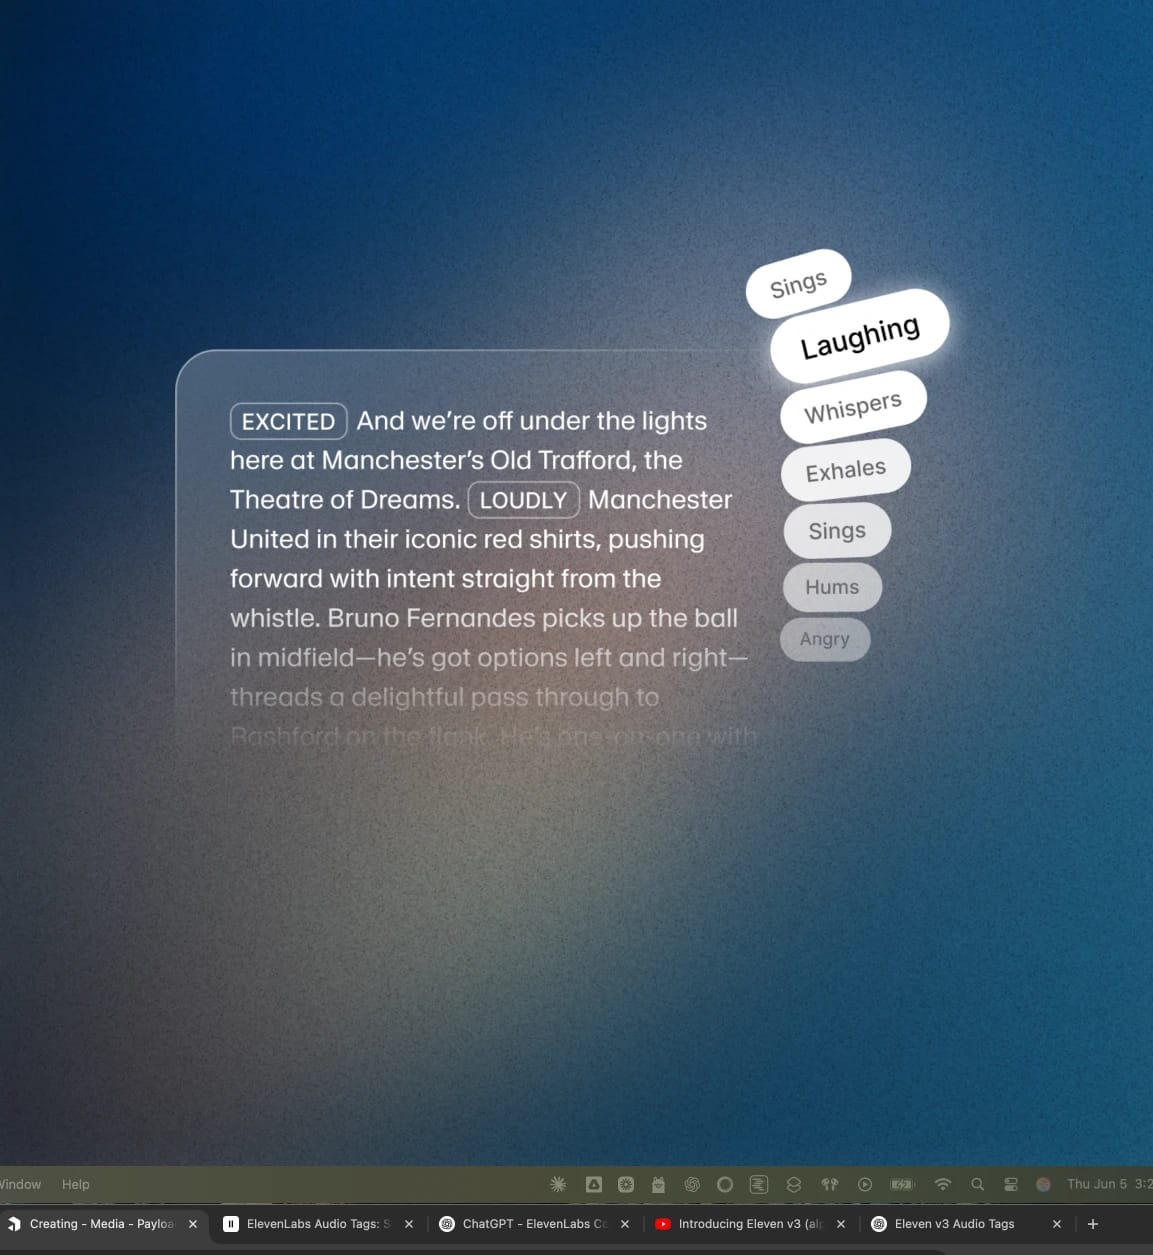
Audio Tagsは、[laughs]、[gasps]、[excited]、[worried]のように角括弧で囲まれた自然言語のキューで、Eleven v3とEleven v4では読み上げる言葉ではなく演技指示として扱われます。テキスト読み上げモデル用の台本にAudio Tagsを挿入すると、文章の感情表現を細かくコントロールできます。
Eleven v3 は2026年3月に一般公開されました。v3以前は、テキスト読み上げモデルから特定の感情表現を引き出すには、コンテンツを何度も生成し直し、うまくいくことを願うしかありませんでした。Audio Tagsなら、そのような試行錯誤は不要です。感情豊かなテキスト読み上げを完全にコントロールできます。Eleven v4では、さらに細かな感情コントロールが可能です。
このガイドでは、Audio Tagsとは何か、その仕組み、利用できるすべてのタグカテゴリー、SSML(音声合成マークアップ言語)との違いを解説します。また、各専用ガイドへのリンク付きで、代表的なユースケースもご紹介します。
概要
- Audio Tagsは、[shouts]や[excited]のように角括弧で囲まれたキューです。Eleven v3とEleven v4のTTSにおける感情、ペース、話し方、トーンを指定できます。
- Eleven v3とEleven v4はSSMLをサポートしていませんが、より自然に書けるAudio Tagsを代わりに使用できます。
- タグには、感情、話し方とペース、人間らしい反応、アクセント、サウンドエフェクトなどのカテゴリーがあります。
- テキスト内の句読点や大文字表記を使えば、AI音声のパフォーマンスのペースを調整できます。
- Audio Tagsは、ElevenLabsのUIまたはAPIから利用できます。
Audio Tagsの仕組み
Audio Tagsは台本のテキスト内に記述し、角括弧で囲みます。たとえば通常の話し方から[worried]に切り替えたい場合は、Audio Tagを追加するだけです。
1つの文で複数のタグを使ったり、タグを組み合わせてより多層的な演技を作ったりすることもできます。たとえば、[tired] It’s been a long day… [upset] How many more days can I take?
Eleven v4のアーキテクチャにより、従来モデルより深いレベルでコンテキストを読み取れます。個別のパラメーターや設定を指定しなくても、感情のキュー、トーンの変化、話者の切り替わり、文脈上のヒントに従えます。その場面に必要なことをモデルに伝えるだけで、意図どおりにセリフを演じます。
Eleven v4は、タグと台本の構造だけで、割り込みや気分の変化、実際の会話のような自然なやり取りを含む、即興的に感じられる複数話者の対話も扱えます。
Audio TagsとSSMLの比較
他のTTSシステムを使ったことがあれば、音声合成マークアップ言語(SSML)をご存じかもしれません。Amazon PollyやMicrosoft Azure Speechなどのプラットフォームは、<break>や<emphasis>といったSSMLタグを使い、TTS用台本に追加のコンテキストを与えます。
Eleven v4は、SSMLのbreakタグを含むSSMLタグセットをサポートしていません。代わりに、Audio Tags、句読点、そしてテキスト構造そのものがその役割を担い、話し方を細かくコントロールできます。
以下の表で、一般的なSSMLタグをEleven v4での対応方法に置き換えられます。
書き手の視点では、セリフに[whispers]を追加する方が、プロソディのレートを設定するよりはるかに手軽です。
v3におけるAudio Tagsのカテゴリー:Audio Tagsで演技を演出する
Audio Tagsは台本内のどこにでも配置でき、リアルタイムで話し方を調整できます。台本全体や1つの文の中で、複数のタグを組み合わせることも可能です。
タグは次の主要カテゴリーに分類されます。
感情
これらのタグは、陰鬱、激しさ、明るさなど、声の感情的なトーンを設定するのに役立ちます。たとえば、[sad]、[angry]、[happily]、[sorrowful]を単独または組み合わせて使用できます。
話し方とペース
これらはトーンや演技に関するタグです。抑制や力強さが必要なシーンで、音量やエネルギーを調整できます。[whispers]、[shouts]、[softly]などがあります。
人間らしい反応
真に自然な話し方には反応が含まれます。たとえば、自然で台本にない瞬間を音声に組み込むことで、リアリティを加えられます。[laughs]、[clears throat]、[sighs]のようなタグは、人間らしい感情を表現できるTTSモデルの実現に役立ちます。
ほかのAudio Tagカテゴリーの例:
- アクセントとキャラクターボイス: アクセントタグを使うと、[French accent]、[British accent]、[pirate voice]のように、モデルを切り替えずに声を特定の地域や人物像に変えられます。1つの声を、固定された1つの演技ではなく、柔軟なキャストとして活用できます。
- サウンドエフェクト: サウンドエフェクトタグは、[gunshot]、[explosion]、[clapping]のような非音声オーディオを直接生成に加えます。没入感のあるオーディオ、ゲーム、声だけでは足りない場面のドラマチックなナレーションに適しています。または、ElevenCreative AIサウンドエフェクトジェネレーターを使用してください。
タグで高度なコントロールができる一方、句読点を使ってリズムや強調を調整することもできます。たとえば、自然な間には省略記号を、自然な息継ぎにはコンマを使います。単語をすべて大文字にして強調してみましょう:「I want it right NOW.」
Audio Tagsでできること
Audio Tagsを使うと、直感的に台本の感情的な複雑さを引き出せます。自然に書き、必要に応じてタグを追加してください。
Audio Tagsを使った感情豊かなTTSのユースケースをいくつかご紹介します。
AIオーディオの状況認識
[whisper]や[shouting]などのタグにより、Eleven v4はその瞬間に反応できます。警告をやわらげたり、緊張感を高めるために長い間を置いたりと、動的な状況認識を台本に組み込めます。
詳しくは、AIオーディオの状況認識ガイドをご覧ください。
音声におけるキャラクター演技の演出
複数のキャラクターが登場する台本を作る場合は、それぞれの声の違いを明確に示すことが大切です。[sarcastically]で性格を調整したり、[British accent]で話し方を定義したりすることで、TTSエンジンで幅広い感情を表現できます。
詳しくは、AI音声におけるキャラクター演技の演出をご覧ください。
音声で感情的な文脈を表現する
Audio Tagsを使うと、セリフの進行に合わせて感情表現を調整できます。スピーチを通して感情を積み上げ、キャラクターが最高潮に達する瞬間にクレッシェンドを作り出せます。[awe]、[booming]、[big laugh]のようなタグは、AI音声のパフォーマンスに幅広い感情表現を加えるのに役立ちます。
詳しくは、AI音声における感情的な文脈の活用方法をご覧ください。
複数キャラクターの対話に命を吹き込む
複数キャラクターによる対話パフォーマンスを作る場合、各行をAudio Tagで始めることで、魅力的なキャラクター同士の会話を構築できます。
例:Tom: [coughing] [beginning to speak] ごめん、今日は少し体調が悪くて— Emma: [interrupting] —具合が悪い? トム、私が咳が嫌いなの知ってるでしょ! Tom: [surprised] ただの軽い咳だよ、深刻なことじゃない。もし君が— Emma: [overlapping] [annoyed] —家に帰ったほうがいいと思う。
ほかにもできることは、Eleven v3での複数キャラクター対話をご覧ください。
AI音声の話し方を精密にコントロール
Eleven v3とEleven v4では、Audio Tagsまたは句読点を使って音声のペースをコントロールできます。[pause]、[rushed]、[drawn out]のようなタグを使うと、セリフを精密に調整できます。また、省略記号、句点、感嘆符を加えることで、TTSパフォーマンスに自然に感情を組み込めます。
以下では、Eleven v3での話し方の精密なコントロールについて詳しく解説しています。
感情豊かなTTSはAPIで利用可能
Audio Tagsは、テキスト読み上げAPIでもElevenLabsのUIと同じように機能します。台本テキスト内にタグを記述すると、APIはオーディオブックのパイプラインから広告用ボイスオーバーまで、タグに沿ったパフォーマンスを生成済みオーディオとして返します。
Eleven v4の詳細をご確認いただくか、営業に問い合わせることで、今すぐ始められます。
Audio Tagsと感情豊かなTTSに関するよくある質問

Jack LimebearはGrowthチームに所属し、ブログやインサイトページのコンテンツライター兼ストラテジストとして活躍しています。ElevenLabsに入社する前は、急成長中のSaaSスタートアップからFortune 500企業まで、さまざまな組織で10年以上にわたりコンテンツ戦略をリードしてきました。ケンブリッジ大学で英文学の修士号を取得しています。