Eleven v3 オーディオタグ: AIオーディオに状況認識を
- 公開日
- 最終更新日
聴くこの記事を聴く
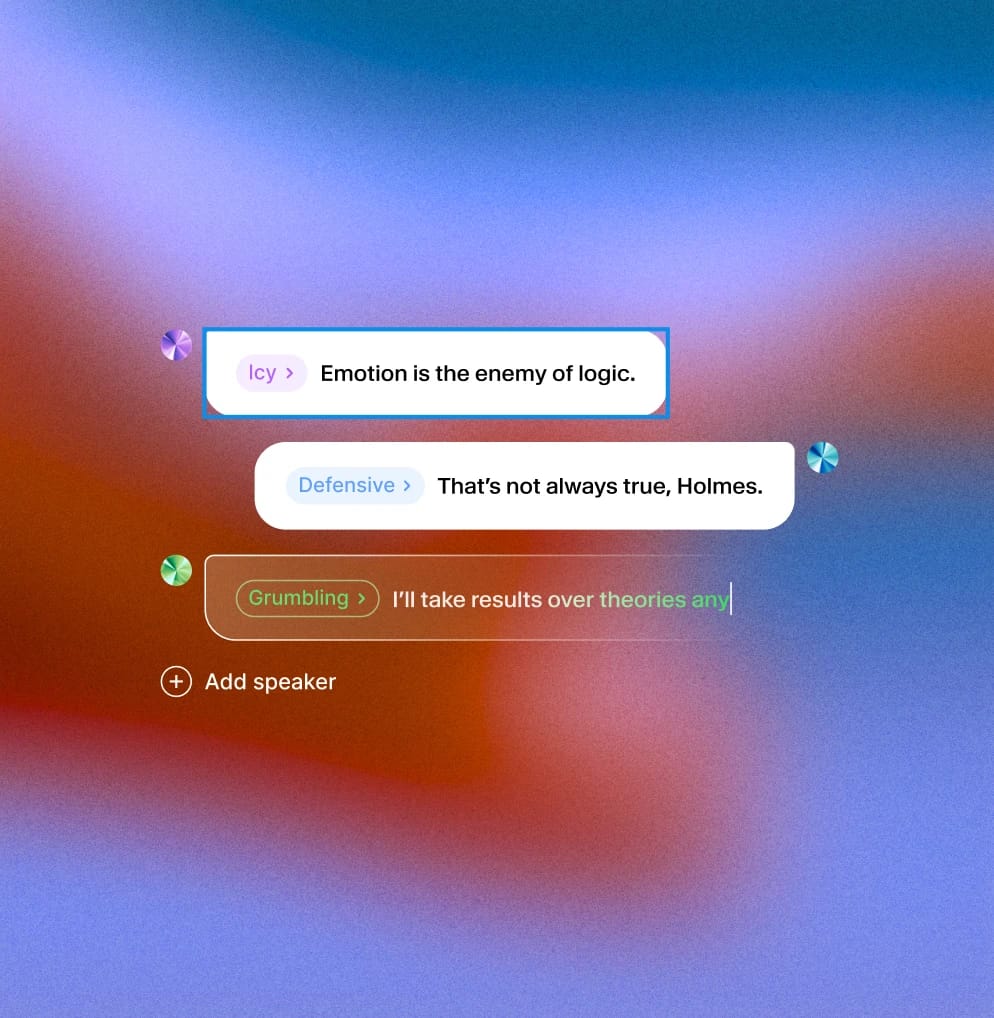
Audio Tagsは、新しいEleven v3(アルファ版)のテキスト読み上げモデルの中核を担う機能です。トーン、感情、話すペースを変え、現実の状況に合わせてセリフの伝え方をコントロールできます。
最もシンプルなAudio Tagsは、角括弧で囲んだ単語です。モデルはこれを演技の指示として解釈します。感情の変化や状況の切り替わりに合わせて、文の途中でも話し方を調整できるため、AIにある程度の状況認識を持たせられます。
AI音声における状況認識とは?
状況認識とは、AIがその場に合わせて話し方を調整することです。Audio Tagsを使えば、モデルが何を話すかだけでなく、どう反応するかもコントロールできます。
[SHOUTING]タグで緊迫感を加えたり、[WHISPER]で警告をやわらげたり、[SIGH]でためらいを表現したり。タグを使えば、ナレーションが演技へと変わります。特に、文脈が重要なシーンや変化の多い場面で効果を発揮します。
ただ読むだけではない、演技
11 United対12 Unitedのサッカー試合を題材に、Veo 3のハイライト動画を作る場面を想像してください。プレーに合わせて盛り上がりを高めたい場合は、こう書けます。「ディフェンダーを1人かわした—[EXCITED]クロスが上がる—[SHOUTING] ゴォォォール!」
あるいは、オーディオブックで緊迫した場面に声を当てるなら、「[WHISPERING]家の中に誰かいる気がする。[PAUSE] 静かにして。」
これらは単なるスタイル上の追加要素ではありません。その瞬間を形づくり、感じ方を左右します。モデルは読むだけではなく、演じるのです。
状況に応じて使える主なタグ
Audio Tagsでは、さまざまな感情や身体的な表現を再現できます。
- 感情のトーン: [EXCITED], [NERVOUS], [FRUSTRATED], [TIRED]
- リアクション: [GASP], [SIGH], [LAUGHS], [GULPS]
- 音量とエネルギー: [WHISPERING], [SHOUTING], [QUIETLY], [LOUDLY]
- ペースとリズム: [PAUSES], [STAMMERS], [RUSHED]
タグを重ねれば、より繊細な表現も可能です。「[NERVOUSLY]ぼく…ぼくには、これがうまくいくか分からない。[GULPS]でも、とにかくやってみよう。」
思いどおりに演出できるパフォーマンス
Eleven v3は、より深い文脈モデルでこれらのタグをサポートします。セリフの途中でトーンを変えたり、中断を処理したり、流れを維持したりできるため、台本を書き直さなくても、より自然な話し方を実現できます。
ボイスデザイン担当者、ゲームデベロッパー、ストーリーテラーにとって、これは新たなクリエイティブの可能性を開きます。セリフを書くだけではありません。演出もできるのです。
適切な音声を選ぶ
プロフェッショナルボイスクローン(PVC)は現在、Eleven v3向けに完全には最適化されていないため、以前のモデルと比べてクローンの品質が低下する可能性があります。この研究プレビュー期間中にv3の機能を使用する必要がある場合は、プロジェクトに適したInstant ボイスクローン(IVC)またはデザイン済みの音声を選ぶことをおすすめします。v3向けのPVC最適化は、近いうちに提供予定です。
ライアンはBBCやFuture Plcでの役職を含む、20年以上のニュースと出版の経験を経てElevenLabsに参加しました。コンテンツ戦略とストーリーテリングに注力し、ElevenLabsの物語を形作り、共有する手助けをしています。