
LLMとは?言語モデルの実践ガイド
- 公開日
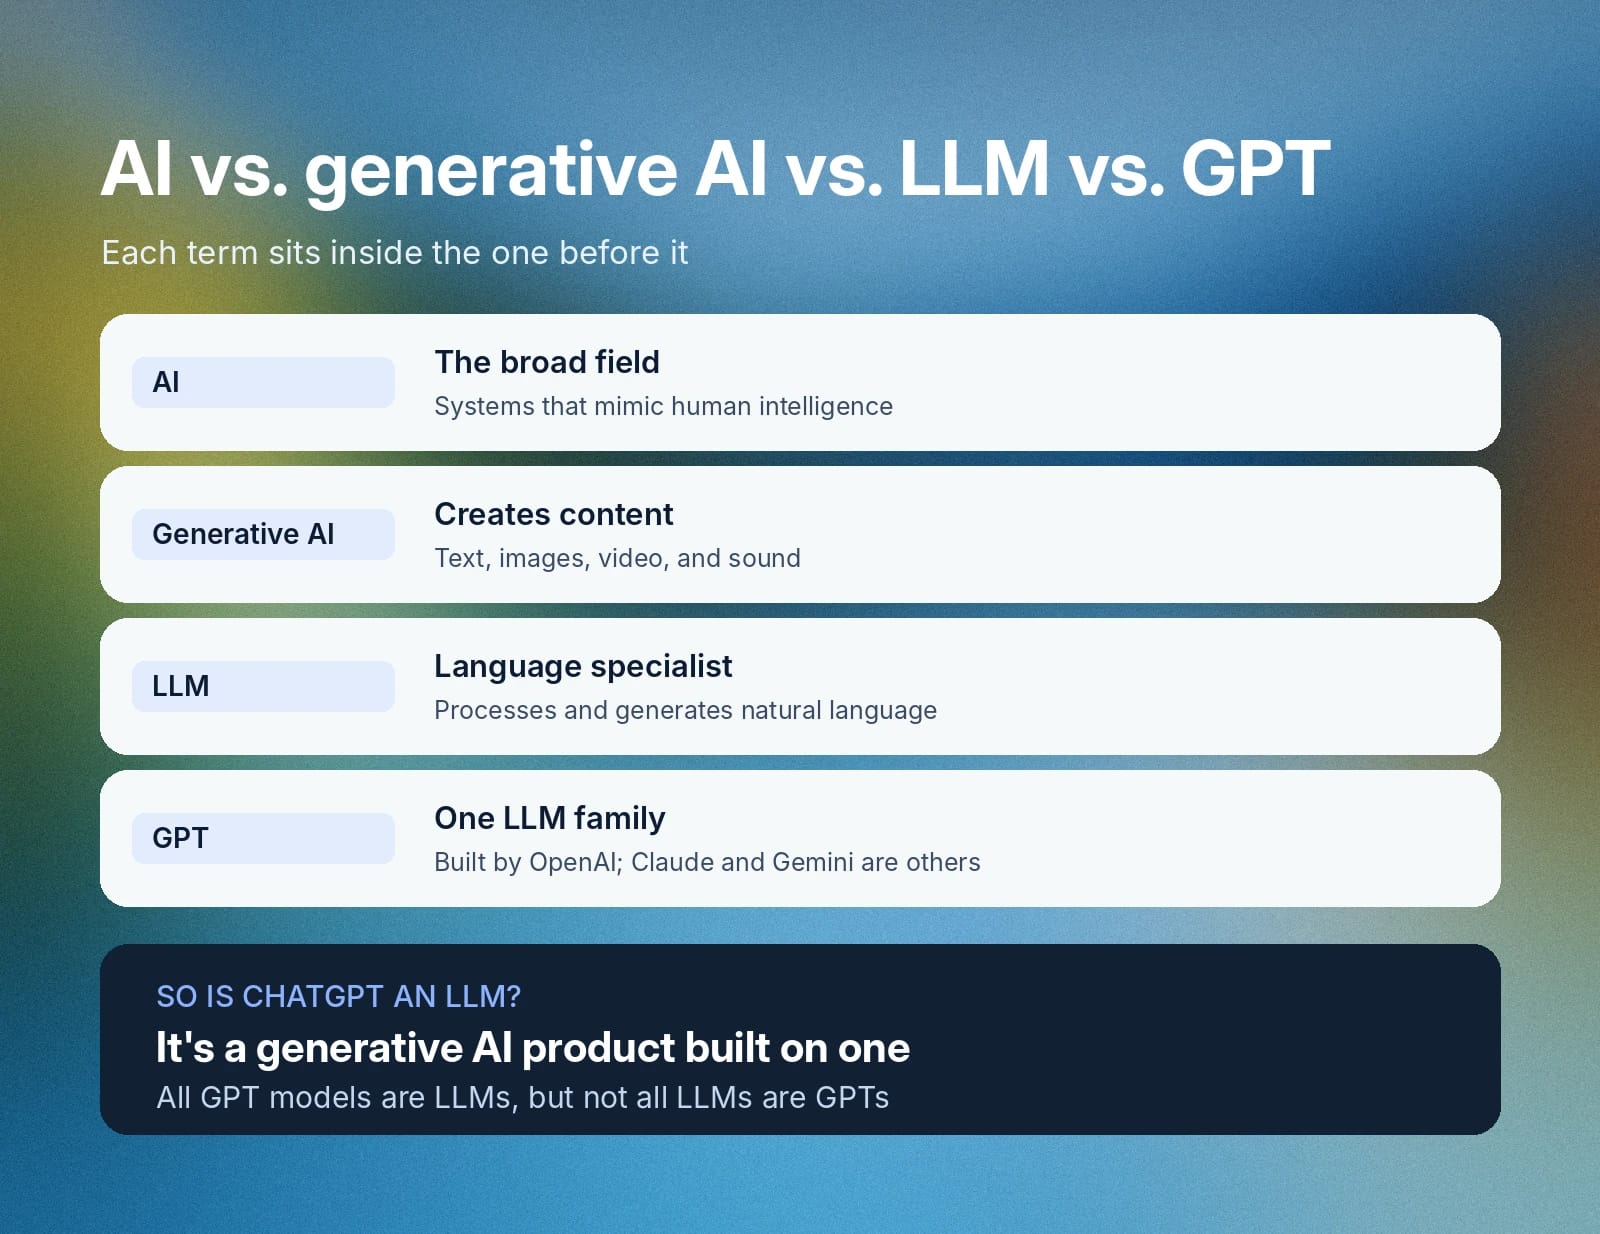
大規模言語モデル(LLM)は、膨大なデータセットでトレーニングされ、自然言語を分析、予測、生成する人工知能システムです。代表的なLLMには、OpenAIのGPTモデル、AnthropicのClaude、GoogleのGeminiなどがあり、文章作成、編集、コーディングなどによく使われています。
初期のLLMデータセットは、主に書籍、ブログ、オンラインフォーラムなどのテキストで構成されていました。現在のLLMはマルチモーダルデータも活用し、会話型音声エージェントの稼働や音楽制作など、用途を広げています。
このテクノロジーを導入する前に、多くの組織は「LLMとは何か」「LLMはどう機能するのか」「どのアーキテクチャを採用すべきか」といった疑問に直面します。このガイドでは、こうした疑問に答えながら、実際の活用例と具体的なメリットも紹介します。
要約
- 大規模言語モデル(LLM)は、出力の分析、予測、生成を目的として、膨大なテキストおよびマルチモーダルデータセットでトレーニングされた人工知能モデルです。
- GPTとLLMの主な違いは、GPT(Generative Pre-trained Transformer)がOpenAIによって開発された特定のLLMファミリーであるのに対し、LLMはClaudeやGeminiなどのモデルを含む総称であることです。
- 生成AIは、トレーニングデータに基づいて幅広いコンテンツを生成するモデルの総称です。一方、LLMは自然言語処理に特化した生成AIの一種です。
- LLMは、Transformerニューラルネットワークを使ってテキストをトークンと呼ばれる小さな単位に分割し、プロンプトや既存のチャット履歴の文脈情報に基づいて次のトークンを予測します。
- 大規模言語モデルの実用例には、カスタマーサービス用チャットボット、自動文章作成ツール、コードジェネレーター、音声アプリケーション向けの自然言語処理レイヤーなどがあります。
LLMとは?大規模言語モデルの定義
大規模言語モデルは、自然言語を分析、予測、生成するために、ディープラーニングのニューラルネットワーク上に構築されたAIプログラムです。書籍、学術論文、ウェブサイト、ブログなど、数十億件の著作物を含むデータセットでトレーニングされています。「大規模」という言葉は、トレーニングに使われる膨大なデータ量と、モデルの動作を左右する数十億もの内部パラメーターの両方を指します。
大規模言語モデルは、従来のソフトウェアの仕組みを大きく変えました。従来のソフトウェアは明示的な構文コマンドに依存していましたが、LLMはそうではありません。単語を個別に処理するのではなく、文脈上の関係を使って複雑な言語パターンや文法を認識します。構造化されていない人間の言葉を解釈し、会話の途中で文脈が変化しても適応しながら、自由形式のユーザープロンプトに応答し続けます。
こうした自然言語処理の進歩により、ElevenAgentsは複雑な顧客の意図を理解し、自動化されたワークフローを実行できます。
大規模言語モデルの仕組み
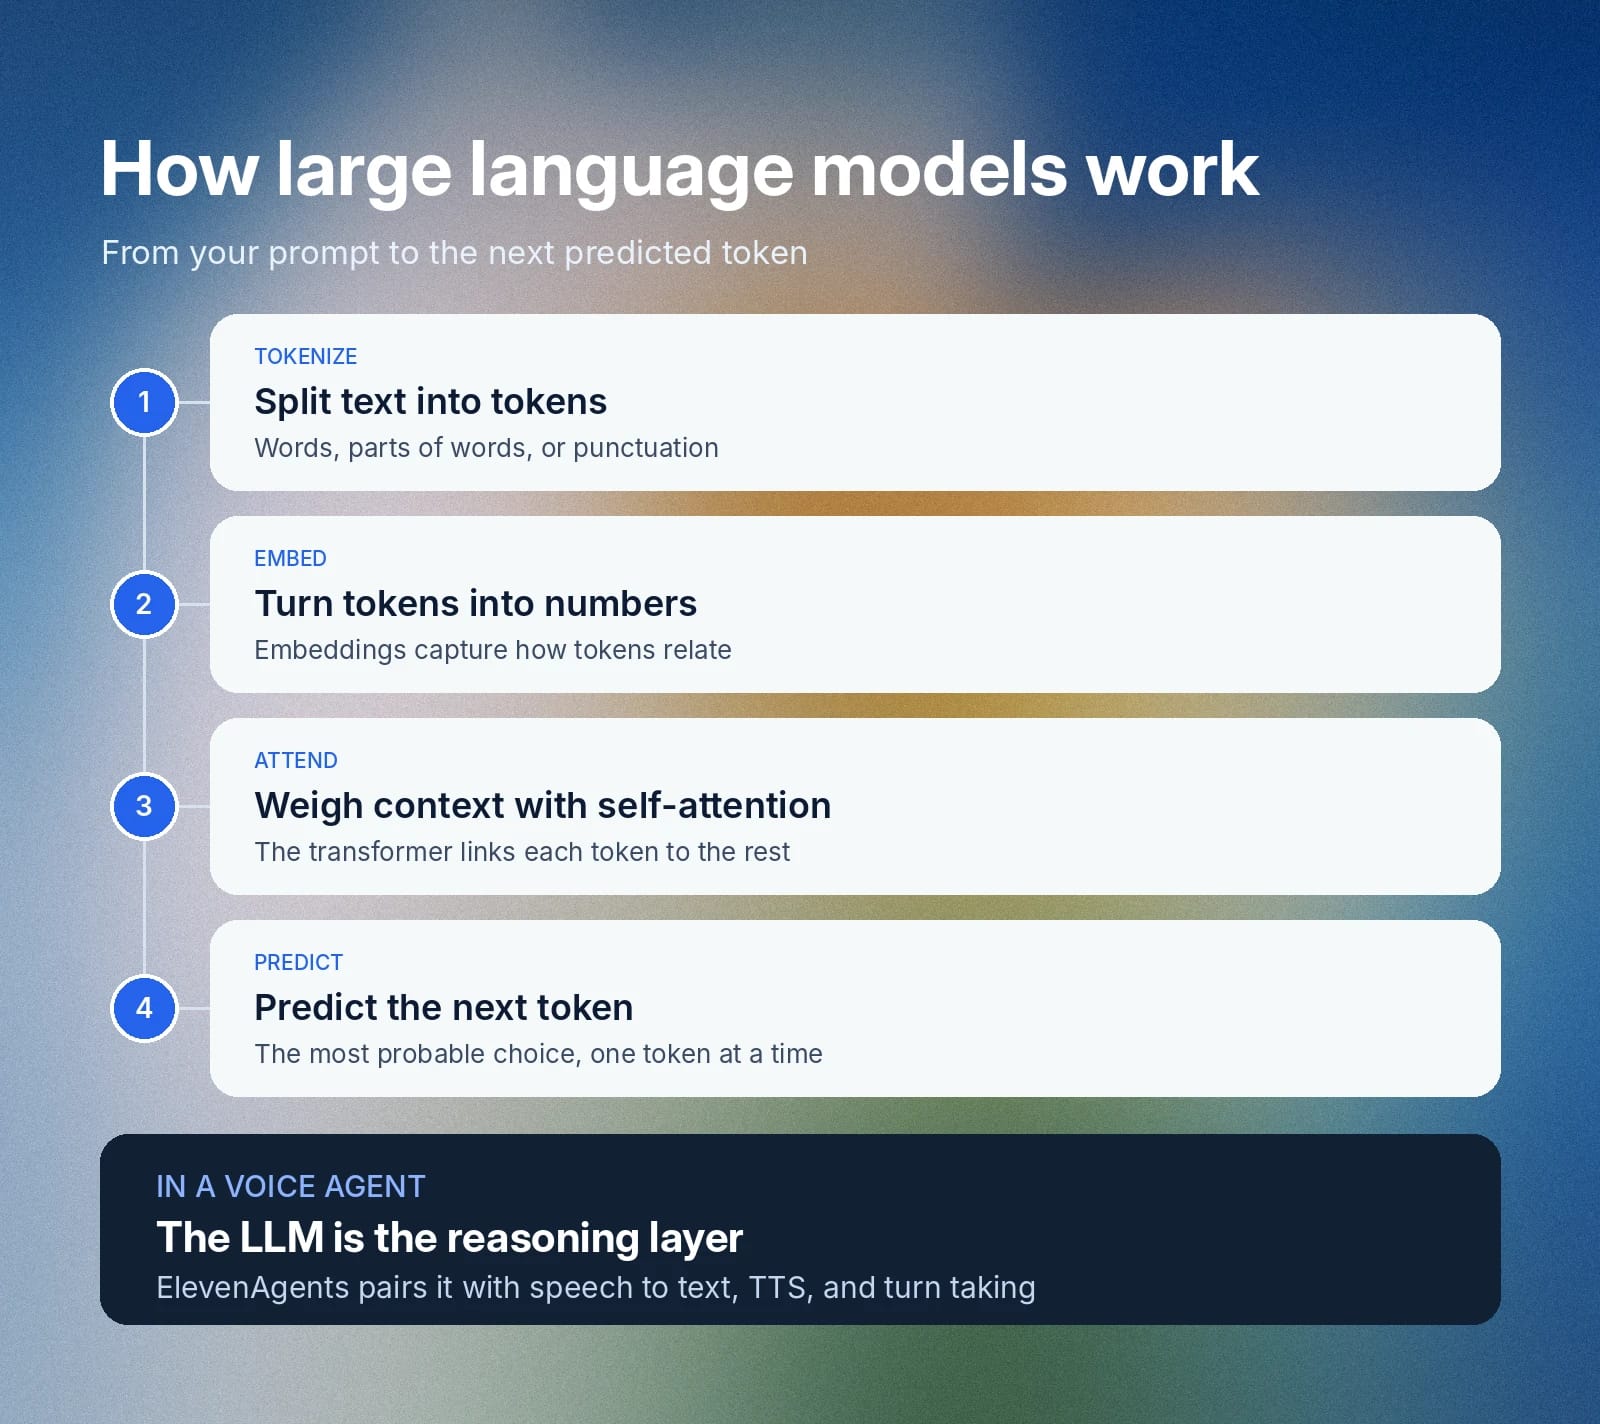
大規模言語モデルは、人工ニューラルネットワークでテキストを処理し、自然言語の入力を分析して関連性の高いコンテンツを生成します。まずトークン化を行い、入力テキストをトークンと呼ばれる小さな単位に分割します。次に、トークンを埋め込み(Embedding)と呼ばれる数値表現に変換し、トークン間の数学的または統計的な関係を評価します。
現在のLLMシステムの多くは、Transformerニューラルネットワークのアーキテクチャを採用しています。Transformerは自己注意(Self-Attention)機構を使い、トークン間の文脈上の関係を評価します。学習したパターンから確率分布を計算し、シーケンスを完成させるうえで統計的に最も可能性の高いトークンを予測します。
自己注意により、自然言語処理モデルは長距離の文脈を維持し、会話途中の変化にも適応できます。ElevenAgentsとのプラットフォームインテグレーションは、こうした機能を活かし、人間同士の自然な会話に近い、低レイテンシーで関連性の高い応答を提供します。
LLMの温度とは?
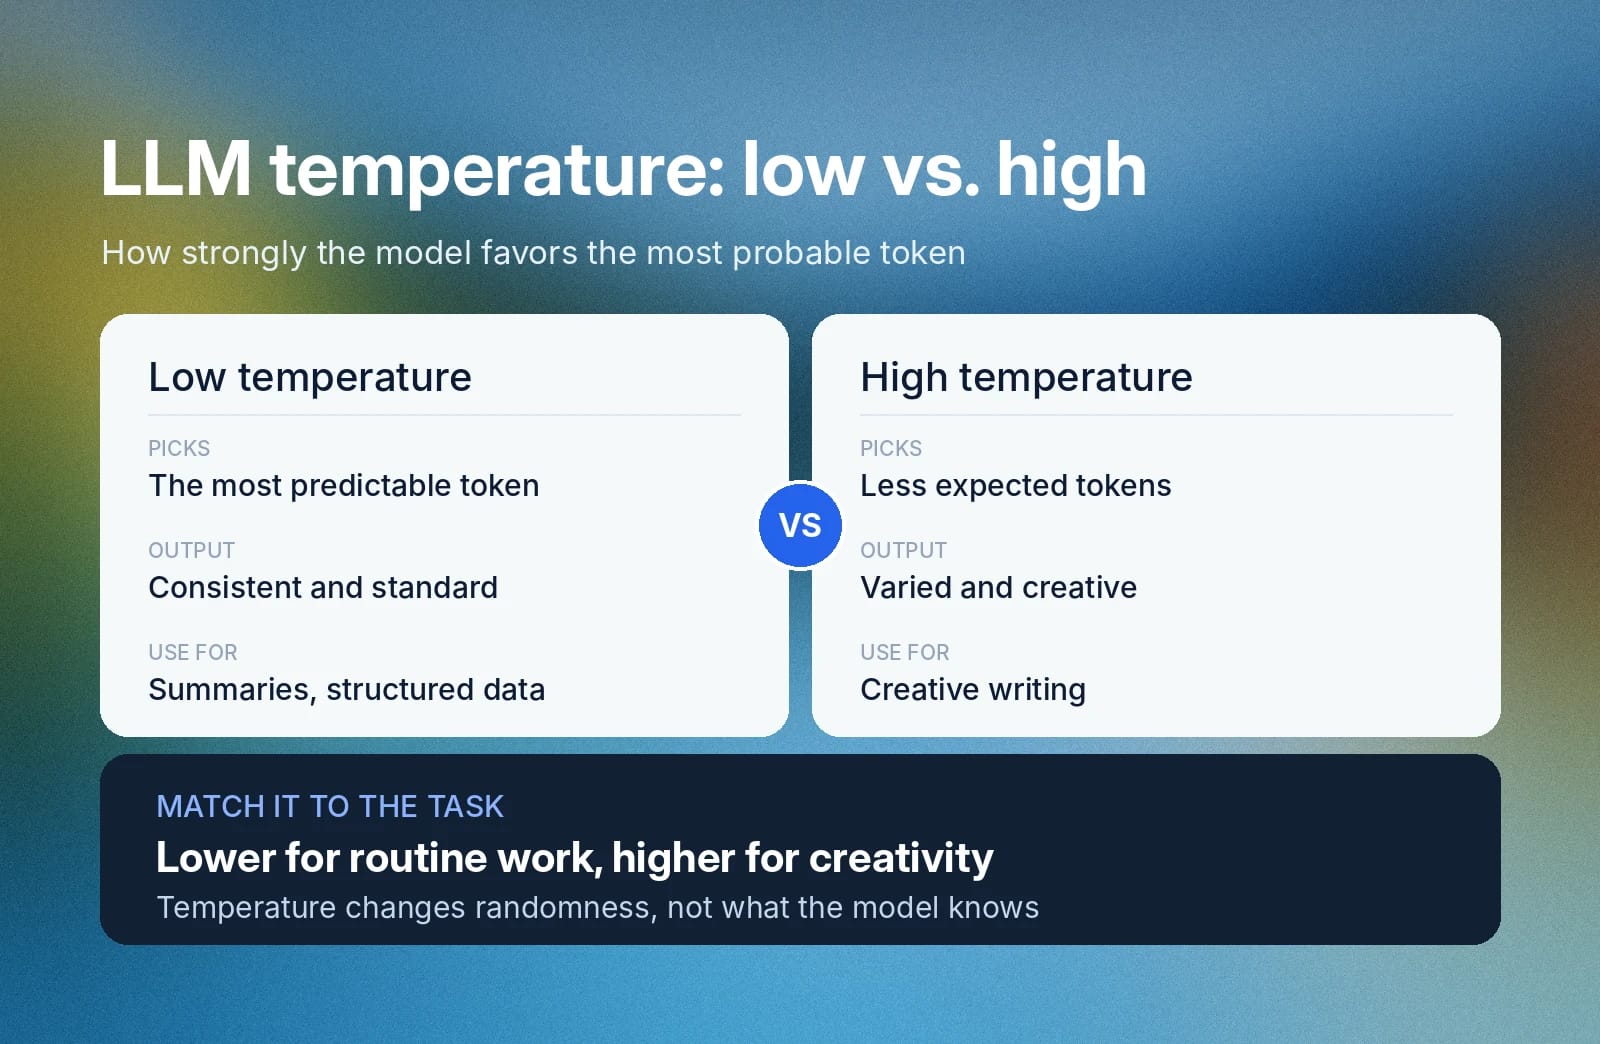
LLMの温度は、出力のランダム性を調整するためにデベロッパーが設定できる変数です。LLMは、最も一般的な候補を選んで単語列の次のトークンを生成します。ただし、各選択には、同程度の重みを持つ候補が複数存在する場合があります。
LLMの温度を調整すると、最も確率の高い候補をどの程度優先するかが変わります。温度を低くすると、常に予測しやすい次のトークンを選ぶ傾向が強まり、標準的で一貫した出力になります。一方、温度を高くすると、予想される候補から外れる頻度が増え、より創造的で多様な出力になります。
LLMの温度は、達成したいタスクに合わせて調整してください。創造性が必要なタスクでは高めに、定型作業やデータ要約のような構造化された出力では低めに設定するのが適しています。
LLMのトレーニングと微調整の方法
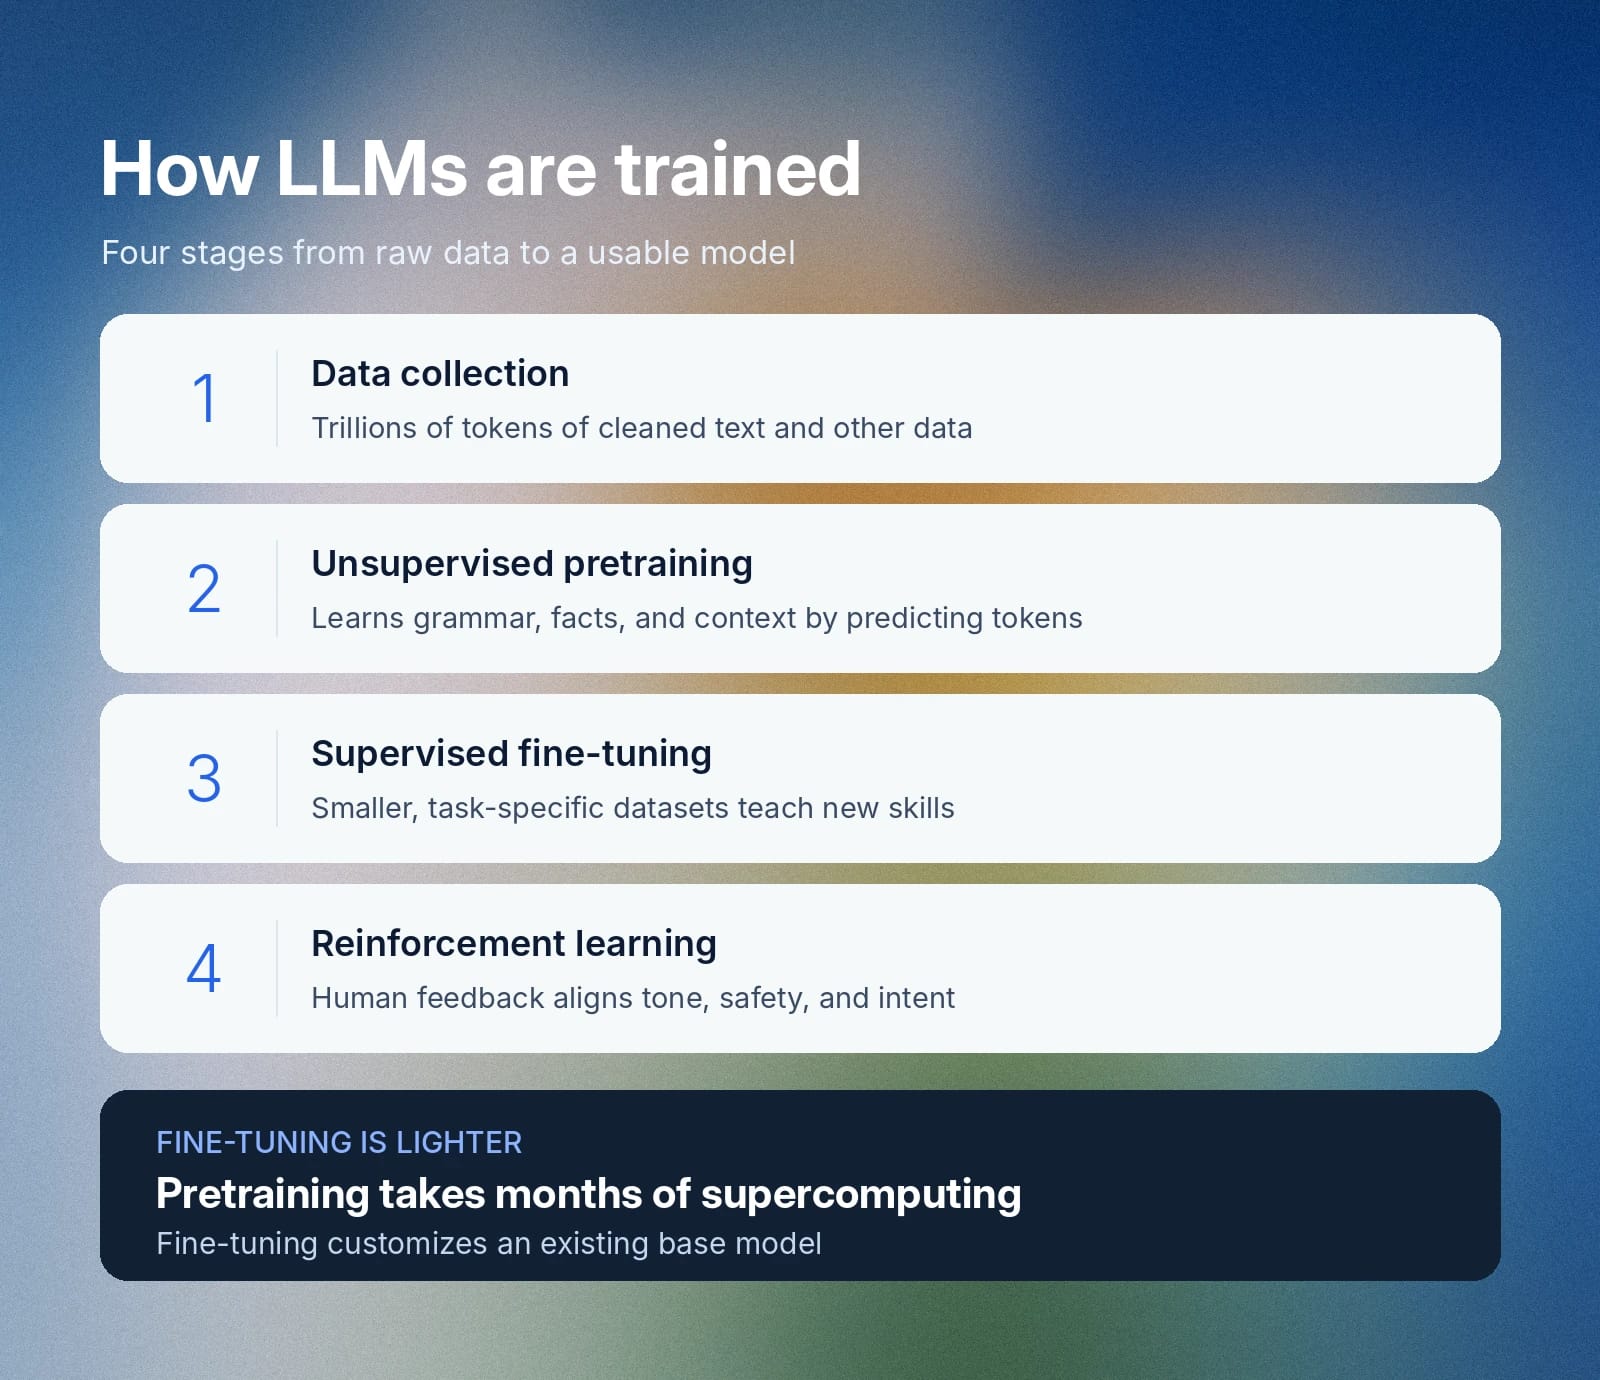
LLMのトレーニングでは、生のテキストやマルチモーダルデータを実用的な言語システムに変換するために、複数段階のプロセスが必要です。企業には、高度なスーパーコンピューティング環境を数か月稼働させる能力が求められます。一方、微調整は既存のベースモデルをカスタマイズする、比較的負荷の軽いプロセスです。
最先端のAI企業は、詳細なトレーニングプロセスを機密情報として扱う傾向があり、ほとんどの企業はソースコードや重みを公開していません。それでも、一般的には次の手順でトレーニングします。
- データ収集と前処理:デベロッパーは複数のソースからデータセットを構築します。事前トレーニング用コーパスには、クリーニング済みの数テラバイトのテキストから抽出した数兆個のトークンが含まれます。インターネット上のソースからテキストをスクレイピングまたは抽出することは、企業がこうしたデータセットを構築する主な方法の一つです。
- 教師なし事前トレーニング:大規模言語モデルは数兆個のトークンを読み込み、文法規則、事実関係、言語的文脈を学習します。シーケンス内で統計的に可能性の高い次のトークンを計算する自己注意機構を利用した自己回帰型言語モデリングにより、実質的に自己学習します。
- 教師あり微調整:エンジニアは、より小規模でタスクに特化したデータセットを使って、事前トレーニング済みモデルを調整します。この段階で、一般的な質問への回答からロゴ生成、研究室での調査まで、特定の能力をモデルに学習させます。
- 強化学習とアラインメント:デベロッパーは、人間のレビュアーからのフィードバックと報酬モデルを使って、モデルの動作を改善します。この段階で、モデルの出力をセーフティガイドライン、トーン要件、人間の意図に合わせます。
LLMアーキテクチャの種類:エンコーダー、デコーダー、ハイブリッドモデル
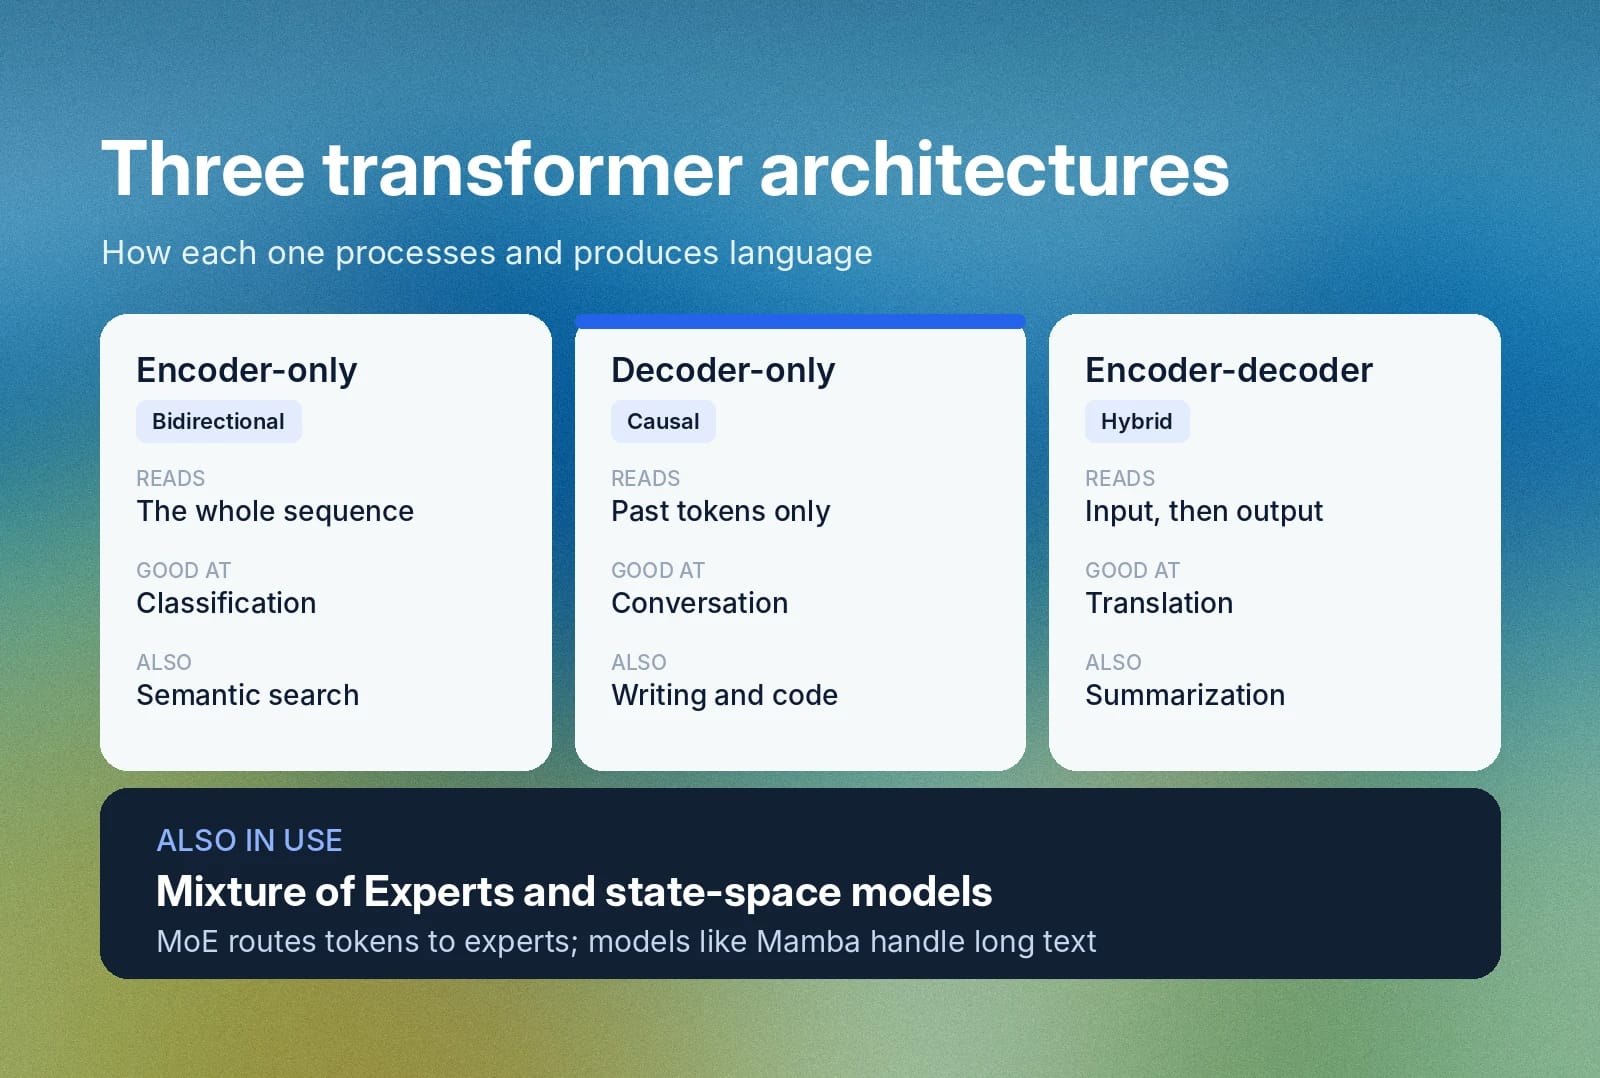
Transformerアーキテクチャは、ニューラルネットワークのレイヤーをさまざまな方法で構成し、入力を処理してコンテンツを生成します。従来のTransformerは、エンコーダーのみ、デコーダーのみ、エンコーダー・デコーダー(ハイブリッド)モデルの3種類に大別されます。ただし、現在のシステムには、性能を拡張するための効率重視のアーキテクチャも組み込まれています。
エンコーダーのみのモデル
エンコーダーのみのアーキテクチャは、双方向の自己注意を使ってシーケンス全体を一度に処理します。これにより、各トークンと過去および未来のほかのトークンとの関係を比較評価できます。実際には、次のようなタスクに適しています。
- テキスト分類
- 感情分析
- 情報検索
- セマンティック検索
こうしたタスクは音声ワークフローでも使われます。ElevenLabsのScribeスピーチtoテキストモデルは、90以上の言語で音声を文字起こしし、エンティティ検出機能によって文字起こし内の機密情報や攻撃的な表現を検出します。
デコーダーのみのモデル
デコーダーのみのアーキテクチャは、因果的注意を使ってトークンを処理し、過去のトークンに基づいて各単語を予測します。自然で流れるような会話を生成できるため、現在の会話型チャットボット、自由形式の文章作成アシスタント、コード生成ツールの主要なアーキテクチャとして使われています。
ElevenAgentsでは、選択したLLM(通常はデコーダーのみのモデル)がエージェントの応答を生成し、独自のターンテイキングモデルが会話のタイミングを管理します。
エンコーダー・デコーダー(ハイブリッド)モデル
エンコーダー・デコーダーモデルは、エンコーダーで入力を処理し、デコーダーで出力を生成します。この二重構造により、文書の要約、言語翻訳、データの再フォーマットなど、文脈を厳密に保持する必要があるタスクに適しています。
翻訳は代表的なエンコーダー・デコーダータスクであり、ElevenLabsのダビングは90以上の言語に対応しています。
Mixture of Experts(MoE)と状態空間モデル
Mixture of Experts(MoE)は、単語ごとにニューラルネットワークの全パラメーターを動作させるのではなく、個々のトークンを特化型の小規模な「エキスパート」サブネットワーク群に振り分けます。これにより、大規模モデルに匹敵する推論の深さを保ちながら、処理を高速化し、計算コストを削減できます。一方、Mambaなどの状態空間モデルは、極めて長いテキストを効率的に処理します。
ElevenAgentsには、ElevenLabsが自社インフラでホストするオープンソースLLMも用意されています。
大規模言語モデルの例と日常的な用途
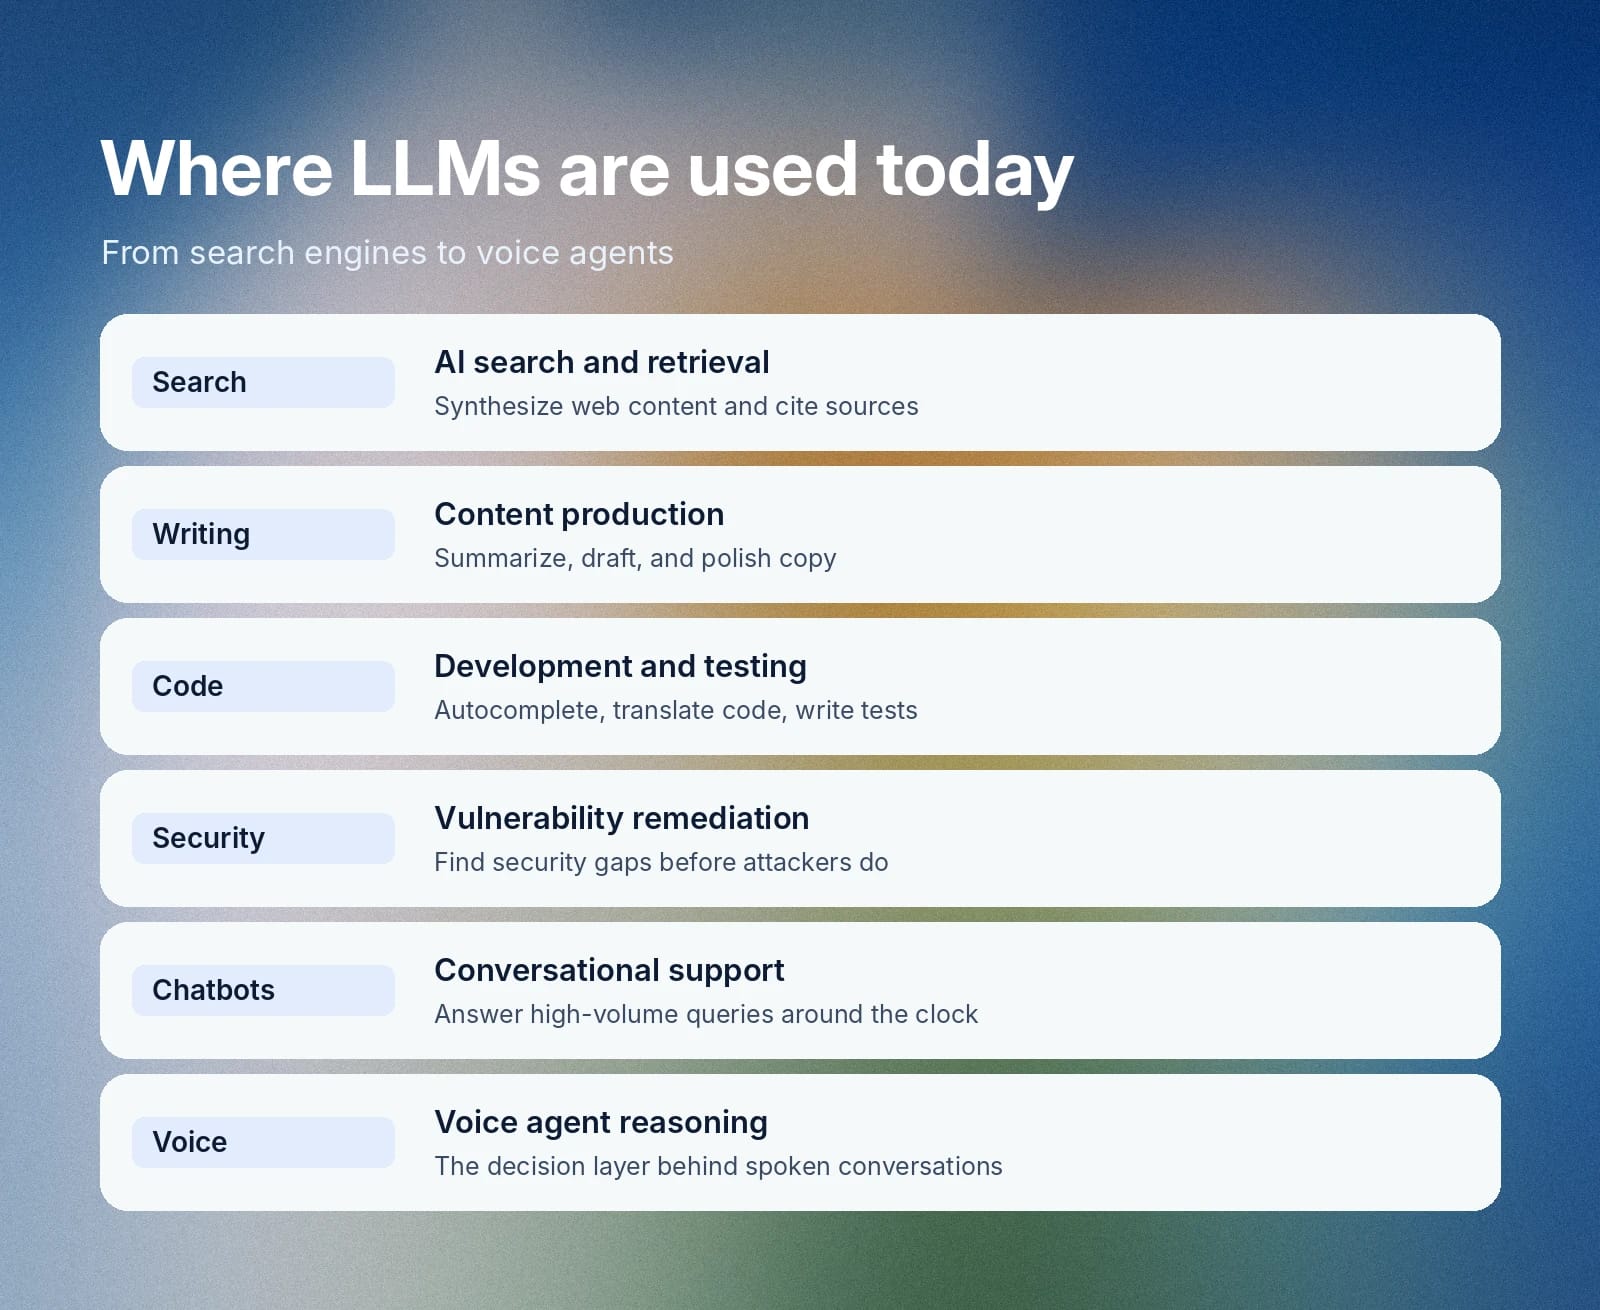
大規模言語モデルは、組織で幅広く活用されています。こうしたユースケースは、AIが実験的な研究から、ウェブ、ソフトウェアアプリケーション、日常的なデバイスの標準機能へと発展した過程を示しています。AI研究者が基盤アーキテクチャの研究と最適化を続ける一方、実際のLLMの例からは、各チームがこれまでどのように導入してきたかがわかります。
- AI検索と情報検索:Bing、Google AI Overviews、Perplexityなどの会話型検索エンジンは、LLMを使ってウェブコンテンツをリアルタイムで分析します。モデルは情報をまとめ、出典を直接引用し、ユーザーからの追加質問にも対応します。
- 文章作成、編集、コンテンツ制作:LLMやその他のAIツールにより、社内外向けの資料を簡単に作成、編集できます。たとえば、NotebookLMは長いレポートを要約し、Jasper AIは広告文を作成し、Grammarlyは文章を整えます。
- コード生成、開発、テスト:AIはGitHub Copilotなどのコーディングツールを支え、関数の自動補完や、あるプログラミング言語から別の言語へのコード変換を可能にします。自動テストスイートの生成にも使えるため、デプロイ前にバグを簡単に特定して修正できます。
- サイバーセキュリティと脆弱性の修正:最先端のAI企業は、セキュリティ上の欠陥を検出する特化型モデルを公開しています。これにより、攻撃者が脆弱性を発見して悪用する前に、組織は修正を適用できます。
- チャットボットと会話型アシスタント:組織は会話型インターフェースを導入し、24時間365日のカスタマーサポートを提供しています。ElevenAgentsのようなプラットフォームを統合すれば、FAQに頼らず、会話型ソリューションで大量の問い合わせを自動処理できます。
- 音声エージェントの推論エンジン:LLMは音声AIシステムの中核的な推論レイヤーとしても機能します。ElevenAgentsは、選択したLLMにスピーチtoテキスト、低レイテンシーのテキスト読み上げ、独自のターンテイキングモデルを組み合わせ、自然なリアルタイム会話を実現します。
大規模言語モデルの制約とは?
LLMは、消費者が利用する多くのAIプロダクトの基盤であり、さまざまなワークフローやユースケースに役立つ強力なアーキテクチャです。ただし、LLMを使って開発したり、独自モデルをトレーニングしたりする場合は、主な制約を把握しておく必要があります。
- ハルシネーション:LLMが生成する内容が正確である保証はありません。応答には、捏造された情報や単純な誤情報が含まれることがあります。
- 静的な知識:RAGを使用しない場合、LLMが利用できる知識は、トレーニング時に得た既定の範囲に限られます。
- バイアス:トレーニングデータに偏りがあれば、モデルにもその偏りが反映されます。LLMでデータを分類したり、情報に関する判断を下したりする場合は、特に注意が必要です。データに潜む暗黙的なバイアスが、気付かないうちに出力へ悪影響を及ぼす可能性があります。
- 限られたコンテキストウィンドウ:LLMが一度に扱えるテキスト量は通常固定されています。そのため、会話が長くなると詳細を保持できなくなり、徐々に効果が低下する場合があります。
- コストとレイテンシー:LLMが大きいほど、実行に必要な計算リソースも増えます。より高性能なモデルを選ぶと、サービス品質の向上に応じて料金も高くなる可能性があります。
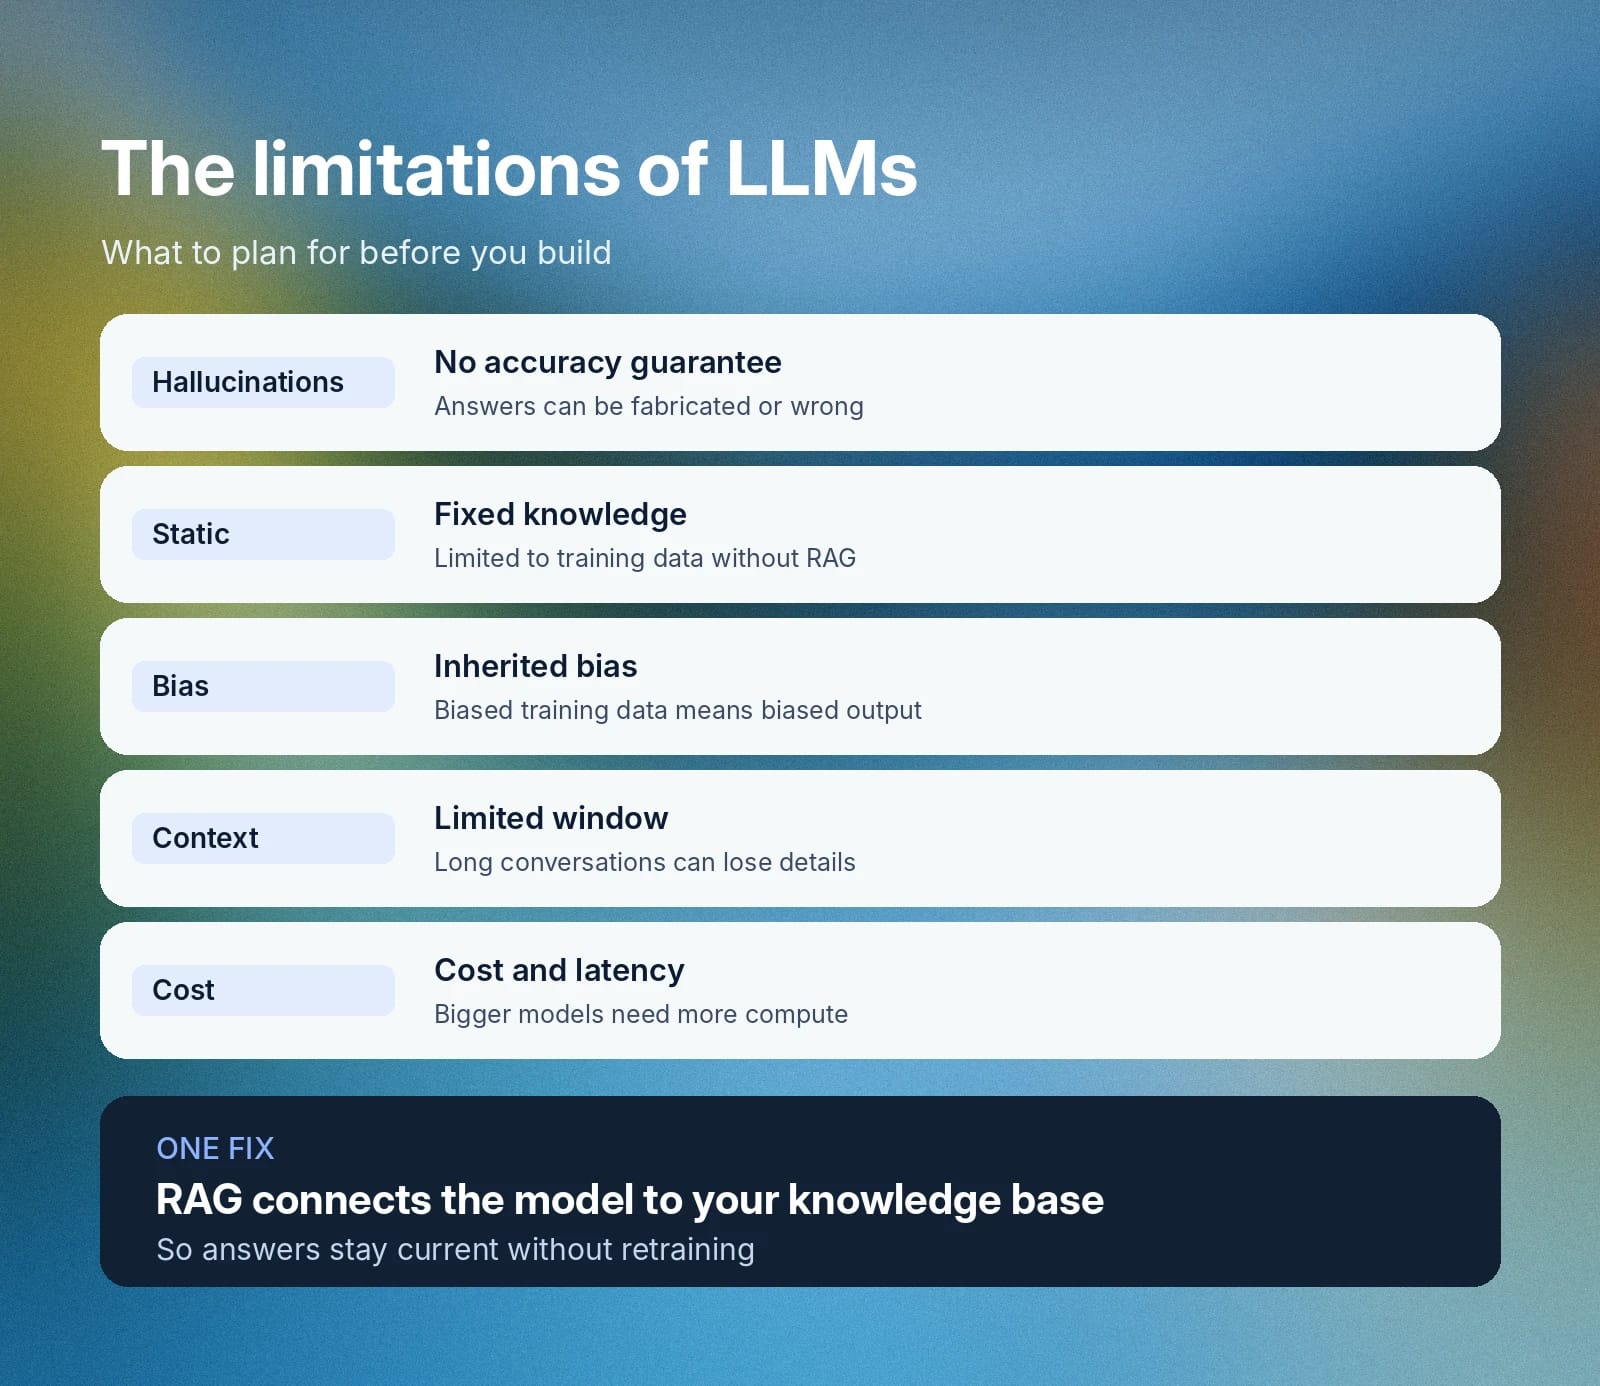
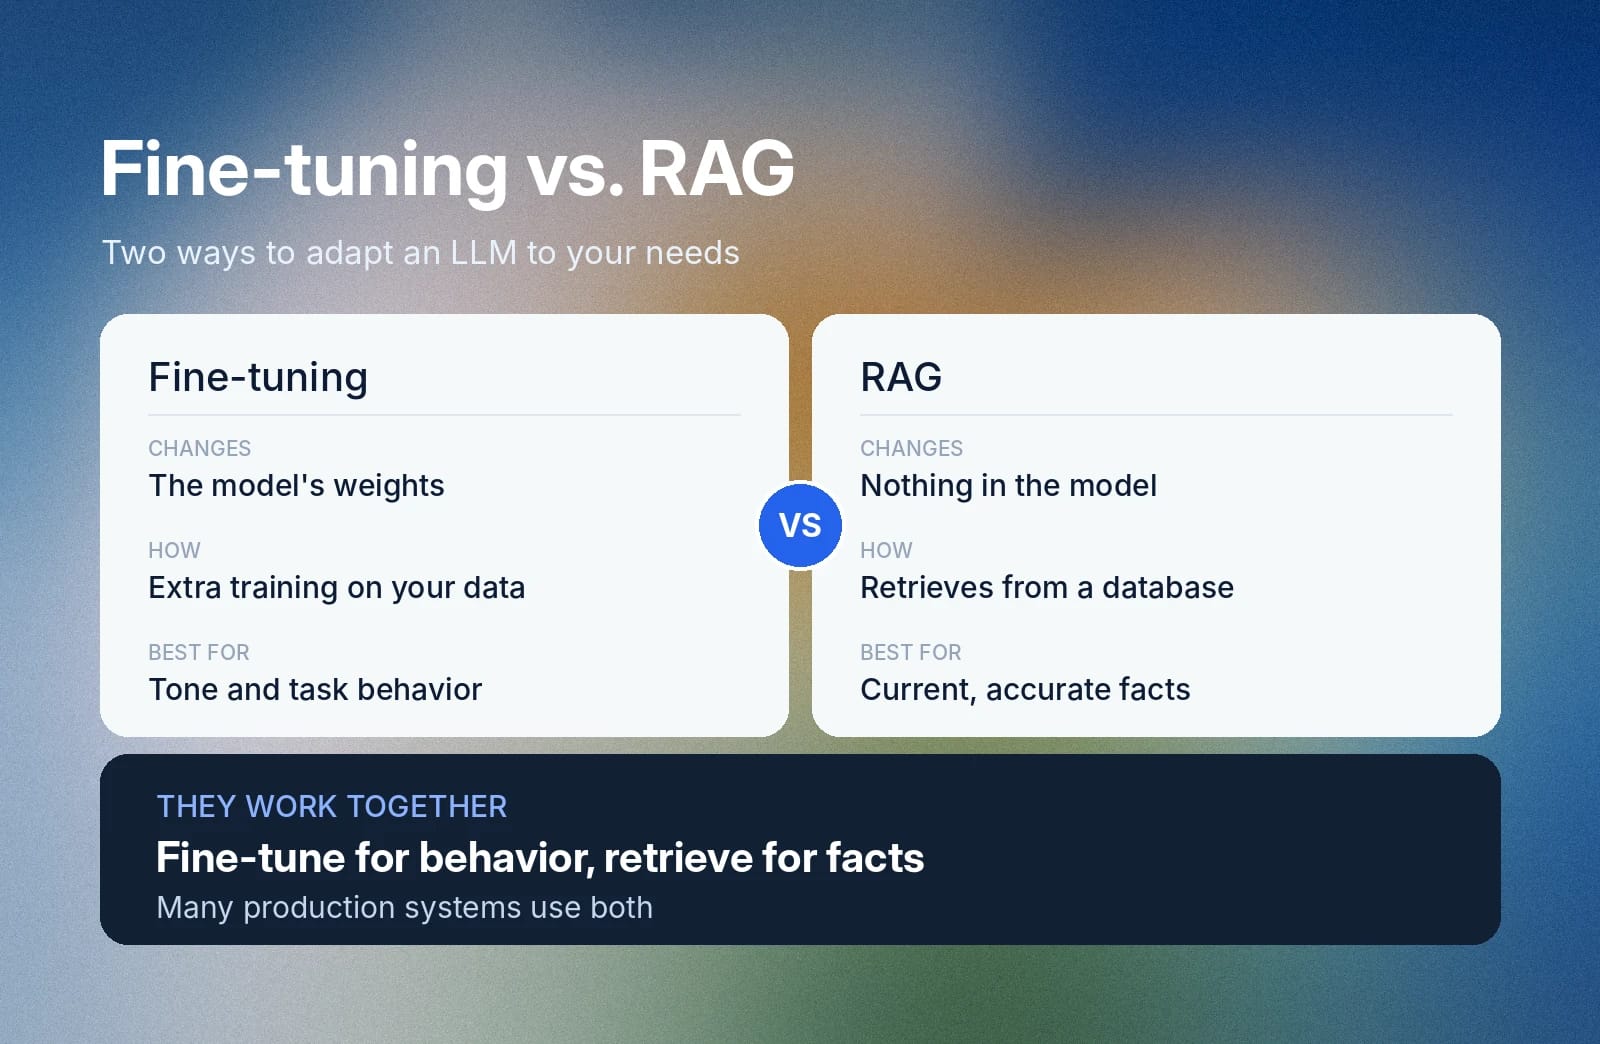
こうした制約の影響を抑えるために、検討できる戦略や実装方法はいくつかあります。たとえば、LLMでRAGを有効にし、継続的に拡張されるナレッジベースを接続すれば、静的な知識の問題を解消できます。
ElevenAgentsで音声対応のLLM体験を構築
ユースケースに合う大規模言語モデルの選択は重要です。ビジネスニーズや規制要件の変化に応じて、選択を見直す必要もあります。会話型音声AIソリューションを構築する際にベンダーロックインを避ければ、ビジネスの俊敏性と柔軟性を維持できます。
ElevenAgentsでは、OpenAI、Anthropic、Googleなどのプロバイダーが提供する対応LLMから選択できるほか、OpenAI互換エンドポイントを通じて独自のカスタムモデルを接続できます。用途に応じて、速度、推論能力、コストの最適なバランスを簡単に選べます。
ElevenAgentsでホスト型LLMが音声ワークフローを効率化する仕組みをご確認ください。または、営業に問い合わせて、低レイテンシーの音声エージェントの構築を今すぐ始めましょう。
LLMに関するよくある質問

Jack LimebearはGrowthチームに所属し、ブログやインサイトページのコンテンツライター兼ストラテジストとして活躍しています。ElevenLabsに入社する前は、急成長中のSaaSスタートアップからFortune 500企業まで、さまざまな組織で10年以上にわたりコンテンツ戦略をリードしてきました。ケンブリッジ大学で英文学の修士号を取得しています。


