
RAGとは?Retrieval-Augmented Generationの仕組み
- 公開日
- 最終更新日
聴くこの記事を聴く
AIモデルは、トレーニング中に学習した内容に基づいて回答を生成します。そのため、トレーニング後に作成された企業のポリシー、プロダクト、その他の情報を自動的に把握しているわけではありません。RAG(検索拡張生成)は、回答前に関連する外部情報を取得してモデルに渡すことで、この課題を解決します。
RAGは、AIの回答を企業の実際の文書に基づかせます。カスタマーサポートエージェントがRAGを使えば、回答前に最新の返品ポリシーやプロダクト仕様を取得でき、ハルシネーションのリスクを抑えられます。
このガイドでは、AIにおけるRAGの意味、検索と生成の連携の仕組み、RAGと単体のLLMの違いを解説します。また、RAGの制約、生成AIアプリケーションで効果を発揮する場面、RAGがAIエージェントでの知識検索をどのように支援するかについても説明します。
概要
- RAGは検索システムと生成モデルを組み合わせ、モデルがトレーニングデータを超える情報を利用できるようにします。
- RAGが取得する知識はモデルの外部にあるため、再トレーニングなしで更新できます。
- ElevenAgentsは、ナレッジベースが大きすぎてモデルのコンテキストに直接収まらない場合にRAGを自動で使用します。大規模で複雑なナレッジベースでも、精度を損なわずに高速な回答を実現します。
AIにおけるRAGとは?
RAGは、ブランドガイドライン、プロダクトマニュアル、ナレッジベースの記事、社内データベースなどの外部情報をLLMに提供するためのシステムアーキテクチャです。これによりAIはビジネス固有の情報を扱えるため、最新のポリシー、非公開の知識、モデルがトレーニングされていない企業情報を回答に反映できます。
LLMが一度に扱える情報量にも限りがあり、これをコンテキストウィンドウと呼びます。大規模な組織のナレッジベースはこの上限をすぐに超える可能性があるため、RAGは情報をLLMの外部に保持し、現在の質問に必要な箇所だけを取得します。
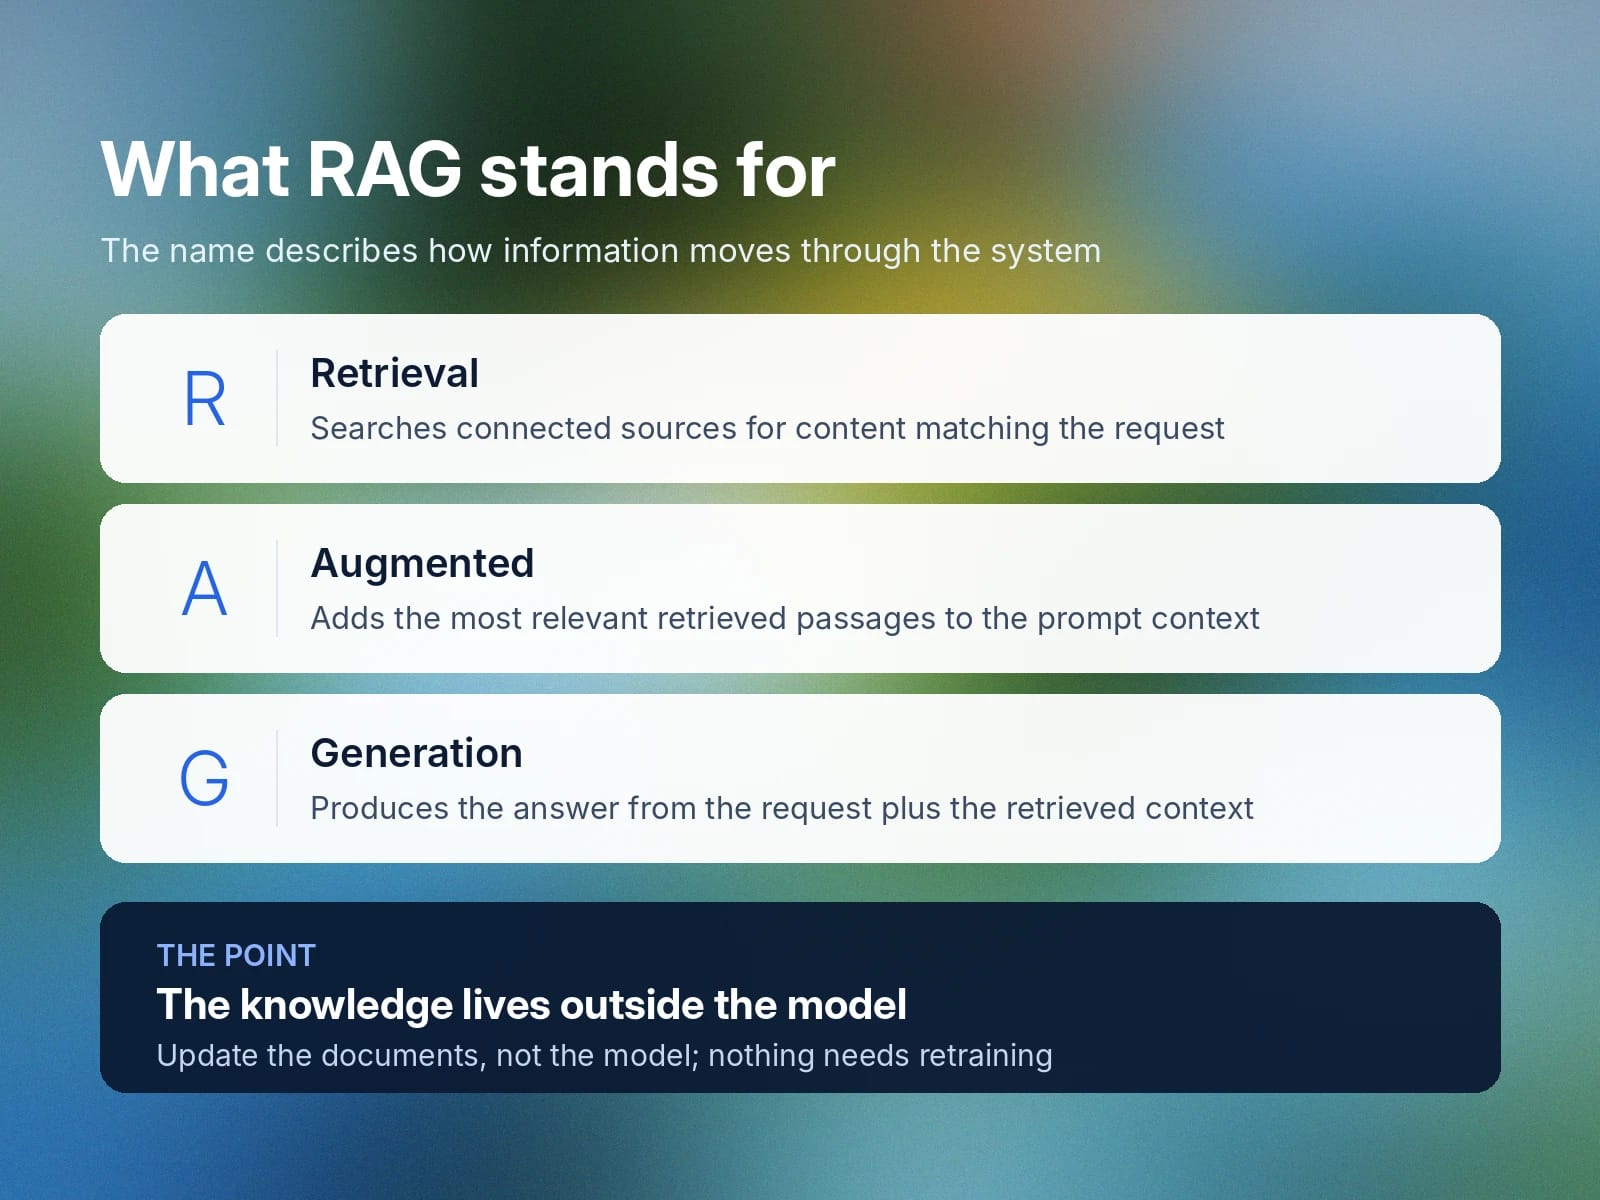
この名称は、情報がシステム内をどのように流れるかを表しています。
- 検索:ポリシー文書、ヘルプデスクのログ、在庫ファイルなどの接続されたソースから、ユーザーのリクエストに合致するコンテンツを検索します。
- 拡張:取得した情報のうち最も関連性の高い箇所を、プロンプトのコンテキストに追加します。
- 生成:ユーザーのリクエストと取得したコンテキストを使って回答を生成します。
RAGは、回答の生成時にLLMへ関連資料を渡すことで、AIの回答を特定のソース情報に結び付けるグラウンディングも支援します。たとえば、顧客が保証ポリシーについて尋ねた場合、RAGシステムは企業文書から該当する条件を取得し、LLMに渡して回答を生成します。
検索拡張生成はどのように機能する?
RAGシステムは外部知識を検索できるよう準備し、ユーザーの質問に最も関連する情報を取得して、応答を生成する前にコンテキストとしてLLMに渡します。
RAGの実装は複雑さがさまざまです。基本的なRAGではシンプルな検索・生成プロセスを使いますが、より高度なアプローチでは、クエリの書き換え、フィルタリング、再ランキング、その他の検索技術を加える場合があります。
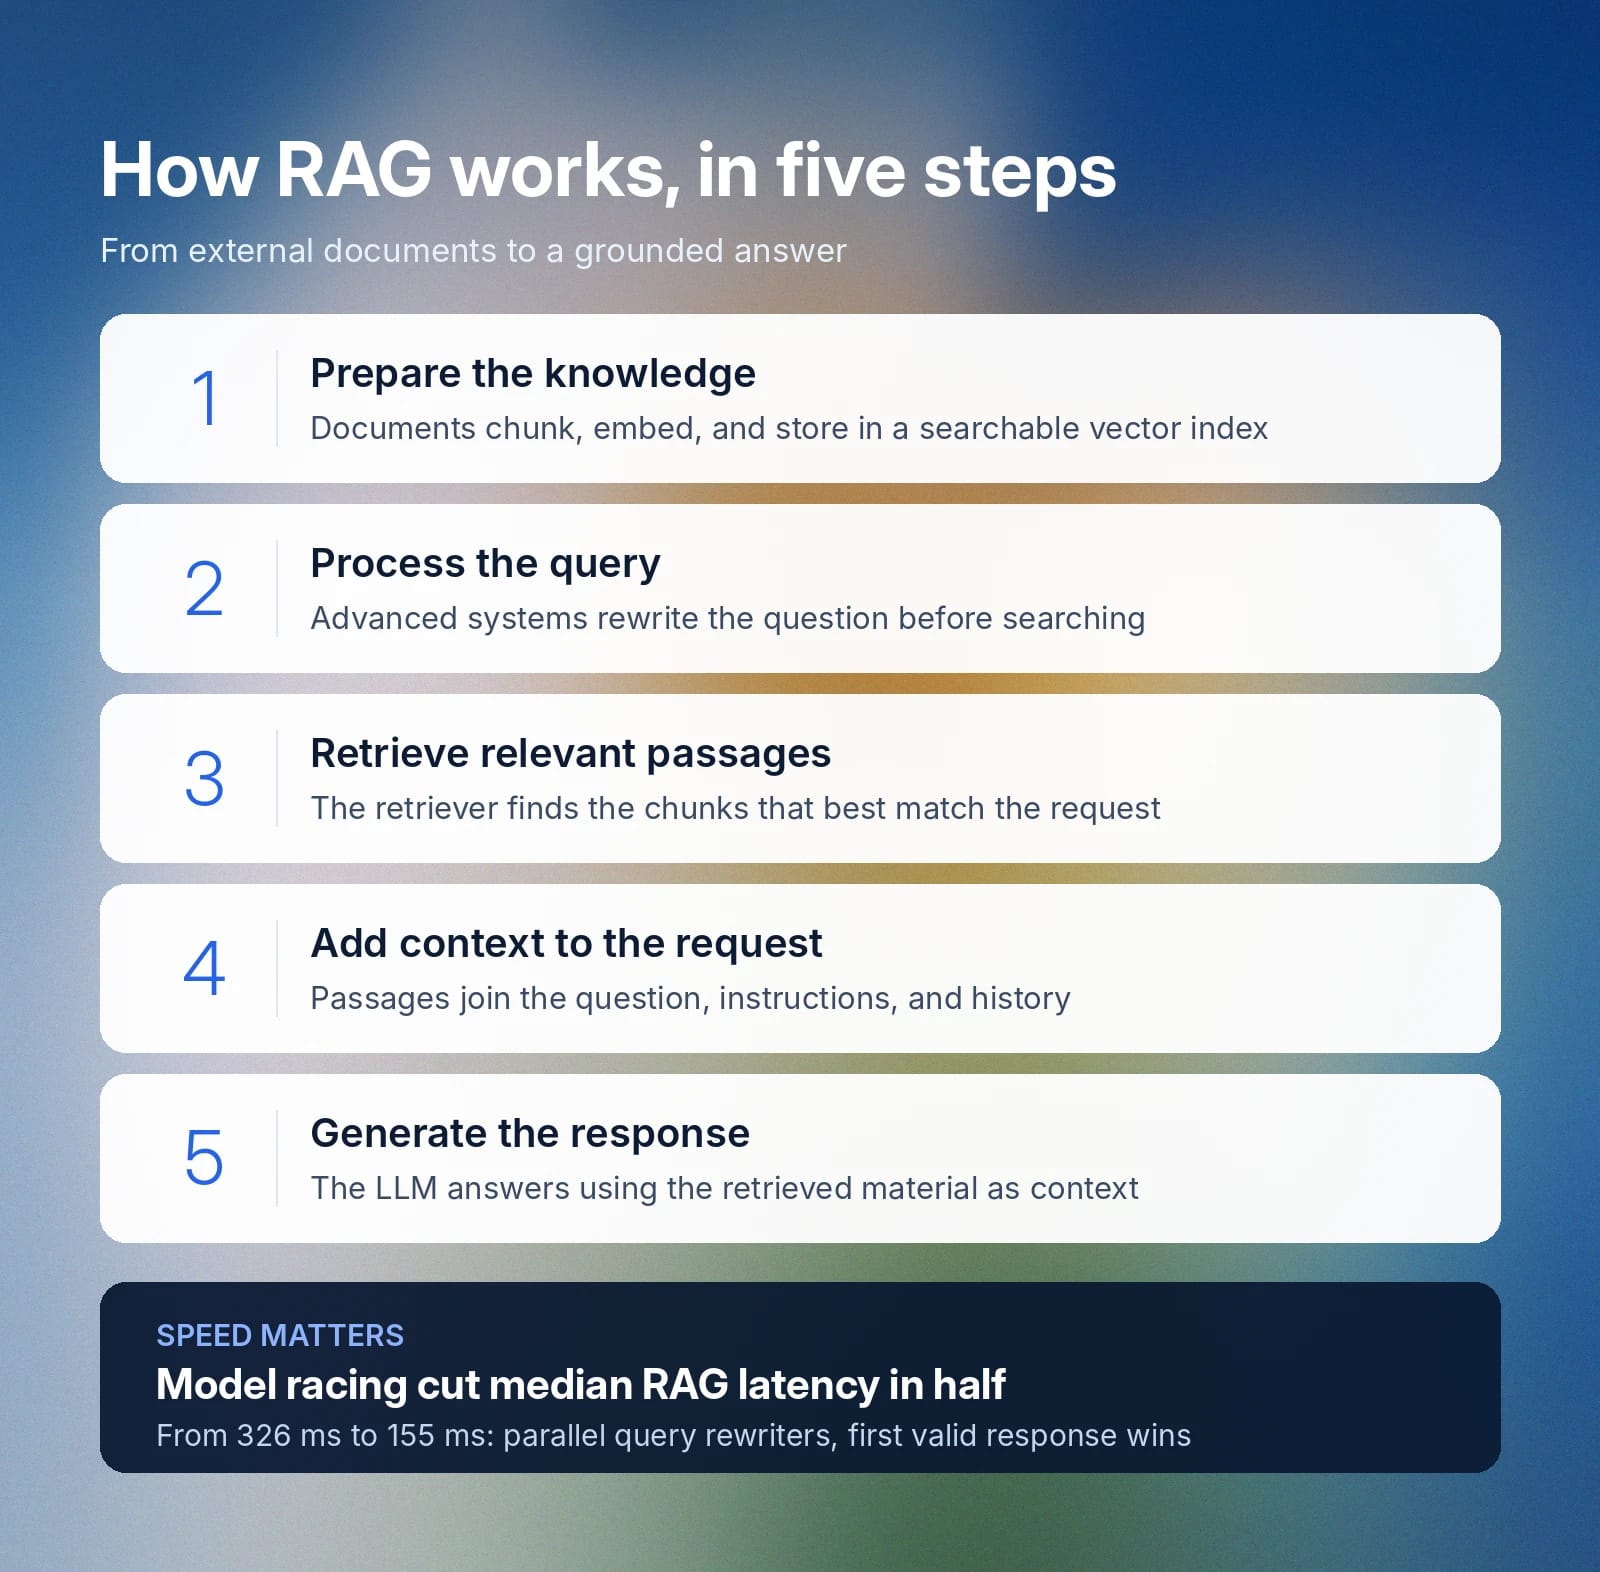
RAGのプロセスは通常、次の5つのステップで進みます。
- 知識を準備する:文書を小さな文章単位に分割する(「チャンク化」と呼ばれるプロセス)、埋め込み(embedding)と呼ばれる数学的表現に変換する、検索可能なインデックスまたはベクトルデータベースに保存する、という手順を行います。
- クエリを処理する:システムはユーザーの質問を解釈し、より高度なRAGシステムでは検索前に質問を書き換えたり、洗練したりします。
- 関連する箇所を取得する:リトリーバーがインデックス化されたナレッジベースを検索し、リクエストに最も適したテキストチャンクを取得します。
- モデルへのリクエストにコンテキストを追加する:選択した箇所を、ユーザーの質問、関連する指示、会話履歴とともにLLMへ送ります。
- 応答を生成する:LLMは取得した資料をコンテキストの一部として使い、回答を生成します。
多くのRAGシステムは、外部ツールとして必要なときにのみ検索を実行します。ElevenAgentsでは、エージェント設定からナレッジベースに対するRAGを直接有効にできます。また、会話のフォローアップ時には、クエリの書き換えによって過去の会話や曖昧な参照を正確で自己完結した検索クエリに変換します。
迅速な応答を実現するため、ElevenLabsは各クエリを複数の書き換えモデルに並行して送信し、最初に有効な応答を使用するモデルレースアーキテクチャも開発しました。このアプローチによりRAGレイテンシーの中央値を半減し、326msから155msへ短縮しました。大規模なナレッジベースによって検索がトリガーされた場合でも、自然な会話の流れを維持できる速度を実現します。
LLMとRAGモデルの違いは?
LLMは言語を理解し、生成するモデルです。RAGは、アプリケーションが必要とする際に外部情報を取得する、LLMを取り巻くアーキテクチャです。
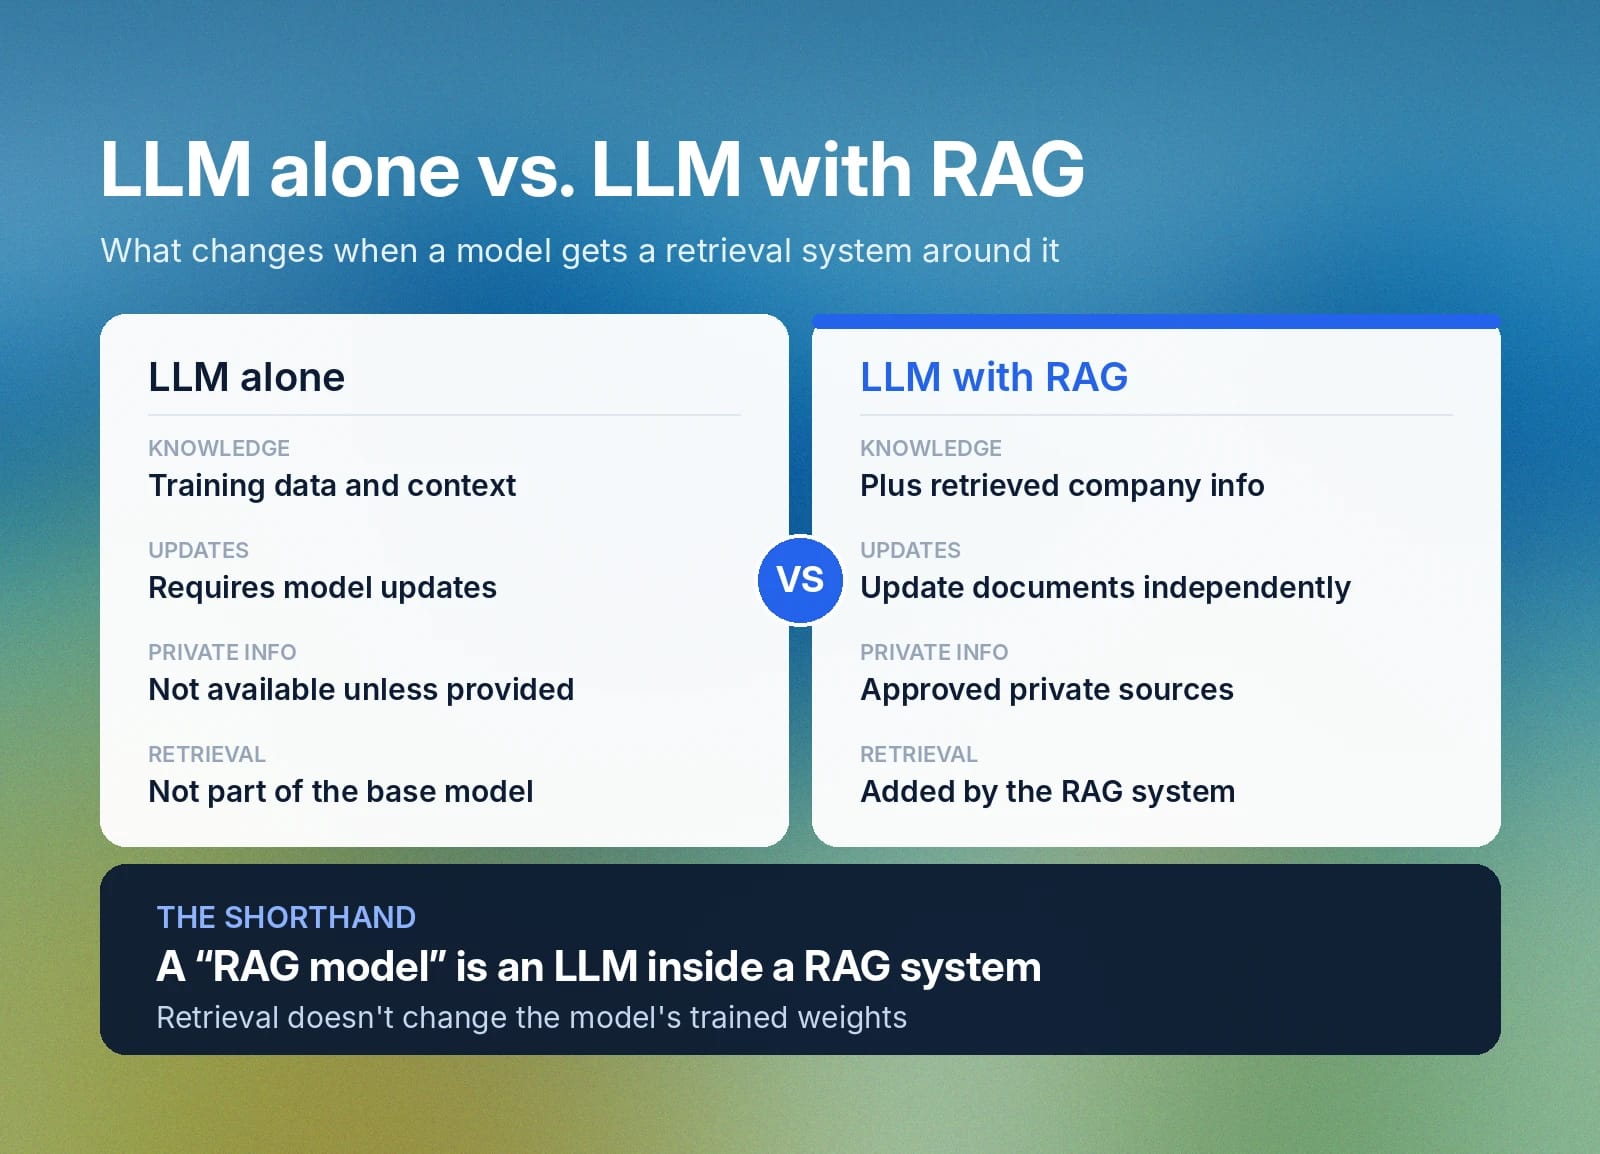
LLMをRAGと組み合わせると、次のように変わります。
機能 | LLM単体 | RAGを使用するLLM |
知識 | トレーニングデータと現在のコンテキスト | トレーニングデータ、現在のコンテキスト、ポリシー、プロダクト文書、ナレッジベースのコンテンツなど、取得した企業情報 |
更新 | 新しい情報はコンテキストまたはモデル更新を通じて提供する必要がある | 外部知識はモデルとは別に更新できる |
非公開情報 | 提供されない限り利用できない | 承認済みの非公開ソースから取得できる |
検索 | ベースモデルの機能には含まれない | 周囲のRAGシステムによって追加される |
「RAGモデル」は、RAGシステム内で使用されるLLMの略称として使われることがあります。たとえば、企業がカスタマーサポートに「RAGモデル」を使用していると言う場合、実際には、回答を生成する前に関連するヘルプセンターやポリシーのコンテンツを取得するLLMを指しています。
実際のアプリケーションにおけるRAGモデルの制約
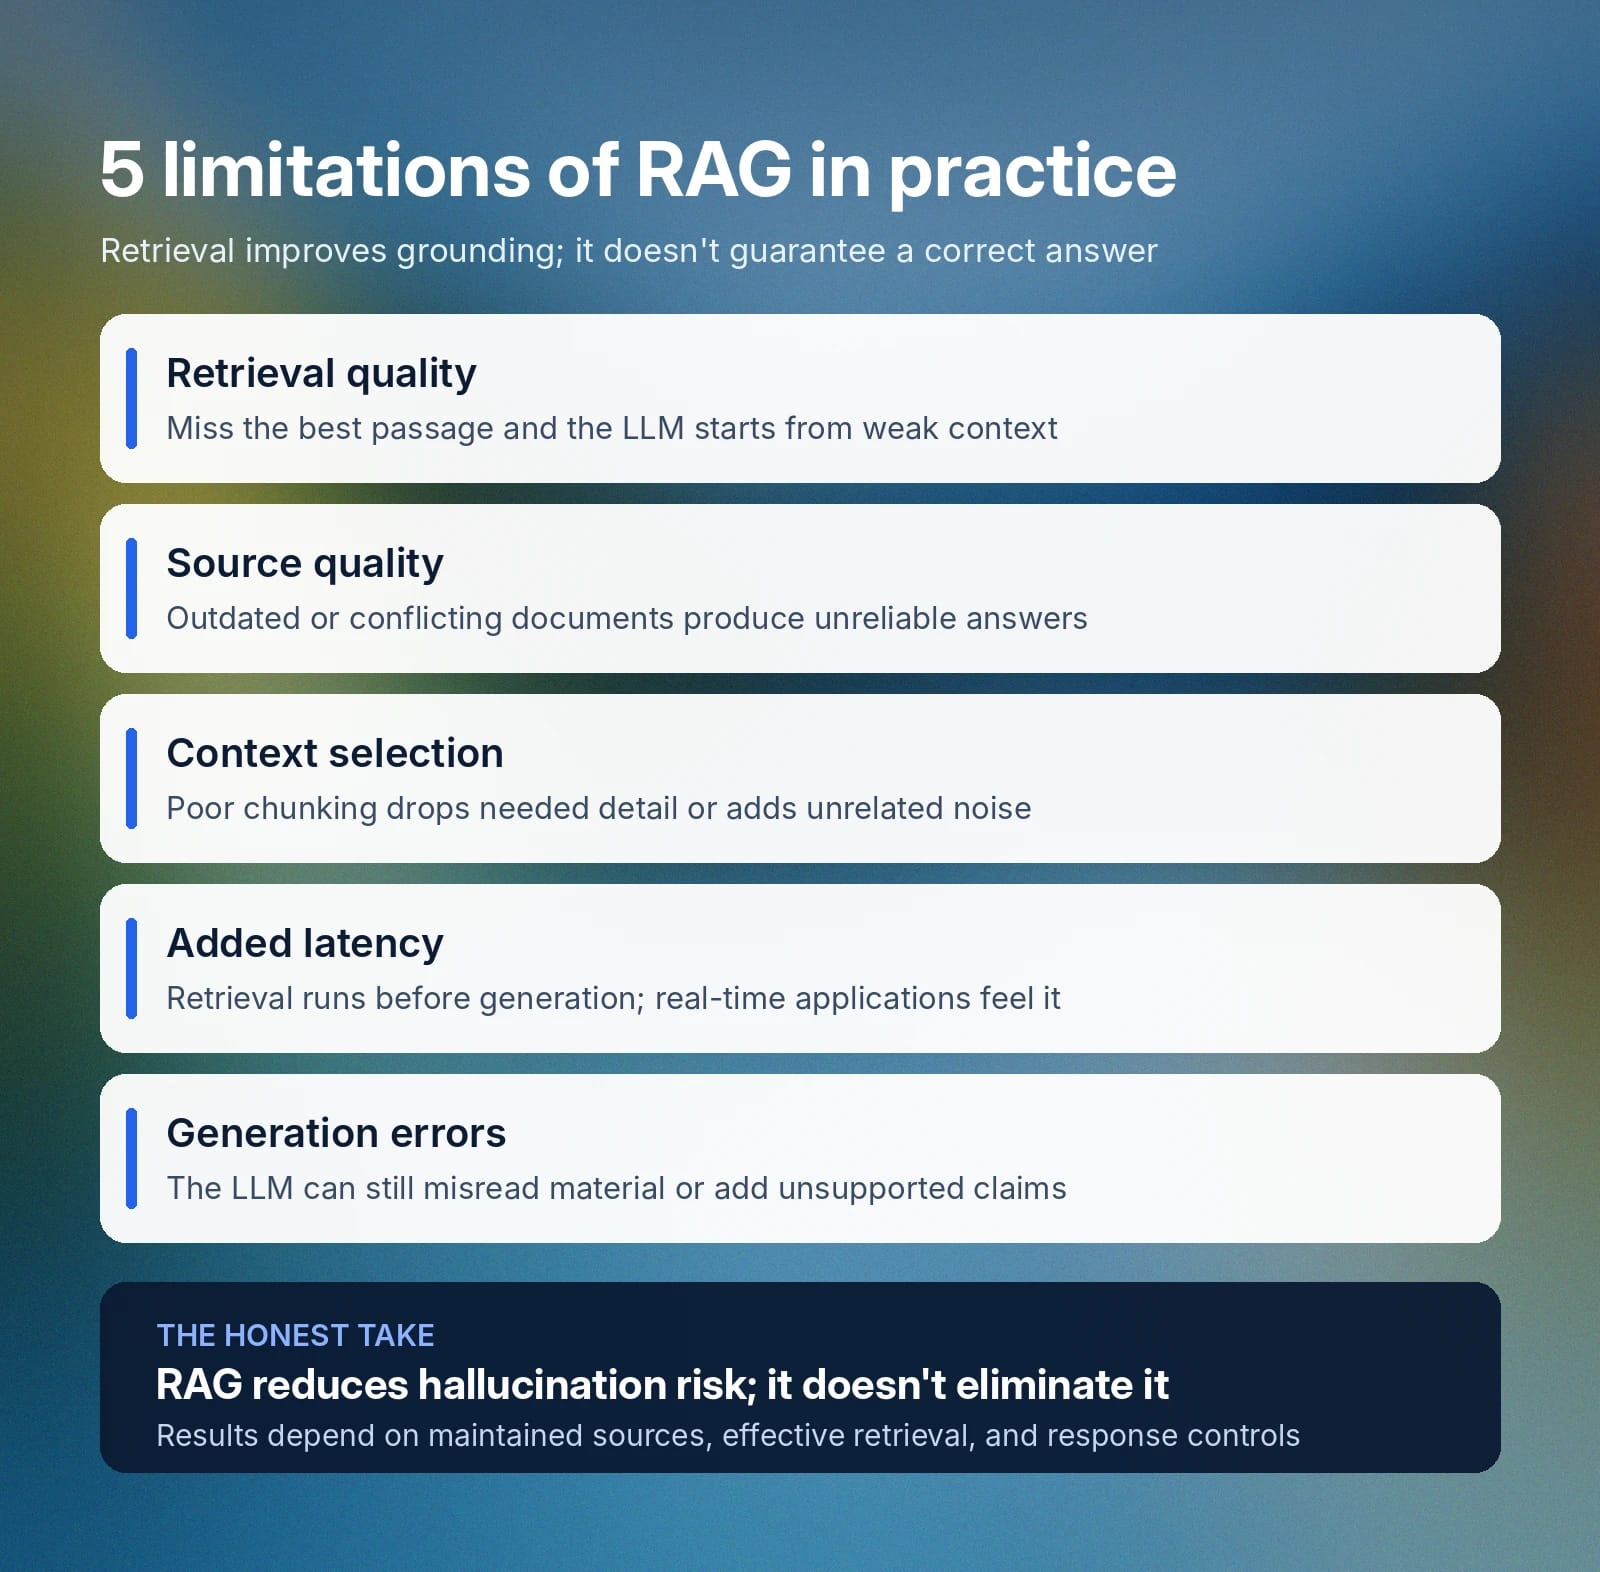
RAGはLLMの外部に保存された関連ビジネス知識へのアクセスを改善しますが、検索には独自の制約があり、正しい回答を保証するものではありません。主な制約は、システムが何を取得するか、何をモデルに送るか、モデルがどのように応答するかに現れます。
- 検索品質:システムが最も関連性の高い箇所を見逃すと、LLMは不完全または弱いコンテキストから始めることになります。表現の悪いクエリ、弱い意味的な一致、曖昧な表現は、いずれも検索を誤った方向へ導く可能性があります。
- ソース品質:古い文書、内容が矛盾する文書、不完全な文書は、信頼性の低い回答につながる可能性があります。
- コンテキストの選択:不適切なチャンク化や検索の選択により、必要な詳細が失われたり、無関係な情報が含まれたりする可能性があります。
- 追加レイテンシー:生成前に検索とクエリ処理が行われるため、リアルタイムアプリケーションでは応答が遅くなる可能性があります。
- 生成エラー:LLMは、取得した情報を誤って解釈したり、根拠のない主張を追加したりする可能性があります。
RAGはハルシネーションのリスクを低減できますが、完全に排除することはできません。正確な結果を得るには、適切に管理されたソース、効果的な検索、最終応答に対する制御が引き続き必要です。
生成AIにおけるRAG:実用的なユースケースとメリット
RAGは、AIアプリケーションが頻繁に変わる情報、組織に属する情報、またはすべてのモデルリクエストに含めるには大きすぎる情報を必要とする場合に、特に役立ちます。
RAGが特に効果を発揮する場面は次のとおりです。
頻繁に更新される情報への対応
RAGは、AIの回答を最新のプロダクト詳細、価格、ポリシー、在庫状況に合わせるのに役立ちます。チームはソース情報を個別に更新でき、質問されたときにRAGが関連するバージョンを取得します。たとえば、リード選別エージェントは、受信した電話のリードを選別する際に、最新の価格やプランの詳細を取得できます。
非公開または専門的な知識の活用
社内ポリシー、技術文書、特定チーム向けのサポートコンテンツなど、公開情報ではなく非公開または専門的な知識もあります。RAGを使えば、公開されている情報やモデルに組み込まれた情報だけに頼るのではなく、エージェントがこうしたソースから直接取得できます。
たとえば、社内のITまたは人事ヘルプデスクエージェントは、その情報を含まない公開文書を検索する代わりに、人事専用のナレッジベースから取得して、従業員の福利厚生に関する質問へ回答できます。
大規模なナレッジベースの検索
RAGは、企業がLLMが1回のリクエストで扱える量を大幅に超える文書を保有している場合に役立ちます。コレクション全体をモデルへ送るのではなく、現在の質問に関連する箇所だけを取得します。営業の場面では、技術アシスタントが通話中にプロダクトマニュアルを検索して、関連する要件を見つけることができます。
高度なRAGソリューションをElevenAgentsで始める
ElevenAgentsなら、ノーコードのWebプラットフォームを使う場合でも、エージェントを自社プロダクトへ直接組み込みたいチーム向けのAPIを使う場合でも、接続された知識ソースとRAGを活用するAI音声・チャットエージェントを構築できます。
RAG対応エージェントでは、文書、URL、テキストをナレッジベースに追加し、各クエリに関連する情報だけを取得できます。
ElevenLabsは、リアルタイム会話向けに検索も最適化し、ElevenAgentsのアーキテクチャでRAGレイテンシーの中央値を326msから155msに短縮しました。ダッシュボードでエージェントを設定する場合も、APIを通じてその上に構築する場合も、ElevenAgentsで開発するチームはこれらの検索機能をすぐに利用できます。
構築を始める:ElevenAgentsを活用するか、チームにお問い合わせいただき、アプリケーションに適した構成についてご相談ください。


