
コンテキストウィンドウとは?LLMユーザーが知っておくべきこと
- 公開日
- 最終更新日
コンテキストウィンドウとは、大規模言語モデル(LLM)が1回のリクエストで処理できる情報量です。トークンで測定され、プロンプト、会話履歴、システム指示、取得した文書、ツールの結果、モデルが生成した応答を含められます。
コンテキストウィンドウが大きいほど、モデルは1回のリクエストでより多くの情報を扱えます。たとえば、バグを調査するコーディングエージェントは、各要素を個別に分析してリクエスト間で有用なコンテキストを失う代わりに、関連するソースファイル、ドキュメント、テスト結果、最近のコード変更を同時に扱えます。
ただし、コンテキストウィンドウが大きいことは、完全な記憶を意味しません。長いプロンプトでは計算量とトークン消費量が増え、モデルが実際に重要な詳細を見極めにくくなる場合があります。 Lost in the Middleの研究やNVIDIAの RULERベンチマークを含むロングコンテキストモデルの研究では、コンテキストが増えるほど、特に関連情報が有用性の低い情報に埋もれている場合に、モデルが利用できる情報の活用度が下がることが繰り返し示されています。
この記事では、コンテキストウィンドウの仕組み、測定方法、上限に達したときに起こること、デベロッパーが効果的に管理する方法を解説します。
概要
- コンテキストウィンドウは、LLMが1回のリクエストで利用するトークンの総予算です。ユーザープロンプト、会話履歴、取得したコンテンツ、出力が含まれます。
- コンテキストウィンドウが大きいほど、より長い文書、コードベース、会話を扱えますが、モデルがそのすべてを適切に活用できるとは限りません。
- モデルは長いプロンプトの中央にある情報を最も信頼性低く取得する傾向があります。このパターンはLost in the Middleの研究とRULERベンチマークで報告されています。
- 効果的なコンテキスト管理(検索、要約、キャッシュ)は、単に送信するトークン数を最大化するよりも通常は優れています。
- 最適なコンテキスト戦略とは、最大の公称コンテキストウィンドウを使うものではなく、実際のワークロードに合ったものです。
AIモデルにおけるコンテキストウィンドウとは?
コンテキストウィンドウは、モデルが応答を生成する前に、現在のリクエストに関連するすべての情報が集まるアクティブな作業領域です。
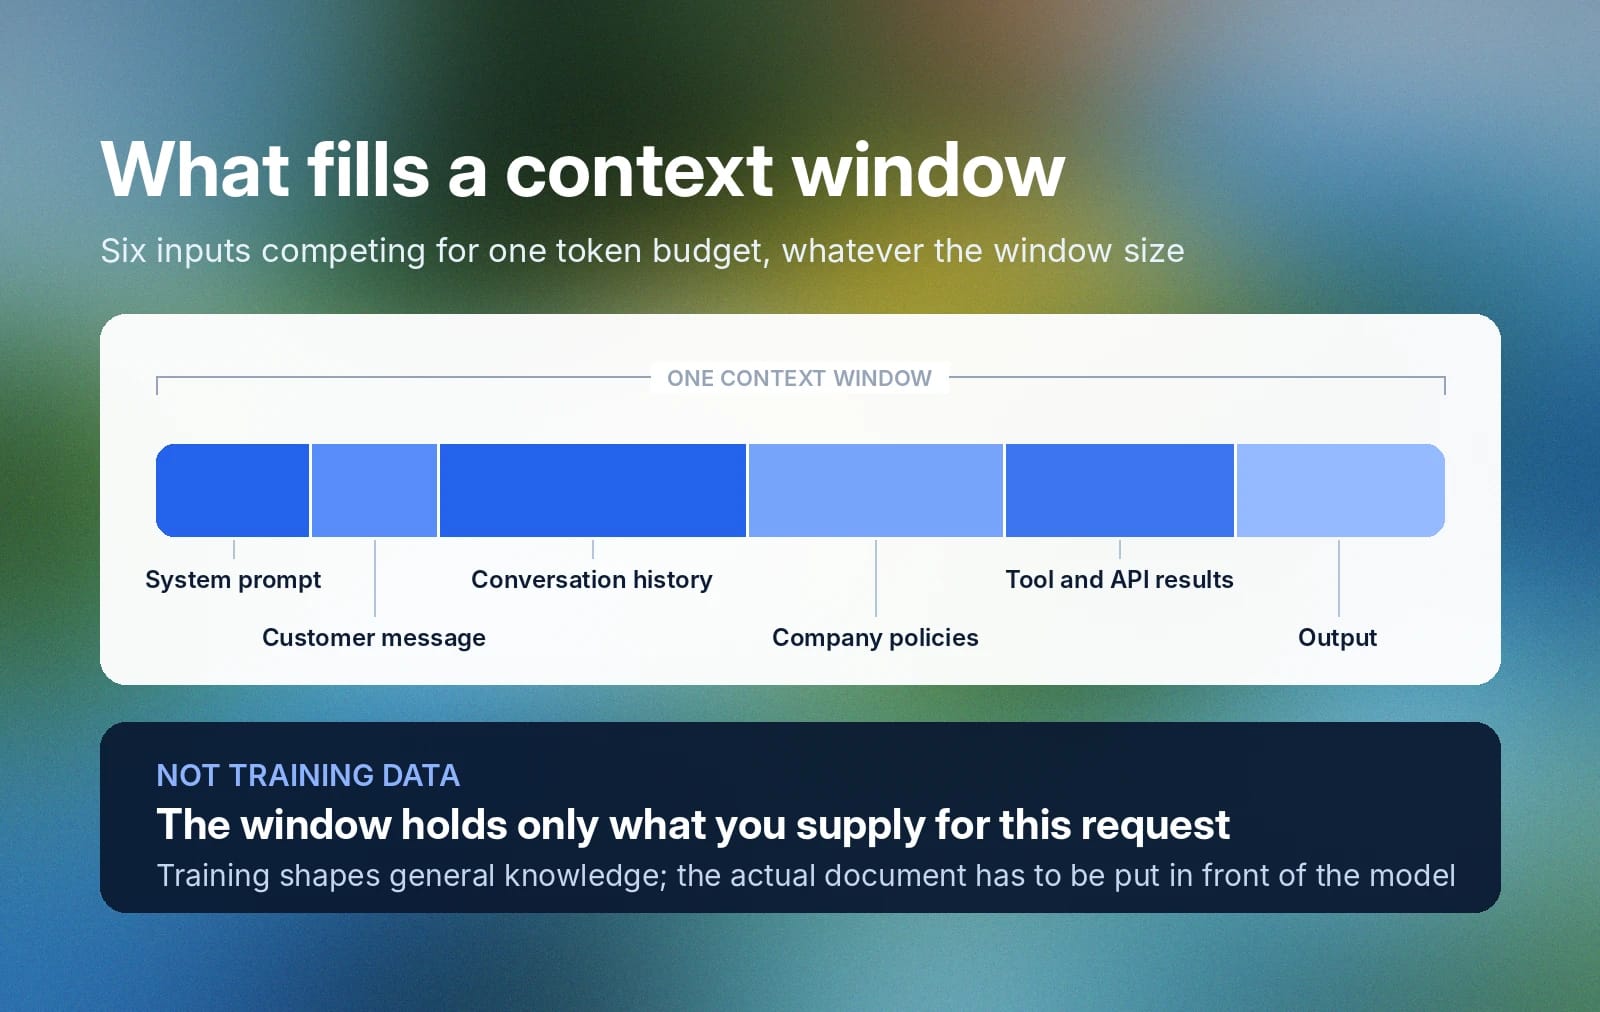
たとえば、 AIエージェントがカスタマーサポートの会話を要約し、解決策を提案するケースを考えてみましょう。適切に行うには、モデルは次を処理する必要があります。
- システムプロンプト
- 顧客のメッセージ
- 会話履歴
- 会社のポリシー
- ツールとAPIの結果
- 出力
これらはすべて、ウィンドウの大きさにかかわらず、同じコンテキストウィンドウ内のスペースを競合して使用します。
コンテキストウィンドウに学習データは含まれません。トレーニングでは情報がモデルのパラメータに恒久的に組み込まれ、一般的に「知っている」ことが形成されます。一方、コンテキストウィンドウに保持されるのは、現在のタスクのために提供された情報だけです。
この違いは実務上重要です。アプリケーションが特定のポリシー、顧客記録、技術文書についてモデルに推論させる必要がある場合、類似の資料でモデルが学習されていたとしても、その情報を利用できるとは限りません。通常は、プロンプトで直接、または検索・ツールシステムを通じてモデルの作業コンテキストに入れる必要があります。そうしなければ、モデルは目の前の実際の文書ではなく一般知識に基づいて推論します。
トークン化とコンテキストウィンドウ:データの処理方法
LLMがテキストを処理する前に、トークナイザーがテキストをトークンと呼ばれる小さな単位に分割します。トークンは、単語全体、単語の一部、句読点、その他の短いテキスト片を表す場合があります。
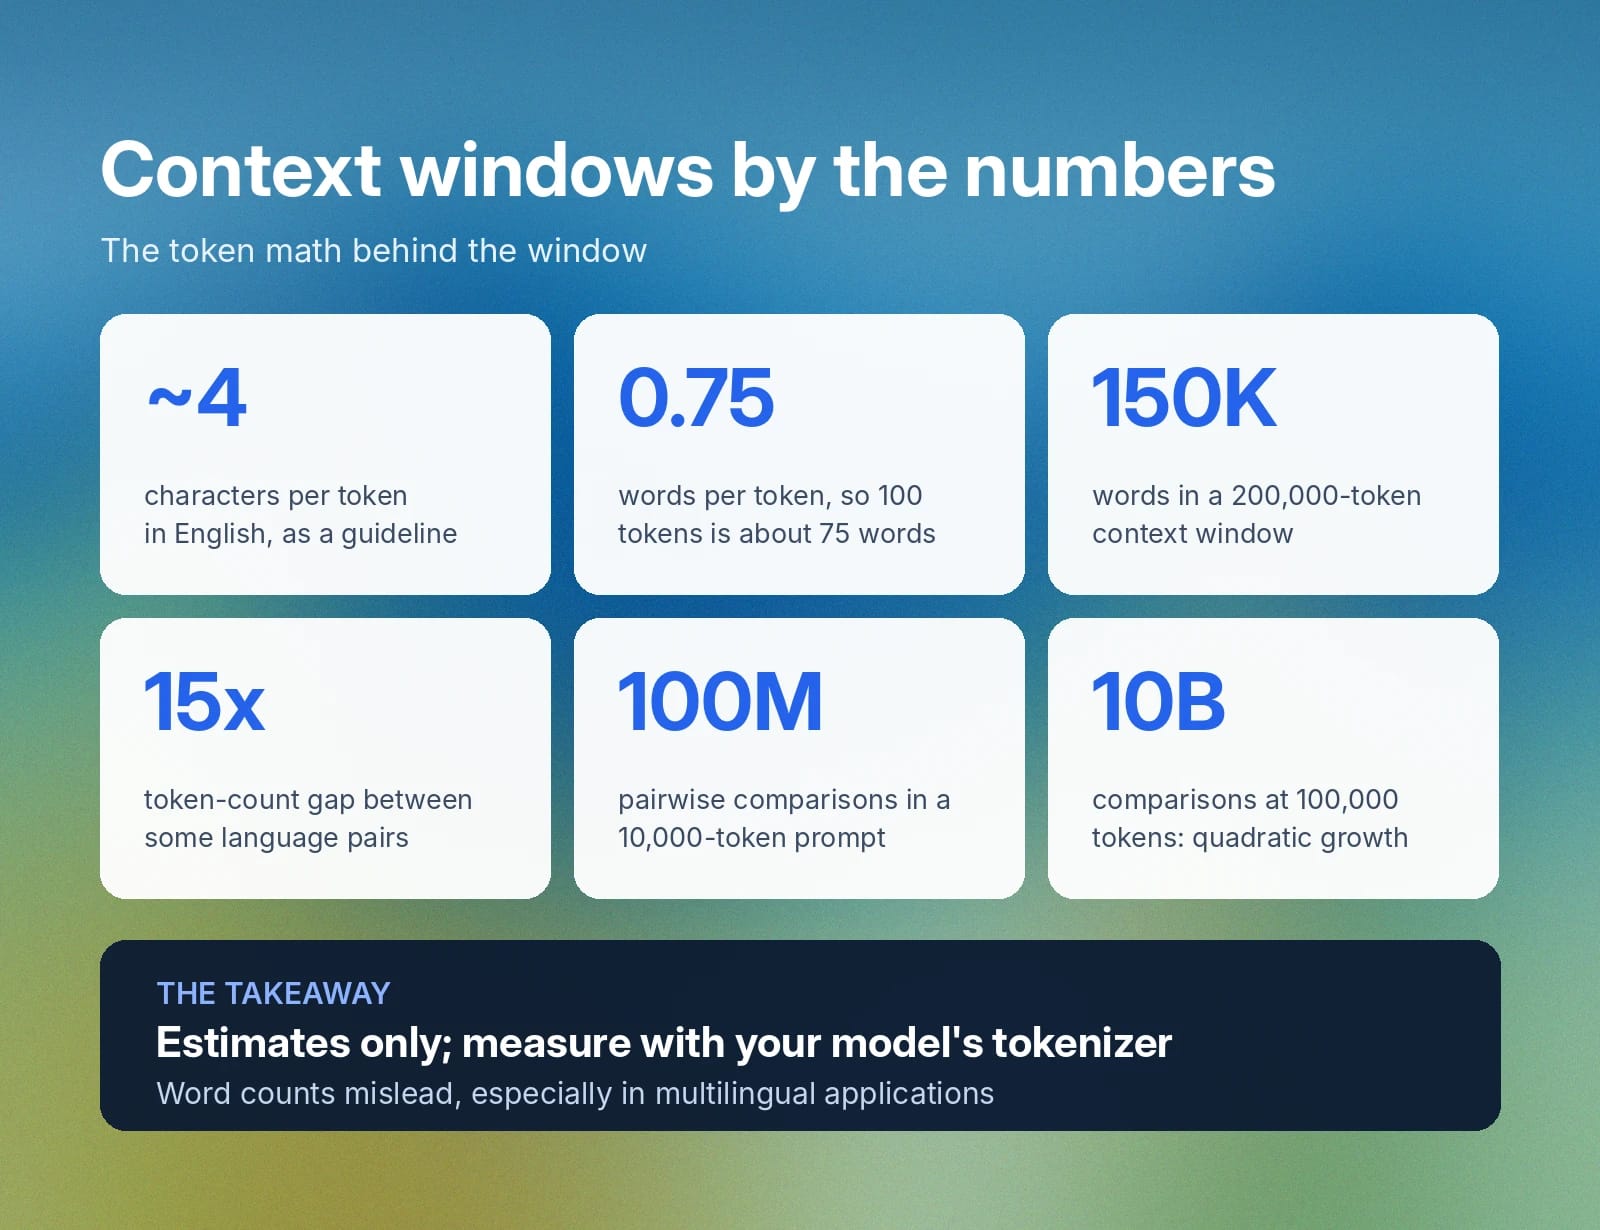
英語では、1トークンはおおよそ4文字、または単語の約4分の3に相当すると考えるのが目安です。この推定では、100トークンは約75語に相当します。ただし、これはあくまで概算です。「Context windows affect application performance.」という文を考えてみましょう。トークナイザーが必ずしもこれを5つの完全な単語として表現するわけではなく、トークナイザーによっては1つ以上の単語が複数のサブワードトークンに分割されます。
トークン化は言語によっても大きく異なります。意味や見た目の長さが似た2つの文でも、言語やトークナイザーによって消費するトークン数は大きく異なる場合があります。トークナイザーの公平性に関する研究では、多言語対応向けに作られたトークナイザーでも、同等のテキストに対するトークン化後の長さが、言語ペアによって最大15倍異なることが示されています。多言語アプリケーションを構築するデベロッパーは、単語数から推定するのではなく、対象モデルで実際に使われるトークナイザーでトークン使用量を測定すべきです。
20万トークンのコンテキストウィンドウは非常に大きく聞こえるかもしれません。しかし、会話履歴、取得したドキュメント、ツール応答、システム指示を継続的に追加するアプリケーションでは、予想より早く上限に近づく可能性があります。そのため、本番アプリケーションではトークン使用量を監視し、要約、履歴の削減、検索フィルタリング、プロンプト圧縮などを使って、最も関連性の高い情報をアクティブなコンテキスト内に維持することがよくあります。
言語モデルでコンテキストウィンドウはどのように機能する?
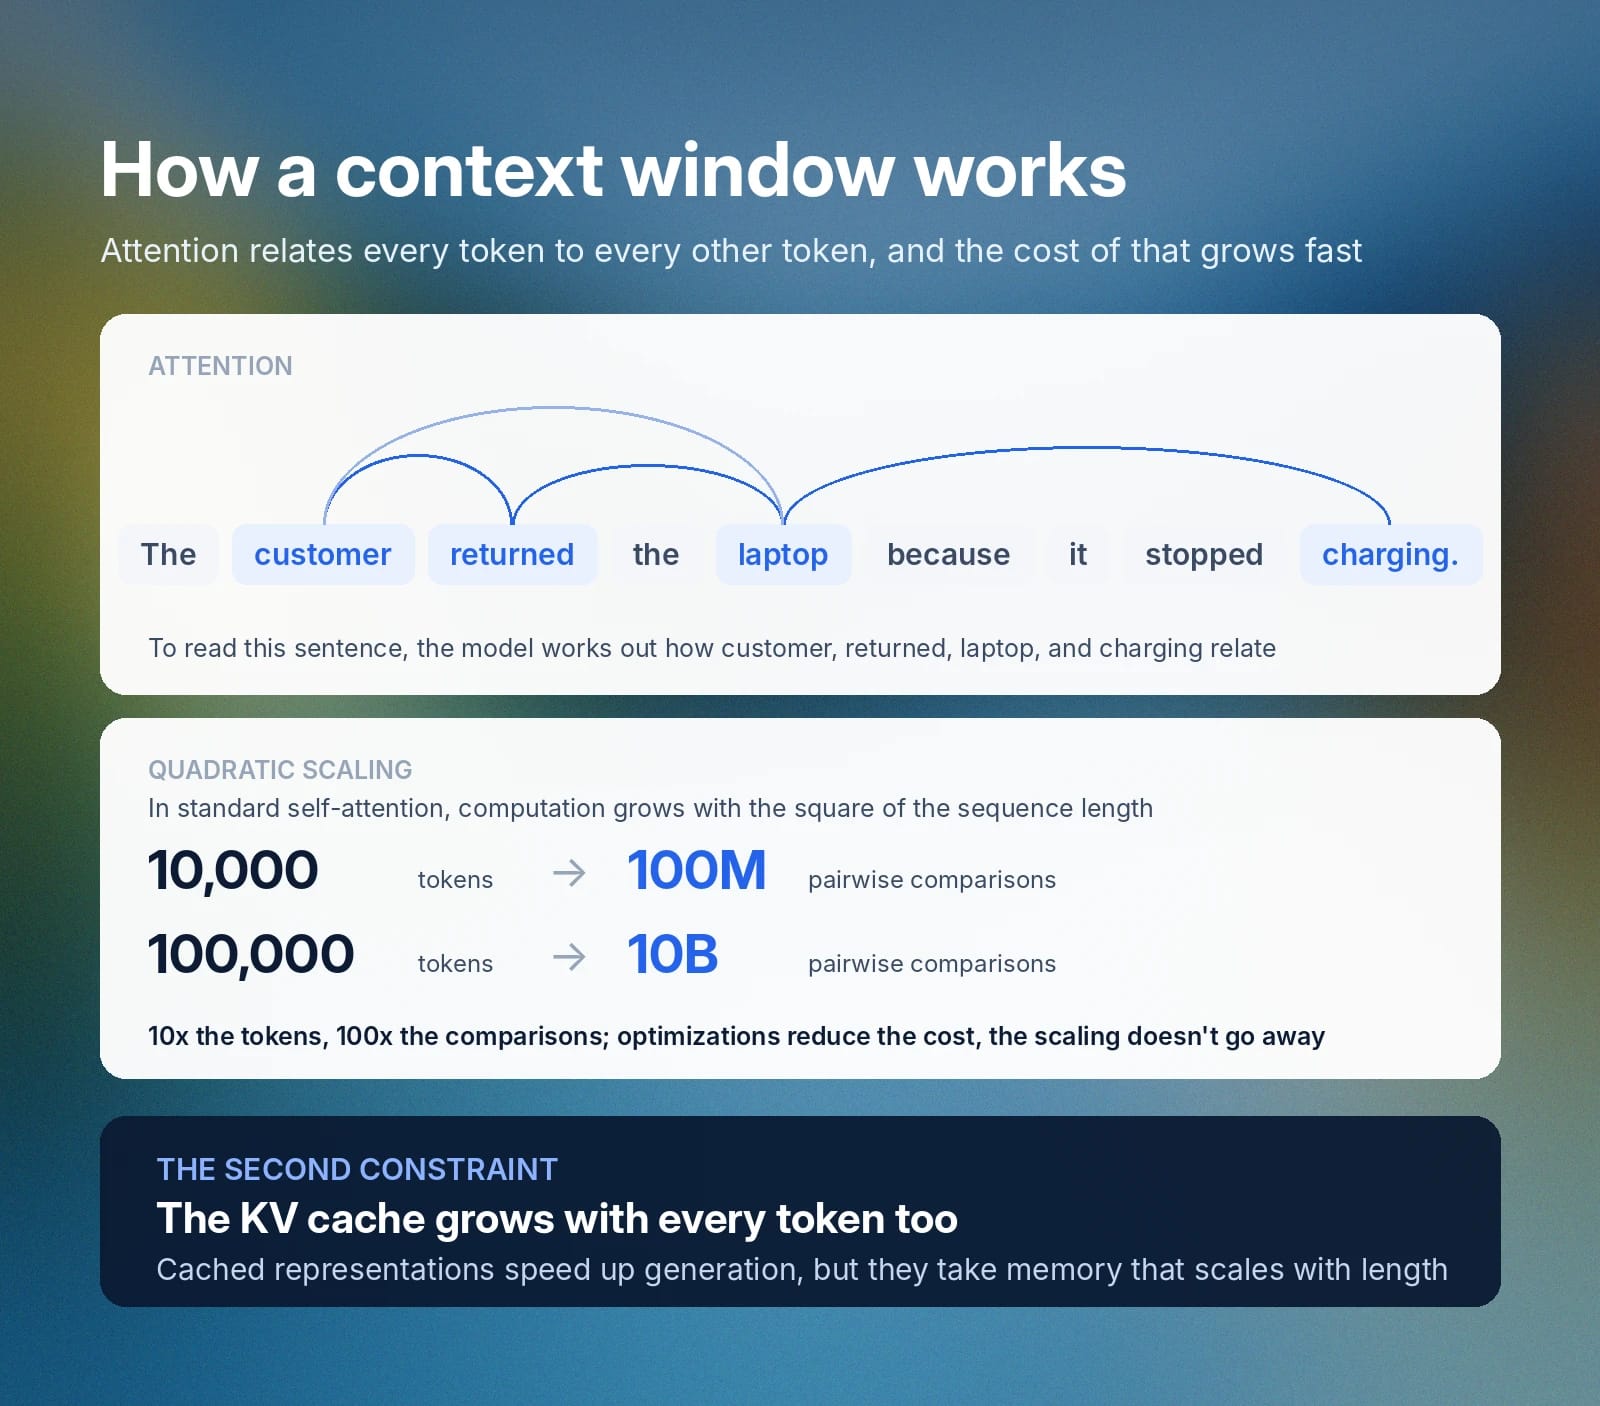
コンテキストウィンドウは、モデルが応答を生成する前に、入力内の各トークンが他のすべてのトークンとどのように関係するかを計算する、Transformerアーキテクチャのアテンション機構を通じて機能します。
「顧客はノートPCの充電ができなくなったため返品した」という文を考えてみましょう。これを正しく解釈するには、モデルは顧客、ノートPC、返品、そして充電が互いにどう関係するかを把握する必要があります。シーケンスが長くなるほど、こうした関係の数は急速に増加します。
標準的な自己アテンションでは、必要な計算量はシーケンス長のおおよそ2乗で増加します。たとえば、1万トークンのプロンプトでは約1億回のペア比較が必要ですが、10万トークンのプロンプトでは約100億回必要です。最新のモデルは、このコストを実用的に抑えるためのさまざまなアーキテクチャおよびインフラ最適化を利用していますが、根本的なスケーリングの問題はなくなりません。
長い会話には、キー・バリュー(KV)キャッシュという第2の制約もあります。生成中、モデルは新しいトークンごとに再計算するのではなく、以前のトークンの中間表現を保持するため、推論が大幅に高速化されます。ただし、キャッシュ自体がメモリを使用し、シーケンスが長くなるほど増大します。
AIモデルの最大コンテキスト長とその重要性
モデルの最大コンテキスト長は、1回のリクエストで受け入れ、処理できる情報量を定義します。ただし、モデルが大きなコンテキストウィンドウを効果的に利用できるかどうかは別の問題です。
コンテキストウィンドウが長くなると、従来のLLMでは困難または非現実的だったユースケースが可能になります。デベロッパーは、コードリポジトリ全体、長大な法的文書、研究論文、会議の文字起こし、または大量の会話履歴を、まず数千トークンまで削減せずにモデルへ提供できます。
これは、元のコンテキストをより多く保持することで、質問への正確な回答、離れた情報同士の関係の特定、文書全体に依存するタスクの実行といったモデルの能力を高められるためです。たとえば、コーディングアシスタントは関数の呼び出し方を理解するために複数のファイルを調べる必要がある一方、法的文書アシスタントは、ある節の定義と文書のかなり後ろに記載された義務を比較する必要がある場合があります。
ただし、コンテキストウィンドウが大きくなっても、結果が自動的に向上するわけではありません。非常に長い入力はコストとレイテンシーを増加させ、モデルは大規模なコンテキストの中央に埋もれた情報に注意を向けにくくなることがあります。したがってデベロッパーは、関連情報を選択的に含め、長い入力を明確に整理し、必要に応じて検索、要約、コンテキストの削減を利用すべきです。
モデル別コンテキストウィンドウサイズの比較
コンテキストウィンドウは、現在の主要モデルファミリー間で数十万トークンから1,000万トークンまで大きく異なります。主要モデルを比較してみましょう。
モデル | コンテキストウィンドウ | 備考 |
1,000万トークン | Metaのオープンウェイトモデル。執筆時点で公開されている中で最大のウィンドウ | |
105万トークン | コーディングとエージェント型推論向けのOpenAIの現行フラッグシップモデル | |
100万トークン | 長文書・複数ファイル分析向けのGoogleの現行Proティアモデル | |
100万トークン | Anthropicの現行Sonnetティアモデル。Claude API全体にデフォルトでこのウィンドウが適用されます |
プロバイダーは新モデルの投入や上限の引き上げを迅速に行うため、このような表は恒久的な順位ではなく、スナップショットとして捉えてください。コンテキストサイズはモデル選定における要素の1つにすぎません。それだけでは、推論品質、出力上限、レイテンシー、コストは分かりません。
小さいコンテキストウィンドウと大きいコンテキストウィンドウの影響
コンテキストウィンドウが小さい場合、デベロッパーは選別を迫られます。長い文書はチャンク化され、古い会話履歴は要約され、外部知識は実際に必要なときだけ取得されます。
コンテキストウィンドウが大きいと、こうした制約の一部がなくなります。すべてを分割しなくても、より多くの例を提供し、より多くの会話履歴を保持し、より大きな文書セットを分析できます。
しかし、ウィンドウが大きくなると別の問題、アテンションの希薄化が生じます。プロンプトに大量の情報が含まれると、モデルは現在のリクエストに最も関連する詳細を特定するのに苦労することがあります。重要な指示や根拠が関連性の低いコンテンツに埋もれ、不完全、一貫性に欠ける、または精度の低い応答のリスクが高まります。
モデルが中央で情報を見失う理由
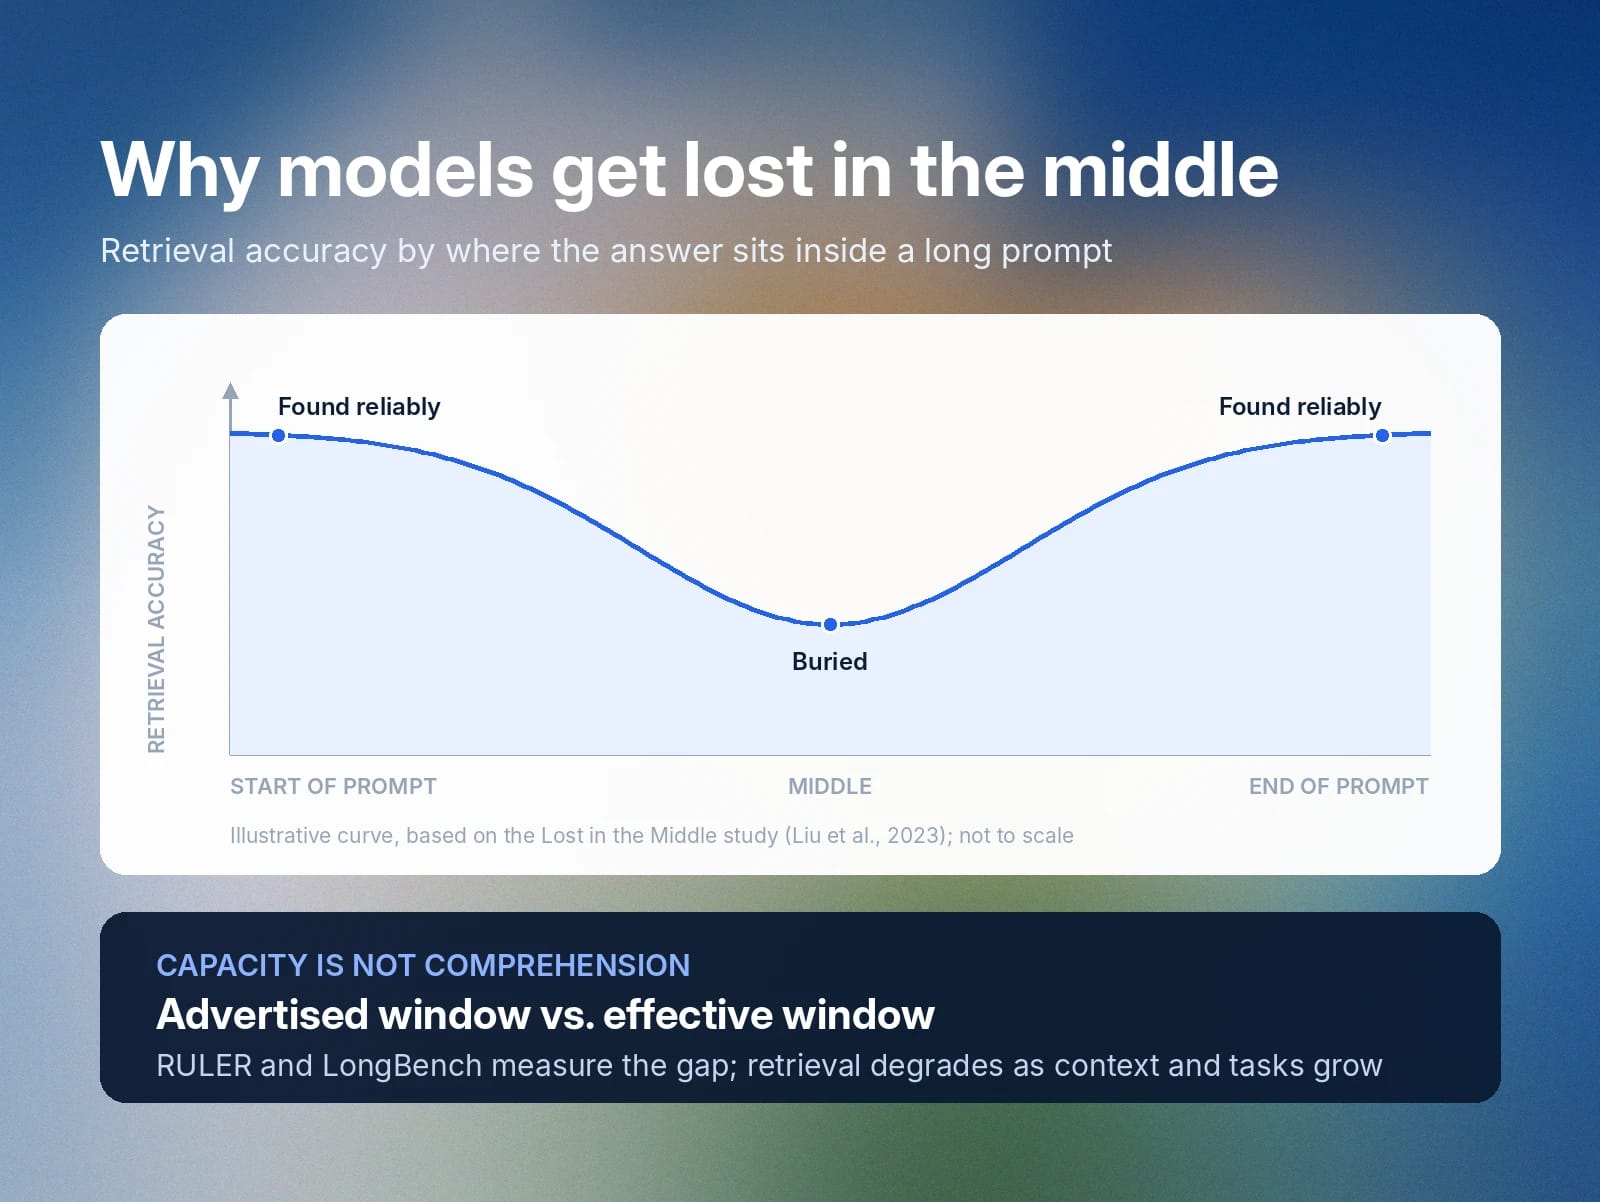
モデルは、長いプロンプトの先頭または末尾にある情報を最もよく取得し、中央に埋もれた情報を最も取得しにくい傾向があります。影響力の大きい Lost in the Middleの研究では、長いプロンプト内の異なる位置に質問の答えを配置し、モデルがそれを見つける頻度を測定することで、この点を直接検証しました。精度はコンテキストの先頭と末尾で一貫して最も高く、中央で最も低くなりました。
つまり、モデルは技術的には文書を受け入れられても、そのすべてを確実に活用できるとは限りません。顧客の質問の答えが100件のサポート文書のうち1件に含まれているため、LLMに100件すべてを送るとします。大きなコンテキストウィンドウなら100件すべてを収められるかもしれません。しかしモデルは依然として、無関係な99件の中から関連する1つの文章を見つけ出す必要があり、ウィンドウが長くなってもそれを保証するものではありません。
そのため、モデルが公称するコンテキストウィンドウと、特定のワークロードにおける実効コンテキストウィンドウは区別する価値があります。RULERや LongBenchのようなベンチマークは、この差を測定しようとしています。RULERでは、単純な検索テストでほぼ完璧なスコアを出したモデルでも、コンテキスト長とタスクの複雑さが増すにつれて性能が低下することが分かりました。LongBenchは、文書質問応答、複数文書の推論、要約、few-shot学習、コード補完など、より幅広いタスクを評価します。
ロングコンテキストには依然として実際の価値があります。容量と理解力は単に別の特性であり、特定のタスク用のモデルを選ぶ際にはどちらも重要です。
コンテキスト上限の管理:デベロッパーのベストプラクティス
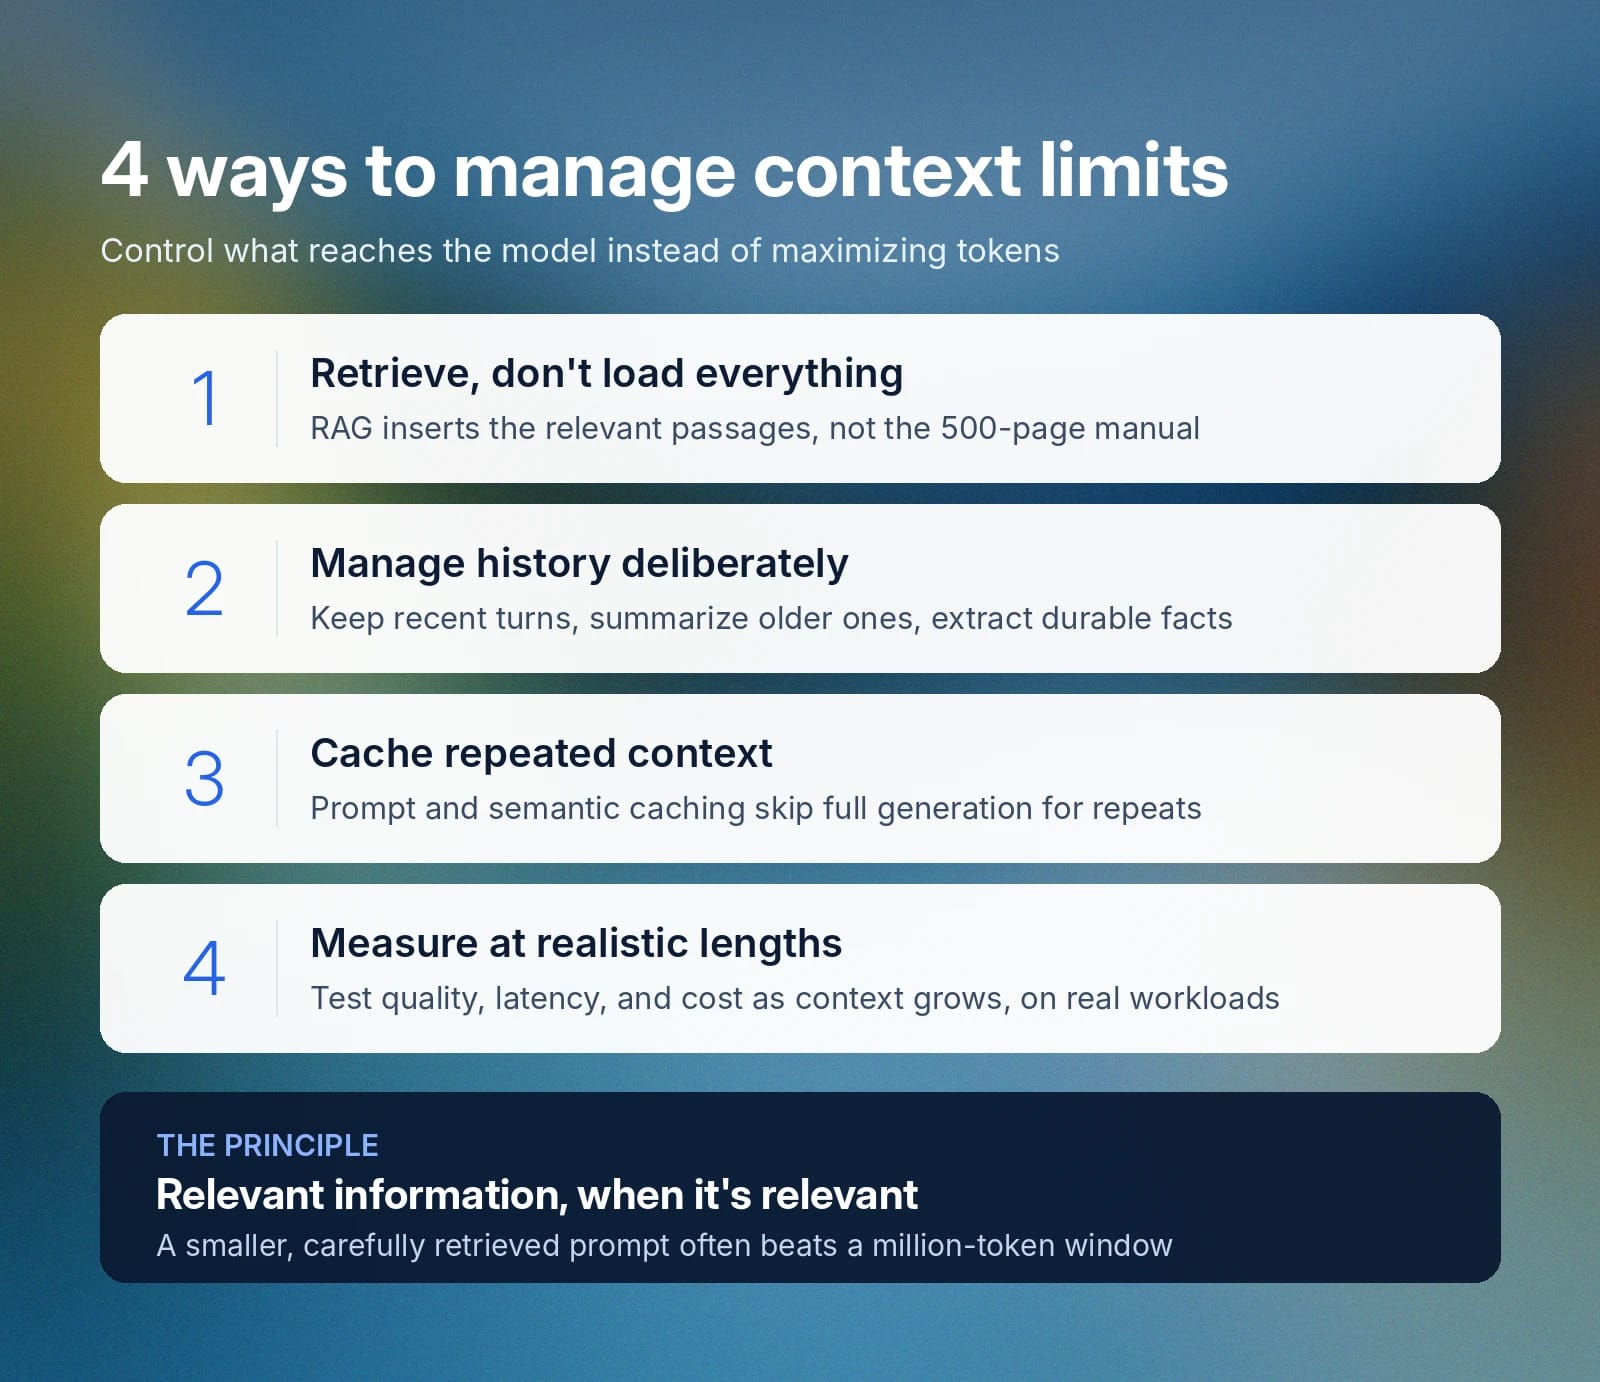
優れたコンテキスト管理とは、すべてのリクエストでトークン数を最大化しようとするのではなく、タスクに関連する情報を、関連するタイミングでモデルに渡すよう制御することです。以下の方法は、不要なコンテキストの削減、応答品質の向上、コストとレイテンシーの管理に役立ちます。
1. すべてを読み込まず、関連情報を取得する
検索拡張生成(RAG)を使うと、アプリケーションは外部ナレッジベースを検索し、関連する文章だけをモデルのコンテキストに挿入できます。500ページのマニュアル全体をすべてのサポートリクエストに入れる代わりに、顧客の実際の質問に最も近い数個の文章を取得します。
これによりトークン使用量が減り、何が重要かについてモデルにより明確なシグナルを与えられます。検索の品質も重要です。本番RAGシステムでは通常、文書を慎重にチャンク化し、複数の候補文章を取得して再ランキングし、最終プロンプトを作る前に無関係なものを除外することで結果を改善します。たとえばElevenLabsは、RAGパイプラインを再構築し、クエリ書き換えと並列モデル呼び出しを追加することで、検索レイテンシーの中央値を半減させました。
2. 会話履歴を意図的に管理する
会話型アプリケーションではコンテキストがすぐに蓄積します。過去のメッセージをすべて無期限に追加すると、トークンを浪費し、無関係な詳細が後続ターンに入り込む可能性があります。
アプリケーションでは、直近のターンを保持し、古い会話を要約し、永続的な事実を構造化メモリに抽出し、古い詳細は再び関連性が出たときだけ取得することで対処します。これにより、モデルがすぐに必要とする短期的な会話コンテキストと、後で呼び戻せる長期的なアプリケーションメモリを有用に分けられます。
3. コンテキストが繰り返される場合はキャッシュを使う
多くのアプリケーションでは、同じ大きな指示を繰り返し送信したり、すでに処理した質問と意味的に似た質問に回答したりします。キャッシュによりこのオーバーヘッドを削減できます。
プロンプトまたはコンテキストのキャッシュでは、繰り返し入力をより効率的に再利用できます。また、セマンティックキャッシュは、新しい質問がシステムがすでに回答した質問とほぼ同じ意味かどうかを認識することで、さらに一歩進みます。「返品ポリシーを教えてください」と「商品の返品期限はどのくらいですか?」は異なる文字列ですが、セマンティックキャッシュでは同じ質問として扱えます。完全な生成呼び出しを省略し、レイテンシーとトークンコストの両方を削減できます。
4. 現実的なコンテキスト長でパフォーマンスを測定する
モデルプロバイダーが公表するトークン上限だけに基づいてコンテキスト戦略を選ばないでください。代表的な本番ワークロードをテストし、コンテキスト長の増加に伴う応答品質、検索精度、レイテンシー、トークン使用量、コスト、失敗率を測定してください。
より多くのコンテキストを提供する、取得する文章を減らす、会話履歴を要約する、検索と要約を組み合わせるといった戦略を比較してください。100万トークンのコンテキストウィンドウを持つモデルは技術的にはアプリケーションをサポートできるかもしれませんが、より小さく慎重に取得されたプロンプトの方が、低コストで高速かつ正確な結果を生むことがあります。
スケーラブルな言語ソリューションにElevenAgentsを活用
コンテキスト管理が最も重要になるのは会話型エージェントです。会話を自然に感じさせる速度で応答しながら、現在の発話、過去のターン、ビジネス指示、顧客情報、ナレッジベースのコンテンツ、ツールの結果を組み合わせる必要があるためです。
ElevenAgentsは、AI音声エージェントを構築・デプロイするために、これらの要素を1つのプラットフォームに統合します。そのオーケストレーションエンジンは音声認識、LLM、テキスト読み上げを連携させ、デベロッパーはプロンプト、ナレッジベース、ツール、ワークフロー、基盤となる言語モデルを設定します。エージェントが音声で感情的なコンテキストを伝える方法を含む表現豊かな話し方は、そもそもエージェントが何を言うかを形作る同じコンテキストに依存します。
ナレッジ管理については、ElevenAgentsはフルコンテキスト文書とRAGの両方をサポートしており、プラットフォーム上で直接設定できます。小さな文書はエージェントのプロンプトに直接入るため、その内容は会話全体を通して利用できます。より大きなナレッジベースは代わりにインデックス化され、RAGがすべてを一度にコンテキストウィンドウへ読み込むのではなく、各クエリに関連する文章を取得します。
ElevenAgentsに登録して今すぐ始めるか、チームに問い合わせることで、デプロイの選択肢をご確認ください。
コンテキストウィンドウに関するよくある質問

Jack LimebearはGrowthチームに所属し、ブログやインサイトページのコンテンツライター兼ストラテジストとして活躍しています。ElevenLabsに入社する前は、急成長中のSaaSスタートアップからFortune 500企業まで、さまざまな組織で10年以上にわたりコンテンツ戦略をリードしてきました。ケンブリッジ大学で英文学の修士号を取得しています。

