会議文字起こしAPIの使い方:Scribe v2によるリアルタイム・バッチ処理
- 公開日
会議メモを手作業で取るのは、特に会議が1時間を超えると、手間がかかるうえにミスも起こりがちです。時間を浪費し、参加者の議論への集中も妨げます。音声を録音していても、特定の発言を個々の話者に紐づけるのは困難です。
会議文字起こしAPIを使えば、ライブまたは録音済みの会議を、タイムスタンプと話者ラベル付きのテキストに変換できます。音声を送信するだけで、音声モデルを自作せずに構造化された文字起こしを取得できます。
この記事では、会議文字起こしAPIの仕組み、リアルタイム文字起こしとバッチ文字起こしの比較、そしてEleven Scribe v2 とEleven Scribe v2 Realtimeを使った構築方法を紹介します。
概要
- 会議文字起こしAPIは、会議音声をタイムスタンプと話者ラベル付きの文字起こしに変換します。
- リアルタイム文字起こしは会議中に低遅延の字幕を提供し、バッチ文字起こしは会議終了後に録音音声を処理します。
- 会議文字起こしの精度は、音声品質、話者の声の特徴、基盤となる音声モデルに左右されます。
- ElevenLabsは、エンジニアリングチームが高精度な会議文字起こしプロダクトを構築できるScribe v2とScribe v2 Realtimeを提供しています。
会議文字起こしAPIの機能と必要とする人
会議文字起こしAPIは会議音声を入力として受け取り、テキストを返します。音声認識、話者ダイアライゼーション、タイムスタンプ付与を処理し、すぐに活用できる一式を提供します。手作業でのメモ取りと比べ、会議向けスピーチtoテキストは、参加者が後から検索・確認できる記録を提供します。
より多くのチームがAIエージェントを導入するにつれ、会議の書面記録は検索可能なコンテキストになります。社内エージェントが文字起こしから詳細を検索し、データサイロを減らし、チーム間の情報アクセスを向上させます。
多くの商用ツールが文字起こしを提供していますが、組織の要件を完全に満たせない場合があります。
プロダクトエンジニアリングチームにとっては、STT会議アプリを構築する、または既存ツールにこの機能を追加するほうが実現しやすい場合があります。独自の会議文字起こしソフトウェアなら、次の項目を管理できます。
- プライバシー:ElevenLabsはエンタープライズユーザー向けにZero Retention Modeを提供しており、特定の地域におけるプライバシー要件にも対応できます。
- カスタム語彙:モデルに追加のコンテキストを与えることで、会社、プロダクト、業界に固有の用語を理解し、正確に文字起こしできます。
- カスタマイズされたワークフロー:ベンダー固有のワークフローに制限されず、社内データベース、CRM、エンタープライズソフトウェアと接続する会議文字起こしツールを構築できます。
ElevenLabsは、会議文字起こしアプリの構築を支援する先進的な音声・オーディオモデルを提供しています。会議文字起こしAPIを使えば、会議で話された内容を正確にテキストメモとして記録できます。モデルは90以上の言語に対応しており、英語、フランス語、中国語など数十の言語を文字起こしできます。

会議向けリアルタイム/バッチのスピーチtoテキスト:選び方
リアルタイム文字起こしは、発話と同時に音声ストリームを取り込み、ライブ字幕に変換します。会議中のテキスト支援や、ライブボットによるセッション中のアクションをトリガーするために利用できます。一方、バッチ文字起こしは会議後に録音全体を処理し、より簡潔で構造化された文字起こしを提供します。会議後メモの作成、記録の保存、監査可能な記録の維持に役立ちます。
リアルタイムとバッチのスピーチtoテキストを選ぶ際は、技術面とコスト面への影響を理解することが重要です。
両アプローチを簡単に比較してみましょう。
特性 | リアルタイム文字起こし | バッチ文字起こし |
技術的な運用 | 発話と同時に音声ストリームを取得します。音声モデルとのアクティブな接続が必要です。 | 会議後に音声録音全体を処理します。非同期で動作できます。 |
精度 | 標準的。完全なコンテキストなしで、その場で音声を処理します。 | より高い。会話全体のコンテキストを十分に分析できます。 |
ユースケース | 会議中のライブ字幕、会議ボット。 | 会議後メモ、記録保存。 |
コスト | 永続的な接続が必要なため高めです。 | 一括処理の効率により低めです。 |
最終的には、優先事項によって選択が決まります。ライブ会議アシスタントを構築する場合は、リアルタイムで文字起こしする必要があります。それ以外の場合は、コストと精度の面で優位なバッチ文字起こしを利用できます。
Scribe v2で会議文字起こしAPIを設定する方法
ElevenLabs スピーチtoテキストなら、Scribe v2 RealtimeとScribe v2で会議を文字起こしできます。どちらの音声モデルも、さまざまなアクセント、方言、音声品質において話者を正確にタグ付けできるよう学習されています。Scribe v2 Realtimeではライブ音声を即座に文字起こしでき、Scribe v2では録音音声を高精度に文字起こしできます。
提供されるAPIを使用して両方のモデルにアクセスできます。以下では、主な機能、APIアーキテクチャ、文字起こしソリューションへの統合方法に注目しながら、各モデルを詳しく紹介します。
オプション1:リアルタイム(ライブ)文字起こし
リアルタイム文字起こしでは、会議中の会話を処理し、話者の発話とともにテキストへ変換します。聞こえる音声と文字起こしの間に、認識できるほどの遅延はほとんどありません。
リアルタイムで文字起こしするには、音声入力からテキスト出力まで150msの低遅延を実現するScribe v2 Realtimeモデルを使います(ほぼ瞬時の部分文字起こし)。このモデルを文字起こしアプリに統合すれば、途切れのない字幕を提供できます。
ライブ会話をサポートするために設計されたScribe v2 Realtimeは、ライブ字幕、リアルタイムの会議メモ作成、AIアシスタントへのライブテキスト入力による二次トリガーなどを必要とするユースケースに適しています。また、プロンプト用に最大50個のキーワードをサポートします。
Scribe v2 Realtimeで文字起こしする方法
ライブ文字起こしを行うには、ElevenAPIを使ってプロダクトをScribe v2 Realtimeに接続します。
- まず、WebSocketを開き、プロダクトがScribe v2 Realtimeモデルから文字起こしを受信できるようにします。
- 次に、ライブ会議の会話ストリームをモデルに送信します。
- 最後に、150ms以内に部分文字起こしと最終文字起こしを受信します。
コード内では、APIイベントのハンドラーを作成します。これらのイベントは文字起こしプロセス全体で発生します。たとえば、音声データの送信時や、確定した文字起こしの受信時のイベントをコードで処理します。
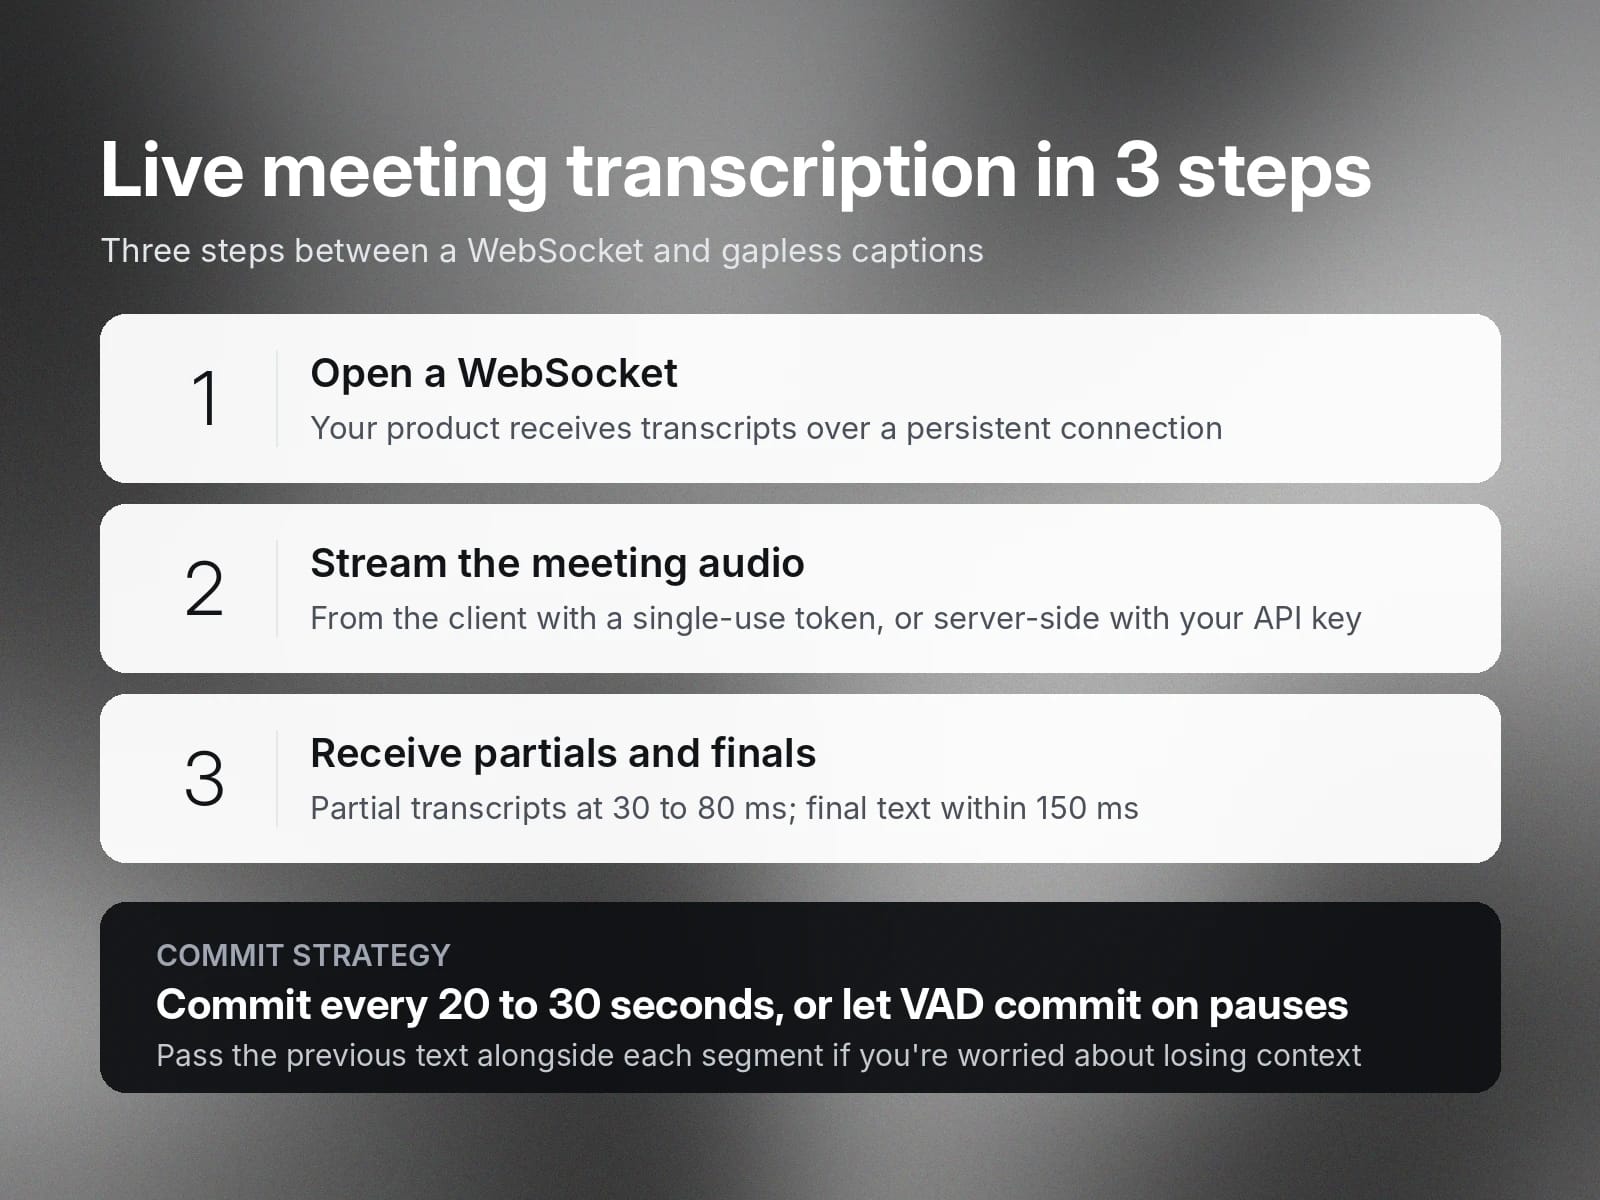
Scribe v2 Realtimeのライブストリーミング方法
以下の例では、バックエンドで使い捨てトークンを作成します。クライアントは会議音声を会議文字起こしAPIへAPIキーを公開せずにストリーミングできます。
アプリのアーキテクチャに応じて、クライアントアプリまたはバックエンドサーバーからScribe v2 Realtimeへライブ会話をストリーミングできます。
- クライアントサイドストリーミング:この方法では、マイクから直接、または手動チャンク化によって、音声入力をオーディオモデルへ送ります。APIへの接続には使い捨てトークンで検証を行うため、APIキーの公開を防げます。
- サーバーサイドストリーミング:この方法では、URL、ファイルアップロード、またはオーディオストリームから直接音声をストリーミングできます。使い捨てトークンの代わりにElevenLabs APIキーを使用します。
Scribe v2 Realtimeのコミット戦略を選ぶ
以下の例では、音声アクティビティ検出を設定します。話者が一時停止するたびに、APIが文字起こしセグメントをコミットします。
最終文字起こしは、会議で話された内容を正確に記録する証拠資料となります。最終文字起こしをコミットする方法は、手動とVoice Activity Detection(VAD)の2種類です。
- 手動コミット: デフォルトでは、コード内で文字起こしセグメントを手動でコミットする必要があります。最適な遅延を実現するため、20〜30秒ごとのコミットをおすすめします。コンテキストの喪失が懸念される場合は、前のテキストを音声セグメントとともに送信して処理できます。
- Voice Activity Detection: または、音声ストリーム内の無音を検出して文字起こしを開始するVADを使用できます。
オプション2:バッチ文字起こし(会議後)
バッチ文字起こしは、何時間もの会議録音をテキスト形式に変換する効果的な方法です。簡潔でコンテキストに適した、話者分離済みの文字起こしを大規模に提供します。
Scribe v2は、動的なオーディオタグ付けをサポートするElevenLabsのスピーチtoテキストモデルです。会話データに加え、笑い声や足音などの非音声イベントも正確に抽出できます。
リアルタイム文字起こしとは異なり、Scribe v2は録音後の会議メモ向けに構築されています。たとえば、Zoom、Teams、Google Meetなどのプラットフォームで会議を録音し、セッション後に音声ファイルをScribe v2へアップロードしてバッチ文字起こしを行います。

Scribe v2でバッチ文字起こしする方法
Scribe v2での文字起こしは、REST APIを介して非同期で行われます。音声モデルとのアクティブな接続を維持する必要はありません。代わりに、文字起こしの準備ができた際に通知を受けるためのWebhookを使用します。
以下は、フローの論理的な流れです。このフローは音声録音を文字起こしに変換します。
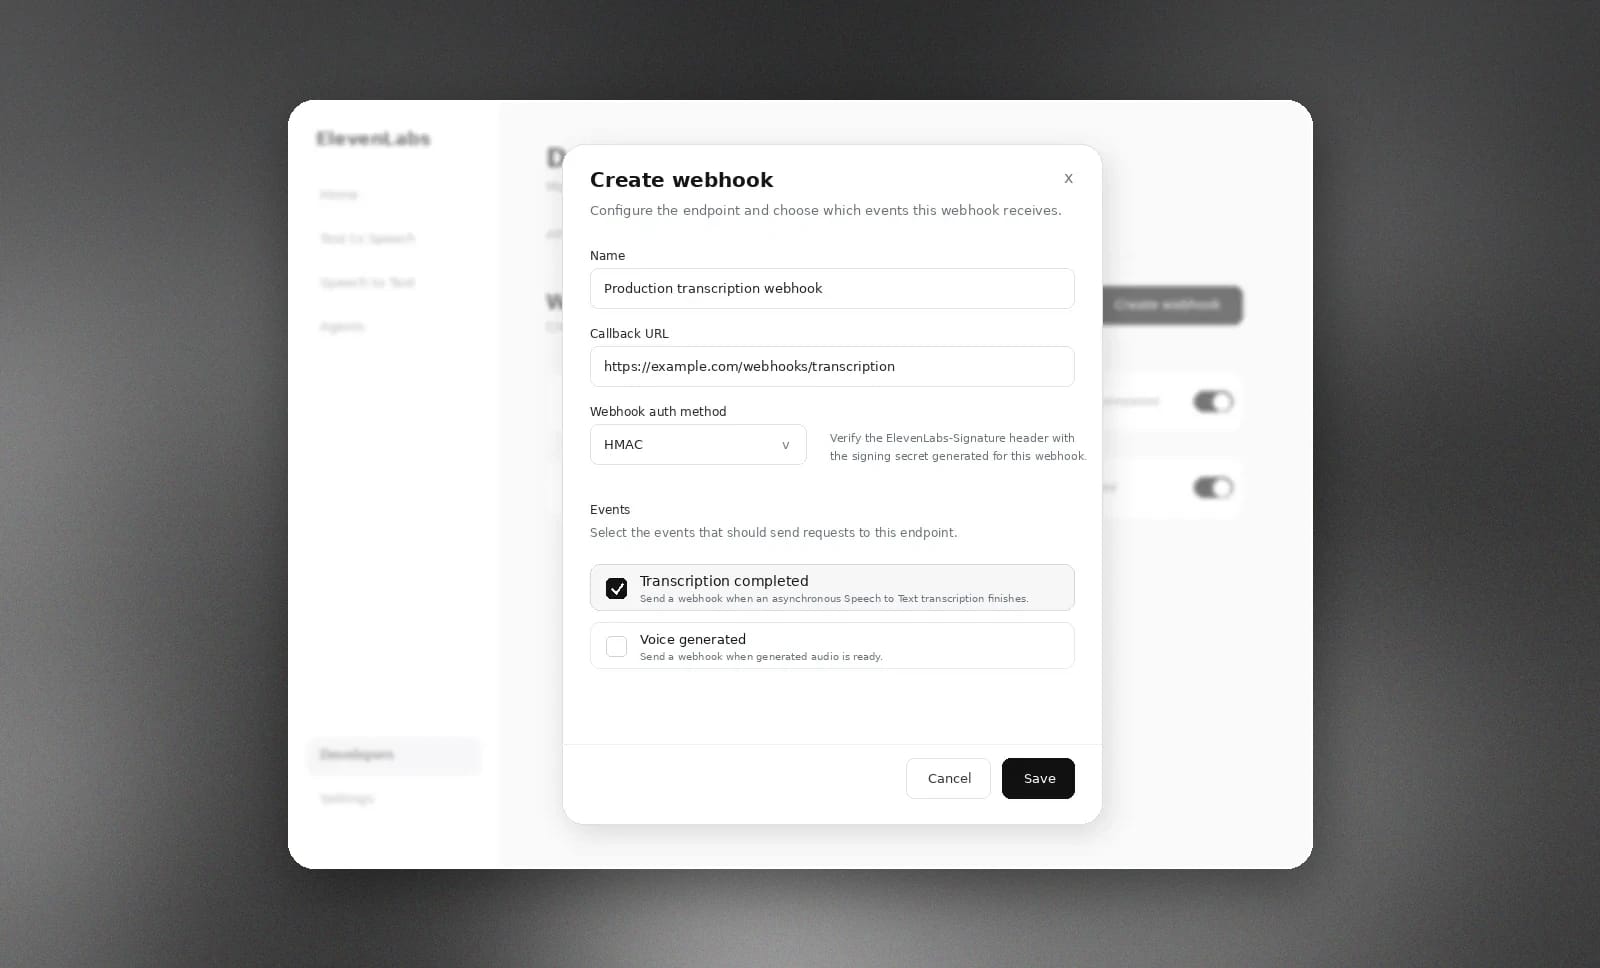
- まず、文字起こし結果を受け取るためにElevenLabsダッシュボードでWebhookを作成します。
- 次に、返された文字起こしを処理するイベントハンドラーをコード内に作成します。
- その後、音声ファイルをScribe v2のRESTエンドポイントへアップロードします。
文字起こしが完了すると、設定したイベントハンドラーが呼び出されます。
Scribe v2のキーワードプロンプト
Scribe v2(バッチ)は、最大1,000語のキーワードプロンプトに対応しています。文字起こし用の音声ファイルを送信する際、API呼び出しに用語を含めることができます。語彙リストとは異なり、Scribe v2はキーワードを会話のコンテキストと照合し、適切な文字起こしを判断します。
これにより、特定の用語が発話されたときにモデルがより注意を払い、正確に文字起こしできます。
以下の例では、リクエストとともに会社名とプロダクト名を渡しています。そのため、APIはコンテキストに応じて正確に文字起こしします。
たとえば、ブランド名または会社名として文脈に沿って「ElevenLabs」と発音した場合、そのように文字起こしされます。
Scribe v2のマルチチャンネル文字起こし
マルチチャンネル文字起こしでは、Scribe v2モデルが、異なる話者の音声を含む音声ファイルの各チャンネルを文字起こしできます。この機能は、会議、法廷記録、ポッドキャスト向けの文字起こしツールを構築する際に便利です。
各チャンネルには、話者を表す一意の識別子がタグ付けされます。
会議文字起こしでよくある課題とAPIによる対処方法
会議を文字起こしする際、エンジニアリングチームはしばしばいくつかの課題に直面します。

発言の重なり
複数の話者が同時に話すと、内容の理解が難しくなります。話者を区別するには、Scribe v2が提供するダイアライゼーションまたはマルチチャンネル文字起こしを使用します。これにより、それぞれの話者にタグ付けされた個別の文字起こしを取得できます。
誤認識
文字起こしツールが直面するもう1つの課題は、特定のプロダクト名、ブランド名、業界用語を正確に検出・解釈することです。たとえば、ソフトウェアデベロッパーには馴染みのある「DevOps」という用語が、「dev ops」と誤って文字起こしされる可能性があります。ElevenLabsの会議文字起こしAPIでは、キーワードプロンプトにより、モデルを正しい解釈へ導けます。
多言語話者
複数の言語に堪能な話者が、2つ以上の言語を切り替えながら話す会議もあります。標準的な音声モデルはコンテキストや発話内容の解釈に苦戦し、文字起こし品質が低下します。Scribe v2は、多言語文字起こしにより、90以上の言語で会話を展開どおりに正確に記録します。
ライブ字幕と録音後の文字起こし
ライブ字幕の投影と会議後の文字起こし生成の両方を必要とするチームもあります。しかし、既製の文字起こしツールがすべて両機能を提供するわけではありません。ElevenLabs APIなら、Scribe v2とScribe v2 Realtimeを使って両方を実現できます。
会議文字起こしAPIを始める
ElevenAPIでは、会議向け文字起こしツールを構築するための先進的なスピーチtoテキストモデルを利用できます。開発環境のセットアップは簡単です。APIキーを取得し、PythonまたはNode.js向けSDKをインストールします。その後、提供されるAPIを使ってScribe v2またはScribe v2 Realtimeをプロダクトに統合します。
ElevenLabsにアクセスして、最初のAPIリクエストを送信しましょう。
よくある質問

Jack LimebearはGrowthチームに所属し、ブログやインサイトページのコンテンツライター兼ストラテジストとして活躍しています。ElevenLabsに入社する前は、急成長中のSaaSスタートアップからFortune 500企業まで、さまざまな組織で10年以上にわたりコンテンツ戦略をリードしてきました。ケンブリッジ大学で英文学の修士号を取得しています。