
音声アクティビティ検出とは?その仕組みを解説
- 公開日
音声アクティビティ検出は、ミリ秒単位の短い音声フレームに人の発話が含まれるかどうかを分類します。文字起こし、電話、音声エージェントなど、多くのデジタル音声処理アプリケーションで利用されています。
この記事では、音声アクティビティ検出でできることとできないこと、そして主要なエンタープライズアプリケーションでの役割を解説します。
概要
- 音声アクティビティ検出(VAD)は、現代のオーディオワークフローにおける基本的な要素です。音声ストリームを継続的に分析し、ミリ秒単位の各音声フレームに人の発話があるかどうかを、はい/いいえで出力します。
- VADは、下流のオーディオツールに対して、処理すべきタイミングと待機すべきタイミングを伝えます。LLMや文字起こしサービス、その他のエンタープライズ向け音声パイプラインの一部で使われています。
- 音声アクティビティ検出アルゴリズムは、音声の取得、フレーム化、音声特徴の抽出、発話が含まれる可能性のスコアリング、下流サービスへの判定の受け渡しという、5段階の連続ループで動作します。
- VADはもともと、発話の有無をはい/いいえで判定するために、純粋に数学的な信号処理に依存していました。現在のAIベースのシステムは、ニューラルネットワークを用いて同じ機能を実現し、バックグラウンドノイズや意味的な手がかりをより文脈に即して理解します。
- VADシステムが分類するのは、音声フレームに発話が含まれるかどうかだけです。話し手が話し終えたタイミングはわかりません。エンドポイントシステムは、VADやその他のヒューリスティック分析ツールを使って、話し手が考えを言い終えたかどうかを判断します。
- エンタープライズ環境では、VADは音声エージェントが顧客の話を遮らずに自然に会話するのを支援し、VoIPの帯域幅利用を最適化し、スピーチtoテキスト(STT)AIの文字起こしコストを抑えるなど、さまざまな用途があります。
- VADシステムは実環境の条件でテストしてください。無傷のスタジオ録音では、性能を効果的に判断できません。
音声アクティビティ検出(VAD)とは?
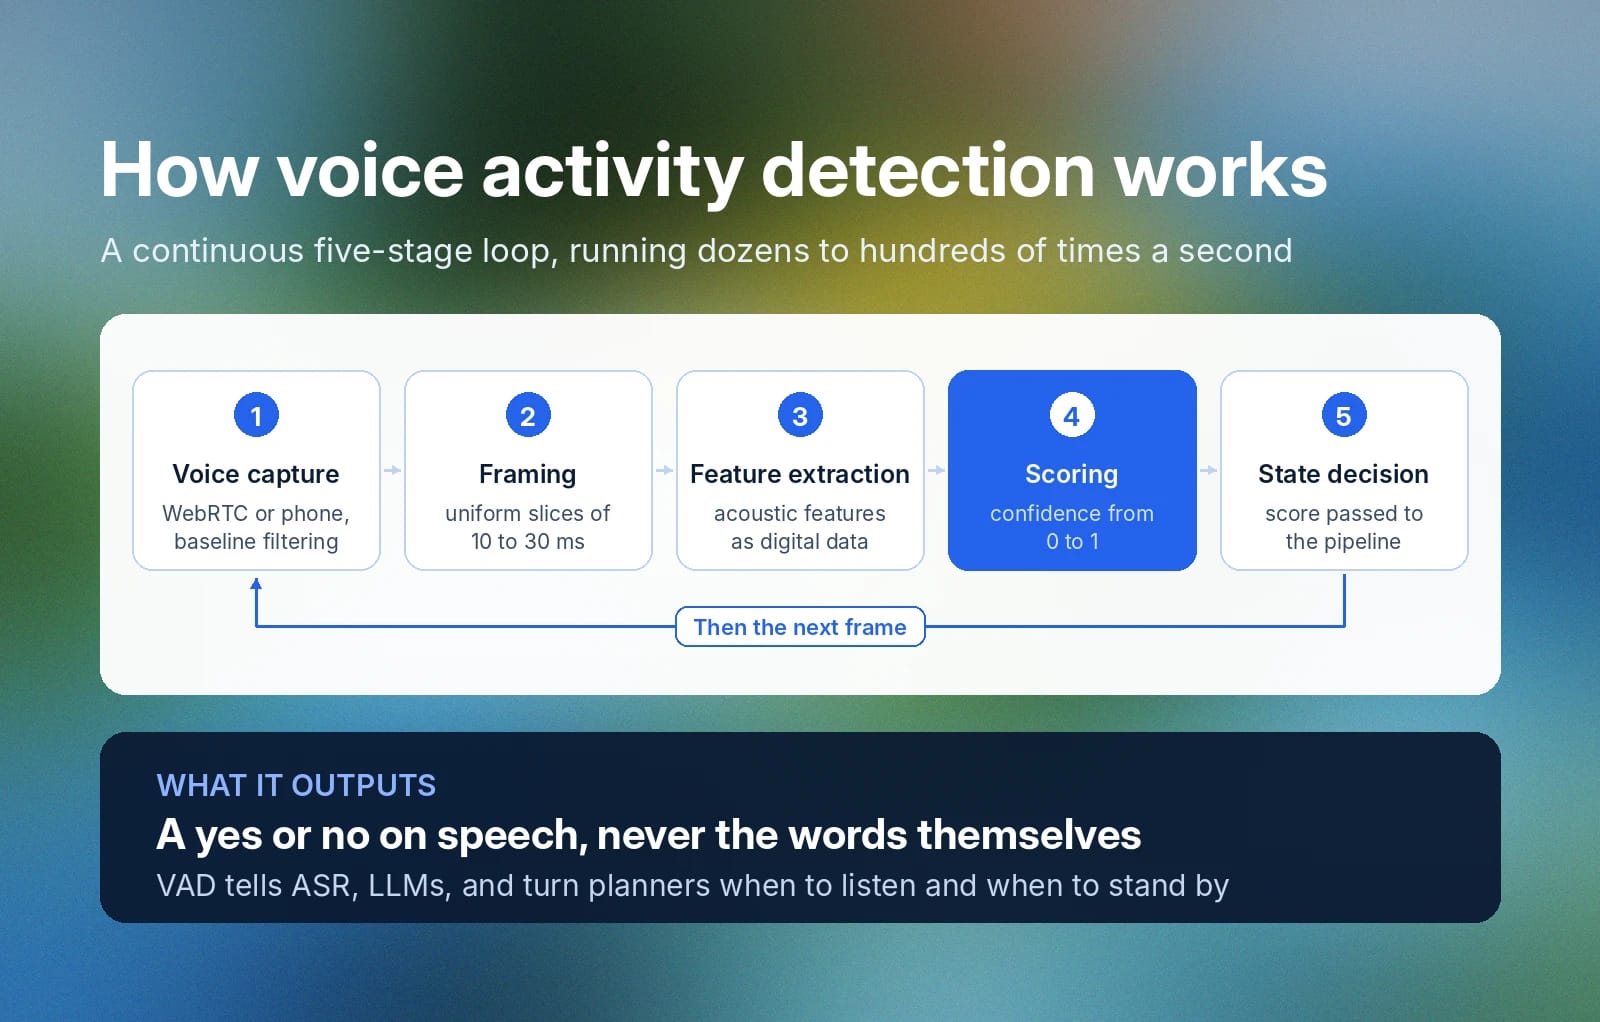
音声アクティビティ検出(VAD)は、フレームと呼ばれる小さな音声チャンクに発話が含まれるかどうかを分類するソフトウェア処理です。VADアルゴリズムは音声ストリーム上で毎秒数十回から数百回実行され、発話を検出したかどうかを「はい」または「いいえ」の二値で返します。
これは、通信や音声文字起こしなど、より広範なデジタル音声パイプラインで使われています。ASR/STT、LLM、ターンプランナーなどの下流システムに、音声ストリームを能動的に聞くべきか、待機すべきかを伝えます。
VADは、自動音声認識(ASR)とは異なります。VADシステムが行うのは、発話を検出したかどうかについて、確率的なはい/いいえの応答を出力することだけです。実際の単語を出力するわけではありません。主な役割は、下流システムに対して特定の音声フレームを処理すべきかを伝えることです。
音声アクティビティ検出アルゴリズムの仕組みは?
VADアルゴリズムは音声ストリームに対して実行され、通常10~30ミリ秒の音声フレームに発話が含まれるかどうかを、はい/いいえで判定します。
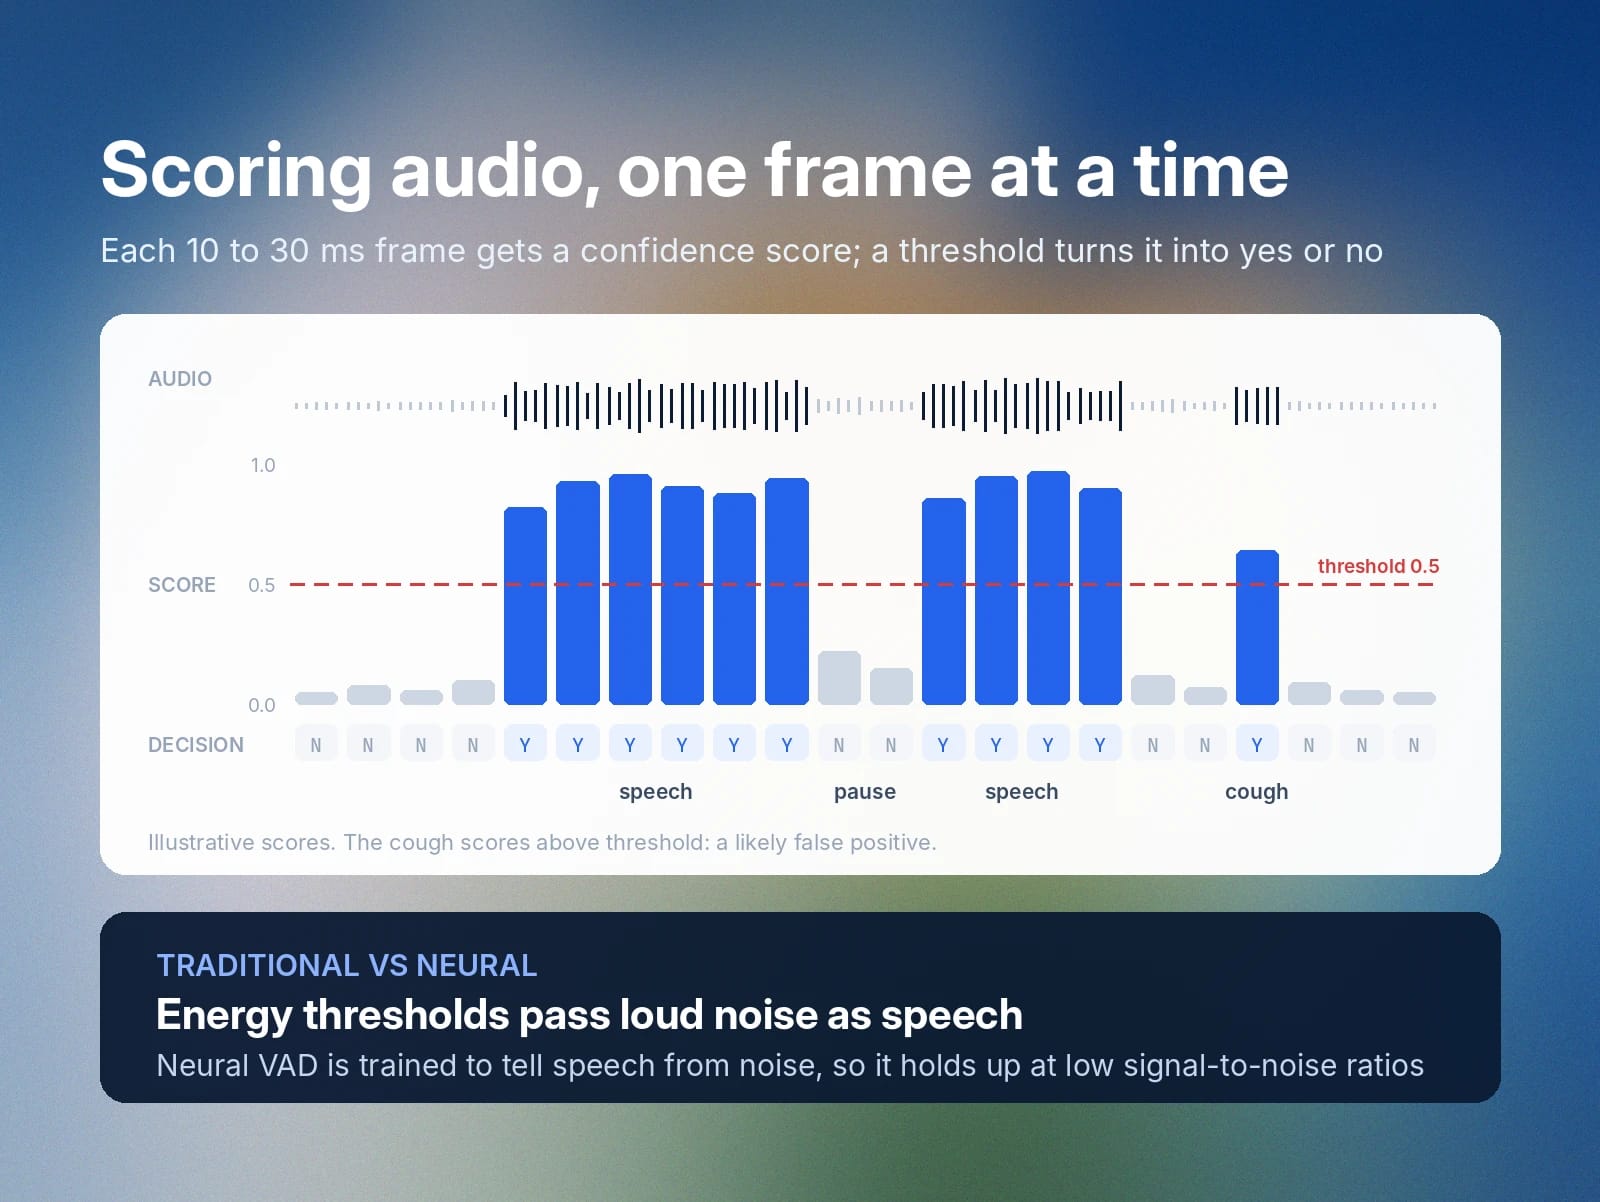
次の5段階のループで継続的に動作します。
- 音声の取得:VADを実行するシステムは、WebRTCまたは電話を通じて音声ストリームを受信し、基本的なノイズフィルタリングをデータに適用します。
- フレーム化:アルゴリズムが生の音声ストリームを均一なフレームに分割します。
- 特徴抽出:アルゴリズムがストリームから、デジタルデータとして数学的に表現できる音響特徴を抽出します。
- スコアリング:システムはフレーム内で抽出した特徴をVADアルゴリズムにかけ、発話を含む可能性について0~1の信頼度スコア(0=「発話なし」、1=「発話あり」)を生成します。
- 状態の判定:VADシステムは信頼度スコアを実行中のオーディオパイプラインに渡し、パイプラインが処理方法を決定できるようにします。
従来型とAIベースの音声アクティビティ検出
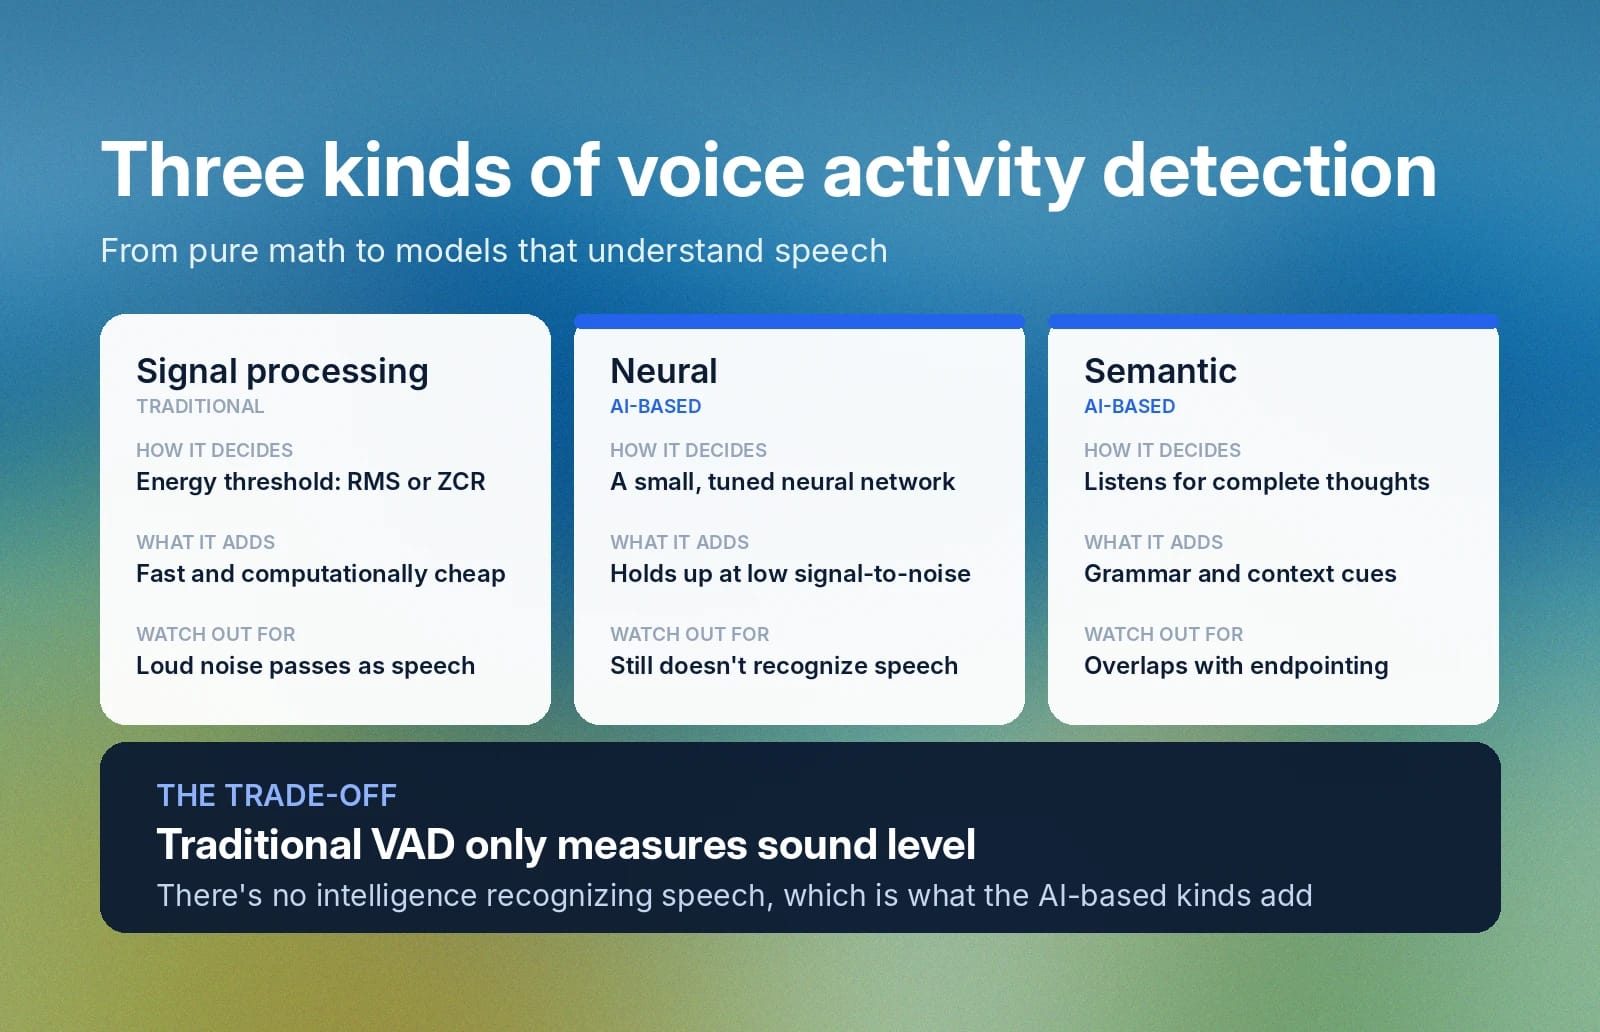
VADは、大きく信号処理とAIの2種類に分けられます。
AIベースのVADには2つの異なるアプローチがあり、音声アクティビティ検出は合計3種類に分類されます。
それぞれを詳しく見ていきましょう。
従来型(信号処理)VAD
従来型のVAD技術は、音声ストリームのエネルギーレベルを測定し、一定の閾値を超えた場合に発話ありと判断します。これは純粋に数学的な処理であり、多くの場合、二乗平均平方根(RMS)またはゼロ交差率(ZCR)の計算を用います。フレームが閾値を上回れば発話として渡され、下回れば発話として扱われません。
従来型VADは高速で計算コストも低い一方、音声内の音量しか測定しません。大きなバックグラウンドノイズは偽陽性を引き起こす可能性があります。実際に発話を認識する知能はありません。
AIベースのVAD
新しいAIベースのVADには、ニューラル型とセマンティック型の2種類があります。ニューラルVADは、純粋に数学的な閾値を使う代わりに、小規模で高度に調整されたニューラルネットワークを使い、音声フレームに発話または無音が含まれるかを判断します。学習により発話とノイズの違いを理解できるため、音声ストリームの信号対雑音比(SNR)が低く、バックグラウンドノイズが大きい場合には、従来型VADより優れた性能を発揮します。
ニューラルVADの欠点は、発話そのものを認識するわけではない点です。セマンティックAI VADは、それを認識できる別の種類です。話された内容が完結しているかを音声入力から判断するという点で、エンドポインティングと重なります。文法や文脈から、さらに発話が続く可能性を理解できます。
VADとエンドポインティングの比較
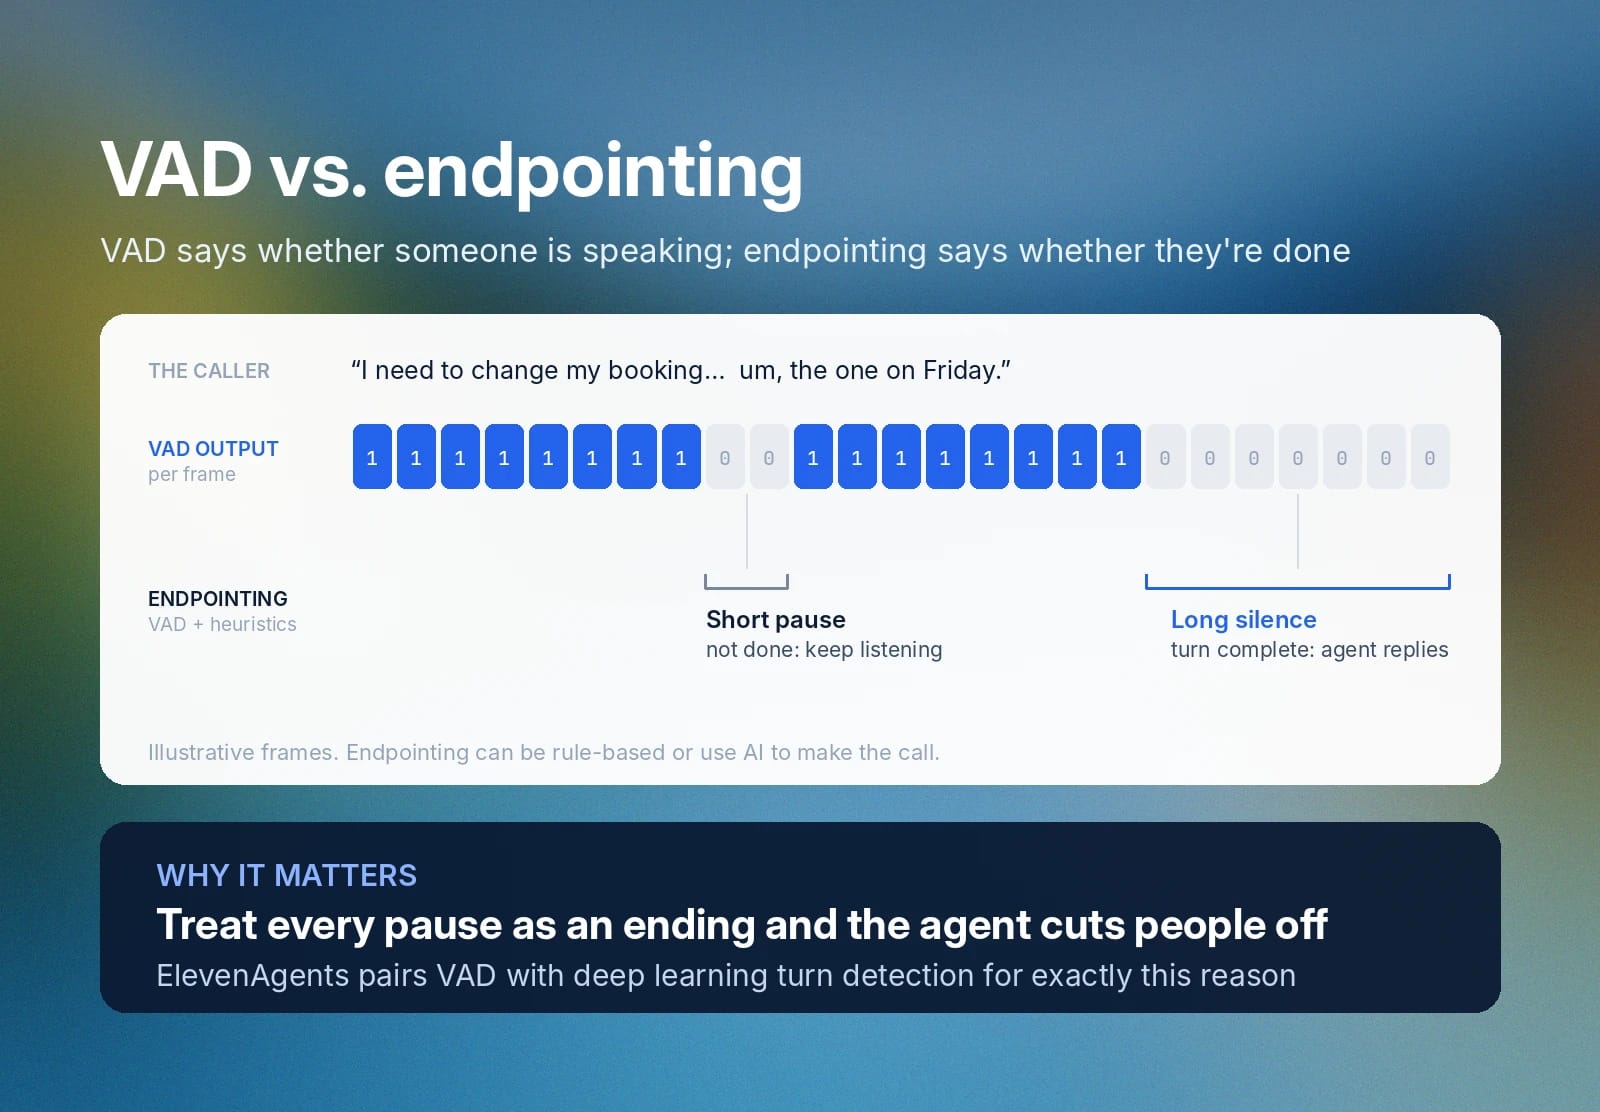
VADとエンドポインティングは補完関係にある技術です。音声アクティビティ検出システムは、処理する各音声フレームで誰かが話しているかどうかを単純に判断します。はい/いいえの二値判定を行い、残りの音声処理パイプラインに渡します。
エンドポインティングシステムは、VADの出力とヒューリスティック分析を組み合わせ、話し手が考えを言い終えたかどうかを判断します。この判定には、ルールベースの信号処理またはAIを利用できます。
リアルタイムAIにおける音声アクティビティ検出の用途
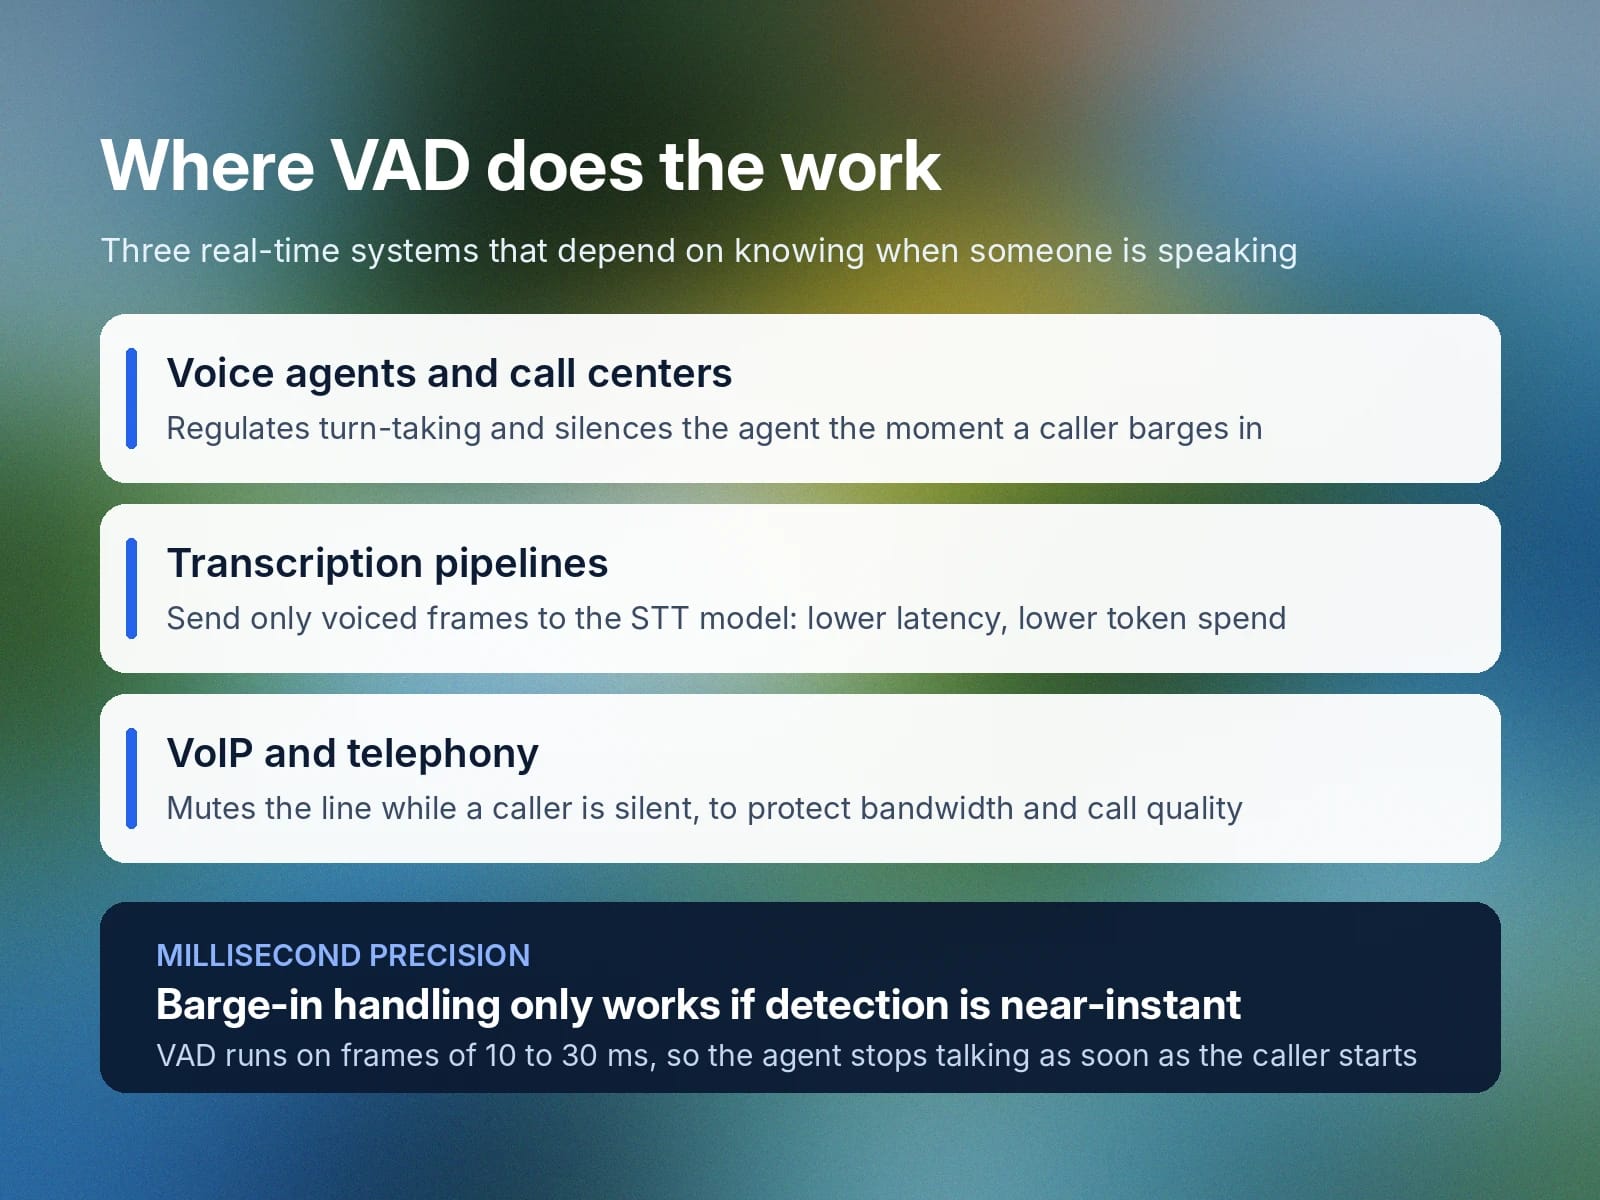
音声アクティビティ検出は、数多くのユースケースで重要な役割を果たします。
自律型音声エージェントとコールセンター
自律型エージェントが顧客の通話をスクリーニングするには、応答するのに適切なタイミングを把握する必要があります。エージェントが顧客の話の途中で割り込んだり、顧客が早めに応答した際に話し続けたりすることは避けなければなりません。VADは、会話のターンテイキングを調整し、自然なフローを維持するのに役立ちます。ミリ秒単位で動作するため、顧客が割り込んだときにエージェントを停止する「バージイン」の管理にも非常に効果的です。
文字起こしパイプライン
スピーチtoテキストの文字起こしAPIサービス(たとえばElevenAPI)を使用している場合、音声アクティビティ検出で送信する音声をフィルタリングし、モデルが発話フレームのみを処理するようにできます。これによりネットワーク遅延が減り、さらに重要なことに、文字起こしモデルでのトークン使用量を削減できます。バックグラウンドノイズにAIコストを費やす必要はありません。
VoIPと電話の最適化
遅延は、エンタープライズVoIPネットワークの通話品質にも影響します。パフォーマンスを最適化するため、こうしたデジタル音声システムは、発信者が話していないときにVADを使って一時的に回線をミュートします。
音声アクティビティ検出が難しい理由
従来の音声アクティビティ検出は、発話があるかを判断するために数学的アルゴリズムを使用します。しかし、人の話し方は一様ではありません。会話は不規則で途切れがちであり、バックグラウンドノイズや周囲の会話がある実環境で行われます。VADの中心的な課題は、ノイズの多い音声の中から意味のある無音を特定することです。
これは、いくつかの具体的な課題として現れます。
文の途中の間
人は会話全体を通して一定のリズムで話すわけではありません。立ち止まって考えをまとめたり、話しながら考え直したり、何を言おうとしていたか忘れたりします。こうした間は、いずれも話し手が話し終えたことを意味しません。人間の聞き手には通常わかりやすいことでも、ソフトウェアにとっては、新しいAIモデルであっても難しい場合があります。
VADシステムがこうした間を発話終了と誤認すると、処理中に文の途中で音声が切れたり、音声エージェントが人の話し手を遮ったりする可能性があります。
発声ノイズ
小さな声、語尾で弱まる子音(文末によく見られます)、ボーカルフライのような特徴により、VADシステムが正当な発話を見逃すことがあります。
予測できない音響環境
ファンや流水のような連続的なバックグラウンドのホワイトノイズは、VADシステムでも比較的簡単にフィルタリングできます。一方、犬の鳴き声のような散発的なノイズは、存在しない発話として検出される可能性があります。
強い音声圧縮はダイナミックレンジを失わせ、VADが無音フレームと発話フレームを区別しにくくする場合があります。
VADの性能を評価する方法
人の発話は、特に変化の多い実環境で録音される場合、一様ではありません。無傷な音声録音はVADの性能をテストする適切な手段ではありません。また、純粋なスピーチtoテキストの精度も、VADが検出した後段の処理であるため、VADシステムの有効性を直接測るものではありません。
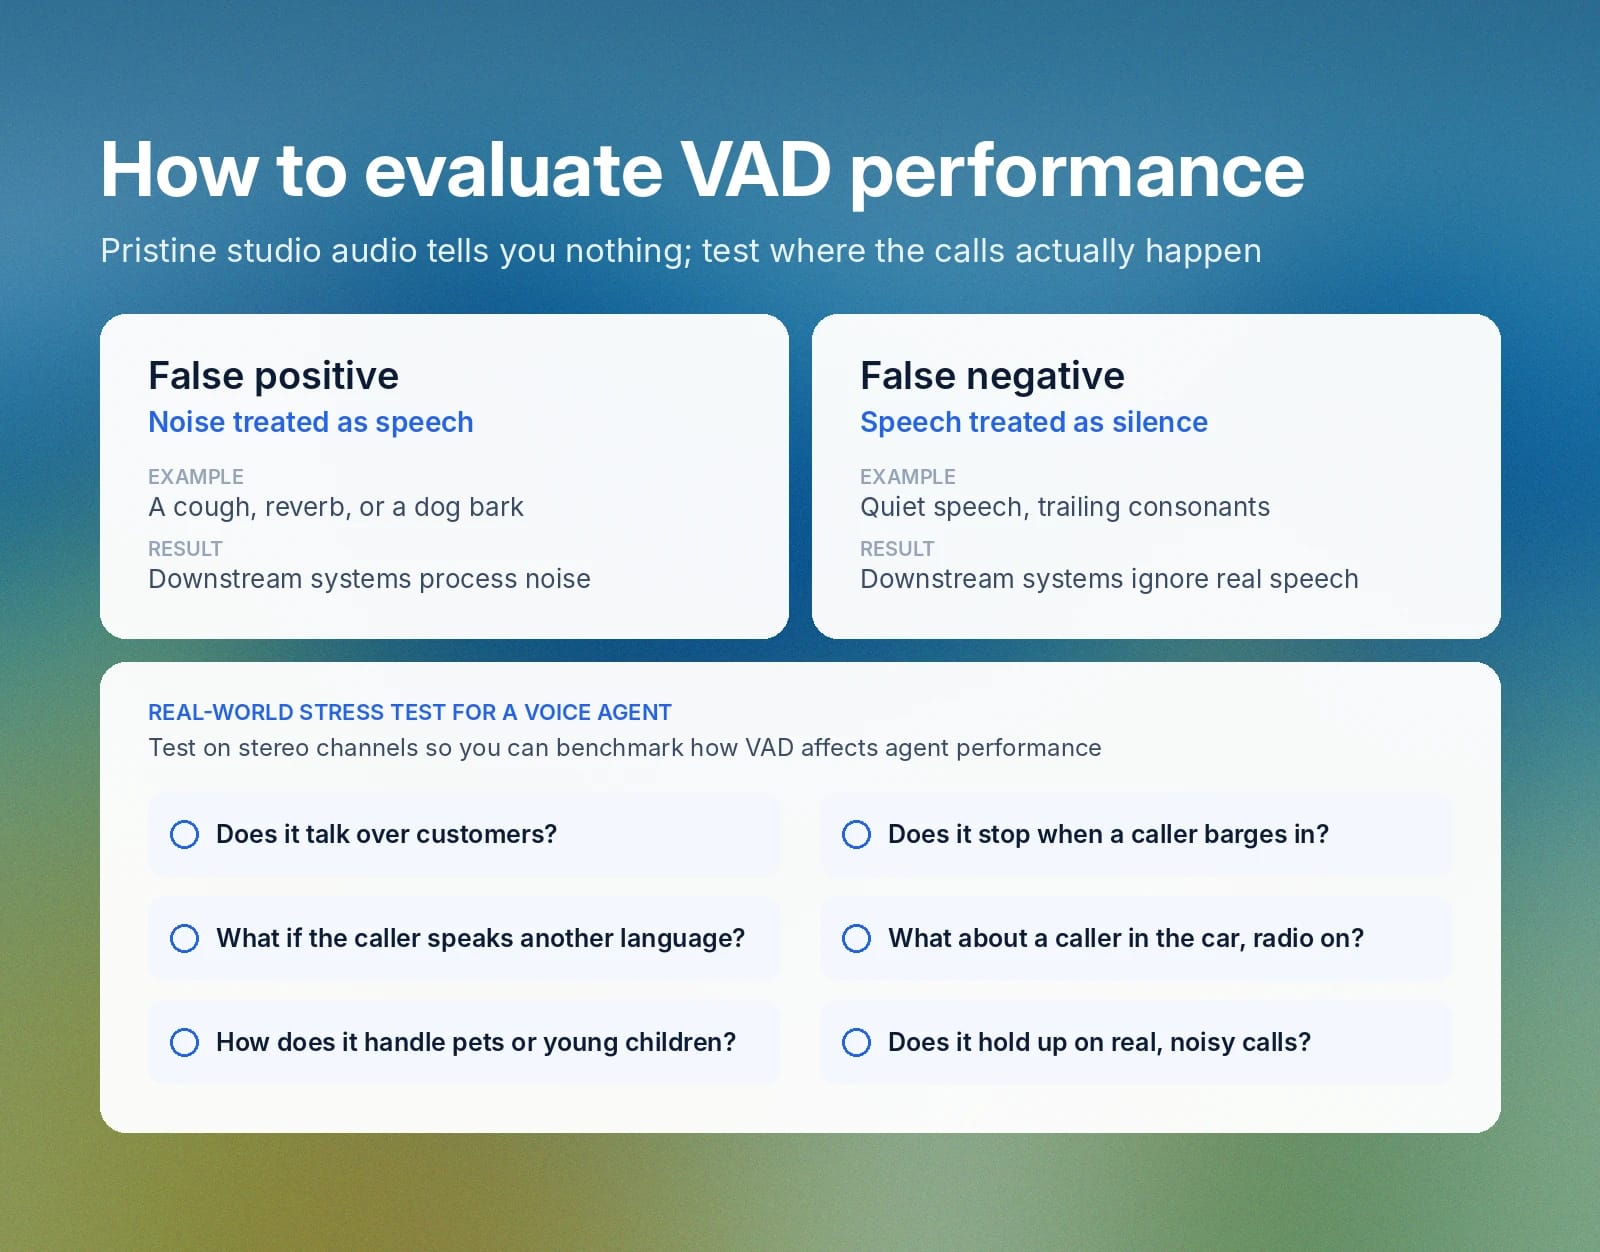
偽陽性と偽陰性
VADの偽陽性とは、ノイズを発話として扱うことです。咳、残響、犬の鳴き声など、突然のバックグラウンドノイズによって誤ってトリガーされ、発話フレームとして渡されることがあります。
偽陰性とは、発話を無音として扱うことです。VADが誤って下流サービスに音声フレームを無視するよう伝えます。
実環境でのストレステスト
VADサービスを評価するには、実際に音声が録音される環境と実世界の条件下で、どのように機能するかを確認する必要があります。
たとえば、音声エージェントにVADを使用するなら、ステレオチャンネルでテストして、エージェントのパフォーマンスへの影響をベンチマークしてみてください。次のような疑問が生じるかもしれません。
- 顧客の発話にかぶせて話してしまう偽陰性はあるか?
- ユーザーが割り込んだとき、エージェントの発話を停止できるか?
- 発信者が外国語を話す場合はどうなるか?
- 実環境から電話をかけている話者を聞く場合、どのように機能するか?
- 顧客が車から電話をかけ、ラジオの音量を下げない場合はどうなるか?
- ペットや幼い子どもによるバックグラウンドノイズには、どの程度対応できるか?
こうした状況はすべて、顧客対応の通話では起こり得ます。VADは、負荷がかかる状況でも安定して機能する必要があります。
カスタマーサービス向けElevenAgentsを始める
ElevenAgentsは、ハイブリッドVADとディープラーニングによるターン検出システムを使い、エージェントとの会話を自然かつスムーズに維持します。
ElevenAgentsで、今すぐ新しいカスタマーサービスエージェントの構築を始めましょう。登録して始めましょう。
よくある質問

Jack LimebearはGrowthチームに所属し、ブログやインサイトページのコンテンツライター兼ストラテジストとして活躍しています。ElevenLabsに入社する前は、急成長中のSaaSスタートアップからFortune 500企業まで、さまざまな組織で10年以上にわたりコンテンツ戦略をリードしてきました。ケンブリッジ大学で英文学の修士号を取得しています。



