
ベクトルデータベースとは?AI検索が意味を見つける仕組み
- 公開日
聴くこの記事を聴く
ベクトルデータベースは、AIモデルが意味の類似性に基づいて非構造化データを検索・取得できるストレージシステムです。AIは、学習データに含まれない知識も使って回答を生成できるようになります。
ベクトルデータベースは、LLMが処理しやすい形式で情報を保存します。AIモデルに追加情報を提供し、関連性が高く正確な回答の生成を支えます。
このガイドでは、ベクトルデータベースとは何か、その仕組み、主なユースケース、種類、具体例、リレーショナルデータベースやグラフデータベースとの違いを解説します。
要点
- ベクトルデータベースは、学習した特徴表現をベクトル埋め込みとして多次元空間に保存します。
- キーワードの一致に依存する従来のデータベースとは異なり、ベクトルデータベースはクエリに対して意味が似ているデータを取得します。
- ベクトルデータベースは社内ドキュメントを保存し、音声AIやカスタマーサービスがRAGシステムを使って文脈に即した回答を提供できるようにします。
- チャットボット、AI検索エンジン、会話型AIなどのアプリケーションは、ベクトルデータベースが対応するセマンティック検索と非構造化データを活用できます。
- ベクトルデータベースとグラフデータベースは異なります。グラフデータベースは関連するエンティティを結び付け、グラフ探索アルゴリズムによるマルチホップクエリに対応します。一方、ベクトルデータベースは追加の文脈を必要とする単純なクエリに適しています。
ベクトルデータベースとは?何を保存するのか
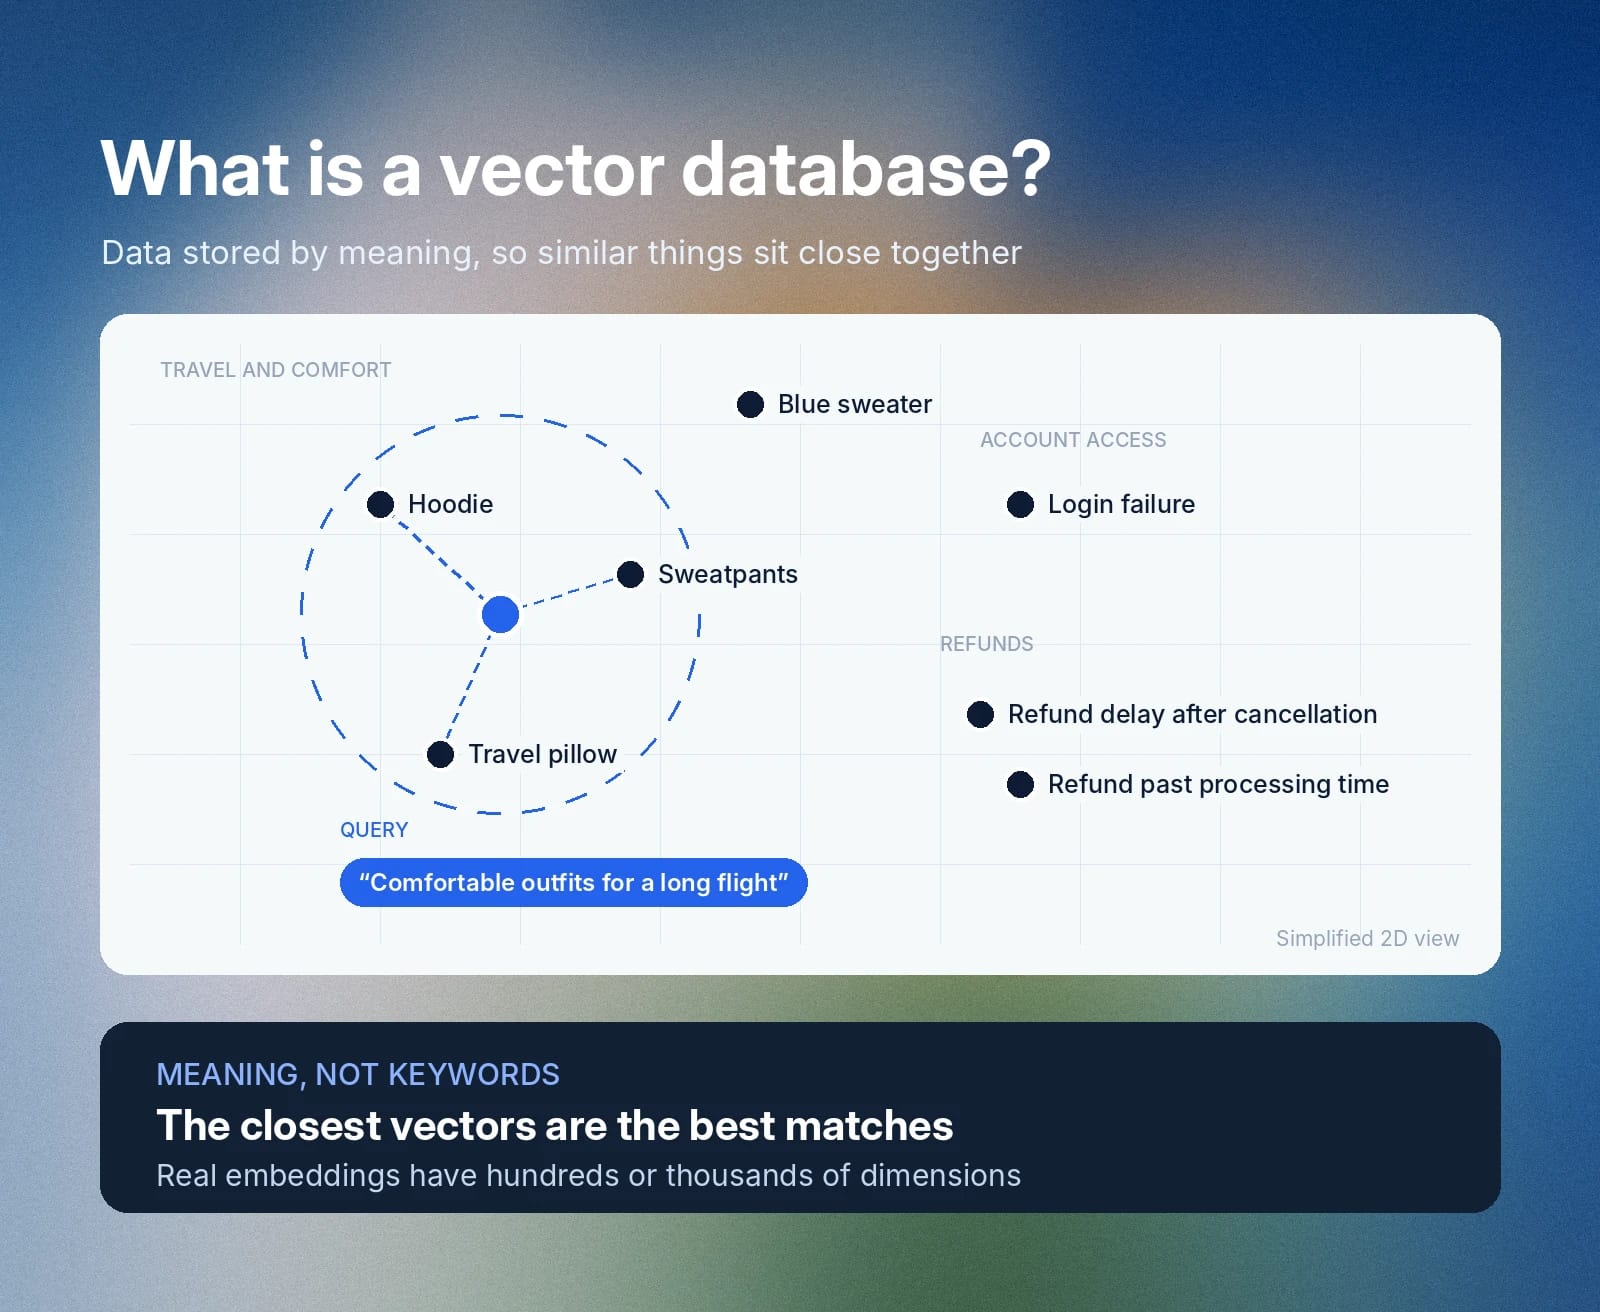
ベクトルデータベースは、埋め込みと呼ばれる数値表現としてデータを保存し、AIモデルによる低遅延のセマンティック検索を可能にします。行と列に情報を保存する従来のデータベースとは異なり、ベクトルデータベースは意味の類似性に基づいて、多次元空間内で埋め込みをグループ化します。
AIにおける「次元」とは、特定の対象について学習された特徴や特性を指します。たとえば犬なら、毛の色や品種などを次元としてイメージできます。ただし実際には、学習された埋め込みの各次元が、人間が理解できる単一の特徴に対応することはほとんどありません。
生成AIアプリケーション、特に外部の知識ソースに接続するものは、検索を高速化するためにベクトルデータベースを使用します。従来のデータベースでキーワードの完全一致を探す代わりに、検索システムがベクトルデータベース内で最も類似する埋め込みを見つけます。
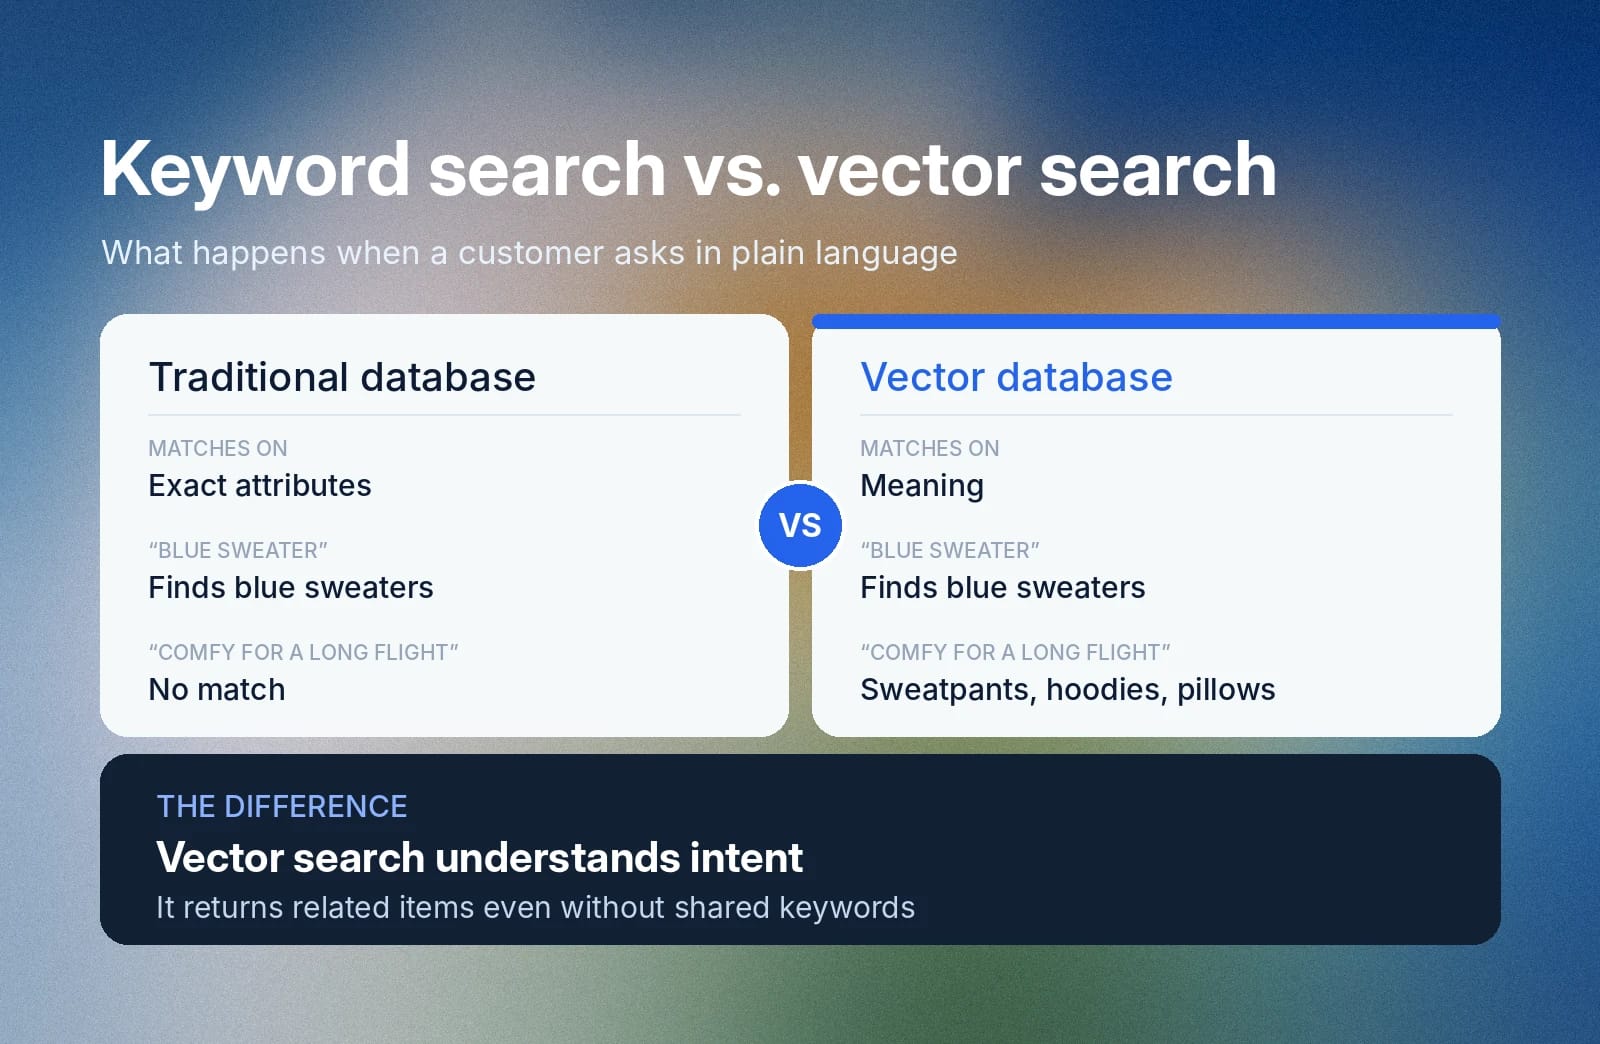
顧客から電話で「青いセーター」を勧めてほしいと言われたとします。従来のデータベースなら、「青」と「セーター」という属性に一致する商品を探します。しかし顧客が「長時間のフライトでも快適に過ごせる服装」を求めた場合、従来のデータベースでは回答できません。
一方、ベクトルデータベースはリクエストの意味を捉えます。ベクトル空間にマッピングすることで、特徴表現が近いスウェットパンツ、パーカー、トラベルピローなどを返します。このように意味を照合できることが、ベクトルデータベースと従来のデータベースの違いです。
ベクトル埋め込み:音声、テキスト、画像を数値に変換
ベクトル埋め込みは、テキスト、画像、ビデオなどの非構造化データを表す数値の配列で、AIモデルが処理しやすい形式にしたものです。
ベクトルは、複数の次元にまたがる数値を数学的に表現したものです。ただし、ベクトルだけでは特定のデータセットの文脈、構造、意味までは捉えられません。
たとえば、浮動小数点数のリスト[0.82, 0.14, 0.67]はベクトルですが、それが何を表すかは埋め込みモデルによって決まります。
埋め込みはデータの特性を捉え、多次元空間内のベクトルとして保存します。本来は単なる数値のリストに意味を与えるものです。ベクトル内の各数値は、学習された表現の1つの次元に当たります。
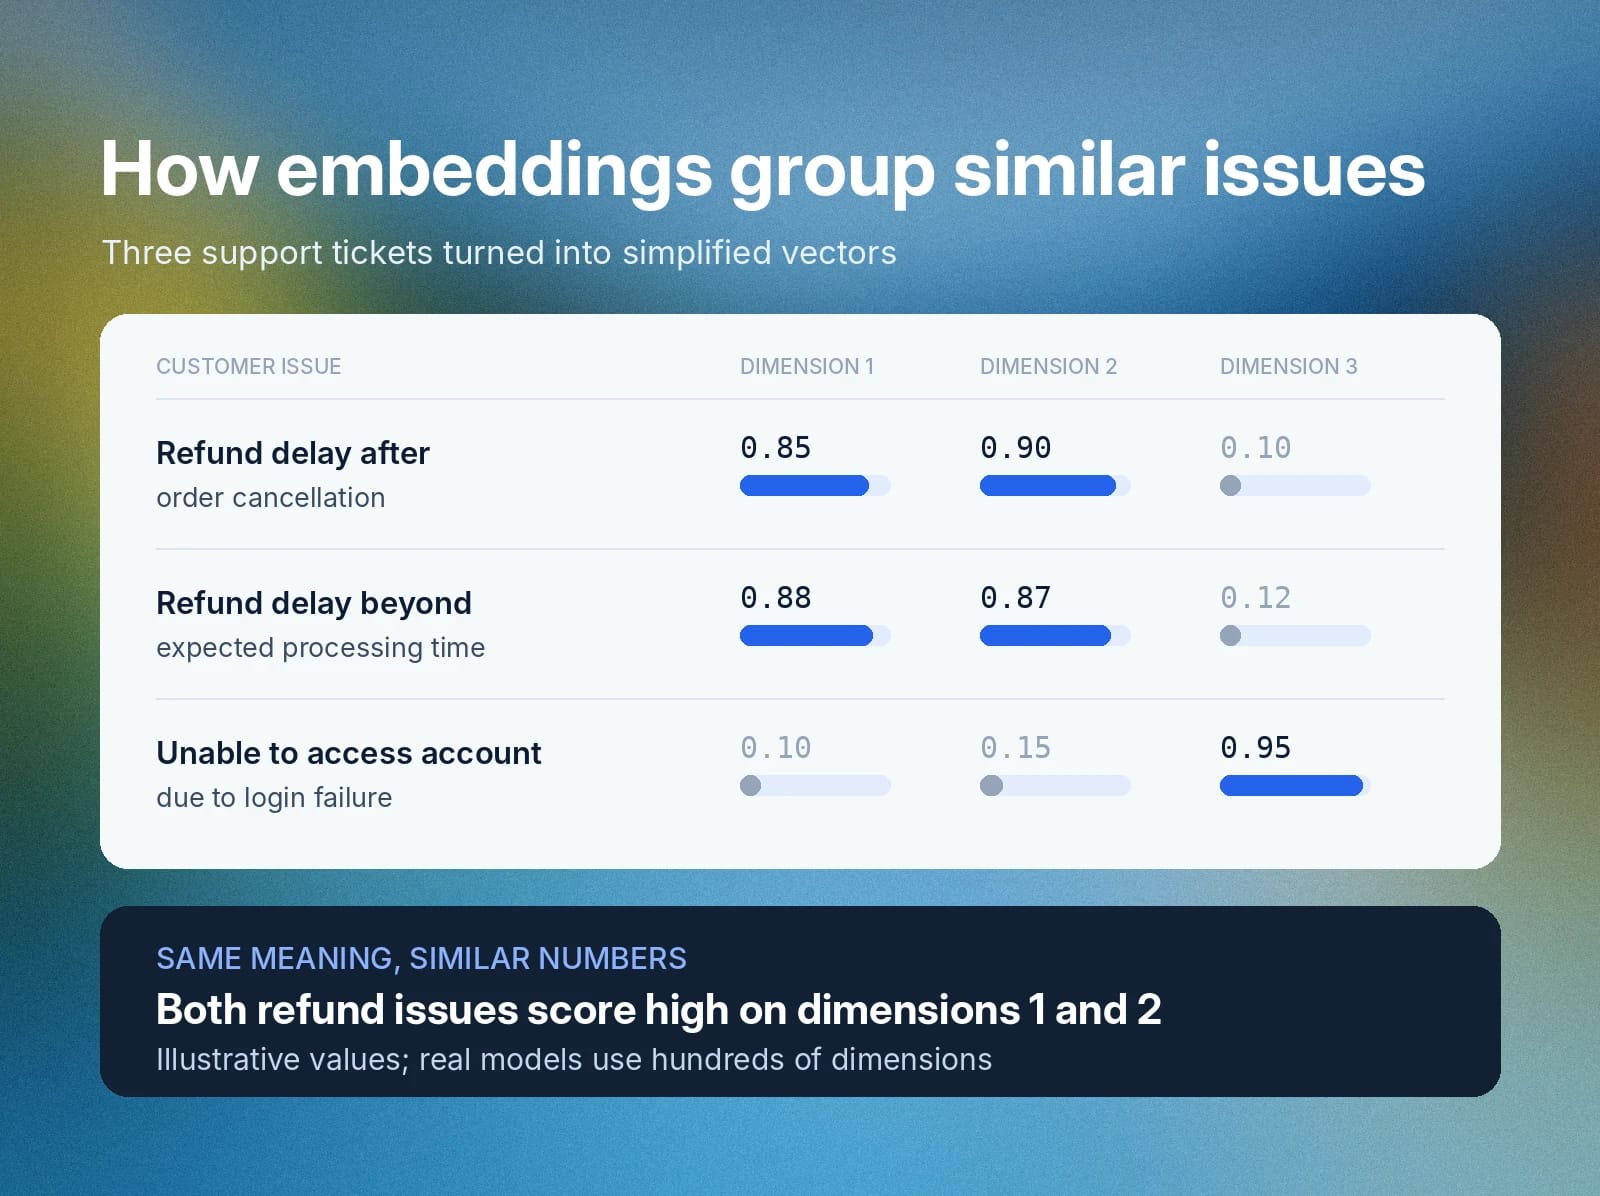
顧客の問い合わせ事例をベクトルデータベースに保存するとします。埋め込みモデルを使い、問い合わせの種類を、各次元に異なる値を持つ埋め込みへ変換します。以下の値は説明用に簡略化しています。
顧客の問題
埋め込み
注文キャンセル後の返金遅延
[0.85, 0.90, 0.10]
想定処理期間を超えた返金遅延
[0.88, 0.87, 0.12]
ログインに失敗してアカウントにアクセスできない
[0.10, 0.15, 0.95]
原因は異なっていても、2件の返金問題は第1次元と第2次元の値が高く、ログインの問題は第3次元の値が最も高くなっています。通常、埋め込みモデルは数百から数千の次元を生成するため、ベクトルデータベースはそれらを素早く比較できるように設計されています。
ベクトルデータベースの仕組み
ベクトルデータベースは非構造化データを埋め込みに変換し、多次元空間に保存して、意味の類似性検索を可能にします。互いに密接に関連する埋め込みは、ベクトル空間内での距離も比較的近くなります。
ベクトルデータベースはクエリを受け取ると、近似最近傍(ANN)アルゴリズムを使い、データベース全体を走査せずに最も類似する埋め込みを取得します。
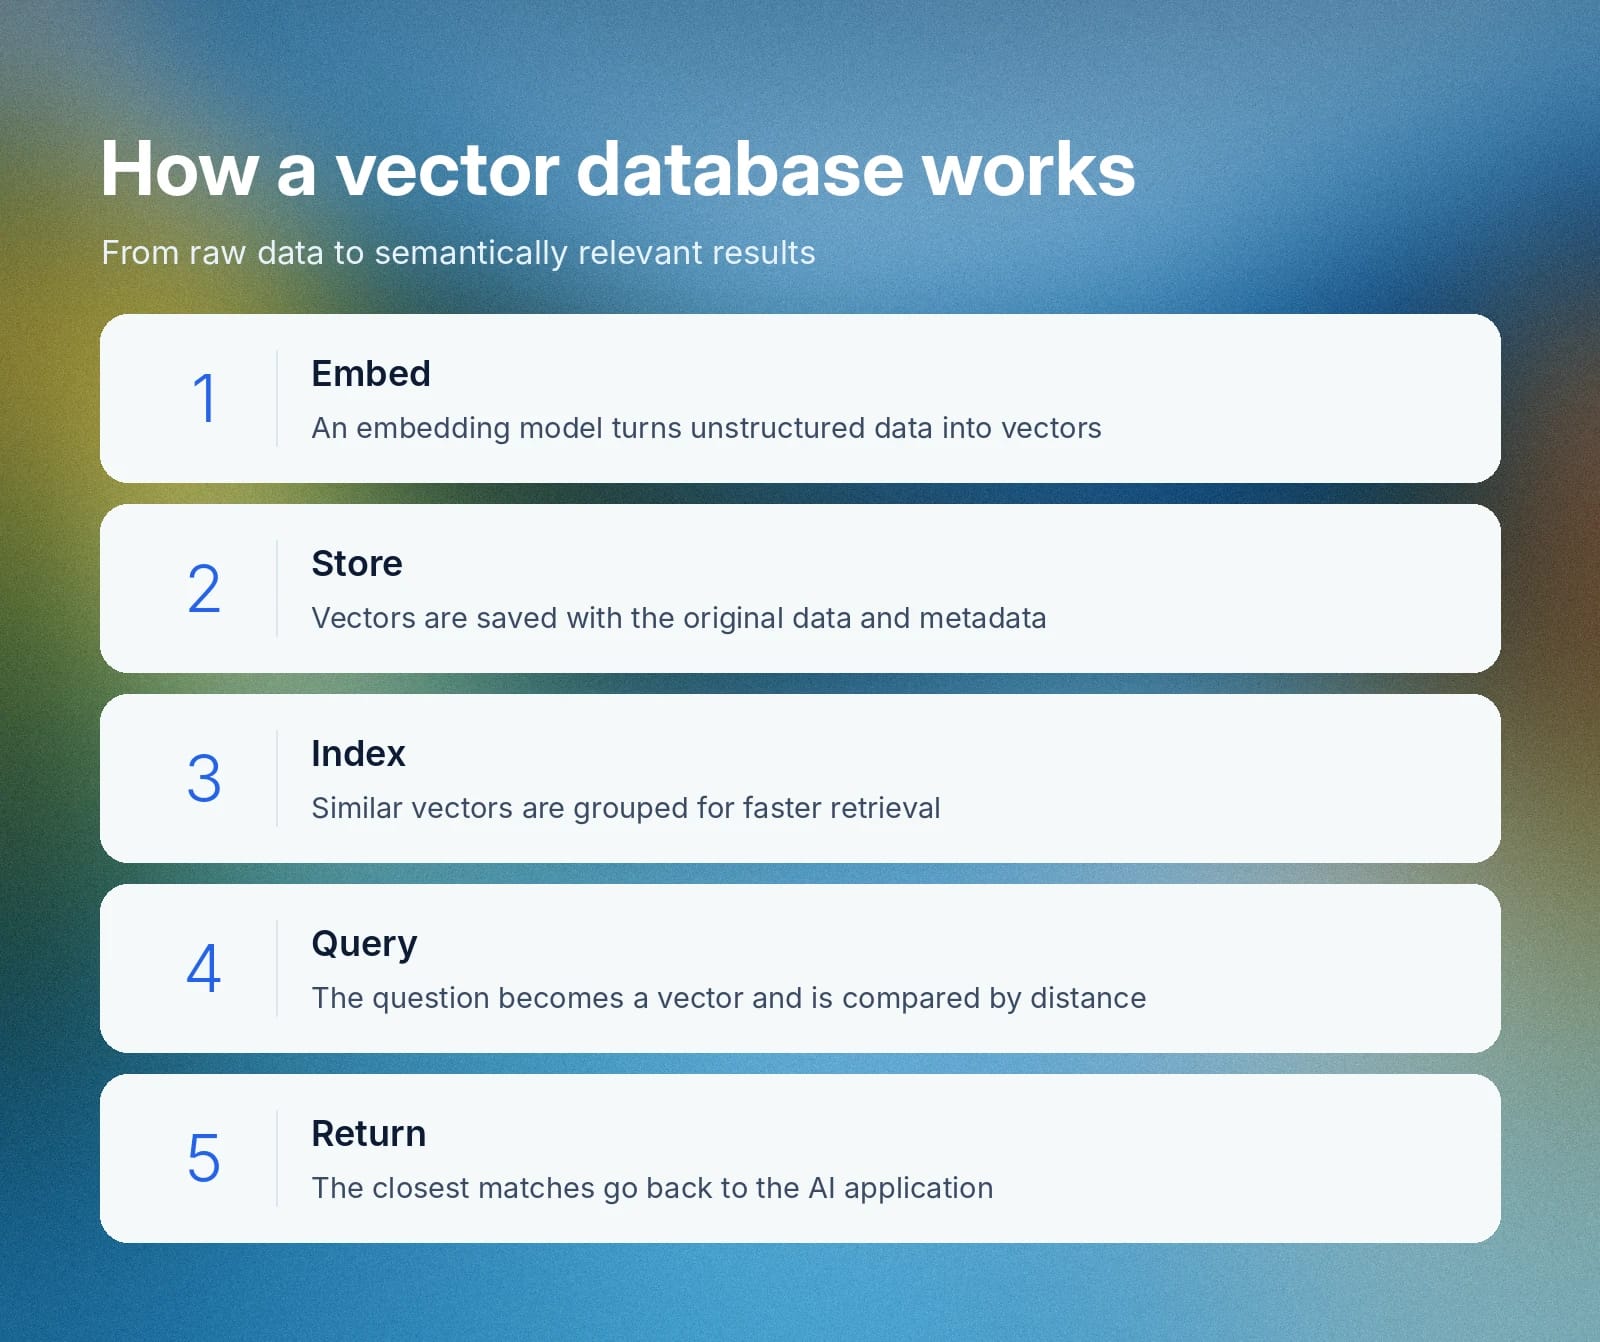
ベクトルデータベースの構築からデータ取得までの流れは次のとおりです。
埋め込みの保存
まず、埋め込みモデルが非構造化データを埋め込みに変換します。各埋め込みは、現実世界の対象が持つ意味的な特徴を表します。その後、元のデータやメタデータとともに、埋め込みをベクトルデータベースへ保存します。
意味が似ている埋め込みはベクトル空間内で近くに配置されるため、データベースはベクトル間の距離を測定して関連性の高いデータを取得できます。
インデックスによる検索の高速化
インデックス作成とは、検索効率を高めるためにベクトル埋め込みを整理する処理です。ベクトルデータベースは、密接に関連する埋め込みをグループ化するために複数のインデックス手法を使用します。たとえば、検索要件に応じてリスト、グラフ、ツリー構造を使用します。
ベクトルデータベースはインデックス作成に加え、直積量子化という手法でデータを圧縮することがあります。直積量子化は埋め込みをコンパクトなコードに圧縮し、検索精度がわずかに低下する代わりにメモリを節約します。
意味的に関連するデータの検索
ベクトルデータベースはクエリを受け取ると、それを埋め込みに変換します。その後、コサイン類似度、内積、ユークリッド距離などの手法を使い、クエリの埋め込みと多次元データベースに保存された埋め込みを比較します。
その結果に基づき、ベクトルデータベースは意味の類似度スコアが最も近い埋め込みを返し、生成AIアプリケーションはそれを使って回答を補強します。保存、インデックス作成、クエリを組み合わせることで、関連性の高い結果を素早く返せます。
ベクトル検索と類似性検索が関連性の高い結果を返す仕組み
類似性検索は、情報を照合するシステムの総称です。クエリ内の単語と完全に一致させるキーワードベースの手法に加え、意味に基づいて照合するベクトル検索も含まれます。
ベクトル検索はベクトルデータベースを使い、意味的に関連する回答を返します。キーワードの完全一致を検索するのではなく、クエリと回答候補の距離を比較して、最適な結果を選びます。
多くの場合、ベクトルデータベースは類似性検索を行う前に、メタデータを使って埋め込みを事前に絞り込みます。たとえば、特定の期間内の埋め込みに絞ることで検索範囲を狭めます。これにより、検索が高速になります。
音声AIとカスタマーサポートにおけるベクトルデータベースのユースケース
ベクトルデータベースは、正確なプロダクト知識に基づいて回答できる音声AIやチャットボットの導入を、カスタマーサポートチームが進めるうえで役立ちます。AIを活用したカスタマーサポートシステムでは、プロダクトガイド、業務ポリシー、顧客対応事例などの独自ナレッジベースをベクトルデータベースに保存します。
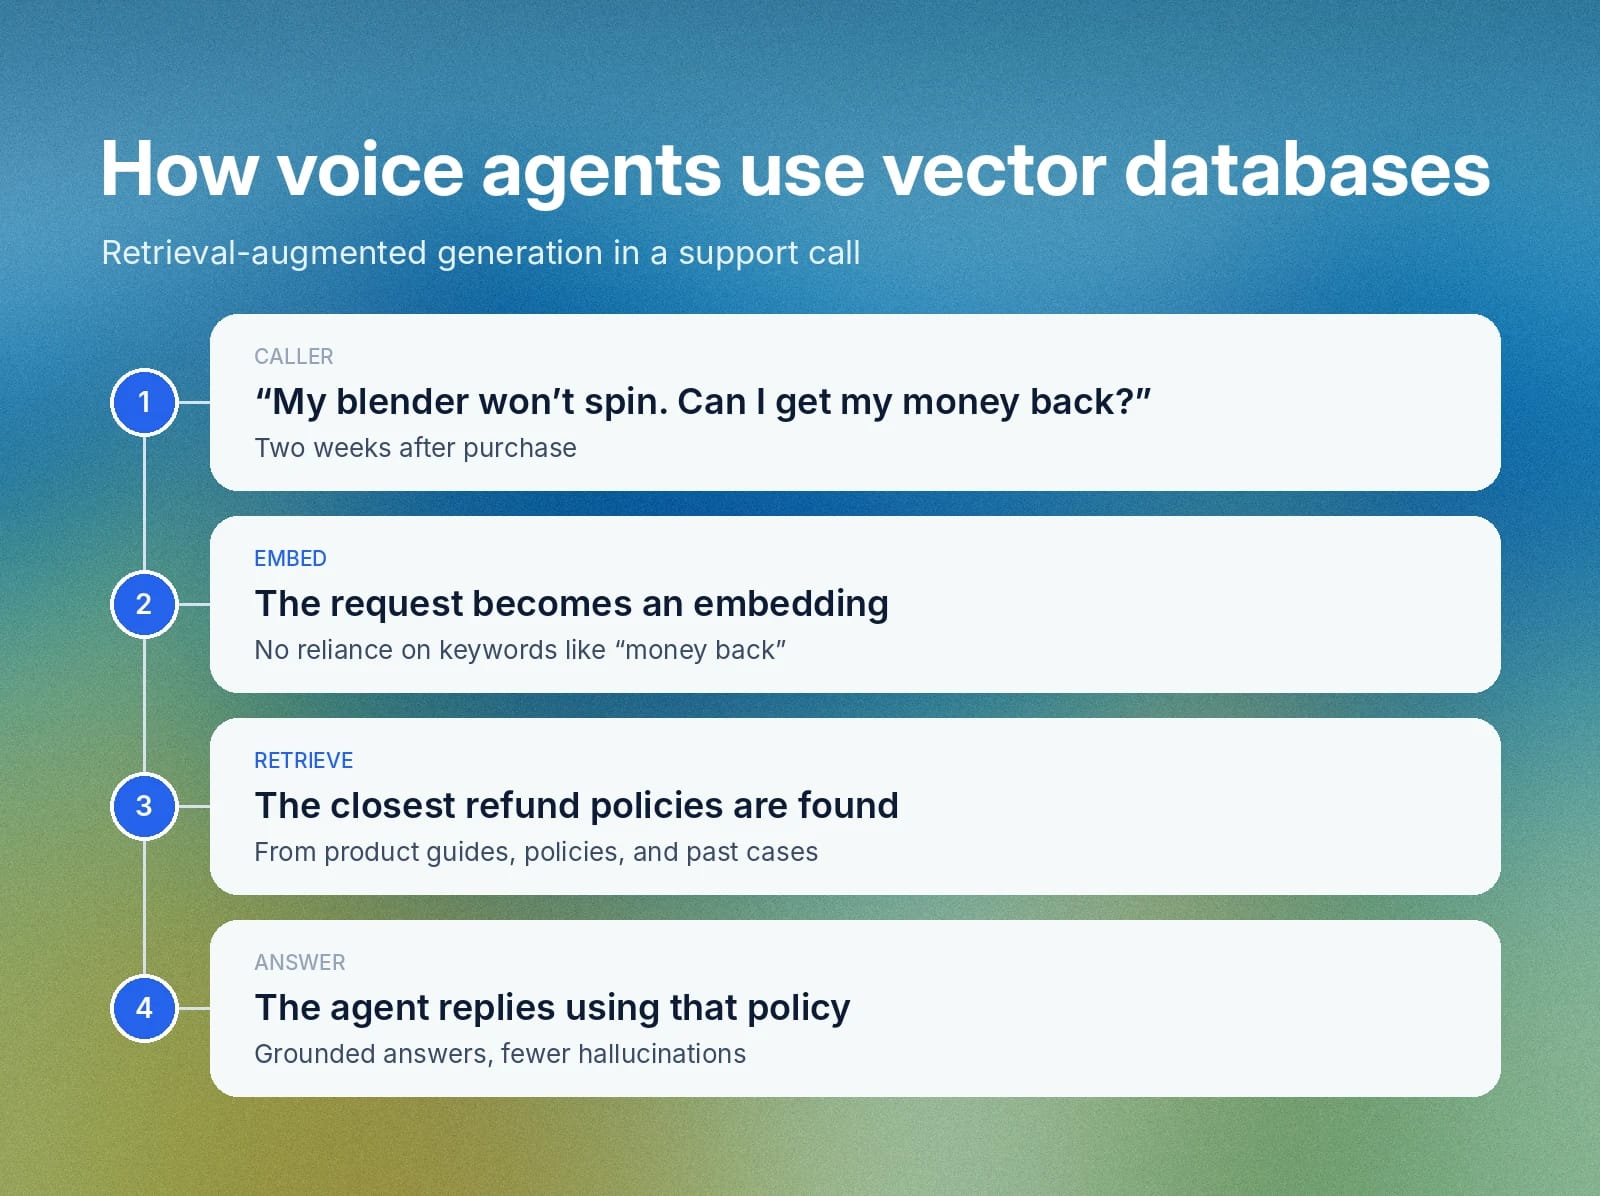
AIエージェントは、検索拡張生成(RAG)システムを使ってベクトルデータベースに接続します。
AI音声エージェントはクエリを受け取ると、顧客に回答するための情報が十分にあるか確認します。最新情報や十分なデータがない場合、RAGが意味的に一致するデータを取得して回答を補強します。
音声エージェントが「購入から2週間でミキサーが回らなくなりました。返金してもらえますか?」という苦情を受けたとします。「回らない」や「返金」といったキーワードの完全一致を探す代わりに、RAGはリクエストを埋め込みへ変換します。その後、意味が最も近い返金ポリシーを取得します。
ベクトルデータベースを基盤とするRAGシステムは、関連する社内ドキュメントを取得することで、音声エージェントのハルシネーションを減らします。ただし、完全になくすことはできません。AIエージェントと人間の担当者は、推測する代わりに社内ドキュメントを活用して顧客の問い合わせを解決できます。
ベクトルデータベースとリレーショナルデータベースの主な違い
リレーショナルデータベースは固定スキーマと行・列を使ってデータを保存します。一方、ベクトルデータベースは非構造化データを表す埋め込みを使用します。
リレーショナルデータベースは、指定した日付に行われたすべての注文を検索する場合など、完全一致や構造化クエリに適しています。一方、ベクトルデータベースはクエリと意味が最も近い保存済みの埋め込みを取得するため、自然言語による質問により効果的です。
どちらもデータを扱ううえで適した用途があるため、多くの場合、チームは両方を使用します。
ベクトルデータベースとグラフデータベース:それぞれを使う場面
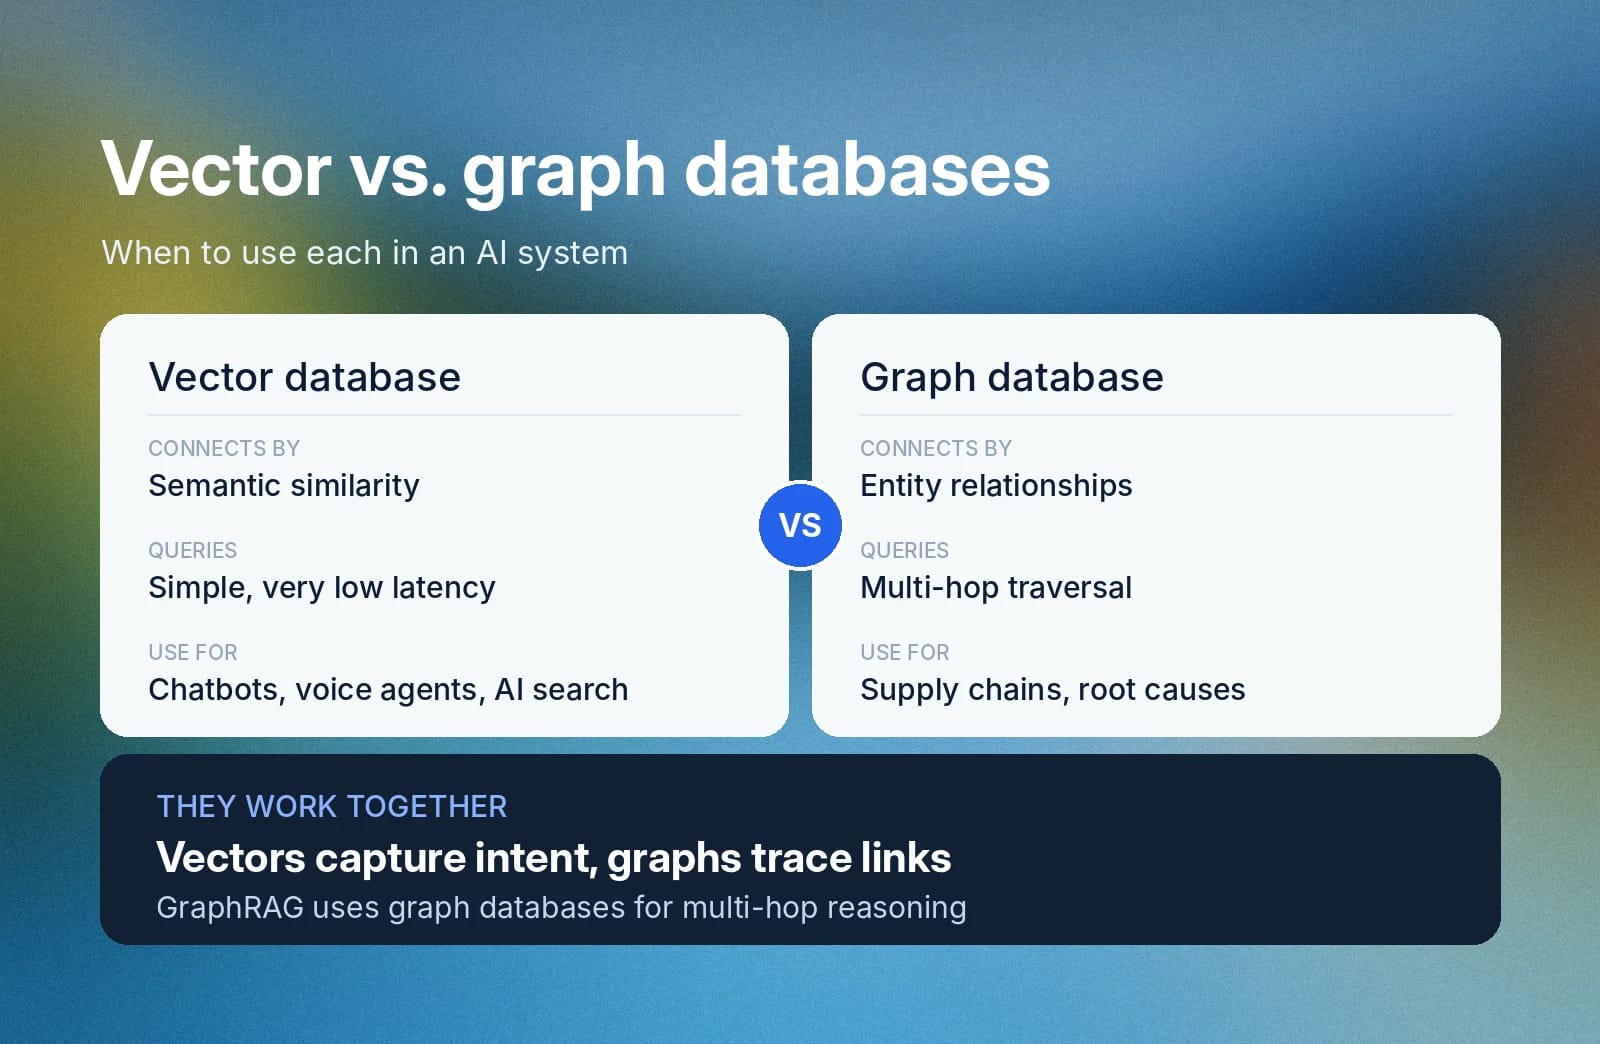
グラフデータベースはナレッジグラフを使い、階層や関係性を反映する形で異なるエンティティを接続します。GraphRAGのようなAIシステムは、マルチホップ推論が必要なクエリに回答するためにグラフデータベースを使用します。
グラフデータベースにクエリを送ると、起点となるデータポイントを特定し、グラフ探索アルゴリズムを使って関連するエンティティを見つけます。たとえば、顧客名から契約更新日、さらにサポートチケットへと順番に関連付けられます。
一方、ベクトルデータベースは、意味に基づく数値表現で非構造化データを保存します。RAGシステムは非常に低い遅延で単純なクエリ照合を実行できます。たとえば、「返金してほしい」というリクエストを処理すると、ベクトルデータベースが返金ポリシーを提示します。
ベクトルデータベースとグラフデータベースは、どちらもAIシステムに役立ちます。両方を組み合わせて使用することもできます。
- 人間の言葉から意図を読み取る必要があるチャットボット、音声エージェント、AI検索エンジンを構築する場合は、ベクトルデータベースを使用します。
- サプライチェーンの追跡、関連商品の提案、根本原因分析など、相互依存関係の問題を解決する場合は、グラフデータベースを使用します。
ベクトルデータベースにはどのような種類がある?
ベクトルデータベースは一般に、アーキテクチャの違いによって2種類に分けられます。
- スタンドアロン型ベクトルデータベース:低遅延の多次元類似性検索に対応する、独立した専用データベースです。多くの生成AIアプリケーションはスタンドアロン型ベクトルデータベースに接続し、大量のクエリ処理に対応します。
- ベクトルデータベース拡張機能:既存のデータベースにベクトル検索機能を追加し、AIモデルが意味に基づいてデータを取得できるようにするものです。SQLの行ベーススキーマなど、元のアーキテクチャを維持しながらベクトルデータ型に対応します。
どちらを選ぶかは主に、大量のクエリ処理に特化したシステムが必要か、すでに運用しているデータベースにセマンティック検索機能を追加したいかによって決まります。
ベクトルデータベースの例
ベクトルデータベースの例を2種類紹介します。
- スタンドアロン型ベクトルデータベース:Pineconeはマネージド型のベクトルデータベースサービスです。Milvus、Weaviate、Qdrant、Chromaはオープンソースのベクトルデータベースです。
- ベクトルデータベース拡張機能:pgvectorはPostgreSQLにベクトル類似性検索を追加し、MongoDB Atlas Vector SearchはMongoDBに同機能を追加します。
どれが適しているかは、必要な規模と、自社で管理したいインフラの範囲によって決まります。
検索対応の音声エージェントをElevenAgentsで始める
ElevenAgentsでは、音声エージェントが独自のナレッジベースから情報を取得し、会話の文脈を踏まえて回答できます。RAGを使い、ナレッジベースに追加したドキュメント、URL、テキストの中から、意味が最も近いコンテンツを取得します。検索を「オンデマンド」に設定すれば、エージェントが必要だと判断した場合にのみナレッジベースを検索できます。
RAGを導入すると、回答生成の遅延が増えるのは避けられません。しかし、エンジニアリングの進歩により、ElevenAgentsのRAGにおける遅延の中央値を326msから155msに短縮しました。
ElevenAgentsを使い始め、ナレッジベースの設定方法をこちらでご確認ください。
よくある質問

Jack LimebearはGrowthチームに所属し、ブログやインサイトページのコンテンツライター兼ストラテジストとして活躍しています。ElevenLabsに入社する前は、急成長中のSaaSスタートアップからFortune 500企業まで、さまざまな組織で10年以上にわたりコンテンツ戦略をリードしてきました。ケンブリッジ大学で英文学の修士号を取得しています。


