
自動音声認識(ASR)とは?
- 公開日
- 最終更新日
聴くこの記事を聴く
1952年、世界で最も高度な音声認識システムが理解できた単語は、わずか9語でした。
そこから約75年後、自動音声認識(ASR)は数十の言語をリアルタイムで文字起こしし、スマートフォンの音声アシスタントからライブ動画に表示される字幕まで、幅広い機能を支えています。
このガイドでは、1952年の技術と現代の技術をつないだ仕組みを取り上げ、ASRとは何か、音声をどのようにテキストへ変換するのか、そして現在もどう進化を続けているのかを解説します。
概要:
- ASRは自動音声認識の略で、話し言葉のオーディオを文字テキストに変換する技術です。
- 最初期のASRは1952年に登場し、2010年代後半にはディープラーニングシステムが人間のベンチマークに匹敵するようになりました。
- 現代のASRは、数百万時間のオーディオで学習したエンドツーエンドのニューラルネットワークを使用します。
- 単語誤り率(WER)は標準的な精度指標ですが、本番環境のASRではレイテンシー、話者ダイアライゼーションの品質、文脈理解も重要です。
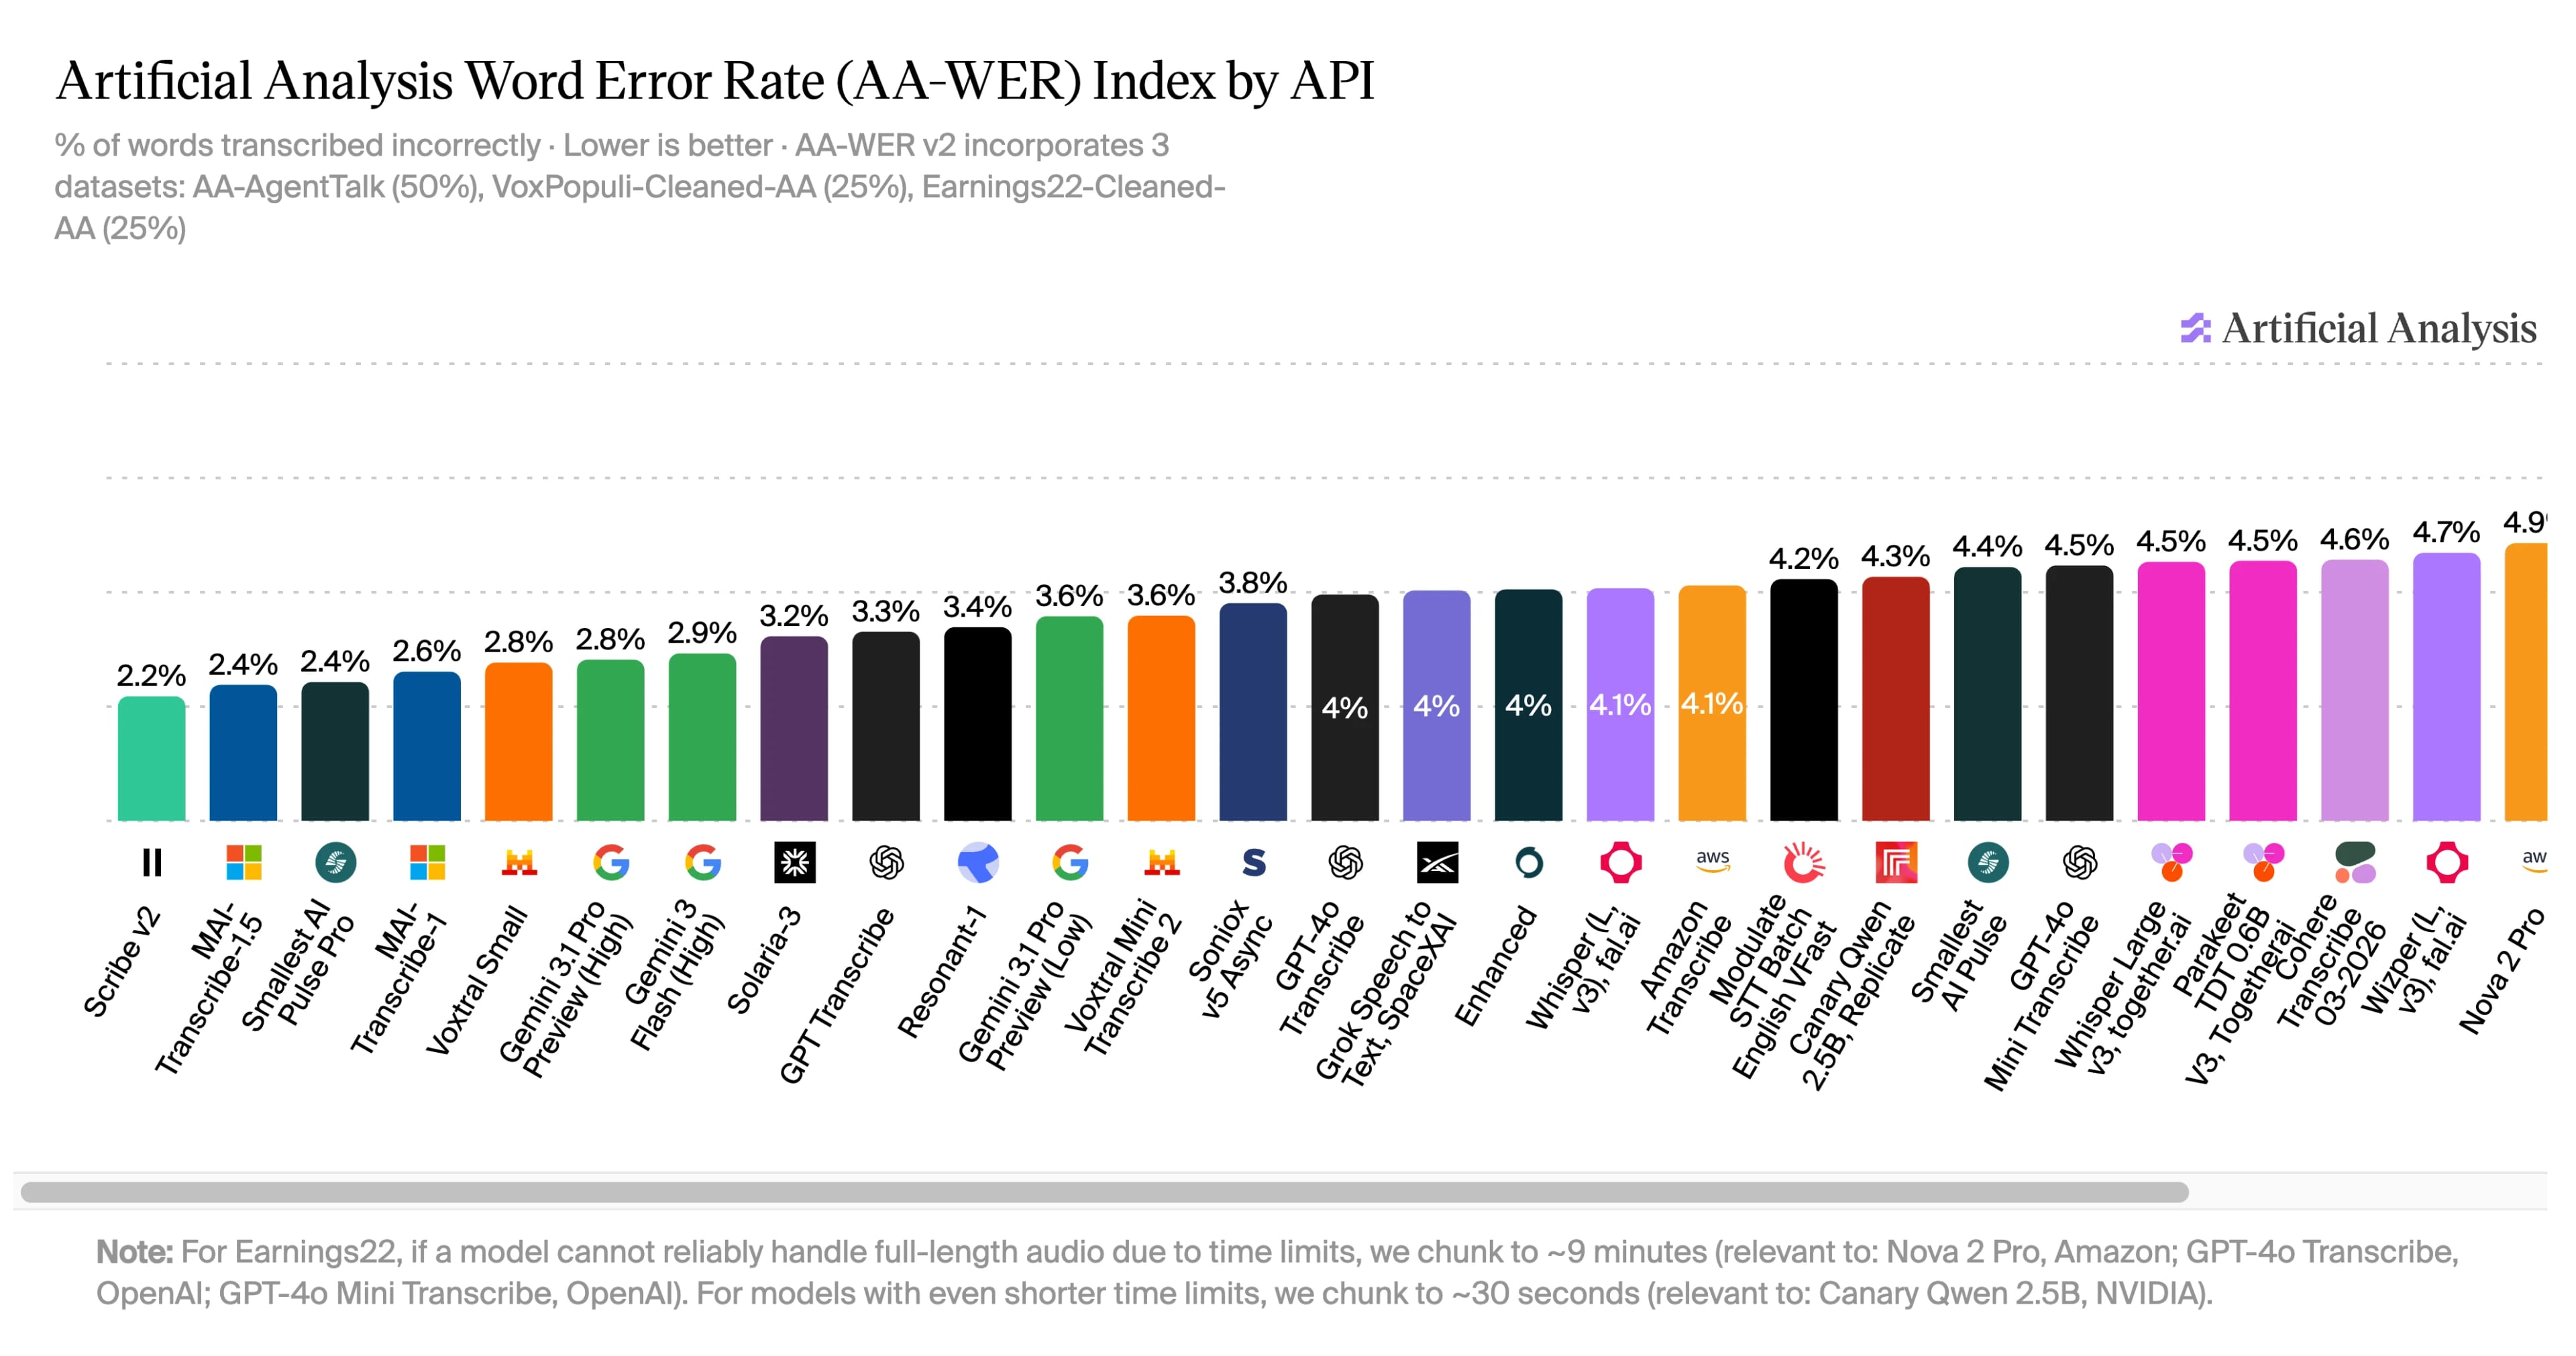
- ElevenAPIは、デベロッパー向けに本番環境対応のASRを提供します。Artificial Analysisの独自ベンチマークでは、単語誤り率2.2%で同社のインデックス中最も低い結果となっています(2026年7月)。
自動音声認識(ASR)とは?
自動音声認識は、ASRという略称でも広く知られ、人の話し声を聞き取り、正確で機械が読み取れるテキストへ変換するソフトウェアを指します。一般にはスピーチtoテキストや音声認識、場合によってはコンピューター音声認識とも呼ばれます。
ASRは非常に身近な技術で、気づかないうちに毎日利用しているかもしれません。メッセージを音声入力するとき、音声アシスタントに質問するとき、ライブ動画の字幕を読むとき、あるいは自動音声応答電話システムを操作するときにも、ASRが使われています。
スピーチtoテキストとASRは同義語として使われることが多く、密接に関連していますが、厳密には同じものではありません。ASRは何が話されたかを識別する技術であり、STTはその技術をツールとして応用したものです。音声認識ソフトウェアはASRの上に構築され、誰が特定の言葉を発したかを識別します。これは話者ダイアライゼーション機能の基盤となります。
小さな違いではありますが、ASR/STT/音声認識システムをアプリやウェブサイトへ統合するなら、理解しておく価値があります。
自動音声認識技術の簡単な歴史
自動音声認識技術は、多くの人が考えるよりはるかに古く、初期の試みは1950年代にさかのぼります。誕生から70年以上の間に、ASRは歴史的な進歩の基盤となる複数の重要な段階を経てきました。
ASR技術がたどってきた主な時代は以下のとおりです。
- 1952年と最初のASR: 1952年、AUDREYとして知られるAutomatic Digit Recognizerが、1から9までの数字を理解するためにベル研究所で開発されました。このツールの精度は約90%に過ぎず、開発者本人が使う場合にしか動作しなかったため、非常に限定的でした。現代の機能とは大きく異なりますが、1〜9を認識できるだけでも当時は印象的な成果でした。
- 1960〜70年代と拡大するASR語彙: その後の数十年間、IBM、ユニバーシティ・カレッジ・ロンドン、日本のNECを含む世界中の研究所が、異なる文脈でAUDREYに似たモデルを開発しました。スタンフォード大学のインド出身大学院生ラジ・レディは、博士課程のプロジェクトとして母音認識器を開発し、単語ごとに間を置く必要のない連続音声認識の基礎を築きました。この時期にDARPA(国防高等研究計画局)が資金提供した研究は、文の構築とデコードの手法であるビームサーチにつながり、1976年までに1,000語を超える単語の認識を可能にする上で重要な役割を果たしました。
- 1980年代〜2010年代初頭の統計的進歩: 1987年、ラジ・レディの大学院生(後に教授)が隠れマルコフモデルとビームサーチを組み合わせ、特定の話者一人だけで学習する必要がないASRを実現しました。このブレークスルーにより、音声認識システムの学習時間は大幅に短縮されました。Dragon Systemsは1997年、NaturallySpeaking Preferredという名称で初の商用ASRを発売しました。毎分100語を認識でき、好調に売れました。
- 現代とディープラーニング: 2010年代、研究者たちはオーディオと文字起こしデータでエンドツーエンド学習した単一のニューラルネットワークが、純粋に統計的なパイプラインを上回ることを示しました。ディープニューラルネットワークの登場により、ASRは誤り率5〜10%で人間に近い性能へ到達しました。この時期に、AlexaやSiriといった音声ベースのアシスタントも市場に登場しました。
それ以降、ASRはさらに高精度かつ広範に利用されるようになりました。2026年7月時点で、Artificial Analysisの独立調査では、ElevenLabsのScribe v2が、わずか2.2%という業界最高水準の単語誤り率(WER)を達成したと報告されています。
ASRの仕組み:スピーチtoテキスト技術の基本
ASRは、オーディオサンプルを取得して数値表現に変換し、学習済みモデルでその数値が表す可能性の高い単語列を予測することで機能します。現代のASRはこのシステムをリアルタイム化し、エンドツーエンドのプロセス全体を1秒未満で完了します。
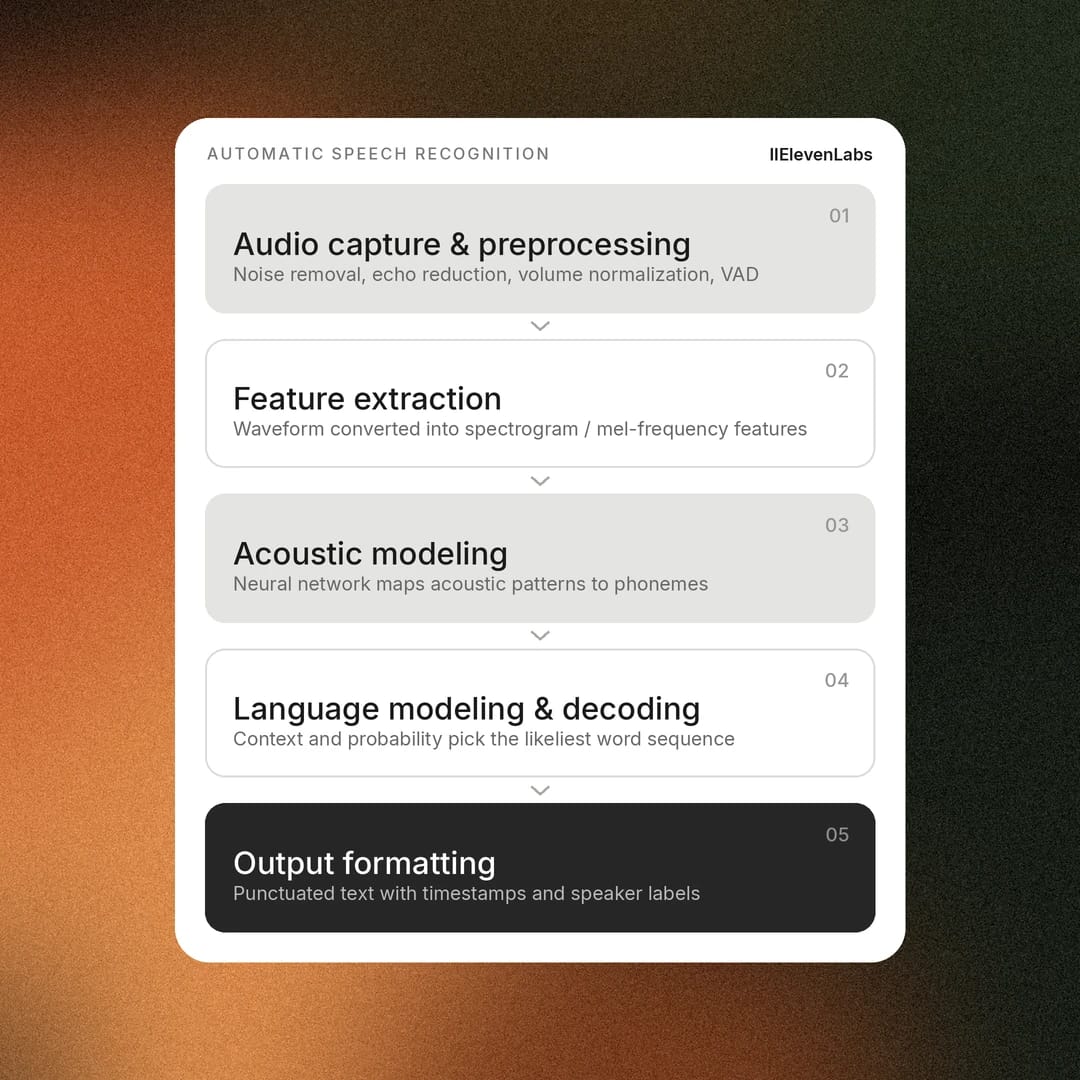
ASRパイプラインには、主に5つの段階があります。
- オーディオの取得と前処理: システムはオーディオ信号を録音し、バックグラウンドノイズを除去し、エコーを低減して、音量レベルを正規化することで一貫性を高めます。モデルによっては、文字起こしを始める前に音声活動検出(VAD)を使用し、発話と無音または背景音を区別します。
- 特徴量抽出: オーディオは、人の発話に含まれる周波数やパターンを正確に表す、通常はスペクトログラムまたはメル周波数特徴量という数値表現に変換されます。このステップでは、未加工の波形を機械学習モデルが効率的に処理できるデータへ変換します。
- 音響モデリング: ニューラルネットワークが前段階の特徴量を分析し、音素などの音声単位を予測しながら、音響パターンと言語音声の関係を学習します。現代のエンドツーエンドモデルでは、この処理を完全に独立した段階としてではなく、言語理解と合わせて実行することが多くあります。
- 言語モデリングとデコード: 次にシステムは、文法、文脈、数学的確率といったルールに基づき、どの単語列が最も可能性が高いかを評価します。2つの文のIPA(国際音声記号)表記が似ていても文脈がまったく異なる場合があるため、後者の2つは特に重要です。たとえば、「Recognize Speech」と「Wreck a nice peach」は同じように聞こえても、意味はまったく異なります。精度だけでは判断できない場合、文脈が正しい候補を選ぶ助けになります。
- 出力の整形: 発話内容を判断した後、句読点と大文字・小文字を含む最終テキストが文字起こしされます。単語レベルのタイムスタンプや話者ラベルなどの追加メタデータにより、より詳細な文字起こしを作成できます。
これらの主要な段階を通じて、モデルは入力オーディオデータを文字起こしテキストへ変換します。
従来のハイブリッドシステムとエンドツーエンドのディープラーニングASR
上記のパイプラインはASRの仕組みを説明していますが、その中間部分には実際には2つの技術的アプローチがあります。
従来のシステムは、単語の発音をエンコードするレキシコンモデル、オーディオを音素に対応付ける音響モデル、可能性の高い単語列を予測する言語モデルという複数のコンポーネントを連結します。発音辞書を手作業で作成する言語学者から、各単語をオーディオ内の正確な位置にアラインメントするアノテーターまで、各コンポーネントの構築には人の専門知識が必要です。
エンドツーエンドのディープラーニングでは、これらすべてのコンポーネントを単一のニューラルネットワークに統合します。このネットワークは、数百万時間分のオーディオと文字起こしのペアから、発音、音響、言語の確率統計を暗黙的に理解し、オーディオを直接テキストに対応付けます。
ASR技術における従来手法と現代的手法の違いを見ていきましょう。
ASR精度の測定方法:単語誤り率(WER)ベンチマーク
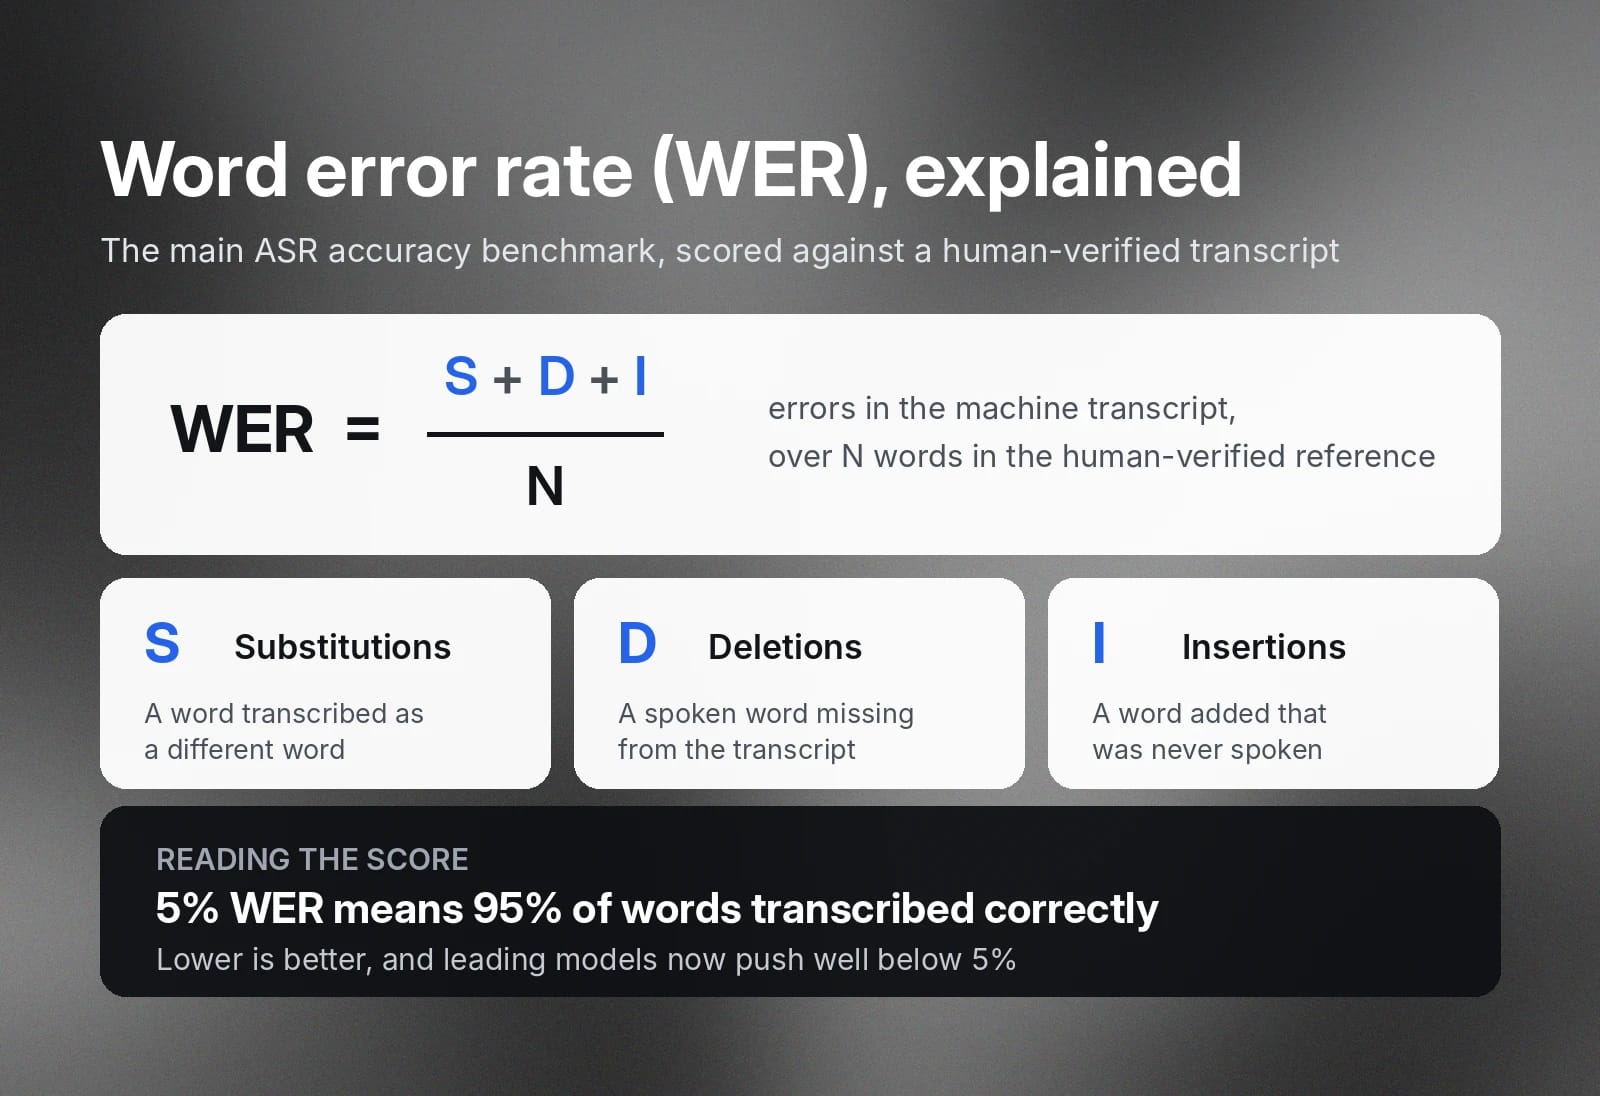
スピーチtoテキストおよびASRのすべてのワークフローにおいて、単語誤り率(WER)は企業が使用する主要な精度指標です。ASRで生成した機械文字起こしを、人間が検証した版と比較します。考慮すべき主なエラーには、置換、削除、挿入の3種類があります。
WERの式では、総エラー数を参照文字起こしに含まれる単語数で割ります。WERが5%なら、テキストの95%を正確に文字起こしできたことを意味します。現在の主要モデルは、より完全な精度を目指して5%を大きく下回る水準に進んでいます。
WERは有用なベンチマークですが、ASRツールの有効性を判断する際には、他の要素も考慮する必要があります。
- 整形精度: システムは標準的でない文字列を適切に整形できるでしょうか。たとえば、$1,225のような金額をそのまま表示できるか、それとも「1,225ドル」と表記してしまうか、といった点です。
- レイテンシー: 精度は重要ですが、簡単な文字起こしの生成に数分かかるなら、そのツールは使いものになりません。どれほど高精度でも、実用性を高めるには低レイテンシーとのバランスが必要です。
- 堅牢性: 強い アクセントや騒がしい背景といったユースケースでも、モデル精度が大幅に低下してはいけません。
- ダイアライゼーションの品質: 複数話者のユースケースでは、すべての単語を正しい話者に正確に帰属させる必要があります。異なる話者を識別して正しくタグ付けする能力は、特に法廷のように多数の話者が関わる業界においてASRに貢献します。
詳しくは、単語誤り率に関する包括的なガイドをご覧ください。
現代のビジネスにおけるASRの主なメリット
世界の音声・ボイス認識市場は、2030年までに231.1億ドル超へ成長すると予測されています。市場の年平均成長率19.1%は、この技術が商用デバイスにどれほど広く普及したかを示しています。現代の携帯電話にはすべて音声入力キーボードと音声アシスタントが搭載され、ほとんどの新車は音声コマンドに応答し、スマートスピーカーやアシスタントは世界中の家庭に普及しています。
音声でテクノロジーとやり取りすることは、今や顧客が幅広い場面で利用できる標準的な手段です。企業にとってASRは、顧客通話の文字起こしから音声エージェント支援までを提供し、業務プロセスに統合されて生産性を高めます。
現代のビジネスにおけるASRの主なメリットをいくつか紹介します。
- 入力と文書化の高速化: 10年以上前にも、スタンフォード大学の論文では、音声認識技術はエラー率を低く保ちながら、キーボード入力のほぼ3倍の速さであることが示されました。大半の人にとってASRは、文字起こしワークフローの文書化や音声ファーストのメモ作成を高速化します。
- 運用コストの削減: 以前は何時間もの手作業によるメモ作成に頼っていた多くのユースケースで、ASR技術は高品質な文字起こしのコストを大幅に削減します。裁判、コンタクトセンター、医療クリニック、ビジネス会議では、詳細なメモと会話全体の話者分離済み文字起こしを作成する正確なASRシステムを利用できるようになりました。
- アクセシビリティの向上: 世界保健機関は、2050年までに25億人が何らかの聴覚障害を抱えると予測しています。高度なASRツールが提供するリアルタイム字幕は、デジタル会議やメディアをユーザーにとって利用しやすくすることができます。
- 検索可能な音声データ: ASRで音声を自動的に文字起こしすると、顧客と企業のあらゆるやり取りが完全に記録されます。営業電話、サポートチケット、見込み顧客との通話、会議のすべてが、検索や監査が可能なテキストになります。特にAI時代では、機械可読形式の文脈を取り出せることが、広範なナレッジベースの構築に役立ちます。機能面でもコンプライアンス面でも、これにより情報を可視化し続けられます。
- 常時対応の顧客体験: ASRは、音声エージェントの基盤技術の一つであり、顧客の通話を解決する24時間365日の自動サポートユースケースを可能にします。
自動音声認識がテクノロジーで広く使われているのは、導入するメリットが多く、対応できるユースケースも非常に幅広いためです。医療分野でも、感情分析のために顧客通話を文字起こししたい場合でも、ASRは導入・活用する基盤技術です。
業界横断で広がるASRの代表的な活用例
自動音声認識は、数え切れないほどのワークフローやプロダクトにおける中核技術です。あまりに広く普及しているため、ユーザーは普段使うテクノロジーにどう組み込まれているかさえ意識しないことがよくあります。
世界で利用されているASRの代表的なユースケースを簡単に紹介します。
カスタマーサービスとコンタクトセンター
コンタクトセンターはASRを早くから導入し、品質保証とコンプライアンスのために通話を文字起こししてきました。現在では、ASRをリアルタイムで稼働させ、会話中のエージェントに提案を表示し、数千件の顧客対応をチームが分析できるデータへ変換できます。
メディアとエンターテインメント
放送局やストリーミングプラットフォームは、人間の文字起こし担当者では対応できない規模で、会話の字幕やキャプションを生成するためにASRを利用できます。リアルタイム文字起こしを可能にすると同時に、ビデオとオーディオのライブラリ全体を検索可能にします。
医療
臨床スタッフは、記録やカルテ作成に一日のうち驚くほど多くの時間を費やしています。ASRはこの時間を取り戻し、医師がメモをリアルタイムで音声入力できる医療向けSTTプラットフォームを提供します。
バーチャル会議
会議プラットフォームは、会話を進行中に文字起こしする何らかのデジタルメモ機能を提供することが多く、参加とメモ取りのどちらかを選ぶ必要がなくなります。Google Meetのようなサービスでは、会議後にアクションアイテムを強調表示した文字起こしを送信し、検索可能な情報インデックスの作成に役立てることもできます。
法務とコンプライアンス
法的な場面では、誰が何を言ったのかを正確に記録することが法廷における重要な要件です。法律事務所は、将来の参照に備え、正確なタイムスタンプ付きで会議、審問、顧客との通話、法廷での審理を文字起こしするためにASRプラットフォームを使用します。
教育
大学教員は、学生が受講した授業の記録を蓄積できるよう、講義の文字起こしを提供できます。情報を理解して記憶する際、学生は出発点となる包括的なリソースを利用できます。
音声エージェントのパイプラインにおけるASRの位置付け
ASRは、幅広い技術導入における標準的な要素です。音声エージェント技術では、連続ループで動作する大きく3つの段階のうち最初の段階にあたります。
- 聞く(ASR): エージェントは入力オーディオストリームを取得し、リアルタイムで音声をテキストに変換します。現代のASRは、到着したオーディオを継続的に処理し、バックグラウンドノイズを除去し、割り込みを処理し、部分的な文字起こしを生成し、各人が話しているタイミングを識別します。
- 考える(言語モデル): 大規模言語モデルが文字起こしを解釈し、ユーザーの意図を理解し、接続されたツールやナレッジベースから情報を取得し、会話の文脈を維持して、最も適切な応答またはアクションを決定します。
- 話す(テキスト読み上げ): テキスト読み上げモデルは、生成されたLLMの応答を自然で表現豊かなオーディオへ変換します。現代のTTSシステムでは、応答全体が完成するのを待つのではなく、生成と同時にオーディオを発信者へストリーミングしながら、話す速さ、イントネーション、感情、強調を調整できます。
会話レイテンシーは、これらすべての段階で積み重なります。ストリーミングASRは、発話が終わるのを待たず、話された単語をすぐに出力し始めることでレイテンシーを低減します。ElevenAgentsはこれをリアルタイム音声エージェントの標準として採用し、高効率なエージェント体験を実現します。
ASRの課題と進化する技術
ASR技術は1952年の誕生から大きく進歩しましたが、精度を低下させる可能性のあるさまざまな課題が今も残っています。
ASRツールが現在も直面している問題をいくつか紹介します。
- アクセントと方言: 利用可能な学習データは通常、少数の言語やアクセントに集中しており、あまり一般的でないアクセントや、話者の少ない言語はASRツールにとってより困難です。この解決策となるのが、豊富で多様な学習データセットです。
- バックグラウンドノイズと重なった発話: 音量が変動する環境や大きなバックグラウンドノイズがある環境では、録音から個々の単語を特定しにくくなります。話者の発話が重なることにも同様の影響があり、ASR文字起こしの精度を低下させる可能性があります。
- ドメイン固有の語彙: 特有の専門用語や略語がある分野では、精度を高めるためにドメインレベルの辞書や参照情報が必要です。医療と法務は、ASRツールに追加支援や専門的な学習が必要となる2つの分野です。
- プライバシーとセキュリティ: 多くの法域で、音声データは個人データとして扱われます。企業は、音声データの取り扱いを保護し、より広範な規制への準拠を確保するため、明確な保持ポリシーとガードレールを整備する必要があります。
ASR技術を扱う際により広い視点で考慮すべき点は、レイテンシーと精度のトレードオフです。一部のユースケースでは両者のバランスが必要ですが、医療のような分野では精度が最優先されるでしょう。
本番環境対応ASRの統合をElevenAPIで始める
ElevenAPIは、ElevenLabsのスピーチtoテキストモデルであるScribe v2を通じて、本番環境対応の自動音声認識をプロダクトに提供します。Scribe v2は、単語レベルのタイムスタンプ、話者ダイアライゼーション、オーディオイベントのタグ付け、リアルタイムアプリケーションに必要な精度と信頼性を実現します。
詳細はElevenLabs スピーチtoテキストページをご覧いただくか、無料アカウントを作成して、数分でAPIをセットアップしてください。
ASRに関するよくある質問

Jack LimebearはGrowthチームに所属し、ブログやインサイトページのコンテンツライター兼ストラテジストとして活躍しています。ElevenLabsに入社する前は、急成長中のSaaSスタートアップからFortune 500企業まで、さまざまな組織で10年以上にわたりコンテンツ戦略をリードしてきました。ケンブリッジ大学で英文学の修士号を取得しています。


