リアルタイム文字起こしとバッチ文字起こし:主な違い
- 公開日
AI搭載の文字起こしモデルを選ぶ際は、リアルタイム文字起こしとバッチ文字起こしの2つから選べます。どちらも音声をテキストに変換しますが、アプローチは異なります。
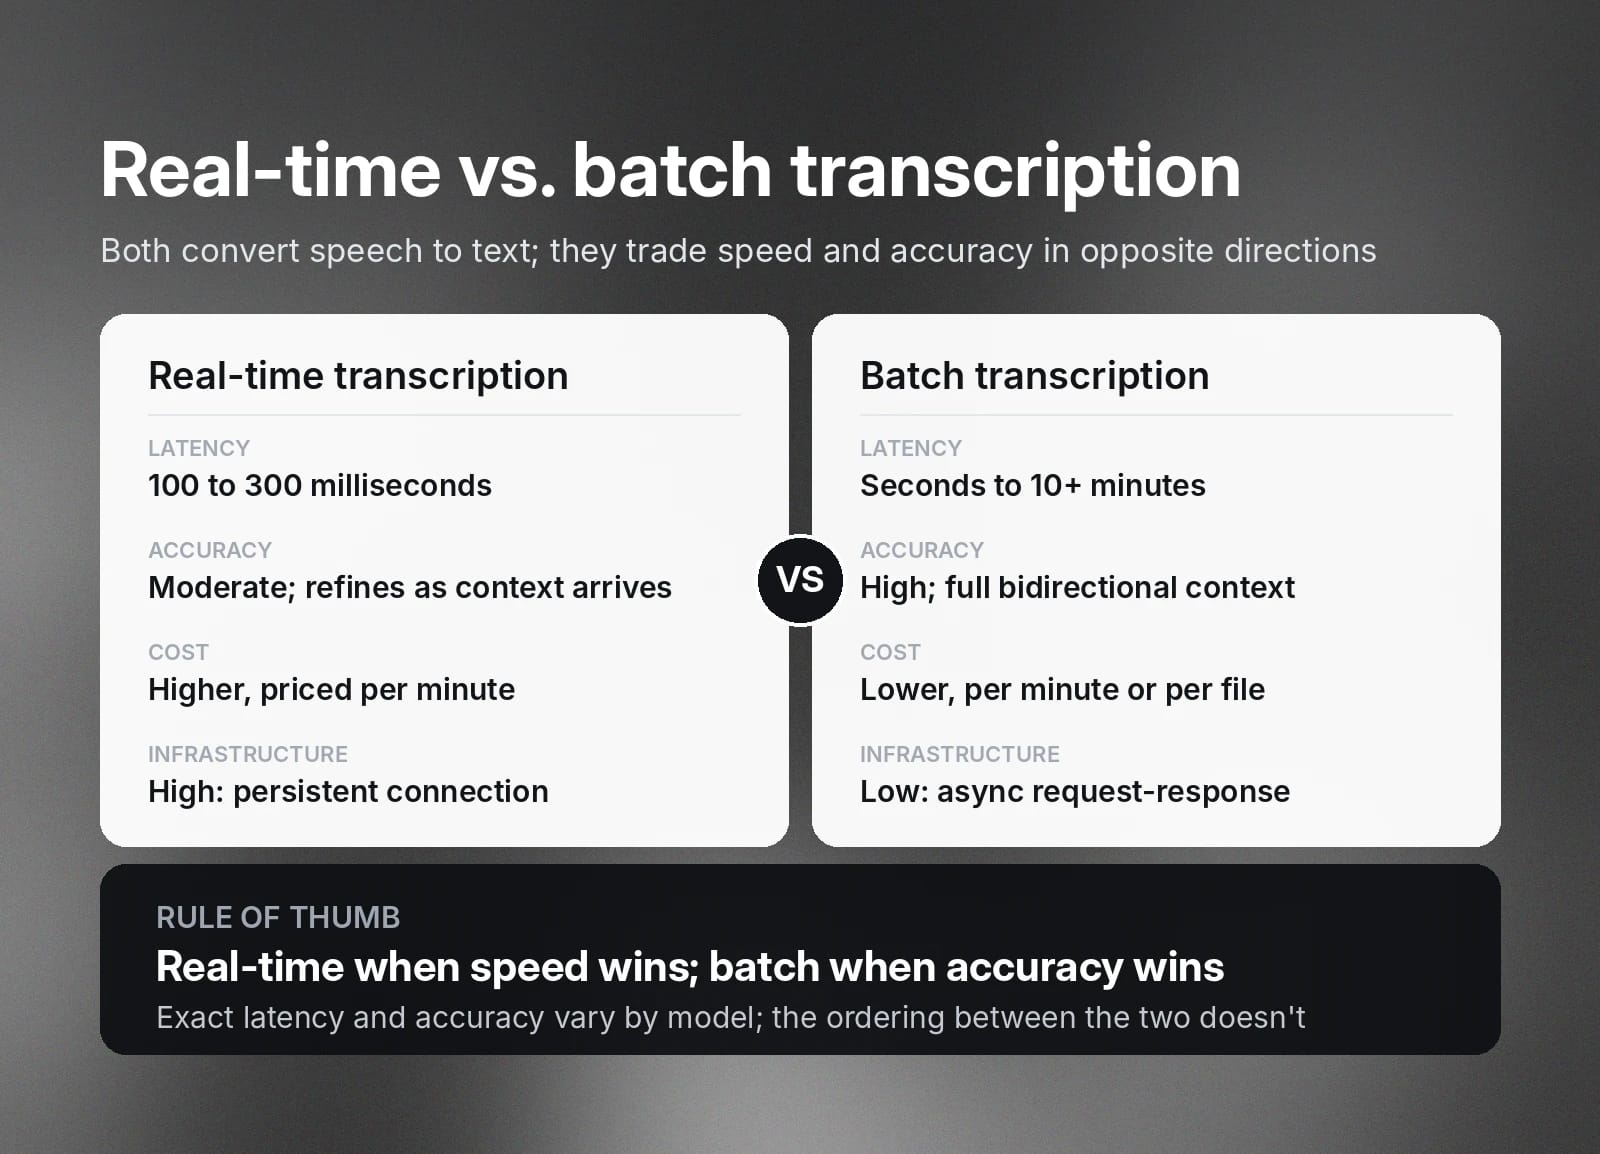
リアルタイム文字起こしは発話と同時にオーディオを処理し、バッチ文字起こしは録音完了後に音声録音全体を処理します。リアルタイム文字起こしは即座に結果を得られる一方、バッチ文字起こしの方が精度は高いことが多いです。
このガイドでは、次のプロジェクトに適したモデルを選べるよう、リアルタイム文字起こしとバッチ文字起こしを比較します。各モデルの仕組み、メリットとデメリット、代表的なユースケースを解説します。
概要
- リアルタイム文字起こしは、音声が発生している最中に処理します。
- バッチ文字起こしは、音声ファイル全体を一度に処理します。
- リアルタイム文字起こしは高速ですが、バッチ文字起こしは音声ファイル全体から双方向のコンテキストを得られるため、より高精度です。
- リアルタイム文字起こしは、ライブ音声エージェント、ライブ動画の字幕、会議メモなど、精度より速度が重要なアプリケーションに最適です。
- バッチ文字起こしは、録音後のオーディオを一括で文字起こしする場合に、より高精度かつ費用対効果に優れています。
STTにおけるリアルタイム文字起こしとは?
リアルタイム文字起こしとは、スピーチtoテキスト(STT)モデルが音声を発生と同時にテキストへ変換することです。ストリーミング文字起こしと呼ばれることもあります。
リアルタイム文字起こしでは、STTモデルがオーディオを小さなチャンクに分けて処理します。発話からわずか数ミリ秒後にはテキストを利用できます。会話が進むにつれてSTTモデルはより多くのデータとコンテキストを取得し、その情報を使って文字起こしを改善します。
この形式の文字起こしは、精度より速度が重要な場面に最適です。たとえば、これらのモデルはリアルタイム字幕によってオーディオやビデオのストリームをより利用しやすくします。リアルタイムのメモ作成プラットフォームも代表的なユースケースです。
STTにおけるバッチ文字起こしとは?
バッチ文字起こしでは、録音が完了した後に音声録音全体を一度にスピーチtoテキスト変換します。録音の長さや複雑さに応じて、数秒から10分以上かかります。
バッチ文字起こしモデルは、処理中に録音全体のコンテキストを使用します。コンテキスト全体を利用できるため、複雑な言語、バックグラウンドノイズ、発話の中断がある箇所も正確に解釈できます。また、一部のリアルタイムモデルでは難しい句読点の追加や書式設定も行えます。
バッチ文字起こしは、精度が最優先となる場面に最適です。多くの組織が、長時間のインタビュー、会議、ポッドキャストをアーカイブ用に文字起こしするため、バッチモデルを利用しています。
バッチとストリーミングのアーキテクチャが文字起こしに与える影響
文字起こしにおけるバッチ処理とストリーム処理を比較すると、2つのモデルは根本的に異なるプロセスを使っており、それが最終出力に影響します。
ストリーミング文字起こしモデルは、オーディオをチャンクに分割し、発生と同時に各チャンクを文字起こしします。通常、チャンクは250ミリ秒以下と非常に小さいものです。この形式でオーディオを処理することで、文字起こしモデルは高速に動作し、音声の発生から数秒後にはテキストを表示できます。
オーディオチャンクは非常に小さいため、スピーチtoテキストモデルは会話の完全なコンテキストを得られず、誤りにつながることがあります。たとえば、文字起こしモデルが「you're」ではなく「your」を使う場合があります。
リアルタイム文字起こしモデルは、会話が続いてコンテキストが明確になると、こうした誤りの一部を修正します。ただし、すべてのエラーを修正するには時間やコンテキストが不足することが多いため、最終的な文字起こしが常に100%正確とは限りません。
一方、バッチ文字起こしモデルは音声ファイル全体を一度に処理します。つまり、文字起こしモデルは会話について双方向のコンテキストを持ち、それを使って不明瞭な単語やフレーズを解決できます。音声ファイル内に不明瞭な部分がある場合、モデルは前後の単語を分析して発話内容を判断し、正確に文字起こしします。
この追加コンテキストにより、バッチ文字起こしモデルはリアルタイム文字起こしモデルより低速になります。しかし、最終成果物ははるかに正確で洗練されたものになります。
リアルタイム文字起こしとバッチ文字起こしモデルの主な特性:レイテンシー、精度、コスト
リアルタイムモデルとバッチモデルは、どちらも文字起こしに効果的です。重要なのは、取り組むプロジェクトの種類です。即時の結果が必要なプロジェクトもあれば、高い精度が求められるものもあります。
リアルタイム文字起こしとバッチ文字起こしを選ぶ際は、次の要素を検討してください。
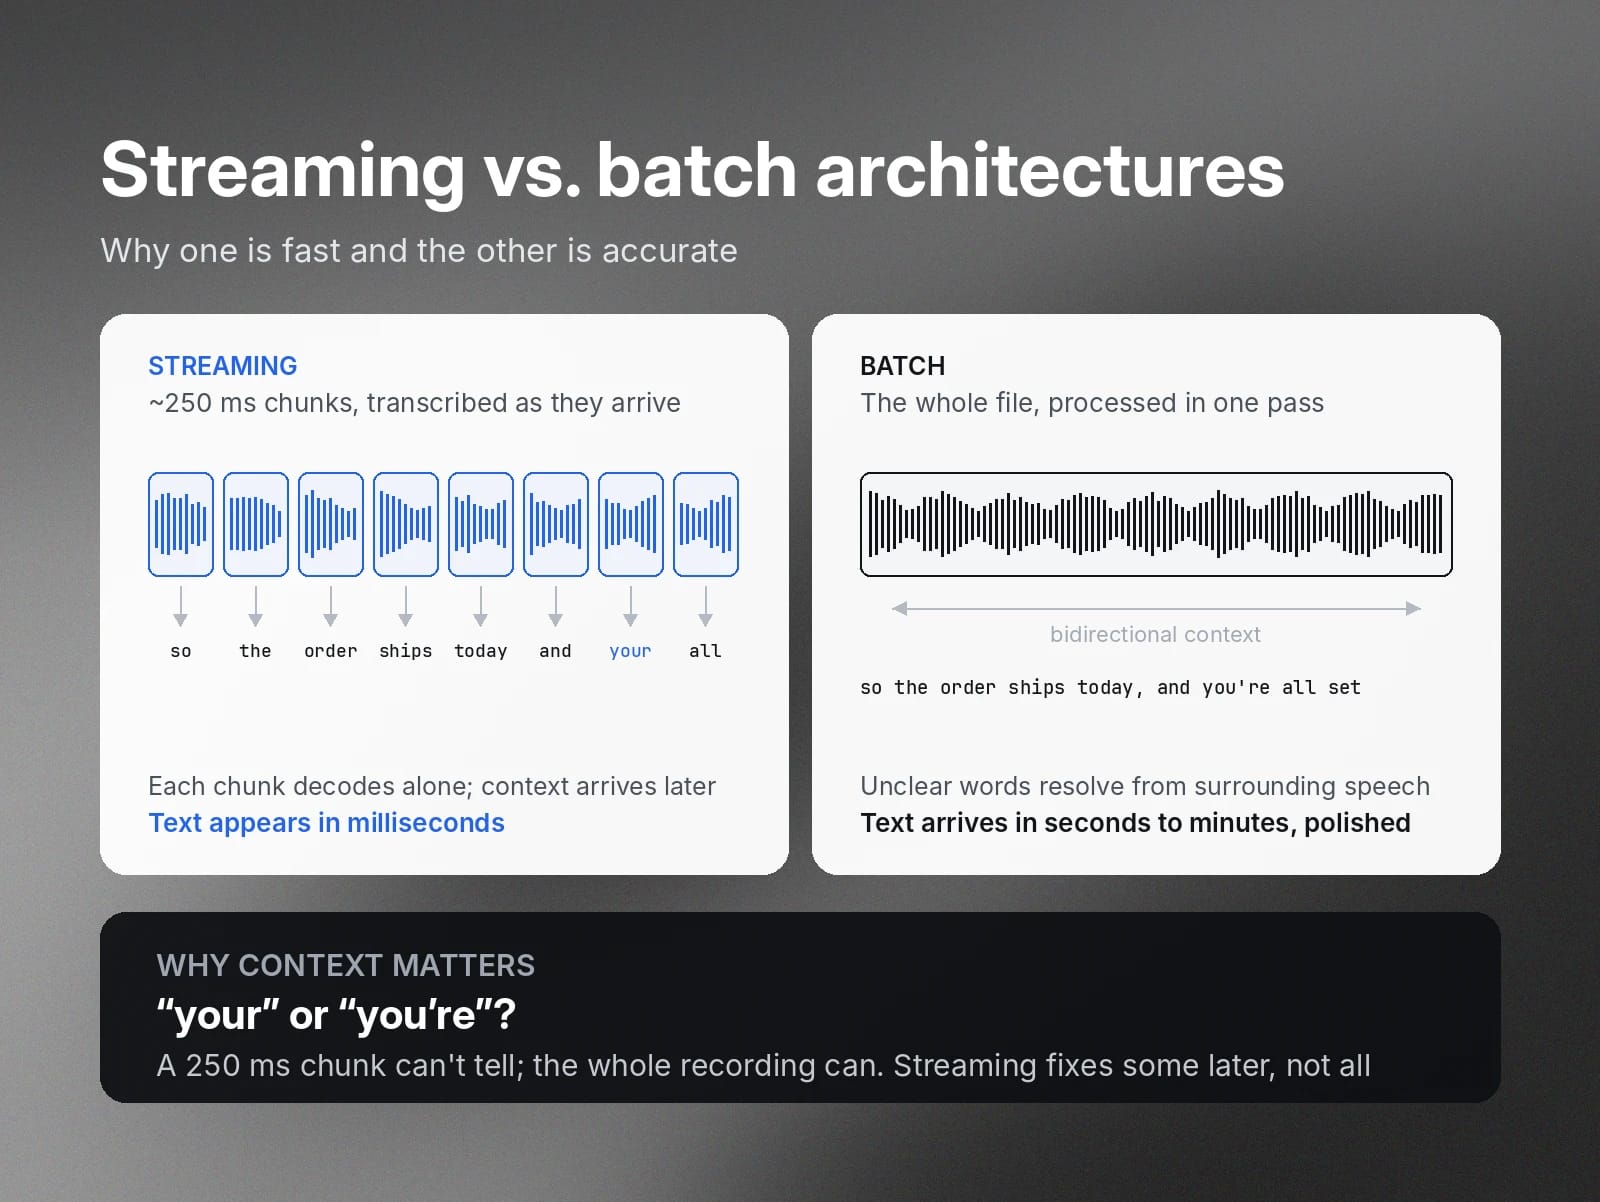
リアルタイム文字起こし | バッチ文字起こし | |
レイテンシー | 100~300ミリ秒 | ファイルの長さに応じて数秒~10分以上 |
精度 | 中程度 | 高い |
コスト | 高い(分単位の料金) | 中程度(分単位またはファイル単位の料金) |
インフラの複雑さ | 高い。安定した接続と負荷分散が必要 | 低い。非同期のリクエスト・レスポンス構造を使用 |
正確なレイテンシーと精度は、使用する文字起こしモデルによって異なります。ただし、リアルタイム文字起こしは一貫して高速で、バッチ文字起こしはより高精度です。
リアルタイム文字起こしは、より複雑なインフラと高い運用負荷が必要なため、バッチ文字起こしよりコストがかかります。リアルタイムモデルは速度を維持するために安定した接続を必要とし、バッチモデルよりもセットアップと保守に時間がかかります。
ライブ会話中のアクセシビリティには、リアルタイムモデルへの投資が価値を発揮します。一方、速度が優先されないプロジェクトでは、バッチ文字起こしを使うことで費用とセットアップ時間を節約できます。
リアルタイム文字起こしとバッチ文字起こしのAPI比較:プロジェクトに最適な選択
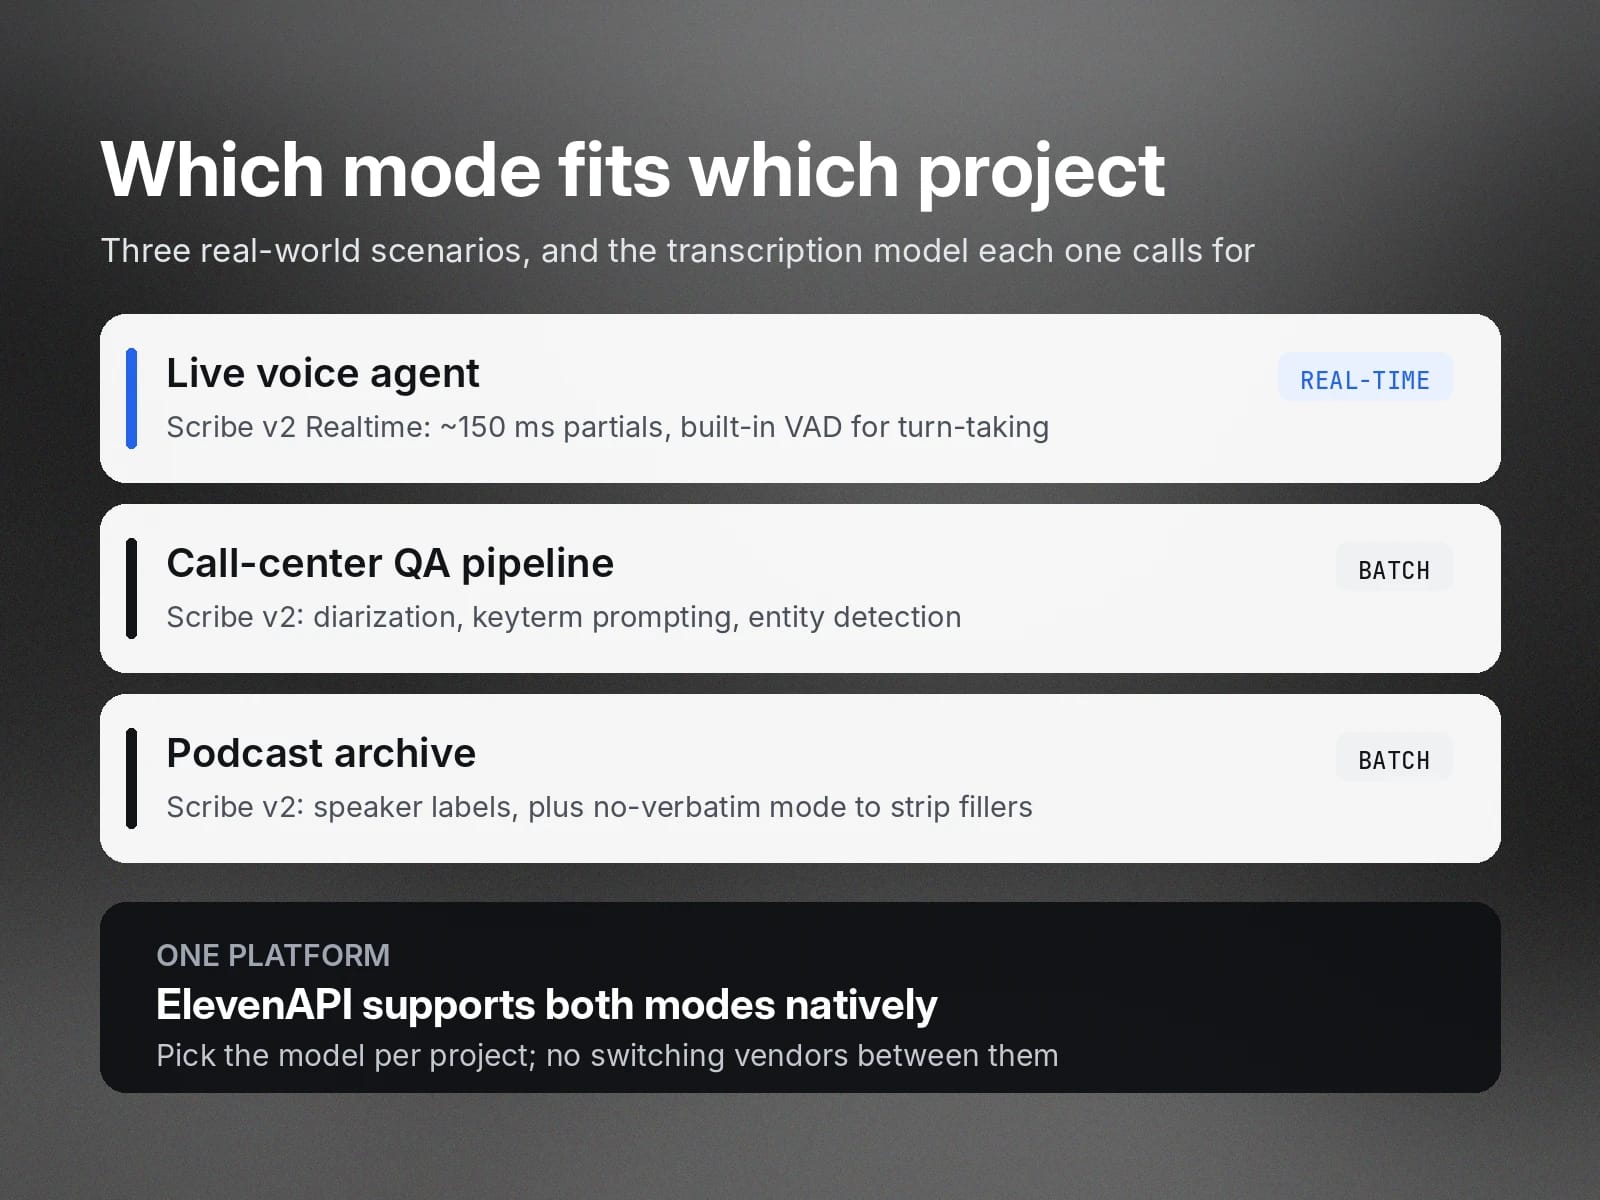
新しい文字起こしプロジェクトを始める前に、バッチモデルとリアルタイムモデルの長所と短所を評価し、目標に最も適したものを確認する必要があります。ここでは、実際の3つのシナリオでの判断プロセスを紹介します。
ライブ音声エージェント:リアルタイム文字起こし
ライブ会話型AIモデルでは、特に複雑な業務上の課題やカスタマーサービスの課題に対応する際、アクセシビリティのためにほぼ瞬時の文字起こしが必要です。
たとえば、Scribe v2 Realtimeのようなリアルタイムモデルは、滑らかで自然な会話に必要な低レイテンシーを実現します。Scribe v2 Realtimeは、約150ミリ秒で部分的な文字起こしを提供します。
ライブ音声エージェント向けの文字起こしモデルには、正確なターンテイキングも必要です。つまり、ユーザーが話し始めた、または話し終えたことを検出し、すぐに応答できなければなりません。効果的なターンテイキングと割り込み管理は、文字起こしが会話に遅れをとるのを防ぎます。
リアルタイム文字起こしモデルは、高速な結果のために正確なターンテイキングを重視します。たとえば、Scribe v2 Realtimeには音声アクティビティ検出が組み込まれており、話者間の無音を検出すると文字起こしを自動的に分割します。
コールセンターQAパイプライン:バッチ文字起こし
品質保証では精度が鍵となるため、このシナリオではScribe v2のようなバッチ文字起こしモデルが最適です。
コールセンターの文字起こしには、固有名詞や業界特有の詳細が含まれることがよくあります。正しく文字起こしされなければ、通話が本当に成功したかどうかをアナリストが判断するのは困難です。バッチモデルは録音全体を一度に処理するため、正確な文字起こしと書式設定に必要なコンテキストを得られます。
Scribe v2には、文字起こし精度を高める機能がいくつかあります。話者ダイアライゼーションにより、発話が重なった場合でもエージェントと顧客は常に適切にラベル付けされます。キータームプロンプティングでは、ブランド名や業界用語を事前にモデルへ与えるため、正確に文字起こしできます。
コールセンターの文字起こしには、社会保障番号やクレジットカード番号など、伏せ字処理が必要な機密情報が含まれる場合もあります。Scribe v2にはエンティティ検出機能があり、こうした機密情報を検出してタイムスタンプを付けるため、削除できます。
ポッドキャストアーカイブ:バッチ文字起こし
ポッドキャストアーカイブを構築する場合、チームや視聴者がいつでも参照できる、洗練された文字起こしが必要です。ここでは精度と整った書式が不可欠であるため、バッチ文字起こしが適しています。
バッチ文字起こしなら、すべてのポッドキャストファイルで話者ラベルとダイアライゼーションを含む正確な文字起こしを得られます。Scribe v2にはノンバーベイタムモードもあり、フィラーワード、どもり、繰り返しを自動的に削除します。手作業での編集時間を減らせるため、ポッドキャストアーカイブをより迅速に構築できます。
ElevenAPIは、リアルタイムモードとバッチモードの両方をネイティブにサポートしています。複数の文字起こしプロジェクトを同時に実行する場合も、ElevenAPIならすべてを同じプラットフォームで管理できます。サービスプロバイダーを切り替える手間なく、プロジェクトごとに適切なモデルを選択できます。
ハイブリッド文字起こしモデル:リアルタイムとバッチをつなぐ
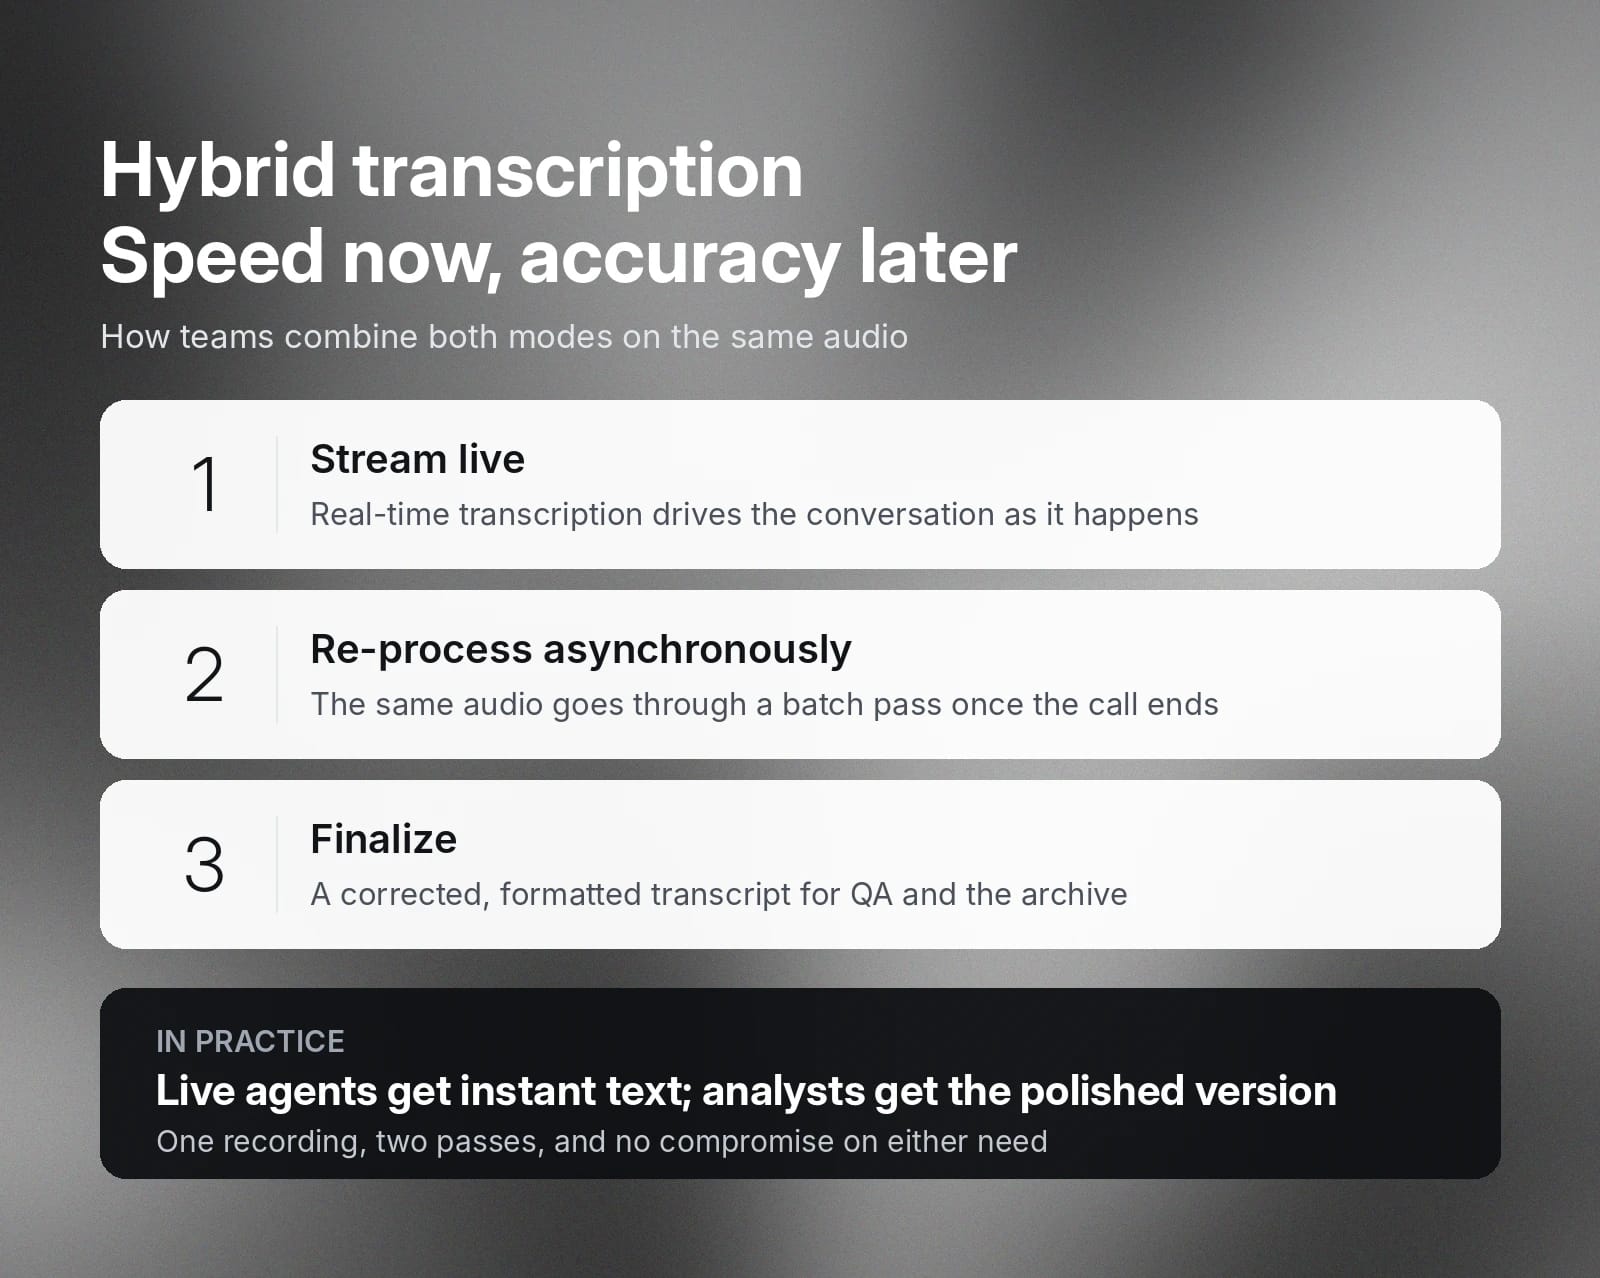
ハイブリッド文字起こしアーキテクチャは、リアルタイムモデルとバッチモデルを組み合わせ、速度と精度のバランスを取ります。
たとえば、カスタマーサービスチームはハイブリッドモデルを使い、ライブ会話中に即時の出力を提供した後、品質保証とアーカイブ用に文字起こしを整えることができます。ライブエージェントはリアルタイム文字起こしを使い、その後、初期の文字起こしをバッチモデルに送信して非同期で再処理します。
このフローの仕組みは次のとおりです:
柔軟な文字起こしソリューションをElevenAPIで始める
ElevenAPIは、90以上の言語で高速かつ正確な文字起こしを実現する、リアルタイムモデルとバッチモデルの両方を提供しています。ElevenAPIの業界最高水準の文字起こしモデルは、低品質なオーディオ、バックグラウンドノイズ、強いアクセントがある場合でも正確な結果を提供します。
ElevenAPIは、90以上の言語に対応した高速かつ正確な文字起こしを実現する、リアルタイムモデルとバッチモデルの両方を提供しています。Scribe v2は業界最高水準の文字起こし精度を実現し、Scribe v2 Realtimeはライブのユースケースで卓越した精度を提供します。どちらも低品質なオーディオ、バックグラウンドノイズ、強いアクセントがある場合でも、信頼性の高い結果を提供します。
どちらのモデルも、ニーズに合う文字起こしアーキテクチャを構築できる、便利な同一プラットフォームで利用できます。ElevenLabsスピーチtoテキストAPIで実際の動作を確認するか、APIキーを作成して始めましょう。



