
Python音声認識チュートリアル:音声ファイルから文字起こしまで
- 公開日
- 最終更新日
Pythonアプリに音声認識機能を導入するのは、かつては煩雑でした。Pythonデベロッパーは、音声の前処理、特徴抽出、モデル統合といった文字起こしプロセスそのものを実装する必要がありました。さらに、エンジニアリングチームは低レベルのオーディオ処理、十分でない文字起こし精度、発話とライブ字幕の間の遅延にも対応しなければなりませんでした。
オーディオモデルと音声認識SDKの進化が、それを変えています。
このPython音声認識チュートリアルでは、ElevenLabsのスピーチtoテキストオーディオモデルをPythonプロジェクトに統合し、商用対応の文字起こしアプリを作成する方法を紹介します。
概要
- 商用向けスピーチtoテキストモデルには、基本的な音声認識モデルにはない話者ダイアライゼーション、単語単位のタイムスタンプ、キータームプロンプトなどの機能があります。
- ElevenAPIなら、Scribe v2とScribe v2 Realtimeを使ってPythonコードに音声認識機能を追加できます。
- デベロッパーはAIコーディングプラットフォームにElevenLabsスキルをインストールし、公式APIドキュメントに基づいた正確なPythonコードを生成できます。
- 商用開発向けの有料プランに加入する前に、ElevenLabs APIを無料で試せます。
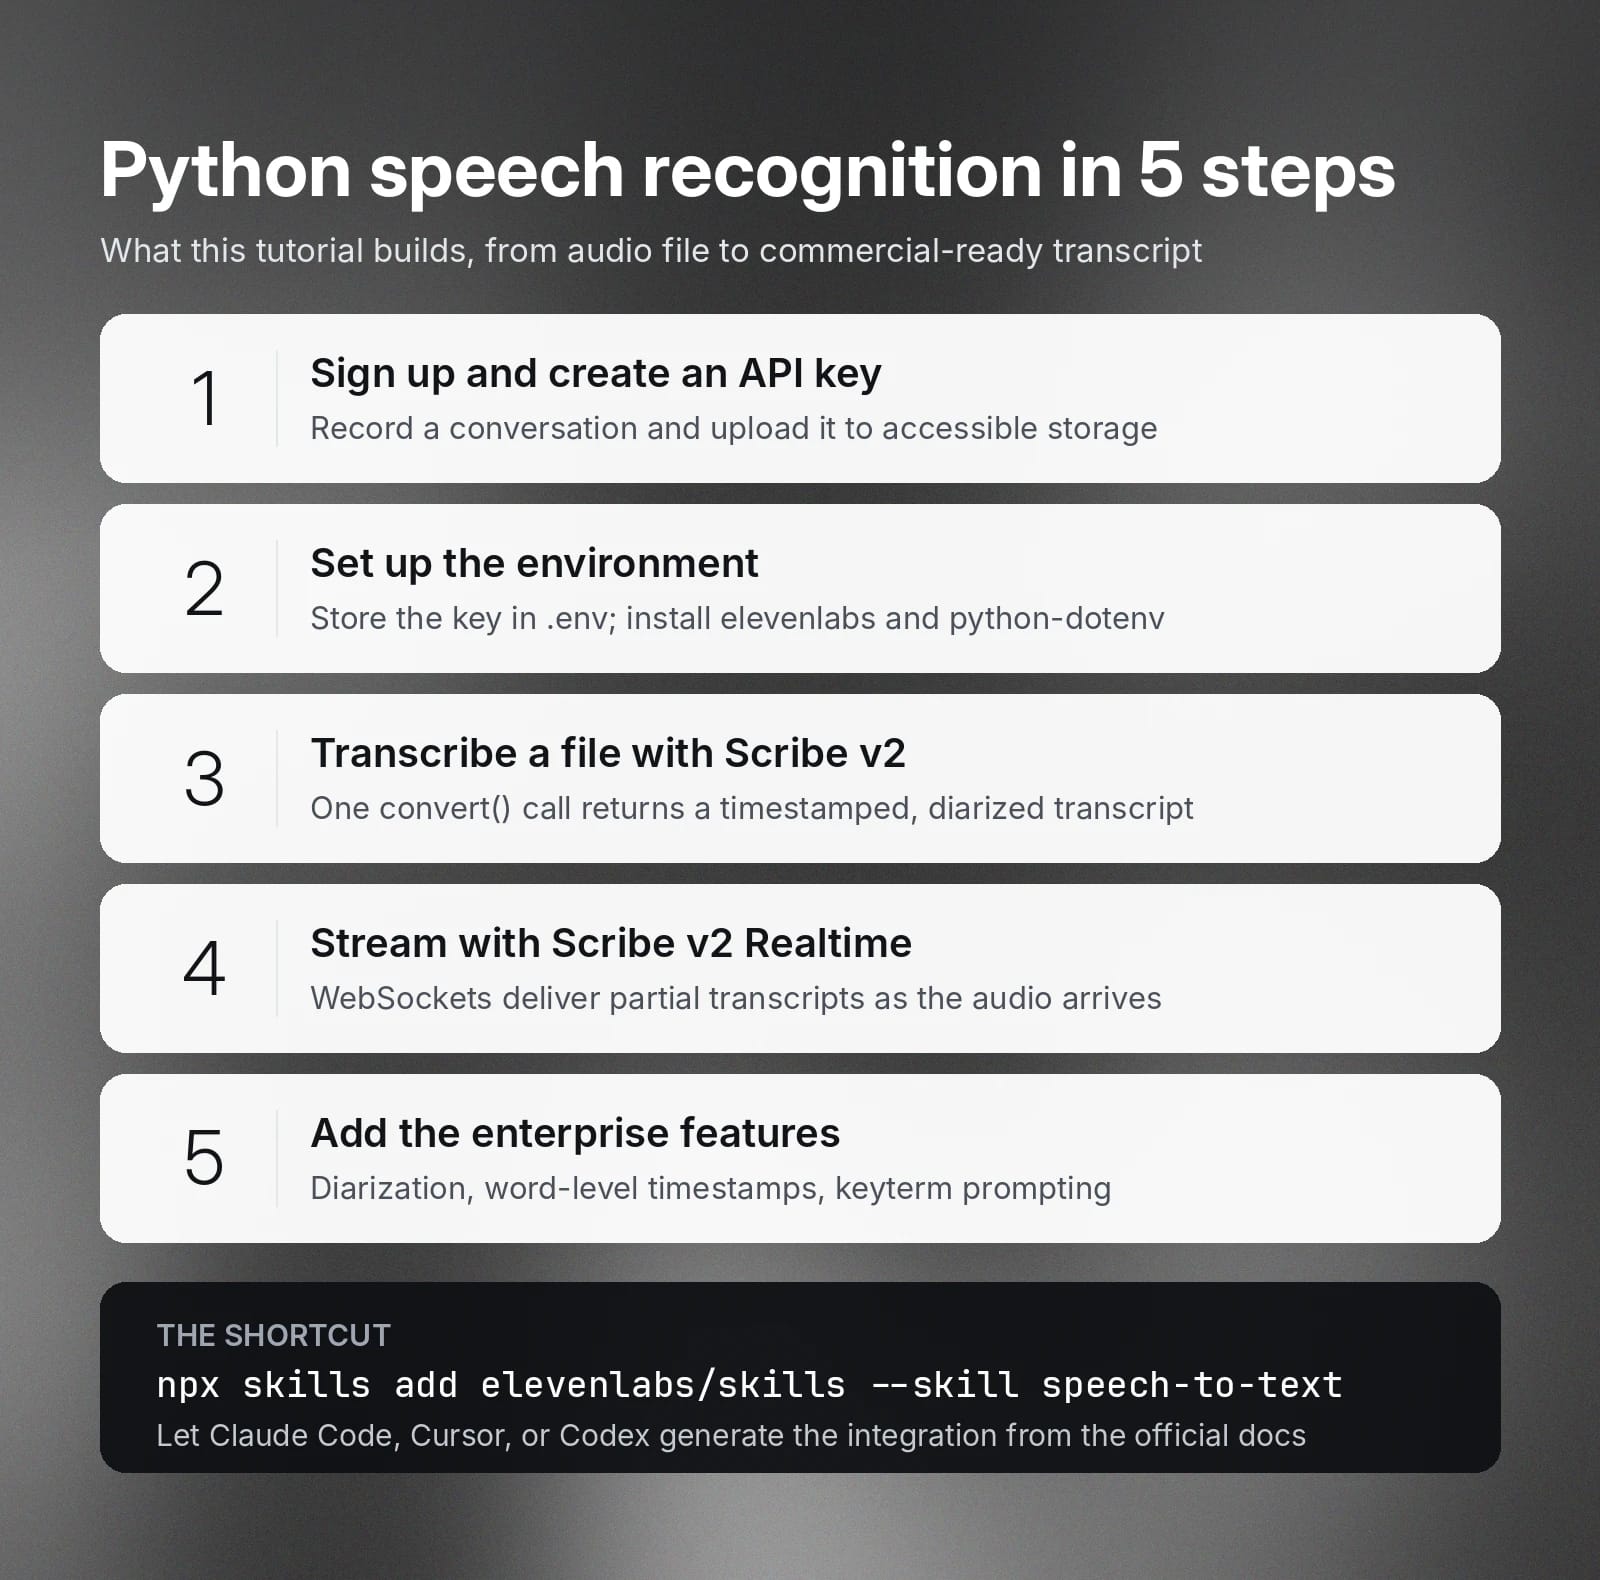
このPython音声認識チュートリアルで扱う内容
このチュートリアルでは、エンタープライズのユースケース向け音声認識Pythonアプリの構築に役立つ、前提条件、API統合、高度な文字起こし機能を解説します。
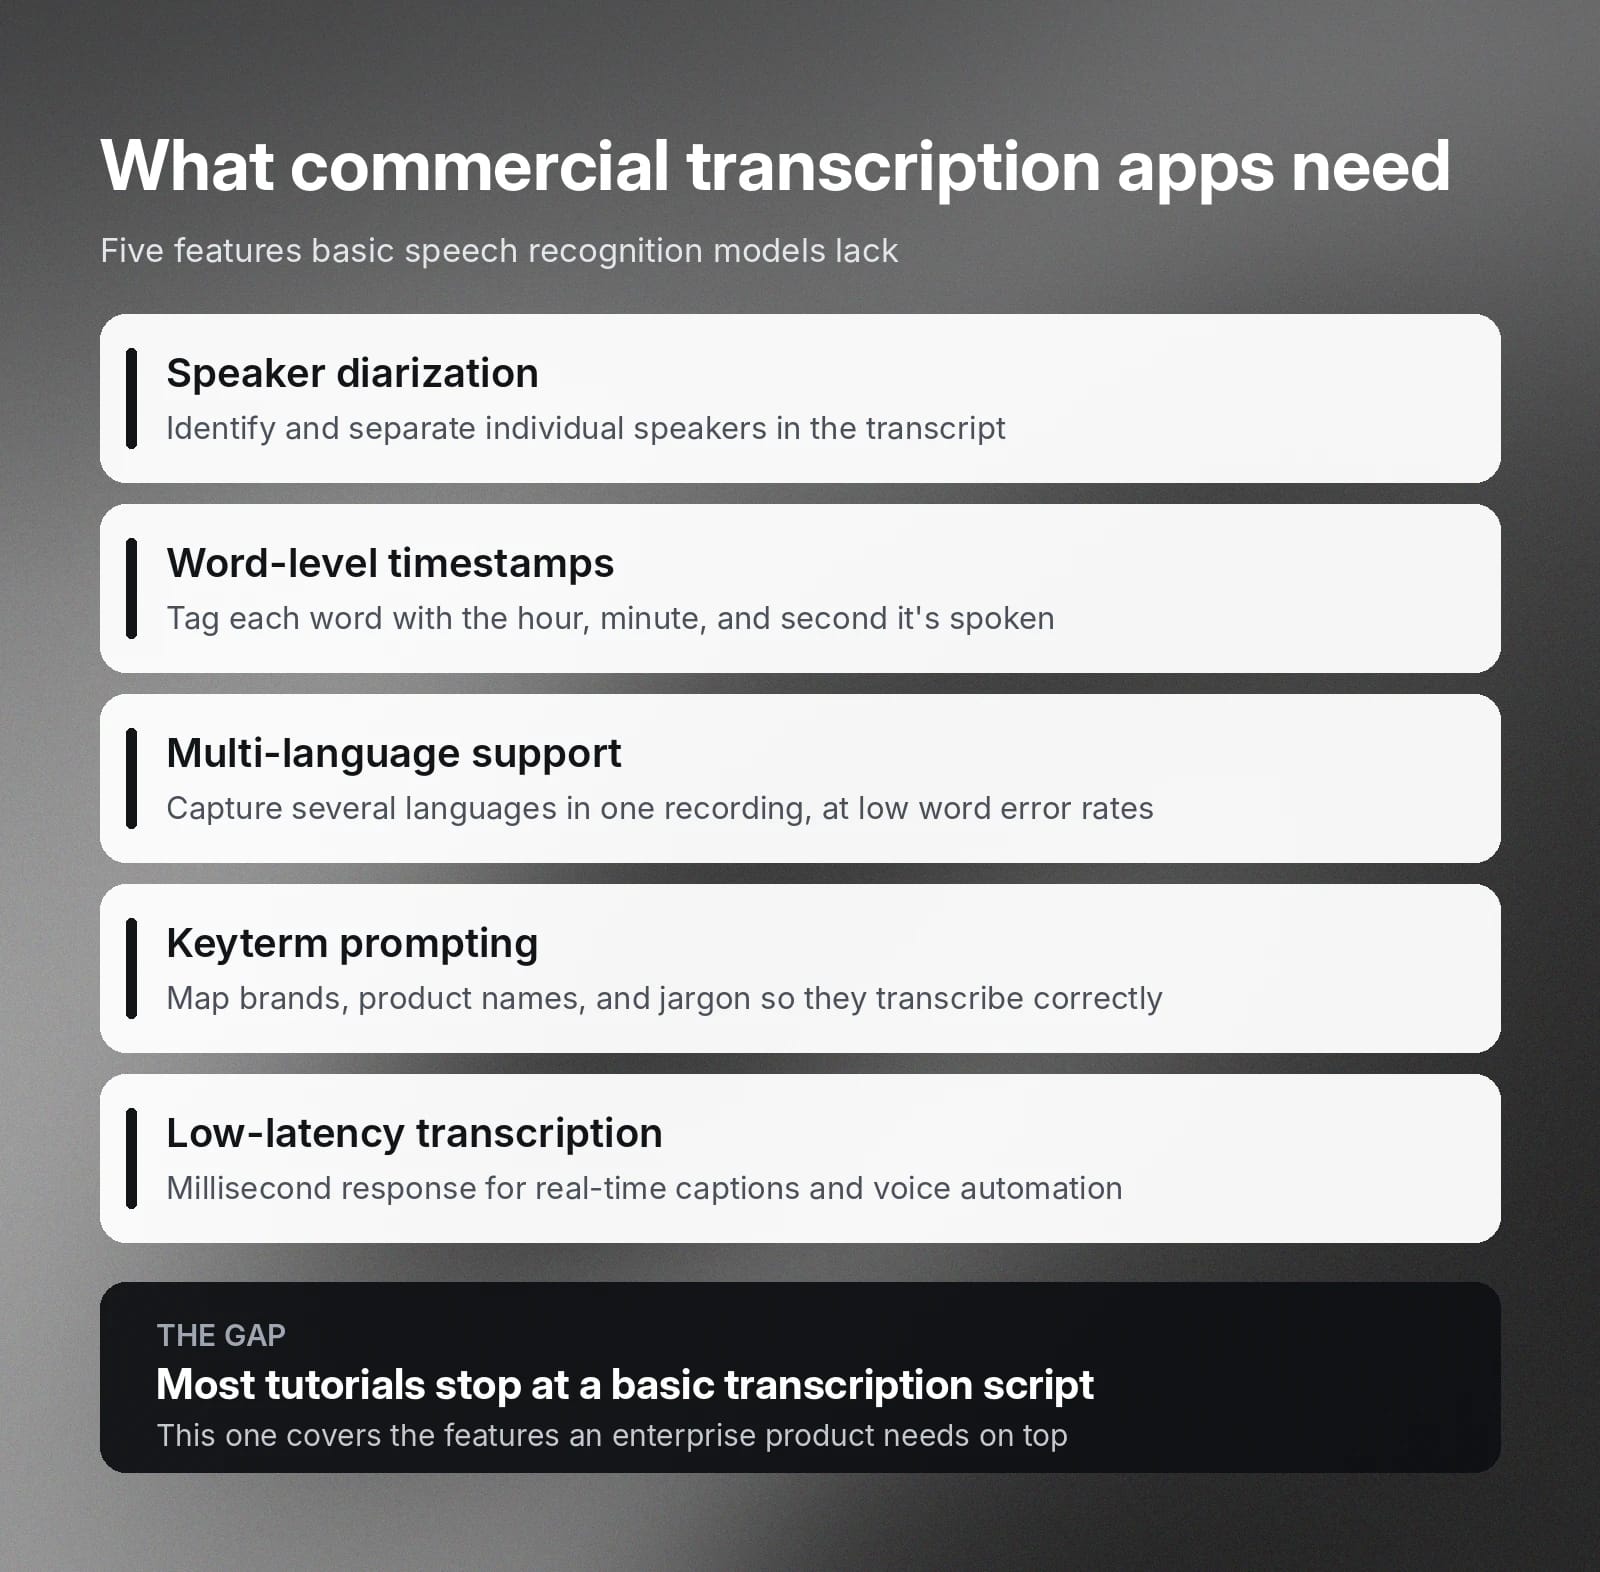
近年、特に大規模言語モデルとディープラーニングのニューラルネットワークによって、Pythonデベロッパーによる文字起こしSDKの使い方が変わり、音声認識は成熟してきました。基本的な文字起こしアプリの構築方法を示すチュートリアルは多くありますが、商用対応プロダクトに必要な機能まで扱うものはほとんどありません。
このギャップを埋めるために、本チュートリアルを作成しました。
たとえば、多くのエンタープライズ向け文字起こしソリューションには、次の機能が必要です。
- 話者ダイアライゼーション:文字起こし内の個々の話者を識別し、分離する機能。
- タイムスタンプ:発話された各単語に、相対的な時・分・秒を正確に付与します。
- 多言語対応: 1つの録音またはライブストリーム内で複数の言語による発話を、低い単語誤り率で取り込みます。
- キータームプロンプト:ブランド名、プロダクト名、専門用語などの特別な単語をマッピングし、誤記された文字起こしを防ぎます。
- 低レイテンシー文字起こし:リアルタイム文字起こしアプリを支える、ミリ秒単位のスピーチtoテキスト応答。
注記:このチュートリアルは、趣味や個人プロジェクト向けのシンプルなスクリプト作成にとどまりません。ビジネスごとに異なるため、スピーチtoテキストAPI統合の上に構築するアプリケーションロジックは含まれていません。
Python音声認識統合の前提条件
このチュートリアルは、コード内での音声モデルとのやり取りを簡素化するElevenLabsの本番環境対応API、ElevenAPIを中心に構成しています。ElevenAPIでは、Scribe v2とScribe v2 Realtimeを利用できます。これらは、バッチ文字起こしとライブ文字起こし向けの主要な音声モデルです。
ElevenLabsのスピーチtoテキストモデルに直接アクセスする代わりに、API呼び出しを通じて録音、ライブストリーム、引数を渡します。その後、オーディオモデルが音声データをテキストに変換します。完了すると、コード内またはWebhook経由で文字起こし結果を受け取れます。
始めるには、次の準備手順に従ってください。
- ElevenLabsに登録します。
- APIキーを作成します。
- 会話を録音し、公開アクセス可能なストレージにアップロードします。
準備ができたら、次のセクションに進んでください。
環境をセットアップする
ElevenLabsモデルを統合する前に、ElevenLabs APIキーを安全に扱えるようPython環境を設定します。すべてのAPIキーと同様に、.envファイル内の環境変数(管理されたシークレット)として保存することをおすすめします。
API呼び出し時には、この環境変数を渡します。これにより、パブリックネットワーク経由でAPIリクエストを行う際に、APIキーを誤って公開することを防げます。
次に、Bashコマンドを実行して、ElevenLabs SDKであるelevenlabsをPython環境にインストールします。SDKを使うと、さまざまな音声モデルにアクセスできます。この場合は、Scribe v2またはScribe v2 Realtimeを選択します。
また、Pythonコードから.envファイルに保存された環境変数へアクセスできるようにするpython-dotenvもインストールする必要があります。
最初の文字起こしスクリプトを書く
Python環境をセットアップしたら、ElevenLabs Scribe v2を使用してオーディオファイルを書き起こせます。
ElevenLabs Scribe v2は、オーディオファイルを大規模に文字起こしできる業界最高水準の音声認識モデルです。録音に大きなバックグラウンドノイズが含まれていても、音素を高精度で検出します。音声を書き起こすには、ElevenLabs APIを介して録音をモデルへ送信し、完成した文字起こし結果を取得します。
以下は、オーディオファイルをタイムスタンプ付き・話者分離済みの文字起こしに変換するPythonコードスニペットです。
このコードは、必要な機能を提供するライブラリを読み込みます。また、宣言した環境変数をプログラムの環境に読み込みます。
次に、環境変数に保存されたAPIキーを使用してElevenLabsクライアントを作成します。その後、オーディオファイルをダウンロードし、バイナリデータに変換します。
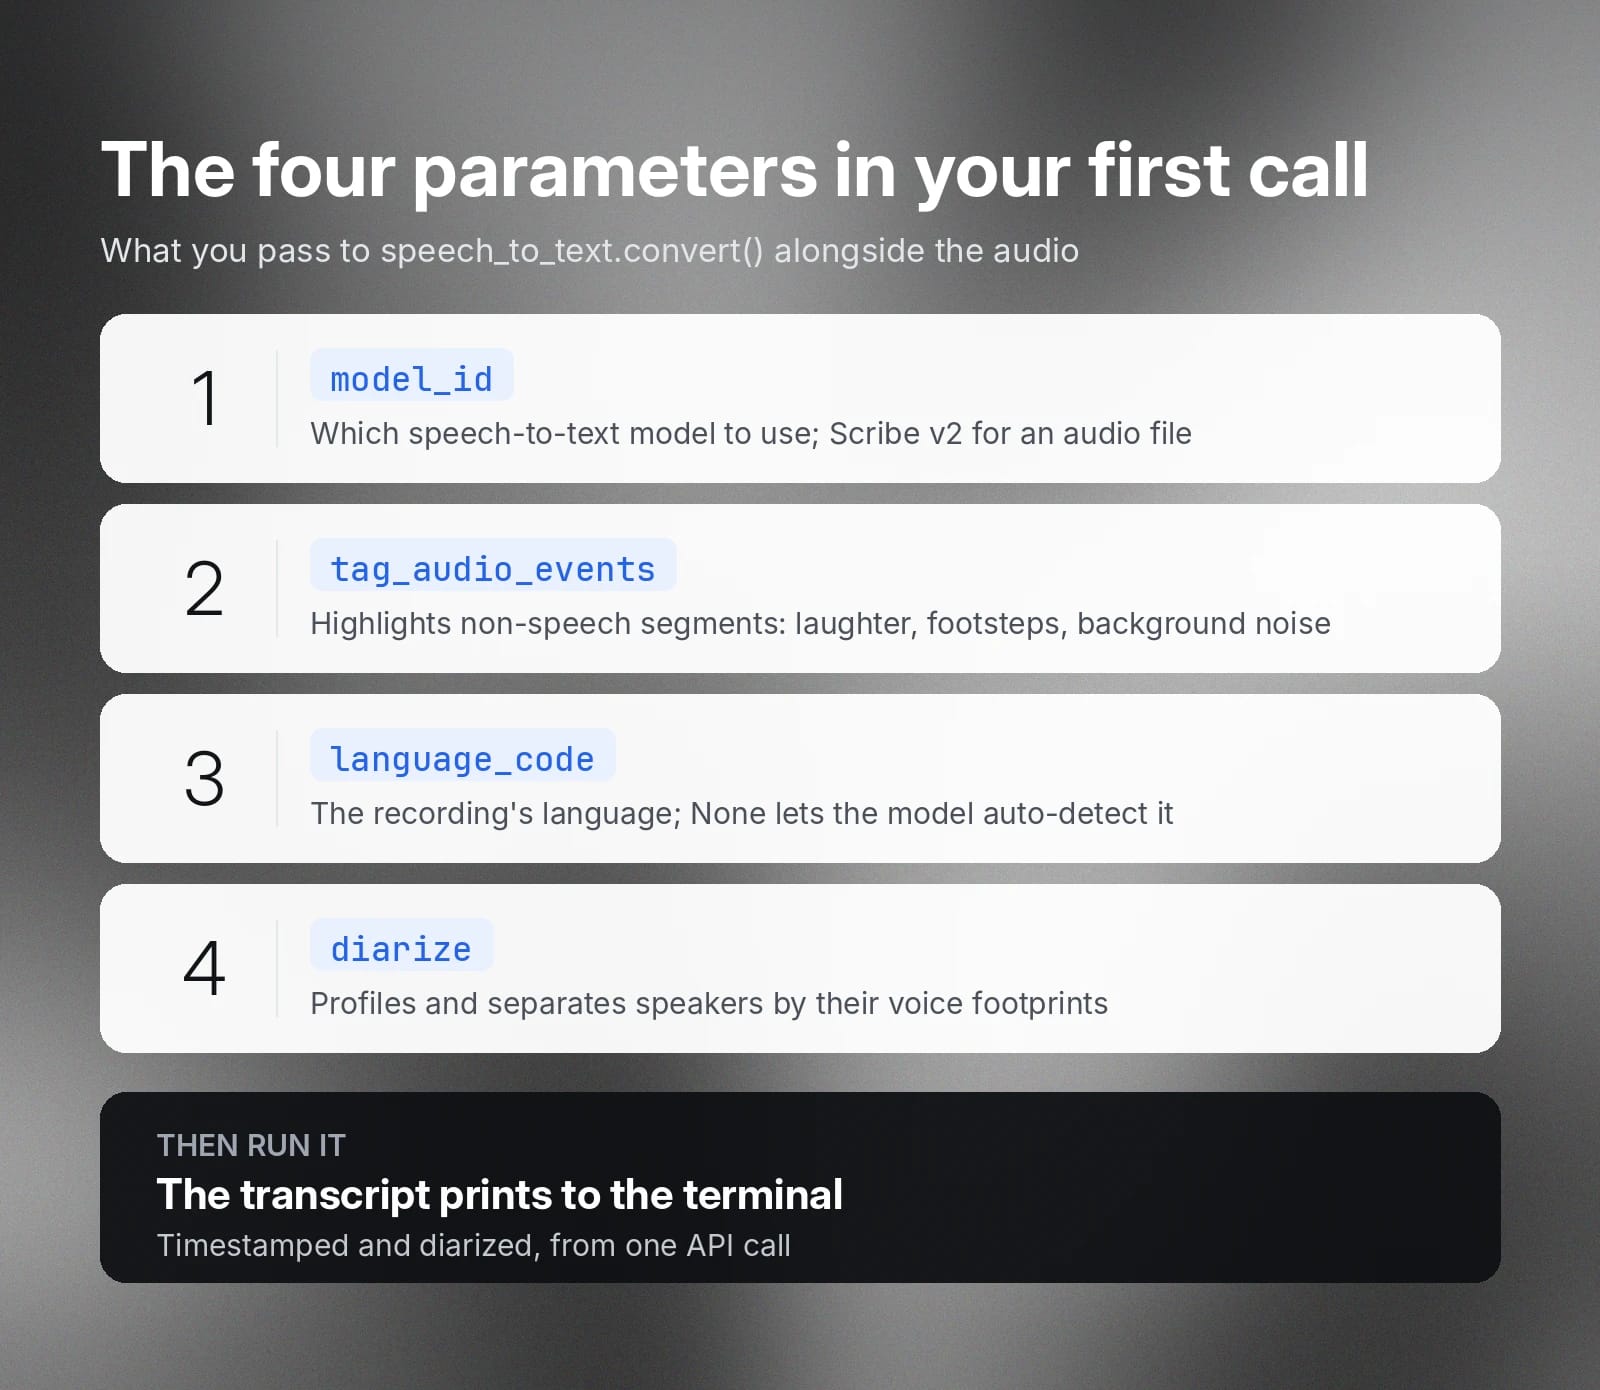
生のオーディオデータを取得したら、複数のパラメータとともにElevenLabs APIへ送信します。
- model_idは、使用するスピーチtoテキストモデルを指定します。オーディオファイルを渡す場合は、Scribe v2が最適です。
- tag_audio_events を使用すると、笑い声、足音、その他のバックグラウンドノイズなど、非音声セグメントを強調表示できます。
- language_code は、録音ファイル内の会話の言語を表します。Noneに設定すると、モデルが言語を自動検出します。
- diarizeは 音声の特徴に基づいて異なる話者をプロファイリングし、分離するかどうかを指定します。
最後にコードを実行すると、ターミナルに文字起こしされた音声が表示されます。
Pythonでストリーミング音声認識を行う
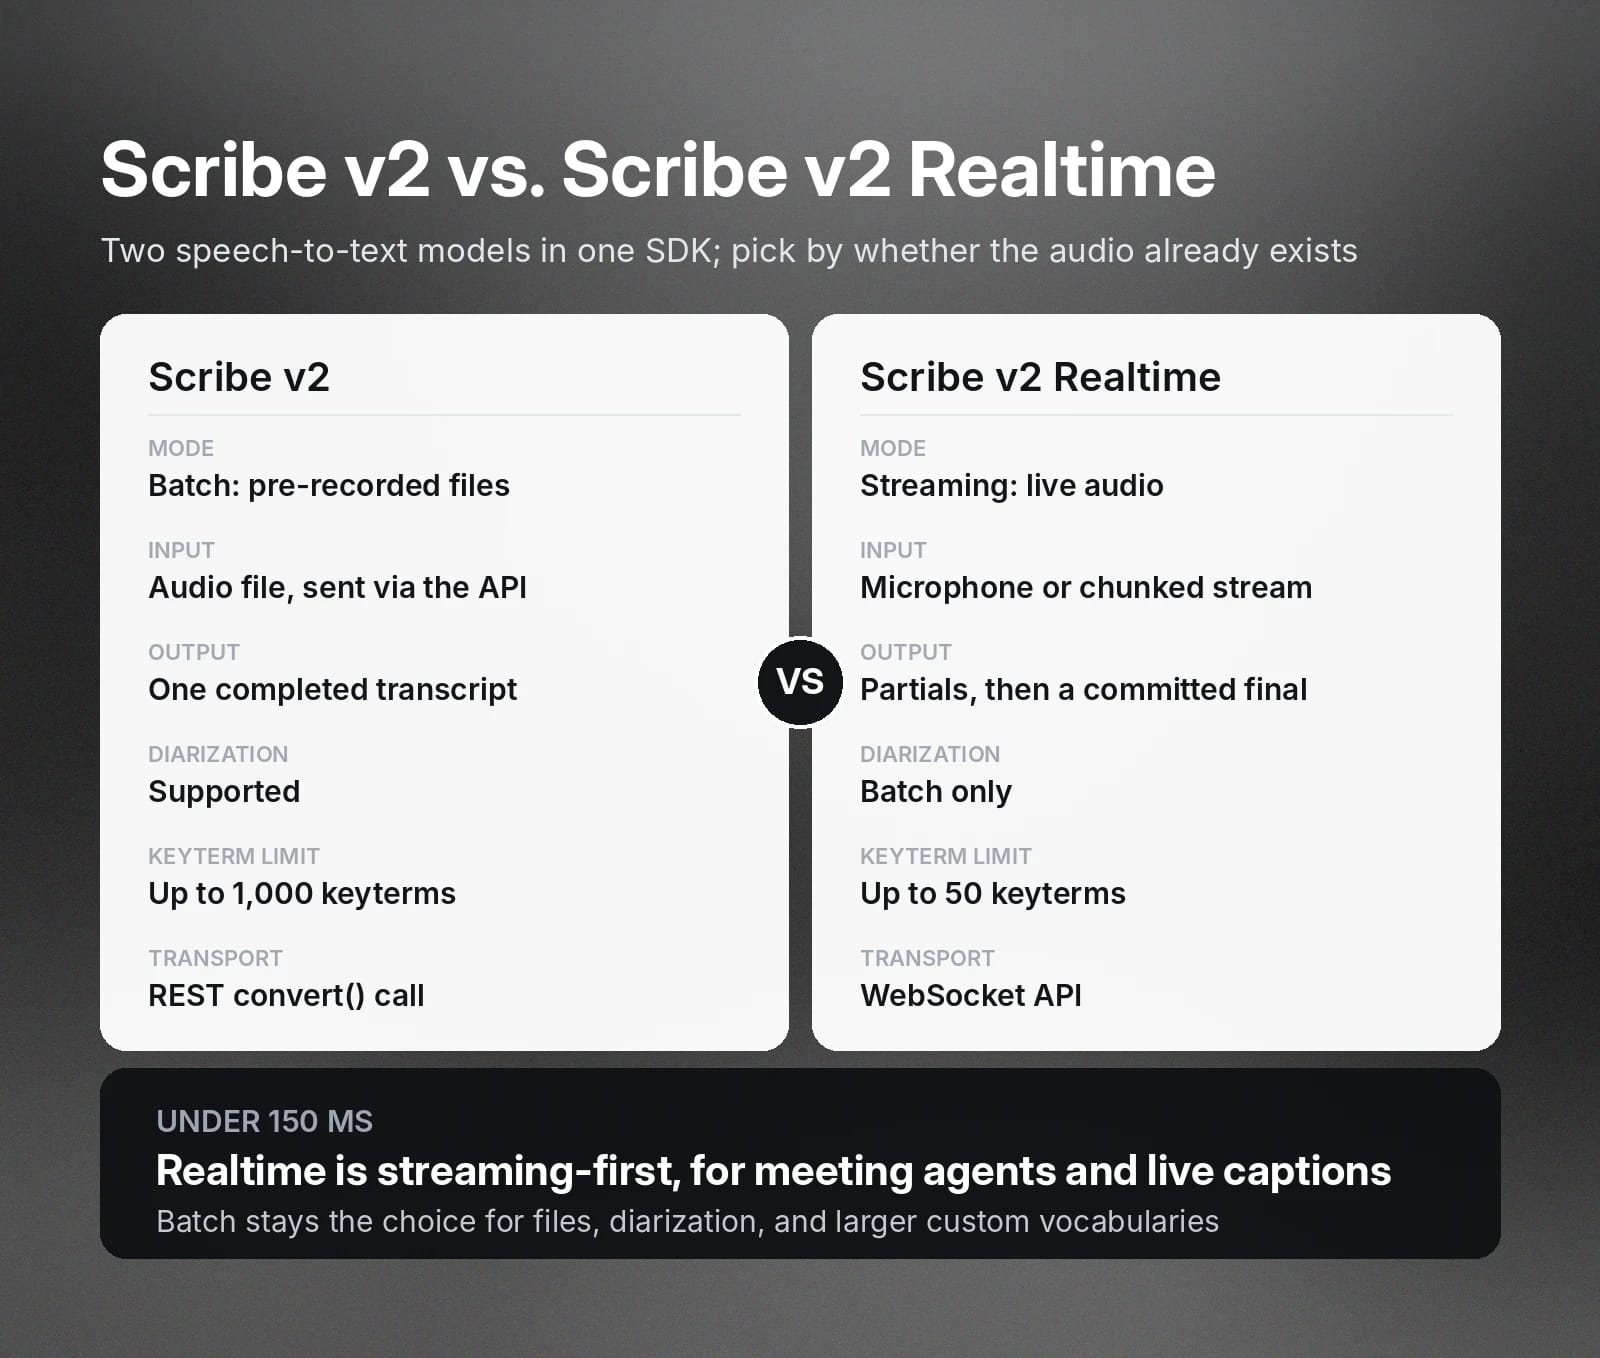
上記の例は、事前に録音されたファイルに適したバッチ文字起こしを扱っています。一方、ElevenLabsはストリーミング音声認識を構築できるAPIも提供しています。バッチ処理とは異なり、このモードでは会話中にリアルタイムで音声認識を実行し、文字起こしを生成します。
これを行うには、WebSocket APIを使用してPythonコードをScribe v2 Realtimeモデルに接続します。
Scribe v2 Realtimeは、文字起こしのレイテンシーが150ms未満のストリーミングファーストなアーキテクチャを提供します。Scribe v2 Realtimeを使うと、会議エージェント、アクセシビリティツール、音声起動オートメーションなどのアプリケーションを構築できます。モデルは、オーディオストリームの処理中に部分的な文字起こしを返します。コードが自動または手動でオーディオセグメントをコミットした場合にのみ、最終的な文字起こしを返します。
オーディオソースとアプリケーションの種類に応じて、サーバー側またはクライアント側でElevenLabs APIと音声認識を統合します。
- クライアント側ストリーミングでは、マイクから直接、または手動で分割したオーディオストリームを通じてストリーミングできます。
- サーバー側ストリーミングでは、URLまたはオーディオソースからのオーディオデータを音声モデルにルーティングします。
クライアント側とサーバー側のどちらのストリーミングでも、非同期ワークフローを利用できます。APIを継続的にポーリングする代わりに、WebSocketを使用して結果を処理します。コードでは、部分的な文字起こしと確定した文字起こしを受け取るハンドラーを作成する必要があります。
さらに活用する:ダイアライゼーション、タイムスタンプ、カスタム語彙
自動音声認識に加えて、ElevenLabsのスピーチtoテキストモデルはダイアライゼーション、タイムスタンプ、カスタム語彙をサポートしています。
- ダイアライゼーション:バッチ文字起こしのみが話者ダイアライゼーションをサポートしています。diarize引数を設定すると、ダイアライゼーションを有効にできます。ただし、バッチ文字起こし内のモードであるマルチチャンネル文字起こしは、ダイアライゼーションをサポートしていません。
- タイムスタンプ:バッチ文字起こしでは、単語単位または文字単位のタイムスタンプを選択できます。これを行うには、convertメソッドの使用時にtimestamps_granularityパラメータを設定します。
- カスタム語彙:リアルタイム文字起こしとバッチ文字起こしの両方でリアルタイム文字起こしとバッチ文字起こしはキータームプロンプトをサポートしています。この機能により、リストに含めた特定のキータームを文字起こしするようモデルを誘導できます。Scribe v2 Realtimeは最大50個、Scribe v2は最大1,000個のキータームをサポートします。
AIコーディングアシスタントでElevenLabsスキルを使う
AIコーディングアシスタントは開発を加速します。Claude Code、Cursor、CodexなどのAIコーディングツールを使用している場合は、コーディング環境にElevenLabsスキルを追加できます。
必要なのは、プラットフォームのターミナルで次のコマンドを実行するだけです:
AIコーディングエージェントは、ElevenLabsのGitHubリポジトリからスピーチtoテキストスキルをダウンロードし、ローカルのスキルディレクトリにインストールします。これにより、API統合全体を一から書く代わりに、ElevenLabsの公式ドキュメントに基づく音声認識用Pythonコードを自動生成できます。
インストール後は、機能を会話形式で説明するだけで、音声認識用のPythonコードを生成できます。説明に基づき、コーディングアシスタントが適切なモデルとパラメータを使って、スピーチtoテキストスキルによるコードを自動生成します。
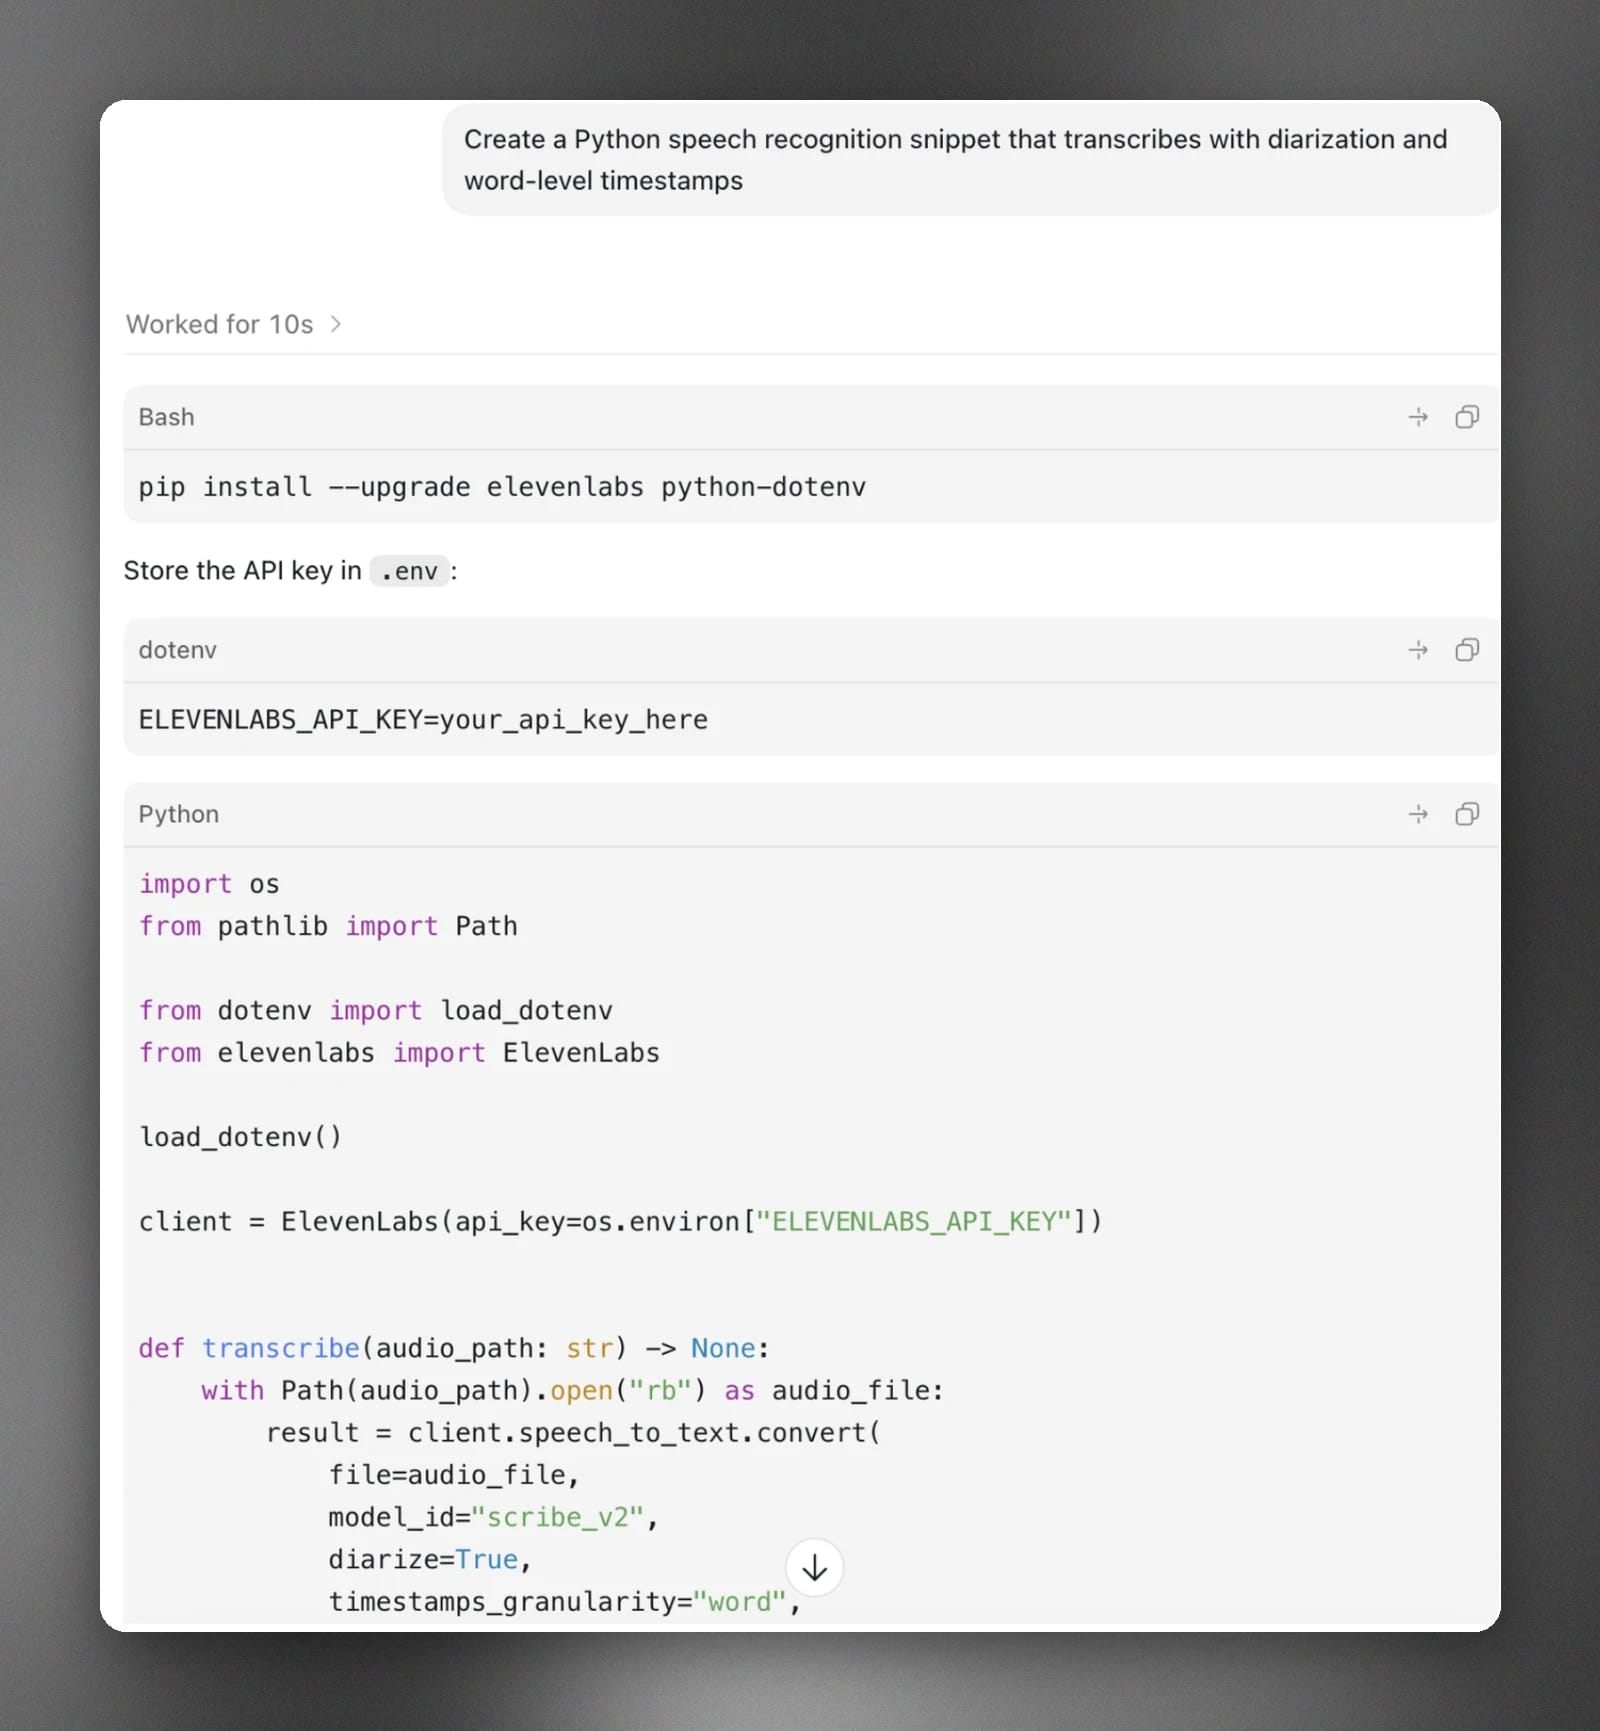
たとえばCodexで「ダイアライゼーションと単語単位のタイムスタンプを使用して文字起こしするPython音声認識スニペットを作成」と入力すると、以下のようなスニペットが得られます。
ElevenAPIで音声認識を始める
ElevenAPIを使うと、高度なスピーチtoテキストモデルにアクセスし、Pythonで音声認識アプリを構築できます。
ElevenAPIを使用すると、プロダクトのイノベーションを遅らせる統合コードを一から書く必要がありません。代わりに、キータームプロンプト、ダイアライゼーション、タイムスタンプなど、商用グレードの要件を満たすスピーチtoテキストサービスを提供するSDKを利用できます。
今すぐElevenLabs APIキーを取得し、公式ドキュメントでAPIの仕組みを確認してください。
よくある質問

Jack LimebearはGrowthチームに所属し、ブログやインサイトページのコンテンツライター兼ストラテジストとして活躍しています。ElevenLabsに入社する前は、急成長中のSaaSスタートアップからFortune 500企業まで、さまざまな組織で10年以上にわたりコンテンツ戦略をリードしてきました。ケンブリッジ大学で英文学の修士号を取得しています。


